Khóa học
Tìm hiểu Machine Learning
2 giờ
313.8K
Hãy xem xét tình huống sau -
Bạn đang làm việc với tập dữ liệu của mình. Bạn tạo một mô hình phân loại và đạt 90% độ chính xác ngay lập tức. Kết quả có vẻ thật tuyệt. Bạn đào sâu thêm và phát hiện gần như toàn bộ dữ liệu thuộc về một lớp. Chao ôi! Dữ liệu mất cân bằng có thể khiến bạn bực bội không ít.
Bạn cảm thấy rất nản khi phát hiện dữ liệu của mình có các lớp mất cân bằng và những kết quả tuyệt vời tưởng như có được hóa ra chỉ là ảo. Điều còn khó chịu hơn là nhiều sách hay cũng không bao quát chủ đề này một cách toàn diện.
Đây là một ví dụ về tình huống do tập dữ liệu mất cân bằng gây ra và những kết quả gây bực bội mà nó có thể dẫn tới.
Trong hướng dẫn này, bạn sẽ khám phá các kỹ thuật có thể dùng để mang lại kết quả xuất sắc trên các tập dữ liệu mất cân bằng. Cụ thể, bạn sẽ tìm hiểu:
Trước hết, hãy xem dữ liệu mất cân bằng là gì.
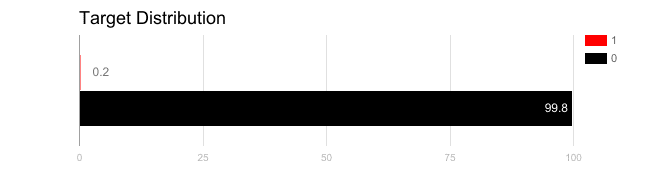 Nguồn: KDNuggets
Dữ liệu mất cân bằng thường đề cập đến các bài toán phân loại trong đó các lớp không được biểu diễn một cách đồng đều.
Ví dụ, bạn có một bài toán phân loại nhị phân với 100 quan sát, trong đó 80 quan sát được gán Nhãn Lớp-1 và 20 quan sát còn lại được gán Nhãn Lớp-2.
Đây thực chất là một ví dụ về tập dữ liệu mất cân bằng, và tỷ lệ số lượng giữa Lớp-1 và Lớp-2 là 4:1.
Dù là cuộc thi Kaggle hay tập dữ liệu kiểm thử thực tế, vấn đề mất cân bằng lớp là một trong những vấn đề phổ biến nhất.
Hầu hết các bài toán phân loại trong thế giới thực đều thể hiện một mức độ mất cân bằng lớp nhất định, xảy ra khi không có đủ số lượng quan sát tương ứng với một trong hai nhãn lớp. Do đó, điều tối quan trọng là chọn đúng thước đo đánh giá cho mô hình của bạn. Nếu không, bạn có thể sẽ tinh chỉnh/tối ưu một tham số vô dụng. Trong bối cảnh ưu tiên kinh doanh, điều này có thể dẫn đến lãng phí hoàn toàn.
Có những bài toán mà mất cân bằng lớp không chỉ phổ biến; nó gần như chắc chắn xảy ra. Ví dụ, với các tập dữ liệu về giao dịch gian lận và không gian lận, rất có khả năng số giao dịch gian lận sẽ rất ít so với số giao dịch không gian lận. Và đây là nơi vấn đề nảy sinh. Bạn sẽ học vì sao.
Mặc dù nhiều thuật toán học máy (cả sâu và thống kê) đã cho thấy thành công lớn trong nhiều ứng dụng thực tế, bài toán học từ dữ liệu mất cân bằng vẫn chưa đạt mức tối tân. Việc học từ dữ liệu mất cân bằng thường được gọi là học mất cân bằng.
Sau đây là những vấn đề đáng kể của học mất cân bằng:
Vào lúc này, hẳn bạn sẽ có một câu hỏi hiển nhiên - tại sao trong thời đại GPU, TPU mà các thuật toán học máy lại không xử lý hiệu quả dữ liệu mất cân bằng? Câu hỏi rất đúng chỗ và bạn sẽ tìm thấy câu trả lời ngay bây giờ.
Việc đánh giá các thuật toán học máy có liên quan rất nhiều tới lý do vì sao một thuật toán học máy nhất định không hoạt động tốt khi được cung cấp dữ liệu mất cân bằng.
"Đây là trường hợp thước đo độ chính xác cho bạn câu chuyện rằng bạn có độ chính xác rất cao (chẳng hạn 90%), nhưng độ chính xác đó chỉ phản ánh phân phối lớp nền tảng." - Machine Learning Mastery
Giả sử bạn có một tập dữ liệu (gắn với một tác vụ phân loại) với hai lớp có tỷ lệ phân phối 9:1. Tổng số quan sát trong tập là 1000, với nhãn lớp là Lớp-1 và Lớp-2. Do đó, theo tỷ lệ phân phối, số quan sát thuộc Lớp-1 là 900 còn Lớp-2 là 100. Bây giờ bạn áp dụng một bộ phân loại tiêu chuẩn (ví dụ Logistic Regression) và đo hiệu năng theo độ chính xác phân loại, tức số quan sát được phân loại đúng. Giờ hãy nhìn kỹ hơn và suy nghĩ thật sâu.
Mô hình Logistic Regression của bạn không cần quá phức tạp để phân loại tất cả 1000 quan sát thành Lớp-1. Khi đó, bạn sẽ có độ chính xác phân loại 90% nhưng điều này thực sự không đủ để kiểm tra chất lượng thực sự của bộ phân loại. Rõ ràng, bạn cần một thước đo khác để đánh giá hiệu năng hệ thống. Bạn sẽ thấy điều đó ngay. Hiện tượng bạn vừa xem gọi là Nghịch lý Độ chính xác.
Bạn sẽ bắt đầu phần này bằng việc tìm hiểu một số thước đo khác ngoài độ chính xác phân loại để thực sự đánh giá một bộ phân loại khi nó xử lý dữ liệu mất cân bằng.
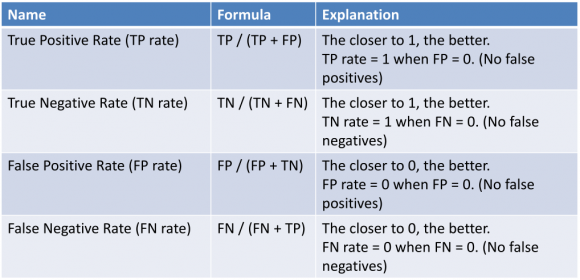
Trước hết, hãy định nghĩa bốn khái niệm cơ bản:
Hình ảnh sau sẽ minh họa các thuật ngữ trên:
Giờ giả sử bạn huấn luyện một bộ phân loại khác trên tập đồ chơi vừa thấy và lần này bạn áp dụng Random Forest. Bạn nhận được độ chính xác phân loại 70%. Nay khi bạn đã biết về các Tỷ lệ Dương tính/Âm tính Đúng và các Tỷ lệ Dương tính/Âm tính Sai, bạn sẽ phân tích hiệu năng của Logistic Regression và Random Forest ở mức chi tiết hơn.
Giả sử bạn có các Tỷ lệ Dương tính/Âm tính Đúng và Dương tính/Âm tính Sai cho Logistic Regression như sau:

Giờ giả sử các Tỷ lệ Dương tính/Âm tính Đúng và Dương tính/Âm tính Sai cho Random Forest như sau:

Hãy nhìn vào số lượng lớp âm được dự đoán đúng (True Negatives) bởi cả hai bộ phân loại. Vì bạn đang xử lý một tập dữ liệu mất cân bằng, bạn cần ưu tiên con số này (bởi Lớp-1 chiếm ưu thế trong dữ liệu). Xét như vậy, Random Forest vượt qua Logistic Regression một cách dễ dàng.
Bây giờ bạn đang ở vị trí rất tốt để nghiên cứu các cách tiếp cận nhằm đối phó vấn đề tập dữ liệu mất cân bằng.
(Hãy nhớ, biểu diễn trên được gọi phổ biến là Ma trận Nhầm lẫn.)
Dưới đây là hai thuật ngữ được suy ra từ ma trận nhầm lẫn và được dùng rất nhiều khi bạn đánh giá một bộ phân loại.
Precision: Precision là số Dương tính Đúng chia cho tổng Dương tính Đúng và Dương tính Sai. Nói cách khác, đó là số dự đoán dương tính chia cho tổng số giá trị lớp dương tính được dự đoán. Nó còn được gọi là Giá trị Dự đoán Dương (PPV).
Precision có thể được xem như thước đo về mức độ chính xác của bộ phân loại. Precision thấp cũng có thể chỉ ra số lượng Dương tính Sai lớn.
Recall: Recall là số Dương tính Đúng chia cho tổng Dương tính Đúng và Âm tính Sai. Nói cách khác, đó là số dự đoán dương tính chia cho số giá trị lớp dương tính trong dữ liệu kiểm thử. Nó còn được gọi là Độ nhạy hoặc Tỷ lệ Dương tính Đúng.
Recall có thể được xem như thước đo về mức độ bao quát của bộ phân loại. Recall thấp cho thấy có nhiều Âm tính Sai.
Một số thước đo khác cũng hữu ích trong ngữ cảnh này:
Trước khi bắt đầu nghiên cứu các cách tiếp cận để xử lý vấn đề mất cân bằng lớp, hãy cùng xem một ví dụ rất thực tế, nơi chỉ chọn độ chính xác phân loại làm thước đo đánh giá có thể tạo ra kết quả tai hại. (Bạn làm điều này để đảm bảo rằng bạn không chỉ xem xét độ chính xác phân loại khi huấn luyện bộ phân loại tiếp theo.)
Tập dữ liệu ung thư vú là một tập dữ liệu học máy tiêu chuẩn. Nó chứa 9 thuộc tính mô tả 286 phụ nữ đã mắc và sống sót sau ung thư vú, và liệu ung thư vú có tái phát trong vòng 5 năm hay không. Hãy khảo sát tập dữ liệu này để bạn cảm nhận rõ hơn vấn đề.
Tập dữ liệu liên quan đến một bài toán phân loại nhị phân. Trong số 286 phụ nữ, 201 người không bị tái phát ung thư vú, 85 người còn lại thì có.
Hãy khám phá tập dữ liệu này trực quan hơn.
import numpy as np
import pandas as pd

# Load the dataset into a pandas dataframe
data = pd.read_csv("breast-cancer.data",header=None)

# See the data
print(data.head(10))
                      0      1        2      3    4   5  6      7          8  \
0  no-recurrence-events  30-39  premeno  30-34  0-2  no  3   left   left_low
1  no-recurrence-events  40-49  premeno  20-24  0-2  no  2  right   right_up
2  no-recurrence-events  40-49  premeno  20-24  0-2  no  2   left   left_low
3  no-recurrence-events  60-69     ge40  15-19  0-2  no  2  right    left_up
4  no-recurrence-events  40-49  premeno    0-4  0-2  no  2  right  right_low
5  no-recurrence-events  60-69     ge40  15-19  0-2  no  2   left   left_low
6  no-recurrence-events  50-59  premeno  25-29  0-2  no  2   left   left_low
7  no-recurrence-events  60-69     ge40  20-24  0-2  no  1   left   left_low
8  no-recurrence-events  40-49  premeno  50-54  0-2  no  2   left   left_low
9  no-recurrence-events  40-49  premeno  20-24  0-2  no  2  right    left_up

    9
0  no
1  no
2  no
3  no
4  no
5  no
6  no
7  no
8  no
9  no
Tên cột là số vì bạn đang dùng một tập dữ liệu đã được tiền xử lý một phần. Nhưng nếu bạn quan tâm, bạn có thể tham khảo hình sau:

Hãy vẽ biểu đồ cột về phân phối lớp.
import matplotlib.pyplot as plt

classes = data[9].values
unique, counts = np.unique(classes, return_counts=True)

plt.bar(unique,counts)
plt.title('Class Frequency')
plt.xlabel('Class')
plt.ylabel('Frequency')
plt.show()

Bạn có thể thấy rất rõ sự mất cân bằng lớp ở đây. yes biểu thị các trường hợp có ung thư và như dễ thấy, số lượng các trường hợp này rất ít so với các trường hợp thuộc lớp còn lại.
Hãy định nghĩa sự kiện "Không tái phát" và "Tái phát" trong tập dữ liệu để mọi thứ rõ ràng hơn nữa.
Tất cả Không tái phát: Một mô hình chỉ dự đoán không tái phát ung thư vú sẽ đạt độ chính xác (201/286) * 100 tức 70,28%. Đây được gọi là Tất cả Không tái phát. Đây là độ chính xác cao, nhưng là mô hình tệ. Nếu mô hình này bị hiểu sai, nó sẽ cho 85 phụ nữ về nhà với suy nghĩ sai rằng ung thư vú của họ sẽ không tái phát (Âm tính Sai cao).
Tất cả Tái phát: Một mô hình chỉ dự đoán tái phát ung thư vú sẽ đạt độ chính xác (85/286) * 100 tức 29,72%. Đây được gọi là Tất cả Tái phát. Mô hình này thất bại trong việc tạo ra độ chính xác tốt và sẽ cho 201 phụ nữ về nhà với suy nghĩ rằng họ bị tái phát ung thư vú, trong khi thực tế không phải vậy (Dương tính Sai cao).
Đến đây hẳn khái niệm này đã thắp lên trong bạn một tia sáng. Hãy tiếp tục.
Tuyệt! Giờ bạn đã có đủ lý do để thấy rằng chỉ xem xét độ chính xác phân loại để đánh giá mô hình phân loại không phải lựa chọn tốt.
Giờ hãy tìm hiểu một số cách tiếp cận.
Xử lý các tập dữ liệu mất cân bằng bao gồm nhiều chiến lược như cải tiến thuật toán phân loại hoặc cân bằng các lớp trong dữ liệu huấn luyện (về bản chất là một bước tiền xử lý dữ liệu) trước khi đưa dữ liệu vào thuật toán học máy. Cách sau được ưa chuộng hơn vì có phạm vi áp dụng và thích nghi rộng hơn. Hơn nữa, thời gian để nâng cấp một thuật toán thường lớn hơn thời gian tạo các mẫu cần thiết. Tuy nhiên, cho mục đích nghiên cứu, cả hai đều được ưa chuộng.
Ý tưởng chính của việc lấy mẫu các lớp là hoặc tăng số mẫu của lớp thiểu số, hoặc giảm số mẫu của lớp đa số. Việc này nhằm đạt được sự cân bằng tương đối giữa số lượng quan sát của cả hai lớp.
Có hai kiểu lấy mẫu chính:
Điều này thậm chí còn dễ thực hiện về mặt triển khai. Đúng không? Ở phần sau của bài, bạn sẽ biết về một thư viện dành riêng cho việc lấy mẫu.
Khi bạn loại ngẫu nhiên các quan sát khỏi lớp đa số của một tập dữ liệu và phân bổ cho lớp thiểu số (mà không bù đắp phần trống tạo ra ở lớp đa số), điều đó được gọi là lấy mẫu thiếu ngẫu nhiên. Phần trống phát sinh trong lớp đa số khiến quá trình này mang tính ngẫu nhiên.
Ưu điểm của cách tiếp cận này:
Nhược điểm:
Tương tự lấy mẫu thiếu ngẫu nhiên, bạn cũng có thể thực hiện lấy mẫu quá mức ngẫu nhiên. Nhưng trong trường hợp này, không nhờ vào lớp đa số, bạn tăng số quan sát tương ứng với lớp thiểu số bằng cách nhân bản chúng lên tới một mức cố định. Khi đó, bạn không giảm số quan sát của lớp đa số. Giả sử bạn có một tập dữ liệu 1000 quan sát, trong đó 980 thuộc lớp đa số và 20 thuộc lớp thiểu số. Giờ bạn lấy mẫu quá mức bằng cách nhân bản 20 quan sát này lên 20 lần. Kết quả, sau khi lấy mẫu quá mức, tổng số quan sát ở lớp thiểu số sẽ là 400.
Ưu điểm của lấy mẫu quá mức ngẫu nhiên:
Nhược điểm:
Bạn có thể cân nhắc các yếu tố sau khi áp dụng lấy mẫu thiếu và lấy mẫu quá mức:
Nếu muốn triển khai lấy mẫu thiếu và lấy mẫu quá mức trong Python, bạn nên xem scikit-learn-contrib.
Giờ bạn sẽ tìm hiểu cách tiếp cận tiếp theo để xử lý dữ liệu mất cân bằng.
Một cách đơn giản để tạo mẫu tổng hợp là lấy mẫu các thuộc tính từ các quan sát trong lớp thiểu số một cách ngẫu nhiên.
Có những thuật toán có hệ thống mà bạn có thể dùng để tạo mẫu tổng hợp. Phổ biến nhất là SMOTE hay Kỹ thuật lấy mẫu quá mức tổng hợp cho lớp thiểu số. Nó được đề xuất năm 2002, và bạn có thể xem. Hình minh họa sau sẽ cho bạn ý niệm khá rõ về các mẫu tổng hợp:
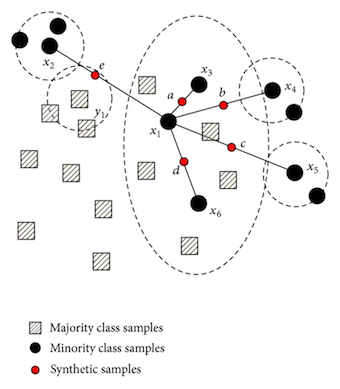
SMOTE là phương pháp lấy mẫu quá mức tạo các ví dụ “tổng hợp” thay vì lấy mẫu quá mức bằng cách nhân bản. Lớp thiểu số được lấy mẫu quá mức bằng cách lấy mỗi quan sát thuộc lớp thiểu số và tạo các ví dụ tổng hợp trên các đoạn nối với một vài/lần lượt k láng giềng gần nhất cùng lớp thiểu số. Tùy vào mức độ lấy mẫu quá mức mong muốn, các láng giềng trong k láng giềng gần nhất được chọn ngẫu nhiên.
Cốt lõi của SMOTE là xây dựng các mẫu cho lớp thiểu số. Trực giác đằng sau thuật toán xây dựng rất đơn giản. Bạn đã học rằng lấy mẫu quá mức gây quá khớp, và do lặp lại các quan sát, ranh giới quyết định trở nên “thắt chặt”. Sẽ ra sao nếu bạn có thể tạo các mẫu tương tự thay vì lặp lại chúng? Trong bài báo SMOTE gốc (liên kết ở trên) đã chỉ ra rằng với một thuật toán học máy, các quan sát mới được tạo không phải là bản sao y hệt, nhờ vậy làm mềm ranh giới quyết định và giúp thuật toán xấp xỉ giả thuyết chính xác hơn.
Tuy nhiên, SMOTE có một số ưu và nhược điểm -
Ưu điểm -
Nhược điểm -
Có một số biến thể của SMOTE như safe-level SMOTE, border-line SMOTE, OSSLDDD-SMOTE, v.v. Nếu muốn dùng SMOTE và các biến thể, bạn có thể xem mô-đun scikit-learn-contrib như đã nêu. Nếu muốn tìm hiểu thêm về SMOTE, bạn nên xem các bài báo này và này.
Hãy chuyển sang cách tiếp cận cuối cùng trong hướng dẫn này.
Có những lĩnh vực nghiên cứu dành riêng cho việc xử lý các tập dữ liệu mất cân bằng. Chúng có thuật toán, thước đo và thuật ngữ riêng.
Thường thì sự sáng tạo và tư duy đổi mới có thể cho bạn những góc nhìn mới khi xử lý dữ liệu mất cân bằng. Cách tiếp cận sau có thể giúp bạn khởi động:
Học có nhạy chi phí (Cost-Sensitive Learning): Thông thường, bạn dùng regularization (nếu muốn tìm hiểu thêm về regularization bạn có thể xem bài viết của DataCamp này) để phạt các hệ số lớn thường xuất hiện trong Các Mô hình Tuyến tính Tổng quát (GLM). Dù việc áp dụng này khác nhau giữa các mô hình, ở đây bạn chỉ xét GLM. Nếu bạn có thể thiết kế một cơ chế phạt bộ phân loại mỗi khi nó phân loại sai. Điều này có thể giúp bộ phân loại học giả thuyết một cách chi tiết hơn nhiều.
Dưới đây là một số cách tiếp cận bạn nên cân nhắc:
Đến đây, bạn đã được giới thiệu về khái niệm dữ liệu mất cân bằng và những vấn đề nó gây ra khi thiết kế và phát triển mô hình học máy. Bạn cũng đã thấy nhiều lý do vì sao cần xử lý dữ liệu mất cân bằng. Sau đó, bạn đã học các cách tiếp cận khác nhau có thể giúp xử lý hiệu quả các tập dữ liệu mất cân bằng. Xử lý dữ liệu mất cân bằng là một lĩnh vực nghiên cứu sôi động và có thể mở ra cho bạn những chân trời mới để cân nhắc các bài toán nghiên cứu mới.
Nhiều khái niệm quan trọng trong một lần! Thật ấn tượng!
Đó là tất cả cho hướng dẫn này.
Dưới đây là một số liên kết bài báo nếu bạn rất muốn nghiên cứu sâu hơn về chủ đề dữ liệu mất cân bằng:
Tài liệu tham khảo:
Nếu bạn muốn học thêm về trực quan hóa dữ liệu, hãy tham gia khóa "Interactive Data Visualization with Bokeh" của DataCamp do Bryan Van de Ven, một trong các nhà phát triển Bokeh, giảng dạy.
Tìm hiểu thêm về Machine Learning
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
