
Program
Pengembangan Model Bahasa Besar
16 jam
Keluarga model open-source terbaru dari Google, Gemma 3, dengan cepat meraih popularitas karena performanya yang mengesankan, sebanding dengan beberapa model proprietary terbaru. Gemma 3 menghadirkan kemampuan multimodal, keterampilan penalaran yang ditingkatkan, dan mendukung lebih dari 140 bahasa.
Dalam tutorial ini, kita akan menjelajahi kemampuan Gemma 3 dan belajar cara melakukan fine-tuning pada dataset tanya jawab penalaran keuangan. Proses fine-tuning ini akan meningkatkan akurasi model secara signifikan dalam memahami pertanyaan keuangan yang kompleks dan memungkinkannya memberikan jawaban yang tepat serta relevan secara kontekstual.
Baru dalam fine-tuning LLM? Jangan khawatir; kami siap membantu! Ikuti tutorial mudah dipahami kami, Fine-Tuning LLMs: A Guide With Examples, untuk mempelajari cara kerja fine-tuning.
Anda juga dapat mengikuti kursus Introduction to LLMs in Python untuk mempelajari lebih lanjut tentang cara kerja LLM, cara melakukan fine-tuning, dan cara mengevaluasi kinerjanya.
Gambar oleh Penulis
Keluarga model terbuka Gemma merepresentasikan kemajuan signifikan dalam membuat teknologi AI mutakhir dapat diakses oleh semua orang. Dibangun menggunakan riset dan teknologi di balik model Gemini 2.0, Gemma 3 menawarkan performa terkini sekaligus tetap ringan dan efisien.
Dengan ukuran mulai dari 1 miliar hingga 27 miliar parameter, Gemma 3 memberikan fleksibilitas dalam kebutuhan perangkat keras dan performa, sehingga lebih mudah dari sebelumnya untuk mengintegrasikan AI canggih ke dalam aplikasi dunia nyata.
Gemma 3 menetapkan tolok ukur baru untuk performa di kelasnya, melampaui pesaing seperti Llama3-405B, DeepSeek-V3, dan o3-mini dalam evaluasi preferensi manusia pada papan peringkat LMArena. Desainnya yang ringan tidak mengorbankan kekuatan, memungkinkan pengembang mencapai hasil terbaik di industri sambil tetap efisien.
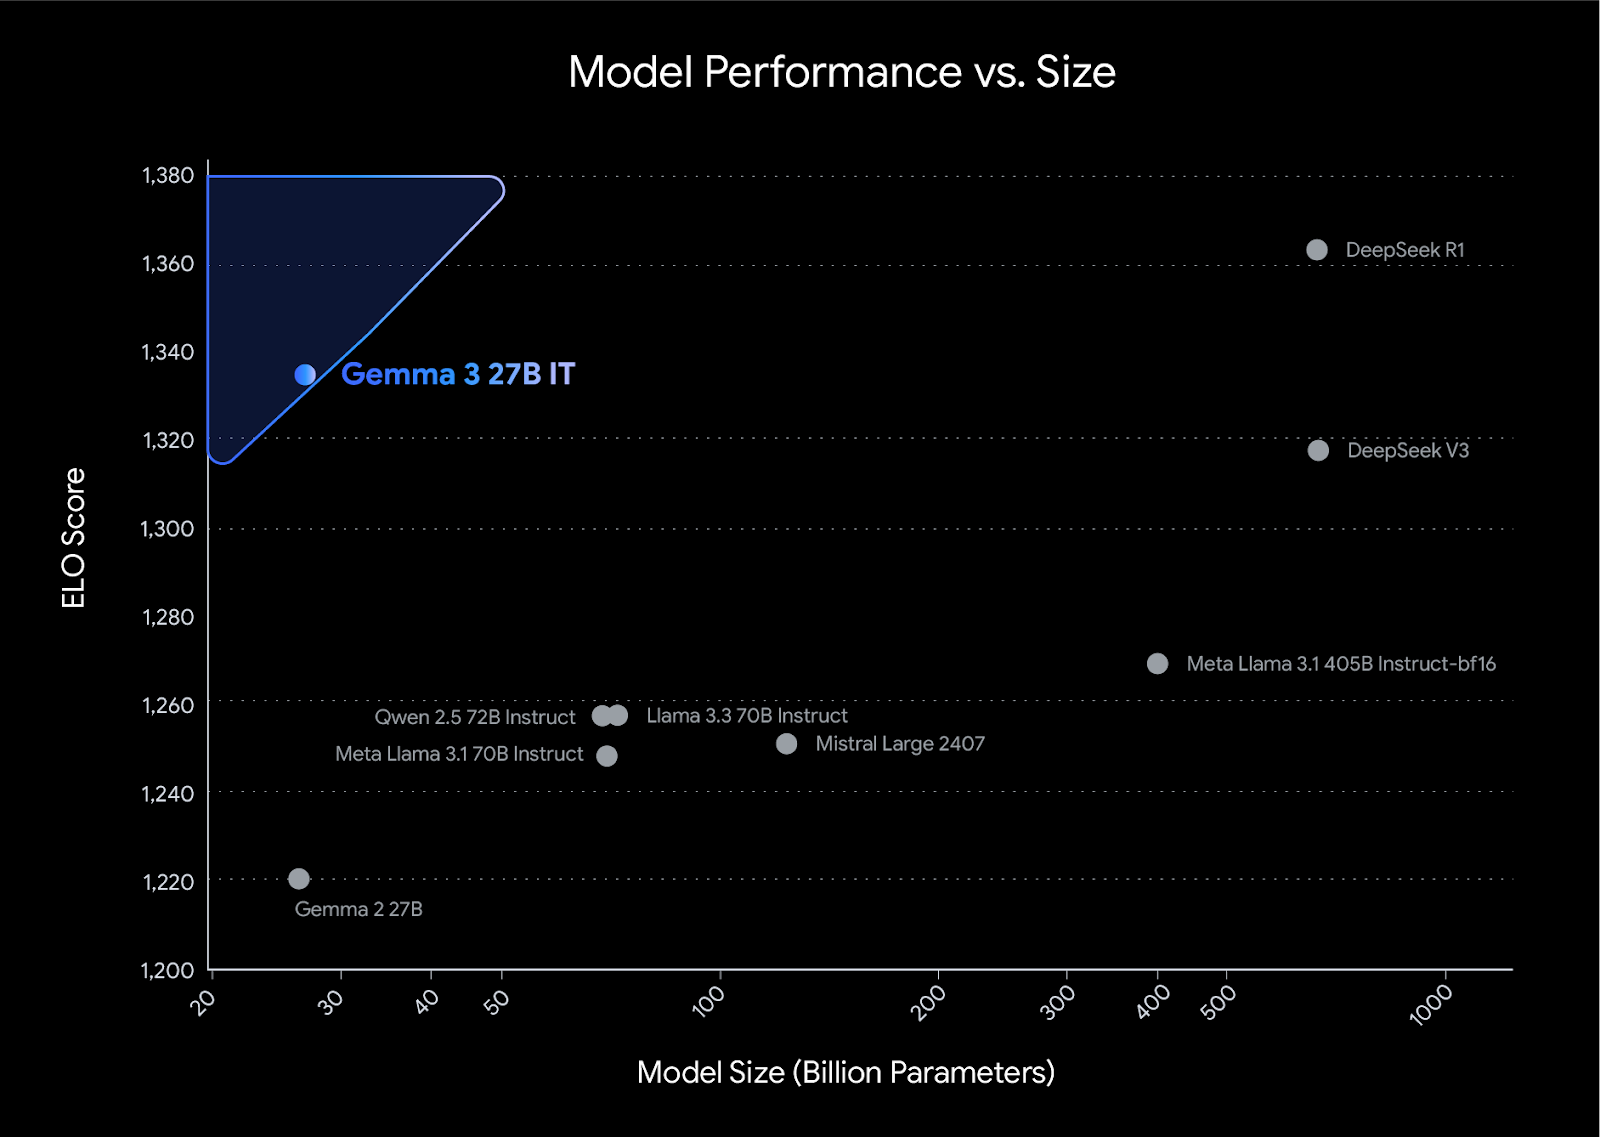
Sumber: Introducing Gemma 3
Dalam proyek ini, kita akan memuat Gemma 3 dari Kaggle dan mengambil data dari Hugging Face. Lalu, kita akan menggunakan pustaka Transformers dan TRL untuk melakukan fine-tuning pada model kita. Untuk perbandingan, kita akan menghasilkan respons sebelum dan sesudah fine-tuning.
Jika Anda ingin mempelajari cara menggunakan pustaka Unsloth untuk melakukan fine-tuning model Anda pada data penalaran, lihat panduan Fine-Tuning DeepSeek R1 (Reasoning Model).
Instal semua pustaka Python yang diperlukan, dan pastikan Anda memperbarui pustaka transformer.
%%capture
!pip install -U datasets
!pip install -U accelerate
!pip install -U peft
!pip install -U trl
!pip install -U bitsandbytes
!pip install git+https://github.com/huggingface/transformers@v4.49.0-Gemma-3
Masuk ke klien Hugging Face menggunakan kunci API Anda. Kunci API disimpan dengan aman di Kaggle secrets, dan kita akan mengekstrak serta menerapkannya ke klien Hugging Face.
from huggingface_hub import login
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()

hf_token = user_secrets.get_secret("HUGGINGFACE_TOKEN")
login(hf_token)Tambahkan model Gemma 3 4B IT ke notebook Kaggle dengan cara yang mirip saat Anda menambahkan dataset, dengan mengklik tombol “+ Add Input”.
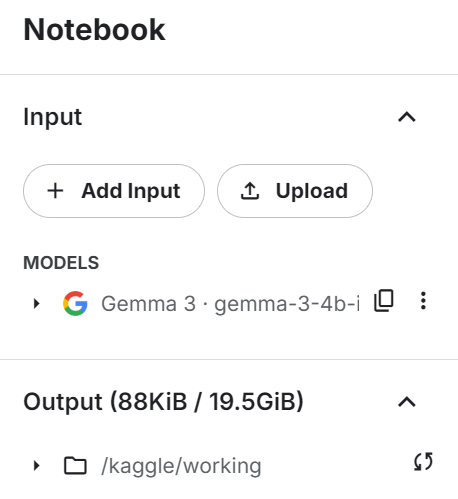
Muat model dan tokenizer menggunakan pustaka transformers. Pastikan model disetel ke device_map="auto" untuk memanfaatkan pengaturan GPU ganda secara efektif.
from transformers import AutoTokenizer, Gemma3ForConditionalGeneration

import torch

GEMMA_PATH = "/kaggle/input/gemma-3/transformers/gemma-3-4b-it/1"

model = Gemma3ForConditionalGeneration.from_pretrained(
    GEMMA_PATH, device_map="auto",attn_implementation='eager'
).eval()

tokenizer = AutoTokenizer.from_pretrained(GEMMA_PATH)Sebelum memuat dataset, kita akan membuat gaya prompt pelatihan dan menyediakan tiga placeholder yang akan kita isi dengan kolom dataset. Gaya prompt ini akan membantu kita menghasilkan teks penalaran.
train_prompt_style="""
Below is an instruction that describes a task, paired with an input that provides further context.
Write a response that appropriately completes the request.
Before answering, think carefully about the question and create a step-by-step chain of thoughts to ensure a logical and accurate response.

### Question:
{}

### Response:
<think>
{}
</think>
{}
"""
Selanjutnya, kita akan membuat fungsi pemformatan yang menggunakan kolom dari dataset dan menerapkannya ke gaya prompt pelatihan untuk membuat kolom "text". Pastikan Anda menambahkan token EOS di akhir respons.
def formatting_prompts_func(examples):
    inputs = examples["Open-ended Verifiable Question"]
    complex_cots = examples["Complex_CoT"]
    outputs = examples["Response"]
    texts = []
    for question, cot, response in zip(inputs, complex_cots, outputs):
        # Append the EOS token to the response if it's not already there
        if not response.endswith(tokenizer.eos_token):
            response += tokenizer.eos_token
        text = train_prompt_style.format(question, cot, response)
        texts.append(text)
    return {"text": texts}
Sekarang kita akan memuat dataset TheFinAI/Fino1_Reasoning_Path_FinQA, yaitu dataset penalaran keuangan berbasis FinQA yang ditingkatkan dengan jalur penalaran yang dihasilkan GPT-4o untuk tanya jawab keuangan terstruktur. Setelah itu, kita akan menerapkan fungsi pemformatan ke dataset dan membuat kolom teks baru yang dibentuk oleh gaya prompt.
from datasets import load_dataset
dataset = load_dataset("TheFinAI/Fino1_Reasoning_Path_FinQA", split = "train[0:500]",trust_remote_code=True)
dataset = dataset.map(formatting_prompts_func, batched = True,)
dataset["text"][0]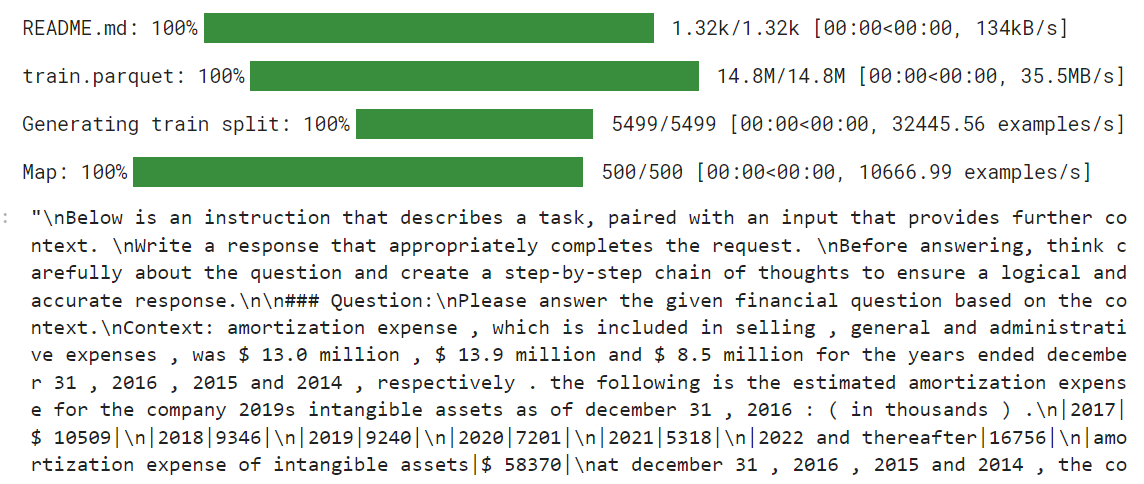
STF trainer baru tidak menerima tokenizer, jadi kita harus membuat pengolah data sendiri menggunakan tokenizer dan menyediakannya ke trainer nanti.
from transformers import DataCollatorForLanguageModeling

data_collator = DataCollatorForLanguageModeling(
    tokenizer=tokenizer,
    mlm=False  # we're doing causal LM, not masked LM
)Sebelum kita mulai melakukan fine-tuning model, kita akan menguji model asli untuk melihat seberapa baik ia menghasilkan respons. Kita akan membuat gaya prompt dengan dua placeholder, bukan tiga.
prompt_style = """Below is an instruction that describes a task, paired with an input that provides further context.
Write a response that appropriately completes the request.
Before answering, think carefully about the question and create a step-by-step chain of thoughts to ensure a logical and accurate response.

### Question:
{}

### Response:
<think>
{}
"""
Lalu, kita akan menerapkan gaya prompt ke pertanyaan, mengubahnya menjadi token, dan memberikannya ke model. Setelah itu, kita akan menghasilkan respons dan mengonversi token kembali menjadi teks.
question = dataset[0]['Open-ended Verifiable Question']


inputs = tokenizer(
    [prompt_style.format(question, "") + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
Responsnya singkat dan jauh dari akurat.
<think>

The question asks for the portion of the estimated amortization expense that will be recognized in 2017.
The provided table shows the estimated amortization expense for intangible assets for the years 2017, 2018, 2019, 2020, 2021, and 2022 and thereafter.
The amortization expense for 2017 is $10,509.
</think>
$10,509
Berikut jawaban dari dataset. Jawaban seharusnya berupa rasio, bukan jumlah.
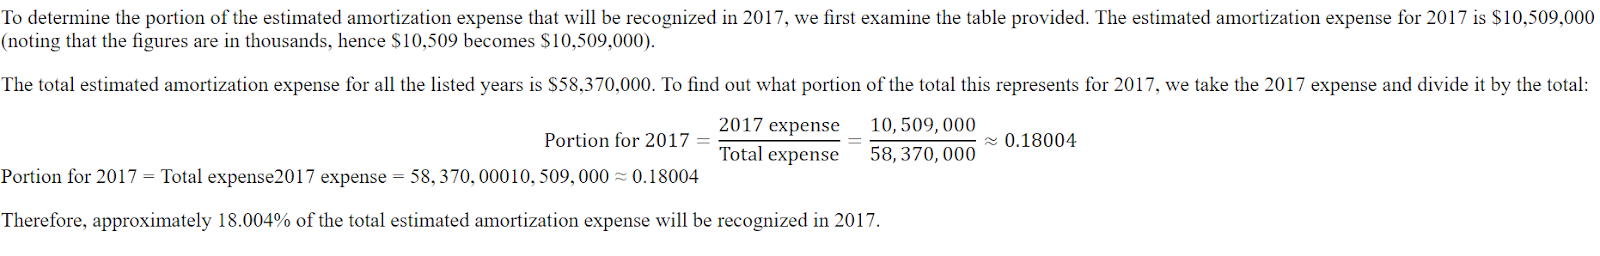
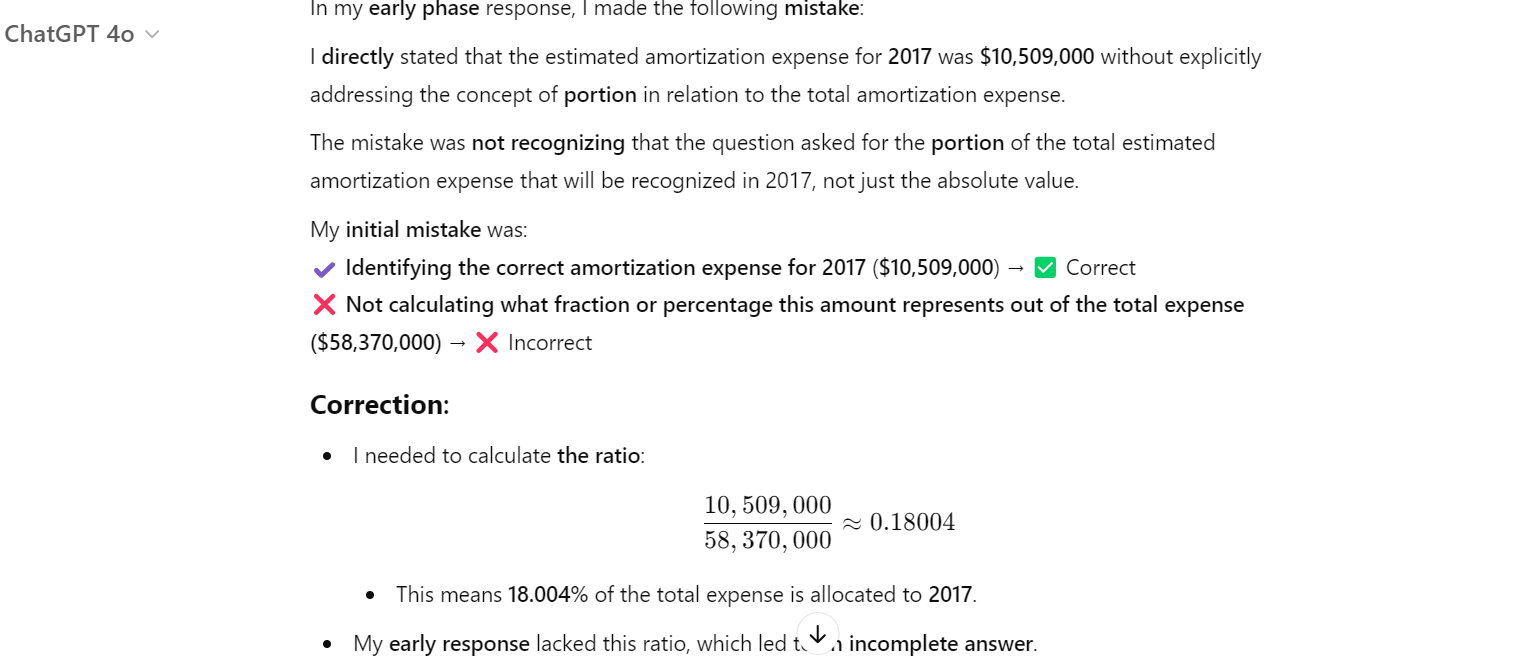
Bahkan ChatGPT juga salah, dan kami harus memintanya memperbaiki kesalahan. Setelah itu, ia memahami bahwa ada kesalahan dan memperbaikinya.
Sekarang kita akan memberikan dataset, model, pengolah data, argumen pelatihan, dan konfigurasi LoRA kepada SFTTrainer.
from trl import SFTTrainer
from transformers import TrainingArguments
from peft import LoraConfig

# LoRA Configuration
peft_config = LoraConfig(
    lora_alpha=16,                           # Scaling factor for LoRA
    lora_dropout=0.05,                       # Add slight dropout for regularization
    r=64,                                    # Rank of the LoRA update matrices
    bias="none",                             # No bias reparameterization
    task_type="CAUSAL_LM",                   # Task type: Causal Language Modeling
    target_modules=[
        "q_proj",
        "k_proj",
        "v_proj",
        "o_proj",
        "gate_proj",
        "up_proj",
        "down_proj",
    ],  # Target modules for LoRA
)


# Training Arguments
training_arguments = TrainingArguments(
    output_dir="output",
    per_device_train_batch_size=1,
    per_device_eval_batch_size=1,
    gradient_accumulation_steps=2,
    optim="paged_adamw_32bit",
    num_train_epochs=1,
    logging_steps=0.2,
    warmup_steps=10,
    logging_strategy="steps",
    learning_rate=2e-4,
    fp16=False,
    bf16=False,
    group_by_length=True,
    report_to="none"
)

# Initialize the Trainer
trainer = SFTTrainer(
    model=model,
    args=training_arguments,
    train_dataset=dataset,
    peft_config=peft_config,
    data_collator=data_collator,
)Bersihkan cache CUDA sebelum memulai proses pelatihan.
torch.cuda.empty_cache()
trainer_stats = trainer.train()
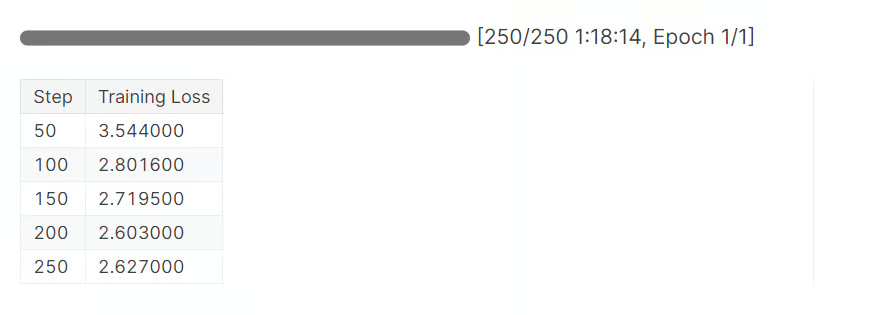
Dibutuhkan hampir 1 jam 20 menit untuk menyelesaikan 1 epoch. Seperti yang terlihat, loss berkurang secara bertahap.
Sekarang, mari uji model yang telah difine-tune dengan memberikan contoh pertanyaan seperti sebelumnya.
question = dataset[0]['Open-ended Verifiable Question']

inputs = tokenizer(
    [prompt_style.format(question, "") + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
Bagian penalarannya kini terperinci dan benar. Jawabannya juga akurat.
<think>


Alright, let's figure out what portion of the estimated amortization expense will be recognized in 2017. First, I need to see what the total estimated amortization expense is for the years 2017 through 2022. Looking at the numbers, it's $58,370.

Now, I need to find out how much of that is specifically for 2017. The table shows that the estimated amortization expense for 2017 is $10,509.

So, to find out what portion of the total expense is for 2017, I'll divide the 2017 expense by the total expense. That's $10,509 divided by $58,370.

Let's do the math: $10,509 divided by $58,370 gives me approximately 0.1805.

Now, to express this as a percentage, I'll multiply by 100. So, 0.1805 times 100 gives me 18.05%.

Therefore, about 18.05% of the estimated amortization expense for the years 2017 through 2022 will be recognized in 2017.

</think>
About 18.05% of the estimated amortization expense for the years 2017 through 2022 will be recognized in 2017.
Mari ajukan pertanyaan lain.
question = dataset[10]['Open-ended Verifiable Question']

inputs = tokenizer(
    [prompt_style.format(question, "") + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
Seperti yang kita lihat, kita telah berhasil melakukan fine-tuning model pada dataset baru. Kini model akurat dan mengikuti gaya penalaran serta jawaban.
<think>


Alright, let's figure out the total purchase price of Impella Cardiosystems. First, we know the purchase price was $45.1 million, but there's a contingent payment of $5.6 million that could be earned. So, we need to see if we can figure out how much of that $5.6 million is actually likely to be paid.

Now, the question mentions that the contingent payment is triggered by FDA approvals. Since we're dealing with a medical device, getting FDA clearance is pretty important. Let's assume that the FDA approval for the Impella 2.5 is a good sign that the contingent payments will be made.

Okay, so if we assume all the contingent payments are earned, we just need to add the $5.6 million to the original $45.1 million. Let's do the math: $45.1 million plus $5.6 million equals $50.7 million.

Hmm, let's double-check our work. We're adding $45.1 million to $5.6 million, which gives us $50.7 million. Yep, that seems right.

So, if we assume all the contingent payments are earned, the total purchase price of Impella Cardiosystems would be $50.7 million.

</think>
The total purchase price of Impella Cardiosystems, assuming all contingent consideration is earned, would be $50.7 million.
Fine-tuning sebuah model memerlukan keahlian, biaya, dan waktu. Dalam beberapa kasus, Anda mungkin hanya membutuhkan pipeline RAG yang lebih baik untuk memenuhi kebutuhan Anda. Silakan baca panduan RAG vs Fine-Tuning: A Comprehensive Tutorial with Practical Examples untuk memahami kebutuhan Anda.
Pertama, kita akan menyimpan model dan tokenizer secara lokal.
new_model_online = "kingabzpro/Gemma-3-4B-Fin-QA-Reasoning"
new_model_local = "Gemma-3-4B-Fin-QA-Reasoning"
model.save_pretrained(new_model_local) # Local saving
tokenizer.save_pretrained(new_model_local)
Selanjutnya, kita akan mendorong model ke Hugging Face Hub.
model.push_to_hub(new_model_online) # Online saving
tokenizer.push_to_hub(new_model_online) # Online saving
Proses ini akan terlebih dahulu membuat repositori model dan kemudian mengunggah semua bidang model, tokenizer, dan konfigurasi ke server jarak jauh.
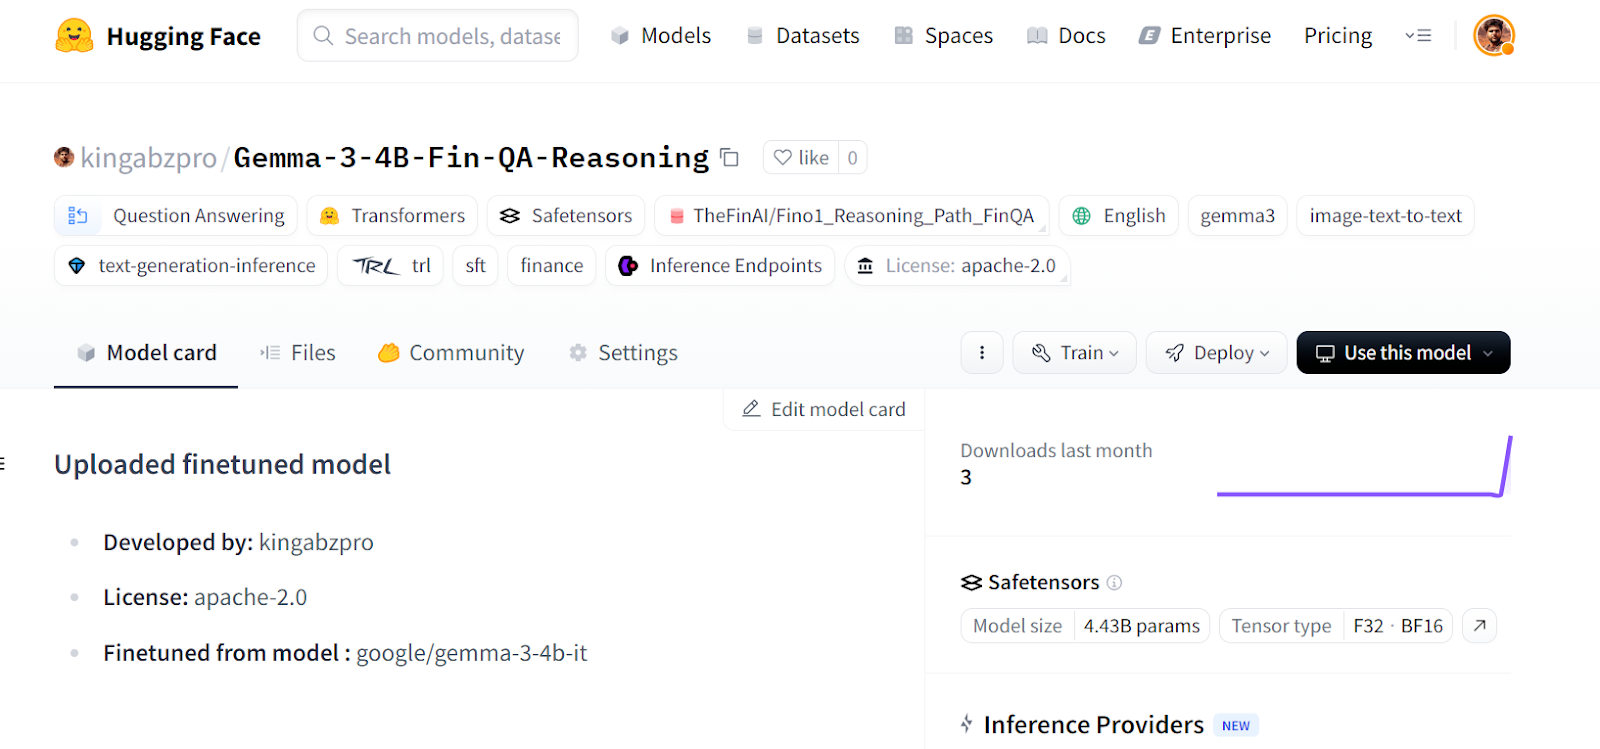
Sumber: kingabzpro/Gemma-3-4B-Fin-QA-Reasoning · Hugging Face
Jika Anda mengalami kendala saat menjalankan kode di atas, kami telah membuat notebook Kaggle yang dapat dikloning dan dijalankan oleh siapa saja untuk lebih memahami prosesnya.
Fine-tuning model Gemma 3 memiliki tantangan; Anda mungkin menemui masalah perangkat keras, masalah pustaka, fragmentasi memori, dan lainnya. Panduan ini memberikan implementasi yang lebih sederhana tentang bagaimana Anda dapat mengonversi model apa pun menjadi model penalaran dan menghindari masalah di masa depan terkait perangkat lunak dan perangkat keras.
Dalam tutorial ini, kita telah membahas fitur model Gemma 3 dan bagaimana kita dapat dengan mudah melakukan fine-tuning ke dataset penalaran menggunakan sumber daya GPU gratis yang tersedia di Kaggle.
Ikuti kursus Fine-tuning with Llama 3 untuk mengatasi tugas fine-tuning menggunakan TorchTune, dan pelajari teknik fine-tuning efisien seperti kuantisasi.
Kursus Teratas di DataCamp
Program
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt
blogs
Javier Canales Luna
14 mnt



