
Lộ trình
Phát triển các mô hình ngôn ngữ quy mô lớn
16 giờ
Dòng mô hình mã nguồn mở mới của Google, Gemma 3, đang nhanh chóng trở nên phổ biến nhờ hiệu năng ấn tượng, sánh ngang một số mô hình độc quyền mới nhất. Gemma 3 mang đến khả năng đa phương thức, kỹ năng suy luận nâng cao và hỗ trợ hơn 140 ngôn ngữ.
Trong bài hướng dẫn này, chúng ta sẽ khám phá các khả năng của Gemma 3 và học cách fine-tune nó trên bộ dữ liệu hỏi đáp suy luận tài chính. Quy trình fine-tune này sẽ cải thiện đáng kể độ chính xác của mô hình trong việc hiểu các câu hỏi tài chính phức tạp và giúp mô hình đưa ra câu trả lời chính xác, phù hợp với ngữ cảnh.
Bạn mới làm quen với fine-tune LLM? Đừng lo; chúng tôi đã chuẩn bị cho bạn! Hãy theo dõi bài hướng dẫn dễ hiểu Fine-Tuning LLMs: A Guide With Examples để tìm hiểu cách thức fine-tune hoạt động.
Bạn cũng có thể tham gia khóa học Introduction to LLMs in Python để hiểu thêm về cách LLM vận hành, cách fine-tune và cách đánh giá hiệu năng.
Hình ảnh bởi Tác giả
Họ mô hình mở Gemma là một bước tiến quan trọng trong việc đưa công nghệ AI tiên tiến đến với mọi người. Được xây dựng dựa trên nghiên cứu và công nghệ phía sau các mô hình Gemini 2.0, Gemma 3 mang lại hiệu năng hàng đầu trong khi vẫn nhẹ và hiệu quả.
Với kích thước từ 1 tỷ đến 27 tỷ tham số, Gemma 3 mang đến sự linh hoạt về yêu cầu phần cứng và hiệu năng, giúp việc tích hợp AI tiên tiến vào các ứng dụng thực tế dễ dàng hơn bao giờ hết.
Gemma 3 thiết lập tiêu chuẩn mới về hiệu năng trong phân khúc của mình, vượt trội so với các đối thủ như Llama3-405B, DeepSeek-V3 và o3-mini trong đánh giá ưu tiên của người dùng trên bảng xếp hạng LMArena. Thiết kế gọn nhẹ nhưng không đánh đổi sức mạnh, cho phép nhà phát triển đạt kết quả dẫn đầu ngành trong khi vẫn đảm bảo hiệu quả.
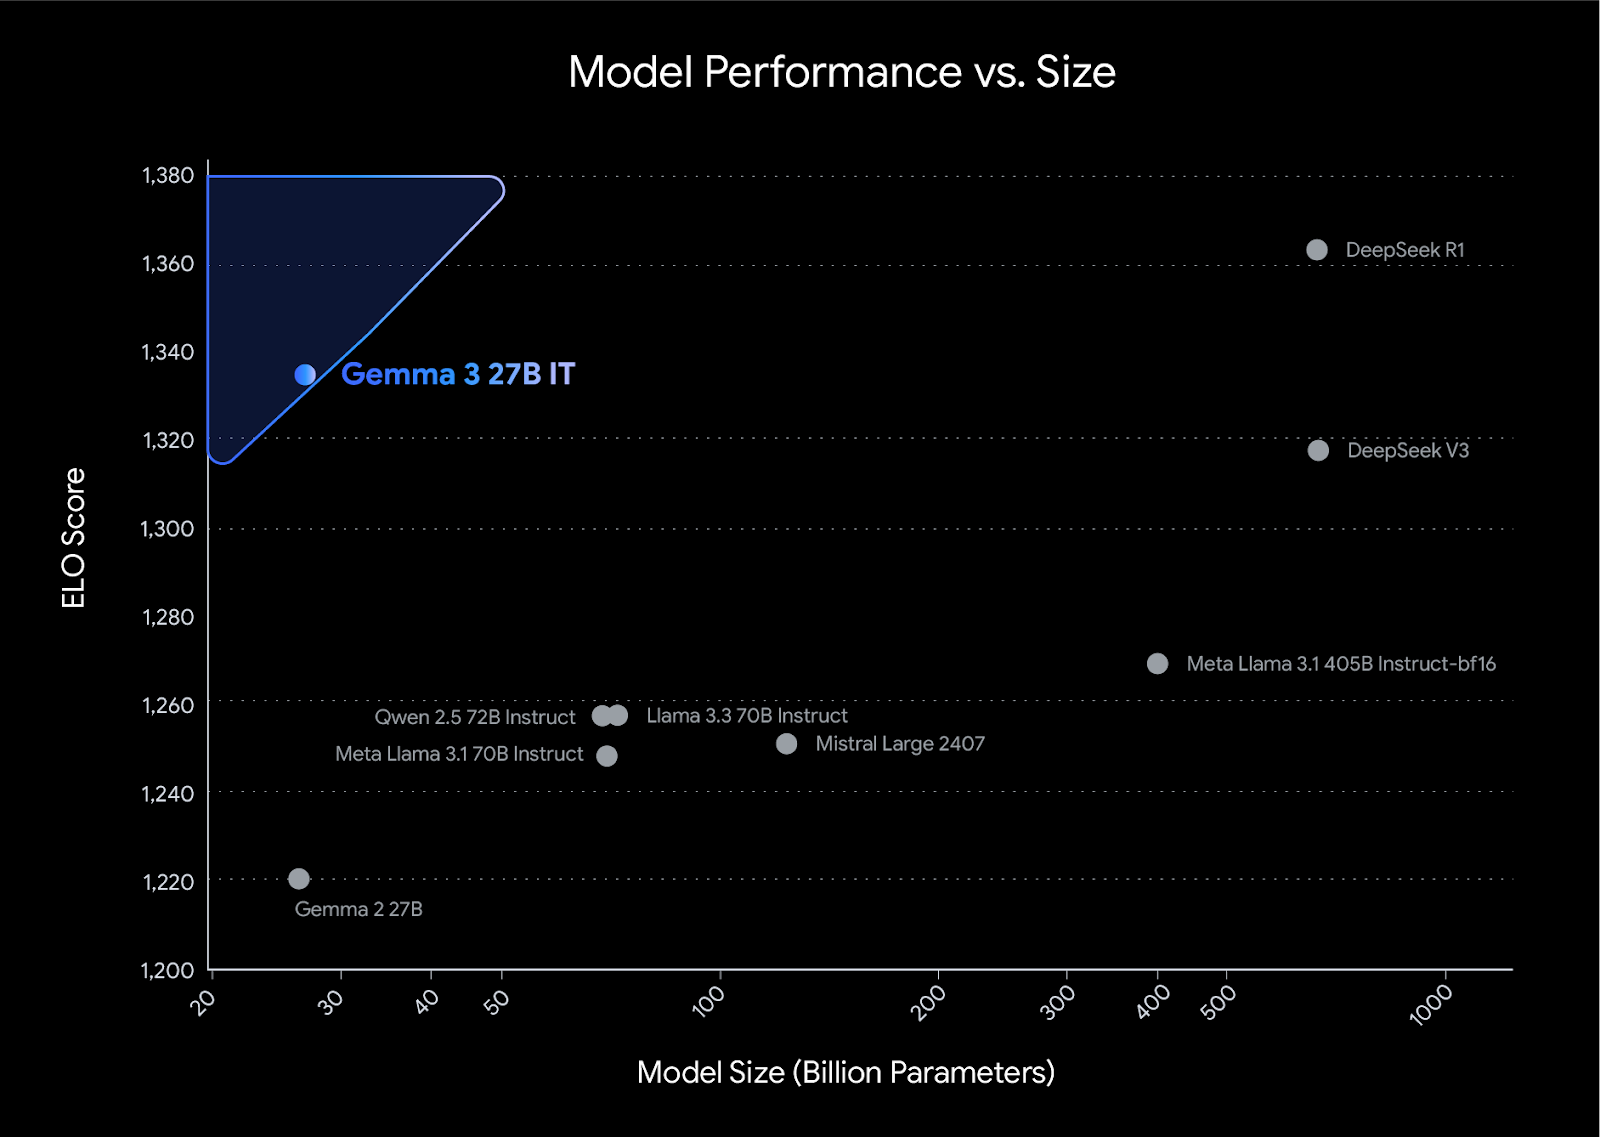
Nguồn: Introducing Gemma 3
Trong dự án này, chúng ta sẽ tải Gemma 3 từ Kaggle và truy xuất dữ liệu từ Hugging Face. Sau đó, chúng ta sẽ dùng thư viện Transformers và TRL để fine-tune mô hình. Để so sánh, chúng ta sẽ tạo phản hồi trước và sau khi fine-tune.
Nếu bạn muốn học cách dùng thư viện Unsloth để fine-tune mô hình trên dữ liệu suy luận, hãy xem hướng dẫn Fine-Tuning DeepSeek R1 (Reasoning Model).
Cài đặt tất cả thư viện Python cần thiết, đảm bảo bạn cập nhật thư viện transformer.
%%capture
!pip install -U datasets
!pip install -U accelerate
!pip install -U peft
!pip install -U trl
!pip install -U bitsandbytes
!pip install git+https://github.com/huggingface/transformers@v4.49.0-Gemma-3
Đăng nhập vào khách hàng Hugging Face bằng khóa API của bạn. Khóa API được lưu an toàn trong phần secrets của Kaggle, và chúng ta sẽ trích xuất rồi áp dụng nó cho khách hàng Hugging Face.
from huggingface_hub import login
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()

hf_token = user_secrets.get_secret("HUGGINGFACE_TOKEN")
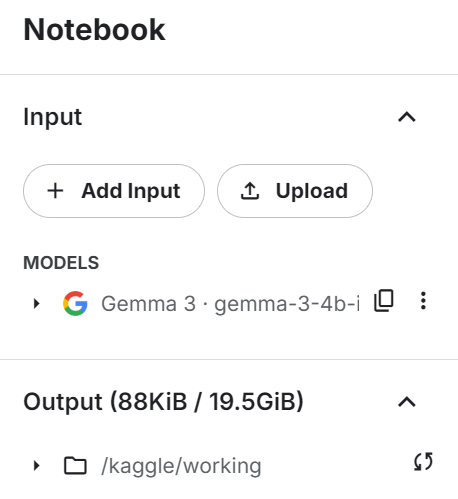
login(hf_token)Thêm mô hình Gemma 3 4B IT vào sổ tay Kaggle tương tự như cách bạn thêm bộ dữ liệu bằng cách nhấp nút “+ Add Input”.
Tải mô hình và tokenizer bằng thư viện transformers. Đảm bảo mô hình được đặt device_map="auto" để tận dụng hiệu quả thiết lập 2 GPU.
from transformers import AutoTokenizer, Gemma3ForConditionalGeneration

import torch

GEMMA_PATH = "/kaggle/input/gemma-3/transformers/gemma-3-4b-it/1"

model = Gemma3ForConditionalGeneration.from_pretrained(
    GEMMA_PATH, device_map="auto",attn_implementation='eager'
).eval()

tokenizer = AutoTokenizer.from_pretrained(GEMMA_PATH)Trước khi tải bộ dữ liệu, chúng ta sẽ tạo kiểu prompt huấn luyện và cung cấp ba chỗ trống để điền bằng các cột trong bộ dữ liệu. Kiểu prompt này sẽ giúp chúng ta tạo văn bản suy luận.
train_prompt_style="""
Below is an instruction that describes a task, paired with an input that provides further context.
Write a response that appropriately completes the request.
Before answering, think carefully about the question and create a step-by-step chain of thoughts to ensure a logical and accurate response.

### Question:
{}

### Response:
<think>
{}
</think>
{}
"""
Tiếp theo, chúng ta sẽ tạo hàm định dạng, dùng các cột từ bộ dữ liệu và áp dụng chúng vào kiểu prompt huấn luyện để tạo cột "text". Hãy đảm bảo bạn thêm token EOS vào cuối phần phản hồi.
def formatting_prompts_func(examples):
    inputs = examples["Open-ended Verifiable Question"]
    complex_cots = examples["Complex_CoT"]
    outputs = examples["Response"]
    texts = []
    for question, cot, response in zip(inputs, complex_cots, outputs):
        # Append the EOS token to the response if it's not already there
        if not response.endswith(tokenizer.eos_token):
            response += tokenizer.eos_token
        text = train_prompt_style.format(question, cot, response)
        texts.append(text)
    return {"text": texts}
Bây giờ, chúng ta sẽ tải bộ dữ liệu TheFinAI/Fino1_Reasoning_Path_FinQA, đây là bộ dữ liệu suy luận tài chính dựa trên FinQA, được tăng cường bằng các đường dẫn suy luận do GPT-4o tạo ra để trả lời câu hỏi tài chính có cấu trúc. Sau đó, chúng ta sẽ áp dụng hàm định dạng cho bộ dữ liệu và tạo cột văn bản mới theo kiểu prompt.
from datasets import load_dataset
dataset = load_dataset("TheFinAI/Fino1_Reasoning_Path_FinQA", split = "train[0:500]",trust_remote_code=True)
dataset = dataset.map(formatting_prompts_func, batched = True,)
dataset["text"][0]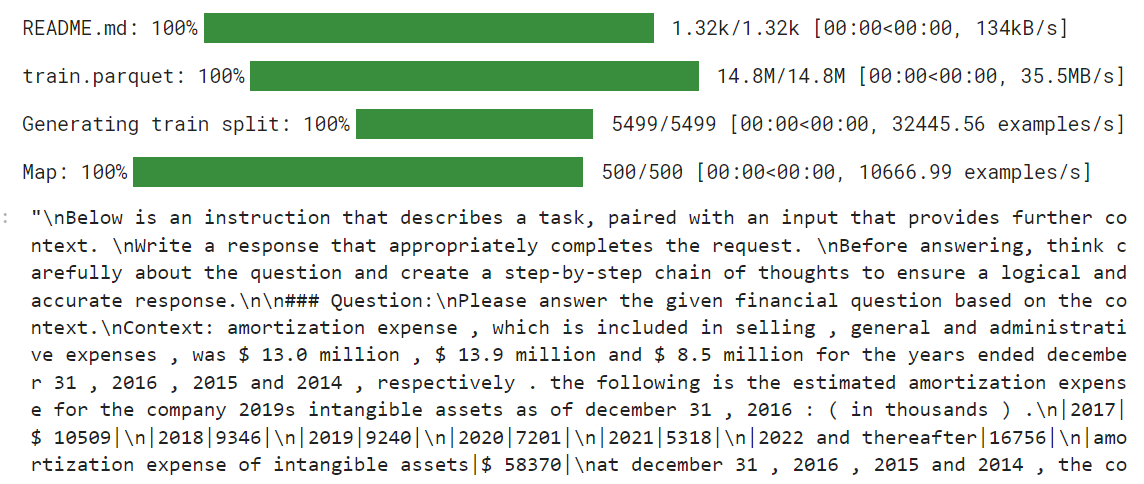
Trình huấn luyện STF mới không chấp nhận tokenizer, nên chúng ta phải tự tạo bộ gom dữ liệu bằng tokenizer và cung cấp cho trainer sau.
from transformers import DataCollatorForLanguageModeling

data_collator = DataCollatorForLanguageModeling(
    tokenizer=tokenizer,
    mlm=False  # we're doing causal LM, not masked LM
)Trước khi bắt đầu fine-tune mô hình, chúng ta sẽ kiểm thử mô hình gốc để xem khả năng tạo phản hồi của nó. Chúng ta sẽ tạo kiểu prompt với hai chỗ trống thay vì ba.
prompt_style = """Below is an instruction that describes a task, paired with an input that provides further context.
Write a response that appropriately completes the request.
Before answering, think carefully about the question and create a step-by-step chain of thoughts to ensure a logical and accurate response.

### Question:
{}

### Response:
<think>
{}
"""
Sau đó, chúng ta sẽ áp dụng kiểu prompt cho câu hỏi, chuyển thành token và đưa vào mô hình. Tiếp theo, chúng ta sẽ sinh phản hồi và chuyển các token trở lại văn bản.
question = dataset[0]['Open-ended Verifiable Question']


inputs = tokenizer(
    [prompt_style.format(question, "") + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
Phản hồi ngắn và khá thiếu chính xác.
<think>

The question asks for the portion of the estimated amortization expense that will be recognized in 2017.
The provided table shows the estimated amortization expense for intangible assets for the years 2017, 2018, 2019, 2020, 2021, and 2022 and thereafter.
The amortization expense for 2017 is $10,509.
</think>
$10,509
Đây là câu trả lời từ bộ dữ liệu. Câu trả lời phải là một tỷ lệ, không phải số tiền.
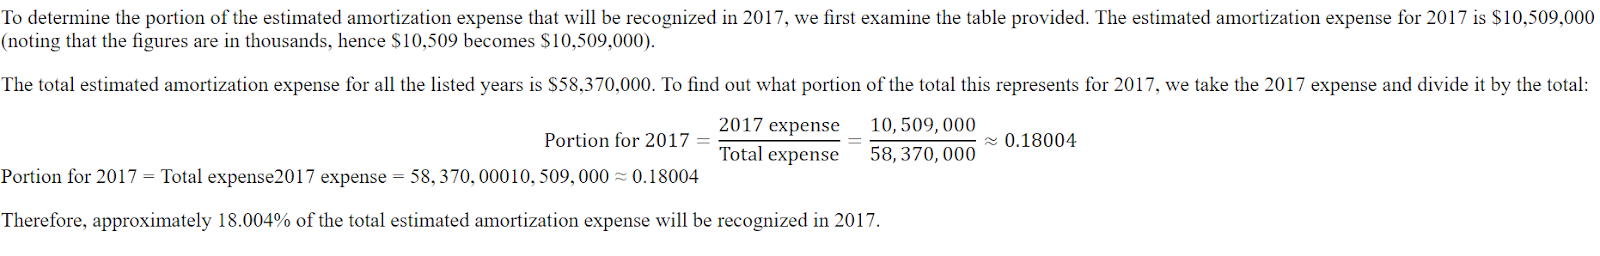
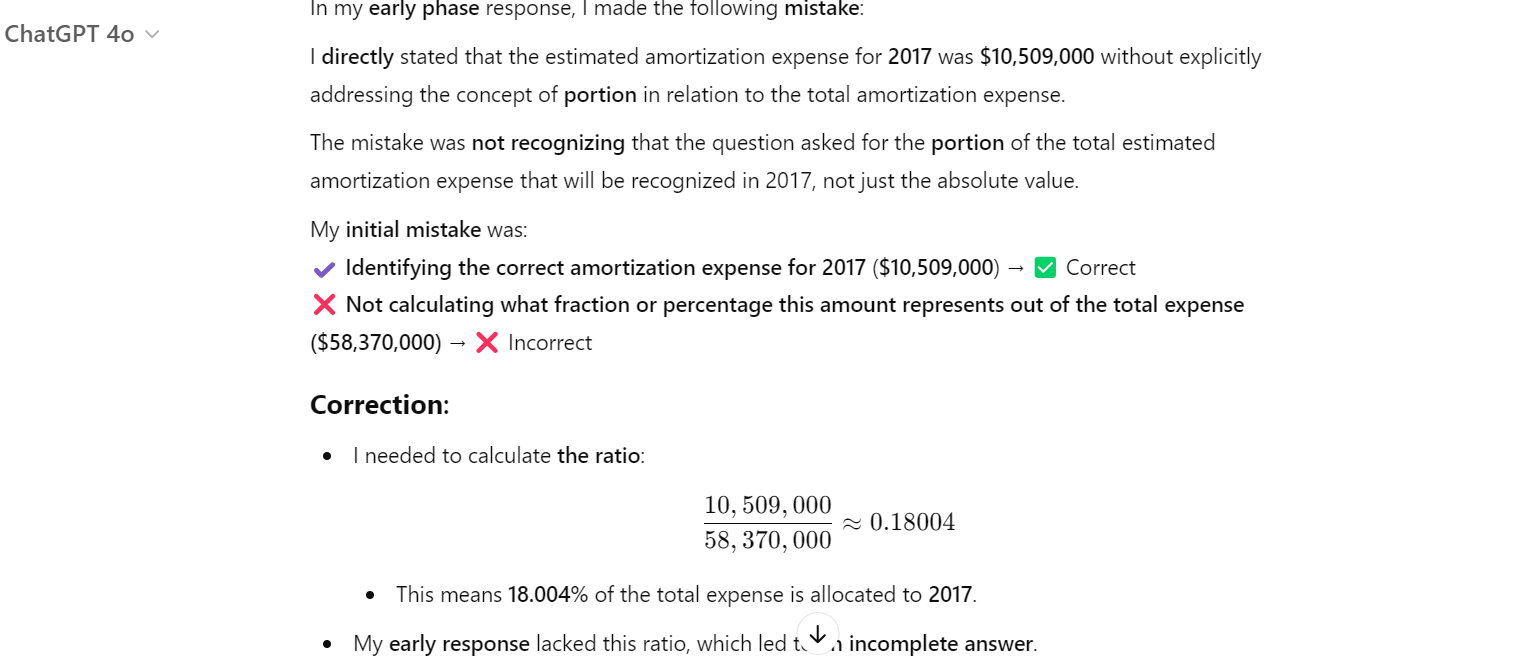
Ngay cả ChatGPT cũng trả lời sai, và chúng tôi phải yêu cầu sửa lỗi. Sau đó, nó nhận ra sai sót và đã chỉnh lại.
Giờ chúng ta sẽ cung cấp bộ dữ liệu, mô hình, bộ gom dữ liệu, tham số huấn luyện và cấu hình LoRA cho SFTTrainer.
from trl import SFTTrainer
from transformers import TrainingArguments
from peft import LoraConfig

# LoRA Configuration
peft_config = LoraConfig(
    lora_alpha=16,                           # Scaling factor for LoRA
    lora_dropout=0.05,                       # Add slight dropout for regularization
    r=64,                                    # Rank of the LoRA update matrices
    bias="none",                             # No bias reparameterization
    task_type="CAUSAL_LM",                   # Task type: Causal Language Modeling
    target_modules=[
        "q_proj",
        "k_proj",
        "v_proj",
        "o_proj",
        "gate_proj",
        "up_proj",
        "down_proj",
    ],  # Target modules for LoRA
)


# Training Arguments
training_arguments = TrainingArguments(
    output_dir="output",
    per_device_train_batch_size=1,
    per_device_eval_batch_size=1,
    gradient_accumulation_steps=2,
    optim="paged_adamw_32bit",
    num_train_epochs=1,
    logging_steps=0.2,
    warmup_steps=10,
    logging_strategy="steps",
    learning_rate=2e-4,
    fp16=False,
    bf16=False,
    group_by_length=True,
    report_to="none"
)

# Initialize the Trainer
trainer = SFTTrainer(
    model=model,
    args=training_arguments,
    train_dataset=dataset,
    peft_config=peft_config,
    data_collator=data_collator,
)Xóa bộ nhớ đệm CUDA trước khi bắt đầu quá trình huấn luyện.
torch.cuda.empty_cache()
trainer_stats = trainer.train()
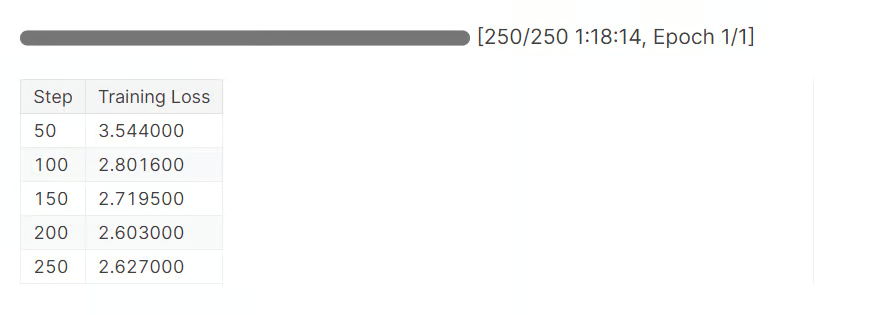
Mất gần 1 giờ 20 phút để hoàn thành 1 epoch. Như có thể thấy, loss đã giảm dần.
Bây giờ, hãy kiểm thử mô hình đã fine-tune bằng cách cung cấp một câu hỏi mẫu như trước.
question = dataset[0]['Open-ended Verifiable Question']

inputs = tokenizer(
    [prompt_style.format(question, "") + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
Phần suy luận giờ đã chi tiết và đúng. Câu trả lời cũng chính xác.
<think>


Alright, let's figure out what portion of the estimated amortization expense will be recognized in 2017. First, I need to see what the total estimated amortization expense is for the years 2017 through 2022. Looking at the numbers, it's $58,370.

Now, I need to find out how much of that is specifically for 2017. The table shows that the estimated amortization expense for 2017 is $10,509.

So, to find out what portion of the total expense is for 2017, I'll divide the 2017 expense by the total expense. That's $10,509 divided by $58,370.

Let's do the math: $10,509 divided by $58,370 gives me approximately 0.1805.

Now, to express this as a percentage, I'll multiply by 100. So, 0.1805 times 100 gives me 18.05%.

Therefore, about 18.05% of the estimated amortization expense for the years 2017 through 2022 will be recognized in 2017.

</think>
About 18.05% of the estimated amortization expense for the years 2017 through 2022 will be recognized in 2017.
Hãy hỏi một câu khác.
question = dataset[10]['Open-ended Verifiable Question']

inputs = tokenizer(
    [prompt_style.format(question, "") + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
Như có thể thấy, chúng ta đã fine-tune mô hình thành công trên bộ dữ liệu mới. Mô hình giờ chính xác và tuân theo phong cách suy luận và trả lời.
<think>


Alright, let's figure out the total purchase price of Impella Cardiosystems. First, we know the purchase price was $45.1 million, but there's a contingent payment of $5.6 million that could be earned. So, we need to see if we can figure out how much of that $5.6 million is actually likely to be paid.

Now, the question mentions that the contingent payment is triggered by FDA approvals. Since we're dealing with a medical device, getting FDA clearance is pretty important. Let's assume that the FDA approval for the Impella 2.5 is a good sign that the contingent payments will be made.

Okay, so if we assume all the contingent payments are earned, we just need to add the $5.6 million to the original $45.1 million. Let's do the math: $45.1 million plus $5.6 million equals $50.7 million.

Hmm, let's double-check our work. We're adding $45.1 million to $5.6 million, which gives us $50.7 million. Yep, that seems right.

So, if we assume all the contingent payments are earned, the total purchase price of Impella Cardiosystems would be $50.7 million.

</think>
The total purchase price of Impella Cardiosystems, assuming all contingent consideration is earned, would be $50.7 million.
Fine-tune một mô hình đòi hỏi chuyên môn, chi phí và thời gian. Trong một số trường hợp, bạn chỉ cần một pipeline RAG tốt hơn để đáp ứng nhu cầu. Vui lòng đọc hướng dẫn RAG vs Fine-Tuning: A Comprehensive Tutorial with Practical Examples để hiểu rõ yêu cầu của bạn.
Đầu tiên, chúng ta sẽ lưu mô hình và tokenizer cục bộ.
new_model_online = "kingabzpro/Gemma-3-4B-Fin-QA-Reasoning"
new_model_local = "Gemma-3-4B-Fin-QA-Reasoning"
model.save_pretrained(new_model_local) # Local saving
tokenizer.save_pretrained(new_model_local)
Sau đó, chúng ta sẽ đẩy mô hình lên Hugging Face Hub.
model.push_to_hub(new_model_online) # Online saving
tokenizer.push_to_hub(new_model_online) # Online saving
Quy trình này sẽ tạo kho lưu trữ mô hình trước, sau đó đẩy toàn bộ mô hình, tokenizer và các trường cấu hình lên máy chủ từ xa.
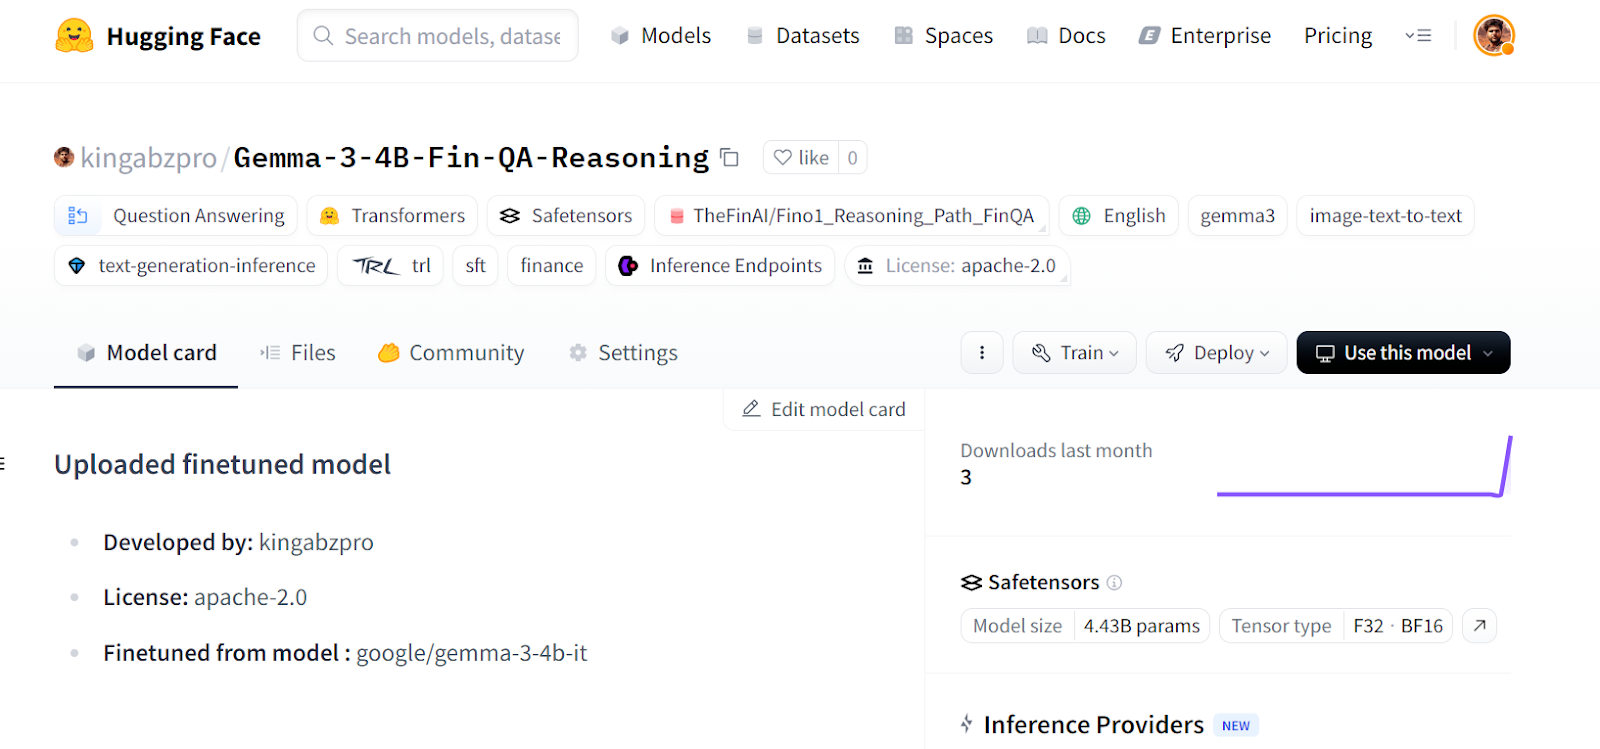
Nguồn: kingabzpro/Gemma-3-4B-Fin-QA-Reasoning · Hugging Face
Nếu bạn gặp vấn đề khi chạy đoạn mã trên, chúng tôi đã tạo một sổ tay Kaggle để mọi người có thể nhân bản và tự chạy nhằm hiểu quy trình tốt hơn.
Fine-tune mô hình Gemma 3 đi kèm nhiều thách thức; bạn có thể gặp vấn đề phần cứng, thư viện, phân mảnh bộ nhớ, và hơn thế nữa. Hướng dẫn này cung cấp cách triển khai đơn giản hơn để bạn chuyển đổi bất kỳ mô hình nào thành mô hình suy luận và tránh các vấn đề tương lai liên quan tới phần mềm và phần cứng.
Trong bài hướng dẫn này, chúng ta đã đề cập các tính năng của mô hình Gemma 3 và cách có thể dễ dàng fine-tune nó với bộ dữ liệu suy luận bằng nguồn GPU miễn phí có trên Kaggle.
Hãy tham gia khóa học Fine-tuning with Llama 3 để giải quyết các tác vụ fine-tune bằng TorchTune và học các kỹ thuật fine-tune hiệu quả như lượng hóa.
Khóa học hàng đầu trên DataCamp
Lộ trình
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
