
Last chance! 50% off DataCamp Premium
Sale ends in
Google'ın yeni açık kaynaklı model ailesi, Gemma 3, son derece etkileyici performansı sayesinde hızla popülerleşiyor ve en yeni kapalı kaynak modellere bile yaklaşan sonuçlar veriyor. Gemma 3, çok kipli (multimodal) yetenekler, gelişmiş muhakeme becerileri sunuyor ve 140’tan fazla dili destekliyor.
Bu eğitimde Gemma 3'ün yeteneklerini inceleyecek ve onu finansal muhakeme soru-cevap veri kümesi üzerinde nasıl ince ayarlayacağımızı öğreneceğiz. Bu ince ayar süreci, modelin karmaşık finansal soruları anlama doğruluğunu belirgin biçimde artıracak ve bağlama uygun, isabetli yanıtlar üretmesini sağlayacaktır.
LLM’leri ince ayarlamada yeni misiniz? Endişelenmeyin; yardımcı oluyoruz! Kolay anlaşılır eğitimimiz olan LLM’lerin İnce Ayarı: Örneklerle Rehber bölümünü izleyerek ince ayarın nasıl çalıştığını öğrenin.
Ayrıca Python ile LLM’lere Giriş kursunu alarak LLM’lerin nasıl çalıştığını, nasıl ince ayarlandıklarını ve performanslarının nasıl değerlendirildiğini öğrenebilirsiniz.
Görsel: Yazar
Açık model ailesi Gemma, en son yapay zekâ teknolojisini herkes için erişilebilir kılma yolunda önemli bir ilerlemeyi temsil ediyor. Gemini 2.0 modellerinin araştırma ve teknolojisi üzerine inşa edilen Gemma 3, hafif ve verimli kalırken en güncel performansı sunuyor.
1 milyardan 27 milyar parametreye kadar uzanan boyut seçenekleriyle Gemma 3, donanım ve performans gereksinimlerinde esneklik sağlayarak ileri düzey yapay zekâyı gerçek dünya uygulamalarına entegre etmeyi her zamankinden kolay hale getiriyor.
Gemma 3, LMArena lider panosundaki insan tercih değerlendirmelerinde Llama3-405B, DeepSeek-V3 ve o3-mini gibi rakiplerini geride bırakarak kendi sınıfında yeni bir performans ölçütü belirliyor. Hafif tasarımı gücünden ödün vermiyor; geliştiricilerin verimliliği korurken sektörde lider sonuçlar elde etmesini sağlıyor.
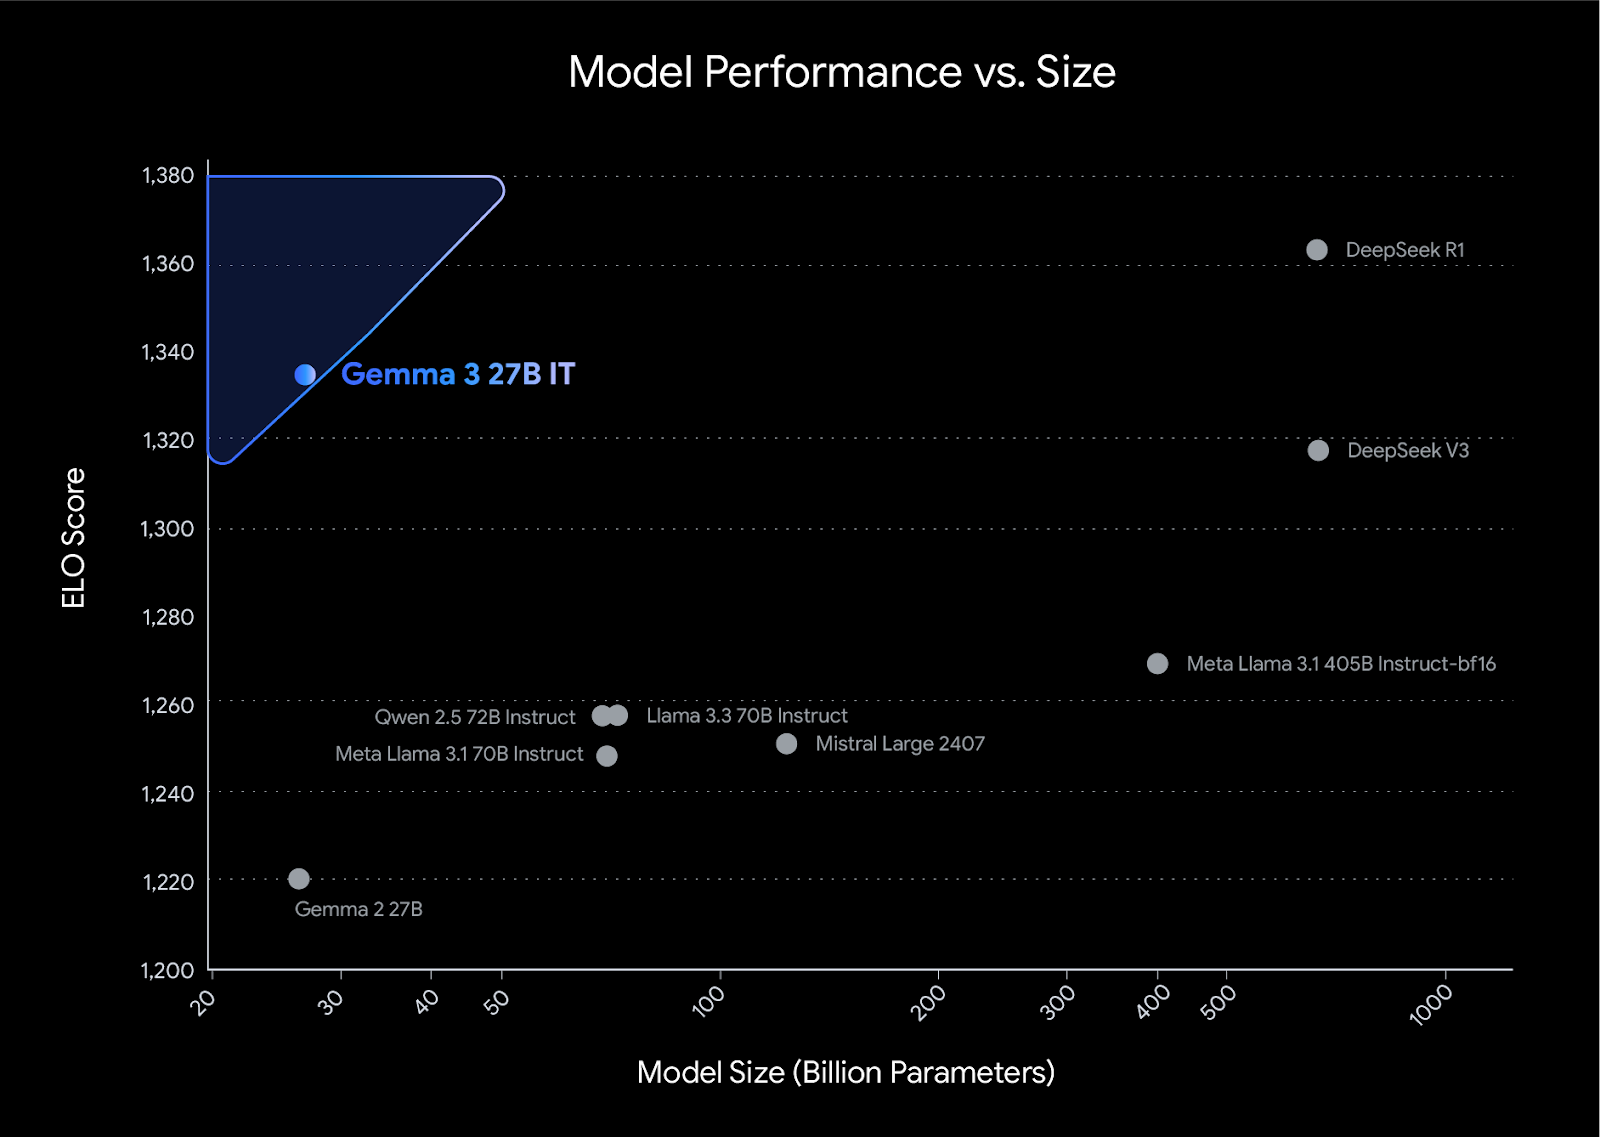
Kaynak: Gemma 3 Tanıtımı
Bu projede Gemma 3’ü Kaggle’dan yükleyecek ve verileri Hugging Face’ten alacağız. Ardından Transformers ve TRL kütüphanelerini kullanarak modelimizi ince ayarlayacağız. Karşılaştırma için ince ayardan önce ve sonra yanıt üreteceğiz.
Muhakeme verisi üzerinde modelinizi Unsloth kütüphanesiyle nasıl ince ayarlayacağınızı öğrenmek isterseniz DeepSeek R1 (Muhakeme Modeli) İnce Ayarı rehberine göz atın.
Gerekli tüm Python kütüphanelerini yükleyin ve transformer kütüphanesini güncellediğinizden emin olun.
%%capture
!pip install -U datasets
!pip install -U accelerate
!pip install -U peft
!pip install -U trl
!pip install -U bitsandbytes
!pip install git+https://github.com/huggingface/transformers@v4.49.0-Gemma-3
API anahtarınızı kullanarak Hugging Face istemcisine giriş yapın. API anahtarı Kaggle secrets içinde güvenle saklanır; onu çıkarıp Hugging Face istemcisine uygulayacağız.
from huggingface_hub import login
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()

hf_token = user_secrets.get_secret("HUGGINGFACE_TOKEN")
login(hf_token)Gemma 3 4B IT modelini, veri kümesini eklerken yaptığınız gibi “+ Girdi Ekle” düğmesine tıklayarak Kaggle defterine ekleyin.
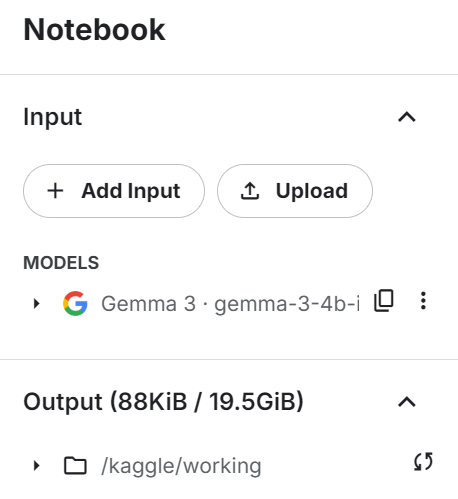
Modeli ve belirteçleyiciyi transformers kütüphanesiyle yükleyin. Çift GPU kurulumunu etkin biçimde kullanmak için modelin device_map="auto" olarak ayarlandığından emin olun.
from transformers import AutoTokenizer, Gemma3ForConditionalGeneration

import torch

GEMMA_PATH = "/kaggle/input/gemma-3/transformers/gemma-3-4b-it/1"

model = Gemma3ForConditionalGeneration.from_pretrained(
    GEMMA_PATH, device_map="auto",attn_implementation='eager'
).eval()

tokenizer = AutoTokenizer.from_pretrained(GEMMA_PATH)Veri kümesini yüklemeden önce eğitim istemi (prompt) stilini oluşturacak ve veri kümesi sütunlarıyla dolduracağımız üç yer tutucu sağlayacağız. Bu istem stili, muhakeme metni üretmemize yardımcı olacak.
train_prompt_style="""
Below is an instruction that describes a task, paired with an input that provides further context.
Write a response that appropriately completes the request.
Before answering, think carefully about the question and create a step-by-step chain of thoughts to ensure a logical and accurate response.

### Question:
{}

### Response:
<think>
{}
</think>
{}
"""
Ardından, veri kümesindeki sütunları kullanan ve bunları eğitim istemi stiline uygulayarak "text" sütununu oluşturan biçimlendirme işlevini yazacağız. Yanıtın sonuna EOS belirteci eklediğinizden emin olun.
def formatting_prompts_func(examples):
    inputs = examples["Open-ended Verifiable Question"]
    complex_cots = examples["Complex_CoT"]
    outputs = examples["Response"]
    texts = []
    for question, cot, response in zip(inputs, complex_cots, outputs):
        # Append the EOS token to the response if it's not already there
        if not response.endswith(tokenizer.eos_token):
            response += tokenizer.eos_token
        text = train_prompt_style.format(question, cot, response)
        texts.append(text)
    return {"text": texts}
Şimdi, FinQA tabanlı finansal muhakeme veri kümesi olan ve yapılandırılmış finansal soru-cevap için GPT-4o ile üretilmiş muhakeme yollarıyla zenginleştirilmiş TheFinAI/Fino1_Reasoning_Path_FinQA veri kümesini yükleyeceğiz. Sonrasında biçimlendirme işlevini veri kümesine uygulayarak, istem stiliyle şekillenen yeni metin sütununu oluşturacağız.
from datasets import load_dataset
dataset = load_dataset("TheFinAI/Fino1_Reasoning_Path_FinQA", split = "train[0:500]",trust_remote_code=True)
dataset = dataset.map(formatting_prompts_func, batched = True,)
dataset["text"][0]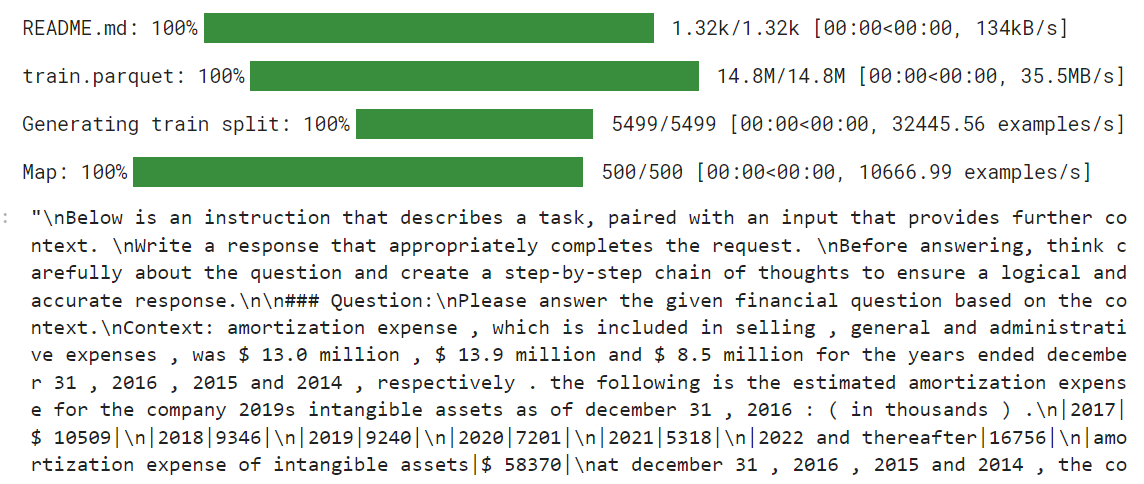
Yeni STF eğiticisi belirteçleyicileri kabul etmiyor; bu nedenle veri koleksiyonumuzu belirteçleyiciyle oluşturup sonrasında eğiticiye sağlamamız gerekiyor.
from transformers import DataCollatorForLanguageModeling

data_collator = DataCollatorForLanguageModeling(
    tokenizer=tokenizer,
    mlm=False  # we're doing causal LM, not masked LM
)Modele ince ayar yapmaya başlamadan önce, özgün modelimizin yanıt üretmede ne kadar iyi olduğunu görmek için test edeceğiz. Üç yer tutucu yerine iki yer tutuculu istem stili oluşturacağız.
prompt_style = """Below is an instruction that describes a task, paired with an input that provides further context.
Write a response that appropriately completes the request.
Before answering, think carefully about the question and create a step-by-step chain of thoughts to ensure a logical and accurate response.

### Question:
{}

### Response:
<think>
{}
"""
Sonra, istem stilini soruya uygulayıp belirteçlere dönüştürecek ve modeli besleyeceğiz. Ardından yanıtı üretecek ve belirteçleri yeniden metne çevireceğiz.
question = dataset[0]['Open-ended Verifiable Question']


inputs = tokenizer(
    [prompt_style.format(question, "") + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
Yanıt kısa ve doğruluktan uzak.
<think>

The question asks for the portion of the estimated amortization expense that will be recognized in 2017.
The provided table shows the estimated amortization expense for intangible assets for the years 2017, 2018, 2019, 2020, 2021, and 2022 and thereafter.
The amortization expense for 2017 is $10,509.
</think>
$10,509
Veri kümesindeki yanıt burada. Yanıtın tutar değil, oran olması gerekir.
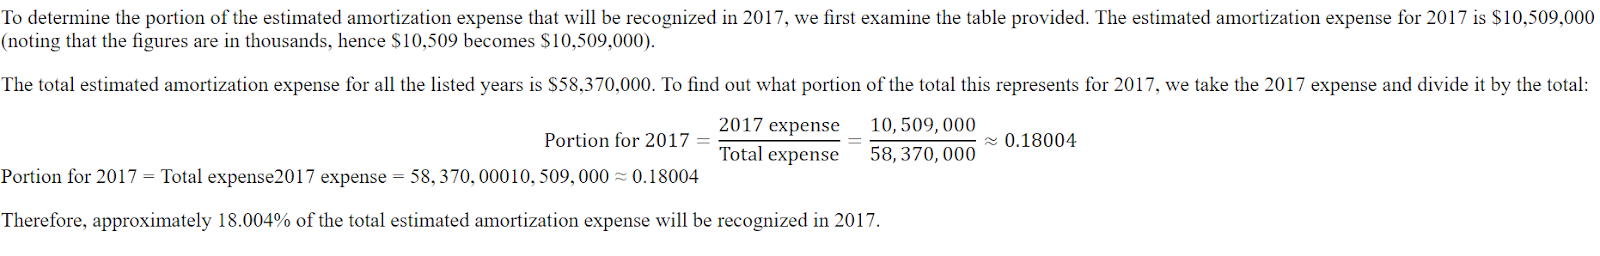
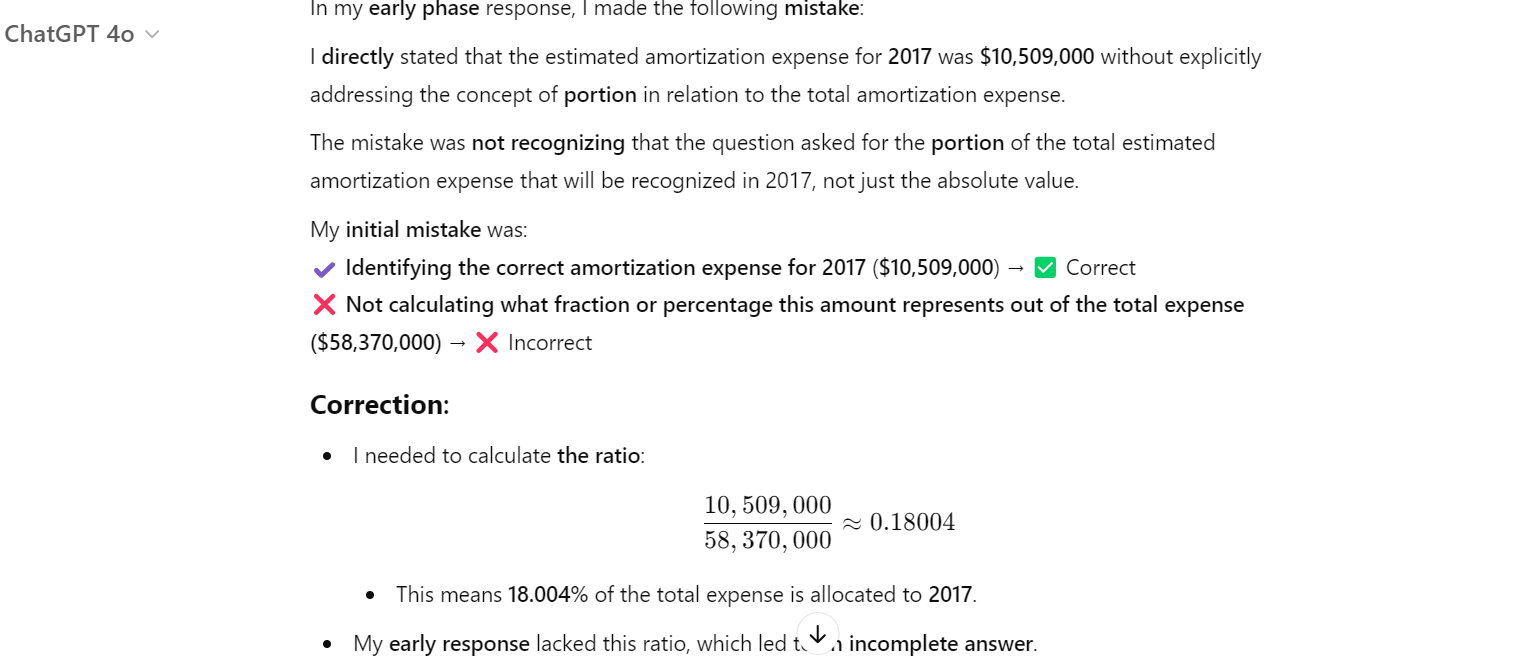
ChatGPT bile yanlış yaptı ve hatayı düzeltmesini istemek zorunda kaldık. Sonrasında hatasını anladı ve düzeltti.
Şimdi veri kümesini, modeli, veri koleksiyonunu, eğitim argümanlarını ve LoRA yapılandırmasını SFTTrainer’a sağlayacağız.
from trl import SFTTrainer
from transformers import TrainingArguments
from peft import LoraConfig

# LoRA Configuration
peft_config = LoraConfig(
    lora_alpha=16,                           # Scaling factor for LoRA
    lora_dropout=0.05,                       # Add slight dropout for regularization
    r=64,                                    # Rank of the LoRA update matrices
    bias="none",                             # No bias reparameterization
    task_type="CAUSAL_LM",                   # Task type: Causal Language Modeling
    target_modules=[
        "q_proj",
        "k_proj",
        "v_proj",
        "o_proj",
        "gate_proj",
        "up_proj",
        "down_proj",
    ],  # Target modules for LoRA
)


# Training Arguments
training_arguments = TrainingArguments(
    output_dir="output",
    per_device_train_batch_size=1,
    per_device_eval_batch_size=1,
    gradient_accumulation_steps=2,
    optim="paged_adamw_32bit",
    num_train_epochs=1,
    logging_steps=0.2,
    warmup_steps=10,
    logging_strategy="steps",
    learning_rate=2e-4,
    fp16=False,
    bf16=False,
    group_by_length=True,
    report_to="none"
)

# Initialize the Trainer
trainer = SFTTrainer(
    model=model,
    args=training_arguments,
    train_dataset=dataset,
    peft_config=peft_config,
    data_collator=data_collator,
)Eğitime başlamadan önce CUDA önbelleğini temizleyin.
torch.cuda.empty_cache()
trainer_stats = trainer.train()
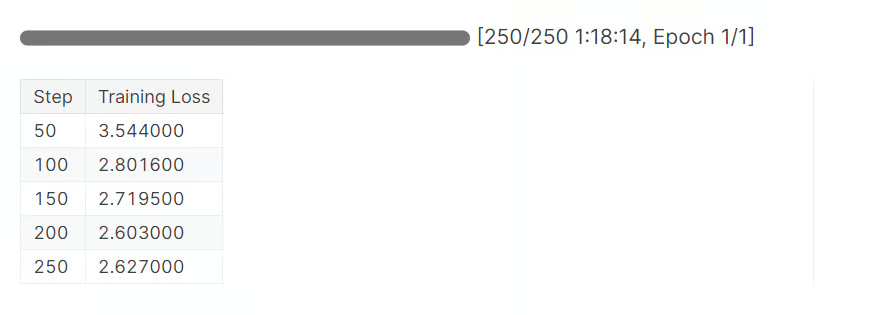
1 dönemi (epoch) tamamlamak yaklaşık 1 saat 20 dakika sürdü. Görüldüğü gibi kayıp (loss) kademeli olarak azaldı.
Şimdi, daha önce yaptığımız gibi örnek bir soru vererek ince ayarlı modelimizi test edelim.
question = dataset[0]['Open-ended Verifiable Question']

inputs = tokenizer(
    [prompt_style.format(question, "") + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
Muhakeme bölümü artık ayrıntılı ve doğru. Yanıt da isabetli.
<think>


Alright, let's figure out what portion of the estimated amortization expense will be recognized in 2017. First, I need to see what the total estimated amortization expense is for the years 2017 through 2022. Looking at the numbers, it's $58,370.

Now, I need to find out how much of that is specifically for 2017. The table shows that the estimated amortization expense for 2017 is $10,509.

So, to find out what portion of the total expense is for 2017, I'll divide the 2017 expense by the total expense. That's $10,509 divided by $58,370.

Let's do the math: $10,509 divided by $58,370 gives me approximately 0.1805.

Now, to express this as a percentage, I'll multiply by 100. So, 0.1805 times 100 gives me 18.05%.

Therefore, about 18.05% of the estimated amortization expense for the years 2017 through 2022 will be recognized in 2017.

</think>
About 18.05% of the estimated amortization expense for the years 2017 through 2022 will be recognized in 2017.
Bir soru daha soralım.
question = dataset[10]['Open-ended Verifiable Question']

inputs = tokenizer(
    [prompt_style.format(question, "") + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
Görüldüğü gibi, modeli yeni veri kümesi üzerinde başarıyla ince ayarladık. Artık isabetli ve muhakeme ile yanıt üslubuna uyuyor.
<think>


Alright, let's figure out the total purchase price of Impella Cardiosystems. First, we know the purchase price was $45.1 million, but there's a contingent payment of $5.6 million that could be earned. So, we need to see if we can figure out how much of that $5.6 million is actually likely to be paid.

Now, the question mentions that the contingent payment is triggered by FDA approvals. Since we're dealing with a medical device, getting FDA clearance is pretty important. Let's assume that the FDA approval for the Impella 2.5 is a good sign that the contingent payments will be made.

Okay, so if we assume all the contingent payments are earned, we just need to add the $5.6 million to the original $45.1 million. Let's do the math: $45.1 million plus $5.6 million equals $50.7 million.

Hmm, let's double-check our work. We're adding $45.1 million to $5.6 million, which gives us $50.7 million. Yep, that seems right.

So, if we assume all the contingent payments are earned, the total purchase price of Impella Cardiosystems would be $50.7 million.

</think>
The total purchase price of Impella Cardiosystems, assuming all contingent consideration is earned, would be $50.7 million.
Bir modeli ince ayarlamak uzmanlık, para ve zaman gerektirir. Bazı durumlarda ihtiyacınızı karşılamak için daha iyi bir RAG hattı yeterli olabilir. Gereksinimlerinizi anlamak için lütfen RAG ve İnce Ayar: Uygulamalı Örneklerle Kapsamlı Bir Eğitim rehberini okuyun.
Önce modeli ve belirteçleyiciyi yerel olarak kaydedeceğiz.
new_model_online = "kingabzpro/Gemma-3-4B-Fin-QA-Reasoning"
new_model_local = "Gemma-3-4B-Fin-QA-Reasoning"
model.save_pretrained(new_model_local) # Local saving
tokenizer.save_pretrained(new_model_local)
Ardından modeli Hugging Face Hub’a yükleyeceğiz.
model.push_to_hub(new_model_online) # Online saving
tokenizer.push_to_hub(new_model_online) # Online saving
Bu işlem önce model deposunu oluşturacak, sonra model, belirteçleyici ve yapılandırma alanlarının tümünü uzak sunucuya gönderecektir.
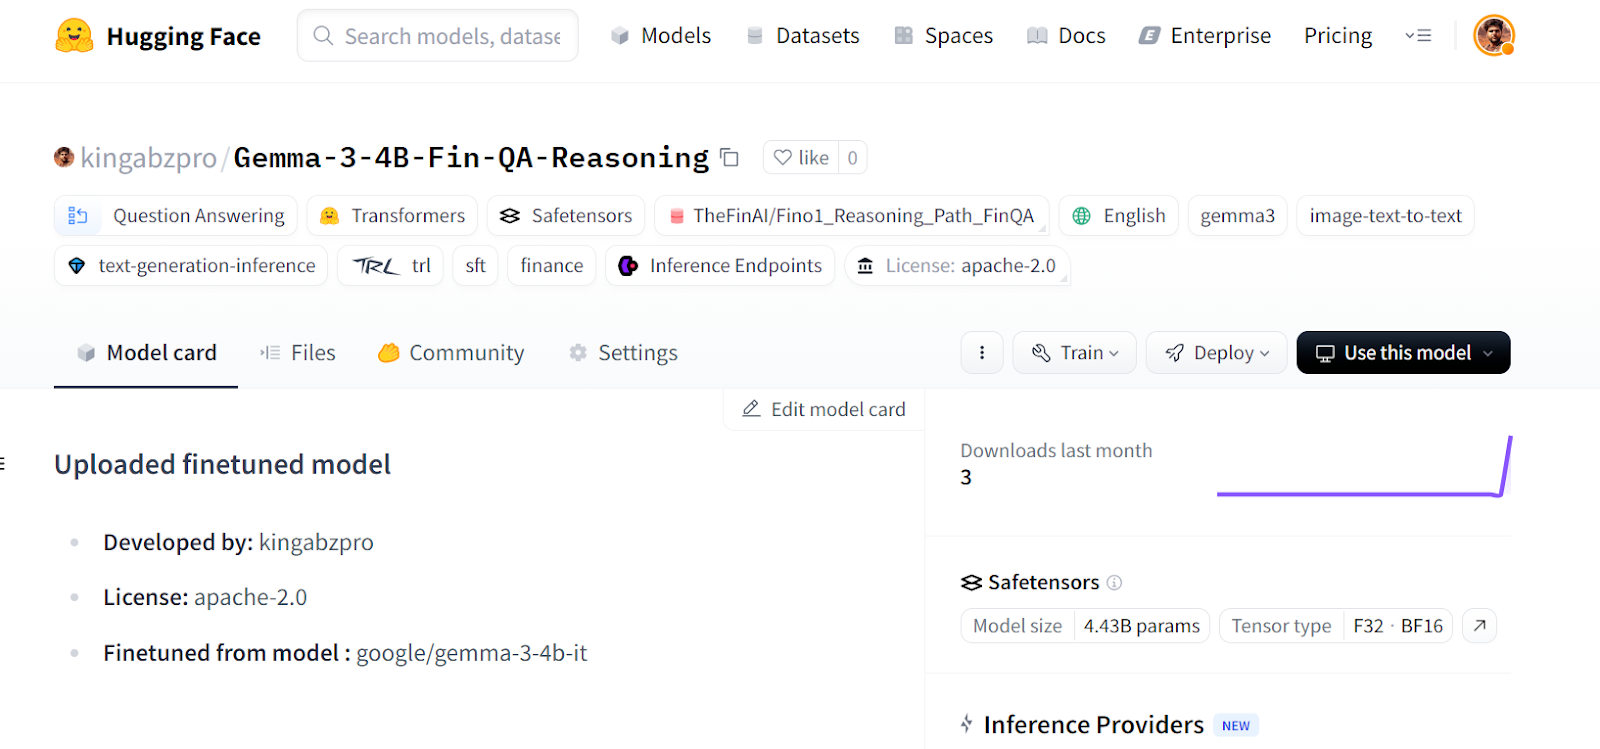
Kaynak: kingabzpro/Gemma-3-4B-Fin-QA-Reasoning · Hugging Face
Yukarıdaki kodu çalıştırırken sorun yaşıyorsanız, süreci daha iyi anlamak için herkesin klonlayıp kendi başına çalıştırabileceği bir Kaggle defteri oluşturduk.
Gemma 3 modelini ince ayarlamak bazı zorluklar barındırır; donanım, kütüphane, bellek parçalanması ve daha fazla sorunla karşılaşabilirsiniz. Bu rehber, herhangi bir modeli bir muhakeme modeline dönüştürmenin daha basit bir uygulamasını sunar ve gelecekte yazılım ve donanımla ilgili sorunlar yaşamanızı önlemeye yardımcı olur.
Bu eğitimde Gemma 3 modelinin özelliklerini ele aldık ve Kaggle’da sunulan ücretsiz GPU kaynaklarını kullanarak onu muhakeme veri kümesine nasıl kolayca ince ayarlayabileceğimizi gösterdik.
İnce ayar görevlerini TorchTune kullanarak ele almak ve kuantizasyon gibi verimli ince ayar tekniklerini öğrenmek için Llama 3 ile İnce Ayar kursunu alın.
En İyi DataCamp Kursları
Program
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme




