
Leerpad
Grote taalmodellen ontwikkelen
16 uur
Google’s nieuwe open-sourcemodelfamilie, Gemma 3, wint snel aan populariteit dankzij de indrukwekkende prestaties, vergelijkbaar met sommige van de nieuwste propriëtaire modellen. Gemma 3 introduceert multimodale mogelijkheden, verbeterde redeneervaardigheden en ondersteunt meer dan 140 talen.
In deze tutorial verkennen we de mogelijkheden van Gemma 3 en leer je hoe je het kunt fine-tunen op een dataset voor financieel redeneren met vraag-en-antwoord. Dit fine-tuningproces verbetert de nauwkeurigheid van het model aanzienlijk bij het begrijpen van complexe financiële vragen en stelt het in staat om precieze, contextueel relevante antwoorden te geven.
Nieuw met het fine-tunen van LLM’s? Geen zorgen, we helpen je op weg! Volg onze toegankelijke tutorial, Fine-tuning LLMs: A Guide With Examples, om te leren hoe fine-tuning werkt.
Je kunt ook de cursus Introduction to LLMs in Python volgen om meer te leren over hoe LLM’s werken, hoe je ze fine-tunet en hoe je hun prestaties evalueert.
Afbeelding door de auteur
De Gemma-familie van open modellen is een grote stap voorwaarts om geavanceerde AI-technologie voor iedereen toegankelijk te maken. Gebouwd op het onderzoek en de technologie achter de Gemini 2.0-modellen, biedt Gemma 3 topprestaties terwijl het lichtgewicht en efficiënt blijft.
Met groottes variërend van 1 miljard tot 27 miljard parameters biedt Gemma 3 flexibiliteit qua hardware- en prestatie-eisen, waardoor het eenvoudiger dan ooit is om geavanceerde AI in echte toepassingen te integreren.
Gemma 3 zet een nieuwe standaard neer voor prestaties in zijn klasse en laat concurrenten zoals Llama3-405B, DeepSeek-V3 en o3-mini achter zich in evaluaties van menselijke voorkeuren op het LMArena-leaderboard. Het lichte ontwerp doet geen concessies aan kracht, waardoor ontwikkelaars toonaangevende resultaten kunnen behalen met behoud van efficiëntie.
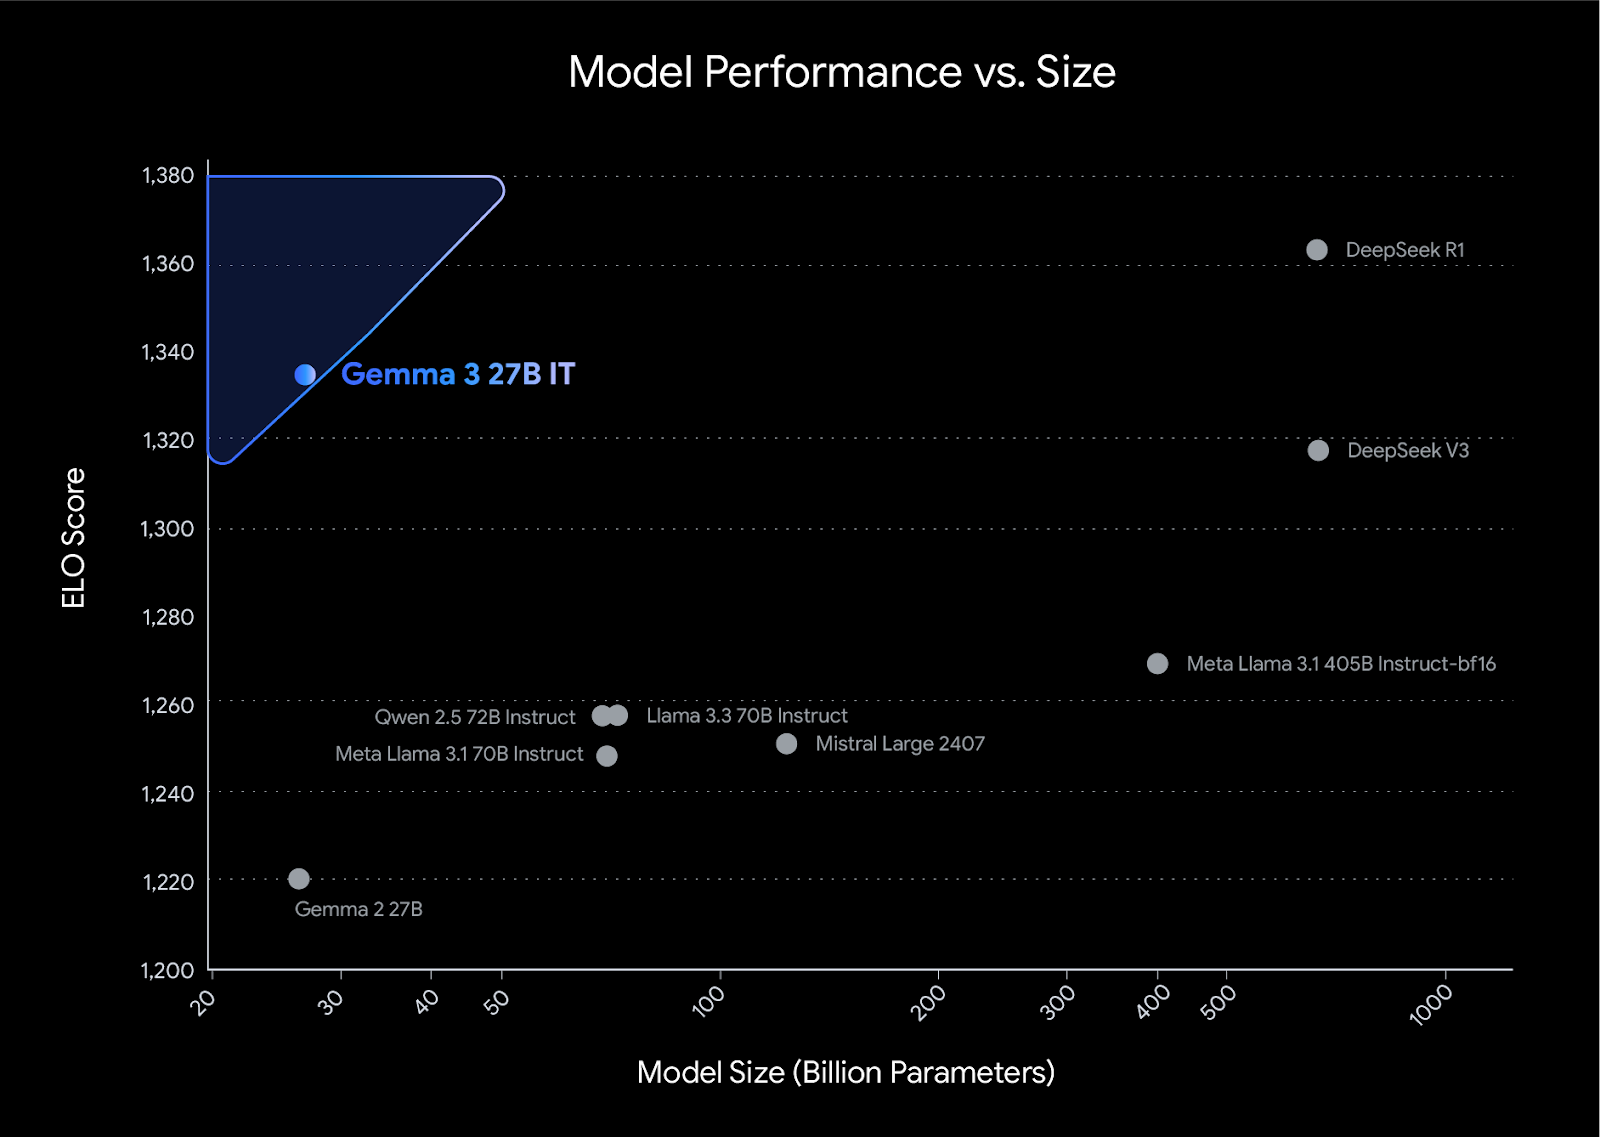
Bron: Introducing Gemma 3
In dit project laden we Gemma 3 vanaf Kaggle en halen we de data op van Hugging Face. Vervolgens gebruiken we de Transformers- en TRL-bibliotheken om ons model te fine-tunen. Ter vergelijking genereren we de respons vóór en na het fine-tunen.
Wil je leren hoe je met de Unsloth-bibliotheek je model fine-tunet op reasoning-data? Bekijk dan de gids Fine-Tuning DeepSeek R1 (Reasoning Model).
Installeer alle benodigde Python-bibliotheken en zorg dat je de ransformer-bibliotheek bijwerkt.
%%capture
!pip install -U datasets
!pip install -U accelerate
!pip install -U peft
!pip install -U trl
!pip install -U bitsandbytes
!pip install git+https://github.com/huggingface/transformers@v4.49.0-Gemma-3
Log in op de Hugging Face-client met je API-sleutel. De API-sleutel wordt veilig opgeslagen in de Kaggle secrets; we halen ‘m op en passen ‘m toe op de Hugging Face-client.
from huggingface_hub import login
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()

hf_token = user_secrets.get_secret("HUGGINGFACE_TOKEN")
login(hf_token)Voeg het Gemma 3 4B IT-model toe aan de Kaggle-notebook zoals je ook een dataset toevoegt, door op de knop “+ Add Input” te klikken.
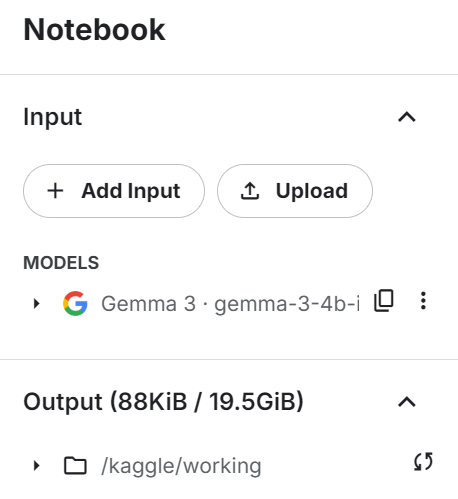
Laad het model en de tokenizer met de transformers-bibliotheek. Zorg dat het model is ingesteld op device_map="auto" om een dual-GPU-opstelling effectief te benutten.
from transformers import AutoTokenizer, Gemma3ForConditionalGeneration

import torch

GEMMA_PATH = "/kaggle/input/gemma-3/transformers/gemma-3-4b-it/1"

model = Gemma3ForConditionalGeneration.from_pretrained(
    GEMMA_PATH, device_map="auto",attn_implementation='eager'
).eval()

tokenizer = AutoTokenizer.from_pretrained(GEMMA_PATH)Voordat we de dataset laden, maken we de trainingspromptstijl en voorzien we drie placeholders die we vullen met datasetkolommen. Deze promptstijl helpt ons redenerende tekst te genereren.
train_prompt_style="""
Below is an instruction that describes a task, paired with an input that provides further context.
Write a response that appropriately completes the request.
Before answering, think carefully about the question and create a step-by-step chain of thoughts to ensure a logical and accurate response.

### Question:
{}

### Response:
<think>
{}
</think>
{}
"""
Vervolgens maken we de opmaakfunctie die de kolommen uit de dataset gebruikt en toepast op de trainingspromptstijl om de kolom "text" te maken. Zorg dat je de EOS-token toevoegt aan het einde van de respons.
def formatting_prompts_func(examples):
    inputs = examples["Open-ended Verifiable Question"]
    complex_cots = examples["Complex_CoT"]
    outputs = examples["Response"]
    texts = []
    for question, cot, response in zip(inputs, complex_cots, outputs):
        # Append the EOS token to the response if it's not already there
        if not response.endswith(tokenizer.eos_token):
            response += tokenizer.eos_token
        text = train_prompt_style.format(question, cot, response)
        texts.append(text)
    return {"text": texts}
We laden nu de TheFinAI/Fino1_Reasoning_Path_FinQA-dataset, een dataset voor financieel redeneren gebaseerd op FinQA, uitgebreid met door GPT-4o gegenereerde redeneerpaden voor gestructureerde financiële Q&A. Daarna passen we de opmaakfunctie toe op de dataset en maken we de nieuwe tekstkolom volgens de promptstijl.
from datasets import load_dataset
dataset = load_dataset("TheFinAI/Fino1_Reasoning_Path_FinQA", split = "train[0:500]",trust_remote_code=True)
dataset = dataset.map(formatting_prompts_func, batched = True,)
dataset["text"][0]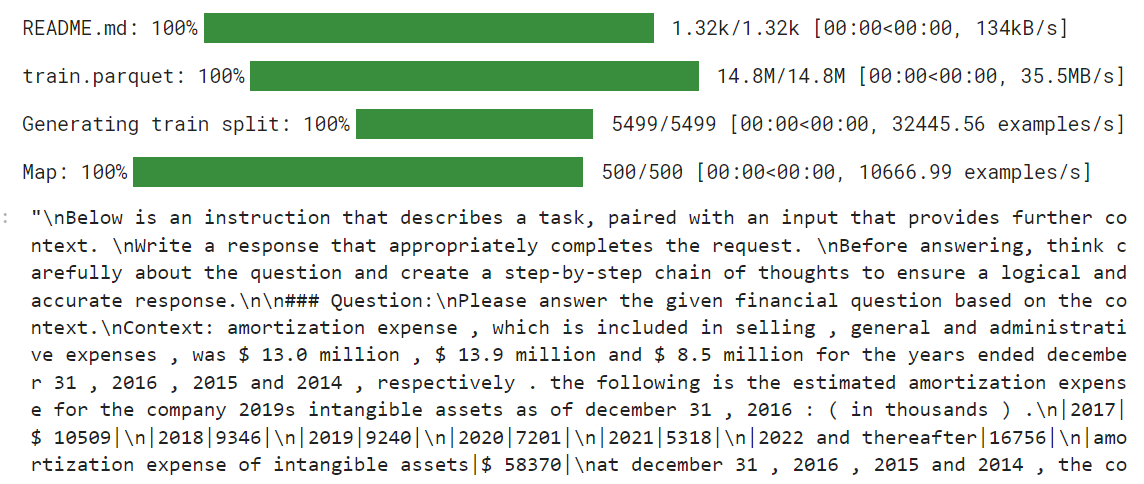
De nieuwe STF-trainer accepteert de tokenizers niet, dus we moeten onze datacollator maken met de tokenizer en die later aan de trainer doorgeven.
from transformers import DataCollatorForLanguageModeling

data_collator = DataCollatorForLanguageModeling(
    tokenizer=tokenizer,
    mlm=False  # we're doing causal LM, not masked LM
)Voordat we het model gaan fine-tunen, testen we ons oorspronkelijke model om te zien hoe goed het antwoorden genereert. We maken de promptstijl met twee placeholders in plaats van drie.
prompt_style = """Below is an instruction that describes a task, paired with an input that provides further context.
Write a response that appropriately completes the request.
Before answering, think carefully about the question and create a step-by-step chain of thoughts to ensure a logical and accurate response.

### Question:
{}

### Response:
<think>
{}
"""
Daarna passen we de promptstijl toe op de vraag, zetten die om naar tokens en voeren die aan het model. Vervolgens genereren we de respons en zetten we de tokens terug naar tekst.
question = dataset[0]['Open-ended Verifiable Question']


inputs = tokenizer(
    [prompt_style.format(question, "") + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
De respons is kort en verre van nauwkeurig.
<think>

The question asks for the portion of the estimated amortization expense that will be recognized in 2017.
The provided table shows the estimated amortization expense for intangible assets for the years 2017, 2018, 2019, 2020, 2021, and 2022 and thereafter.
The amortization expense for 2017 is $10,509.
</think>
$10,509
Hier is het antwoord uit de dataset. Het antwoord zou een verhouding moeten zijn, niet het bedrag.
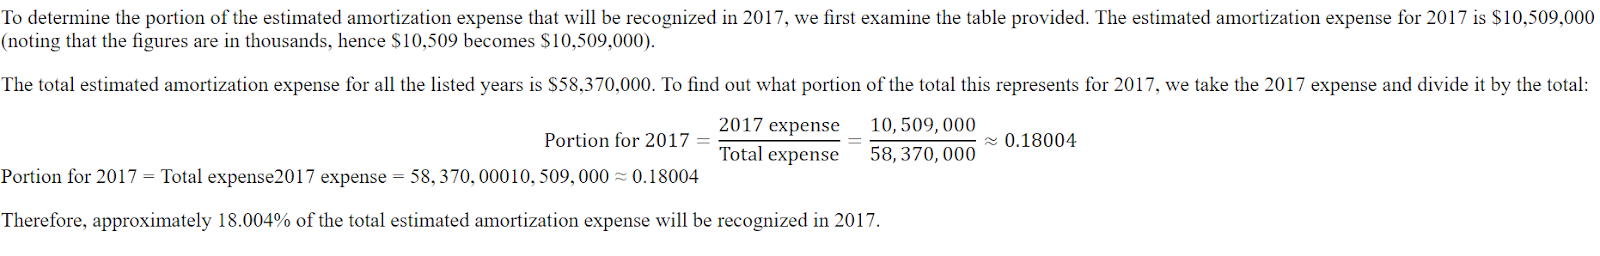
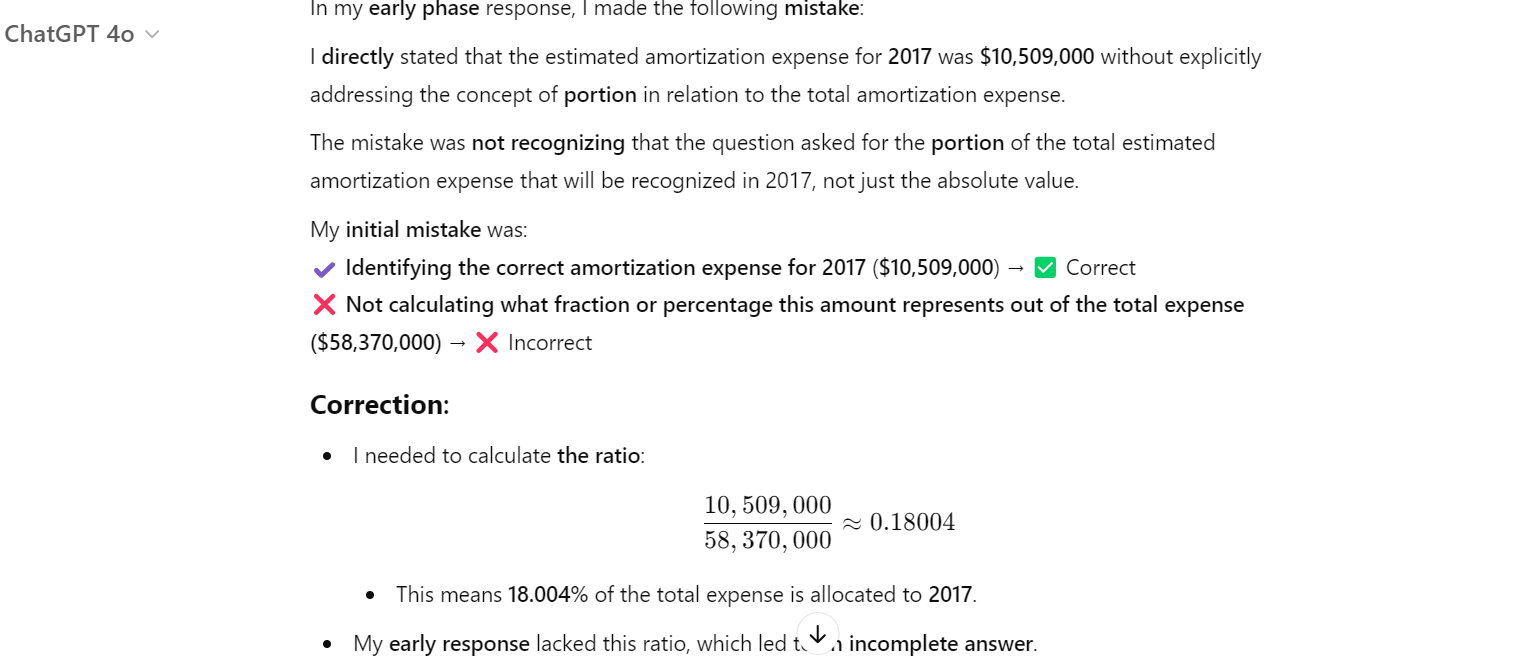
Zelfs ChatGPT zat ernaast; we moesten vragen om de fout te herstellen. Daarna begreep het dat er een fout was gemaakt en is het gecorrigeerd.
We geven nu de dataset, het model, de datacollator, trainingsargumenten en LoRA-configuratie door aan de SFTTrainer.
from trl import SFTTrainer
from transformers import TrainingArguments
from peft import LoraConfig

# LoRA Configuration
peft_config = LoraConfig(
    lora_alpha=16,                           # Scaling factor for LoRA
    lora_dropout=0.05,                       # Add slight dropout for regularization
    r=64,                                    # Rank of the LoRA update matrices
    bias="none",                             # No bias reparameterization
    task_type="CAUSAL_LM",                   # Task type: Causal Language Modeling
    target_modules=[
        "q_proj",
        "k_proj",
        "v_proj",
        "o_proj",
        "gate_proj",
        "up_proj",
        "down_proj",
    ],  # Target modules for LoRA
)


# Training Arguments
training_arguments = TrainingArguments(
    output_dir="output",
    per_device_train_batch_size=1,
    per_device_eval_batch_size=1,
    gradient_accumulation_steps=2,
    optim="paged_adamw_32bit",
    num_train_epochs=1,
    logging_steps=0.2,
    warmup_steps=10,
    logging_strategy="steps",
    learning_rate=2e-4,
    fp16=False,
    bf16=False,
    group_by_length=True,
    report_to="none"
)

# Initialize the Trainer
trainer = SFTTrainer(
    model=model,
    args=training_arguments,
    train_dataset=dataset,
    peft_config=peft_config,
    data_collator=data_collator,
)Leeg de CUDA-cache voordat je het trainingsproces start.
torch.cuda.empty_cache()
trainer_stats = trainer.train()
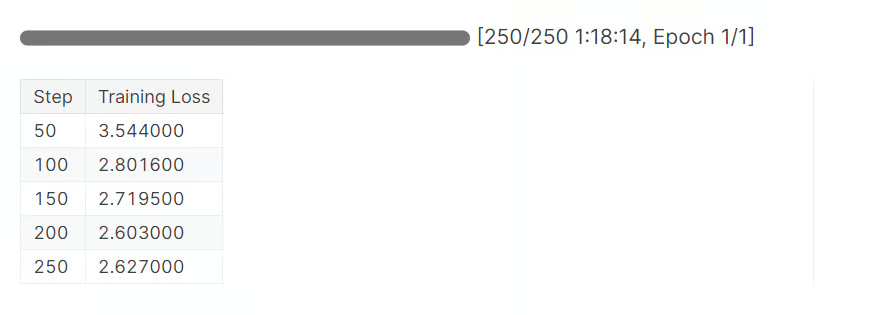
Het duurde bijna 1 uur en 20 minuten om 1 epoch te voltooien. Zoals we zien, nam de loss geleidelijk af.
Laten we nu ons gefinetunede model testen door, net als eerder, een voorbeeldvraag te geven.
question = dataset[0]['Open-ended Verifiable Question']

inputs = tokenizer(
    [prompt_style.format(question, "") + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
Het redeneergedeelte is nu gedetailleerd en correct. Het antwoord is ook nauwkeurig.
<think>


Alright, let's figure out what portion of the estimated amortization expense will be recognized in 2017. First, I need to see what the total estimated amortization expense is for the years 2017 through 2022. Looking at the numbers, it's $58,370.

Now, I need to find out how much of that is specifically for 2017. The table shows that the estimated amortization expense for 2017 is $10,509.

So, to find out what portion of the total expense is for 2017, I'll divide the 2017 expense by the total expense. That's $10,509 divided by $58,370.

Let's do the math: $10,509 divided by $58,370 gives me approximately 0.1805.

Now, to express this as a percentage, I'll multiply by 100. So, 0.1805 times 100 gives me 18.05%.

Therefore, about 18.05% of the estimated amortization expense for the years 2017 through 2022 will be recognized in 2017.

</think>
About 18.05% of the estimated amortization expense for the years 2017 through 2022 will be recognized in 2017.
Stellen we nog een vraag.
question = dataset[10]['Open-ended Verifiable Question']

inputs = tokenizer(
    [prompt_style.format(question, "") + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
Zoals we zien, hebben we het model succesvol gefinetuned op de nieuwe dataset. Het is nu nauwkeurig en volgt de redeneer- en antwoordstijl.
<think>


Alright, let's figure out the total purchase price of Impella Cardiosystems. First, we know the purchase price was $45.1 million, but there's a contingent payment of $5.6 million that could be earned. So, we need to see if we can figure out how much of that $5.6 million is actually likely to be paid.

Now, the question mentions that the contingent payment is triggered by FDA approvals. Since we're dealing with a medical device, getting FDA clearance is pretty important. Let's assume that the FDA approval for the Impella 2.5 is a good sign that the contingent payments will be made.

Okay, so if we assume all the contingent payments are earned, we just need to add the $5.6 million to the original $45.1 million. Let's do the math: $45.1 million plus $5.6 million equals $50.7 million.

Hmm, let's double-check our work. We're adding $45.1 million to $5.6 million, which gives us $50.7 million. Yep, that seems right.

So, if we assume all the contingent payments are earned, the total purchase price of Impella Cardiosystems would be $50.7 million.

</think>
The total purchase price of Impella Cardiosystems, assuming all contingent consideration is earned, would be $50.7 million.
Een model fine-tunen kost expertise, geld en tijd. In sommige gevallen heb je genoeg aan een betere RAG-pijplijn om aan je behoeften te voldoen. Lees de gids RAG vs Fine-Tuning: A Comprehensive Tutorial with Practical Examples om je behoeften in kaart te brengen.
Eerst slaan we het model en de tokenizer lokaal op.
new_model_online = "kingabzpro/Gemma-3-4B-Fin-QA-Reasoning"
new_model_local = "Gemma-3-4B-Fin-QA-Reasoning"
model.save_pretrained(new_model_local) # Local saving
tokenizer.save_pretrained(new_model_local)
Vervolgens pushen we het model naar de Hugging Face Hub.
model.push_to_hub(new_model_online) # Online saving
tokenizer.push_to_hub(new_model_online) # Online saving
Dit proces maakt eerst de modelrepository aan en pusht vervolgens alle model-, tokenizer- en configuratiebestanden naar de externe server.
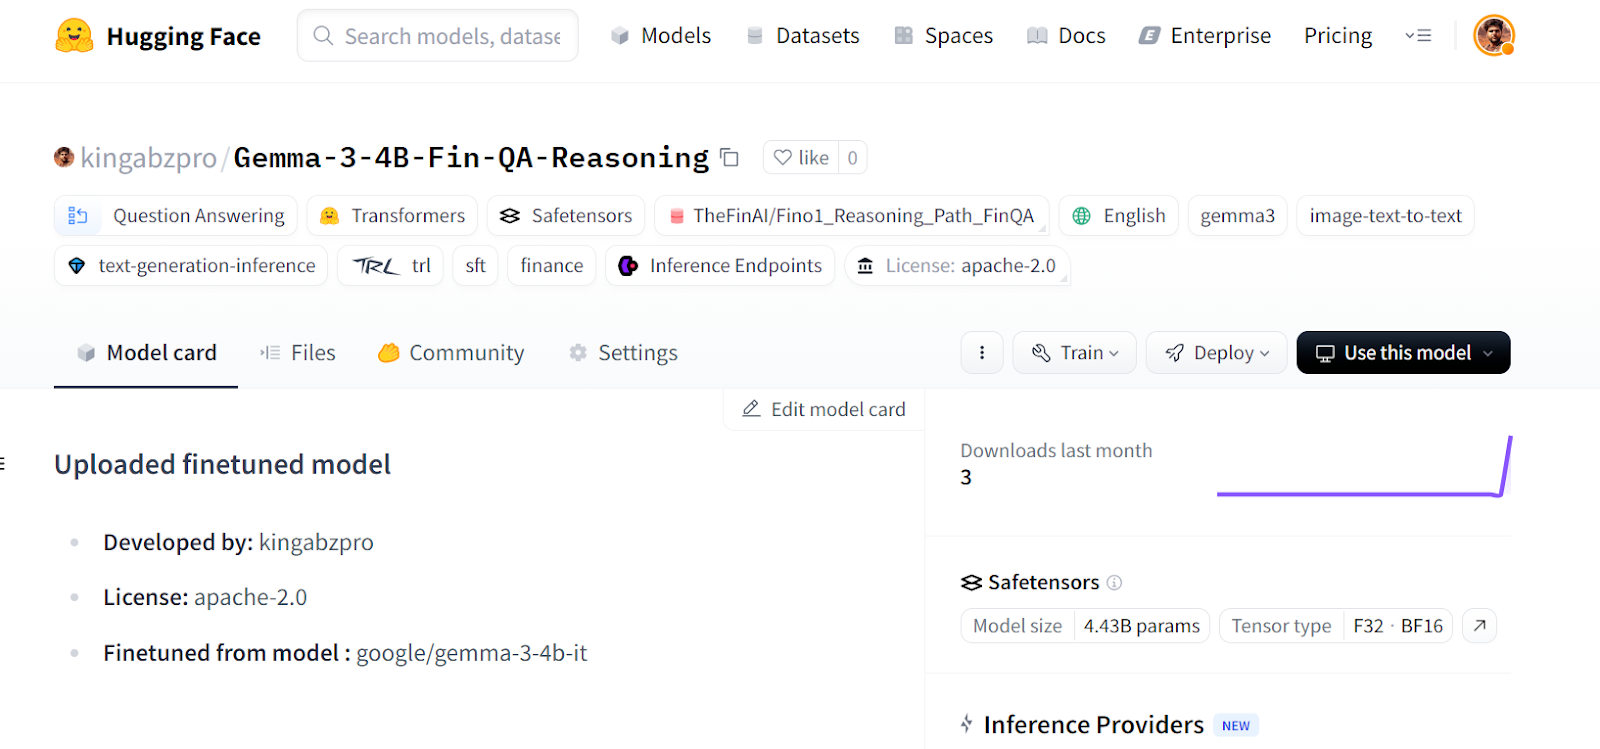
Bron: kingabzpro/Gemma-3-4B-Fin-QA-Reasoning · Hugging Face
Loop je vast met de bovenstaande code? We hebben een Kaggle-notebook gemaakt die iedereen kan clonen en zelf kan draaien om het proces beter te begrijpen.
Het fine-tunen van het Gemma 3-model kent uitdagingen; je kunt te maken krijgen met hardwareproblemen, bibliotheekproblemen, geheugenfragmentatie en meer. Deze gids biedt een eenvoudigere implementatie om elk model om te vormen tot een reasoning-model en toekomstige software- en hardwareproblemen te voorkomen.
In deze tutorial hebben we de functies van het Gemma 3-model behandeld en laten zien hoe je het eenvoudig kunt fine-tunen op de reasoning-dataset met gratis GPU-resources op Kaggle.
Volg de cursus Fine-tuning with Llama 3 om fine-tuningtaken aan te pakken met TorchTune en leer efficiënte technieken zoals kwantisatie.
Topcursussen bij DataCamp
Leerpad
Cursus
Cursus
blog
Adel Nehme
15 min

