
लर्निंग पाथ
बड़े भाषा मॉडल विकसित करना
16 घंटा
Google का नया ओपन-सोर्स मॉडल परिवार, Gemma 3, अपनी प्रभावशाली प्रदर्शन क्षमता के कारण तेजी से लोकप्रिय हो रहा है, जो कुछ नवीनतम स्वामित्त्व वाले मॉडलों के तुल्य है। Gemma 3 मल्टीमोडल क्षमताएँ, बेहतर तर्क कौशल, और 140 से अधिक भाषाओं का समर्थन प्रदान करता है।
इस ट्यूटोरियल में, हम Gemma 3 की क्षमताओं का अन्वेषण करेंगे और सीखेंगे कि इसे वित्तीय तर्क-आधारित प्रश्नोत्तर डेटासेट पर कैसे फाइन-ट्यून किया जाए। यह फाइन-ट्यूनिंग प्रक्रिया जटिल वित्तीय प्रश्नों को समझने में मॉडल की सटीकता को उल्लेखनीय रूप से बढ़ाएगी और इसे सटीक, संदर्भानुकूल उत्तर प्रदान करने में सक्षम बनाएगी।
क्या आप LLMs को फाइन-ट्यून करने में नए हैं? चिंता न करें; हम आपके लिए तैयार हैं! हमारा आसान ट्यूटोरियल, Fine-Tuning LLMs: A Guide With Examples का अनुसरण करें और फाइन-ट्यूनिंग कैसे काम करती है, यह जानें।
आप यह कोर्स भी कर सकते हैं Introduction to LLMs in Python ताकि आप समझ सकें कि LLMs कैसे काम करते हैं, उन्हें कैसे फाइन-ट्यून किया जाता है, और उनके प्रदर्शन का मूल्यांकन कैसे किया जाता है।
छवि: लेखक द्वारा
ओपन मॉडलों का Gemma परिवार अत्याधुनिक AI तकनीक को सभी के लिए सुलभ बनाने में एक महत्वपूर्ण प्रगति का प्रतिनिधित्व करता है। Gemini 2.0 मॉडलों के अनुसंधान और तकनीक पर आधारित, Gemma 3 अत्याधुनिक प्रदर्शन देता है, जबकि यह हल्का और कुशल भी रहता है।
1 बिलियन से 27 बिलियन पैरामीटर्स तक के आकारों के साथ, Gemma 3 हार्डवेयर और प्रदर्शन आवश्यकताओं में लचीलापन प्रदान करता है, जिससे वास्तविक दुनिया के अनुप्रयोगों में उन्नत AI को एकीकृत करना पहले से कहीं अधिक आसान हो जाता है।
Gemma 3 अपने वर्ग में प्रदर्शन के लिए एक नया मानक स्थापित करता है और Llama3-405B, DeepSeek-V3, और o3-mini को LMArena लीडरबोर्ड पर मानव वरीयता मूल्यांकन में पीछे छोड़ता है। इसका हल्का डिज़ाइन शक्ति से समझौता नहीं करता, जिससे डेवलपर्स दक्षता बनाए रखते हुए उद्योग-स्तरीय परिणाम प्राप्त कर सकते हैं।
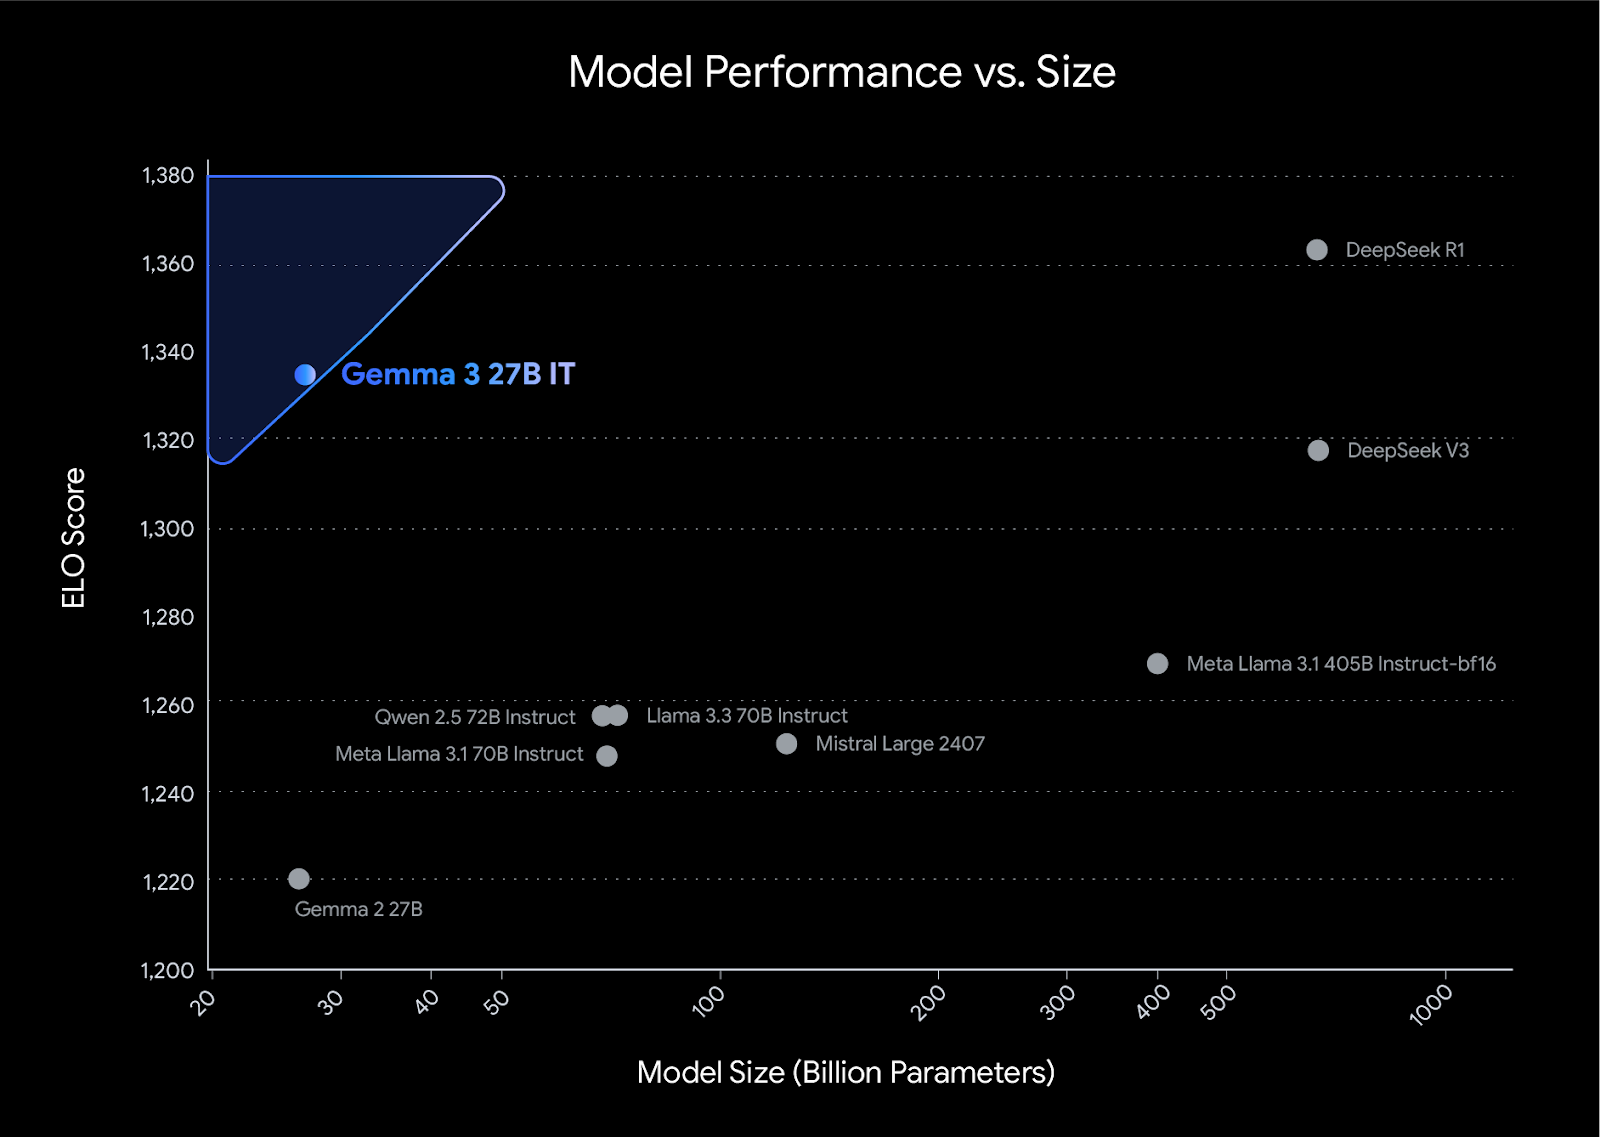
स्रोत: Introducing Gemma 3
इस प्रोजेक्ट में, हम Kaggle से Gemma 3 लोड करेंगे और Hugging Face से डेटा प्राप्त करेंगे। इसके बाद, हम Transformers और TRL लाइब्रेरियों का उपयोग करके अपने मॉडल को फाइन-ट्यून करेंगे। तुलना के लिए, हम फाइन-ट्यूनिंग से पहले और बाद में प्रतिक्रिया उत्पन्न करेंगे।
यदि आप Unsloth लाइब्रेरी का उपयोग करके अपने मॉडल को तर्क डेटा पर फाइन-ट्यून करना सीखना चाहते हैं, तो यह देखें Fine-Tuning DeepSeek R1 (Reasoning Model) गाइड।
सभी आवश्यक Python लाइब्रेरियाँ इंस्टॉल करें, और सुनिश्चित करें कि आप transformer लाइब्रेरी को अपडेट करें।
%%capture
!pip install -U datasets
!pip install -U accelerate
!pip install -U peft
!pip install -U trl
!pip install -U bitsandbytes
!pip install git+https://github.com/huggingface/transformers@v4.49.0-Gemma-3
अपने API कुंजी का उपयोग करके Hugging Face क्लाइंट में लॉग इन करें। API कुंजी को Kaggle secrets में सुरक्षित रूप से संग्रहीत किया गया है, और हम इसे निकालकर Hugging Face क्लाइंट पर लागू करेंगे।
from huggingface_hub import login
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()

hf_token = user_secrets.get_secret("HUGGINGFACE_TOKEN")
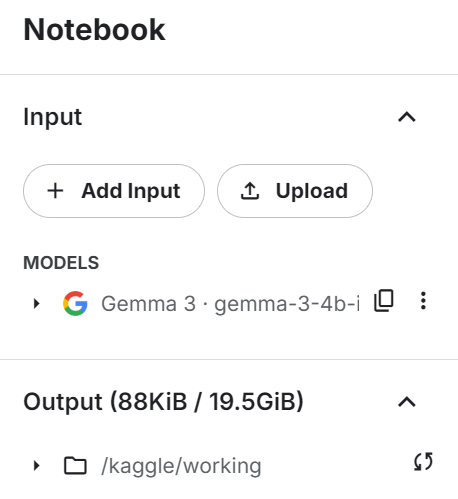
login(hf_token)Gemma 3 4B IT मॉडल को Kaggle नोटबुक में वैसा ही जोड़ें जैसे आप डेटासेट जोड़ते हैं, “+ Add Input” बटन पर क्लिक करके।
transformers लाइब्रेरी का उपयोग करके मॉडल और टोकनाइज़र लोड करें। सुनिश्चित करें कि मॉडल device_map="auto" पर सेट है ताकि डुअल GPU सेटअप का प्रभावी उपयोग हो सके।
from transformers import AutoTokenizer, Gemma3ForConditionalGeneration

import torch

GEMMA_PATH = "/kaggle/input/gemma-3/transformers/gemma-3-4b-it/1"

model = Gemma3ForConditionalGeneration.from_pretrained(
    GEMMA_PATH, device_map="auto",attn_implementation='eager'
).eval()

tokenizer = AutoTokenizer.from_pretrained(GEMMA_PATH)डेटासेट लोड करने से पहले, हम प्रशिक्षण प्रॉम्प्ट शैली बनाएंगे और तीन प्लेसहोल्डर प्रदान करेंगे जिन्हें हम डेटासेट कॉलम से भरेंगे। यह प्रॉम्प्ट शैली हमें तर्क-पाठ (reasoning text) उत्पन्न करने में मदद करेगी।
train_prompt_style="""
Below is an instruction that describes a task, paired with an input that provides further context.
Write a response that appropriately completes the request.
Before answering, think carefully about the question and create a step-by-step chain of thoughts to ensure a logical and accurate response.

### Question:
{}

### Response:
<think>
{}
</think>
{}
"""
अगले चरण में, हम फॉर्मेटिंग फ़ंक्शन बनाएँगे जो डेटासेट के कॉलम का उपयोग करता है और उन्हें प्रशिक्षण प्रॉम्प्ट शैली पर लागू कर "text" कॉलम बनाता है। सुनिश्चित करें कि आप प्रतिक्रिया के अंत में EOS टोकन जोड़ रहे हैं।
def formatting_prompts_func(examples):
    inputs = examples["Open-ended Verifiable Question"]
    complex_cots = examples["Complex_CoT"]
    outputs = examples["Response"]
    texts = []
    for question, cot, response in zip(inputs, complex_cots, outputs):
        # Append the EOS token to the response if it's not already there
        if not response.endswith(tokenizer.eos_token):
            response += tokenizer.eos_token
        text = train_prompt_style.format(question, cot, response)
        texts.append(text)
    return {"text": texts}
अब हम TheFinAI/Fino1_Reasoning_Path_FinQA डेटासेट लोड करेंगे, जो FinQA पर आधारित एक वित्तीय तर्क डेटासेट है और संरचित वित्तीय प्रश्नोत्तर के लिए GPT-4o द्वारा उत्पन्न तर्क-मार्गों से संवर्धित है। इसके बाद, हम डेटासेट पर फॉर्मेटिंग फ़ंक्शन लागू करेंगे और प्रॉम्प्ट शैली के अनुरूप नया टेक्स्ट कॉलम बनाएँगे।
from datasets import load_dataset
dataset = load_dataset("TheFinAI/Fino1_Reasoning_Path_FinQA", split = "train[0:500]",trust_remote_code=True)
dataset = dataset.map(formatting_prompts_func, batched = True,)
dataset["text"][0]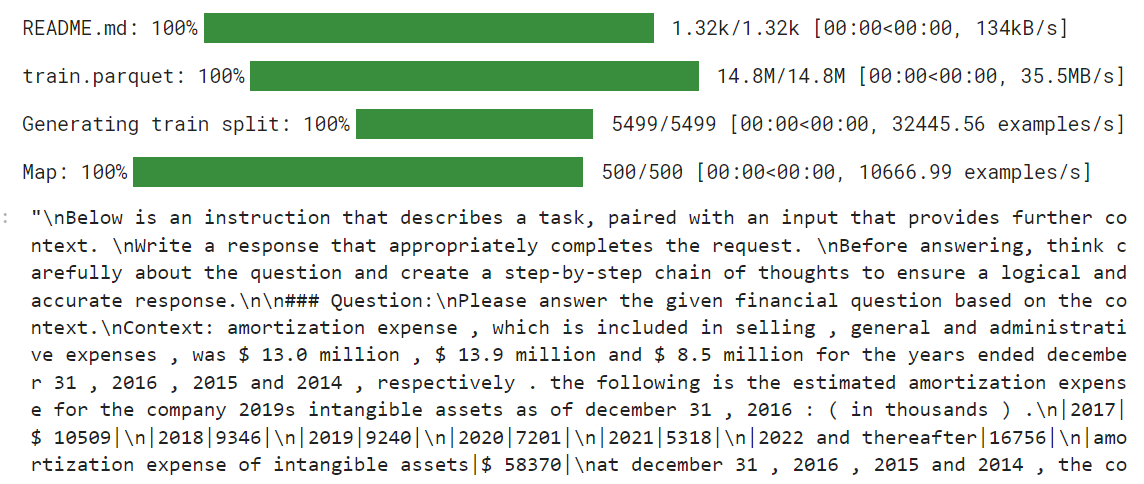
नया STF ट्रेनर टोकनाइज़र्स स्वीकार नहीं करता, इसलिए हमें टोकनाइज़र का उपयोग करके अपना डेटा कोलेशन बनाना होगा और बाद में इसे ट्रेनर को प्रदान करना होगा।
from transformers import DataCollatorForLanguageModeling

data_collator = DataCollatorForLanguageModeling(
    tokenizer=tokenizer,
    mlm=False  # we're doing causal LM, not masked LM
)मॉडल को फाइन-ट्यून करना शुरू करने से पहले, हम अपने मूल मॉडल का परीक्षण करेंगे कि वह प्रतिक्रियाएँ उत्पन्न करने में कितना अच्छा है। हम तीन की जगह दो प्लेसहोल्डर के साथ प्रॉम्प्ट शैली बनाएँगे।
prompt_style = """Below is an instruction that describes a task, paired with an input that provides further context.
Write a response that appropriately completes the request.
Before answering, think carefully about the question and create a step-by-step chain of thoughts to ensure a logical and accurate response.

### Question:
{}

### Response:
<think>
{}
"""
फिर, हम प्रश्न पर प्रॉम्प्ट शैली लागू करेंगे, उसे टोकन में बदलेंगे और मॉडल को देंगे। इसके बाद, हम प्रतिक्रिया उत्पन्न करेंगे और टोकन को वापस टेक्स्ट में बदलेंगे।
question = dataset[0]['Open-ended Verifiable Question']


inputs = tokenizer(
    [prompt_style.format(question, "") + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
प्रतिक्रिया छोटी है और काफी हद तक गलत है।
<think>

The question asks for the portion of the estimated amortization expense that will be recognized in 2017.
The provided table shows the estimated amortization expense for intangible assets for the years 2017, 2018, 2019, 2020, 2021, and 2022 and thereafter.
The amortization expense for 2017 is $10,509.
</think>
$10,509
यहाँ डेटासेट से उत्तर है। उत्तर राशि नहीं, बल्कि अनुपात होना चाहिए।
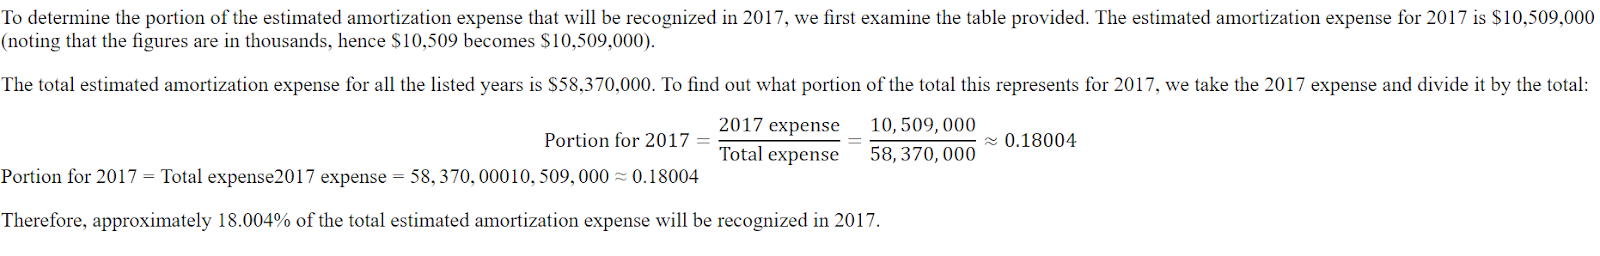
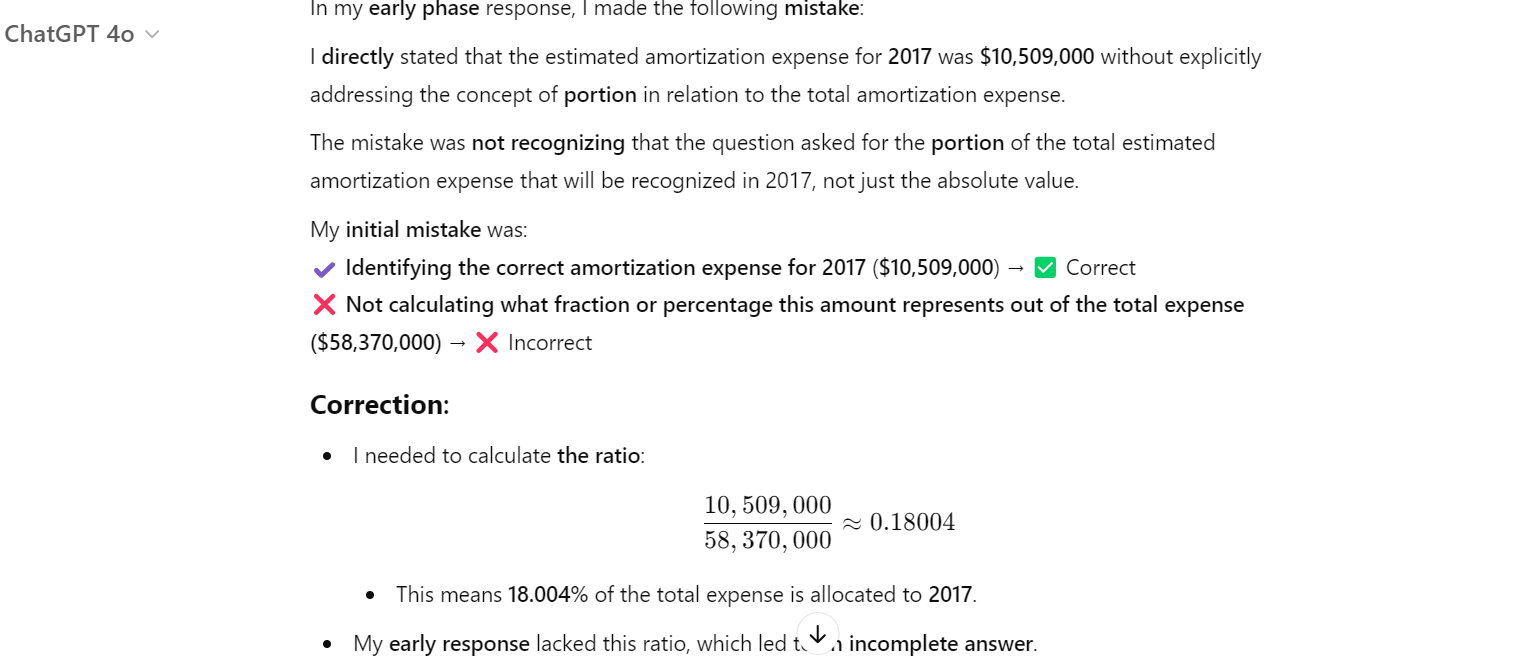
यहाँ तक कि ChatGPT ने भी इसे गलत किया, और हमें उससे गलती सुधारने को कहना पड़ा। उसके बाद, उसने अपनी गलती समझी और उसे ठीक किया।
अब हम SFTTrainer को डेटासेट, मॉडल, डेटा कोलेशन, प्रशिक्षण आर्ग्युमेंट्स और LoRA कॉन्फ़िगरेशन प्रदान करेंगे।
from trl import SFTTrainer
from transformers import TrainingArguments
from peft import LoraConfig

# LoRA Configuration
peft_config = LoraConfig(
    lora_alpha=16,                           # Scaling factor for LoRA
    lora_dropout=0.05,                       # Add slight dropout for regularization
    r=64,                                    # Rank of the LoRA update matrices
    bias="none",                             # No bias reparameterization
    task_type="CAUSAL_LM",                   # Task type: Causal Language Modeling
    target_modules=[
        "q_proj",
        "k_proj",
        "v_proj",
        "o_proj",
        "gate_proj",
        "up_proj",
        "down_proj",
    ],  # Target modules for LoRA
)


# Training Arguments
training_arguments = TrainingArguments(
    output_dir="output",
    per_device_train_batch_size=1,
    per_device_eval_batch_size=1,
    gradient_accumulation_steps=2,
    optim="paged_adamw_32bit",
    num_train_epochs=1,
    logging_steps=0.2,
    warmup_steps=10,
    logging_strategy="steps",
    learning_rate=2e-4,
    fp16=False,
    bf16=False,
    group_by_length=True,
    report_to="none"
)

# Initialize the Trainer
trainer = SFTTrainer(
    model=model,
    args=training_arguments,
    train_dataset=dataset,
    peft_config=peft_config,
    data_collator=data_collator,
)ट्रेनिंग प्रक्रिया शुरू करने से पहले CUDA कैश साफ़ करें।
torch.cuda.empty_cache()
trainer_stats = trainer.train()
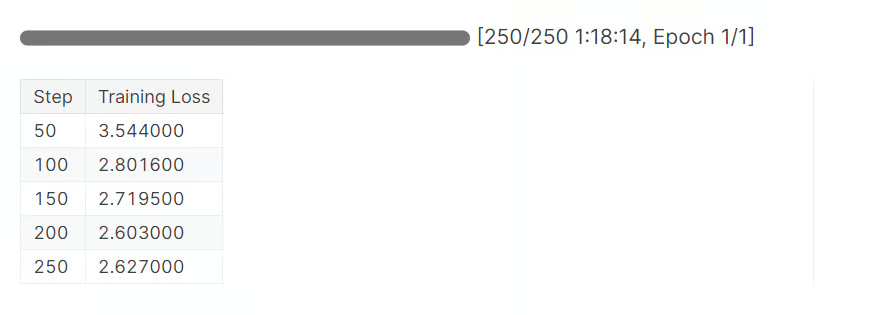
1 epoch पूरा करने में लगभग 1 घंटा 20 मिनट लगे। जैसा कि हम देख सकते हैं, लॉस धीरे-धीरे कम हुआ है।
अब, पहले की तरह एक नमूना प्रश्न देकर अपने फाइन-ट्यून किए गए मॉडल का परीक्षण करें।
question = dataset[0]['Open-ended Verifiable Question']

inputs = tokenizer(
    [prompt_style.format(question, "") + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
अब तर्क वाला भाग विस्तृत और सही है। उत्तर भी सटीक है।
<think>


Alright, let's figure out what portion of the estimated amortization expense will be recognized in 2017. First, I need to see what the total estimated amortization expense is for the years 2017 through 2022. Looking at the numbers, it's $58,370.

Now, I need to find out how much of that is specifically for 2017. The table shows that the estimated amortization expense for 2017 is $10,509.

So, to find out what portion of the total expense is for 2017, I'll divide the 2017 expense by the total expense. That's $10,509 divided by $58,370.

Let's do the math: $10,509 divided by $58,370 gives me approximately 0.1805.

Now, to express this as a percentage, I'll multiply by 100. So, 0.1805 times 100 gives me 18.05%.

Therefore, about 18.05% of the estimated amortization expense for the years 2017 through 2022 will be recognized in 2017.

</think>
About 18.05% of the estimated amortization expense for the years 2017 through 2022 will be recognized in 2017.
एक और प्रश्न पूछते हैं।
question = dataset[10]['Open-ended Verifiable Question']

inputs = tokenizer(
    [prompt_style.format(question, "") + tokenizer.eos_token],
    return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs.input_ids,
    attention_mask=inputs.attention_mask,
    max_new_tokens=1200,
    eos_token_id=tokenizer.eos_token_id,
    use_cache=True,
)
response = tokenizer.batch_decode(outputs, skip_special_tokens=True)
print(response[0].split("### Response:")[1])
जैसा कि हम देख सकते हैं, हमने नए डेटासेट पर मॉडल को सफलतापूर्वक फाइन-ट्यून कर लिया है। अब यह सटीक है और तर्क व उत्तर की शैली का पालन करता है।
<think>


Alright, let's figure out the total purchase price of Impella Cardiosystems. First, we know the purchase price was $45.1 million, but there's a contingent payment of $5.6 million that could be earned. So, we need to see if we can figure out how much of that $5.6 million is actually likely to be paid.

Now, the question mentions that the contingent payment is triggered by FDA approvals. Since we're dealing with a medical device, getting FDA clearance is pretty important. Let's assume that the FDA approval for the Impella 2.5 is a good sign that the contingent payments will be made.

Okay, so if we assume all the contingent payments are earned, we just need to add the $5.6 million to the original $45.1 million. Let's do the math: $45.1 million plus $5.6 million equals $50.7 million.

Hmm, let's double-check our work. We're adding $45.1 million to $5.6 million, which gives us $50.7 million. Yep, that seems right.

So, if we assume all the contingent payments are earned, the total purchase price of Impella Cardiosystems would be $50.7 million.

</think>
The total purchase price of Impella Cardiosystems, assuming all contingent consideration is earned, would be $50.7 million.
किसी मॉडल को फाइन-ट्यून करना विशेषज्ञता, धन और समय माँगता है। कई मामलों में, आपकी आवश्यकताओं के लिए बेहतर RAG पाइपलाइन ही पर्याप्त हो सकती है। कृपया यह गाइड पढ़ें RAG vs Fine-Tuning: A Comprehensive Tutorial with Practical Examples ताकि आप अपनी आवश्यकताओं को समझ सकें।
सबसे पहले, हम मॉडल और टोकनाइज़र को लोकली सहेजेंगे।
new_model_online = "kingabzpro/Gemma-3-4B-Fin-QA-Reasoning"
new_model_local = "Gemma-3-4B-Fin-QA-Reasoning"
model.save_pretrained(new_model_local) # Local saving
tokenizer.save_pretrained(new_model_local)
फिर, हम मॉडल को Hugging Face Hub पर पुश करेंगे।
model.push_to_hub(new_model_online) # Online saving
tokenizer.push_to_hub(new_model_online) # Online saving
यह प्रक्रिया पहले मॉडल रिपॉज़िटरी बनाएगी और फिर मॉडल, टोकनाइज़र और कॉन्फ़िगरेशन से जुड़े सभी फ़ील्ड्स को रिमोट सर्वर पर पुश करेगी।
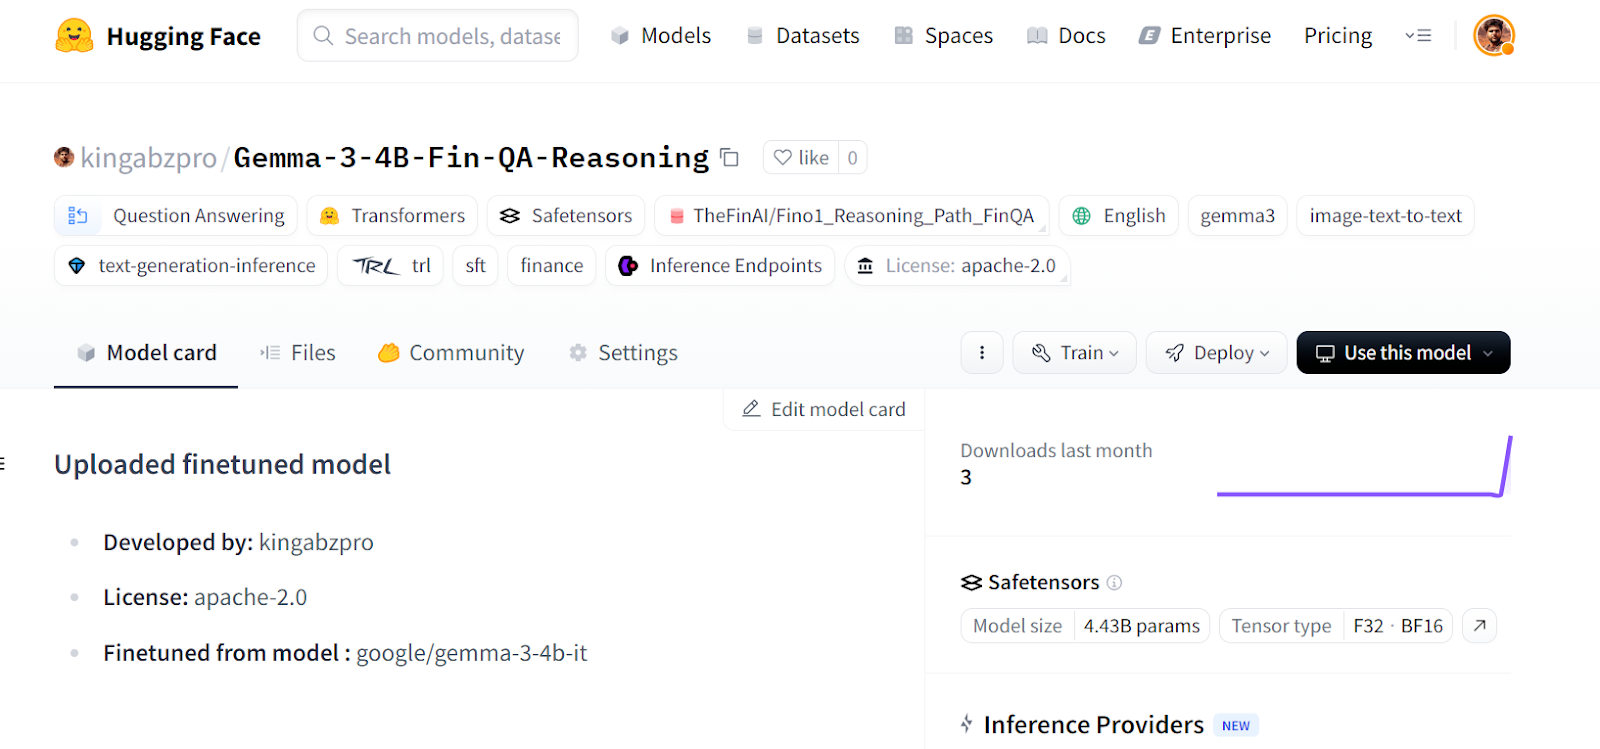
स्रोत: kingabzpro/Gemma-3-4B-Fin-QA-Reasoning · Hugging Face
यदि आपको उपरोक्त कोड चलाने में समस्या आ रही है, तो हमने एक Kaggle नोटबुक तैयार की है जिसे कोई भी क्लोन कर सकता है और स्वयं चलाकर प्रक्रिया को बेहतर ढंग से समझ सकता है।
Gemma 3 मॉडल को फाइन-ट्यून करना चुनौतियों के साथ आता है; आपको हार्डवेयर समस्याएँ, लाइब्रेरी समस्याएँ, मेमोरी फ्रैगमेंटेशन समस्याएँ, और भी बहुत कुछ मिल सकता है। यह गाइड एक सरल इम्प्लीमेंटेशन प्रदान करता है कि आप किसी भी मॉडल को तर्क मॉडल में कैसे बदल सकते हैं और सॉफ़्टवेयर व हार्डवेयर से जुड़ी भविष्य की समस्याओं से कैसे बच सकते हैं।
इस ट्यूटोरियल में, हमने Gemma 3 मॉडल की विशेषताओं को कवर किया और कैसे हम इसे Kaggle पर उपलब्ध मुफ़्त GPU संसाधनों का उपयोग करके तर्क डेटासेट पर आसानी से फाइन-ट्यून कर सकते हैं।
यह कोर्स करें Fine-tuning with Llama 3 ताकि आप TorchTune का उपयोग करके फाइन-ट्यूनिंग कार्य कर सकें, और क्वांटाइज़ेशन जैसी कुशल फाइन-ट्यूनिंग तकनीकों को सीख सकें।
शीर्ष DataCamp कोर्स
लर्निंग पाथ
कोर्स
कोर्स