
Kursus
Pengantar LLM di Python
3 jam
36.5K
Microsoft telah bergabung dalam persaingan model bahasa besar bersama Meta AI dengan memperkenalkan seri Phi-3.5. Seri ini mencakup model bahasa kecil, model bahasa visi, dan menerapkan pendekatan Mixture-of-Experts untuk mencapai kinerja kelas atas.
Dalam tutorial ini, kita akan mengeksplorasi keluarga model Microsoft Phi-3.5. Kita akan memuat model Phi-3.5-mini-instruct dan melakukan fine-tuning untuk mengklasifikasikan produk e-commerce berdasarkan deskripsi teksnya. Pada langkah terakhir, kita akan menunjukkan cara menggabungkan LoRA (Low-Rank Adaptation) dengan model dasar dan mendorongnya ke Hugging Face. Ini akan memungkinkan deployment cloud yang efisien, sehingga model dapat diakses untuk berbagai aplikasi.
Ikuti kursus Master Large Language Models (LLMs) Concepts dan pelajari aplikasi LLM, metodologi pelatihan, pertimbangan etis, dan riset terbaru.
Gambar oleh Penulis
Rilis Microsoft Phi-3.5 memperkenalkan tiga model inovatif: Phi-3.5-mini, Phi-3.5-vision, dan tambahan terbaru, Phi-3.5-MoE, sebuah model Mixture-of-Experts.
Phi-3.5-mini dioptimalkan untuk dukungan multibahasa yang lebih baik dengan panjang konteks 128K yang mengesankan. Meski ukurannya lebih kecil, performanya menyaingi model yang lebih besar berkat peningkatan ketat melalui supervised fine-tuning, proximal policy optimization, dan direct preference optimization, memastikan kepatuhan instruksi yang presisi.
Phi-3.5-vision adalah model multimodal mutakhir yang ringan, dilatih pada dataset yang terdiri dari data sintetis dan situs web publik yang difilter. Model ini unggul dalam pemahaman dan penalaran gambar multi-bingkai, ideal untuk perbandingan gambar terperinci, peringkasan/bercerita multi-gambar, dan peringkasan video, dengan potensi aplikasi yang luas.
Model unggulan, Phi-3.5-MoE, menampilkan arsitektur Mixture-of-Experts dengan 16 expert dan 6,6 miliar parameter aktif. Model ini menawarkan kinerja luar biasa dengan latensi yang lebih rendah dan keamanan yang kuat, serta dukungan multibahasa yang komprehensif.
Keluarga model Phi-3.5 menawarkan solusi hemat biaya dan berkinerja tinggi bagi komunitas open-source, memajukan model bahasa kecil dan AI generatif.
Untuk mempelajari arsitektur, fitur, dan aplikasi Phi-3, ikuti panduan Tutorial Phi-3: Praktik Langsung dengan Model AI Terkecil Microsoft.
Di bagian ini, kita akan memuat model Phi-3.5-mini-instruct dan menjalankan inferensi model di platform Kaggle.
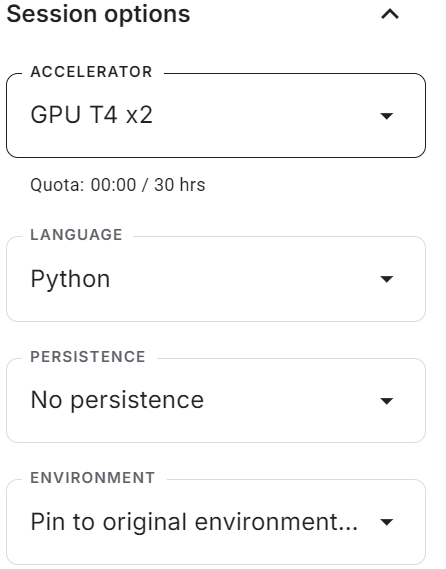
pip.%%capture
%pip install -U transformers acceleratetext-generation dengan model dan tokenizer. from transformers import AutoTokenizer,AutoModelForCausalLM,pipeline
import torch
base_model = "microsoft/Phi-3.5-mini-instruct"
tokenizer = AutoTokenizer.from_pretrained(base_model)
model = AutoModelForCausalLM.from_pretrained(
base_model,
return_dict=True,
low_cpu_mem_usage=True,
torch_dtype=torch.float16,
device_map="auto",
trust_remote_code=True,
)
pipe = pipeline(
"text-generation",
model=model,
tokenizer=tokenizer,
torch_dtype=torch.float16,
device_map="auto",
)messages = [
{"role": "system", "content": "You are a helpful assistant."},
{"role": "user", "content": "What is the tallest building in the world?"}
]
# Apply the chat template to the messages
prompt = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)
# Generate the output using the pipeline
outputs = pipe(prompt, max_new_tokens=120, do_sample=True)
# Print the generated text
print(outputs[0]["generated_text"])Kita mendapatkan hasil yang akurat dan terperinci.
<|system|>
You are a helpful assistant.<|end|>
<|user|>
What is the tallest building in the world?<|end|>
<|assistant|>
As of my knowledge cutoff in 2023, the tallest building in the world is the Burj Khalifa, located in Dubai, United Arab Emirates. It stands at a remarkable 828 meters (2,716.5 feet) tall once its antenna is included. Completed in January 2010, the Burj Khalifa marks a significant achievement in architecture and engineering, setting numerous records. It provides office space, luxury condominiums, and various leisure facilities. This landmark continues toprompt = """
In a call center environment, classify customer interactions as 'Fraudulent' or 'Non-Fraudulent'.
Consider factors such as the nature of the inquiry, caller verification details, transaction history, and any red flags raised during the call.
[Lisa Adams, contacts the call center claiming unauthorized transactions on her credit card statement. She demands a full refund, asserting that she has never visited the merchant in question.] =
"""
outputs = pipe(prompt, max_new_tokens=120, do_sample=True)
print(outputs[0]["generated_text"])Seperti yang terlihat, model berkinerja cukup baik, menandai panggilan sebagai penipuan dan memberikan penjelasan.
 In a call center environment, classify customer interactions as 'Fraudulent' or 'Non-Fraudulent'.
        Consider factors such as the nature of the inquiry, caller verification details, transaction history, and any red flags raised during the call.
        [Lisa Adams, contacts the call center claiming unauthorized transactions on her credit card statement. She demands a full refund, asserting that she has never visited the merchant in question.] =

        Call Interaction Classification: Fraudulent

        Explanation:
        The situation described by Lisa Adams indicates a potential case of credit card fraud. There are several red flags in this interaction that suggest the customer might be reporting unauthorized transactions:

1. The caller claims unauthorized transactions - This is a common indicator of fraud, especially if the transactions were for places or services the customer did not recognize or didn't patronize according to their personal knowledge or documented transaction history (e.g., no visits to the
Jika Anda mengalami masalah saat menjalankan model di platform Kaggle, silakan lihat Simple Model Inference of Phi-3.5 notebook Kaggle. Notebook ini dilengkapi pengaturan dan kode yang sudah disiapkan beserta outputnya.
Dalam panduan ini, kita akan mempelajari cara memuat dan memproses data klasifikasi teks E-commerce. Kita juga akan memuat model dan tokenizer, mengevaluasi model pada dataset uji sebelum fine-tuning, membangun trainer, melakukan fine-tuning model pada set pelatihan, dan menguji model setelah fine-tuning.
Jika Anda baru dalam proses ini, pastikan membaca panduan kami, Panduan Pengantar Fine-Tuning LLM, dan pelajari teori di balik fine-tuning LLM.
Luncurkan notebook Kaggle baru dengan akselerasi GPU diaktifkan. Lalu, pastikan Anda telah menetapkan token API Hugging Face dan Weights & Biases sebagai variabel lingkungan menggunakan Kaggle secrets.
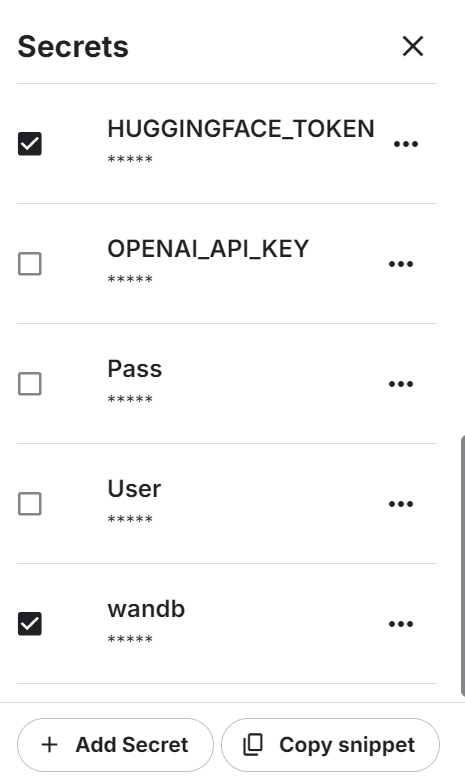
Instal semua paket Python yang diperlukan.
%%capture
%pip install -U bitsandbytes
%pip install -U transformers
%pip install -U accelerate
%pip install -U peft
%pip install -U trl
Masuk ke layanan Weights and Biases, tanda tangani kunci API, dan mulai proyek baru.
import wandb

from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()

wb_token = user_secrets.get_secret("wandb")

wandb.login(key=wb_token)
run = wandb.init(
    project='Fine-tune Phi-3.5-it on Ecommerce Text Classification',
    job_type="training",
    anonymous="allow"
Terakhir, muat semua paket dan fungsi Python yang diperlukan yang akan kita gunakan selama proses fine-tuning dan evaluasi.
import numpy as np
import pandas as pd
import os
from tqdm import tqdm
import bitsandbytes as bnb
import torch
import torch.nn as nn
import transformers
from datasets import Dataset
from peft import LoraConfig, PeftConfig
from trl import SFTTrainer
from trl import setup_chat_format
from transformers import (AutoModelForCausalLM,
                          AutoTokenizer,
                          BitsAndBytesConfig,
                          TrainingArguments,
                          pipeline,
                          logging)
from sklearn.metrics import (accuracy_score,
                             classification_report,
                             confusion_matrix)
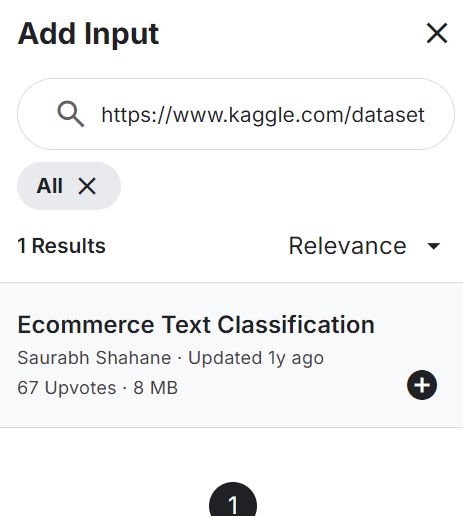
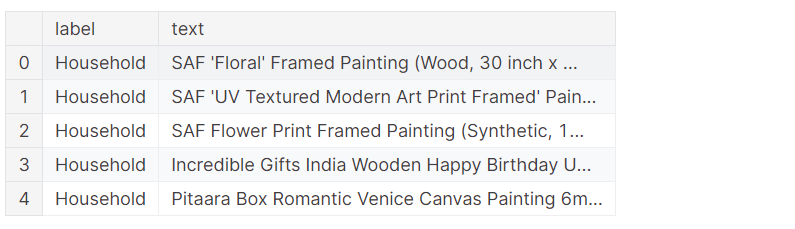
from sklearn.model_selection import train_test_splitTambahkan dataset E-commerce Text Classification ke notebook Anda, seperti ditunjukkan di bawah. Dataset terdiri dari dua kolom: label (kategori e-commerce) dan deskripsi teks produk.
Muat file CSV, proses, dan lihat 5 baris teratas.
df = pd.read_csv("/kaggle/input/ecommerce-text-classification/ecommerceDataset.csv")
df.columns = ["label","text"]
df.loc[:,'label'] = df.loc[:,'label'].str.replace('Clothing & Accessories','Clothing')
df.head()
Dataset berisi deskripsi produk dan label kategori.
Acak dataset dan pilih hanya 2000 baris teratas. Ini adalah panduan contoh, dimaksudkan untuk mempercepat proses fine-tuning dengan melakukan fine-tuning model pada kumpulan sampel terbatas.
Selanjutnya, kita akan membagi data menjadi dataset pelatihan, evaluasi, dan uji.
# Shuffle the DataFrame and select only 2000 rows
df = df.sample(frac=1, random_state=85).reset_index(drop=True).head(2000)

# Split the DataFrame
train_size = 0.8
eval_size = 0.1

# Calculate sizes
train_end = int(train_size * len(df))
eval_end = train_end + int(eval_size * len(df))

# Split the data
X_train = df[:train_end]
X_eval = df[train_end:eval_end]
X_test = df[eval_end:]
Kita akan membuat dua fungsi. Fungsi generate_prompt akan mengonversi kolom teks ke dalam prompt, termasuk instruksi, deskripsi teks, dan label. Fungsi generate_test_prompt sama, tetapi tanpa label.
# Define the prompt generation functions
def generate_prompt(data_point):
    return f"""
            Classify the E-commerce text into Electronics, Household, Books and Clothing.
text: {data_point["text"]}
label: {data_point["label"]}""".strip()

def generate_test_prompt(data_point):
    return f"""
            Classify the E-commerce text into Electronics, Household, Books and Clothing.
text: {data_point["text"]}
label: """.strip()

# Generate prompts for training and evaluation data
X_train.loc[:,'text'] = X_train.apply(generate_prompt, axis=1)
X_eval.loc[:,'text'] = X_eval.apply(generate_prompt, axis=1)

# Generate test prompts and extract true labels
y_true = X_test.loc[:,'label']
X_test = pd.DataFrame(X_test.apply(generate_test_prompt, axis=1), columns=["text"])
Konversi dataframe data pelatihan dan evaluasi pandas menjadi dataset Hugging Face.
# Convert to datasets
train_data = Dataset.from_pandas(X_train[["text"]])
eval_data = Dataset.from_pandas(X_eval[["text"]])

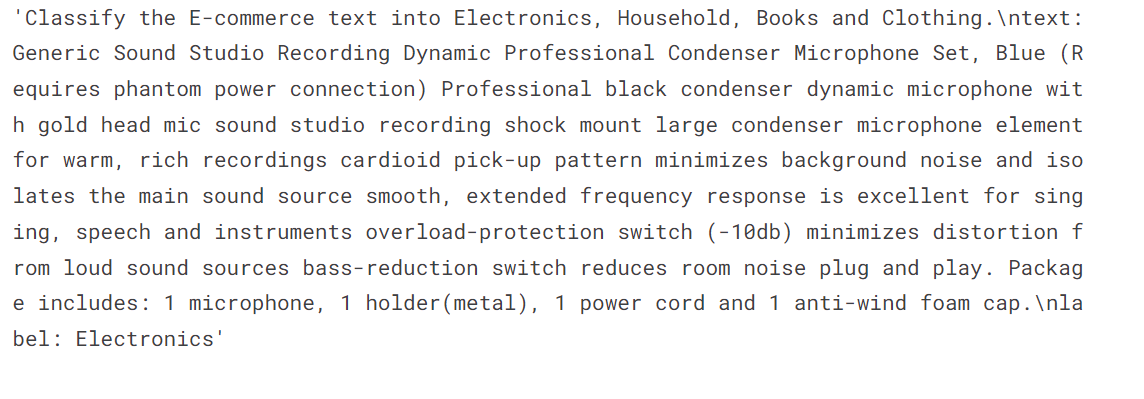
train_data['text'][3]
Teks terdiri dari instruksi sistem, deskripsi teks produk, dan label.
Muat model terkuantisasi 4-bit dan tokenizer dari Hugging Face Hub menggunakan ID repositori. Lalu, siapkan model dan tokenizer agar siap digunakan.
base_model_name = "microsoft/Phi-3.5-mini-instruct"

bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_use_double_quant=False,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype="float16",
)

model = AutoModelForCausalLM.from_pretrained(
    base_model_name,
    device_map="auto",
    torch_dtype="float16",
    quantization_config=bnb_config,
)

model.config.use_cache = False
model.config.pretraining_tp = 1

tokenizer = AutoTokenizer.from_pretrained(base_model_name)

tokenizer.pad_token_id = tokenizer.eos_token_idKita perlu mengevaluasi model dasar sebelum fine-tuning untuk menentukan apakah fine-tuning meningkatkan hasil atau tidak. Untuk ini, kita akan membuat fungsi predict yang mengambil dataset uji dan menghasilkan kategori e-commerce berdasarkan produk dan deskripsi teks.
def predict(test, model, tokenizer):
    y_pred = []
    categories = ["Electronics", "Household", "Books", "Clothing"]

    for i in tqdm(range(len(test))):
        prompt = test.iloc[i]["text"]
        pipe = pipeline(task="text-generation",
                        model=model,
                        tokenizer=tokenizer,
                        max_new_tokens=4,
                        temperature=0.1)

        result = pipe(prompt)
        answer = result[0]['generated_text'].split("label:")[-1].strip()

        # Determine the predicted category
        for category in categories:
            if category.lower() in answer.lower():
                y_pred.append(category)
                break
        else:
            y_pred.append("none")

    return y_pred

y_pred = predict(X_test, model, tokenizer)
Kita memiliki daftar kategori yang diprediksi, dan sekarang kita akan membandingkannya dengan kategori aktual untuk menghasilkan laporan evaluasi model. Fungsi "evaluate" mengambil daftar kategori yang diprediksi dan aktual serta menghasilkan laporan evaluasi terperinci. Laporan ini mencakup akurasi rata-rata, akurasi individual untuk setiap kategori, classification report, dan confusion matrix.
def evaluate(y_true, y_pred):
    labels = ["Electronics", "Household", "Books", "Clothing"]
    mapping = {label: idx for idx, label in enumerate(labels)}

    def map_func(x):
        return mapping.get(x, -1)  # Map to -1 if not found, but should not occur with correct data

    y_true_mapped = np.vectorize(map_func)(y_true)
    y_pred_mapped = np.vectorize(map_func)(y_pred)

    # Calculate accuracy
    accuracy = accuracy_score(y_true=y_true_mapped, y_pred=y_pred_mapped)
    print(f'Accuracy: {accuracy:.3f}')

    # Generate accuracy report
    unique_labels = set(y_true_mapped)  # Get unique labels

    for label in unique_labels:
        label_indices = [i for i in range(len(y_true_mapped)) if y_true_mapped[i] == label]
        label_y_true = [y_true_mapped[i] for i in label_indices]
        label_y_pred = [y_pred_mapped[i] for i in label_indices]
        label_accuracy = accuracy_score(label_y_true, label_y_pred)
        print(f'Accuracy for label {labels[label]}: {label_accuracy:.3f}')

    # Generate classification report
    class_report = classification_report(y_true=y_true_mapped, y_pred=y_pred_mapped, target_names=labels, labels=list(range(len(labels))))
    print('\nClassification Report:')
    print(class_report)

    # Generate confusion matrix
    conf_matrix = confusion_matrix(y_true=y_true_mapped, y_pred=y_pred_mapped, labels=list(range(len(labels))))
    print('\nConfusion Matrix:')
    print(conf_matrix)


evaluate(y_true, y_pred)
Kita mencapai akurasi rata-rata 65%. Mari kita lihat apakah fine-tuning dapat meningkatkan skor ini.
Accuracy: 0.645
Accuracy for label Electronics: 0.950
Accuracy for label Household: 0.531
Accuracy for label Books: 0.561
Accuracy for label Clothing: 0.658

Classification Report:
              precision    recall  f1-score   support

 Electronics       0.46      0.95      0.62        40
   Household       0.83      0.53      0.65        81
       Books       0.96      0.56      0.71        41
    Clothing       0.86      0.66      0.75        38

   micro avg       0.69      0.65      0.67       200
   macro avg       0.78      0.67      0.68       200
weighted avg       0.79      0.65      0.67       200


Confusion Matrix:
[[38  0  1  0]
 [33 43  0  2]
 [ 9  6 23  2]
[ 2 3 0 25]]Ekstrak nama modul linear dari model.
def find_all_linear_names(model):
    cls = bnb.nn.Linear4bit
    lora_module_names = set()
    for name, module in model.named_modules():
        if isinstance(module, cls):
            names = name.split('.')
            lora_module_names.add(names[0] if len(names) == 1 else names[-1])
    if 'lm_head' in lora_module_names:  # needed for 16 bit
        lora_module_names.remove('lm_head')
    return list(lora_module_names)
modules = find_all_linear_names(model)
modules
['gate_up_proj', 'down_proj', 'qkv_proj', 'o_proj']Gunakan nama modul linear untuk membuat LoRA. Kita hanya akan melakukan fine-tuning pada LoRA dan membiarkan bagian model lainnya agar menghemat memori dan mempercepat waktu pelatihan.
Selanjutnya, konfigurasikan hyperparameter model untuk lingkungan Kaggle. Anda dapat mengubah parameter ini untuk meningkatkan akurasi dan mengurangi waktu pelatihan berdasarkan mesin Anda. Untuk mempelajari setiap hyperparameter ikuti tutorial Fine-Tuning Llama 2.
Sekarang kita akan menyiapkan trainer supervised fine-tuning (SFT) dan menyediakan dataset pelatihan dan evaluasi, konfigurasi LoRA, argumen pelatihan, tokenizer, dan model.
output_dir="Phi-3.5-mini-instruct"

peft_config = LoraConfig(
    lora_alpha=16,
    lora_dropout=0,
    r=64,
    bias="none",
    task_type="CAUSAL_LM",
    target_modules=modules,
)

training_arguments = TrainingArguments(
    output_dir=output_dir,                    # directory to save and repository id
    num_train_epochs=1,                       # number of training epochs
    per_device_train_batch_size=1,            # batch size per device during training
    gradient_accumulation_steps=4,            # number of steps before performing a backward/update pass
    gradient_checkpointing=True,              # use gradient checkpointing to save memory
    optim="paged_adamw_8bit",
    logging_steps=1,
    learning_rate=2e-5,                       # learning rate, based on QLoRA paper
    weight_decay=0.001,
    fp16=False,
    bf16=False,
    max_grad_norm=0.3,                        # max gradient norm based on QLoRA paper
    max_steps=-1,
    warmup_ratio=0.03,                        # warmup ratio based on QLoRA paper
    group_by_length=False,
    lr_scheduler_type="cosine",               # use cosine learning rate scheduler
    report_to="wandb",                  # report metrics to w&b
    eval_strategy="steps",              # save checkpoint every epoch
    eval_steps = 0.2
)

trainer = SFTTrainer(
    model=model,
    args=training_arguments,
    train_dataset=train_data,
    eval_dataset=eval_data,
    peft_config=peft_config,
    dataset_text_field="text",
    tokenizer=tokenizer,
    max_seq_length=512,
    packing=False,
    dataset_kwargs={
    "add_special_tokens": False,
    "append_concat_token": False,
    }
)Kita akan menggunakan fungsi .train untuk memulai proses fine-tuning.
# Train model
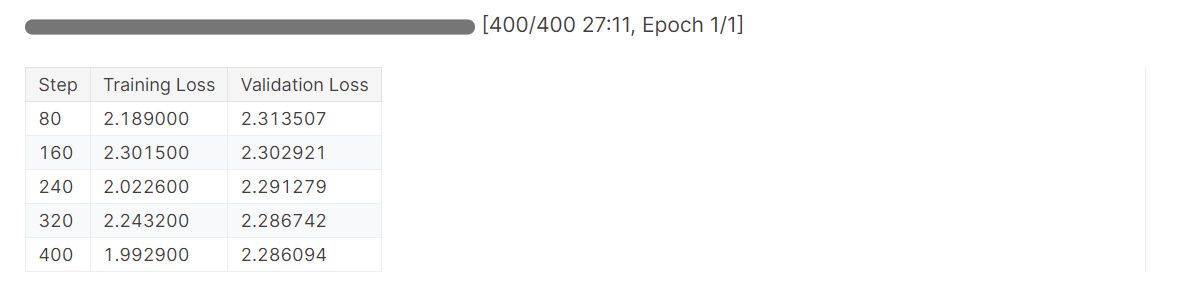
trainer.train()
Loss berangsur turun, dan kita bisa mendapatkan hasil yang lebih baik lagi dengan lebih banyak epoch.
Selesaikan run Weights & Biases untuk menghasilkan laporan evaluasi.
wandb.finish()
model.config.use_cache = True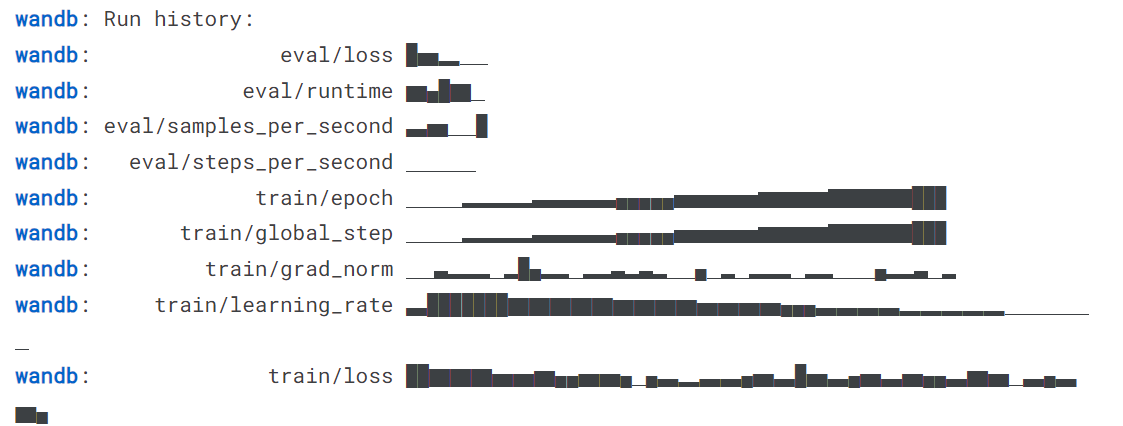
Anda dapat menganalisis performa model dengan mengunjungi situs Weights & Biases, memilih proyek Anda, dan melihat analisis pelatihan.
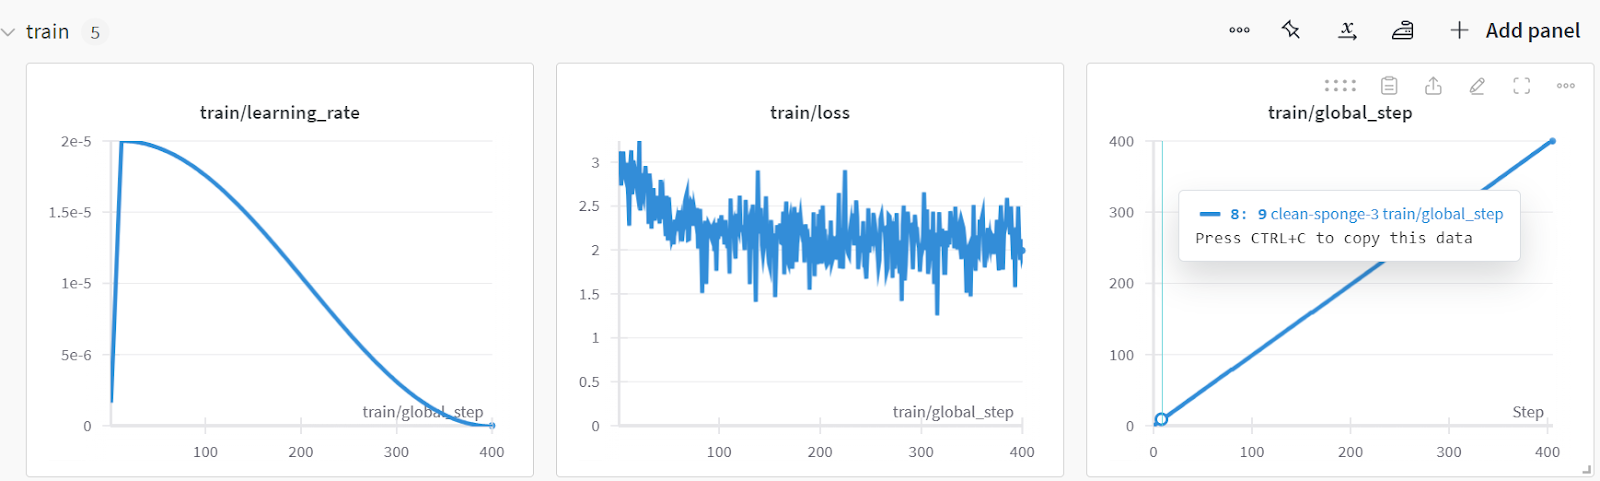
Simpan model dan tokenizer secara lokal agar nantinya dapat kita gunakan untuk penggabungan model dan mendorongnya ke server jarak jauh.
# Save trained model and tokenizer
trainer.save_model(output_dir)
tokenizer.save_pretrained(output_dir)
Panduan ini cukup sarat kode. Jika Anda mencari solusi yang lebih sederhana, Anda dapat melakukan fine-tuning model open-source dengan mengikuti tutorial Panduan Pemula LlaMA-Factory WebUI: Fine-Tuning LLM. Untuk solusi yang lebih sederhana lagi di mana Anda tidak perlu khawatir soal perangkat keras, kami sangat merekomendasikan tutorial Fine-tuning GPT-4o Mini: Panduan Langkah demi Langkah. Ini akan membantu Anda melakukan fine-tuning di cloud dengan sedikit kode.
Mari uji apakah performa model meningkat setelah fine-tuning. Pertama, kita akan menghasilkan daftar label prediksi dan memberikannya ke fungsi evaluate bersama label aktual.
y_pred = predict(X_test, model, tokenizer)
evaluate(y_true, y_pred)
Akurasi model meningkat sekitar 32,31%, dan metrik performa lainnya terlihat sangat baik. Selain kategori Books, model mampu mengidentifikasi kategori dengan cukup akurat.
Accuracy: 0.860
Accuracy for label Electronics: 0.825
Accuracy for label Household: 0.926
Accuracy for label Books: 0.683
Accuracy for label Clothing: 0.947

Classification Report:
              precision    recall  f1-score   support

 Electronics       0.97      0.82      0.89        40
   Household       0.88      0.93      0.90        81
       Books       0.90      0.68      0.78        41
    Clothing       0.88      0.95      0.91        38

   micro avg       0.90      0.86      0.88       200
   macro avg       0.91      0.85      0.87       200
weighted avg       0.90      0.86      0.88       200


Confusion Matrix:
[[33  6  1  0]
 [ 1 75  2  3]
 [ 0  3 28  2]
 [ 0  1  0 36]]
Pastikan menyimpan notebook Kaggle dengan mengeklik tombol "Save Version" di kanan atas. Lalu, pilih opsi quick save dan ubah opsi penyimpanan output untuk menyertakan penyimpanan file model dan seluruh kode.
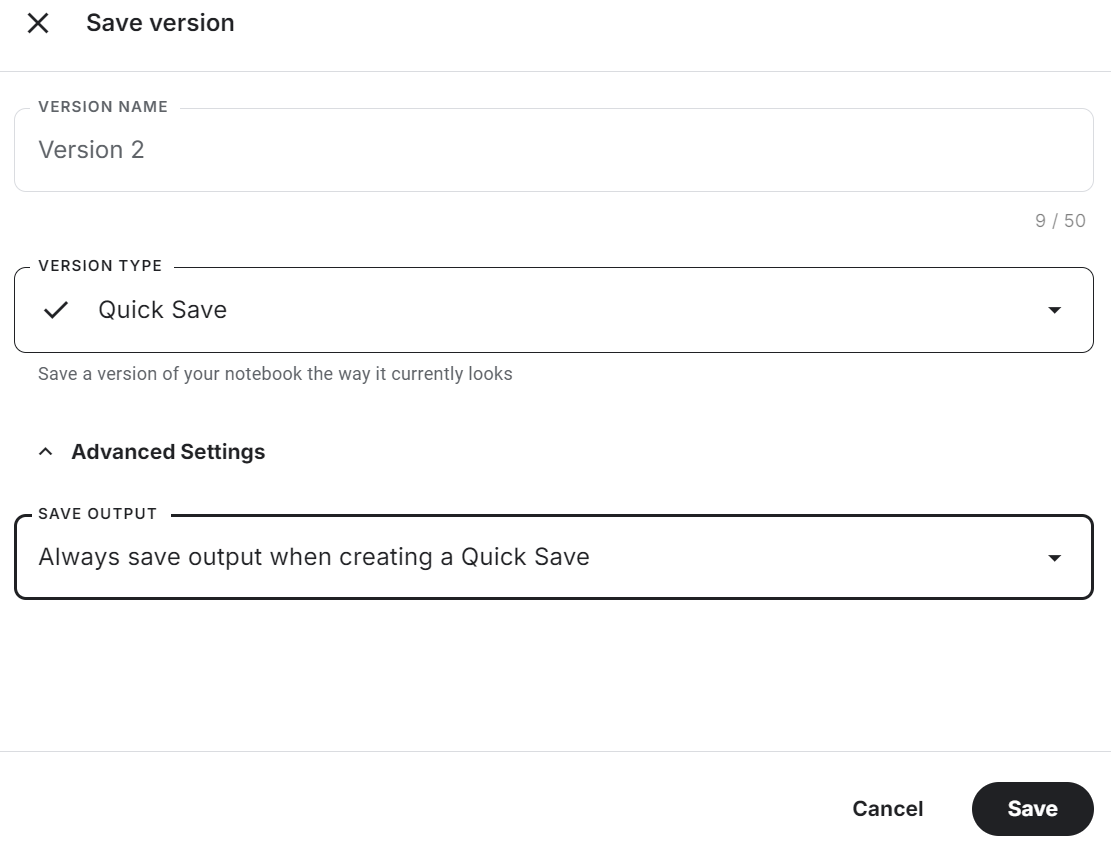
Jika Anda mengalami kendala saat melakukan fine-tuning model, silakan lihat notebook Kaggle Fine-tune Phi-3.5 for Text Classification Kaggle notebook.
Untuk menggabungkan dan mengekspor model ke Hugging Face, pertama-tama kita akan membuat notebook Kaggle baru dan menambahkan notebook yang telah disimpan untuk mengakses model dan tokenizer yang telah di-fine-tune.
Menambahkan notebook Kaggle lain mirip dengan menambahkan dataset dan model. Klik tombol “+ Add Input”, tempel tautan notebook, lalu tekan tombol add.
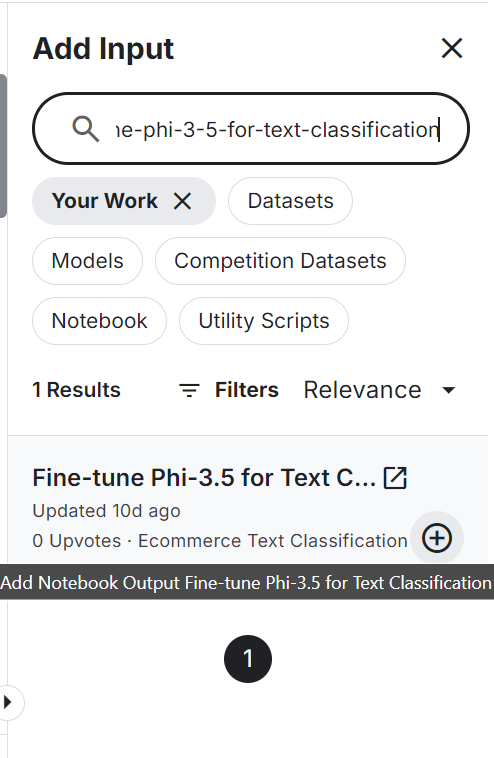
Menetapkan API Hugging Face sebagai variabel lingkungan menggunakan Kaggle secrets dan menginstal semua paket Python yang diperlukan untuk memuat dan menggabungkan model.
%%capture
%pip install -U bitsandbytes
%pip install -U transformers
%pip install -U accelerate
%pip install -U peft
Tetapkan variabel model dasar dan model yang di-fine-tune dengan ID model dan lokasi adaptor model.
# Model
base_model = "microsoft/Phi-3.5-mini-instruct"
fine_tuned_model = "/kaggle/input/fine-tune-phi-3-5-for-text-classification/Phi-3.5-mini-instruct/"
Muat model lengkap dari Hugging Face hub beserta tokenizer.
from transformers import AutoModelForCausalLM, AutoTokenizer, pipeline
from peft import PeftModel
import torch
# Reload tokenizer and model
tokenizer = AutoTokenizer.from_pretrained(base_model)

base_model_reload = AutoModelForCausalLM.from_pretrained(
        base_model,
        return_dict=True,
        low_cpu_mem_usage=True,
        torch_dtype=torch.float16,
        device_map="auto",
        trust_remote_code=True,
)
Gabungkan model dasar dengan adaptor menggunakan dua baris kode.
# Merge adapter with base model
model = PeftModel.from_pretrained(base_model_reload, fine_tuned_model)
model = model.merge_and_unload()
Untuk menguji apakah model berhasil digabungkan, kita akan membuat pipeline generasi teks dengan model dan tokenizer yang telah digabungkan, lalu mengoperkan contoh prompt untuk menghasilkan respons.
text = "Inalsa Dazzle Glass Top, 3 Burner Gas Stove with Rust Proof Powder Coated Body, Black Toughened Glass Top, 2 Medium and 1 Small High Efficiency Brass Burners, Aluminum Mixing Tubes, Powder Coated Body, Inbuilt Stainless Steel Drip Trays, 360 degree Swivel Nozzle,Bigger Legs to Facilitate Cleaning Under Cooktop"
prompt = f"""Classify the E-commerce text into Electronics, Household, Books and Clothing.
text: {text}
label: """.strip()

pipe = pipeline(
    "text-generation",
    model=model,
    tokenizer=tokenizer,
    torch_dtype=torch.float16,
    device_map="auto",
)

outputs = pipe(prompt, max_new_tokens=4, do_sample=True, temperature=0.1)
print(outputs[0]["generated_text"].split("label: ")[-1].strip())1].strip())
Model berhasil memprediksi kategori produk dengan akurat.
HouseholdKita akan menyimpan model lengkap secara lokal dengan memberikan direktori modelnya.
model_dir = "Phi-3.5-mini-instruct-Ecommerce-Text-Classification"
model.save_pretrained(model_dir)
tokenizer.save_pretrained(model_dir)
Dorong model yang disimpan ke Hugging Face hub. Pertama, masuk ke CLI Hugging Face menggunakan kunci API yang diambil dari Kaggle secrets, lalu gunakan fungsi push_to_hub untuk mendorong model dan tokenizer.
from huggingface_hub import login
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()

hf_token = user_secrets.get_secret("HUGGINGFACE_TOKEN")
login(token = hf_token)


model.push_to_hub(model_dir, use_temp_dir=False)
tokenizer.push_to_hub(model_dir, use_temp_dir=False)
Ini telah membuat repositori model baru dan mendorong semua file ke repositori model Hugging Face.
Sumber: kingabzpro/Phi-3.5-mini-instruct-Ecommerce-Text-Classification
Jika Anda mengalami kesulitan menggabungkan dan mengekspor model, silakan lihat notebook Kaggle Phi-3.5 Fine-tuned Adapter to the full model.
Selain itu, lihat juga tutorial terbaru kami tentang Fine-tuning Llama 3.2 dan Menggunakannya Secara Lokal: Panduan Langkah demi Langkah. Dalam tutorial ini, Anda akan belajar cara melakukan fine-tuning model pada dataset kustom menggunakan GPU gratis, menggabungkan dan mengekspor model ke Hugging Face Hub, serta mengonversi model yang telah di-fine-tune ke format GGUF agar dapat digunakan secara lokal dengan aplikasi Jan.
Model bahasa besar menjadi semakin kecil dan efisien, sehingga menurunkan biaya operasional dan meningkatkan adaptabilitas di berbagai bidang. Dalam tutorial ini, kita mengeksplorasi model Phi-3.5 Mini, Vision, dan MoE. Kita juga mempelajari cara mengakses model Phi-3.5 Mini menggunakan Kaggle Notebooks.
Selanjutnya, kita melakukan fine-tuning model pada data klasifikasi dan mengevaluasi performanya, mencapai peningkatan signifikan dari 65% menjadi 86% akurasi—sebuah pencapaian yang luar biasa. Performa seperti ini tidak dapat dicapai hanya melalui RAG atau function calling.
Terakhir, kita mengintegrasikan LoRA dengan model dasar dan mengekspor model lengkap ke Hugging Face Hub, sehingga tersedia untuk semua orang.
Langkah berikutnya dalam perjalanan Anda adalah membangun proyek dengan mengikuti daftar 12 Proyek LLM untuk Semua Tingkat. Daftar ini mencakup proyek LLM untuk pemula, menengah, mahasiswa tingkat akhir, dan pakar. Setiap proyek dilengkapi sumber kode, panduan visual, dan tautan pendukung.
Kursus LLM Teratas
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt




