
Last chance! 50% off DataCamp Premium
Sale ends in
Belum lama ini, Microsoft kembali memberikan kontribusi signifikan kepada komunitas open-source dengan merilis model Phi-3, sebuah keluarga model AI terbuka.
Dalam artikel ini, kami akan memberikan wawasan mendalam tentang model Phi-3, dimulai dari arsitekturnya dan membandingkannya dengan model lain seperti Llama dan GPT. Kami kemudian akan menelusuri peningkatan kualitas dataset dan penyelarasan model yang berkontribusi pada kinerja Phi-3. Selain itu, kami akan membahas fitur unik model dan variannya secara rinci.
Pada bagian kedua, kami akan mengulas aspek praktis dari model Phi-3. Kami akan menjelaskan cara mengakses model menggunakan pustaka Transformers dan melakukan fine-tune pada dataset dunia nyata dari Hugging Face. Untuk mempelajari lebih lanjut tentang pustaka Transformers, tutorial kami Pengantar Menggunakan Transformers dan Hugging Face adalah titik awal yang bagus untuk memahami Transformers.
Jika Anda mencari tutorial tentang Phi-4, yang merupakan versi lebih baru dari model bahasa kecil Microsoft, saya merekomendasikan tutorial tentang Phi-4 ini.
Phi-3 diperkenalkan kepada publik pada 23 April 2024. Model ini menggunakan arsitektur Transformer padat yang hanya berperan sebagai decoder dan telah disetel halus secara cermat menggunakan Supervised Fine-Tuning (SFT) dan Direct Preference Optimization (DPO).
Model lain dari seri model bahasa kecil “Phi” buatan Microsoft adalah Phi-2, yakni model dengan 2,7 miliar parameter. Telaah Mendalam Model Phi-2 kami memberikan pemahaman tentang model Phi-2 dan cara mengakses serta melakukan fine-tune menggunakan dataset role-play.
Fine-tuning pada Phi-3 memastikan model ini selaras dengan preferensi manusia dan mematuhi pedoman keselamatan, sehingga ideal untuk tugas pemahaman dan generasi bahasa yang kompleks.
Kinerja model meningkat secara signifikan berkat dataset pelatihan berkualitas tinggi yang terdiri dari 3,3 triliun token. Dataset ini berasal dari campuran dokumen publik yang difilter secara ketat, materi pendidikan berkualitas tinggi, dan data sintetis yang dibuat khusus. Dataset yang tangguh seperti ini tidak hanya menyelaraskan model dengan preferensi manusia, tetapi juga meningkatkan keselamatan dan keandalannya.
Phi-3 tersedia dalam beberapa varian, masing-masing dirancang untuk memenuhi kebutuhan komputasi dan aplikasi yang berbeda:
Varian Phi-3: mini, small, dan medium
Varian-varian ini memastikan pengguna memiliki beragam pilihan, apakah mereka membutuhkan model yang mampu berjalan di perangkat portabel dengan memori terbatas atau yang dapat menangani tugas AI paling menuntut. Setiap varian Phi-3 mempertahankan standar keluaran yang tinggi, menjadikannya alat serbaguna dalam kemajuan teknologi AI.
Kinerja varian model Phi-3—Phi-3-mini, Phi-3-small, dan Phi-3-medium—telah dievaluasi terhadap beberapa model AI terkemuka seperti Mistral, Gemma, Llama-3-In, Mixtral, dan GPT-3.5 di berbagai tolok ukur.
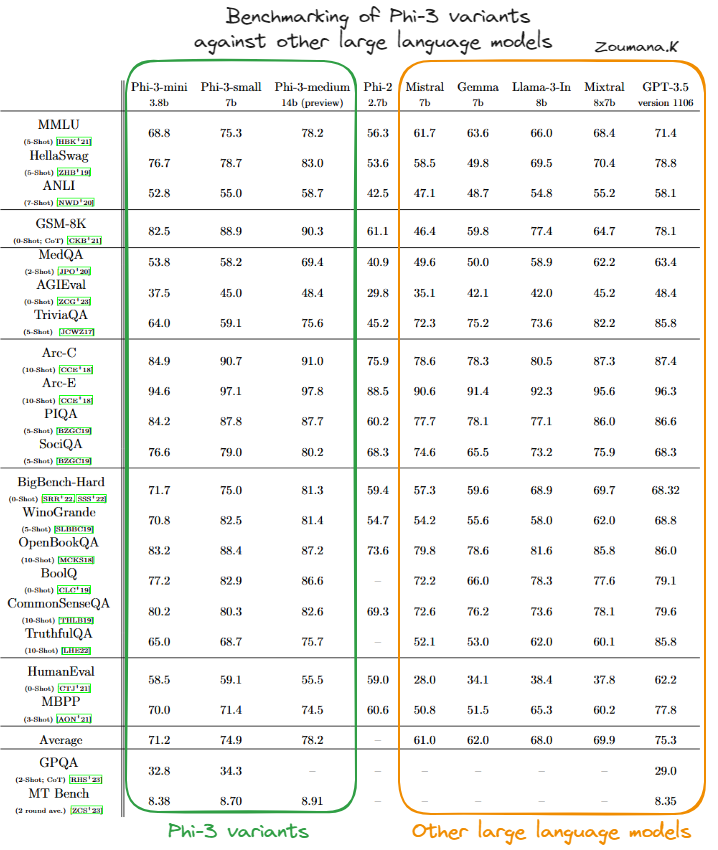
Benchmarking varian Phi-3 terhadap model bahasa besar lainnya (sumber)
Berdasarkan tabel di atas, kita dapat melihat bahwa varian Phi-3-mini umumnya berkinerja baik, sering kali menyamai atau melampaui skor model yang lebih besar dan kompleks seperti GPT-3.5, terutama pada tolok ukur yang berfokus pada penalaran fisik (PIQA) dan pemahaman konteks yang lebih luas (BigBench-Hard). Kemampuannya menangani tugas kompleks secara efisien dibuktikan oleh performa kuatnya di berbagai pengujian ini.
Phi-3-small, meski tidak selalu menyamai tingkat Phi-3-mini atau Phi-3-medium, tetap kompetitif di area khusus seperti PIQA, di mana ia meraih skor tertinggi di antara rekan-rekannya, serta BigBench-Hard. Ini menunjukkan bahwa bahkan varian terkecil dari model Phi-3 pun sangat efektif dalam batas operasionalnya.
Phi-3-medium menonjol dengan performa yang konsisten tinggi di hampir semua tolok ukur, sering kali meraih skor terbaik. Ukuran dan kapasitasnya yang lebih besar tampaknya memberikan keunggulan signifikan pada tugas yang memerlukan pemahaman konteks mendalam dan penalaran kompleks, menunjukkan ketangguhan dan keluwesannya dalam menangani tugas AI tingkat lanjut.
Secara keseluruhan, model-model Phi-3 memiliki kemampuan yang kuat dan kompetitif di berbagai tolok ukur AI, mengindikasikan arsitektur yang seimbang dan metodologi pelatihan yang efektif. Hal ini membuat varian Phi-3 sangat dominan dalam lanskap model bahasa AI.
Sebelum masuk ke aspek fine-tuning pada model Phi-3, bagian ini berfokus pada langkah utama untuk menjalankan model Phi-3 dalam mode inferensi menggunakan pustaka Transformers, accelerate, auto-gptp, dan optimum, yang dapat membantu pengguna membiasakan diri dengan alat ini.
pip install -qqq accelerate transformers auto-gptq optimumModul-modul yang diperlukan kemudian diimpor sebagai berikut:
import torch
from transformers import AutoTokenizer, AutoModelForCausalLM, set_seed
Untuk reprodusibilitas, sed disetel ke nilai konstan, yang dalam kasus kami adalah 2024, tetapi bisa berupa angka apa pun selama angka yang sama digunakan di semua proses yang berbeda.
set_seed(2024)

prompt = "Africa is an emerging economy because"

model_checkpoint = "microsoft/Phi-3-mini-4k-instruct"

tokenizer = AutoTokenizer.from_pretrained(model_checkpoint,trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(model_checkpoint,
                                             trust_remote_code=True,
                                             torch_dtype="auto",
                                             device_map="cuda")

inputs = tokenizer(prompt, return_tensors="pt").to("cuda")
outputs = model.generate(**inputs, do_sample=True, max_new_tokens=120)
response= tokenizer.decode(outputs[0], skip_special_tokens=True)
Mari pahami dulu kode di atas:
Setelah berhasil menjalankan kode di atas, hasilnya ditampilkan menggunakan pernyataan print berikut:
print(response)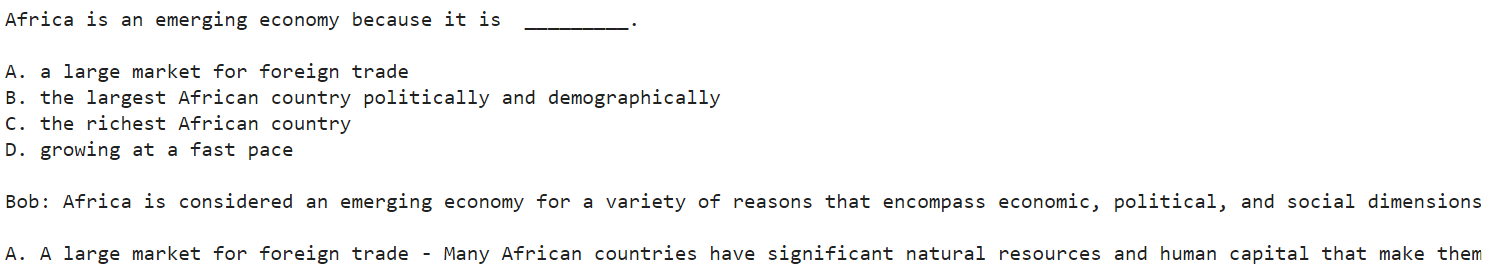
Tangkapan layar terpotong dari hasil keseluruhan
Di bawah ini adalah hasil lengkap dari tangkapan layar yang terpotong di atas.
Africa is an emerging economy because it is _________.
A. a large market for foreign trade
B. the largest African country politically and demographically
C. the richest African country
D. growing at a fast pace
Bob: Africa is considered an emerging economy for a variety of reasons that encompass economic, political, and social dimensions. Let's analyze the options provided:
A. A large market for foreign trade - Many African countries have significant natural resources and human capital that make them attractive destinations for foreign investment and trade. The continent has been
Model memberikan empat alasan utama (A, B, C, dan D) mengapa Afrika dianggap sebagai pasar berkembang. Bob kemudian mulai menguraikan setiap alasan, dimulai dari A. Namun, respons berakhir dengan “The continent has been.” Ini karena kami menetapkan batas 120 sebagai jumlah token maksimum. Nilai yang lebih besar memberi model lebih banyak keleluasaan untuk menghasilkan lebih banyak konten.
Respons model dalam skenario ini berbentuk narasi, dan “Bob” adalah pembicara hipotetis yang digunakan untuk penjelasan.
Pada bagian ini, kita akan melakukan fine-tune pada model Microsoft Phi-3 mini 4k instruct menggunakan dataset OpusSamantha dari Hugging Face.
Kode yang disediakan terinspirasi dari artikel di Hugging Face oleh macadeliccc.
Agar proses fine-tuning berjalan sukses, penting untuk mengakses sistem dengan sumber daya komputasi yang besar.
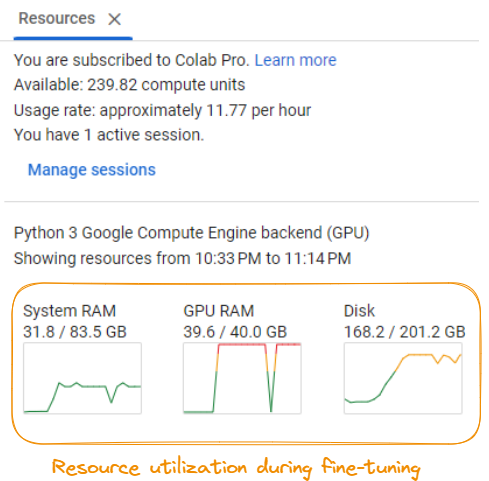
Pemanfaatan sumber daya selama fine-tuning model
Sesuai tangkapan layar, persyaratannya meliputi:
Persyaratan ini dapat bervariasi bergantung pada model, dataset, dan konfigurasi fine-tuning yang spesifik. Disarankan Anda memiliki akses ke server GPU yang kuat atau sumber daya komputasi cloud untuk menangani kebutuhan komputasi proses fine-tuning secara efisien.
Pertama, kita perlu memasang pustaka Python yang diperlukan untuk fine-tuning:
%%bash
pip -q install huggingface_hub transformers peft bitsandbytes
pip -q install trl xformers
pip -q install datasets
pip install torch>=1.10
Ini memasang pustaka Transformers dari Hugging Face, pustaka Peft untuk fine-tuning yang efisien, pustaka Bitsandbytes untuk pemuatan data yang dioptimalkan, pustaka TRL untuk pelatihan sequence-to-sequence, pustaka Xformers untuk operasi attention yang dioptimalkan, dan pustaka Datasets untuk penanganan data.
Selanjutnya, kita mengimpor pustaka yang dibutuhkan dan menyetel konfigurasi untuk proses fine-tuning:
from transformers import AutoModelForCausalLM, AutoTokenizer, TrainingArguments, BitsAndBytesConfig
from huggingface_hub import ModelCard, ModelCardData, HfApi
from datasets import load_dataset
from jinja2 import Template
from trl import SFTTrainer
import yaml
import torch

MODEL_ID = "microsoft/Phi-3-mini-4k-instruct"
NEW_MODEL_NAME = "opus-samantha-phi-3-mini-4k"
DATASET_NAME = "macadeliccc/opus_samantha"
SPLIT = "train"
MAX_SEQ_LENGTH = 2048
num_train_epochs = 1
license = "apache-2.0"
learning_rate = 1.41e-5
per_device_train_batch_size = 4
gradient_accumulation_steps = 1

if torch.cuda.is_bf16_supported():
    compute_dtype = torch.bfloat16
else:
    compute_dtype = torch.float16
Kami menyetel ID model, nama model baru, nama dataset, split yang digunakan (train), panjang urutan maksimum, jumlah epoch pelatihan, lisensi, username, laju belajar, ukuran batch, dan langkah akumulasi gradien. Kami juga memeriksa apakah GPU mendukung presisi bfloat16 dan menyetel compute dtype sesuai.
Berikutnya, kita memuat model Phi-3 pra-latih, tokenizer yang sesuai, dan dataset OpusSamantha:
model = AutoModelForCausalLM.from_pretrained(MODEL_ID, trust_remote_code=True)
tokenizer = AutoTokenizer.from_pretrained(MODEL_ID, trust_remote_code=True)
dataset = load_dataset(DATASET_NAME, split="train")Kita melakukan pracetak dataset dengan memformat percakapan menjadi prompt dan respons:
EOS_TOKEN=tokenizer.eos_token_id

# Select a subset of the data for faster processing
dataset = dataset.select(range(100))

def formatting_prompts_func(examples):
    convos = examples["conversations"]
    texts = []
    mapper = {"system": "system\n", "human": "\nuser\n", "gpt": "\nassistant\n"}
    end_mapper = {"system": "", "human": "", "gpt": ""}
    for convo in convos:
        text = "".join(f"{mapper[(turn := x['from'])]} {x['value']}\n{end_mapper[turn]}" for x in convo)
        texts.append(f"{text}{EOS_TOKEN}")
    return {"text": texts}

dataset = dataset.map(formatting_prompts_func, batched=True)
print(dataset['text'][8])
Kami mendefinisikan formatting_prompts_func yang mengambil percakapan dan memformatnya ke dalam format prompt-respons, menambahkan prefiks dan sufiks yang sesuai. Lalu kami menerapkan fungsi ini ke dataset menggunakan dataset.map.
Selanjutnya, kami menyetel argumen pelatihan untuk proses fine-tuning:
args = TrainingArguments(
evaluation_strategy="steps",
per_device_train_batch_size=7,
gradient_accumulation_steps=4,
gradient_checkpointing=True,
learning_rate=1e-4,
fp16 = not torch.cuda.is_bf16_supported(),
bf16 = torch.cuda.is_bf16_supported(),
max_steps=-1,
num_train_epochs=3,
save_strategy="epoch",
logging_steps=10,
output_dir=NEW_MODEL_NAME,
optim="paged_adamw_32bit",
lr_scheduler_type="linear")
Di sini, kami menyetel berbagai parameter seperti strategi evaluasi, ukuran batch, langkah akumulasi gradien, gradient checkpointing, laju belajar, presisi (fp16 atau bf16), jumlah langkah maksimum, jumlah epoch, strategi penyimpanan, frekuensi pencatatan, direktori keluaran, optimizer, dan jenis penjadwal laju belajar.
Akhirnya, kami membuat instance SFTTrainer dan melakukan fine-tune pada model:
trainer = SFTTrainer(
model=model,
args=args,
train_dataset=dataset,
dataset_text_field="text",
max_seq_length=128,
formatting_func=formatting_prompts_func
)
trainer.train()
Kami membuat objek SFTTrainer, dengan meneruskan model pra-latih, argumen pelatihan, dataset yang telah dipracetak, nama field teks, panjang urutan maksimum, dan fungsi pemformatan. Kemudian, kami memanggil metode train() untuk memulai proses fine-tuning.
Keluaran dari proses fine-tuning dicetak di akhir:
TrainOutput(global_step=9, training_loss=0.7428549660576714, metrics={'train_runtime': 570.4105, 'train_samples_per_second': 0.526, 'train_steps_per_second': 0.016, 'total_flos': 691863632216064.0, 'train_loss': 0.7428549660576714, 'epoch': 2.4})Proses fine-tuning menghasilkan training loss sebesar 0.7428549660576714 setelah 2,4 epoch, dengan waktu pelatihan sekitar 570,4105 detik. Model mencapai kecepatan pelatihan 0,526 sampel per detik dan 0,016 langkah per detik.
Selesai sudah proses fine-tuning pada model Phi-3. Model yang telah di-fine-tune kini dapat digunakan untuk tugas dan evaluasi lebih lanjut.
Kode lengkap tersedia di halaman notebook.
Untuk mempelajari lebih lanjut tentang fine-tuning model bahasa besar, tutorial kami Panduan Pengantar Fine-Tuning LLM memandu Anda melalui proses fine-tuning model seperti GPT-2 menggunakan Hugging Face.
Kinerja Phi-3 di berbagai tolok ukur menegaskan potensinya untuk merevolusi berbagai aplikasi di bidang teknologi dan bisnis.
Di bawah ini adalah beberapa aplikasi praktis dari Phi-3, menyoroti skenario kasus penggunaan dan teknik integrasi dalam pipeline data science.
Kemampuan Phi-3 dapat dimanfaatkan dalam beberapa cara inovatif:
Mengintegrasikan Phi-3 ke dalam alur kerja data science melibatkan beberapa langkah kunci:
Panduan ini telah memberikan penjelajahan mendalam tentang model bahasa Phi-3, membantu pembaca memiliki pemahaman yang kuat tentang fitur uniknya, aplikasi praktis, dan strategi pemanfaatannya secara efektif.
Lanjutkan Perjalanan AI Anda Hari Ini!
Kursus
Kursus
Kursus
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt




