

3. Tinggalkan which()
Lain kali Anda menggunakan which(), coba tinggalkan! Orang sering menggunakan which() untuk mendapatkan indeks dari suatu kondisi boolean, lalu memilih nilai pada indeks tersebut. Ini tidak perlu.
Mengambil elemen vektor yang lebih besar dari 5:
x <- 3:7
# Using which (not necessary)
x[which(x > 5)]
#> [1] 6 7
# No which
x[x > 5]
#> [1] 6 7
Atau menghitung jumlah nilai yang lebih besar dari 5:
# Using which
length(which(x > 5))
#> [1] 2
# Without which
sum(x > 5)
#> [1] 2
Mengapa Anda harus meninggalkan which()? Sering kali tidak perlu dan vektor boolean sudah cukup.
Misalnya, R memungkinkan Anda memilih elemen yang ditandai sebagai TRUE dalam vektor boolean:
condition <- x > 5
condition
#> [1] FALSE FALSE FALSE TRUE TRUE
x[condition]
#> [1] 6 7
Selain itu, ketika digabungkan dengan sum() atau mean(), vektor boolean dapat digunakan untuk mendapatkan jumlah atau proporsi nilai yang memenuhi suatu kondisi:
sum(condition)
#> [1] 2
mean(condition)
#> [1] 0.4
which() memberi tahu Anda indeks dari nilai TRUE:
which(condition)
#> [1] 4 5
Dan meski hasilnya tidak salah, ini memang tidak perlu. Misalnya, saya sering melihat orang menggabungkan which() dan length() untuk menguji apakah ada atau semua nilai bernilai TRUE. Sebagai gantinya, Anda hanya membutuhkan any() atau all():
x <- c(1, 2, 12)
# Using `which()` and `length()` to test if any values are greater than 10
if (length(which(x > 10)) > 0)
print("At least one value is greater than 10")
#> [1] "At least one value is greater than 10"
# Wrapping a boolean vector with `any()`
if (any(x > 10))
print("At least one value is greater than 10")
#> [1] "At least one value is greater than 10"
# Using `which()` and `length()` to test if all values are positive
if (length(which(x > 0)) == length(x))
print("All values are positive")
#> [1] "All values are positive"
# Wrapping a boolean vector with `all()`
if (all(x > 0))
print("All values are positive")
#> [1] "All values are positive"
Oh, dan ini menghemat sedikit waktu...
x <- runif(1e8)
system.time(x[which(x > .5)])
#> user system elapsed
#> 1.156 0.522 1.686
system.time(x[x > .5])
#> user system elapsed
#> 1.071 0.442 1.662
4. factor itu factor!
Pernah menghapus nilai dari factor dan mendapati level lama yang sudah tidak ada masih tersisa? Saya sering melihat berbagai cara kreatif untuk mengatasinya. Solusi paling sederhana sering kali hanya dengan membungkusnya lagi dengan factor().
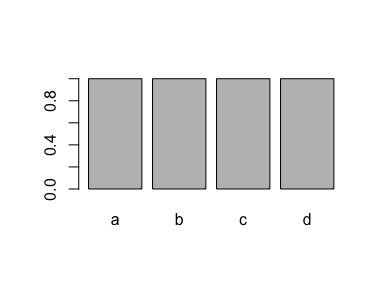
Contoh ini membuat factor dengan empat level ("a", "b", "c", dan "d"):
# A factor with four levels
x <- factor(c("a", "b", "c", "d"))
x
#> [1] a b c d
#> Levels: a b c d
plot(x)
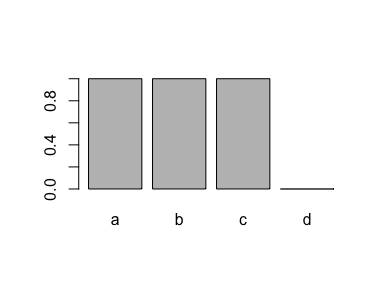
Jika Anda menghapus semua kasus dari satu level ("d"), level tersebut masih tercatat dalam factor:
# Drop all values for one level
x <- x[x != "d"]
# But we still have this level!
x
#> [1] a b c
#> Levels: a b c d
plot(x)
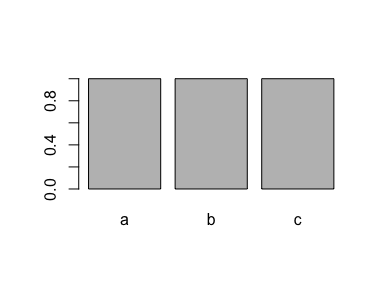
Cara super sederhana untuk menghapusnya adalah dengan menggunakan factor() lagi:
x <- factor(x)
x
#> [1] a b c
#> Levels: a b c
plot(x)
Ini biasanya solusi yang baik untuk masalah yang membuat banyak orang kesal. Jadi selamatkan diri Anda dari pusing dan factor itu factor!
5. Pertama Anda ambil $, lalu Anda dapatkan kekuatannya
Lain kali Anda ingin mengekstrak nilai dari kolom data.frame saat baris memenuhi suatu kondisi, tentukan kolom dengan $ sebelum baris dengan [.
Misalnya Anda menginginkan tenaga kuda (hp) untuk mobil dengan 4 silinder (cyl), menggunakan data mtcars. Anda bisa menulis salah satu dari ini:
# rows first, column second - not ideal
mtcars[mtcars$cyl == 4, ]$hp
#> [1] 93 62 95 66 52 65 97 66 91 113 109
# column first, rows second - much better
mtcars$hp[mtcars$cyl == 4]
#> [1] 93 62 95 66 52 65 97 66 91 113 109
Intinya, gunakan pendekatan kedua.
Tapi mengapa demikian?
Alasan pertama: singkirkan koma yang merepotkan itu! Saat Anda menentukan baris sebelum kolom, Anda harus ingat komanya: mtcars[mtcars$cyl == 4,]$hp. Saat Anda menentukan kolom terlebih dahulu, artinya sekarang Anda merujuk pada sebuah vektor, dan tidak perlu koma!
Alasan kedua: kecepatan! Mari uji pada data frame yang lebih besar:
# Simulate a data frame...
n <- 1e7
d <- data.frame(
a = seq(n),
b = runif(n)
)
# rows first, column second - not ideal
system.time(d[d$b > .5, ]$a)
#> user system elapsed
#> 0.497 0.126 0.629
# column first, rows second - much better
system.time(d$a[d$b > .5])
#> user system elapsed
#> 0.089 0.017 0.107
Pantas dicoba, bukan?
Namun, jika Anda ingin mengasah keterampilan sebagai ninja data frame R, saya sarankan belajar dplyr. Anda bisa mendapatkan gambaran yang baik di situs web dplyr atau benar-benar memahaminya melalui kursus online seperti Data Manipulation in R with dplyr di DataCamp.
Penutup
Terima kasih sudah membaca dan semoga ini bermanfaat bagi Anda.
Untuk pembaruan artikel terbaru, ikuti @drsimonj di Twitter, atau email saya di [email protected] untuk menghubungi.
Jika Anda menginginkan kode yang menghasilkan blog ini, lihat repositori GitHub blogR.
Lihat Panduan Memulai Tidyverse: Tutorial kami.




@drsimonj hadir dengan lima trik sederhana yang sering saya bagikan kepada sesama pengguna R untuk memperbaiki kode mereka!
1. Lebih Asyik Membuat Deret dari 1
Lain kali Anda menggunakan operator titik dua untuk membuat deret dari 1 seperti
1:n, coba gunakanseq().Operator titik dua dapat menghasilkan hasil tak terduga yang bisa menimbulkan berbagai masalah tanpa Anda sadari! Perhatikan apa yang terjadi saat Anda ingin membuat deret sepanjang vektor kosong:
Anda juga akan melihat bahwa ini menyelamatkan Anda dari penggunaan fungsi seperti
length(). Ketika diterapkan pada objek dengan panjang tertentu,seq()akan otomatis membuat deret dari 1 hingga panjang objek tersebut.2.
vector()apa yang Andac()Lain kali Anda membuat vektor kosong dengan
c(), coba ganti denganvector("type", length).Melakukan ini memperbaiki penggunaan memori dan meningkatkan kecepatan! Sering kali Anda sudah tahu sejak awal tipe nilai apa yang akan masuk ke dalam vektor, dan seberapa panjang vektornya. Menggunakan
c()membuat R harus secara perlahan menebak kedua hal tersebut. Jadi bantu percepat denganvector()!Contoh bagusnya adalah di dalam for loop. Banyak orang menulis loop dengan mendeklarasikan vektor kosong dan memperbesarnya dengan
c()seperti ini:Alih-alih, tentukan terlebih dahulu tipe dan panjangnya dengan
vector(), dan referensikan posisi berdasarkan indeks, seperti ini:Berikut perbandingan kecepatannya secara cepat:
Itu seharusnya cukup meyakinkan!