

3. Dimentica which()
La prossima volta che usi which(), prova a farne a meno! Spesso si usa which() per ottenere indici da una condizione booleana e poi selezionare i valori a quegli indici. Non è necessario.
Ottenere gli elementi del vettore maggiori di 5:
x <- 3:7
# Using which (not necessary)
x[which(x > 5)]
#> [1] 6 7
# No which
x[x > 5]
#> [1] 6 7
Oppure contare il numero di valori maggiori di 5:
# Using which
length(which(x > 5))
#> [1] 2
# Without which
sum(x > 5)
#> [1] 2
Perché dovresti dimenticare which()? Spesso è superfluo e i vettori booleani sono tutto ciò che ti serve.
Per esempio, R ti permette di selezionare gli elementi contrassegnati come TRUE in un vettore booleano:
condition <- x > 5
condition
#> [1] FALSE FALSE FALSE TRUE TRUE
x[condition]
#> [1] 6 7
Inoltre, combinati con sum() o mean(), i vettori booleani possono essere usati per ottenere il conteggio o la proporzione dei valori che soddisfano una condizione:
sum(condition)
#> [1] 2
mean(condition)
#> [1] 0.4
which() ti dice gli indici dei valori TRUE:
which(condition)
#> [1] 4 5
E anche se i risultati non sono sbagliati, semplicemente non è necessario. Ad esempio, spesso vedo combinare which() e length() per verificare se almeno un valore o tutti i valori sono TRUE. Invece, ti basta any() o all():
x <- c(1, 2, 12)
# Using `which()` and `length()` to test if any values are greater than 10
if (length(which(x > 10)) > 0)
print("At least one value is greater than 10")
#> [1] "At least one value is greater than 10"
# Wrapping a boolean vector with `any()`
if (any(x > 10))
print("At least one value is greater than 10")
#> [1] "At least one value is greater than 10"
# Using `which()` and `length()` to test if all values are positive
if (length(which(x > 0)) == length(x))
print("All values are positive")
#> [1] "All values are positive"
# Wrapping a boolean vector with `all()`
if (all(x > 0))
print("All values are positive")
#> [1] "All values are positive"
Ah, e ti fa risparmiare anche un po' di tempo...
x <- runif(1e8)
system.time(x[which(x > .5)])
#> user system elapsed
#> 1.156 0.522 1.686
system.time(x[x > .5])
#> user system elapsed
#> 1.071 0.442 1.662
4. factor quel factor!
Ti è mai capitato di rimuovere valori da un factor e ritrovarti con vecchi livelli che non esistono più? Vedo ogni sorta di soluzione creativa per gestire questo caso. La soluzione più semplice spesso è semplicemente riavvolgerlo in factor().
Questo esempio crea un factor con quattro livelli ("a", "b", "c" e "d"):
# A factor with four levels
x <- factor(c("a", "b", "c", "d"))
x
#> [1] a b c d
#> Levels: a b c d
plot(x)
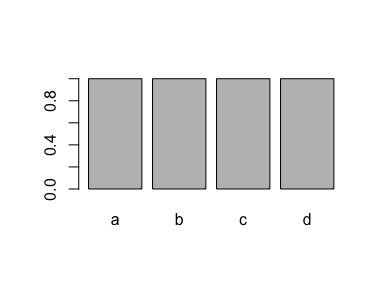
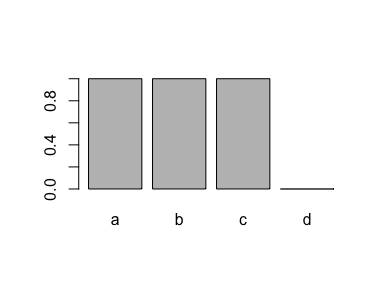
Se elimini tutti i casi di un livello ("d"), il livello è ancora registrato nel factor:
# Drop all values for one level
x <- x[x != "d"]
# But we still have this level!
x
#> [1] a b c
#> Levels: a b c d
plot(x)
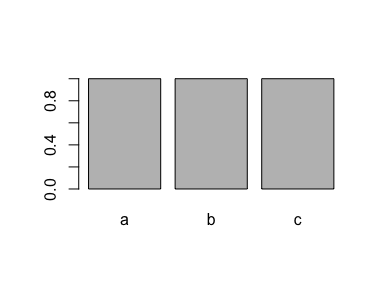
Un metodo semplicissimo per rimuoverlo è usare di nuovo factor():
x <- factor(x)
x
#> [1] a b c
#> Levels: a b c
plot(x)
Di solito è una buona soluzione a un problema che fa impazzire molte persone. Evita mal di testa e fai factor a quel factor!
5. Prima ottieni il $, poi il potere
La prossima volta che vuoi estrarre valori da una colonna di data.frame in cui le righe soddisfano una condizione, specifica prima la colonna con $ e poi le righe con [.
Mettiamo che tu voglia i cavalli (hp) per le auto con 4 cilindri (cyl), usando il dataset mtcars. Puoi scrivere una di queste due versioni:
# rows first, column second - not ideal
mtcars[mtcars$cyl == 4, ]$hp
#> [1] 93 62 95 66 52 65 97 66 91 113 109
# column first, rows second - much better
mtcars$hp[mtcars$cyl == 4]
#> [1] 93 62 95 66 52 65 97 66 91 113 109
Il consiglio qui è di usare il secondo approccio.
Ma perché?
Primo motivo: elimina quella fastidiosa virgola! Quando specifichi le righe prima della colonna, devi ricordarti la virgola: mtcars[mtcars$cyl == 4,]$hp. Quando specifichi prima la colonna, stai facendo riferimento a un vettore e non ti serve la virgola!
Secondo motivo: velocità! Proviamolo su un data frame più grande:
# Simulate a data frame...
n <- 1e7
d <- data.frame(
a = seq(n),
b = runif(n)
)
# rows first, column second - not ideal
system.time(d[d$b > .5, ]$a)
#> user system elapsed
#> 0.497 0.126 0.629
# column first, rows second - much better
system.time(d$a[d$b > .5])
#> user system elapsed
#> 0.089 0.017 0.107
Ne vale la pena, no?
Comunque, se vuoi affinare le tue abilità da ninja dei data frame in R, ti consiglio di imparare dplyr. Puoi farti un'idea generale sul sito di dplyr o imparare davvero le basi con corsi online come Data Manipulation in R with dplyr di DataCamp.
Chiusura
Grazie per la lettura, spero ti sia stato utile.
Per aggiornamenti sui post recenti, segui @drsimonj su Twitter, o scrivimi a [email protected] per metterti in contatto.
Se vuoi il codice che ha prodotto questo blog, dai un'occhiata al repository GitHub blogR.
Dai un'occhiata alla nostra Guida introduttiva al Tidyverse: Tutorial.





@drsimonj qui con cinque semplici trucchi che mi ritrovo a condividere spesso con altri utenti R per migliorare il loro codice!
1. Più divertente sequenziare da 1
La prossima volta che usi l'operatore due punti per creare una sequenza da 1 come
1:n, provaseq().L'operatore due punti può produrre risultati imprevisti che possono creare ogni sorta di problemi senza che tu te ne accorga! Guarda cosa succede quando vuoi creare la sequenza della lunghezza di un vettore vuoto:
Noterai anche che questo ti evita di usare funzioni come
length(). Applicato a un oggetto di una certa lunghezza,seq()crea automaticamente una sequenza da 1 alla lunghezza dell'oggetto.2.
vector()quello chec()La prossima volta che crei un vettore vuoto con
c(), prova a sostituirlo convector("type", length).Così facendo migliori l'uso della memoria e aumenti la velocità! Spesso sai in anticipo che tipo di valori andranno in un vettore e quanto sarà lungo. Usare
c()significa che R deve determinare entrambi questi aspetti in modo lento. Dagli una spinta convector()!Un buon esempio di questo vantaggio è in un ciclo for. Spesso si scrivono cicli dichiarando un vettore vuoto e facendolo crescere con
c()così:Invece, predefinisci tipo e lunghezza con
vector()e riferisciti alle posizioni per indice, così:Ecco un rapido confronto di velocità:
Direi che è abbastanza convincente!