

3. Bỏ which() đi
Lần tới khi bạn dùng which(), hãy thử bỏ nó! Mọi người thường dùng which() để lấy chỉ số từ một điều kiện boolean rồi chọn giá trị tại các chỉ số đó. Điều này không cần thiết.
Lấy các phần tử của vector lớn hơn 5:
x <- 3:7
# Using which (not necessary)
x[which(x > 5)]
#> [1] 6 7
# No which
x[x > 5]
#> [1] 6 7
Hoặc đếm số giá trị lớn hơn 5:
# Using which
length(which(x > 5))
#> [1] 2
# Without which
sum(x > 5)
#> [1] 2
Tại sao bạn nên bỏ which()? Thường là không cần thiết và vector boolean là đủ dùng.
Ví dụ, R cho phép bạn chọn các phần tử được gắn cờ là TRUE trong một vector boolean:
condition <- x > 5
condition
#> [1] FALSE FALSE FALSE TRUE TRUE
x[condition]
#> [1] 6 7
Ngoài ra, khi kết hợp với sum() hoặc mean(), vector boolean có thể dùng để lấy số lượng hoặc tỷ lệ giá trị thỏa điều kiện:
sum(condition)
#> [1] 2
mean(condition)
#> [1] 0.4
which() cho bạn biết chỉ số của các giá trị TRUE:
which(condition)
#> [1] 4 5
Và dù kết quả không sai, nó đơn giản là không cần thiết. Chẳng hạn, tôi thường thấy mọi người kết hợp which() và length() để kiểm tra xem có phần tử nào TRUE hay tất cả đều TRUE. Thay vào đó, bạn chỉ cần any() hoặc all():
x <- c(1, 2, 12)
# Using `which()` and `length()` to test if any values are greater than 10
if (length(which(x > 10)) > 0)
print("At least one value is greater than 10")
#> [1] "At least one value is greater than 10"
# Wrapping a boolean vector with `any()`
if (any(x > 10))
print("At least one value is greater than 10")
#> [1] "At least one value is greater than 10"
# Using `which()` and `length()` to test if all values are positive
if (length(which(x > 0)) == length(x))
print("All values are positive")
#> [1] "All values are positive"
# Wrapping a boolean vector with `all()`
if (all(x > 0))
print("All values are positive")
#> [1] "All values are positive"
Ồ, và nó cũng tiết kiệm cho bạn chút thời gian...
x <- runif(1e8)
system.time(x[which(x > .5)])
#> user system elapsed
#> 1.156 0.522 1.686
system.time(x[x > .5])
#> user system elapsed
#> 1.071 0.442 1.662
4. factor lại factor đó!
Đã bao giờ bạn loại bỏ một số giá trị khỏi factor và thấy mình vẫn kẹt với các level cũ không còn tồn tại? Tôi thấy đủ kiểu cách xử lý sáng tạo. Giải pháp đơn giản nhất thường là bọc nó lại trong factor().
Ví dụ này tạo một factor với bốn level ("a", "b", "c" và "d"):
# A factor with four levels
x <- factor(c("a", "b", "c", "d"))
x
#> [1] a b c d
#> Levels: a b c d
plot(x)
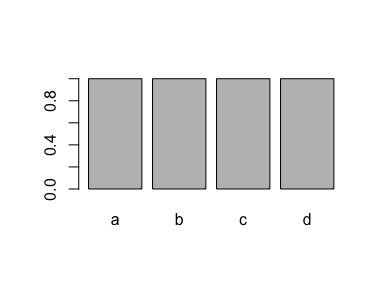
Nếu bạn bỏ tất cả các trường hợp của một level ("d"), level đó vẫn được ghi nhận trong factor:
# Drop all values for one level
x <- x[x != "d"]
# But we still have this level!
x
#> [1] a b c
#> Levels: a b c d
plot(x)
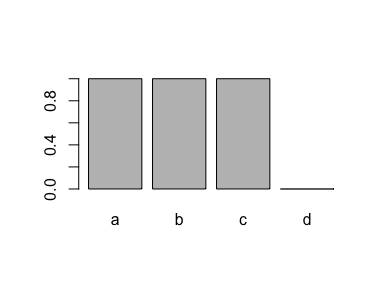
Một cách cực kỳ đơn giản để loại bỏ nó là dùng lại factor():
x <- factor(x)
x
#> [1] a b c
#> Levels: a b c
plot(x)
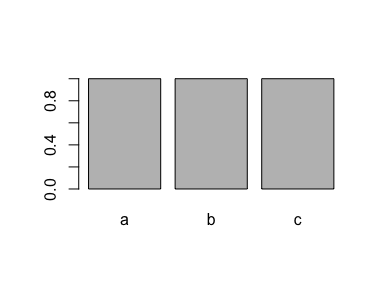
Đây thường là một giải pháp tốt cho vấn đề khiến nhiều người bực bội. Vậy nên hãy tự cứu mình khỏi cơn đau đầu và factor lại factor đó!
5. Trước tiên bạn lấy $, rồi bạn có sức mạnh
Lần tới khi bạn muốn trích xuất giá trị từ một cột của data.frame nơi các hàng thỏa điều kiện, hãy chỉ định cột bằng $ trước rồi mới tới hàng bằng [.
Giả sử bạn muốn lấy horsepower (hp) cho các xe có 4 xi-lanh (cyl), dùng bộ dữ liệu mtcars. Bạn có thể viết một trong hai cách sau:
# rows first, column second - not ideal
mtcars[mtcars$cyl == 4, ]$hp
#> [1] 93 62 95 66 52 65 97 66 91 113 109
# column first, rows second - much better
mtcars$hp[mtcars$cyl == 4]
#> [1] 93 62 95 66 52 65 97 66 91 113 109
Mẹo ở đây là dùng cách thứ hai.
Nhưng tại sao vậy?
Lý do thứ nhất: loại bỏ dấu phẩy phiền toái đó! Khi bạn chỉ định hàng trước cột, bạn phải nhớ dấu phẩy: mtcars[mtcars$cyl == 4,]$hp. Khi bạn chỉ định cột trước, lúc này bạn đang tham chiếu tới một vector, và không cần dấu phẩy nữa!
Lý do thứ hai: tốc độ! Hãy thử trên một data frame lớn hơn:
# Simulate a data frame...
n <- 1e7
d <- data.frame(
a = seq(n),
b = runif(n)
)
# rows first, column second - not ideal
system.time(d[d$b > .5, ]$a)
#> user system elapsed
#> 0.497 0.126 0.629
# column first, rows second - much better
system.time(d$a[d$b > .5])
#> user system elapsed
#> 0.089 0.017 0.107
Đáng giá chứ, đúng không?
Dẫu vậy, nếu bạn muốn trau dồi kỹ năng ninja với data frame trong R, tôi gợi ý học dplyr. Bạn có thể xem tổng quan tốt trên trang web dplyr hoặc học bài bản qua các khóa trực tuyến như Data Manipulation in R with dplyr của DataCamp.
Lời kết
Cảm ơn bạn đã đọc và hy vọng điều này hữu ích với bạn.
Để cập nhật các bài viết mới, hãy theo dõi @drsimonj trên Twitter, hoặc email cho tôi tại [email protected] để liên hệ.
Nếu bạn muốn có mã tạo ra bài viết này, hãy xem kho GitHub blogR.
Khám phá Hướng dẫn bắt đầu với Tidyverse của chúng tôi.


@drsimonj ở đây với năm mẹo đơn giản mà tôi thường xuyên chia sẻ với các R user để cải thiện mã của họ!
1. Tạo dãy từ 1 sẽ vui hơn
Lần tới khi bạn dùng toán tử hai chấm để tạo dãy từ 1 như
1:n, hãy thửseq().Toán tử hai chấm có thể tạo ra kết quả bất ngờ và gây ra đủ kiểu rắc rối mà bạn khó nhận ra! Hãy xem điều gì xảy ra khi bạn muốn tạo dãy theo độ dài của một vector rỗng:
Bạn cũng sẽ thấy cách này giúp tránh phải dùng các hàm như
length(). Khi áp dụng cho một đối tượng có độ dài xác định,seq()sẽ tự động tạo dãy từ 1 đến độ dài của đối tượng.2.
vector()cho thứ bạnc()Lần tới khi bạn tạo một vector rỗng bằng
c(), hãy thử thay bằngvector("type", length).Làm vậy sẽ cải thiện việc sử dụng bộ nhớ và tăng tốc độ! Bạn thường biết trước kiểu giá trị sẽ đưa vào vector và độ dài của nó. Dùng
c()khiến R phải từ từ tự suy ra cả hai điều này. Vì vậy, hãy hỗ trợ nó tăng tốc vớivector()!Một ví dụ điển hình là trong vòng lặp for. Mọi người hay viết vòng lặp bằng cách khai báo một vector rỗng và mở rộng nó với
c()như sau:Thay vào đó, hãy định nghĩa trước kiểu và độ dài bằng
vector(), rồi gán theo chỉ số, như sau:Đây là so sánh tốc độ nhanh gọn:
Thế là đủ thuyết phục rồi nhé!