

3. Verabschiede dich von which()
Wenn du das nächste Mal which() verwenden willst, lass es bleiben! Oft nutzt man which(), um Indizes aus einer booleschen Bedingung zu ziehen und dann Werte an diesen Indizes auszuwählen. Das ist nicht nötig.
Elemente eines Vektors größer als 5 auswählen:
x <- 3:7
# Mit which (nicht nötig)
x[which(x > 5)]
#> [1] 6 7
# Ohne which
x[x > 5]
#> [1] 6 7
Oder die Anzahl der Werte größer als 5 zählen:
# Mit which
length(which(x > 5))
#> [1] 2
# Ohne which
sum(x > 5)
#> [1] 2
Warum solltest du which() weglassen? Es ist oft überflüssig, und boolesche Vektoren reichen völlig aus.
Zum Beispiel kannst du in R Elemente auswählen, die im booleschen Vektor als TRUE markiert sind:
condition <- x > 5
condition
#> [1] FALSE FALSE FALSE TRUE TRUE
x[condition]
#> [1] 6 7
Kombiniert mit sum() oder mean() kannst du mit booleschen Vektoren außerdem Anzahl oder Anteil der Werte berechnen, die eine Bedingung erfüllen:
sum(condition)
#> [1] 2
mean(condition)
#> [1] 0.4
which() liefert dir die Indizes der TRUE-Werte:
which(condition)
#> [1] 4 5
Und auch wenn die Ergebnisse nicht falsch sind, ist es schlicht unnötig. Häufig sehe ich etwa, dass which() und length() kombiniert werden, um zu prüfen, ob irgendein oder alle Werte TRUE sind. Stattdessen brauchst du nur any() bzw. all():
x <- c(1, 2, 12)
# Mit `which()` und `length()` prüfen, ob mindestens ein Wert > 10 ist
if (length(which(x > 10)) > 0)
print("At least one value is greater than 10")
#> [1] "At least one value is greater than 10"
# Booleschen Vektor mit `any()` prüfen
if (any(x > 10))
print("At least one value is greater than 10")
#> [1] "At least one value is greater than 10"
# Mit `which()` und `length()` prüfen, ob alle Werte positiv sind
if (length(which(x > 0)) == length(x))
print("All values are positive")
#> [1] "All values are positive"
# Booleschen Vektor mit `all()` prüfen
if (all(x > 0))
print("All values are positive")
#> [1] "All values are positive"
Und es spart dir auch ein bisschen Zeit...
x <- runif(1e8)
system.time(x[which(x > .5)])
#> user system elapsed
#> 1.156 0.522 1.686
system.time(x[x > .5])
#> user system elapsed
#> 1.071 0.442 1.662
4. factor that factor!
Schon mal Werte aus einem Faktor entfernt und dich dann über alte, nicht mehr vorhandene Level geärgert? Ich sehe die kreativsten Workarounds. Die einfachste Lösung ist oft, den Vektor erneut in factor() zu hüllen.
Dieses Beispiel erzeugt einen Faktor mit vier Levels ("a", "b", "c" und "d"):
# A factor with four levels
x <- factor(c("a", "b", "c", "d"))
x
#> [1] a b c d
#> Levels: a b c d
plot(x)
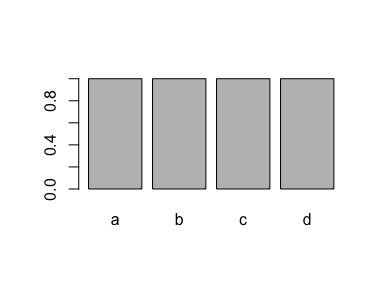
Wenn du alle Fälle eines Levels entfernst ("d"), bleibt das Level im Faktor trotzdem erhalten:
# Drop all values for one level
x <- x[x != "d"]
# Aber das Level ist noch da!
x
#> [1] a b c
#> Levels: a b c d
plot(x)
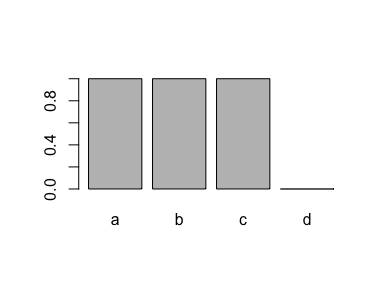
Super simpel entfernst du es, indem du erneut factor() anwendest:
x <- factor(x)
x
#> [1] a b c
#> Levels: a b c
plot(x)
Das ist meist die beste Lösung für ein Problem, das viele zur Verzweiflung bringt. Spar dir den Ärger und factor that factor!
5. Erst das $, dann die Power
Wenn du Werte aus einer data.frame-Spalte extrahieren willst, deren Zeilen eine Bedingung erfüllen, gib zuerst die Spalte mit $ an und dann die Zeilen mit [.
Angenommen, du möchtest die Pferdestärken (hp) für Autos mit 4 Zylindern (cyl) im mtcars-Datensatz. Du kannst beides schreiben:
# Erst Zeilen, dann Spalte – nicht ideal
mtcars[mtcars$cyl == 4, ]$hp
#> [1] 93 62 95 66 52 65 97 66 91 113 109
# Erst Spalte, dann Zeilen – viel besser
mtcars$hp[mtcars$cyl == 4]
#> [1] 93 62 95 66 52 65 97 66 91 113 109
Die Empfehlung ist, die zweite Variante zu nutzen.
Aber warum?
Erstens: Schluss mit dem lästigen Komma! Wenn du zuerst die Zeilen angibst, musst du an das Komma denken: mtcars[mtcars$cyl == 4,]$hp. Wenn du zuerst die Spalte auswählst, arbeitest du mit einem Vektor – und brauchst kein Komma!
Zweitens: Geschwindigkeit! Testen wir es an einem größeren Data Frame:
# Simulate a data frame...
n <- 1e7
d <- data.frame(
a = seq(n),
b = runif(n)
)
# Erst Zeilen, dann Spalte – nicht ideal
system.time(d[d$b > .5, ]$a)
#> user system elapsed
#> 0.497 0.126 0.629
# Erst Spalte, dann Zeilen – viel besser
system.time(d$a[d$b > .5])
#> user system elapsed
#> 0.089 0.017 0.107
Lohnt sich, oder?
Wenn du deine Fähigkeiten als Data-Frame-Ninja in R weiter schärfen willst, lern dplyr. Einen guten Überblick gibt es auf der dplyr-Website oder du lernst die Details in Online-Kursen wie DataCamps Data Manipulation in R with dplyr.
Zum Schluss
Danke fürs Lesen – ich hoffe, das war hilfreich für dich.
Für Updates zu neuen Blogposts folge @drsimonj auf Twitter oder schreib mir an [email protected].
Wenn du den Code zu diesem Blog sehen möchtest, schau dir das blogR GitHub-Repository an.
Sieh dir auch unser Getting Started with the Tidyverse: Tutorial an.







@drsimonj ist hier mit fünf einfachen Tricks, die ich ständig mit anderen R-Anwendern teile, um ihren Code zu verbessern!
1. Mehr Spaß mit Sequenzen ab 1
Wenn du das nächste Mal den Doppelpunkt-Operator nutzt, um eine Sequenz ab 1 wie
1:nzu erstellen, probierseq()aus.Der Doppelpunkt-Operator kann unerwartete Ergebnisse liefern, die dir unbemerkt allerlei Probleme einhandeln! Schau dir an, was passiert, wenn du die Länge eines leeren Vektors sequenzieren willst:
Du wirst auch feststellen, dass du dir so Funktionen wie
length()oft sparen kannst. Auf ein Objekt mit einer bestimmten Länge angewendet, erzeugtseq()automatisch eine Sequenz von 1 bis zur Länge des Objekts.2.
vector()stattc()Wenn du das nächste Mal einen leeren Vektor mit
c()anlegst, ersetze ihn durchvector("type", length).Das verbessert den Speicherverbrauch und macht deinen Code schneller! Meist weißt du ohnehin vorab, welchen Typ Werte der Vektor enthält und wie lang er sein wird. Mit
c()muss R beides langsam herausfinden. Gib ihm also mitvector()einen Schub!Ein gutes Beispiel dafür ist eine For-Schleife. Häufig wird eine Schleife so geschrieben, dass ein leerer Vektor deklariert und dann mit
c()sukzessive erweitert wird:Besser: Definiere Typ und Länge mit
vector()vor und greife per Index auf Positionen zu:Hier ein schneller Geschwindigkeitsvergleich:
Das sollte überzeugend genug sein!