

3. which() को छोड़ दें
अगली बार जब आप which() का उपयोग करें, तो उसे छोड़ने की कोशिश करें! लोग अक्सर किसी बूलियन कंडीशन से इंडेक्स पाने के लिए which() का इस्तेमाल करते हैं, और फिर उन इंडेक्स पर मान चुनते हैं। यह ज़रूरी नहीं है।
5 से बड़े वेक्टर तत्व प्राप्त करना:
x <- 3:7
# Using which (not necessary)
x[which(x > 5)]
#> [1] 6 7
# No which
x[x > 5]
#> [1] 6 7
या 5 से बड़े मानों की गिनती करना:
# Using which
length(which(x > 5))
#> [1] 2
# Without which
sum(x > 5)
#> [1] 2
आपको which() क्यों छोड़ना चाहिए? अक्सर इसकी ज़रूरत नहीं होती और बूलियन वेक्टर ही पर्याप्त होते हैं।
उदाहरण के लिए, R आपको बूलियन वेक्टर में TRUE के रूप में फ़्लैग किए गए तत्वों का चयन करने देता है:
condition <- x > 5
condition
#> [1] FALSE FALSE FALSE TRUE TRUE
x[condition]
#> [1] 6 7
साथ ही, sum() या mean() के साथ मिलाने पर, बूलियन वेक्टर का उपयोग किसी शर्त को पूरा करने वाले मानों की संख्या या अनुपात प्राप्त करने के लिए किया जा सकता है:
sum(condition)
#> [1] 2
mean(condition)
#> [1] 0.4
which() आपको TRUE मानों के इंडेक्स बताता है:
which(condition)
#> [1] 4 5
और भले ही नतीजे गलत न हों, यह बस ज़रूरी नहीं है। उदाहरण के लिए, मैं अक्सर लोगों को which() और length() को मिलाकर यह जाँचते देखता हूँ कि कोई भी या सभी मान TRUE हैं या नहीं। इसकी बजाय, आपको सिर्फ़ any() या all() की ज़रूरत है:
x <- c(1, 2, 12)
# Using `which()` and `length()` to test if any values are greater than 10
if (length(which(x > 10)) > 0)
print("At least one value is greater than 10")
#> [1] "At least one value is greater than 10"
# Wrapping a boolean vector with `any()`
if (any(x > 10))
print("At least one value is greater than 10")
#> [1] "At least one value is greater than 10"
# Using `which()` and `length()` to test if all values are positive
if (length(which(x > 0)) == length(x))
print("All values are positive")
#> [1] "All values are positive"
# Wrapping a boolean vector with `all()`
if (all(x > 0))
print("All values are positive")
#> [1] "All values are positive"
और हाँ, यह आपका थोड़ा समय भी बचाता है...
x <- runif(1e8)
system.time(x[which(x > .5)])
#> user system elapsed
#> 1.156 0.522 1.686
system.time(x[x > .5])
#> user system elapsed
#> 1.071 0.442 1.662
4. उस factor को फिर से factor करें!
कभी किसी फैक्टर से मान हटाए हैं और पाया है कि पुराने लेवल अब भी अटके हुए हैं जो अब मौजूद ही नहीं? मैं इस पर तरह-तरह के रचनात्मक उपाय देखता हूँ। अक्सर सबसे सरल समाधान यही है कि उसे फिर से factor() में रैप कर दें।
यह उदाहरण चार लेवल ("a", "b", "c" और "d") वाला एक फैक्टर बनाता है:
# A factor with four levels
x <- factor(c("a", "b", "c", "d"))
x
#> [1] a b c d
#> Levels: a b c d
plot(x)
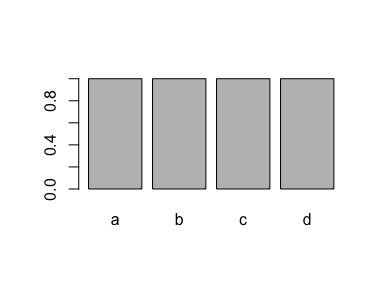
यदि आप किसी एक लेवल ("d") के सभी केस हटा देते हैं, तब भी वह लेवल फैक्टर में दर्ज रहता है:
# Drop all values for one level
x <- x[x != "d"]
# But we still have this level!
x
#> [1] a b c
#> Levels: a b c d
plot(x)
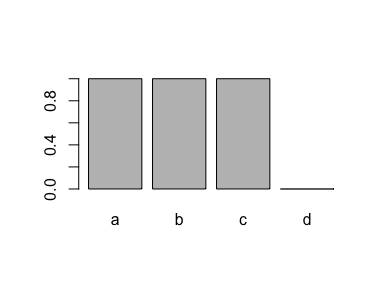
इसे हटाने का एक बेहद सरल तरीका है फिर से factor() का उपयोग करना:
x <- factor(x)
x
#> [1] a b c
#> Levels: a b c
plot(x)
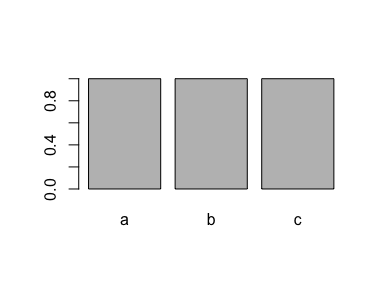
यह आम तौर पर एक ऐसे मसले का अच्छा समाधान है जो बहुत लोगों को परेशान करता है। तो सिरदर्द से बचें और उस factor को factor करें!
5. पहले लें $, फिर मिलेगी पावर
अगली बार जब आप किसी data.frame के कॉलम से वे मान निकालना चाहें जहाँ पंक्तियाँ किसी शर्त को पूरी करती हों, तो पंक्तियों के [ से पहले $ के साथ कॉलम निर्दिष्ट करें।
मान लीजिए आप 4 सिलिंडर (cyl) वाली कारों की हॉर्सपावर (hp) चाहते हैं, mtcars डेटा सेट का उपयोग करते हुए। आप इनमें से कुछ भी लिख सकते हैं:
# rows first, column second - not ideal
mtcars[mtcars$cyl == 4, ]$hp
#> [1] 93 62 95 66 52 65 97 66 91 113 109
# column first, rows second - much better
mtcars$hp[mtcars$cyl == 4]
#> [1] 93 62 95 66 52 65 97 66 91 113 109
यहाँ टिप है कि दूसरा तरीका अपनाएँ।
लेकिन क्यों?
पहला कारण: उस झंझट वाले कॉमा से निजात! जब आप पहले पंक्तियाँ और फिर कॉलम बताते हैं, तो कॉमा याद रखना पड़ता है: mtcars[mtcars$cyl == 4,]$hp। जब आप पहले कॉलम बताते हैं, तो अब आप एक वेक्टर का संदर्भ दे रहे हैं, और कॉमा की ज़रूरत नहीं!
दूसरा कारण: गति! आइए इसे बड़े डेटा फ्रेम पर आज़माएँ:
# Simulate a data frame...
n <- 1e7
d <- data.frame(
a = seq(n),
b = runif(n)
)
# rows first, column second - not ideal
system.time(d[d$b > .5, ]$a)
#> user system elapsed
#> 0.497 0.126 0.629
# column first, rows second - much better
system.time(d$a[d$b > .5])
#> user system elapsed
#> 0.089 0.017 0.107
फायदे का सौदा है, है ना?
फिर भी, यदि आप R डेटा फ्रेम निंजा के रूप में अपने कौशल को निखारना चाहते हैं, तो dplyr सीखने की सलाह दूँगा। आप dplyr वेबसाइट पर एक अच्छा ओवरव्यू पा सकते हैं या DataCamp के Data Manipulation in R with dplyr जैसे ऑनलाइन कोर्स के साथ इसे अच्छी तरह सीख सकते हैं।
समापन
पढ़ने के लिए धन्यवाद और आशा है यह आपके लिए उपयोगी रहा होगा।
हाल के ब्लॉग पोस्ट्स के अपडेट के लिए, Twitter पर @drsimonj को फ़ॉलो करें, या मुझसे संपर्क करने के लिए [email protected] पर ईमेल करें।
यदि आप इस ब्लॉग को बनाने वाला कोड देखना चाहें, तो blogR GitHub रिपॉज़िटरी देखें।
हमारा Getting Started with the Tidyverse: Tutorial देखें।
@drsimonj यहाँ, पाँच सरल ट्रिक्स के साथ जो मैं साथी R उपयोगकर्ताओं के साथ उनका कोड बेहतर बनाने के लिए अक्सर साझा करता हूँ!
1. 1 से सीक्वेंस बनाना और भी मज़ेदार
अगली बार जब आप 1 से सीक्वेंस बनाने के लिए कॉलन ऑपरेटर
1:nका उपयोग करें, तोseq()आज़माएँ।कॉलन ऑपरेटर अप्रत्याशित परिणाम दे सकता है जो बिना ध्यान दिए तरह-तरह की दिक्कतें खड़ी कर सकता है! ज़रा देखें कि खाली वेक्टर की लंबाई का सीक्वेंस बनाते समय क्या होता है:
आप यह भी नोट करेंगे कि यह आपको
length()जैसी फ़ंक्शन कॉल से बचा लेता है। किसी निश्चित लंबाई की ऑब्जेक्ट पर लागू होने पर,seq()अपने आप 1 से उस ऑब्जेक्ट की लंबाई तक का सीक्वेंस बना देता है।2.
vector()वही जो आपc()से करना चाहते हैंअगली बार जब आप
c()से खाली वेक्टर बनाएँ, तो उसेvector("type", length)से बदलकर देखें।ऐसा करने से मेमोरी उपयोग बेहतर होता है और गति बढ़ती है! अक्सर आपको पहले से पता होता है कि वेक्टर में किस प्रकार के मान जायेंगे और उसकी लंबाई क्या होगी।
c()का उपयोग करने पर R को दोनों बातें धीरे-धीरे समझनी पड़ती हैं। इसलिएvector()के साथ उसे थोड़ा बढ़त दें!इसका अच्छा उदाहरण for लूप में दिखता है। लोग अक्सर खाली वेक्टर घोषित कर
c()से उसे बढ़ाते हुए ऐसे लूप लिखते हैं:इसके बजाय,
vector()से टाइप और लंबाई पहले से तय करें, और इंडेक्स द्वारा स्थानों को संदर्भित करें, इस तरह:यहाँ एक त्वरित गति तुलना है:
यह काफ़ी प्रभावशाली होना चाहिए!