

3. Gooi de which() weg
Gebruik je de volgende keer which()? Laat het achterwege! Mensen gebruiken which() vaak om indexen op te halen op basis van een booleaanse voorwaarde en selecteren dan waarden op die indexen. Dat is niet nodig.
Elementen uit een vector ophalen die groter zijn dan 5:
x <- 3:7
# Using which (not necessary)
x[which(x > 5)]
#> [1] 6 7
# No which
x[x > 5]
#> [1] 6 7
Of het aantal waarden tellen dat groter is dan 5:
# Using which
length(which(x > 5))
#> [1] 2
# Without which
sum(x > 5)
#> [1] 2
Waarom zou je which() laten vallen? Het is vaak overbodig en booleaanse vectoren zijn alles wat je nodig hebt.
Je kunt in R bijvoorbeeld elementen selecteren die als TRUE zijn gemarkeerd in een booleaanse vector:
condition <- x > 5
condition
#> [1] FALSE FALSE FALSE TRUE TRUE
x[condition]
#> [1] 6 7
En in combinatie met sum() of mean() kun je met booleaanse vectoren het aantal of het aandeel waarden krijgen die aan een voorwaarde voldoen:
sum(condition)
#> [1] 2
mean(condition)
#> [1] 0.4
which() vertelt je de indexen van TRUE-waarden:
which(condition)
#> [1] 4 5
En hoewel de resultaten niet fout zijn, is het gewoon niet nodig. Zo zie ik vaak dat mensen which() en length() combineren om te testen of er minstens één of juist alle waarden TRUE zijn. In plaats daarvan heb je alleen any() of all() nodig:
x <- c(1, 2, 12)
# Using `which()` and `length()` to test if any values are greater than 10
if (length(which(x > 10)) > 0)
print("At least one value is greater than 10")
#> [1] "At least one value is greater than 10"
# Wrapping a boolean vector with `any()`
if (any(x > 10))
print("At least one value is greater than 10")
#> [1] "At least one value is greater than 10"
# Using `which()` and `length()` to test if all values are positive
if (length(which(x > 0)) == length(x))
print("All values are positive")
#> [1] "All values are positive"
# Wrapping a boolean vector with `all()`
if (all(x > 0))
print("All values are positive")
#> [1] "All values are positive"
Oh, en het scheelt je ook nog wat tijd...
x <- runif(1e8)
system.time(x[which(x > .5)])
#> user system elapsed
#> 1.156 0.522 1.686
system.time(x[x > .5])
#> user system elapsed
#> 1.071 0.442 1.662
4. factor die factor!
Heb je ooit waarden uit een factor verwijderd en gemerkt dat je blijft zitten met oude levels die niet meer bestaan? Ik zie de meest creatieve manieren om hiermee om te gaan. De simpelste oplossing is vaak om het gewoon opnieuw in factor() te wikkelen.
In dit voorbeeld maken we een factor met vier levels ("a", "b", "c" en "d"):
# A factor with four levels
x <- factor(c("a", "b", "c", "d"))
x
#> [1] a b c d
#> Levels: a b c d
plot(x)
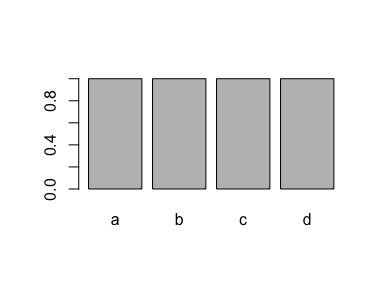
Als je alle gevallen van één level ("d") weggooit, blijft het level toch geregistreerd in de factor:
# Drop all values for one level
x <- x[x != "d"]
# But we still have this level!
x
#> [1] a b c
#> Levels: a b c d
plot(x)
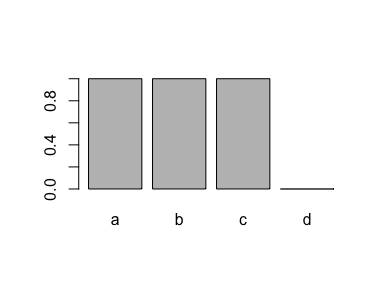
Een supersimpele manier om dit te verwijderen is door opnieuw factor() te gebruiken:
x <- factor(x)
x
#> [1] a b c
#> Levels: a b c
plot(x)
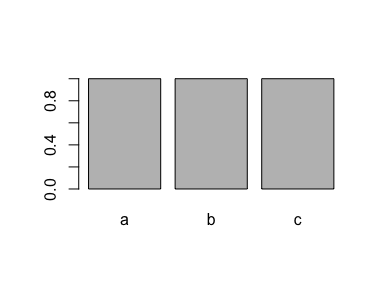
Dit is doorgaans een goede oplossing voor een probleem waar veel mensen gek van worden. Bespaar jezelf dus hoofdpijn en factor die factor!
5. Eerst pak je de $, dan krijg je de power
Als je de volgende keer waarden wilt halen uit een kolom van een data.frame waarvoor de rijen aan een voorwaarde voldoen, geef dan eerst de kolom met $ op en daarna de rijen met [.
Stel dat je het aantal pk (hp) wilt voor auto's met 4 cilinders (cyl), met de dataset mtcars. Je kunt één van deze twee schrijven:
# rows first, column second - not ideal
mtcars[mtcars$cyl == 4, ]$hp
#> [1] 93 62 95 66 52 65 97 66 91 113 109
# column first, rows second - much better
mtcars$hp[mtcars$cyl == 4]
#> [1] 93 62 95 66 52 65 97 66 91 113 109
De tip hier is: gebruik de tweede aanpak.
Maar waarom?
Eerste reden: weg met die lastige komma! Als je eerst de rijen en daarna de kolom opgeeft, moet je die komma onthouden: mtcars[mtcars$cyl == 4,]$hp. Als je eerst de kolom opgeeft, verwijs je naar een vector en is de komma niet nodig!
Tweede reden: snelheid! Laten we het testen op een groter data frame:
# Simulate a data frame...
n <- 1e7
d <- data.frame(
a = seq(n),
b = runif(n)
)
# rows first, column second - not ideal
system.time(d[d$b > .5, ]$a)
#> user system elapsed
#> 0.497 0.126 0.629
# column first, rows second - much better
system.time(d$a[d$b > .5])
#> user system elapsed
#> 0.089 0.017 0.107
De moeite waard, toch?
Als je je skills als R data frame-ninja verder wilt aanscherpen, raad ik je aan dplyr te leren. Je vindt een goed overzicht op de dplyr-website of je leert het echt goed met online cursussen zoals DataCamps Data Manipulation in R met dplyr.
Afsluiting
Bedankt voor het lezen en ik hoop dat je hier iets aan had.
Voor updates over recente blogposts, volg @drsimonj op Twitter, of mail me op [email protected] om contact op te nemen.
Als je de code wilt waarmee deze blog is gemaakt, bekijk dan de blogR GitHub-repository.
Bekijk ook onze Aan de slag met de Tidyverse: Tutorial.


@drsimonj hier met vijf simpele trucs die ik voortdurend deel met andere R-gebruikers om hun code te verbeteren!
1. Leuker om vanaf 1 te sequentiëren
Gebruik je de volgende keer de dubbelpunt-operator om een reeks vanaf 1 te maken, zoals
1:n? Probeer danseq().De dubbelpunt-operator kan onverwachte resultaten opleveren die voor allerlei problemen kunnen zorgen zonder dat je het merkt! Kijk maar eens wat er gebeurt als je de lengte van een lege vector wilt sequentiëren:
Je merkt ook dat je hiermee functies als
length()kunt vermijden. Toegepast op een object met een bepaalde lengte maaktseq()automatisch een reeks van 1 tot en met de lengte van het object.2.
vector()wat je metc()doetMaak je de volgende keer een lege vector met
c()? Vervang die dan doorvector("type", length).Dit verbetert het geheugengebruik en verhoogt de snelheid! Je weet vaak vooraf welk type waarden in een vector terechtkomen en hoe lang de vector wordt. Met
c()moet R beide dingen langzaam uitzoeken. Geef het dus een zetje metvector()!Een goed voorbeeld hiervan is in een for-lus. Mensen schrijven vaak lussen door een lege vector te declareren en die met
c()te laten groeien, zo:In plaats daarvan: definieer type en lengte vooraf met
vector()en verwijs naar posities via de index, zo:Hier is een snelle snelheidsvergelijking:
Dat zou overtuigend genoeg moeten zijn!