Curso
Introducción a R
4 h
3.1M
Más de 10 millones de personas aprenden Python, R, SQL y otras habilidades tecnológicas con nuestros cursos prácticos elaborados por expertos del sector.
which()La próxima vez que uses which(), mejor evítalo. A menudo se usa which() para obtener índices a partir de una condición booleana y luego seleccionar los valores en esos índices. No hace falta.
Obtener los elementos del vector mayores que 5:
x <- 3:7

# Usando which (innecesario)
x[which(x > 5)]
#> [1] 6 7

# Sin which
x[x > 5]
#> [1] 6 7
O contar cuántos valores son mayores que 5:
# Usando which
length(which(x > 5))
#> [1] 2

# Sin which
sum(x > 5)
#> [1] 2
¿Por qué deberías prescindir de which()? Muchas veces es innecesario y con vectores booleanos tienes todo lo que necesitas.
Por ejemplo, R te permite seleccionar elementos marcados como TRUE en un vector booleano:
condition <- x > 5
condition
#> [1] FALSE FALSE FALSE  TRUE  TRUE
x[condition]
#> [1] 6 7
Además, combinados con sum() o mean(), los vectores booleanos sirven para obtener el recuento o la proporción de valores que cumplen una condición:
sum(condition)
#> [1] 2
mean(condition)
#> [1] 0.4
which() te devuelve los índices de los valores TRUE:
which(condition)
#> [1] 4 5
Y aunque el resultado no es incorrecto, simplemente no es necesario. Por ejemplo, a menudo veo a gente combinar which() y length() para comprobar si alguno o todos los valores son TRUE. En su lugar, usa any() o all():
x <- c(1, 2, 12)

# Usando `which()` y `length()` para comprobar si algún valor es mayor que 10
if (length(which(x > 10)) > 0)
  print("At least one value is greater than 10")
#> [1] "At least one value is greater than 10"

# Envolviendo un vector booleano con `any()`
if (any(x > 10))
  print("At least one value is greater than 10")
#> [1] "At least one value is greater than 10"

# Usando `which()` y `length()` para comprobar si todos los valores son positivos
if (length(which(x > 0)) == length(x))
  print("All values are positive")
#> [1] "All values are positive"

# Envolviendo un vector booleano con `all()`
if (all(x > 0))
  print("All values are positive")
#> [1] "All values are positive"
Ah, y también te ahorra un poco de tiempo...
x <- runif(1e8)

system.time(x[which(x > .5)])
#>    user  system elapsed
#>   1.156   0.522   1.686

system.time(x[x > .5])
#>    user  system elapsed
#>   1.071   0.442   1.662
factor a ese factor!¿Alguna vez has eliminado valores de un factor y te has quedado con niveles antiguos que ya no existen? He visto todo tipo de formas creativas de lidiar con esto. La solución más simple suele ser volver a envolverlo con factor().
Este ejemplo crea un factor con cuatro niveles ("a", "b", "c" y "d"):
# A factor with four levels
x <- factor(c("a", "b", "c", "d"))
x
#> [1] a b c d
#> Levels: a b c d

plot(x)
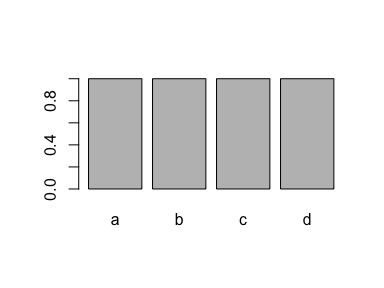
Si eliminas todos los casos de un nivel ("d"), el nivel sigue registrado en el factor:
# Drop all values for one level
x <- x[x != "d"]

# ¡Pero aún tenemos este nivel!
x
#> [1] a b c
#> Levels: a b c d

plot(x)
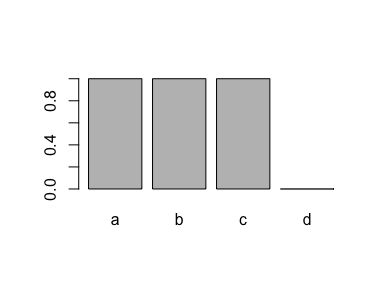
Un método supersencillo para quitarlo es usar factor() de nuevo:
x <- factor(x)
x
#> [1] a b c
#> Levels: a b c

plot(x)
Esto suele ser una buena solución a un problema que saca de quicio a mucha gente. Evítate el dolor de cabeza y haz factor a ese factor.
$, luego el poderLa próxima vez que quieras extraer valores de una columna de un data.frame donde las filas cumplan una condición, especifica primero la columna con $ y después las filas con [.
Imagina que quieres la potencia (hp) de los coches con 4 cilindros (cyl) usando el conjunto de datos mtcars. Puedes escribir cualquiera de estas dos:
# filas primero, columna después - no ideal
mtcars[mtcars$cyl == 4, ]$hp
#>  [1]  93  62  95  66  52  65  97  66  91 113 109

# columna primero, filas después - mucho mejor
mtcars$hp[mtcars$cyl == 4]
#>  [1]  93  62  95  66  52  65  97  66  91 113 109
El consejo es usar el segundo enfoque.
¿Y por qué?
Primer motivo: olvídate de la dichosa coma. Cuando especificas filas antes que columna, tienes que recordar la coma: mtcars[mtcars$cyl == 4,]$hp. Si especificas primero la columna, ahora te refieres a un vector y no necesitas la coma.
Segundo motivo: la velocidad. Probémoslo en un data frame más grande:
# Simulate a data frame...
n <- 1e7
d <- data.frame(
  a = seq(n),
  b = runif(n)
)

# filas primero, columna después - no ideal
system.time(d[d$b > .5, ]$a)
#>    user  system elapsed
#>   0.497   0.126   0.629

# columna primero, filas después - mucho mejor
system.time(d$a[d$b > .5])
#>    user  system elapsed
#>   0.089   0.017   0.107
Merece la pena, ¿verdad?
Aun así, si quieres pulir tus habilidades como ninja de data frames en R, te recomiendo aprender dplyr. Puedes ver una buena introducción en la web de dplyr o aprender a fondo con cursos online como Data Manipulation in R with dplyr de DataCamp.
Gracias por leerme; espero que te haya sido útil.
Para estar al día de las últimas entradas del blog, sigue a @drsimonj en Twitter o escríbeme a drsimonjackson@gmail.com.
Si quieres el código con el que se ha generado este blog, echa un vistazo al repositorio blogR en GitHub.
Consulta nuestro primeros pasos con el Tidyverse: tutorial.
Cursos de R
Curso
Curso
Curso
blog
Elena Kosourova
14 min
Tutorial
Carlo Fanara
32 min
Tutorial
Javier Canales Luna
11 min
Tutorial
DataCamp Team
15 min
Tutorial
DataCamp Team
4 min
Tutorial
Ryan Sheehy
3 min



