

3. which() işlevini bırakın
Bir dahaki sefere which() kullanacağınız zaman, kullanmamayı deneyin! İnsanlar genellikle bir mantıksal koşuldan indeksler elde etmek ve sonra bu indekslerdeki değerleri seçmek için which()’i kullanır. Buna gerek yok.
5’ten büyük vektör elemanlarını alma:
x <- 3:7
# Using which (not necessary)
x[which(x > 5)]
#> [1] 6 7
# No which
x[x > 5]
#> [1] 6 7
Ya da 5’ten büyük değerlerin sayısını bulma:
# Using which
length(which(x > 5))
#> [1] 2
# Without which
sum(x > 5)
#> [1] 2
Neden which()’i bırakmalısınız? Çoğu zaman gereksizdir ve ihtiyacınız olan tek şey mantıksal vektörlerdir.
Örneğin, R bir mantıksal vektörde TRUE olarak işaretlenen öğeleri seçmenize izin verir:
condition <- x > 5
condition
#> [1] FALSE FALSE FALSE TRUE TRUE
x[condition]
#> [1] 6 7
Ayrıca, sum() veya mean() ile birleştirildiğinde, mantıksal vektörler bir koşulu sağlayan değerlerin sayısını veya oranını elde etmek için kullanılabilir:
sum(condition)
#> [1] 2
mean(condition)
#> [1] 0.4
which(), TRUE değerlerinin indekslerini verir:
which(condition)
#> [1] 4 5
Ve sonuçlar yanlış olmasa da, buna gerek yok. Örneğin, insanların which() ve length()’i birleştirerek herhangi bir veya tüm değerlerin TRUE olup olmadığını test ettiklerini sık sık görüyorum. Bunun yerine yalnızca any() veya all() gerekir:
x <- c(1, 2, 12)
# Using `which()` and `length()` to test if any values are greater than 10
if (length(which(x > 10)) > 0)
print("At least one value is greater than 10")
#> [1] "At least one value is greater than 10"
# Wrapping a boolean vector with `any()`
if (any(x > 10))
print("At least one value is greater than 10")
#> [1] "At least one value is greater than 10"
# Using `which()` and `length()` to test if all values are positive
if (length(which(x > 0)) == length(x))
print("All values are positive")
#> [1] "All values are positive"
# Wrapping a boolean vector with `all()`
if (all(x > 0))
print("All values are positive")
#> [1] "All values are positive"
Ve evet, size biraz zaman da kazandırır...
x <- runif(1e8)
system.time(x[which(x > .5)])
#> user system elapsed
#> 1.156 0.522 1.686
system.time(x[x > .5])
#> user system elapsed
#> 1.071 0.442 1.662
4. O faktörü factor ile toparlayın!
Hiç bir faktörden bazı değerleri çıkarıp artık var olmayan eski seviyelerin (levels) kaldığını gördünüz mü? Bununla başa çıkmak için her tür yaratıcı yöntem görüyorum. En basit çözüm çoğu zaman sadece factor() ile tekrar sarmalamaktır.
Bu örnek dört seviyeli ("a", "b", "c" ve "d") bir faktör oluşturur:
# A factor with four levels
x <- factor(c("a", "b", "c", "d"))
x
#> [1] a b c d
#> Levels: a b c d
plot(x)
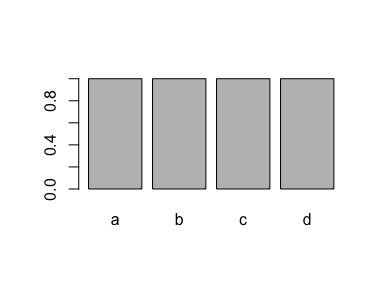
Bir seviyeye ("d") ait tüm gözlemleri düşürürseniz, seviye faktörde hâlâ kayıtlı kalır:
# Drop all values for one level
x <- x[x != "d"]
# But we still have this level!
x
#> [1] a b c
#> Levels: a b c d
plot(x)
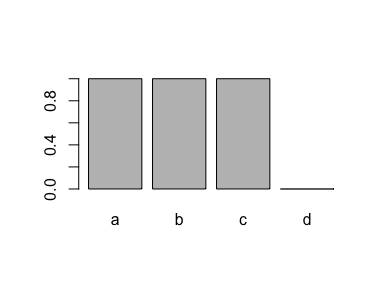
Bunu kaldırmanın çok basit bir yolu, tekrar factor() kullanmaktır:
x <- factor(x)
x
#> [1] a b c
#> Levels: a b c
plot(x)
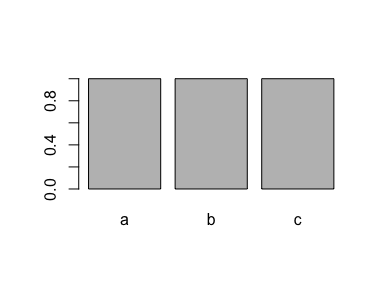
Bu, birçok kişiyi çileden çıkaran bir soruna genellikle iyi bir çözümdür. Kendinize bir baş ağrısından tasarruf edin ve o faktörü factor’layın!
5. Önce $’ı alın, sonra güç gelir
Bir koşulu sağlayan satırlardaki bir data.frame sütunundan değerleri çıkarmak istediğinizde, satırlardan önce sütunu $ ile belirtin ve ardından satırları [ ile seçin.
Diyelim ki mtcars veri setini kullanarak 4 silindirli (cyl) araçların beygir gücünü (hp) istiyorsunuz. Aşağıdakilerden herhangi birini yazabilirsiniz:
# rows first, column second - not ideal
mtcars[mtcars$cyl == 4, ]$hp
#> [1] 93 62 95 66 52 65 97 66 91 113 109
# column first, rows second - much better
mtcars$hp[mtcars$cyl == 4]
#> [1] 93 62 95 66 52 65 97 66 91 113 109
Buradaki ipucu, ikinci yaklaşımı kullanmanızdır.
Peki neden?
İlk neden: Şu can sıkıcı virgülden kurtulun! Satırları sütundan önce belirttiğinizde, virgülü hatırlamanız gerekir: mtcars[mtcars$cyl == 4,]$hp. Sütunu önce belirttiğinizde ise artık bir vektöre referans verirsiniz ve virgüle gerek kalmaz!
İkinci neden: hız! Bunu daha büyük bir veri çerçevesinde test edelim:
# Simulate a data frame...
n <- 1e7
d <- data.frame(
a = seq(n),
b = runif(n)
)
# rows first, column second - not ideal
system.time(d[d$b > .5, ]$a)
#> user system elapsed
#> 0.497 0.126 0.629
# column first, rows second - much better
system.time(d$a[d$b > .5])
#> user system elapsed
#> 0.089 0.017 0.107
Değer, değil mi?
Yine de, bir R data frame ustası olmak istiyorsanız, dplyr öğrenmenizi öneririm. dplyr web sitesinde iyi bir genel bakış edinebilir veya DataCamp’in dplyr ile R’de Veri Manipülasyonu gibi çevrim içi kurslarıyla işi iyice kavrayabilirsiniz.
Kapanış
Okuduğunuz için teşekkürler; umarım sizin için faydalı olmuştur.
En son blog yazılarından haberdar olmak için Twitter’da @drsimonj’i takip edin veya benimle iletişime geçmek için [email protected] adresine e-posta gönderin.
Bu blogu üreten kodu isterseniz, blogR GitHub deposuna göz atın.
Tidyverse’e Giriş: Eğitim yazımıza göz atın.



@drsimonj burada, R kodunu geliştirmek için diğer R kullanıcılarıyla sık sık paylaştığım beş basit püf noktasını anlatıyorum!
1. 1’den dizi oluşturmak daha eğlenceli
Bir sonraki sefere 1’den başlayan bir dizi oluşturmak için
1:ngibi iki nokta üst üste operatörünü kullanacağınız zaman,seq()deneyin.İki nokta üst üste operatörü, fark etmeden her türlü soruna yol açabilecek beklenmedik sonuçlar üretebilir! Boş bir vektörün uzunluğunu diziye çevirmek istediğinizde ne olduğuna bakın:
Ayrıca bu yaklaşımın sizi
length()gibi işlevleri kullanmaktan da kurtardığını fark edeceksiniz. Belirli bir uzunluktaki bir nesneye uygulandığında,seq()otomatik olarak 1’den nesnenin uzunluğuna kadar bir dizi oluşturur.2.
vector()ilec()’ye alternatifBir sonraki sefer boş bir vektörü
c()ile oluşturduğunuzda, bunun yerinevector("type", length)kullanmayı deneyin.Bunu yapmak bellek kullanımını iyileştirir ve hızı artırır! Çoğu zaman bir vektöre hangi türde değerlerin gireceğini ve vektörün ne kadar uzun olacağını baştan bilirsiniz.
c()kullanmak, R’nin bu iki şeyi de yavaşça hesaplaması gerektiği anlamına gelir. Bu yüzdenvector()ile ona hız kazandırın!Bunun faydasına iyi bir örnek for döngüleridir. İnsanlar genellikle boş bir vektör tanımlayıp onu aşağıdaki gibi
c()ile büyüterek döngüler yazar:Bunun yerine, türü ve uzunluğu
vector()ile önceden tanımlayın ve konumlara indeksle referans verin, şöyle:İşte hızlı bir hız karşılaştırması:
Yeterince ikna edici olmalı!