Curso
Introdução ao R
4 h
3.1M
Mais de 10 milhões de pessoas aprendem Python, R, SQL e outras habilidades tecnológicas usando nossos cursos práticos elaborados por especialistas do setor.
which()Da próxima vez que for usar which(), tente evitar! Muita gente usa which() para obter índices a partir de uma condição booleana e depois seleciona valores nesses índices. Não precisa.
Pegando elementos do vetor maiores que 5:
x <- 3:7

# Usando which (desnecessário)
x[which(x > 5)]
#> [1] 6 7

# Sem which
x[x > 5]
#> [1] 6 7
Ou contando quantos valores são maiores que 5:
# Usando which
length(which(x > 5))
#> [1] 2

# Sem which
sum(x > 5)
#> [1] 2
Por que deixar de lado o which()? Ele geralmente é desnecessário, e vetores booleanos já resolvem.
Por exemplo, o R permite selecionar elementos marcados como TRUE em um vetor booleano:
condition <- x > 5
condition
#> [1] FALSE FALSE FALSE  TRUE  TRUE
x[condition]
#> [1] 6 7
Além disso, combinados com sum() ou mean(), vetores booleanos servem para obter a contagem ou a proporção de valores que atendem a uma condição:
sum(condition)
#> [1] 2
mean(condition)
#> [1] 0.4
which() informa os índices dos valores TRUE:
which(condition)
#> [1] 4 5
E embora o resultado não esteja errado, não é necessário. Por exemplo, vejo com frequência gente combinando which() e length() para testar se algum ou todos os valores são TRUE. Em vez disso, use any() ou all():
x <- c(1, 2, 12)

# Usando `which()` e `length()` para testar se existe algum valor > 10
if (length(which(x > 10)) > 0)
  print("At least one value is greater than 10")
#> [1] "At least one value is greater than 10"

# Envolvendo o vetor booleano com `any()`
if (any(x > 10))
  print("At least one value is greater than 10")
#> [1] "At least one value is greater than 10"

# Usando `which()` e `length()` para testar se todos os valores são positivos
if (length(which(x > 0)) == length(x))
  print("All values are positive")
#> [1] "All values are positive"

# Envolvendo o vetor booleano com `all()`
if (all(x > 0))
  print("All values are positive")
#> [1] "All values are positive"
Ah, e ainda economiza um tempinho...
x <- runif(1e8)

system.time(x[which(x > .5)])
#>    user  system elapsed
#>   1.156   0.522   1.686

system.time(x[x > .5])
#>    user  system elapsed
#>   1.071   0.442   1.662
factor nesse factor!Já removeu valores de um factor e ficou preso com níveis antigos que não existem mais? Vejo de tudo quanto é gambiarra para lidar com isso. A solução mais simples muitas vezes é só envolver de novo com factor().
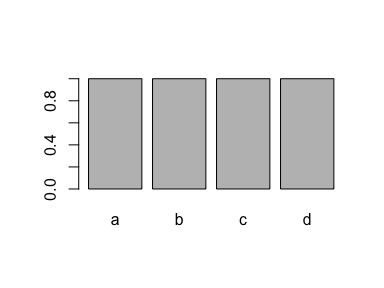
Este exemplo cria um factor com quatro níveis ("a", "b", "c" e "d"):
# Um factor com quatro níveis
x <- factor(c("a", "b", "c", "d"))
x
#> [1] a b c d
#> Levels: a b c d

plot(x)
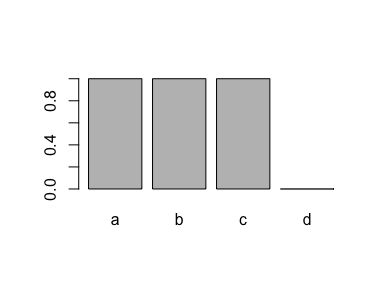
Se você remove todos os casos de um nível ("d"), o nível continua registrado no factor:
# Remover todos os valores de um nível
x <- x[x != "d"]

# Mas o nível ainda está aqui!
x
#> [1] a b c
#> Levels: a b c d

plot(x)
Um jeito super simples de remover é usar factor() de novo:
x <- factor(x)
x
#> [1] a b c
#> Levels: a b c

plot(x)
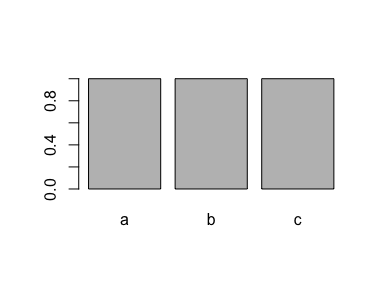
Geralmente é uma boa solução para um problema que irrita muita gente. Poupe dor de cabeça e dê um factor nesse factor!
$, depois vem a performanceDa próxima vez que quiser extrair valores de uma coluna de data.frame em que as linhas atendem a uma condição, especifique a coluna com $ antes das linhas com [.
Digamos que você quer a potência (hp) dos carros com 4 cilindros (cyl) no conjunto mtcars. Você pode escrever de qualquer um destes jeitos:
# linhas primeiro, coluna depois — não é o ideal
mtcars[mtcars$cyl == 4, ]$hp
#>  [1]  93  62  95  66  52  65  97  66  91 113 109

# coluna primeiro, linhas depois — bem melhor
mtcars$hp[mtcars$cyl == 4]
#>  [1]  93  62  95  66  52  65  97  66  91 113 109
A dica é usar a segunda abordagem.
Mas por quê?
Primeiro motivo: se livrar daquela vírgula chata! Quando você especifica as linhas antes da coluna, precisa lembrar da vírgula: mtcars[mtcars$cyl == 4,]$hp. Ao indicar a coluna primeiro, você passa a referenciar um vetor — e não precisa da vírgula!
Segundo motivo: velocidade! Vamos testar em um data frame maior:
# Simulando um data frame...
n <- 1e7
d <- data.frame(
  a = seq(n),
  b = runif(n)
)

# linhas primeiro, coluna depois — não é o ideal
system.time(d[d$b > .5, ]$a)
#>    user  system elapsed
#>   0.497   0.126   0.629

# coluna primeiro, linhas depois — bem melhor
system.time(d$a[d$b > .5])
#>    user  system elapsed
#>   0.089   0.017   0.107
Vale a pena, né?
Ainda assim, se você quiser lapidar suas habilidades de ninja de data frame em R, recomendo aprender dplyr. Você pode ver um bom overview no site do dplyr ou aprender de verdade com cursos online como o Data Manipulation in R with dplyr da DataCamp.
Obrigado por ler e espero que isso tenha sido útil para você.
Para novidades dos posts recentes, siga @drsimonj no Twitter ou me envie um e-mail em drsimonjackson@gmail.com.
Se quiser o código que gerou este post, confira o repositório blogR no GitHub.
Dê uma olhada no nosso Guia de introdução ao Tidyverse: tutorial.
Cursos de R
Curso
Curso
Curso
blog
Elena Kosourova
14 min
blog
Javier Canales Luna
13 min
Tutorial
Karlijn Willems
15 min
Tutorial
Ryan Sheehy
3 min
Tutorial
DataCamp Team
15 min
Tutorial
Elena Kosourova
12 min