Cours
Introduction à R
4 h
3.1M
Plus de 10 millions de personnes apprennent Python, R, SQL et d'autres compétences techniques grâce à nos cours pratiques élaborés par des experts du secteur.
which()La prochaine fois que vous utilisez which(), essayez de vous en passer ! On l’emploie souvent pour récupérer des indices à partir d’une condition booléenne, puis sélectionner les valeurs à ces indices. Ce n’est pas nécessaire.
Récupérer les éléments d’un vecteur supérieurs à 5 :
x <- 3:7

# Avec which (inutile ici)
x[which(x > 5)]
#> [1] 6 7

# Sans which
x[x > 5]
#> [1] 6 7
Ou compter le nombre de valeurs supérieures à 5 :
# Avec which
length(which(x > 5))
#> [1] 2

# Sans which
sum(x > 5)
#> [1] 2
Pourquoi se passer de which() ? Il est souvent superflu et des vecteurs booléens suffisent largement.
Par exemple, R permet de sélectionner les éléments marqués TRUE dans un vecteur booléen :
condition <- x > 5
condition
#> [1] FALSE FALSE FALSE  TRUE  TRUE
x[condition]
#> [1] 6 7
De plus, combinés à sum() ou mean(), les vecteurs booléens permettent d’obtenir le nombre ou la proportion de valeurs qui vérifient une condition :
sum(condition)
#> [1] 2
mean(condition)
#> [1] 0.4
which() renvoie les indices des valeurs TRUE :
which(condition)
#> [1] 4 5
Et même si le résultat est correct, ce n’est tout simplement pas nécessaire. Par exemple, on voit souvent which() combiné à length() pour tester si au moins une ou toutes les valeurs sont TRUE. À la place, utilisez simplement any() ou all() :
x <- c(1, 2, 12)

# Avec `which()` et `length()` pour tester si au moins une valeur est > 10
if (length(which(x > 10)) > 0)
  print("At least one value is greater than 10")
#> [1] "At least one value is greater than 10"

# Enveloppé dans `any()`
if (any(x > 10))
  print("At least one value is greater than 10")
#> [1] "At least one value is greater than 10"

# Avec `which()` et `length()` pour tester si toutes les valeurs sont positives
if (length(which(x > 0)) == length(x))
  print("All values are positive")
#> [1] "All values are positive"

# Enveloppé dans `all()`
if (all(x > 0))
  print("All values are positive")
#> [1] "All values are positive"
Et au passage, vous gagnerez un peu de temps…
x <- runif(1e8)

system.time(x[which(x > .5)])
#>    user  system elapsed
#>   1.156   0.522   1.686

system.time(x[x > .5])
#>    user  system elapsed
#>   1.071   0.442   1.662
factor, pensez à refactoriser !Vous avez déjà supprimé des valeurs d’un facteur et constaté que d’anciens niveaux restaient enregistrés alors qu’ils n’existent plus ? On voit des tas de bricolages pour gérer ça. La solution la plus simple consiste souvent à l’envelopper à nouveau dans factor().
Cet exemple crée un facteur à quatre niveaux ("a", "b", "c" et "d") :
# Un facteur à quatre niveaux
x <- factor(c("a", "b", "c", "d"))
x
#> [1] a b c d
#> Levels: a b c d

plot(x)
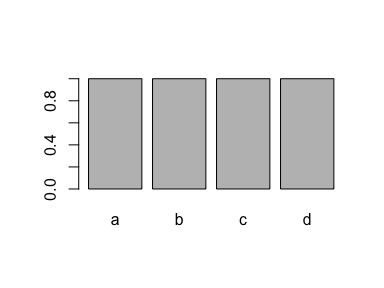
Si vous supprimez tous les cas d’un niveau ("d"), ce niveau reste tout de même enregistré dans le facteur :
# Supprimer toutes les valeurs d’un niveau
x <- x[x != "d"]

# Mais le niveau est toujours là !
x
#> [1] a b c
#> Levels: a b c d

plot(x)
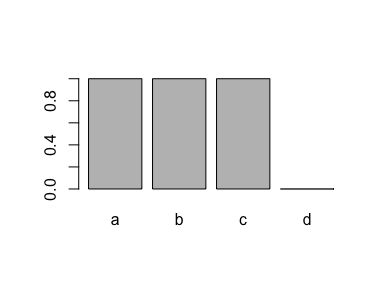
La méthode ultra simple pour l’enlever : utiliser à nouveau factor() :
x <- factor(x)
x
#> [1] a b c
#> Levels: a b c

plot(x)
C’est en général une bonne solution à un problème qui agace beaucoup de monde. Épargnez-vous ce casse-tête et factorisez votre facteur !
$, ensuite la puissanceLa prochaine fois que vous voulez extraire les valeurs d’une colonne d’un data.frame dont les lignes vérifient une condition, indiquez d’abord la colonne avec $, puis les lignes avec [.
Supposons que vous vouliez la puissance (hp) des voitures à 4 cylindres (cyl) dans le jeu de données mtcars. Vous pouvez écrire l’une ou l’autre de ces formes :
# Lignes d’abord, colonne ensuite — pas idéal
mtcars[mtcars$cyl == 4, ]$hp
#>  [1]  93  62  95  66  52  65  97  66  91 113 109

# Colonne d’abord, lignes ensuite — bien mieux
mtcars$hp[mtcars$cyl == 4]
#>  [1]  93  62  95  66  52  65  97  66  91 113 109
Le conseil ici : préférez la seconde approche.
Pourquoi ?
Première raison : finie, la virgule qui traîne ! Quand vous indiquez les lignes avant la colonne, il faut se souvenir de la virgule : mtcars[mtcars$cyl == 4,]$hp. En indiquant d’abord la colonne, vous référencez un vecteur, donc pas besoin de virgule !
Deuxième raison : la vitesse ! Testons sur un data frame plus gros :
# Simulation d’un data frame…
n <- 1e7
d <- data.frame(
  a = seq(n),
  b = runif(n)
)

# Lignes d’abord, colonne ensuite — pas idéal
system.time(d[d$b > .5, ]$a)
#>    user  system elapsed
#>   0.497   0.126   0.629

# Colonne d’abord, lignes ensuite — bien mieux
system.time(d$a[d$b > .5])
#>    user  system elapsed
#>   0.089   0.017   0.107
Ça vaut le coup, n’est-ce pas ?
Pour aller plus loin et affûter vos compétences de ninja des data frames en R, je vous recommande d’apprendre dplyr. Vous trouverez une bonne vue d’ensemble sur le site dplyr ou vous pouvez vraiment prendre en main l’outil avec des cours en ligne comme le cours de DataCamp Data Manipulation in R with dplyr.
Merci de votre lecture, j’espère que cela vous sera utile.
Pour être informé des dernières publications, suivez @drsimonj sur Twitter, ou écrivez-moi à drsimonjackson@gmail.com.
Si vous souhaitez le code qui a servi à produire cet article, consultez le référentiel GitHub blogR.
Découvrez notre guide de démarrage avec le Tidyverse : tutoriel.
Cours R
Cours
Cours
Cours