
Last chance! 50% off DataCamp Premium
Sale ends in
ChatGPT’nin yanıt vermesini beklerken yaşadığınız hayal kırıklığını yaşadıysanız, Groq Language Processing Unit (LPU) Çıkarım Motoru’nu duymak sizi sevindirecek.
Groq ile sorgularınıza çok hızlı yanıt alabilir, bekleme sürelerini 40 saniyeden yalnızca 2 saniyeye indirebilirsiniz.
Bu eğitimde şunları yapacağız:
Büyük dil modellerinde (LLM) yeniyseniz, LLM’leri ince ayarlamanın temellerini ve sıfırdan kendi modelinizi oluşturmayı öğrenmek için Geniş Dil Modelleri Geliştirme beceri yolunu öneririz.
Groq’un LPU (language processing unit) Çıkarım Motoru, özellikle büyük dil modelleri için yanıt üretiminde, ardışık bileşenlere sahip hesaplama açısından yoğun görevleri yöneten yeni bir işlem sistemidir. Bu yenilikçi teknoloji, metni işleme ve üretme biçimimizi dönüştürerek benzersiz performans ve hassasiyet sunar.
Geleneksel merkezi işlem birimi (CPU) ve grafik işlem birimi (GPU) ile karşılaştırıldığında, LPU daha yüksek bir hesaplama kapasitesine sahiptir. Bu da bir kelimenin tahmin edilmesi için gereken sürenin önemli ölçüde azalması ve metin dizilerinin çok daha hızlı üretilmesi anlamına gelir. Ayrıca, LPU LLM’lerle çalışırken GPU’ların yaygın bir sınırlaması olan bellek darboğazlarını da ele alır.
Groq, LPU’yu hesaplama yoğunluğu, bellek bant genişliği, düşük gecikme ve yüksek aktarım hızı gibi zorluklara çözüm getirecek şekilde tasarladı. GPU ve TPU’nun (tensor processing unit) ötesinde performans kazanımları sunar. Örneğin, LPU Llama-3 70B üzerinde kullanıcı başına saniyede 310’dan fazla token üretebilir.
LPU mimarisi hakkında daha fazla bilgi edinmek için resmi araştırma makalesi Groq ISCA 2022 Paper’ı okuyabilirsiniz.
Şu anda Groq LLM’lere yalnızca groq.com, Groq Cloud API, Groq Playground ve Poe gibi üçüncü taraf platformlar üzerinden erişebiliyoruz.
Bu bölümde OpenAI ve Groq Cloud’un sunduğu özellikleri ve modelleri öğreneceğiz. Ayrıca CURL kullanarak API çağrılarının hızını test edecek ve API tasarımlarını karşılaştıracağız.
OpenAI API geniş bir özellik ve model yelpazesi sunar. Şunları sağlar:
OpenAI API hızlıdır ve zamanla daha da ucuzlamaktadır.
En yeni OpenAI modeline terminalde aşağıdaki komutu yazarak erişebiliriz. API, OpenAI’nin API anahtarını, model adını ve sistem yönergesi ile kullanıcı sorgusunu içeren mesajları gerektirir.
curl -X POST https://api.openai.com/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -d '{
    "model": "gpt-4o",
    "messages": [
      {        "role": "system",
        "content": "You are a helpful assistant."
      },
      {
        "role": "user",
        "content": "How do I get better at programming?"
      }
    ]
  }'
İsteğin tamamlanması 13 saniye sürdü.
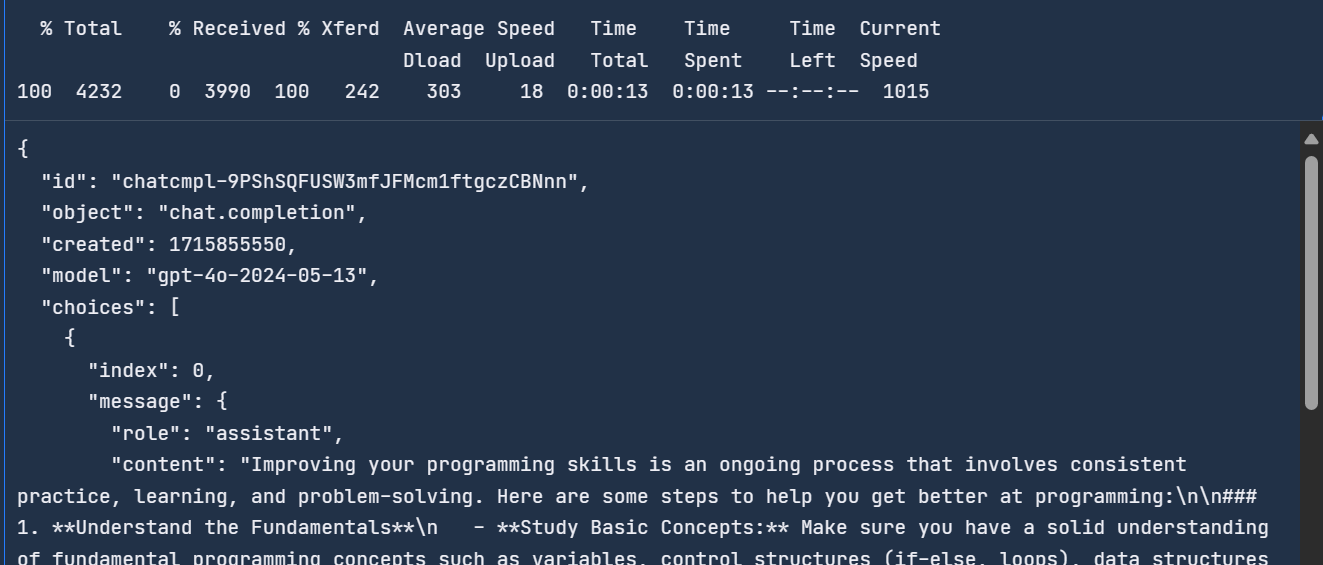
OpenAI'nin API’sı ve özellikleri hakkında daha fazla bilgi edinmek için şu içeriğe göz atın: OpenAI API’ye Yeni Başlayanlar için Rehber: Uygulamalı Eğitim ve En İyi Uygulamalar.
Groq, yapay zeka dünyasında yeni olup şu anda sınırlı özellikler ve modeller sunmaktadır. Şunları sağlar:
Groq Cloud API, OpenAI API’ye kıyasla daha hızlı yanıt süresi sağlar. Bunu test etmek için terminalde CURL komutunu kullanacak ve Groq API’sine aynı mesajı vereceğiz.
Groq API, tek fark URL olmak üzere OpenAI API’sine benzer.
curl -X POST "https://api.groq.com/openai/v1/chat/completions" \
    -H "Authorization: Bearer $GROQ_API_KEY" \
    -H "Content-Type: application/json" \
    -d '{"messages": [
     {
       "role": "system",
       "content": "You are a helpful assistant."
     },
     {        "role": "user",
       "content": "How do I get better at programming?"
     }
   ],
   "model": "llama3-70b-8192"}'
OpenAI API’ye kıyasla iki saniyede yanıt verdi; bu da 6,5 kat daha hızlı olduğu anlamına gelir.
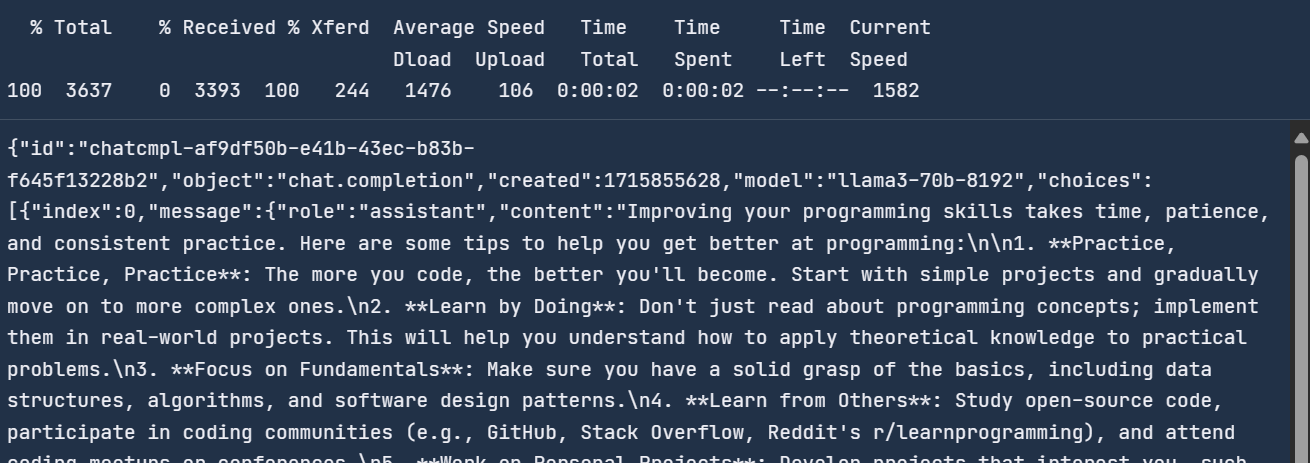
Groq ile bazı uygulamalar için kritik olan gerçek zamanlı yanıt üretimi elde edersiniz.
Groq Cloud, yapay zeka ürün ve uygulamaları geliştirmek için kullanabileceğiniz tüm model ve API’leri test edebileceğiniz bir AI playground ile birlikte gelir.
Groq Cloud’a erişmek için önce bu bağlantıya giderek bir hesap oluşturmanız gerekir.
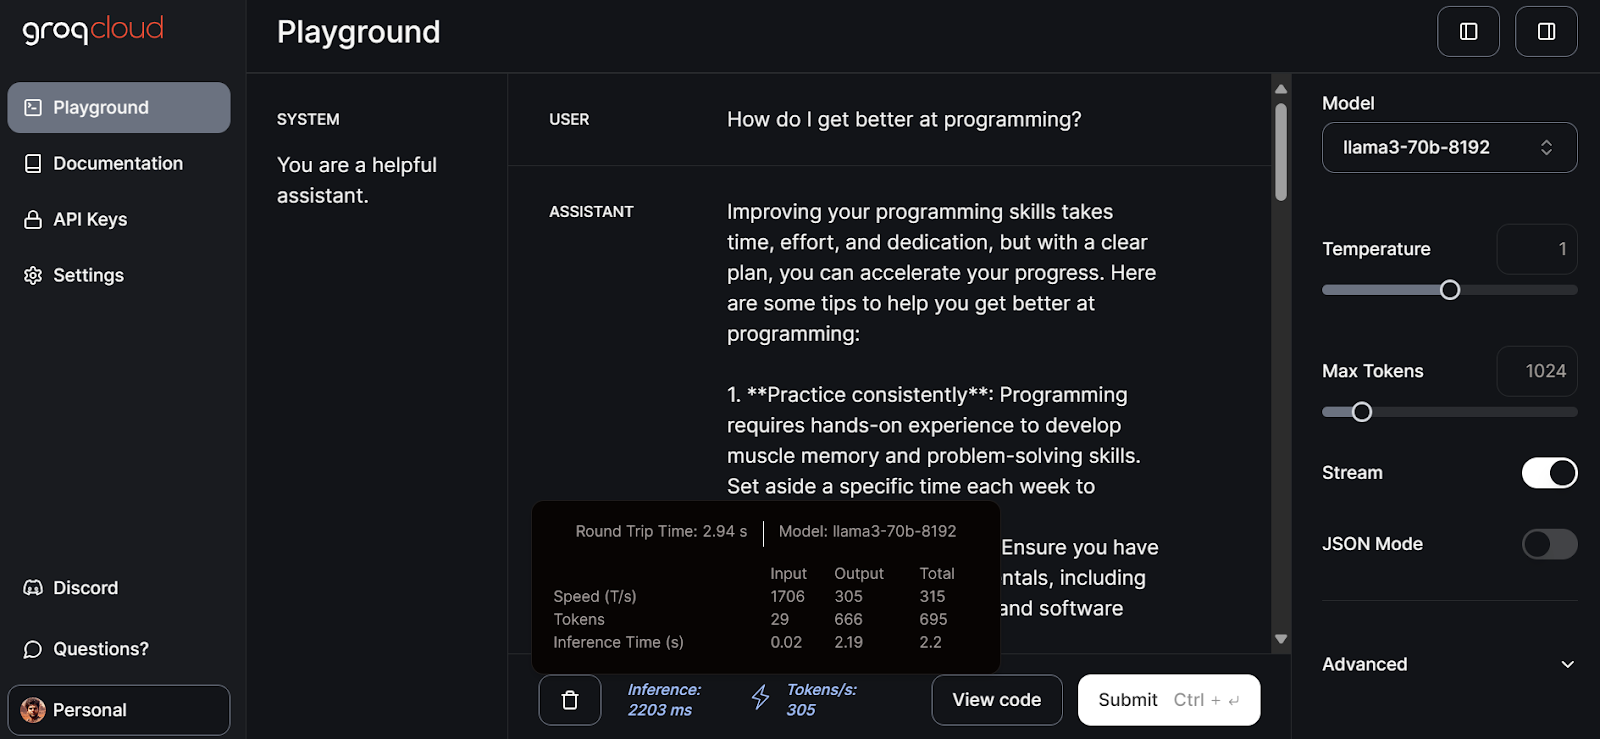
Ardından sol paneldeki playground sekmesine tıklayın, llama3-70b-8192 modelini seçin ve USER girişi için yönergeler yazmaya başlayın.
Tam yanıtın üretilmesi 2,94 saniye sürdü ve hız saniyede 305 token idi. Bu, ChatGPT’den elde edemeyeceğimiz zirve bir performans.
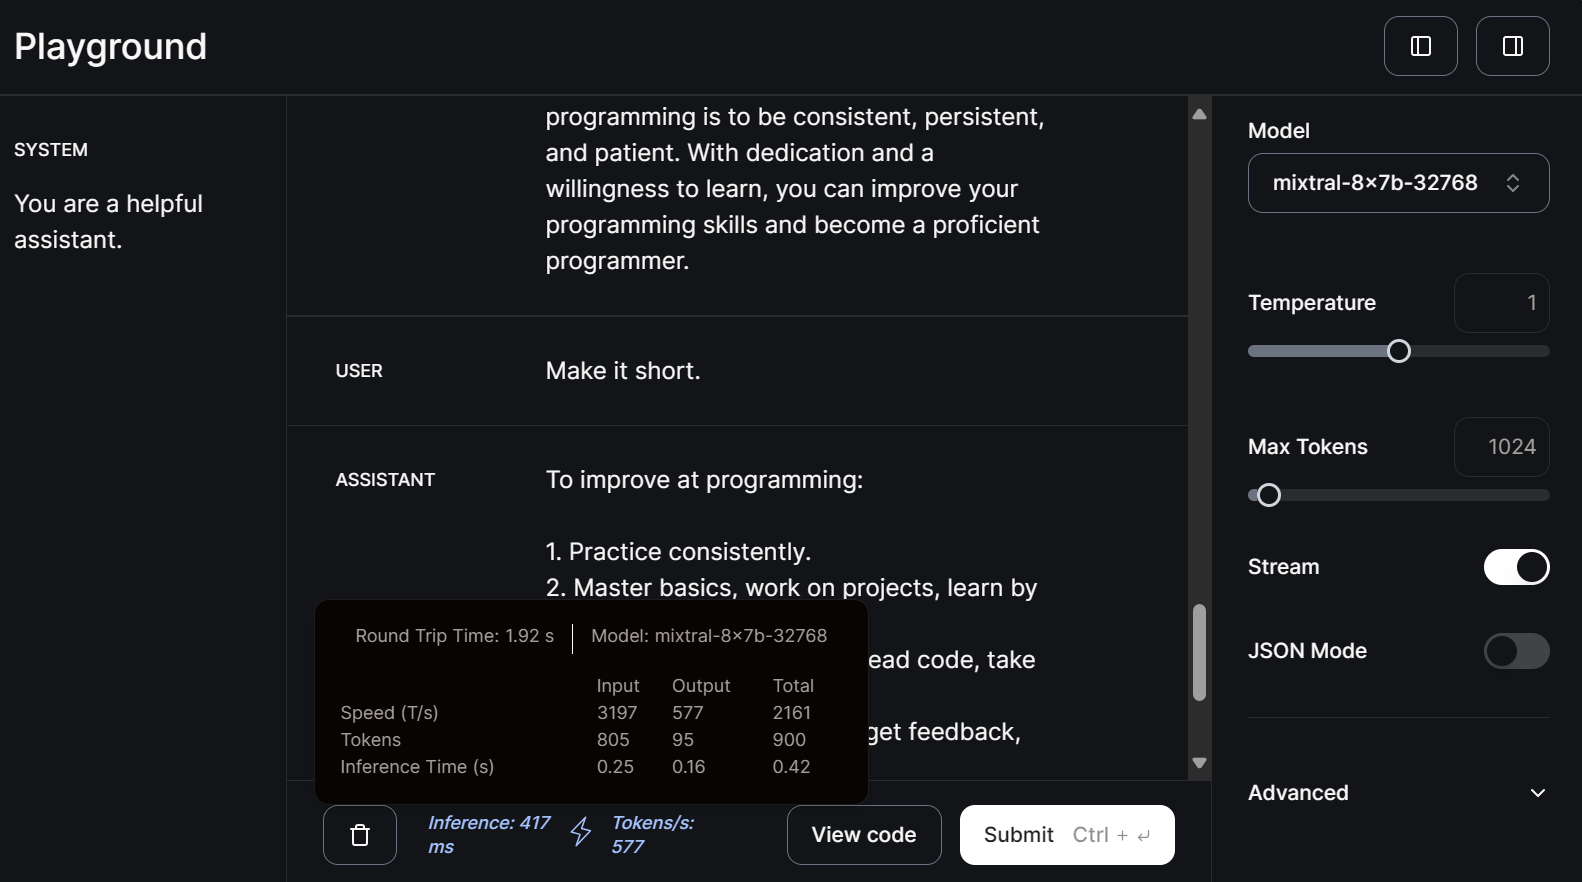
Şimdi küçük model mitral-8x7b-32768’i seçelim ve devam niteliğinde bir yönerge yazalım.
Daha küçük modeller, saniyede 577 token hızla yanıt üretmede daha da hızlıdır.
Mevcut LLM seçenekleri ve seçim yaparken dikkate alınması gereken faktörler hakkında bilgi edinmek için LLM Sınıflandırması: Uygulamanız için En İyi LLM Nasıl Seçilir başlıklı bu eğitimi okuyabilirsiniz.
Groq LLM’lerine yerelde erişmek için API Keys sekmesine gidip Create API Key düğmesine tıklayarak bir API anahtarı üretmemiz gerekiyor.
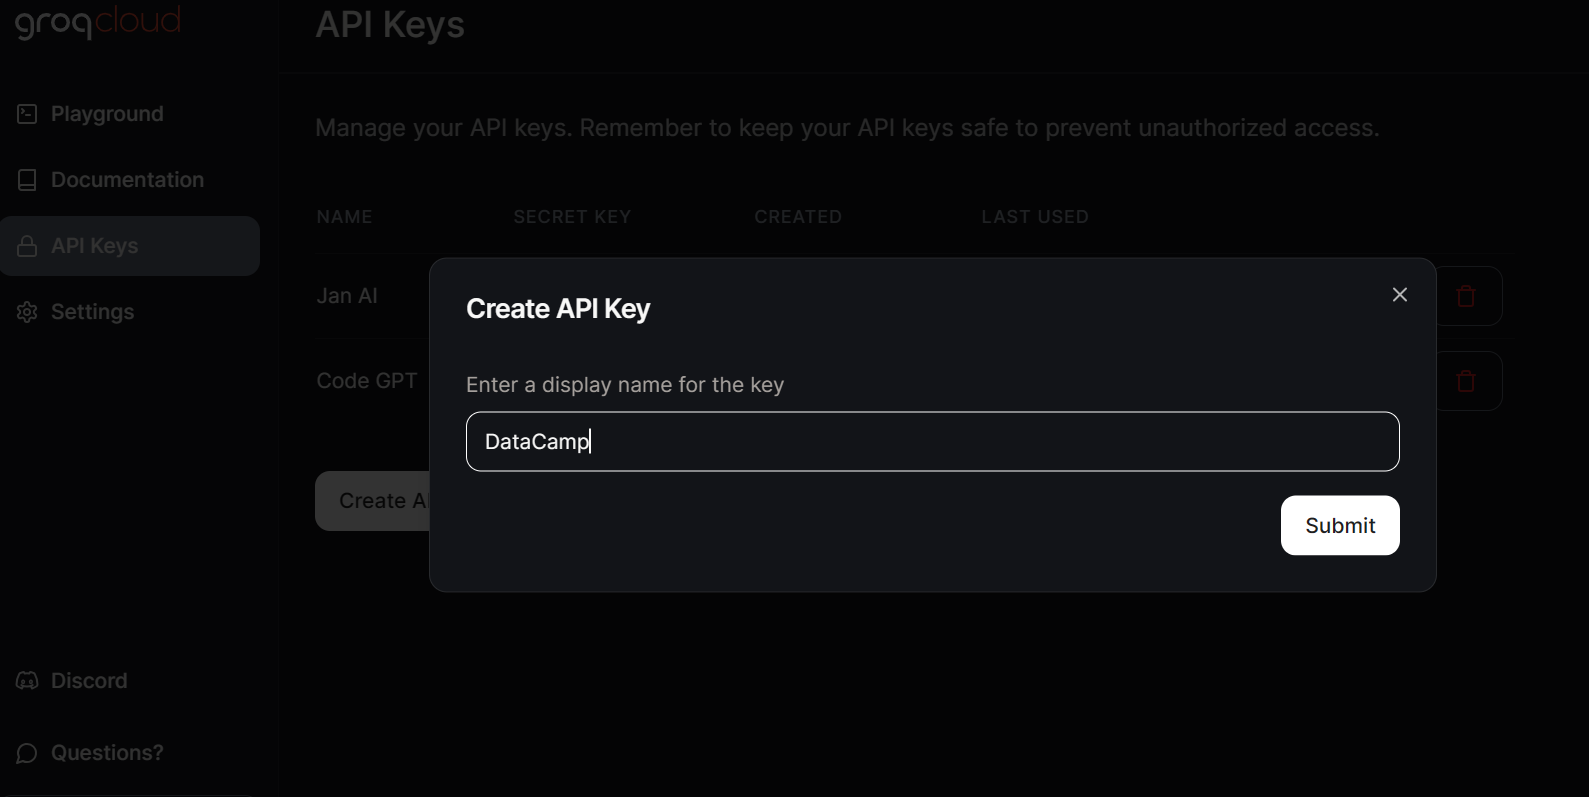
Jan AI, hem açık kaynak hem de tescilli modelleri yerelde kullanmamıza olanak tanır. OpenAI, Anthropic, Cohere, MistralAI ve Groq gibi model sağlayıcılarını destekler.
Resmi web sitesine giderek Jan AI’ı indirecek ve kuracağız. Ardından uygulamayı başlatabiliriz.
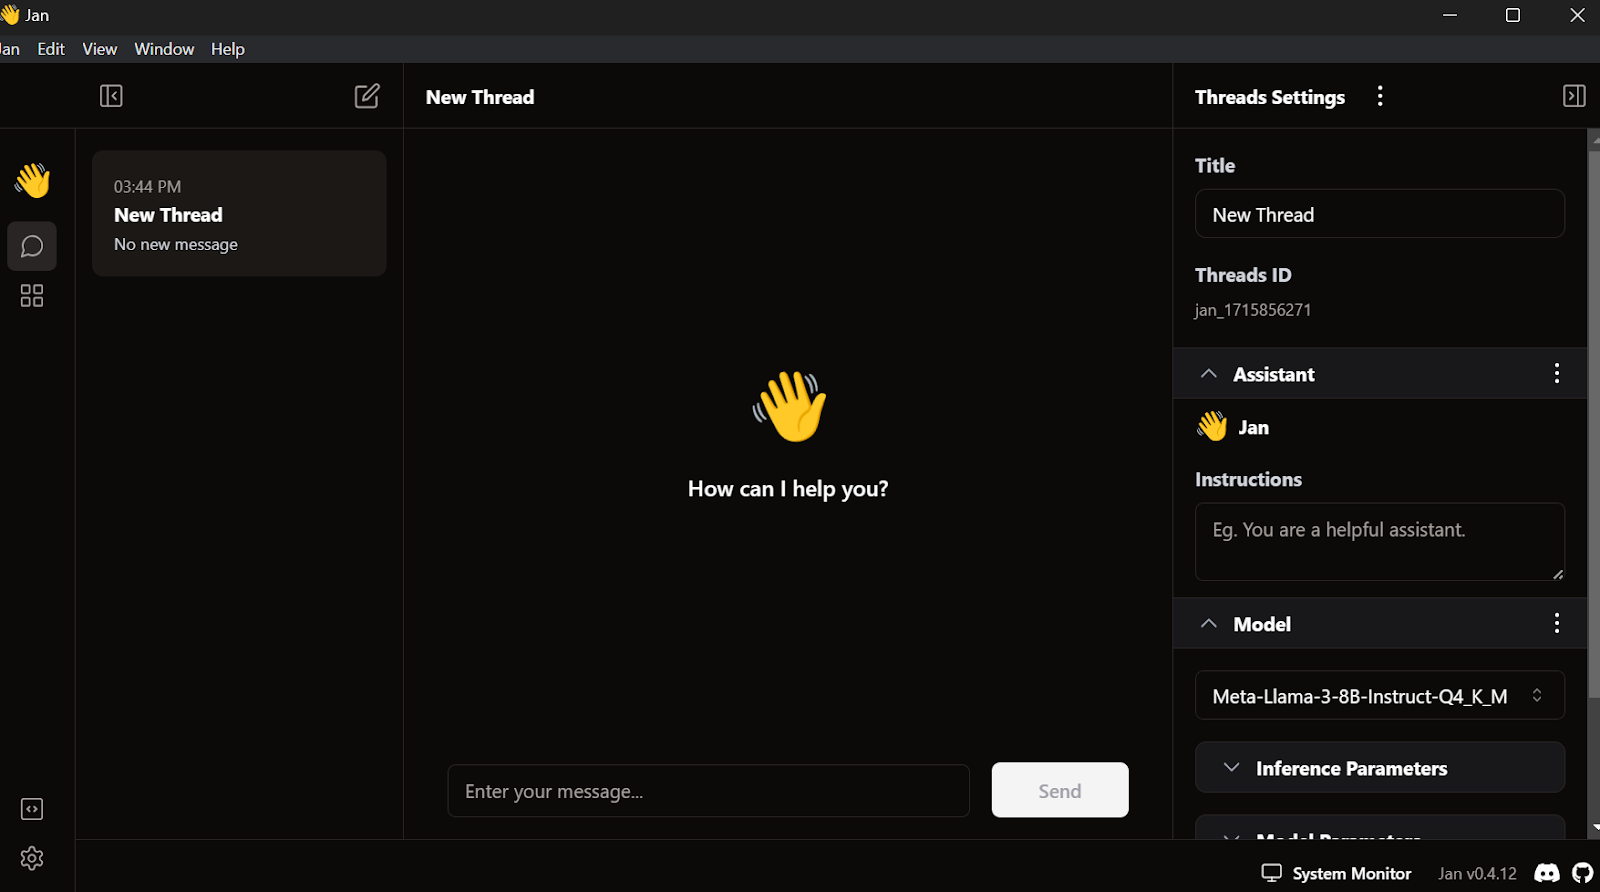
Ayarlar bölümüne gidin, Groq Inference Engine sekmesini seçin ve az önce oluşturduğumuz API anahtarını yapıştırın.
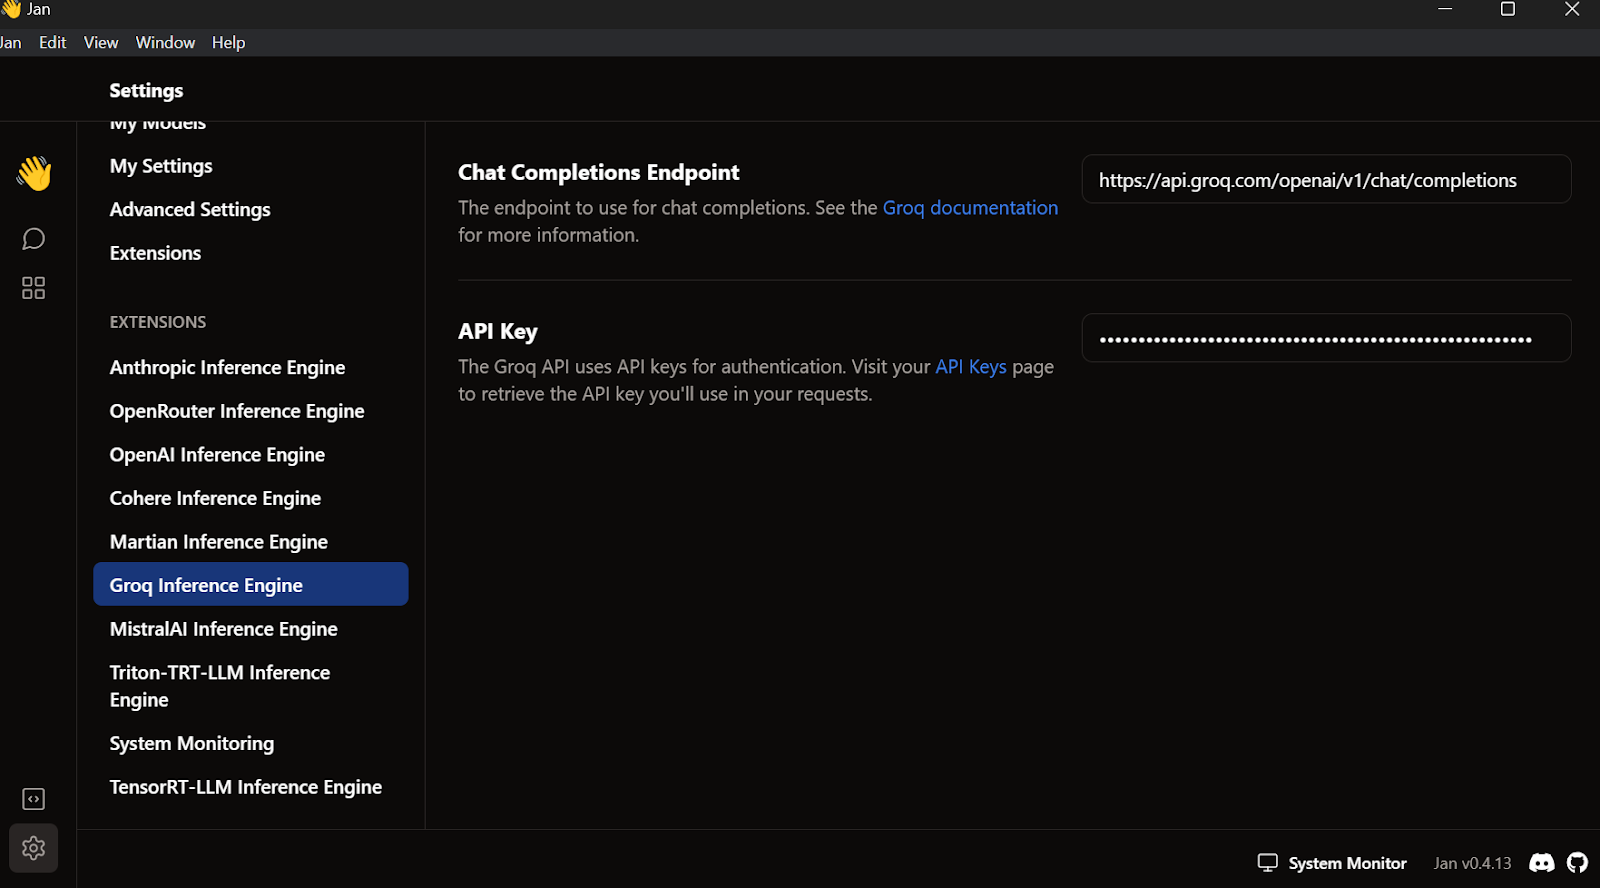
Ayarlar menüsünden çıkın, Thread’e gidin ve Groq Llama 3 70b modelini seçin.
Gerçek zamanlı yanıt üretmek için bir soru veya yönerge yazın:
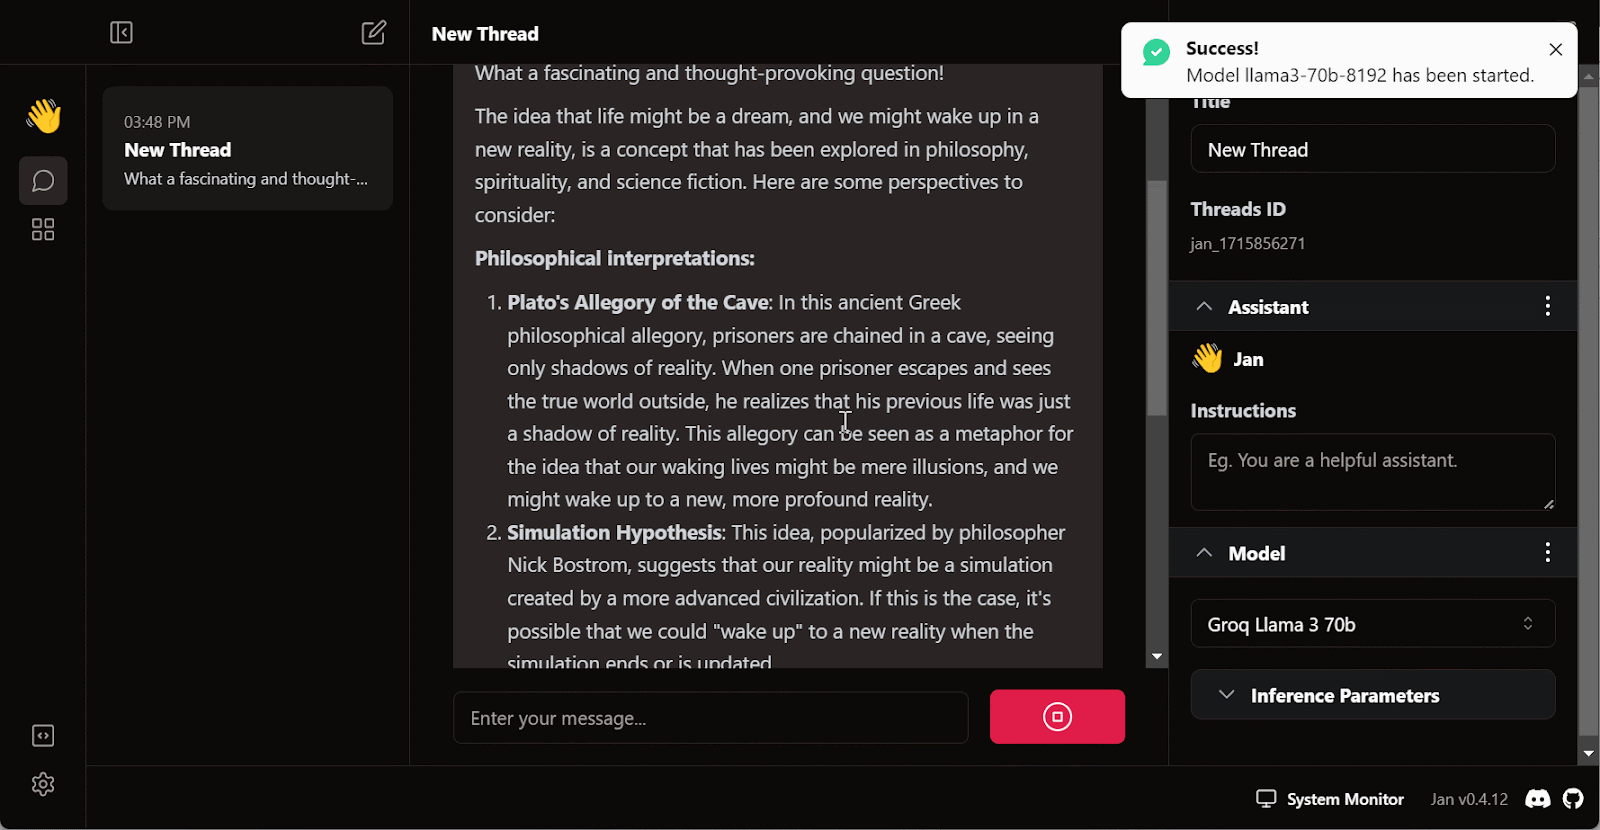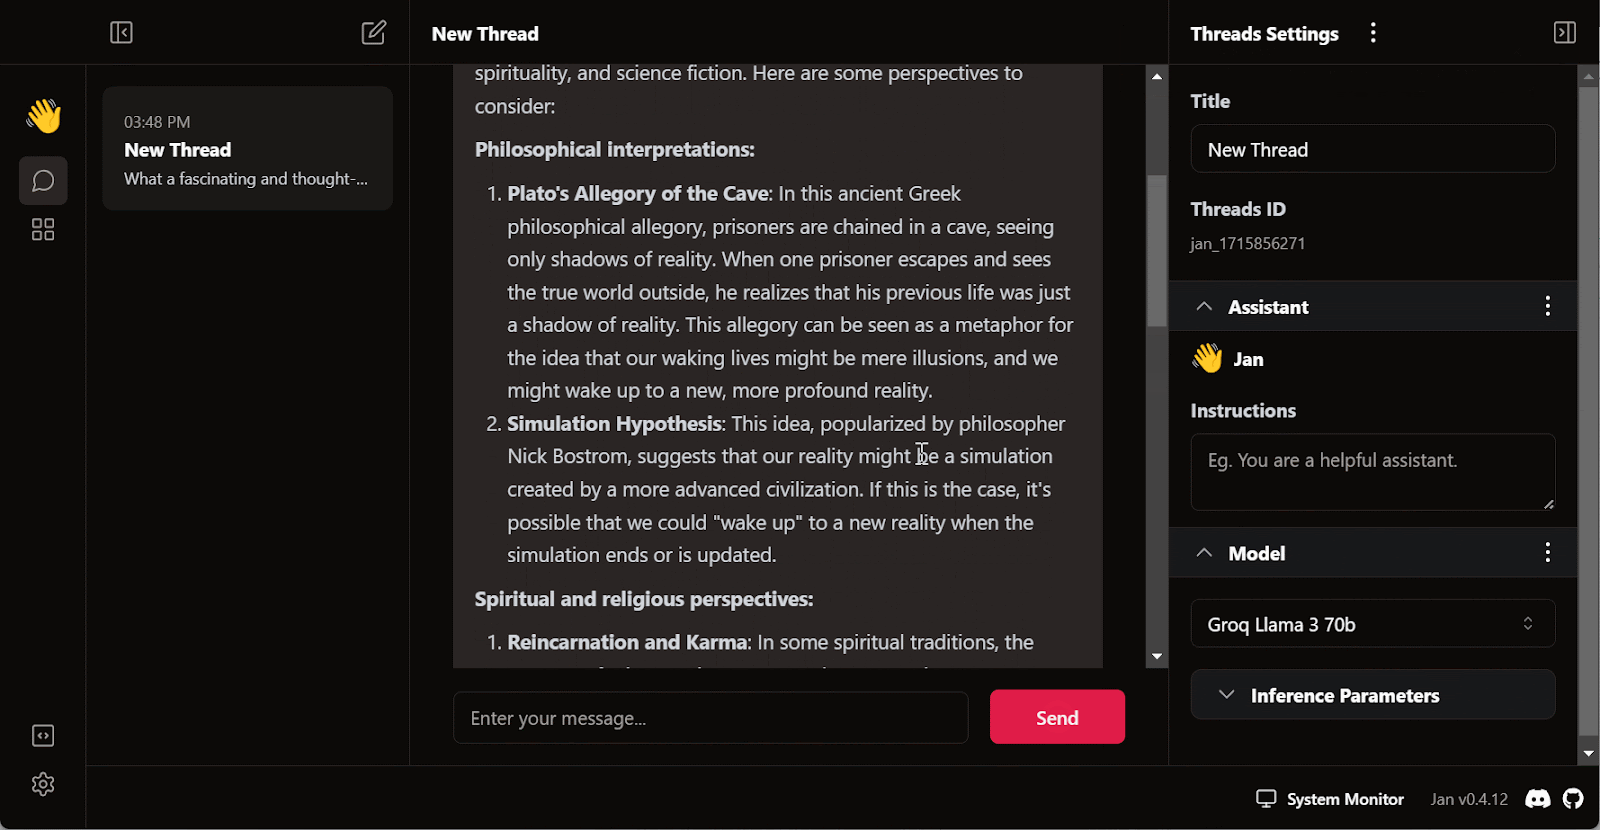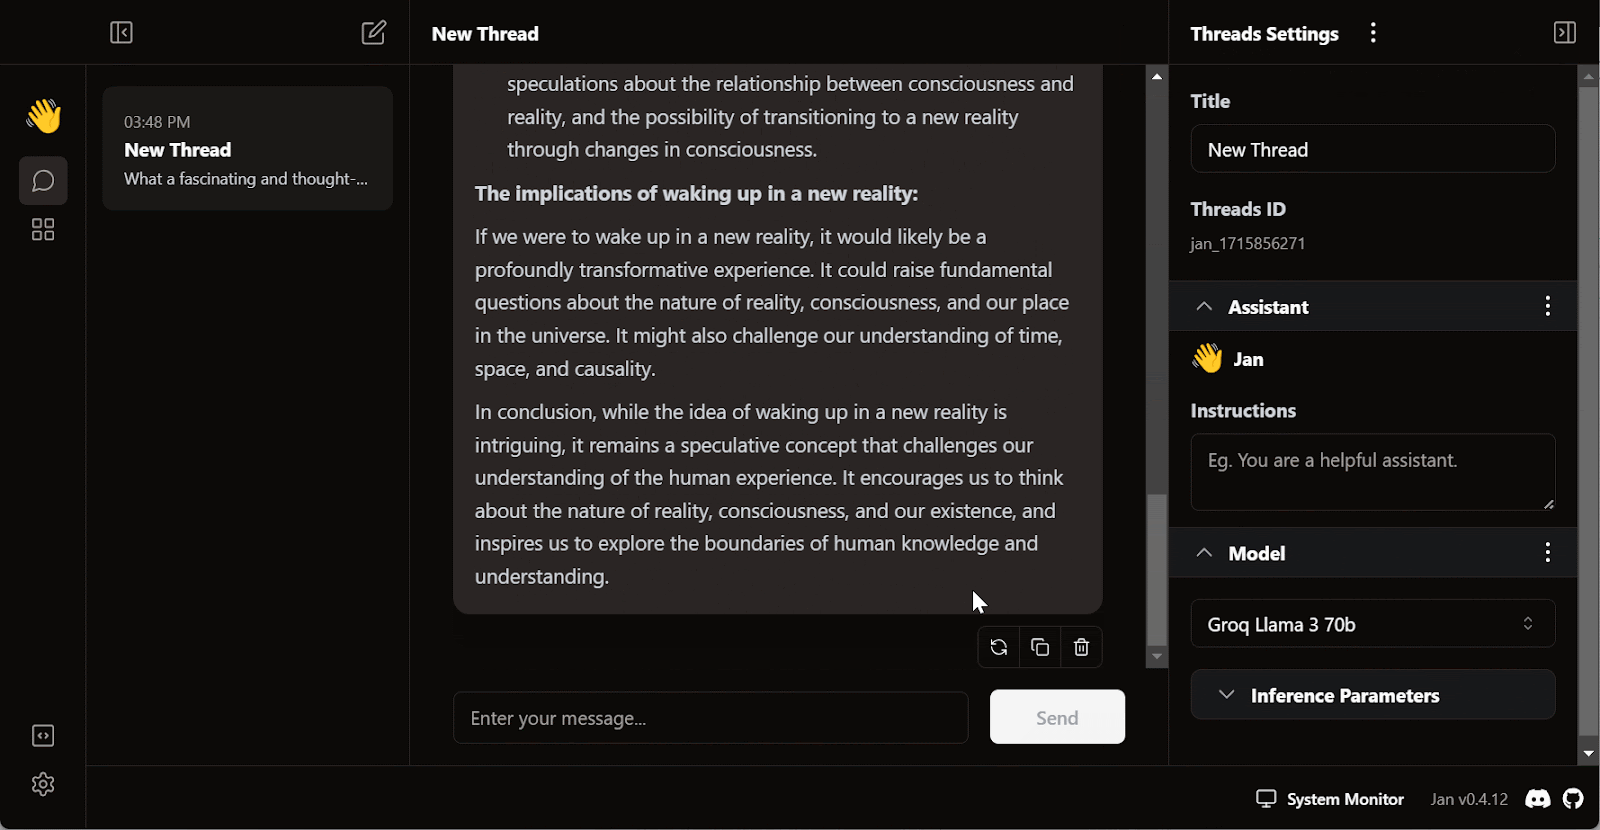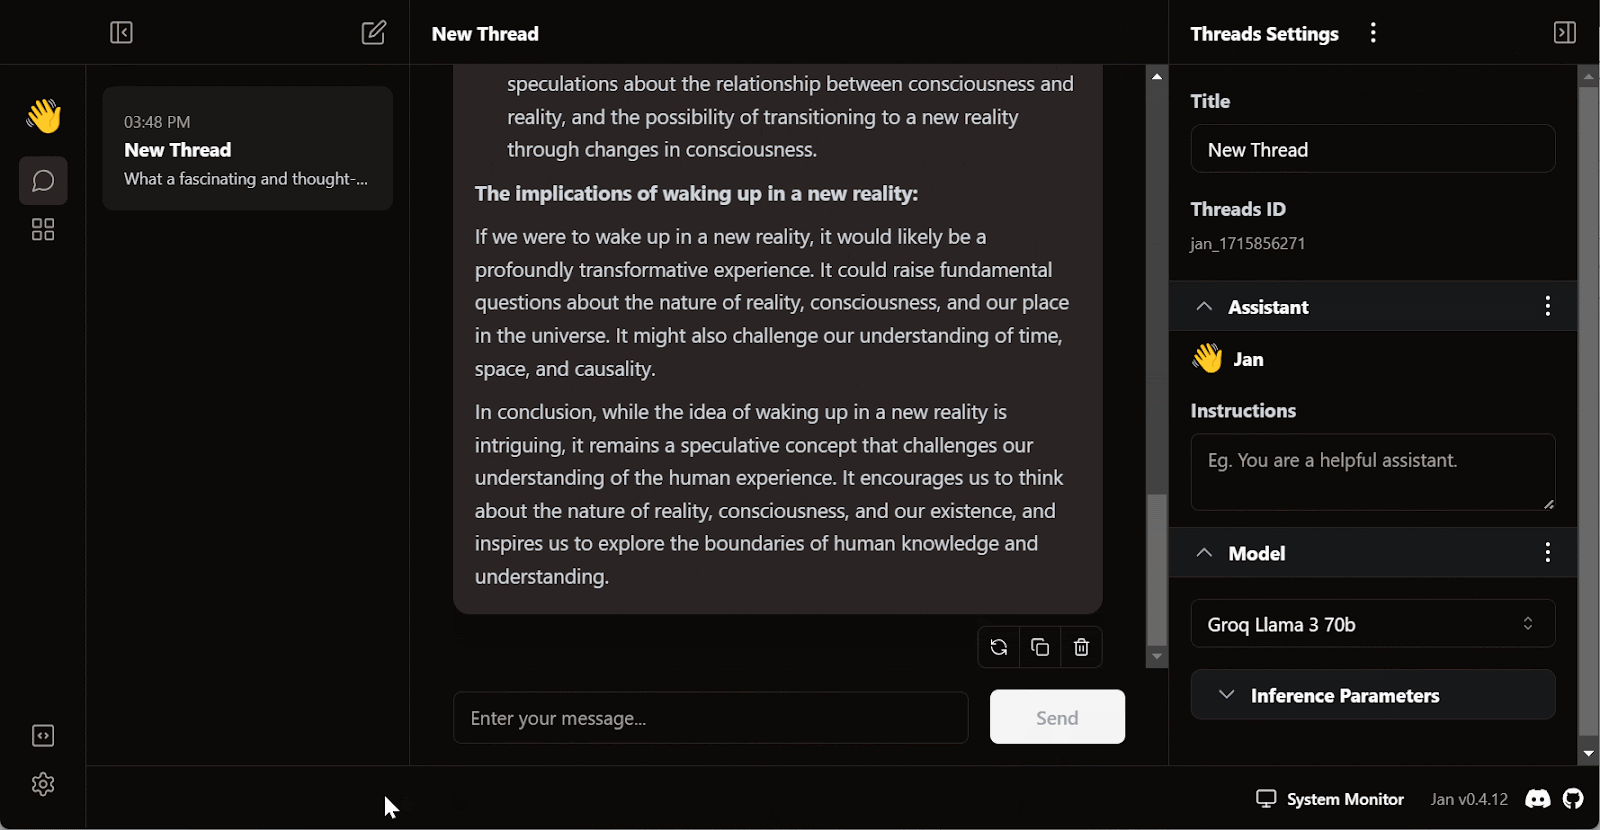
Groq Cloud’un ücretsiz aboneliği belirli oran sınırlamalarıyla gelir. Örneğin, llama3-70b-8192 planı dakikada 30 istek, günde 14.400 istek ve dakikada 6.000 token’a izin verir. Bu sınırlamalar cömert olsa da, Groq API’sini kullanarak düzgün bir yapay zeka uygulaması oluşturmayı planlıyorsanız On Demand veya Enterprise paketine yükseltmeyi düşünmeniz gerekebilir.
Yerelde LLM çalıştırma hakkında bilgi edinmek için, yapay zeka uygulamalarını yerelde çalıştırmanın yedi basit yolunu keşfedeceğiniz LLM’leri yerelde çalıştırma eğitimini okuyabilirsiniz.
Groq API’sini bir sohbetbotu uygulamasında kullanmanın yanı sıra, CodeGPT uzantısını kullanarak VSCode’a da entegre edebiliriz. Bu, son derece hızlı bir yapay zeka kod asistanımız olacak.
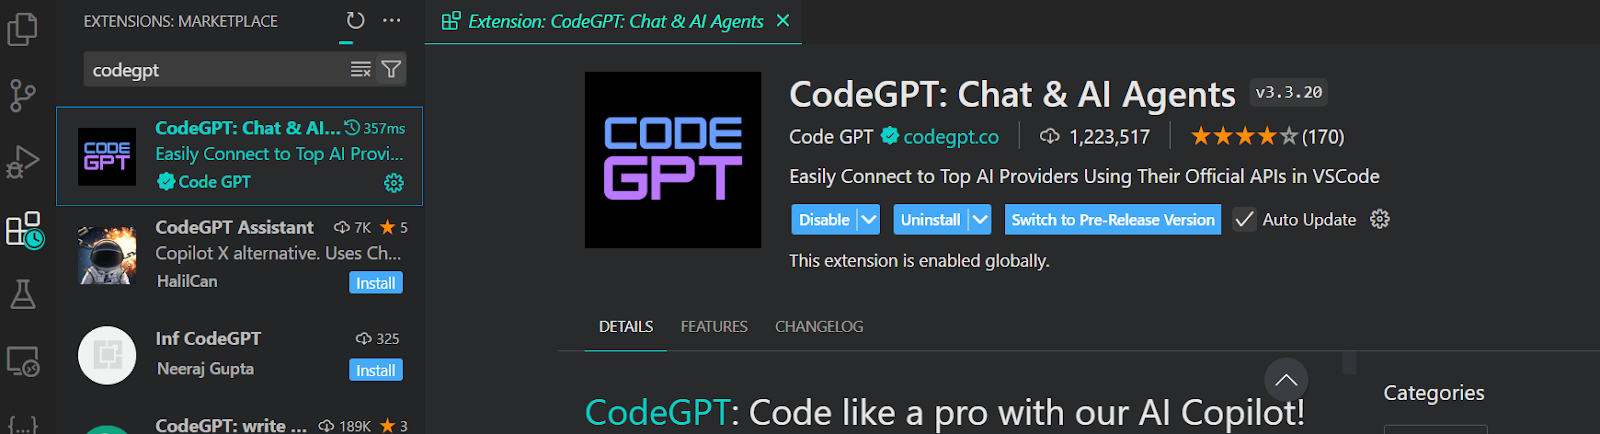
VSCode’da Groq modeline erişmek için uzantı pazarına giderek CodeGPT uzantısını kurmamız gerekir.
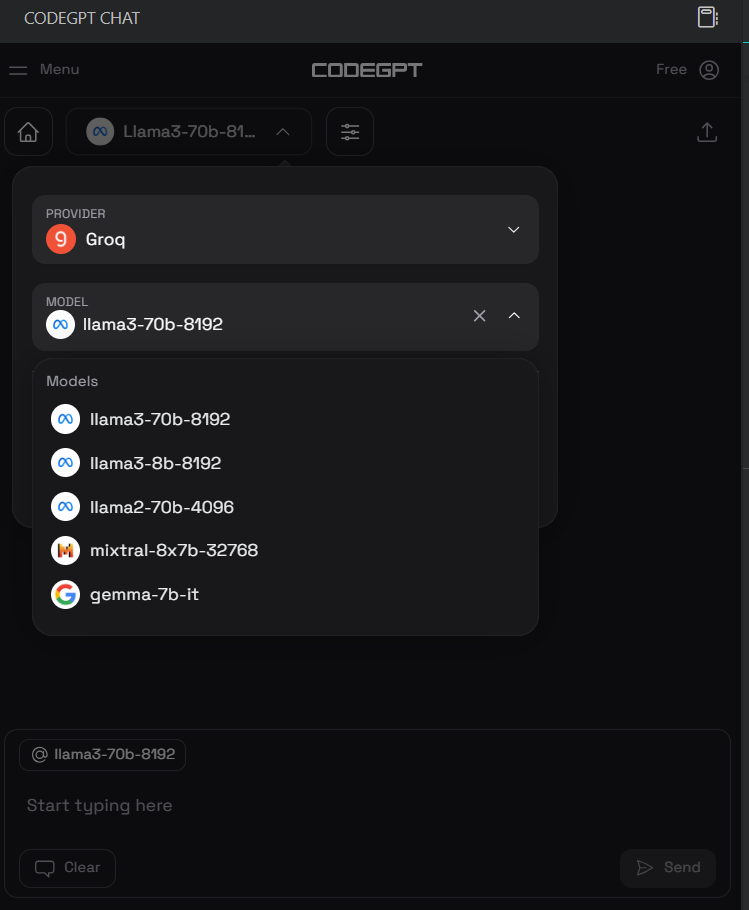
Kurulum tamamlandıktan sonra, sol paneldeki CodeGPT sohbet simgesine tıklayıp sağlayıcıyı ve modeli seçerek Groq API anahtarını ayarlayacağız. Sağlayıcı olarak Groq’u, model olarak ise llama3-70b-8192’yi seçtik.
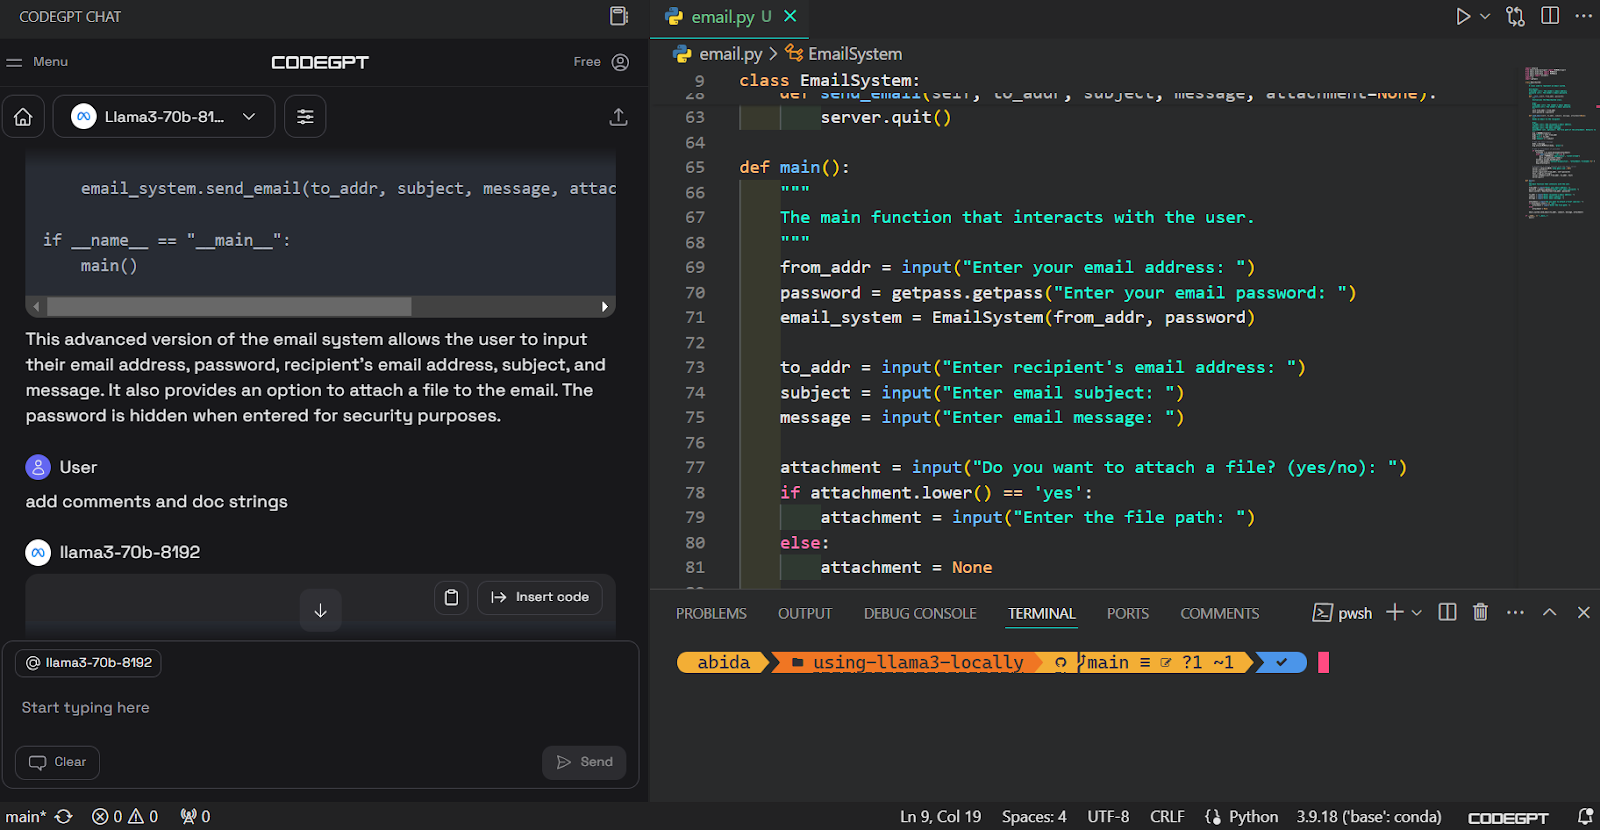
Bundan sonra, sohbet kutusuna bir yönerge yazıp kod üretebiliriz. Doğru kodu oluşturup e-posta sistemini kurmak sadece birkaç saniyemizi aldı.
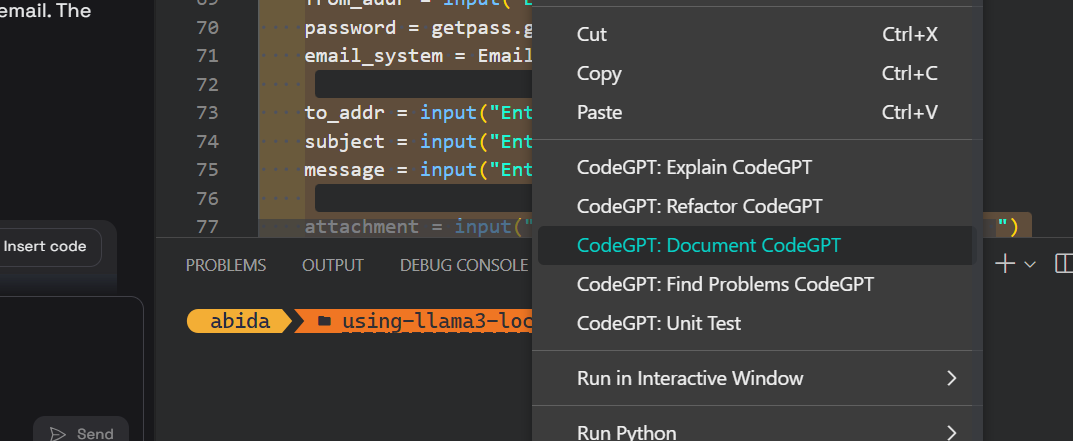
Ardından kodu belgelendirebilir, yeniden düzenleyebilir ve yerleşik komutlarla birim testini oluşturabiliriz.
VSCode hakkında bilgi edinmek için Python için VSCode kurulumu başlıklı bu eğitimi okuyabilirsiniz.
Bu bölümde Groq Python API’sinin temellerini ve akış (streaming) ile eşzamansız (async) sohbet tamamlama gibi temel özelliklerini öğreneceğiz.
Bu rehber için DataCamp’in DataLab platformunu kullanıyoruz. DataLab, kod yazma, veri analizi ve içgörü paylaşımı için çok sayıda özellikle gelen bir AI Cloud Jupyter Notebook’tur.
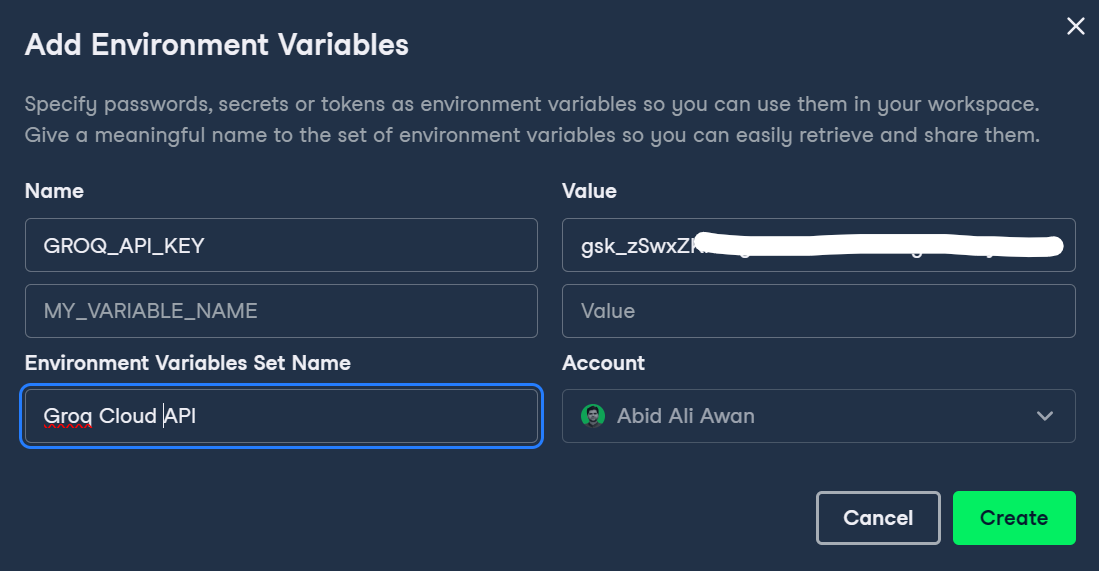
Önce, sol paneldeki Environment düğmesine tıklayıp artı + simgesiyle ortam değişkeni ekleyerek DataLab’de Groq API anahtarını ayarlamamız gerekiyor.
Aşağıda gösterildiği gibi değişkenin adını yazabilir ve Groq API anahtarını yapıştırabiliriz.
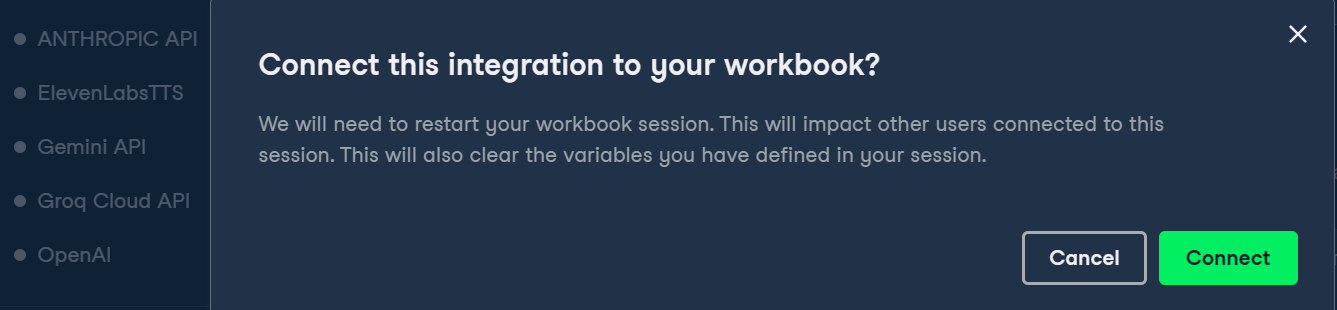
Daha sonra, Groq ortam değişkeninin yanındaki üç noktaya tıklayıp Connect’e tıklayarak ortam değişkenini etkinleştirebiliriz.
Son olarak, pip komutunu kullanarak Groq Python paketini kuracağız.
%pip install groq -qOpenAI Python API’sini kullandıysanız, kod yapısının benzer olduğunu görebilirsiniz. Sohbet tamamlamayı çalıştırmak için:
import os
from groq import Groq
from IPython.display import display, Markdown

client = Groq(
   api_key=os.environ.get("GROQ_API_KEY"),
)

chat_completion = client.chat.completions.create(
   messages=[
       {"role": "system", "content": "You are a professional Data Scientist."},
       {"role": "user", "content": "Can you explain how the neural networks work?"},
   ],
   model="llama3-70b-8192",)

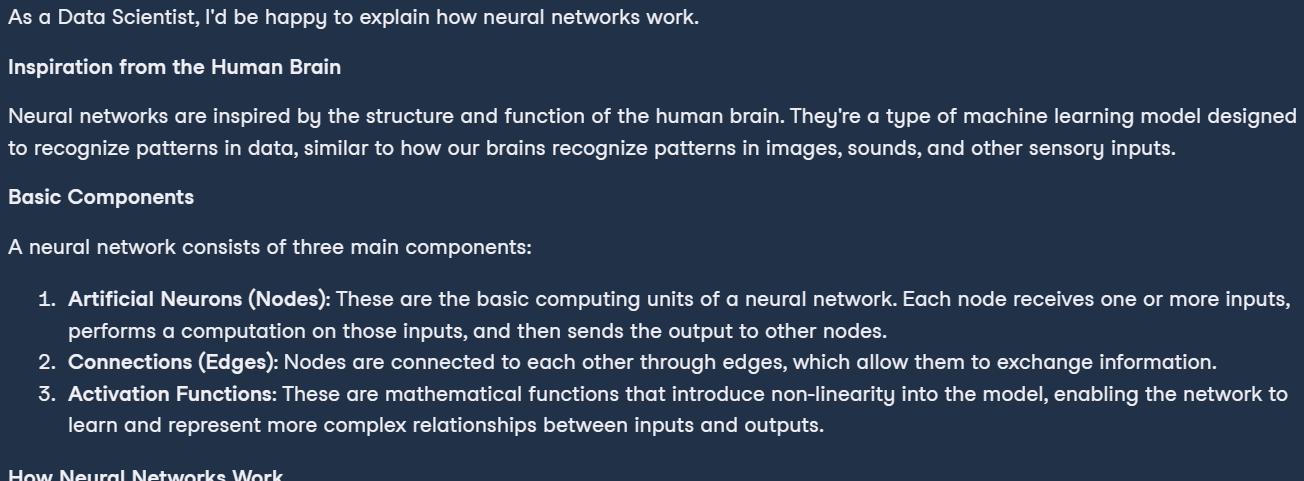
Markdown(chat_completion.choices[0].message.content)
Sonuç olarak, sinir ağlarının ne olduğuna dair kusursuz biçimlendirilmiş bir açıklama elde ettik.
LLM’lerde akış, metni bir seferde bir token işlemeden ve üretmeden geçer; bu da belleğin verimli kullanımını sağlar ve yapay zeka uygulamasının algılanan hızını artırır.
Bu örneklerde akışı etkinleştirdik ve temperature, max_tokens ve top_p gibi hiperparametreleri değiştirerek modeli özelleştirdik.
chat_streaming = client.chat.completions.create(
    messages=[
       {"role": "system", "content": "You are a monk from Thailand."},
       {"role": "user", "content": "Can you explain the meaning of life?"},
    ],
    model="llama3-70b-8192",
    temperature=0.3,
    max_tokens=360,
    top_p=1,
    stop=None,
    stream=True,
)

for chunk in chat_streaming:
    print(chunk.choices[0].delta.content, end="")
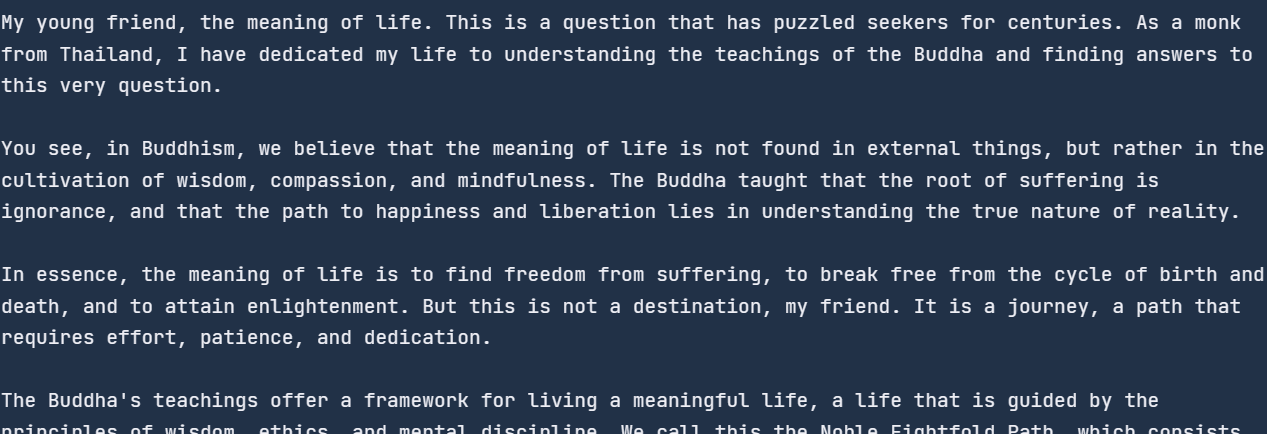
Sonuç olarak, bu kodu çalıştırır çalıştırmaz yanıt almaya başladık.
Eşzamansız API’ler, birden çok eşzamanlı isteği engellemeden ele almayı sağlar; sistemin her isteği bağımsız olarak işlemesine ve yanıtlamasına olanak tanır. Bu yaklaşım daha verimli ve ölçeklenebilirdir; daha yüksek hacimde isteği işleyebilir ve daha hızlı yanıt süreleri sunabilir.
Async API çağrısını etkinleştirmek için kodun yapısını değiştirmemiz gerekiyor. Şunları yapıyoruz:
Not olarak, aşağıdaki kod Jupyter Notebook’ta çalışır; ancak bu kodu bir Python dosyasında çalıştırıyorsanız son satırı asyncio.run(main()) ile değiştirmeniz gerekebilir.
import asyncio
from groq import AsyncGroq

client = AsyncGroq(

    api_key=os.environ.get("GROQ_API_KEY"),

)

async def main():

   chat_completion = await client.chat.completions.create(
       messages=[            {"role": "system", "content": "You are a psychiatrist helping young minds"},
                  {                "role": "user",                "content": "I panicked during the test, even though I knew everything on the test paper.",            },
                ],
                model="llama3-70b-8192",
                temperature=0.3,
                max_tokens=360,
                top_p=1,
                stop=None,
                stream=False,
       )

       print(chat_completion.choices[0].message.content)

await main()  # for Python file use asyncio.run(main())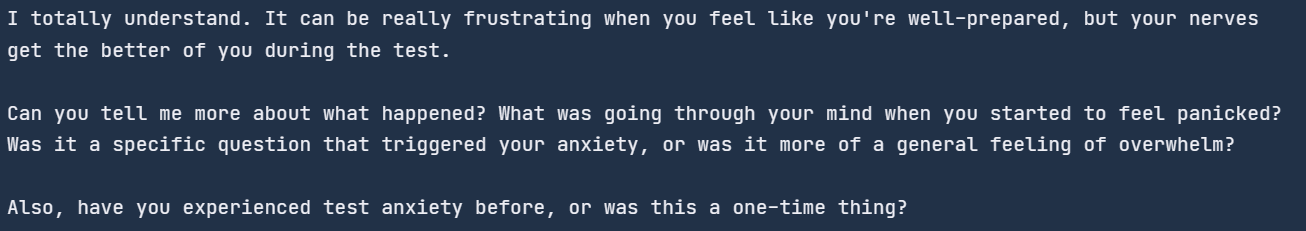
Async API’yi, sohbet tamamlama işlevinde stream argümanını etkinleştirerek ve sonuçları yazdırma biçimimizi değiştirerek de akışa alabiliriz. Sonuçları, async komutuyla birlikte for döngüsü kullanarak her parçayı yazdıracağız.
import asyncio

from groq import AsyncGroq


client = AsyncGroq()

async def main():

    chat_streaming = await client.chat.completions.create(
        messages=[
           {"role": "system", "content": "You are a psychiatrist helping young minds"},
           {                "role": "user",                "content": "I panicked during the test, even though I knew everything on the test paper.",            },
        ],
        model="llama3-70b-8192",
        temperature=0.3,
        max_tokens=360,
        top_p=1,
        stop=None,
        stream=True,
     )
     async for chunk in chat_streaming:
            print(chunk.choices[0].delta.content, end="")

await main()  # for Python file use asyncio.run(main())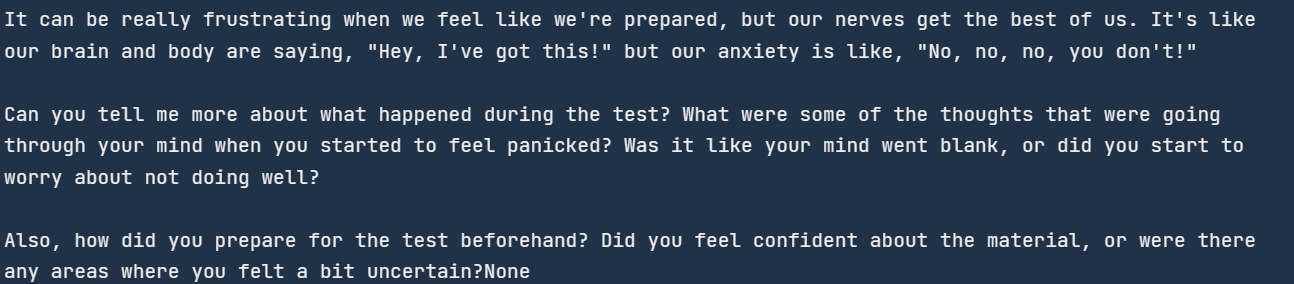
Kodu çalıştırırken sorun yaşıyorsanız lütfen şu DataLab defterine bakın: Groq Cloud API.
Bu rehberde bir adım daha ileri giderek Groq API ve bir LLM çerçevesi olan LlamaIndex kullanarak bir yapay zeka uygulaması geliştirmeyi öğreneceğiz. PDF dosyasından metin yükleyen, bunu gömülere dönüştüren ve vektör deposuna kaydeden bir uygulama kuracağız. Ardından, vektör deposunu geçmişe sahip bir RAG sohbet motoru oluşturmak için kullanılacak bir getiriciye (retriever) dönüştüreceğiz.
Kısacası, belgeyi çok daha hızlı anlamanıza yardımcı olacak bağlama duyarlı bir ChatPDF uygulaması geliştiriyoruz.
Doğal dil kullanarak özel ve alanına özgü verileri nasıl içe aktaracağınızı, yöneteceğinizi ve alacağınızı öğrenmek için şu eğitime göz atın: LlamaIndex: Geniş Dil Modelleri (LLM) için Bir Veri Çerçevesi.
Önce gerekli tüm Python Paketlerini pip ile kuracağız. Günlükleri bastırmak için %%capture sihirli işlevini kullanıyoruz.
%%capture
%pip install llama-index
%pip install llama-index-llms-groq
%pip install llama-index-embeddings-huggingfacellama_index işlevini kullanarak Groq LLM istemcisi oluşturacağız. LLM istemcisi bir model adı ve API anahtarı gerektirir.
from llama_index.llms.groq import Groq
import os

llm =
Groq(model="llama3-70b-8192",api_key=os.environ.get("GROQ_API_KEY"))Şimdi LlamaIndex embeddings API’sini kullanarak Hugging Face gömme modelini indirecek ve yükleyeceğiz.
Bizim durumumuzda, Hugging Face’te en popüler gömme modeli olan mxbai-embed-large-v1’i yüklüyoruz.
from llama_index.embeddings.huggingface import HuggingFaceEmbedding

embed_model =
HuggingFaceEmbedding(model_name="mixedbread-ai/mxbai-embed-large-v1")LlamaIndex, LLM veya gömme modeli nesnelerini her yerde geçirme ihtiyacını ortadan kaldıran genel yapılandırmalar ayarlamamıza olanak tanır.
from llama_index.core import Settings

Settings.llm = llm
Settings.embed_model = embed_modelVeri için 2024’te Kullanılacak 14 Temel Veri Mühendisliği Aracı blog yazısını kullanıyor ve yazdır komutuyla PDF’e dönüştürüyoruz.
SimpleDirectoryReader işlevini kullanarak klasörden her tür belgeyi yükleyebilirsiniz. Sadece klasör dizinini ve gerekli dosya uzantılarını sağlayın.
from llama_index.core import SimpleDirectoryReader

de_tools_blog = SimpleDirectoryReader("./",required_exts=[".pdf", ".docx"]).load_data()VectorStoreIndex, belgeleri yükleyip dizini oluşturarak vektör deposu oluşturmanın en hızlı yolunu sağlar. Dizin, sorgu motorları, getiriciler ve sorgu iş hatları için kullanılabilir.
Bizim durumumuzda, metni gömelere dönüştürecek ve ardından vektör deposuna kaydedecek vektör deposuna belgeleri sağlayarak dizini oluşturuyoruz.
Bundan sonra, temel RAG’i (retrieval augmented generation) gerçekleştirmek için dizini bir sorgu motoruna dönüştüreceğiz; bu, bağlama duyarlı bir yanıt üretmek için getirimi ve yapay zeka modellerini birleştirir.
from llama_index.core import VectorStoreIndex

index = VectorStoreIndex.from_documents(de_tools_blog)
query_engine = index.as_query_engine(similarity_top_k=3)

response = query_engine.query("How many tools are there?")
print(response)
Şimdi geçmişe sahip bir RAG sohbet motoru oluşturacağız. Geçmiş eklemek, sohbet motorunun hem kullanıcı mesajlarını hem de üretilen yanıtları hatırlamasını ve bağlama duyarlı yanıtlar vermesini sağlar.
Bu uygulamayı oluşturmak için 3900 token’lık bir ChatMemoryBuffer oluşturup bunu getirici ve LLM nesnesiyle birlikte sohbet motoruna sağlayacağız.
Bir soru sorduğunuzda sohbet motoru, bağlam olarak PDF belgesini ve önceki mesajları kullanacak ve buna göre yanıt verecektir.
from llama_index.core.memory import ChatMemoryBuffer
from llama_index.core.chat_engine import CondensePlusContextChatEngine

memory = ChatMemoryBuffer.from_defaults(token_limit=3900)

chat_engine = CondensePlusContextChatEngine.from_defaults(
   index.as_retriever(),
   memory=memory,
   llm=llm
)

response = chat_engine.chat(
   "What tools are suitable for data processing?"
)
print(str(response))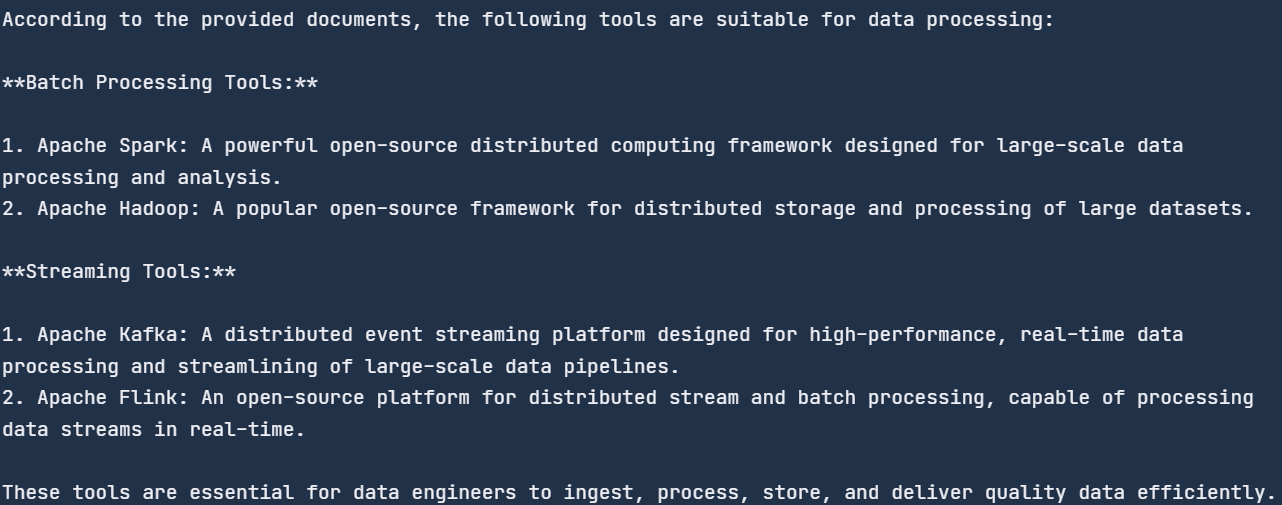
Genel sorular sorduk ve belge içinde veri işleme için olan araçları arayıp listeyi sundu. Tüm araçlar blog yazısında geçiyor.
Sohbet motorunun bellek kısmını test etmek için bir takip sorusu soralım.
response = chat_engine.chat(
    "Can you create a diagram of a data pipeline using these tools?"
)
print(str(response))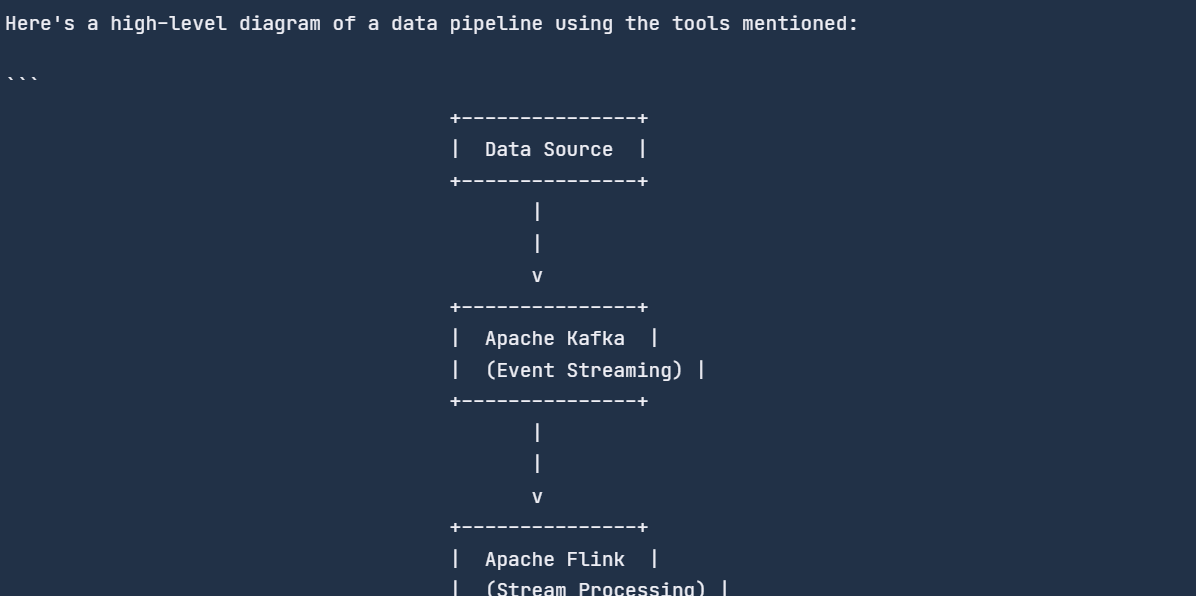
Sohbet motoru önceki sohbeti hatırladı ve buna göre yanıt verdi.
Kullandığımız tüm kodlar bu DataLab defterinde mevcuttur: Groq Cloud API — DataLab.
Groq LPU çıkarım motoru, yapay zekada oyunun kurallarını değiştiriyor. OpenAI ve Google gibi büyük oyuncular yüksek kaliteli LLM’ler geliştirmeye odaklanırken, Groq bu modelleri daha hızlı hale getiriyor. Yapay zeka sahnesine yeni olmasına rağmen Groq, toplulukta ciddi bir etki yaratıyor.
Bu blogda Groq LPU çıkarım motorunu öğrendik, Groq Cloud’u inceledik ve Groq API’sini VSCode ve Jan AI uygulamasına entegre ettik. Ayrıca, Groq Python paketine kod örnekleriyle daldık ve sohbet geçmişi ile PDF belgelerinden öğrenebilen bağlama duyarlı bir yapay zeka uygulamasının nasıl geliştirileceğini öğrendik.
Öğrenme yolculuğunuzda bir sonraki olası adım, LLM’leri özel bir veri kümesi üzerinde ince ayar yapmaktır. Bunu nasıl yapacağınızı şu eğitimi takip ederek öğrenebilirsiniz: Google Gemma’yı İnce Ayarlama: Özelleştirilmiş Yönergelerle LLM’leri Geliştirme.
DataCamp ile öğrenin
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.





