
Last chance! 50% off DataCamp Premium
Sale ends in
Sejak peluncuran ChatGPT, tampaknya setiap beberapa hari muncul Large Language Model (LLM) baru, bersamaan dengan perusahaan baru yang mengkhususkan diri pada teknologi ini. Setiap LLM baru dilatih untuk melampaui pendahulunya dengan berbagai cara. Misalnya, kita semakin sering melihat LLM yang disesuaikan untuk meningkatkan kasus penggunaan tertentu: model percakapan, asisten pengkodean, dan pemahaman konteks panjang, di antaranya.
Memilih model yang tepat untuk aplikasi atau proyek berbasis LLM baru bisa menjadi tugas yang menantang, belum lagi tantangan untuk tetap mengikuti perkembangan model terbaru beserta fiturnya.
Dalam kasus saya, hal ini sering membuat saya secara default menggunakan ChatGPT atau model GPT melalui panggilan API.
Di sini, saya ingin menelaah beragam model yang tersedia dan menyoroti kemampuan kunci yang perlu dipertimbangkan ketika memilih model yang tepat sesuai dengan karakteristik proyek.
Kita akan secara khusus berfokus pada berbagai metode berinteraksi dengan model-model ini sebagai salah satu fitur kunci yang perlu dipertimbangkan saat memilih di antara semua model yang tersedia.
Tujuannya adalah agar panduan komprehensif ini berfungsi sebagai lembar contekan, membantu Anda menavigasi beragam pilihan LLM yang tersedia untuk tugas spesifik Anda.
Jika Anda baru dalam dunia LLM, saya sangat merekomendasikan mengikuti kursus AI Fundamentals dan Large Language Models Concepts untuk membiasakan diri dengan istilah dasar dan model.
Mengakses LLM dan membuat antarmuka dengannya dalam aplikasi atau proyek berbasis LLM dapat dilakukan melalui berbagai metode bergantung pada kebutuhan teknis.
Pendekatan yang paling ramah pengguna untuk berinteraksi dengan LLM adalah melalui antarmuka percakapan di peramban kita. Ini adalah kasus ChatGPT, di mana antarmuka pengguna hanyalah antarmuka chat yang memungkinkan Anda berinteraksi dengan model.
Secara umum, antarmuka ini memberikan sedikit atau tidak ada kendali atau kustomisasi model oleh pengguna, tetapi merupakan cara mudah untuk mencoba model untuk tugas sederhana. ChatGPT dari OpenAI dan Gemini dari Google menyediakan jenis antarmuka seperti ini:
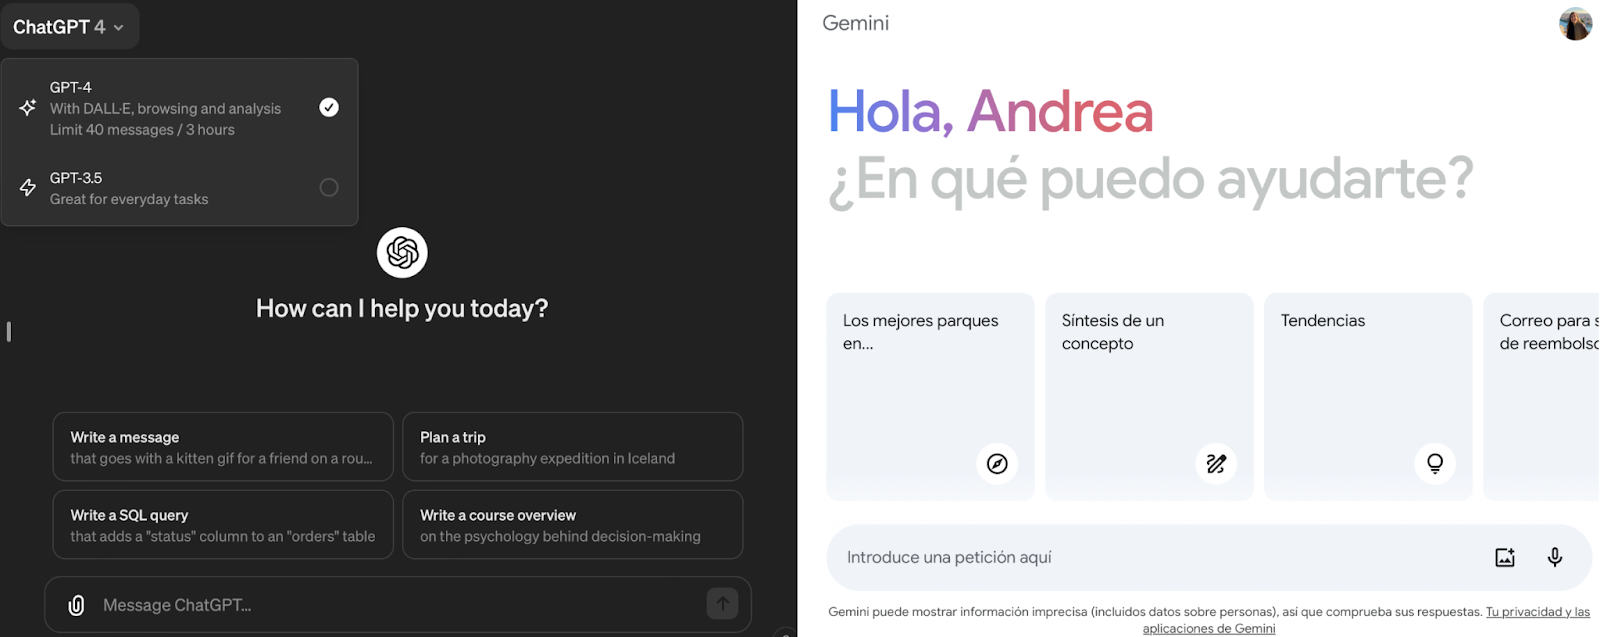
Tangkapan layar antarmuka chat ChatGPT milik OpenAI (kiri) dan Gemini milik Google (kanan).
Terkadang, ada penyedia yang juga memungkinkan tingkat kustomisasi tertentu melalui antarmuka chat yang sama-sama ramah pengguna. Dalam kasus OpenAI, platform ini disebut “Playground.”
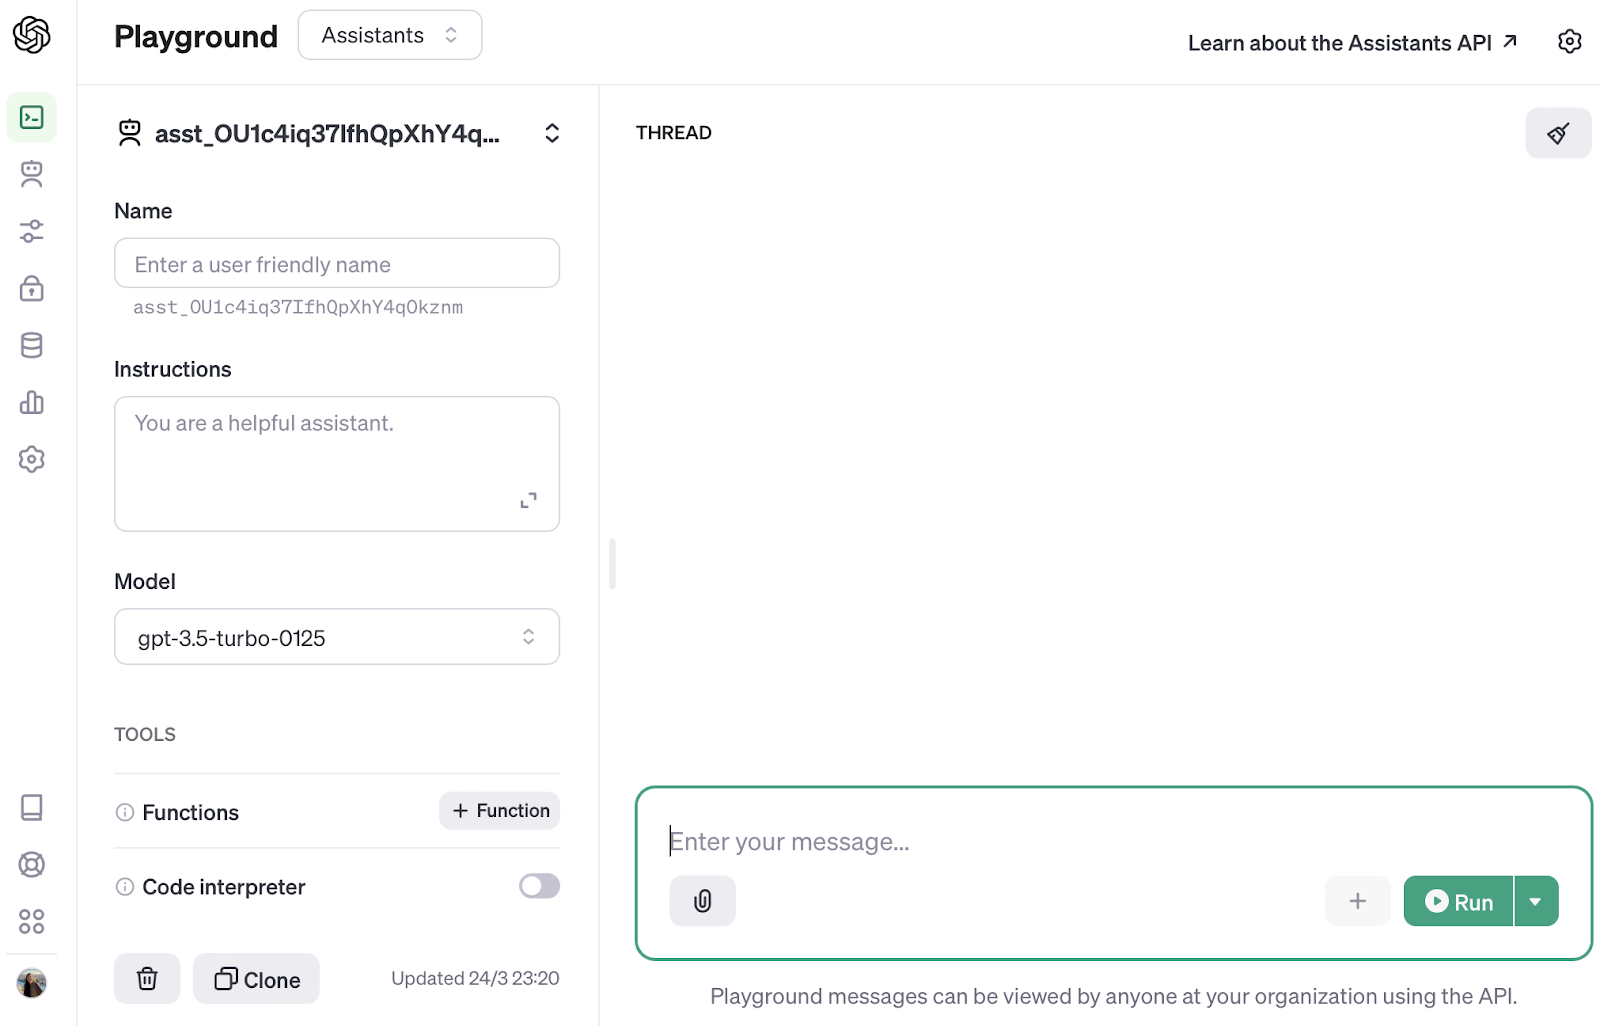
Tangkapan layar antarmuka OpenAI Playground.
Antarmuka Playground memungkinkan kita mencoba berbagai model dengan kendali terbatas atas pengaturan. Dengan cara ini, kita dapat mengeksplorasi parameter mana yang cocok untuk tugas Anda. Namun demikian, seperti yang mungkin sudah Anda sadari, antarmuka playground atau chat tidak memungkinkan kita menyematkan interaksi dengan LLM ke dalam sebuah aplikasi atau proyek.
Salah satu antarmuka paling populer untuk melakukan kueri ke LLM adalah melalui akses API. Pendekatan ini sangat menguntungkan ketika kita tidak memerlukan kustomisasi model lebih lanjut.
Panggilan API dapat diintegrasikan mulus ke dalam skrip kita, menghilangkan kebutuhan untuk menyiapkan dan memelihara infrastruktur di pihak kita.
Namun, kenyamanan ada biayanya, dan meskipun bergantung pada layanan eksternal — ketergantungan yang akan selalu Anda miliki jika Anda memilih untuk tidak meng-host model dan mengelola infrastrukturnya — biaya akan meningkat seiring penggunaan.
Dalam kasus panggilan API, praktik yang baik adalah menerapkan pembungkus sederhana di sekitar panggilan API itu sendiri untuk berinteraksi dengan model secara modular. Untuk OpenAI API, yang paling sering saya gunakan sejauh ini, saya selalu menggunakan pembungkus pada bagian berikut, sehingga pemilihan model menjadi transparan bagi pengguna.
Menulis metode yang terstandar namun fleksibel untuk melakukan kueri ke model GPT melalui OpenAI API sangat berguna jika Anda ingin berinteraksi dengan model secara mulus dan lebih kecil kemungkinan terjadi kesalahan. Itulah mengapa saya biasanya menyiapkan panggilan GPT dalam fungsi pembungkus di awal program, memastikan penggunaan model transparan bagi aplikasi.
Pustaka openai (pip install openai) sudah menyediakan endpoint ChatCompletion yang memungkinkan kita memanggil model GPT apa pun dengan menggunakan metode .create.
Metode .create memiliki dua parameter wajib:
gpt-4.Dengan dua parameter ini, kita dapat menulis panggilan GPT sebagai berikut:
prompt = "Hello world"
chat_completion = openai.ChatCompletion.create(model="gpt-3.5-turbo", messages=[{"role": "user", "content": prompt}])
Saat memanggil model, kita akan mendapatkan completion kembali dalam format JSON:
{
 "choices": [
   {
     "finish_reason": "stop",
     "index": 0,
     "message": {
       "content": "Hello! How can I assist you today?",
       "role": "assistant"
     }
   }
 ],
 "created": 1692042919,
 "id": "chatcmpl-7nXwl0tywcTb91xeEuhpQbpRD6XLM",
 "model": "gpt-3.5-turbo-0613",
 "object": "chat.completion",
 "usage": {
   "completion_tokens": 9,
   "prompt_tokens": 9,
   "total_tokens": 18
 }
}
Oleh karena itu, akan menarik jika hanya mendapatkan completion model sebagai nilai kembali fungsi. Jika kita satukan semuanya, implementasi pembungkus kita dapat ditulis sebagai:
def chatgpt_call(prompt, model="gpt-3.5-turbo"):
   response = openai.ChatCompletion.create(
       model=model,
       messages=[{"role": "user", "content": prompt}]
   )
   return response.choices[0].message["content"]
Jika Anda tertarik dengan lebih banyak detail tentang implementasi ini, artikel ChatGPT API Calls: A Gentle Introduction membahas lebih lanjut seluk-beluknya!
Terakhir, perlu dicatat juga bahwa sebagian besar penyedia API, termasuk OpenAI, menawarkan beberapa panggilan gratis saat Anda membuat akun. Namun, kreditnya terbatas (biasanya kurang dari $20) dan umumnya dibatasi dalam jangka waktu tertentu (biasanya sebulan).
Bagaimanapun, selalu merupakan praktik yang baik untuk membungkus panggilan LLM dalam sebuah fungsi — atau kumpulan fungsi — agar model menjadi transparan bagi aplikasi apa pun penyedianya.
Meng-host model sendiri berarti mengunduh bobot model dan menjalankannya di mesin lokal atau server pribadi.
Pendekatan ini menarik karena memungkinkan kendali penuh atas infrastruktur model, tetapi juga berarti upaya teknis meningkat secara signifikan.
Jika Anda penasaran dengan langkah-langkah yang terlibat dalam menjalankan infrastruktur untuk LLM, lihat artikel LLMOps Essentials!
Menjalankan model secara lokal memungkinkan kustomisasi lebih lanjut sesuai kebutuhan kita. Dalam konteks ini, salah satu pilihan paling populer untuk self-hosting adalah model LLaMa dari Meta AI. Mereka merilis model ringan yang dapat dijalankan di laptop hanya dengan RAM 8GB.
Menjalankan model LLaMa di laptop kita cukup mudah, berkat platform seperti Ollama.
Ollama menawarkan platform yang dirancang untuk menjalankan LLM seperti LLaMa 2 dan Code LLaMa secara lokal di perangkat kita. Mendukung macOS, Linux, dan Windows, memungkinkan kustomisasi dan pembuatan model milik kita. Untuk detail lebih lanjut, Anda dapat mengunjungi situs web Ollama.
Mengunduh platform Ollama dapat dilakukan dari halaman resmi, sementara bobot model dapat ditarik langsung menggunakan antarmuka terminal.
Mari kita instal Ollama terlebih dahulu dengan membuka halaman utamanya!
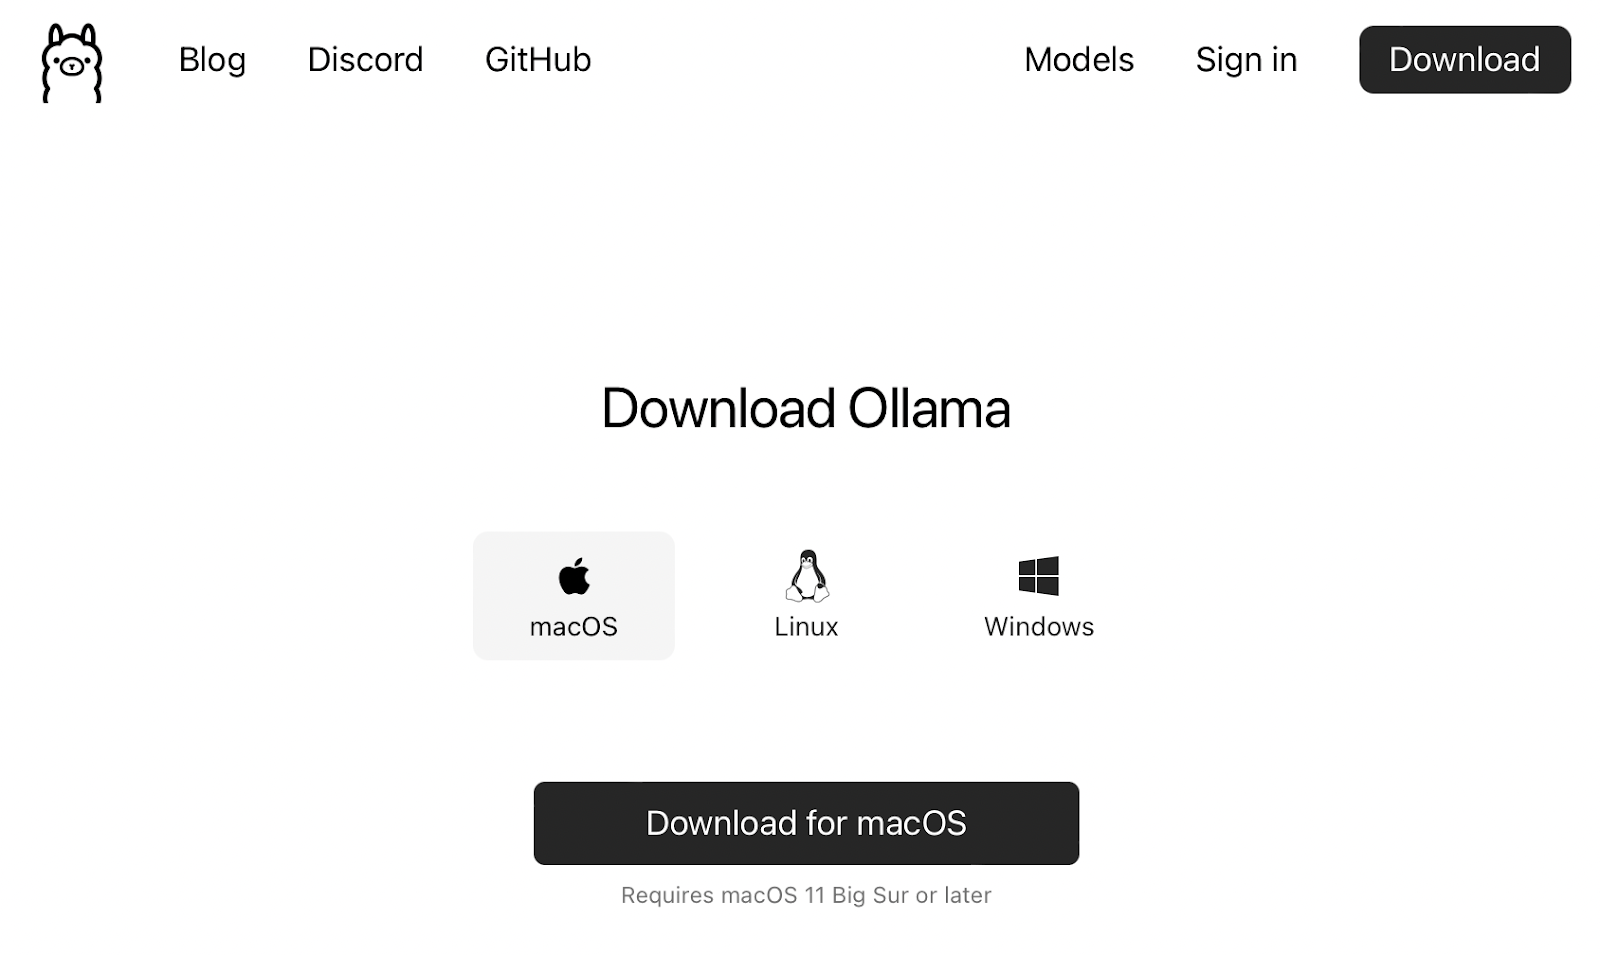 Tangkapan layar halaman utama situs web Ollama.
Dalam hal ini, Ollama adalah utilitas baris perintah:
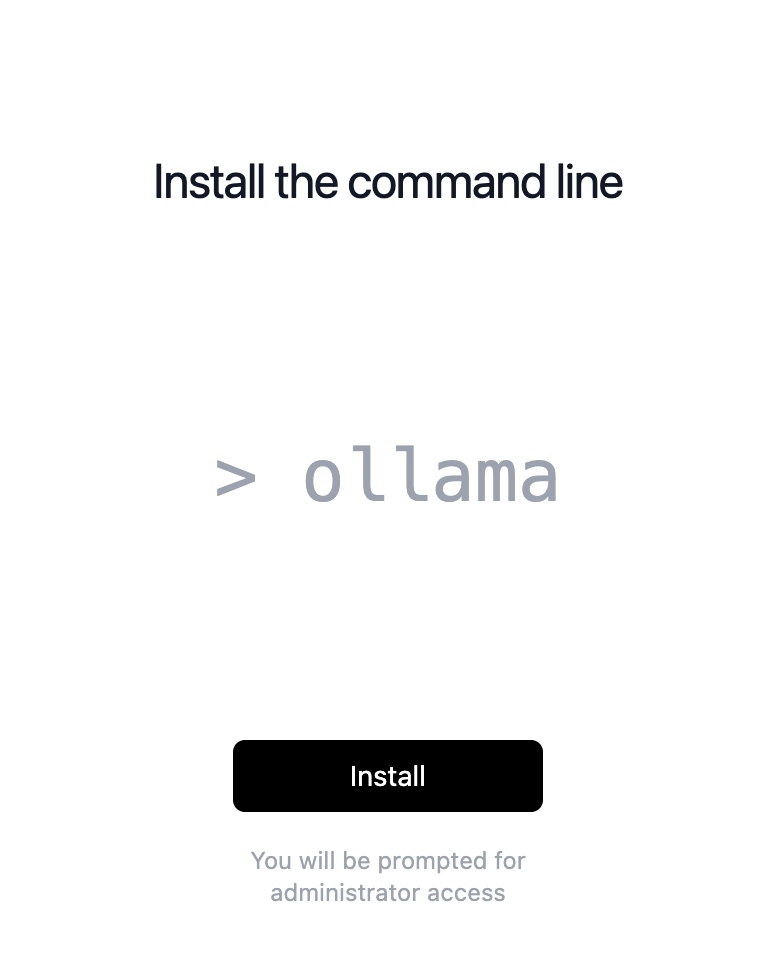
Tangkapan layar instalasi alat baris perintah Ollama.
Setelah utilitas baris perintah terpasang, kita dapat memulai model dengan perintah ollama run <model name>. Jika ini pertama kalinya menjalankan model di perangkat kita, Ollama akan menariknya untuk kita:
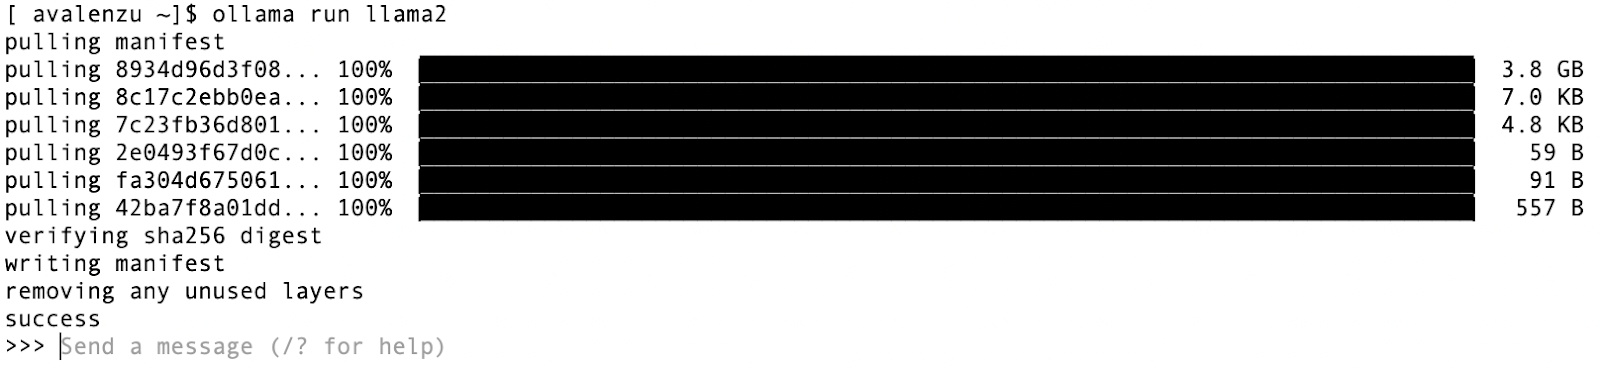
Tangkapan layar penggunaan pertama model LLaMa 2 dengan alat baris perintah Ollama. Model akan ditarik secara otomatis jika ini adalah penggunaan pertama.
Sejak saat itu, memberi prompt dan keluar dari model melalui baris perintah sangatlah mudah:
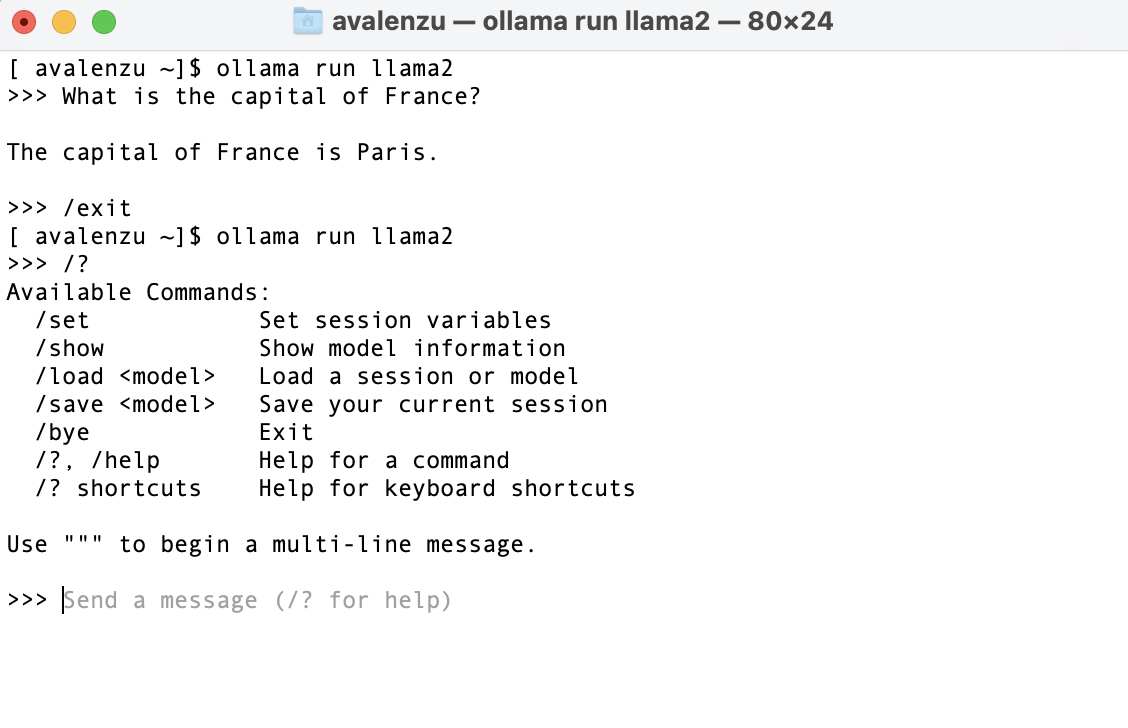
Tangkapan layar interaksi pengguna dengan model melalui alat baris perintah Ollama.
Seperti yang terlihat pada gambar di atas, model juga memiliki sejumlah kecil perintah tambahan yang tersedia.
Ollama juga mendukung model lain, seperti Mistral yang baru:
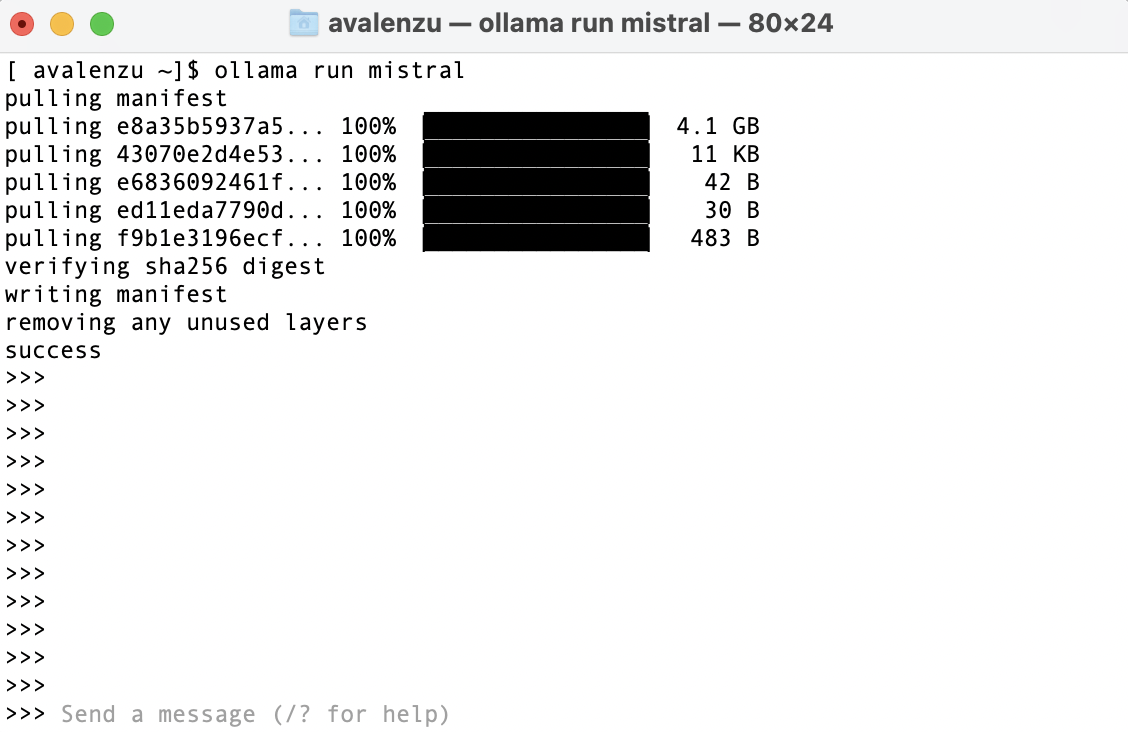
Tangkapan layar penggunaan pertama model Mistral dengan alat baris perintah Ollama. Model akan ditarik secara otomatis jika ini adalah penggunaan pertama.
Model kembali siap digunakan langsung hanya dengan satu perintah!
Pendekatan ini menguntungkan karena hanya mengonsumsi sumber daya dari perangkat kita. Namun, penting untuk diingat bahwa kinerja model umumnya meningkat seiring jumlah parameter.
Akibatnya, semakin banyak parameter yang dimiliki model, semakin banyak sumber daya yang dibutuhkan. Oleh karena itu, model yang lebih besar kemungkinan perlu dijalankan di server pribadi untuk aplikasi LLM self-hosted.
Jika kita ingin membangun aplikasi skala besar, perlu diperhatikan bahwa Ollama juga dapat berjalan dengan Docker Desktop di Mac dan berjalan di dalam kontainer Docker dengan akselerasi GPU di Linux.
Satu hal yang mungkin Anda tanyakan pada titik ini: Bisakah saya menyematkan OLLAMA dalam skrip saya?
Memang, meng-host model sendiri tidak berarti Anda tidak dapat mengintegrasikannya ke dalam skrip Python Anda! Ollama juga menawarkan kemungkinan untuk berinteraksi dengan model self-hosted Anda melalui Python.
Pustaka Python dan JavaScript Ollama memungkinkan kita memasukkan inferensi model ke dalam skrip.
Ollama bukan satu-satunya opsi jika kita ingin meng-host model sendiri. Secara umum, LLM sering kali tersedia untuk diunduh di berbagai platform open-source yang juga menawarkan dukungan komunitas.
LLM open-source umumnya tersedia tanpa biaya untuk tujuan akademis dan penelitian. Namun, ketentuan penggunaan komersial dapat berbeda berdasarkan lisensi spesifik tempat model dirilis. Selalu pahami apakah Anda sedang bereksperimen dengan LLM atau membangun aplikasi berbasis LLM untuk tujuan komersial.
Ingin memulai perjalanan Anda mengembangkan LLM hari ini? Maka kursus Developing Large Language Models cocok untuk Anda!
Meng-host model yang kuat secara lokal dapat sangat menguras sumber daya, itulah mengapa menggunakan layanan cloud bisa menjadi alternatif yang layak, memungkinkan skalabilitas sumber daya sesuai permintaan dan dukungan dari penyedia cloud.
Perlu dicatat bahwa layanan cloud tradisional seperti Azure kini menawarkan pipeline khusus untuk meng-host LLM, seperti Mistral, sehingga kita tidak perlu menerapkan hosting khusus.
Ini merupakan keuntungan signifikan untuk menerapkan aplikasi di dalam organisasi Anda, karena banyak perusahaan sudah memiliki kontrak dengan penyedia ini untuk layanan seperti email dan solusi cloud umum.
Memilih penyedia pihak ketiga dapat menawarkan keseimbangan antara tidak mengelola infrastruktur host dan memiliki sedikit kendali atas model, dibandingkan hanya menggunakan layanan API native.
Penyedia ini biasanya menawarkan akses API, tetapi penting untuk dicatat bahwa biaya dapat meningkat signifikan dengan penggunaan yang luas, mirip dengan menggunakan OpenAI API native.
Perbedaan kuncinya terletak pada pihak yang melakukan hosting. Penyedia pihak ketiga, bukan layanan LLM native, yang meng-host model pada infrastruktur mereka dan mengekspos endpoint API, sering kali menawarkan berbagai model dari berbagai sumber untuk integrasi yang fleksibel.
Salah satu penyedia API pihak ketiga yang populer adalah LLAMA API.
Tangkapan layar halaman utama di situs web LLAMA API.
API ini tidak gratis, tetapi Anda dapat mencobanya secara gratis karena $5 kredit gratis diberikan untuk akun baru mana pun. Namun, ingat bahwa kredit tersebut hanya berlaku selama satu bulan setelah diterbitkan.
Menggunakan LLAMA API sangatlah sederhana. Setelah terpasang (pip install llamaapi), kita dapat melakukan panggilan uji pertama sebagai berikut:
from llamaapi import LlamaAPI
import json

llama = LlamaAPI('<Insert API key here>')
prompt = "Which is the capital of France?"

api_request_json = {
  "model": "llama-13b-chat",
  "messages": [
    {"role": "system", "content": "You are a friendly chatbot."},
    {"role": "user", "content": prompt},
  ]
}

response = llama.run(api_request_json)
print(json.dumps(response.json(), indent=2))
Namun, seperti halnya OpenAI API, praktik yang baik adalah menyematkan panggilan API dalam fungsi pembungkus. Dengan mengikuti pendekatan yang sama seperti sebelumnya:
def llm_call(prompt, model="llama-13b-chat"):
    api_request_json = {
        "model": model,
        "messages": [
            {"role": "system", "content": "You are a friendly chatbot."},
            {"role": "user", "content": prompt},
        ]
    }
    response = llama.run(api_request_json)
    return response.json()["choices"][0]["message"]["content"]
Dengan implementasi ini, kita akan mendapatkan respons string dari LLM hanya dengan memanggil llm_call():
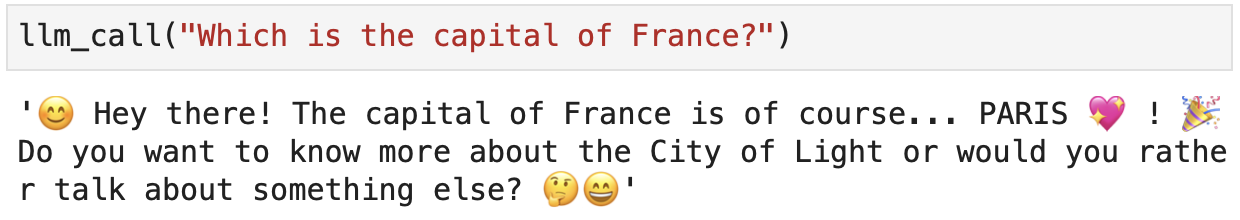
LLAMA API mendukung berbagai model mutakhir, bukan hanya LLaMa milik Meta. Kita akan mengetahui model apa saja yang didukung pada bagian berikut!
Terakhir, dalam kasus LLAMA API, biaya API bergantung pada jumlah parameter model, dan tampaknya konstan di semua model:
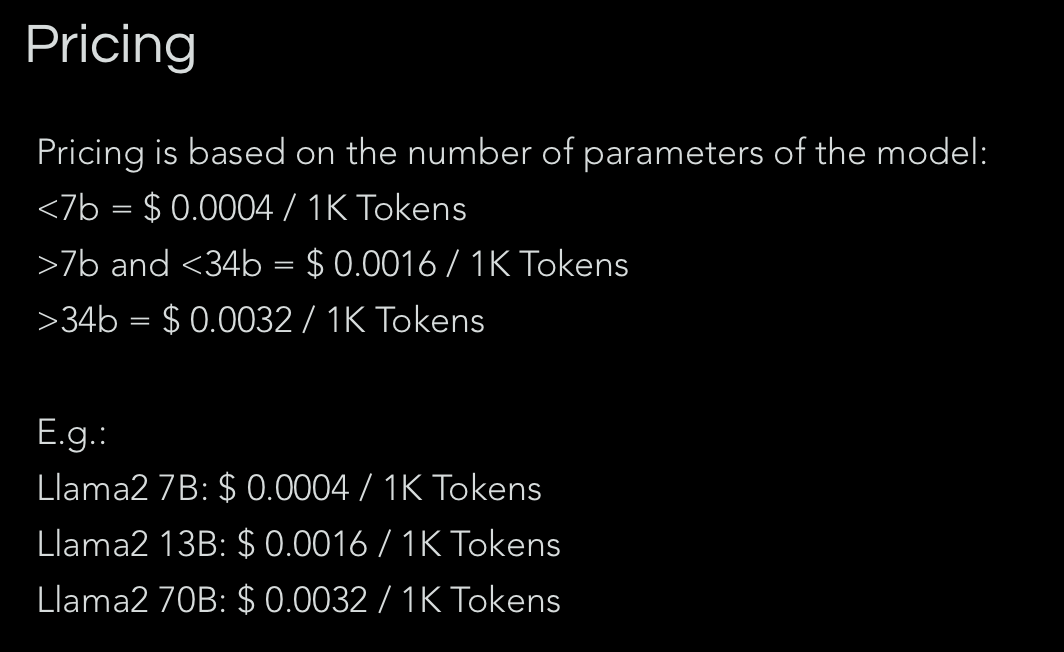
Tangkapan layar harga LLAMA API. Informasi ini hanya tersedia setelah Anda membuat akun.
Penyedia pihak ketiga paling populer untuk LLM adalah Hugging Face. Hugging Face paling dikenal melalui pustaka transformers, pustaka paling populer di Python untuk Natural Language Processing.
Hugging Face menyediakan banyak antarmuka untuk mengakses LLM. Ia memiliki antarmuka playground yang ramah pengguna bernama “Spaces”:

Tangkapan layar “Spaces” playground di Hugging Face.
Ia juga memungkinkan hosting model dan deployment endpoint, serta pengunduhan langsung dan penggunaan lokal model-modelnya.
Penting untuk diingat bahwa Hugging Face adalah semacam “situs para pengembang”, jadi meskipun Anda dapat menemukan tutorial cara memulai, menggunakan model mereka untuk menskalakan aplikasi memerlukan pengetahuan teknis.
Jika Anda ingin mempelajari lebih lanjut tentang Hugging Face, saya sangat merekomendasikan artikel What is Hugging Face? The AI Community's Open-Source Oasis.
Salah satu alat pelengkap yang biasanya saya gunakan untuk membangun aplikasi berbasis LLM dari awal, bersama dengan Hugging Face, adalah LangChain. Tutorial How to Build LLM Applications with LangChain memberikan pengantar praktis yang baik.
Kita telah membahas berbagai metode mengakses dan menjalankan LLM, seperti model GPT, LLaMa, dan Mistral. Namun, ada banyak model lain yang tersedia, termasuk berbagai varian dari yang disebutkan. Pada bagian ini, kita akan mengklasifikasikan model utama yang ada saat ini, dengan mencantumkan karakteristik, harga, dan kasus penggunaannya.
Model OpenAI menjadi sangat populer sejak peluncuran ChatGPT, yang kini ditenagai oleh GPT-3.5 atau GPT-4, bergantung pada langganan Anda. Untuk banyak tugas dasar, perbedaan antara model GPT-3.5 dan GPT-4 tidak signifikan.
Namun, GPT-4 menunjukkan kemampuan yang jauh lebih besar dalam skenario penalaran yang lebih kompleks dibandingkan model sebelumnya.
Selain itu, GPT-4 adalah model multimodal yang menerima masukan teks atau gambar dan menghasilkan keluaran teks. Ia juga menawarkan kemungkinan menggunakan plugin untuk berinteraksi dengan sumber eksternal. Menjelajah Internet adalah salah satu contohnya, seperti penggunaan pencarian Bing.
Ada tiga varian utama GPT-4 yang dapat diakses melalui OpenAI API untuk pelanggan berbayar:
|
Model |
Karakteristik |
Jendela Konteks |
API |
Lokal |
Harga Token |
Data Pelatihan |
|
GPT-4 |
Snapshot gpt-4 per 13 Juni 2023. Endpoint ini yang menerima pembaruan terus-menerus. Dioptimalkan untuk chat. |
8.192 token |
Tidak |
$0,03 / 1K token (masukan) $0,06 / 1K token (keluaran) |
Des 2023 |
|
|
GPT-4 Turbo |
Nama API adalah gpt-4-turbo-preview. Unggul dalam tugas seperti pembuatan kode dan dimaksudkan untuk mengurangi kasus “kemalasan”. |
128k token |
Tidak |
$0,01 / 1K token (masukan) $0,03 / 1K token (keluaran) |
Des 2023 |
|
|
GPT-4 Vision |
Nama API adalah gpt-4-vision-preview. GPT-4 dengan kemampuan memahami gambar, selain semua kemampuan GPT-4 Turbo lainnya. |
128k token |
Tidak |
$0,01 / 1K token (masukan) $0,03 / 1k token (keluaran) |
Apr 2023 |
Secara umum, menarik untuk dicatat bahwa model GPT, berbeda dengan LLaMa, bersifat tertutup (closed-source). Artinya kita tidak dapat menjalankannya secara lokal atau menerapkan endpoint kita sendiri.
Namun demikian, ada kemungkinan kustomisasi melalui penggunaan Fine-tuning API milik OpenAI. Selain itu, model ini tidak dapat diakses melalui penyedia pihak ketiga seperti Ollama, LLAMA API, atau Hugging Face.
Terkait OpenAI Playground, informasi tentang model di baliknya tidak ditampilkan dengan jelas, tetapi tampaknya berbasis model GPT-4 dengan kemampuan DALL-E, penjelajahan, dan analisis.
Mari juga melihat model GPT-3 yang tersedia!
|
Model |
Karakteristik |
Jendela Konteks |
API |
Lokal |
Harga Token |
Data Pelatihan |
|
GPT-3.5 Turbo |
Nama API adalah gpt-3.5-turbo. Ini adalah model andalan dari keluarga ini. Dioptimalkan untuk dialog dan menunjukkan akurasi lebih tinggi dalam merespons sesuai format yang diminta. |
16.385 token |
Tidak |
$0,0005 / 1K token (masukan) $0,0015 / 1K token (keluaran) |
Sep 2021 |
|
|
GPT-3.5 Turbo Instruct |
Nama API adalah gpt-3.5-turbo-instruct. Berfokus pada akurasi dan relevansi respons, selaras erat dengan kebutuhan pengguna. |
4.096 token |
Tidak |
$0,0015 / 1K token (masukan) $0,0020 / 1K token (keluaran) |
Sep 2021 |
Model GPT-3.5 Turbo Instruct yang disajikan pada tabel telah di-fine-tune agar lebih baik mengikuti maksud pengguna melalui Reinforcement Learning from Human Feedback (RLHF).
RLHF adalah teknik di mana umpan balik manusia diintegrasikan ke dalam proses reinforcement learning untuk membimbing dan meningkatkan hasil pembelajaran agen AI. Pendekatan ini memungkinkan pengembangan model yang lebih selaras dengan nilai dan preferensi manusia dengan memasukkan penilaian, koreksi, atau preferensi manusia secara langsung ke dalam siklus pelatihan.
Terakhir, seperti yang dapat kita lihat dari tabel, perlu dicatat bahwa penggunaan salah satu dari dua model GPT-3.5 jauh lebih murah dibandingkan GPT-4.
Dalam hal ini, saya biasanya merekomendasikan membandingkan kinerja setiap model pada sekumpulan contoh yang terdefinisi dengan baik untuk melihat apakah GPT-3.5 sudah cukup untuk tugas yang sedang saya kerjakan, sehingga menghemat biaya inferensi.
Seperti yang telah kita bahas pada bagian sebelumnya, model LLaMa dapat diunduh gratis dan dijalankan secara lokal atau tersedia untuk membangun kustomisasi di atasnya.
Model LLaMa sebenarnya merupakan keluarga besar model terbuka dalam hal ukuran dan varian yang disediakan oleh Meta AI:
|
Model |
Karakteristik |
Jendela Konteks |
API |
Lokal |
Varian |
Data Pelatihan |
|
LLaMa 2 |
Model dasar non-chat untuk tugas completion. |
4096 token |
Ya |
Ya* |
7B 13B 70B |
Sep 2022 |
|
LLaMa 2 Chat |
LLaMa 2 dasar dengan instruction tuning untuk mengubah completion sederhana menjadi model chat yang mengikuti maksud pengguna. |
4096 token |
Ya |
Ya* |
7B 13B 70B |
Sep 2022 |
|
LLaMa 2 Guard |
Model pelindung input-output yang dilatih untuk mendeteksi konten beracun dan berbahaya. |
4096 token |
Ya** |
Tidak |
7B |
Sep 2022* |
*Hugging Face juga menyediakan beberapa varian LLaMa, seperti model dasar dan chat. **Untuk saat ini, LLaMa 2 Guard dapat diakses di lingkungan cloud Amazon SageMaker.
Berbeda dengan model GPT yang memiliki kemampuan pengkodean terintegrasi, model LLaMa memiliki model khusus untuk pengkodean dengan jendela konteks lebih besar yaitu 16k token yang dicapai melalui proses fine-tuning konteks panjang.
|
Model |
Karakteristik |
Jendela Konteks |
API |
Lokal |
Varian |
Data Pelatihan |
|
Code LLaMa |
Model dasar non-chat untuk tugas penyelesaian kode, seperti GitHub Copilot. Terdiri dari model LLaMa 2 dengan pelatihan tambahan pada kode dan fine-tuning konteks panjang . |
16k |
Tidak |
Ya |
7B 13B 34B |
Sep 2022* |
|
Code LLaMa - Instruct |
Diturunkan dari model Instruct. Unggul dalam penyelesaian kode dan penjelasan pada potongan kode. |
16k |
Ya |
Ya |
7B 13B 34B |
Sep 2022* |
|
Code LLaMa - Python |
Di-fine-tune untuk bahasa pemrograman Python. |
16k |
Tidak |
Ya |
34B |
Sep 2022* |
* Tanggal cut-off resmi model LLaMa adalah Sep 2022. Namun, data tuning lebih baru, berasal dari 2023, terutama untuk varian yang lebih baru.
Google memiliki sejarah panjang dalam mengembangkan Large Language Model. Dengan diperkenalkannya model Gemini, Google memulai generasi LLM multimodalnya.
Dalam konteks penawaran Google, Gemini muncul sebagai model andalan, bersifat tertutup, mirip dengan ChatGPT. Namun, mereka baru-baru ini meluncurkan Gemma, yang memperkenalkan rangkaian model open-source turunan Gemini, ditujukan untuk memfasilitasi pengembangan AI yang mudah diakses.
Dalam artikel ini, kita akan berfokus pada Gemini dan Gemma:
|
Model |
Karakteristik |
API |
Lokal |
Varian |
|
Gemini |
Model tertutup untuk tugas tujuan umum (pembuatan teks, terjemahan, tanya jawab, kode, dll.) |
Ya* |
Tidak |
Ultra - Menyelesaikan tugas kompleks. Pro - Beragam tugas. Skalabel. Nano - Efisien untuk penggunaan di perangkat. |
|
Gemma |
Tugas serupa dengan Gemini, tetapi berfokus pada integrasi ke aplikasi kustom dan riset. Ini adalah model ringan. |
Ya**LLAMA API |
YaOllama |
2B 7B |
*Ada API untuk Gemini untuk tujuan komersial (tidak terbuka untuk deployment). Namun, kita dapat mencoba model tersebut melalui antarmuka Playground.
**Tidak ada endpoint native Google, tetapi model dapat diakses melalui Kaggle dan Google Colab. Informasi lebih lanjut tersedia di dokumentasi resmi Google.
Untuk varian Gemini, Gemini Ultra adalah model multimodal yang unggul dalam tugas analisis kompleks. Gemini Pro menyeimbangkan kinerja dan skalabilitas serta menonjol dalam tugas seperti pembuatan kode dan teks. Terakhir, Gemini Nano berfokus pada efisiensi untuk penggunaan di perangkat, berjalan di perangkat seluler dan edge tanpa membutuhkan sumber daya berat.
Terkait model Google, tidak banyak informasi yang tersedia secara publik tentang jendela konteks dan tanggal cut-off data pelatihan pada saat penulisan.
Mistral AI adalah perusahaan AI asal Prancis yang didirikan pada April 2023 oleh mantan karyawan Meta Platforms dan Google DeepMind. Perusahaan ini berfokus pada pengembangan LLM open-source, menekankan pentingnya perangkat lunak open-source sebagai respons terhadap model proprietary. Perusahaan ini menawarkan model seperti Mistral 7B dan Mixtral 8x7B dengan kemampuan pemrosesan bahasa tingkat lanjut.
|
Model |
Karakteristik |
Jendela Konteks |
API |
Lokal |
Harga Token |
Data Pelatihan |
|
Mistral |
Model tujuan umum dengan 7B parameter. Dioptimalkan untuk bahasa Inggris dan tugas pembuatan kode. |
32k |
Ya* |
Ya |
$0,25 / 1M token (masukan dan keluaran) |
Sep 2023 |
|
Mixtral |
Model tujuan umum paling kuat. Fasih dalam bahasa Inggris, Prancis, Italia, Jerman, Spanyol, dan kuat dalam tugas pengkodean. Berdasarkan arsitektur Mixture-of-Expert jarang dengan 7B parameter. |
32k |
Ya* |
Ya |
$0,7 / 1M token (masukan dan keluaran) |
Des 2023 |
*Kita dapat berinteraksi dengan model dari Mistral AI menggunakan antarmuka Playground mereka yang disebut “La Plataforme”.
** Hugging Face juga menawarkan test bed untuk inferensi real-time menggunakan API untuk beberapa model. Ini juga merupakan penyedia pihak ketiga yang memungkinkan Anda menerapkan endpoint berbayar ke model yang tersedia.
Terkait model Mixtral, arsitektur “Mixture-of-Experts” memungkinkan model membagi kemampuan totalnya ke berbagai kelompok khusus atau “expert”. Setiap expert dioptimalkan untuk jenis tugas atau data tertentu.
Saat memproses masukan, Mixtral secara dinamis mengaktifkan hanya expert yang relevan, memungkinkannya menangani tugas kompleks secara efisien dengan memanfaatkan sebagian kecil dari total parameternya untuk setiap token. Metode ini meningkatkan kinerja Mixtral, membuatnya mahir dalam berbagai bahasa dan tugas sekaligus mengoptimalkan sumber daya komputasi. Nama model Mixtral memang "Mixtral 8x7B" yang merujuk pada fakta bahwa model ini menggunakan 8 kelompok “expert” yang berbeda.
Terakhir, Mistral AI juga menawarkan tiga model komersial: Mistral Small, Mistral Medium, dan Mistral Large. Jika Anda tertarik, Anda dapat menemukan informasi lebih lanjut tentang model dan harga dalam dokumentasi resmi.
Sampai saat ini, kita telah melihat berbagai model dan varian dari perusahaan paling terkenal di bidang ini. Namun, masih banyak lagi yang bisa dieksplorasi!
Saya ingin menyoroti model Falcon dari Technology Innovation Institute, yang tersedia di Ollama dan LLAMA API. Ada juga model Orca2 dari Microsoft Research yang unggul khususnya dalam penalaran, juga tersedia di Ollama dan Hugging Face.
Anda dapat membaca tentang model open-source lainnya yang tersedia di 8 Top Open-Source LLMs for 2024 and Their Uses.
Dalam artikel ini, kita telah membahas beberapa aspek yang perlu dipertimbangkan saat memilih Large Language Model terbaik untuk aplikasi target kita. Meskipun tujuan panduan ini adalah berfungsi sebagai lembar contekan, tidak ada aturan emas untuk langsung memilih model terbaik.
Berdasarkan pengalaman pribadi saya, saya pikir mendefinisikan bagaimana kita ingin berinteraksi dengan LLM adalah titik awal yang baik karena hal itu sudah akan mengurangi jumlah model — dan varian — yang tersedia.
Aspek kedua yang perlu dipertimbangkan adalah tugas objektif yang akan dijalankan model: chatbot generik, ahli rangkuman, asisten pengkodean, dan sebagainya.
Meskipun kita selalu dapat melakukan fine-tune model untuk tugas yang diinginkan, kita telah melihat bahwa ada varian yang sudah di-fine-tune untuk kasus penggunaan tertentu yang akan menghemat waktu, sumber daya komputasi, dan keahlian teknis. Mempertimbangkan jendela konteks yang dibutuhkan aplikasi juga krusial untuk memilih model terbaik.
Terakhir, harga selalu menjadi indikator yang baik model mana yang akan digunakan. Sayangnya, sebagian besar waktu, proyek itu sendiri dibatasi oleh investasi awal dan biaya pemeliharaan proyek seiring waktu. Terkait harga, selalu penting untuk diingat bahwa pelatihan dan fine-tuning adalah layanan berbayar yang perlu dipertimbangkan selama pengembangan proyek dan sebenarnya cukup memakan waktu.
Lanjutkan Perjalanan AI Anda Hari Ini!
{count, plural, one {Program} other {Program}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt




