
Last chance! 50% off DataCamp Premium
Sale ends in
यदि आपने ChatGPT के जवाब का इंतजार करते हुए झुंझलाहट महसूस की है, तो आपको Groq Language Processing Unit (LPU) इंफरेंस इंजन के बारे में जानकर खुशी होगी।
Groq के साथ, आप अपनी क्वेरी का उत्तर जल्दी प्राप्त कर सकते हैं—प्रतीक्षा समय 40 सेकंड से घटकर केवल 2 सेकंड रह जाता है।
इस ट्यूटोरियल में, हम:
यदि आप बड़े भाषा मॉडलों (LLMs) में नए हैं, तो हम Developing Large Language Models स्किल ट्रैक लेने की सलाह देते हैं, ताकि आप LLMs को फाइन-ट्यून करने और शुरुआत से अपना मॉडल बनाने की बुनियादी बातें सीख सकें।
Groq का LPU (language processing unit) इंफरेंस इंजन एक नया प्रोसेसिंग सिस्टम है जो क्रमिक घटकों वाले उच्च-गणनात्मक कार्यों को संभालता है, विशेष रूप से बड़े भाषा मॉडलों के लिए प्रतिक्रियाएँ जनरेट करने में। यह अभिनव तकनीक पाठ को प्रोसेस और जनरेट करने के तरीके को बदल देती है, बेजोड़ प्रदर्शन और शुद्धता प्रदान करते हुए।
पारंपरिक सेंट्रल प्रोसेसिंग यूनिट (CPU) और ग्राफिक्स प्रोसेसिंग यूनिट (GPU) की तुलना में LPU की कंप्यूटिंग क्षमता अधिक है। इसका अर्थ है कि एक शब्द की भविष्यवाणी करने में लगने वाला समय काफी घट जाता है, जिससे टेक्स्ट अनुक्रम बहुत तेज़ी से जनरेट होते हैं। इसके अलावा, LPU मेमोरी बॉटलनेक्स से भी निपटता है, जो LLMs के साथ GPU की एक आम सीमा है।
Groq ने LPU को कंप्यूट घनत्व, मेमोरी बैंडविड्थ, कम लेटेंसी और उच्च थ्रूपुट जैसी चुनौतियों को संबोधित करने के लिए डिज़ाइन किया है। यह प्रदर्शन में GPU और TPU (tensor processing unit) से भी आगे निकल जाता है। उदाहरण के लिए, LPU Llama-3 70B पर प्रति उपयोगकर्ता 310 से अधिक टोकन प्रति सेकंड जनरेट कर सकता है।
आप LPU आर्किटेक्चर के बारे में अधिक जानने के लिए आधिकारिक शोध पत्र Groq ISCA 2022 Paper पढ़ सकते हैं।
वर्तमान में, हम Groq LLMs तक केवल groq.com, Groq Cloud API, Groq Playground और Poe जैसे तृतीय-पक्ष प्लेटफ़ॉर्म के माध्यम से पहुँच सकते हैं।
इस खंड में, हम OpenAI और Groq Cloud द्वारा पेश की गई विशेषताओं और मॉडलों के बारे में जानेंगे। साथ ही, हम CURL का उपयोग करके API कॉल की गति का परीक्षण करेंगे और API डिज़ाइन की तुलना करेंगे।
OpenAI API सुविधाओं और मॉडलों की एक विस्तृत श्रृंखला प्रदान करता है। यह पेश करता है:
OpenAI API तेज़ है और समय के साथ सस्ता होता जा रहा है।
हम टर्मिनल में निम्न कमांड टाइप करके नवीनतम OpenAI मॉडल तक पहुँच सकते हैं। API को OpenAI की API कुंजी, मॉडल का नाम, और संदेशों की आवश्यकता होती है जिसमें सिस्टम प्रॉम्प्ट और उपयोगकर्ता क्वेरी शामिल होती है।
curl -X POST https://api.openai.com/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -d '{
    "model": "gpt-4o",
    "messages": [
      {        "role": "system",
        "content": "You are a helpful assistant."
      },
      {
        "role": "user",
        "content": "How do I get better at programming?"
      }
    ]
  }'
अनुरोध पूरा होने में 13 सेकंड लगे।
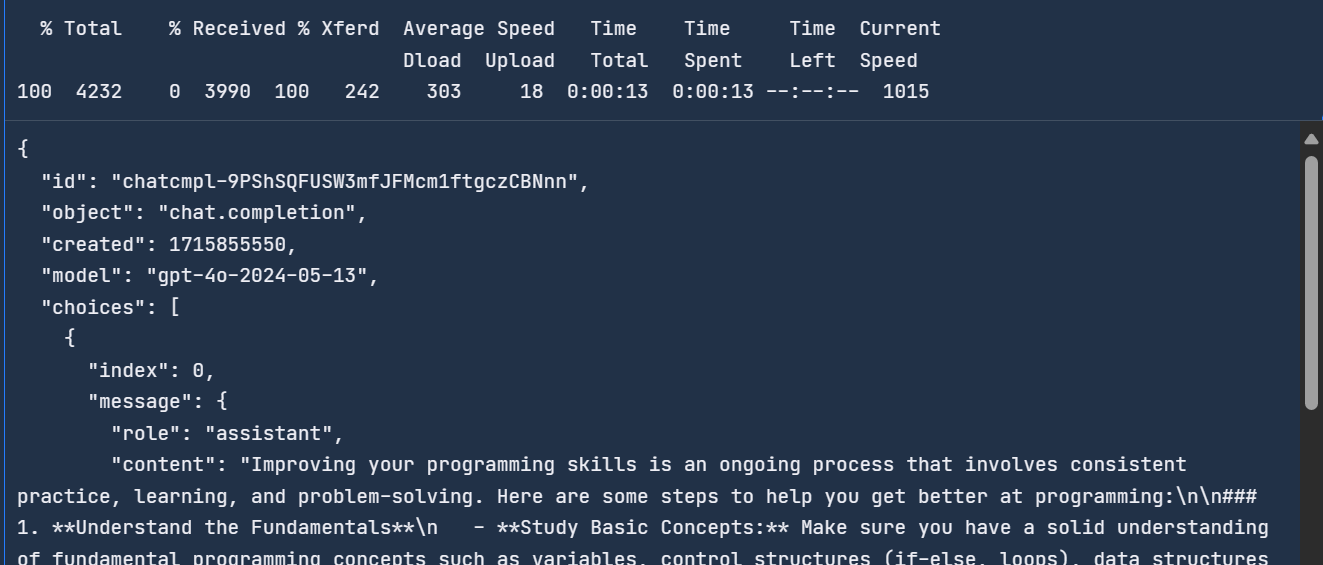
OpenAI के API और सुविधाओं के बारे में अधिक जानने के लिए, यह Beginner's Guide to The OpenAI API: Hands-On Tutorial and Best Practices देखें।
Groq AI उद्योग में नया है और वर्तमान में सीमित सुविधाएँ और मॉडल प्रदान करता है। यह पेश करता है:
Groq Cloud API, OpenAI API की तुलना में तेज़ प्रतिक्रिया समय प्रदान करता है। इसे परखने के लिए, हम टर्मिनल में CURL कमांड का उपयोग करेंगे और Groq API को वही संदेश देंगे।
Groq API, OpenAI API जैसा ही है, केवल URL अलग है।
curl -X POST "https://api.groq.com/openai/v1/chat/completions" \
    -H "Authorization: Bearer $GROQ_API_KEY" \
    -H "Content-Type: application/json" \
    -d '{"messages": [
     {
       "role": "system",
       "content": "You are a helpful assistant."
     },
     {        "role": "user",
       "content": "How do I get better at programming?"
     }
   ],
   "model": "llama3-70b-8192"}'
इसने दो सेकंड में प्रतिक्रिया दी, जो OpenAI API की तुलना में 6.5 गुना तेज़ है।
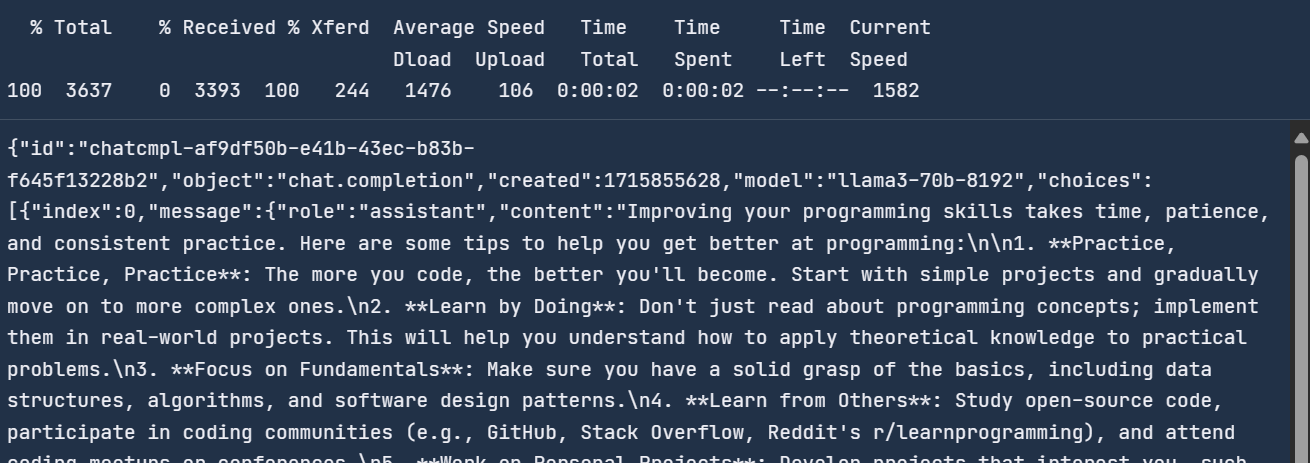
Groq के साथ, आपको रियल-टाइम प्रतिक्रिया जेनरेशन मिलता है, जो कुछ अनुप्रयोगों के लिए अत्यंत महत्वपूर्ण है।
Groq Cloud एक AI प्लेग्राउंड के साथ आता है, जहाँ आप उन सभी मॉडलों और APIs को आज़मा सकते हैं जिनका उपयोग करके आप AI प्रोडक्ट्स और एप्लिकेशन बना सकते हैं।
Groq Cloud तक पहुँचने के लिए, आपको पहले इस लिंक पर जाकर एक खाता बनाना होगा।
इसके बाद, बाएँ पैनल पर प्लेग्राउंड टैब पर क्लिक करें, llama3-70b-8192 मॉडल चुनें, और USER इनपुट के लिए प्रॉम्प्ट लिखना शुरू करें।
पूरी प्रतिक्रिया जनरेट करने में 2.94 सेकंड लगे, और गति 305 टोकन प्रति सेकंड थी। यह वह पीक परफॉर्मेंस है जो हमें ChatGPT से नहीं मिलता।
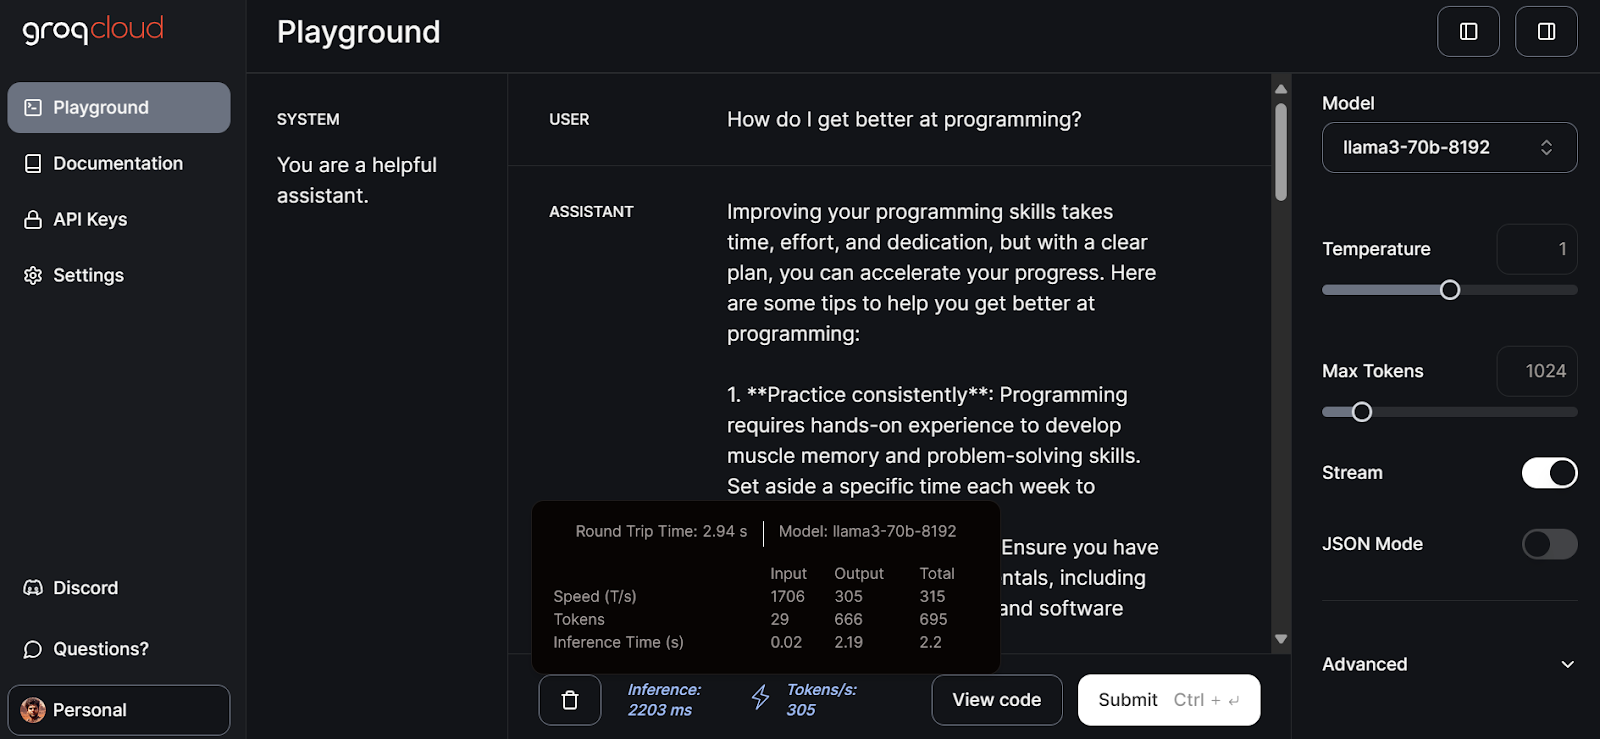
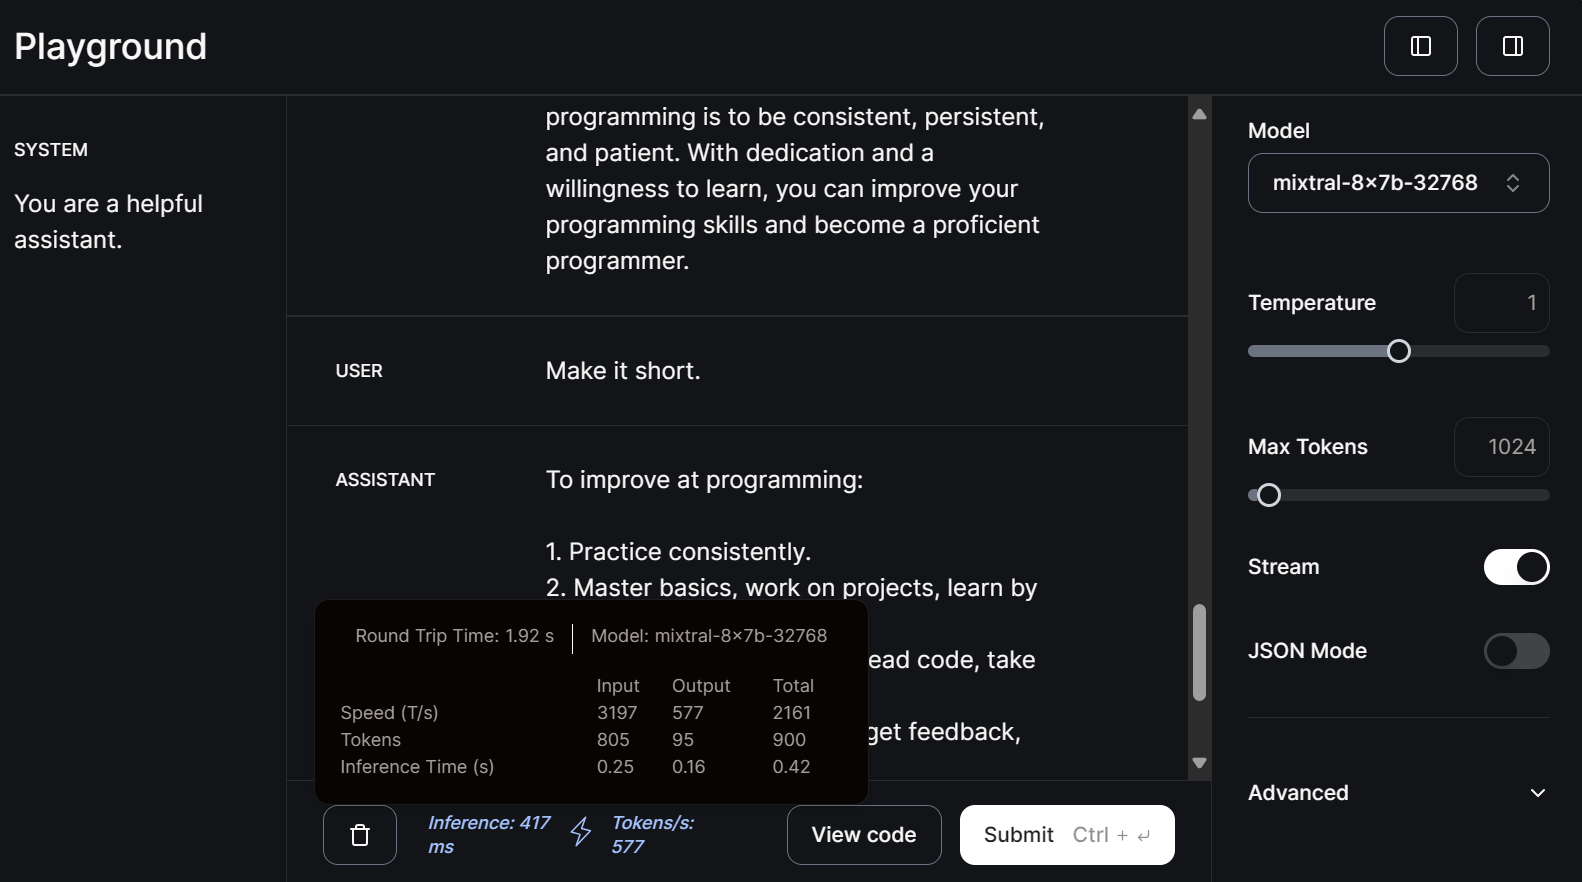
अब छोटा मॉडल mitral-8x7b-32768 चुनते हैं और फॉलो-अप प्रॉम्प्ट लिखते हैं।
छोटे मॉडल प्रतिक्रियाएँ जनरेट करने में और भी तेज़ होते हैं—577 टोकन प्रति सेकंड की गति के साथ।
उपलब्ध LLM विकल्पों और चयन करते समय किन कारकों पर विचार करना है, यह जानने के लिए यह ट्यूटोरियल पढ़ें: LLM Classification: How to Select the Best LLM for Your Application।
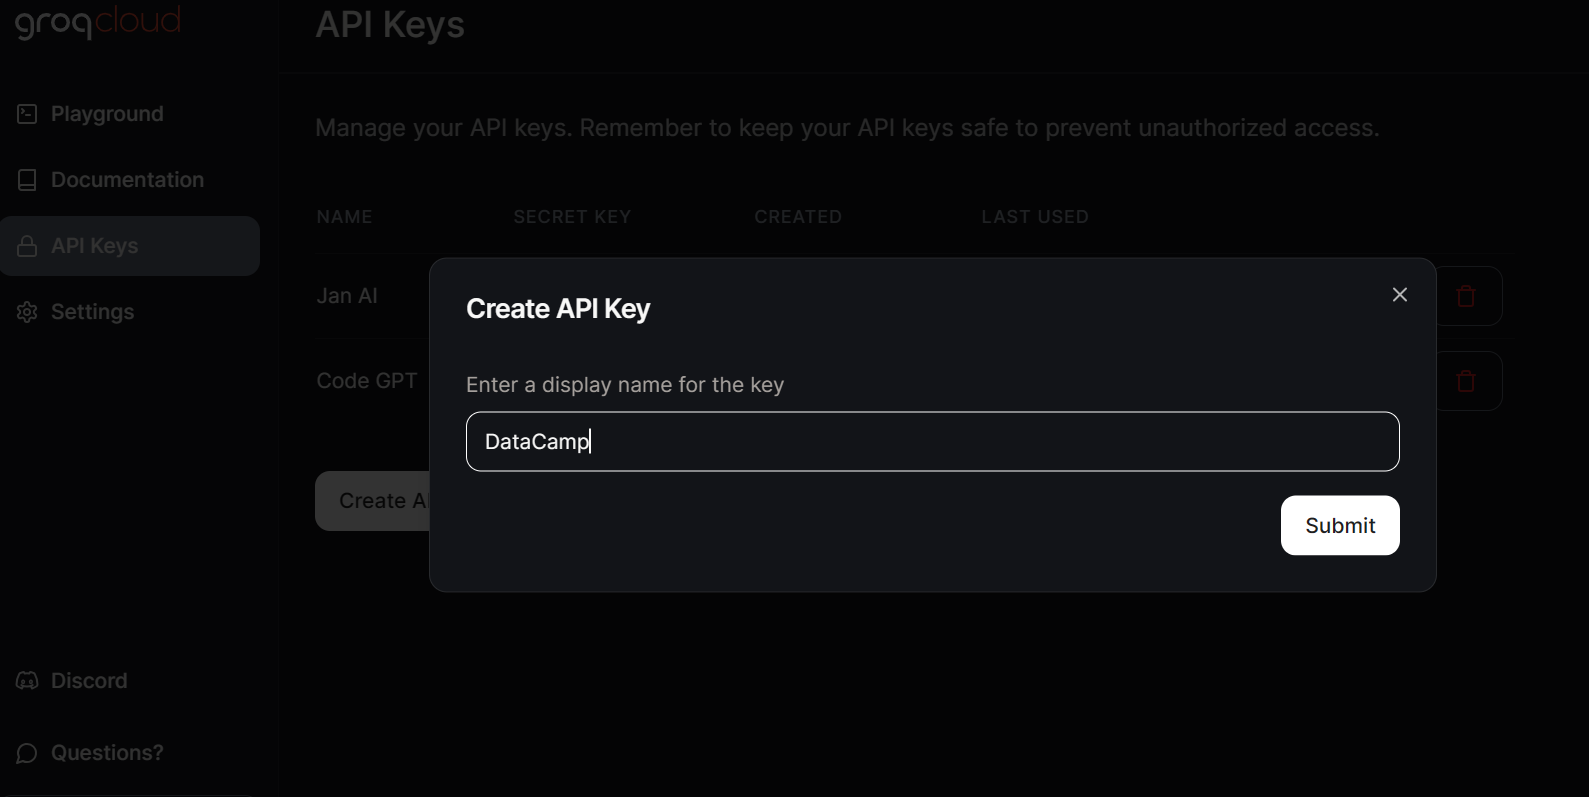
लोकल रूप से Groq LLMs का उपयोग करने के लिए, हमें API Keys टैब पर जाकर और Create API Key बटन पर क्लिक करके एक API कुंजी जनरेट करनी होगी।
Jan AI हमें लोकल रूप से LLMs—दोनों ओपन-सोर्स और स्वामित्व वाले मॉडल—का उपयोग करने की अनुमति देता है। यह OpenAI, Anthropic, Cohere, MistralAI, और Groq जैसे मॉडल प्रदाताओं का समर्थन करता है।
हम आधिकारिक वेबसाइट पर जाकर Jan AI डाउनलोड और इंस्टॉल करेंगे। फिर हम एप्लिकेशन लॉन्च कर सकते हैं।
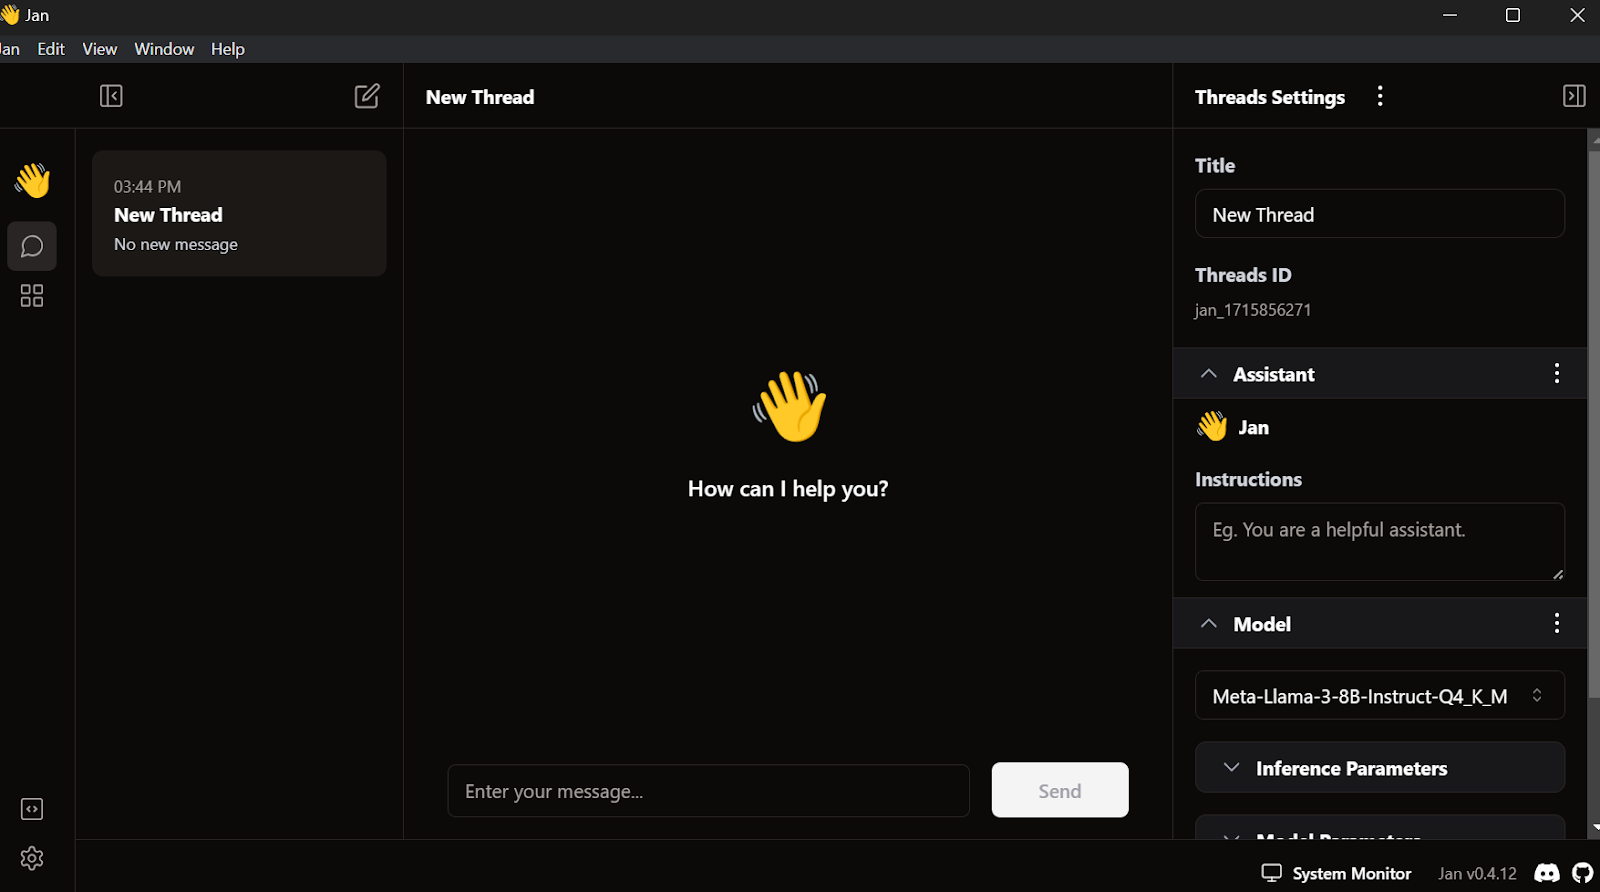
सेटिंग्स में जाएँ, Groq Inference Engine टैब चुनें, और अभी बनाई गई API कुंजी पेस्ट करें।
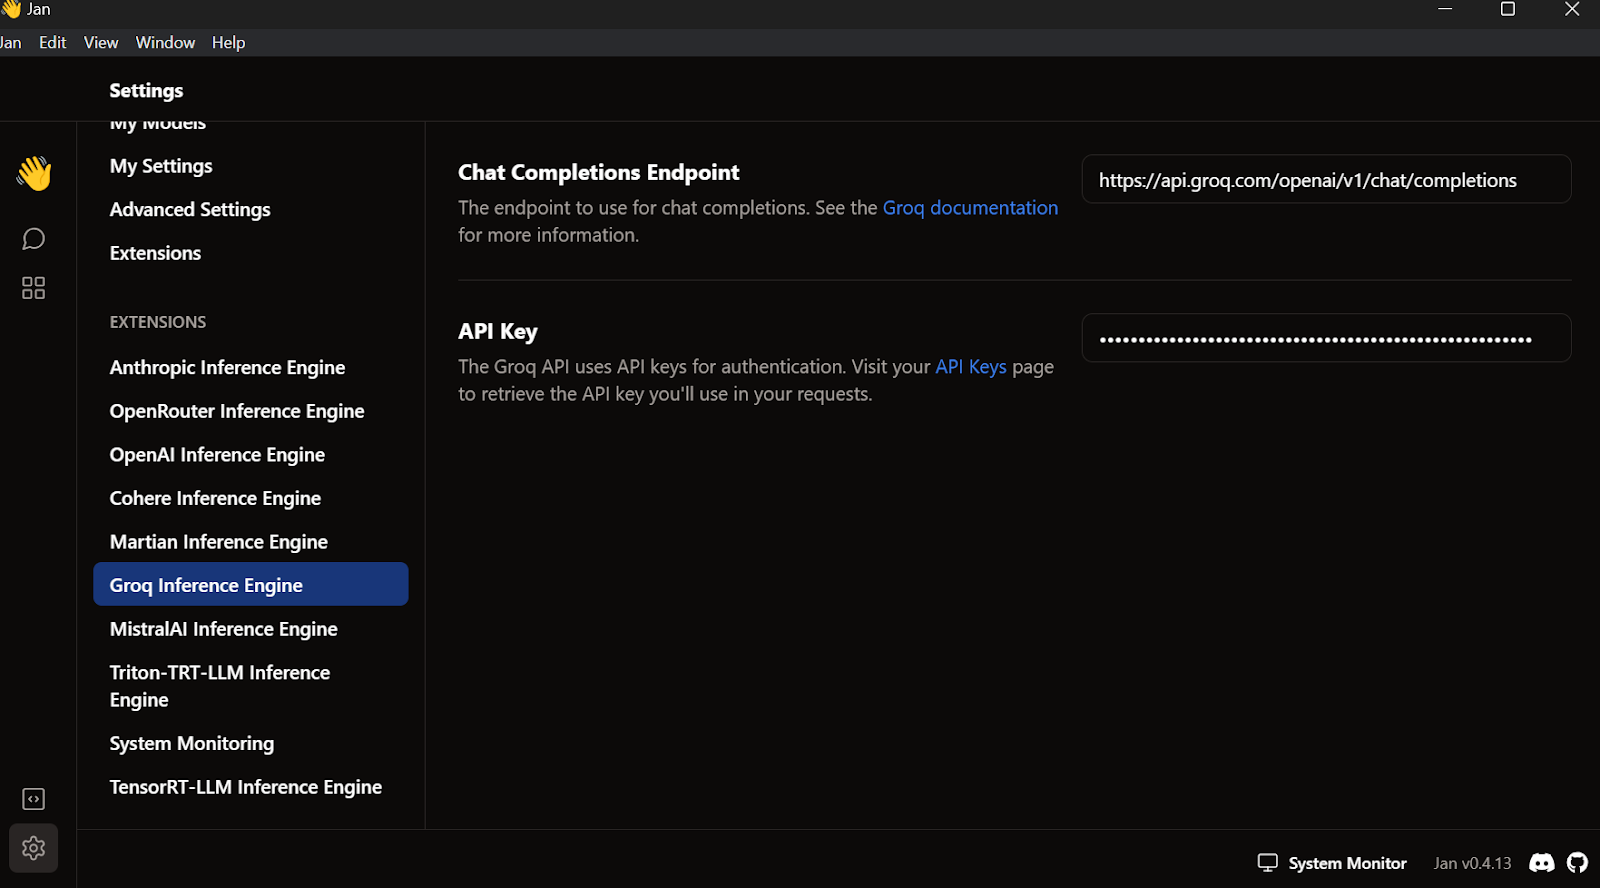
सेटिंग्स मेन्यू से बाहर आएँ, Thread पर जाएँ, और Groq Llama 3 70b मॉडल चुनें।
रियल-टाइम में प्रतिक्रिया जनरेट करने के लिए कोई प्रश्न या प्रॉम्प्ट लिखें:
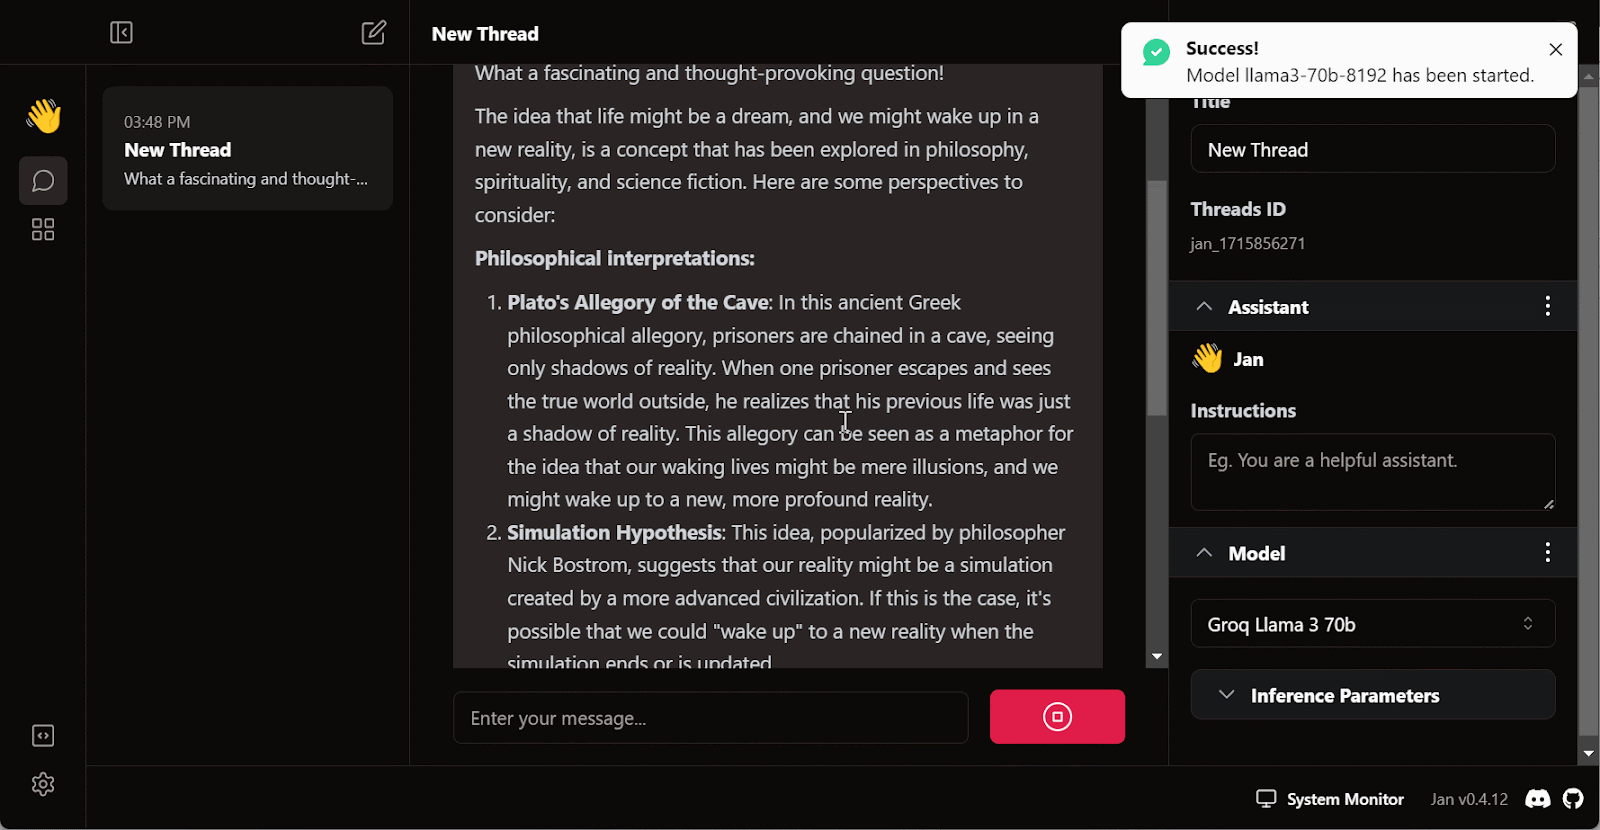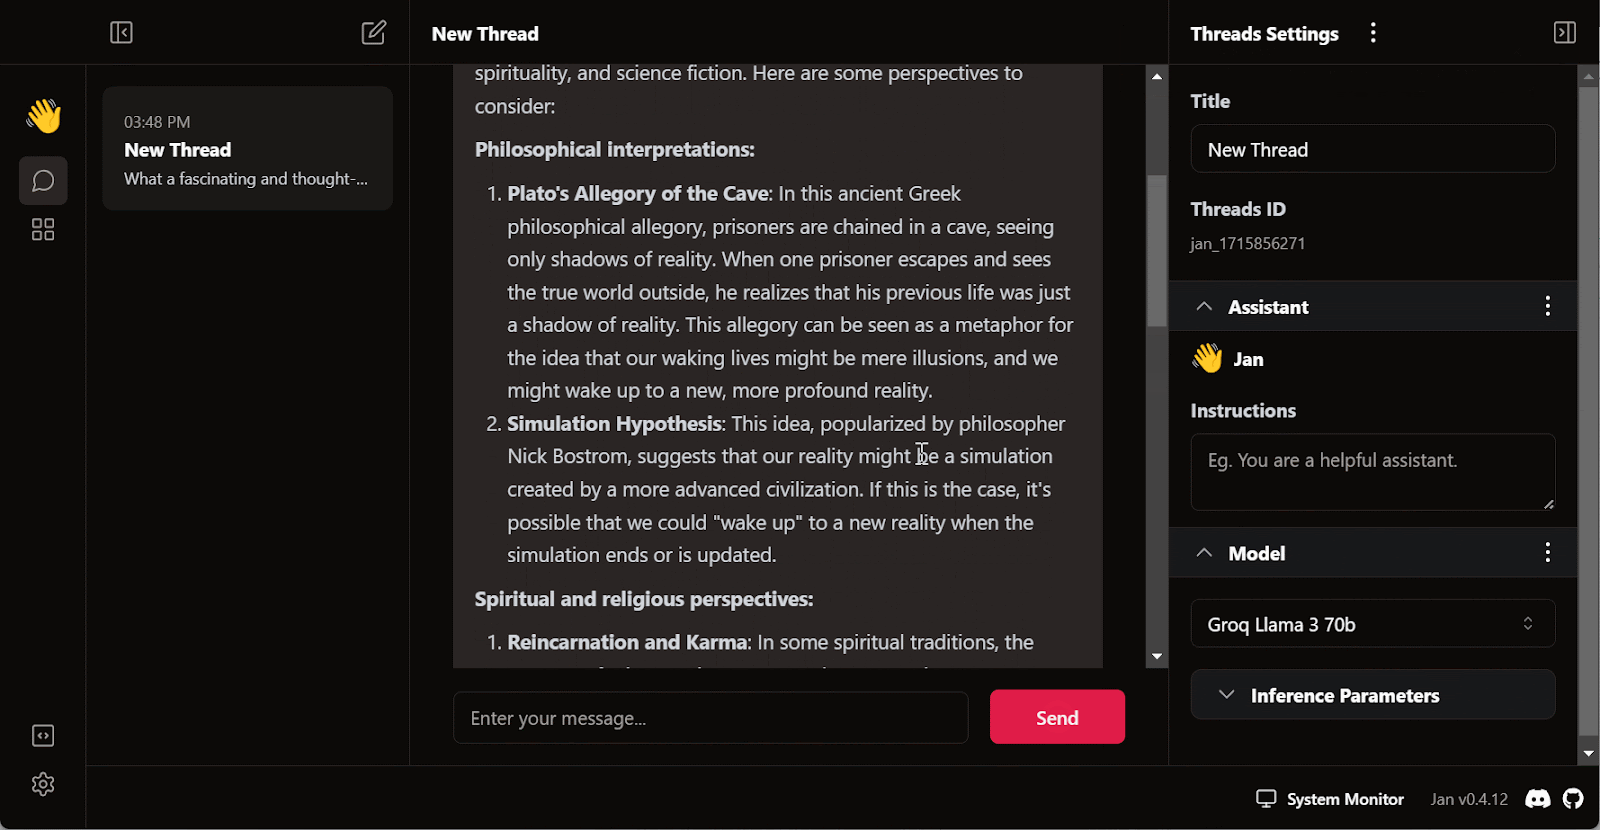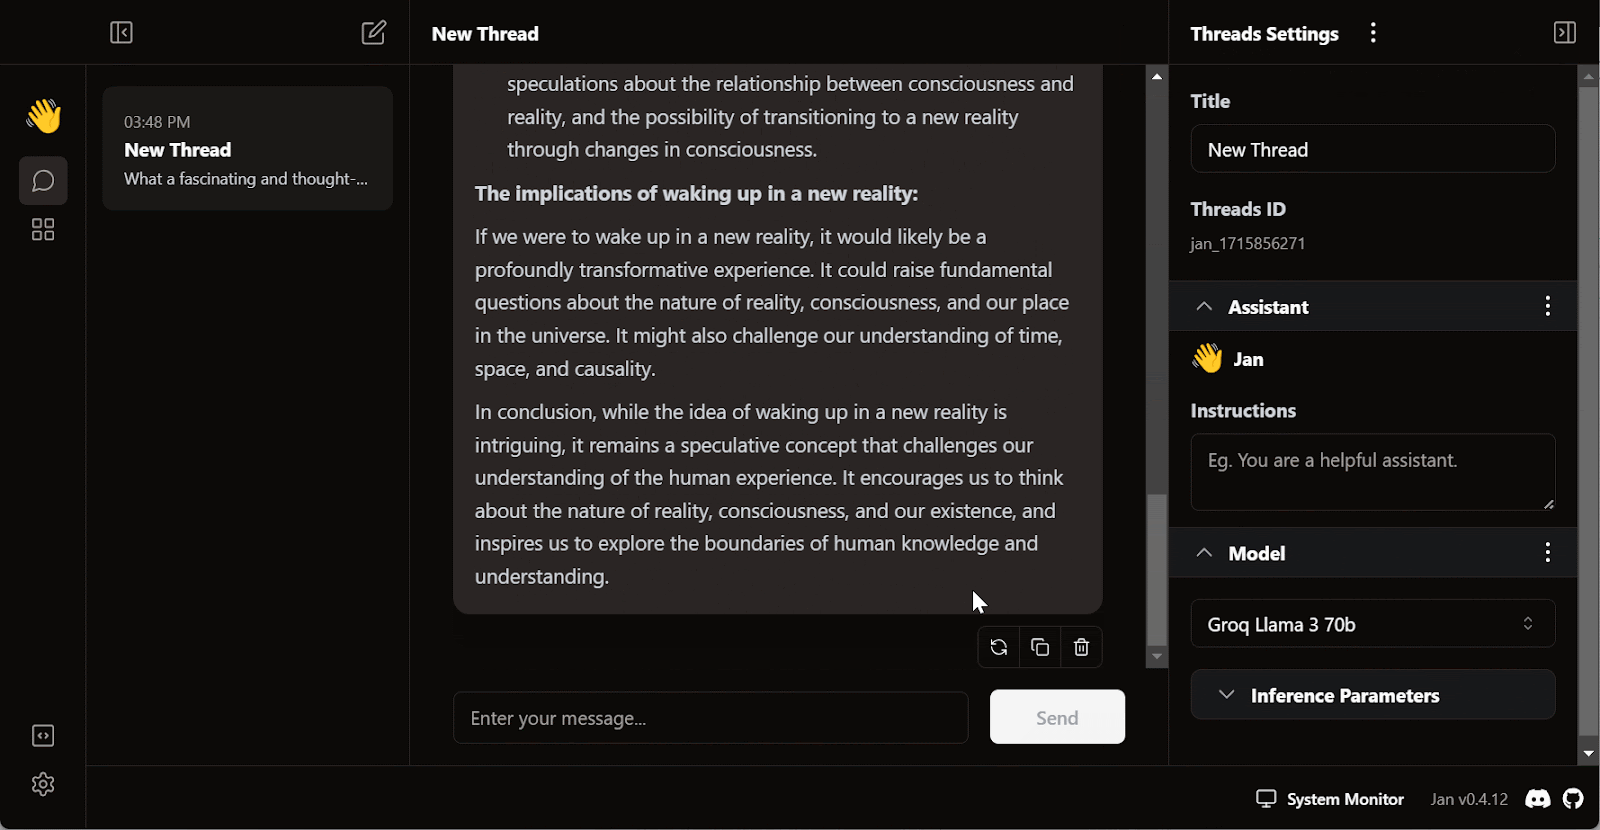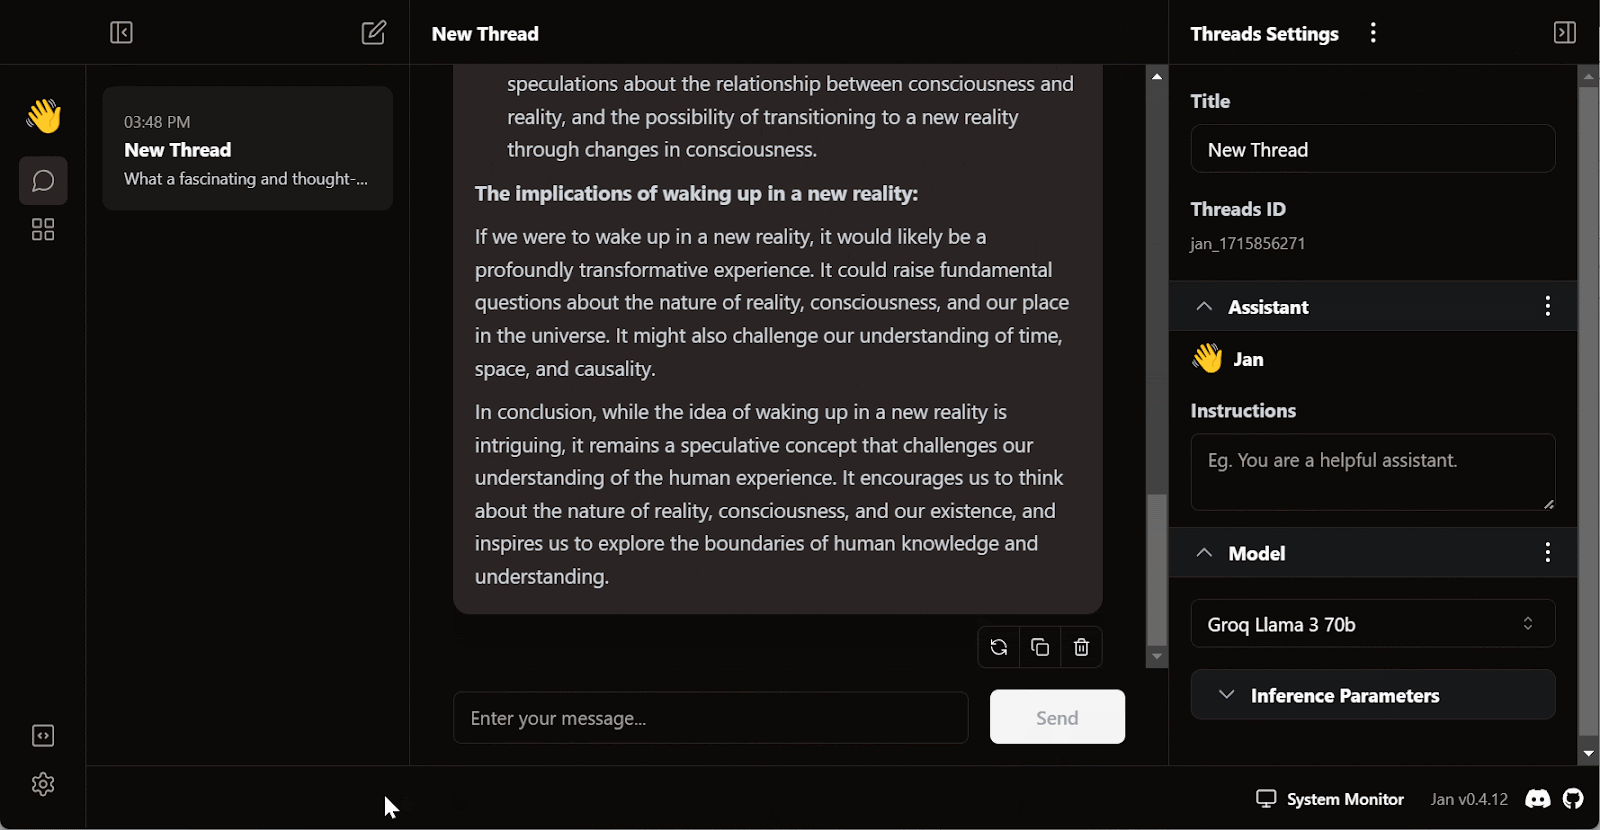
Groq Cloud की निःशुल्क सदस्यता कुछ रेट सीमाओं के साथ आती है। उदाहरण के लिए, llama3-70b-8192 प्लान प्रति मिनट 30 अनुरोध, प्रति दिन 14,400 अनुरोध, और प्रति मिनट 6,000 टोकन की अनुमति देता है। ये सीमाएँ उदार हैं, फिर भी यदि आप Groq API का उपयोग करके एक सुदृढ़ AI एप्लिकेशन बनाना चाहते हैं, तो आपको On Demand या Enterprise पैकेज में अपग्रेड करने पर विचार करना पड़ सकता है।
लोकल रूप से LLMs चलाने पर यह ट्यूटोरियल पढ़ें: running LLMs locally, ताकि आप लोकल रूप से AI ऐप्स चलाने के सात सरल तरीके जान सकें।
चैटबॉट एप्लिकेशन में Groq API का उपयोग करने के अलावा, हम इसे CodeGPT एक्सटेंशन का उपयोग करके VSCode में भी इंटीग्रेट कर सकते हैं। यह हमारा सुपर-फास्ट AI कोडिंग असिस्टेंट होगा।
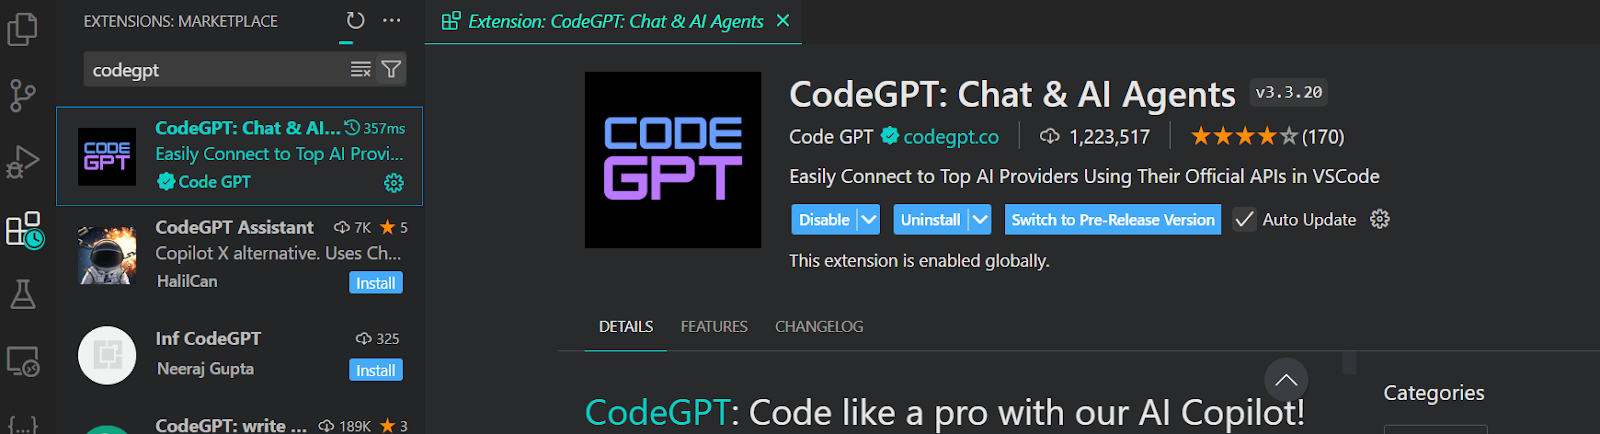
VSCode में Groq मॉडल तक पहुँचने के लिए, हमें एक्सटेंशन मार्केटप्लेस में जाकर CodeGPT एक्सटेंशन इंस्टॉल करना होगा।
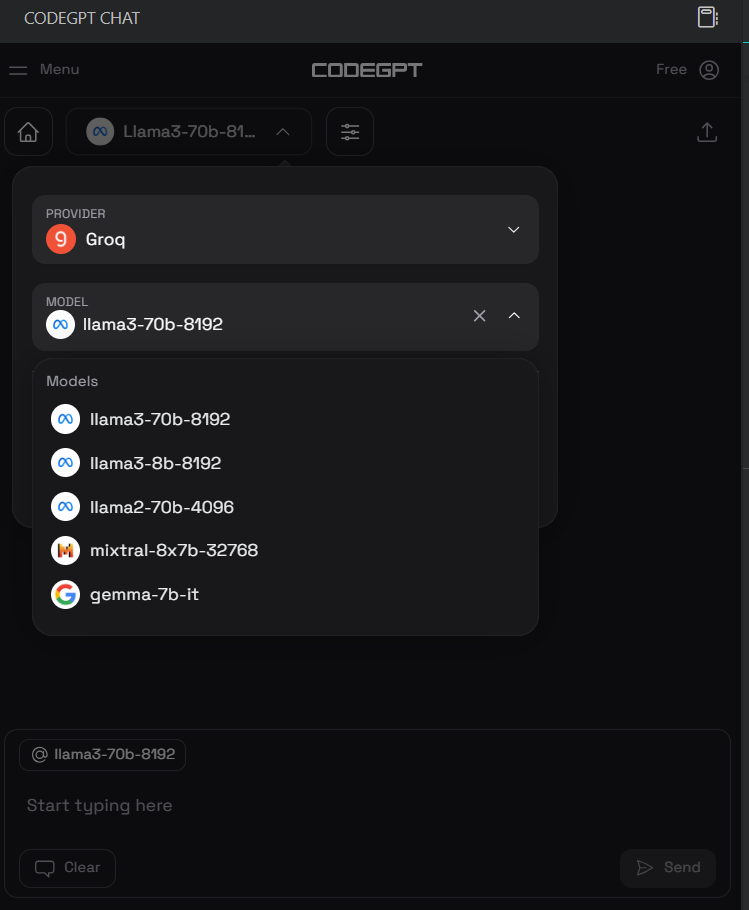
इंस्टॉल होने के बाद, हम बाएँ पैनल पर CodeGPT चैट आइकन पर क्लिक करके और प्रदाता तथा मॉडल का चयन करके Groq API कुंजी सेट करेंगे। हमने प्रदाता के रूप में Groq और मॉडल के रूप में llama3-70b-8192 चुना है।
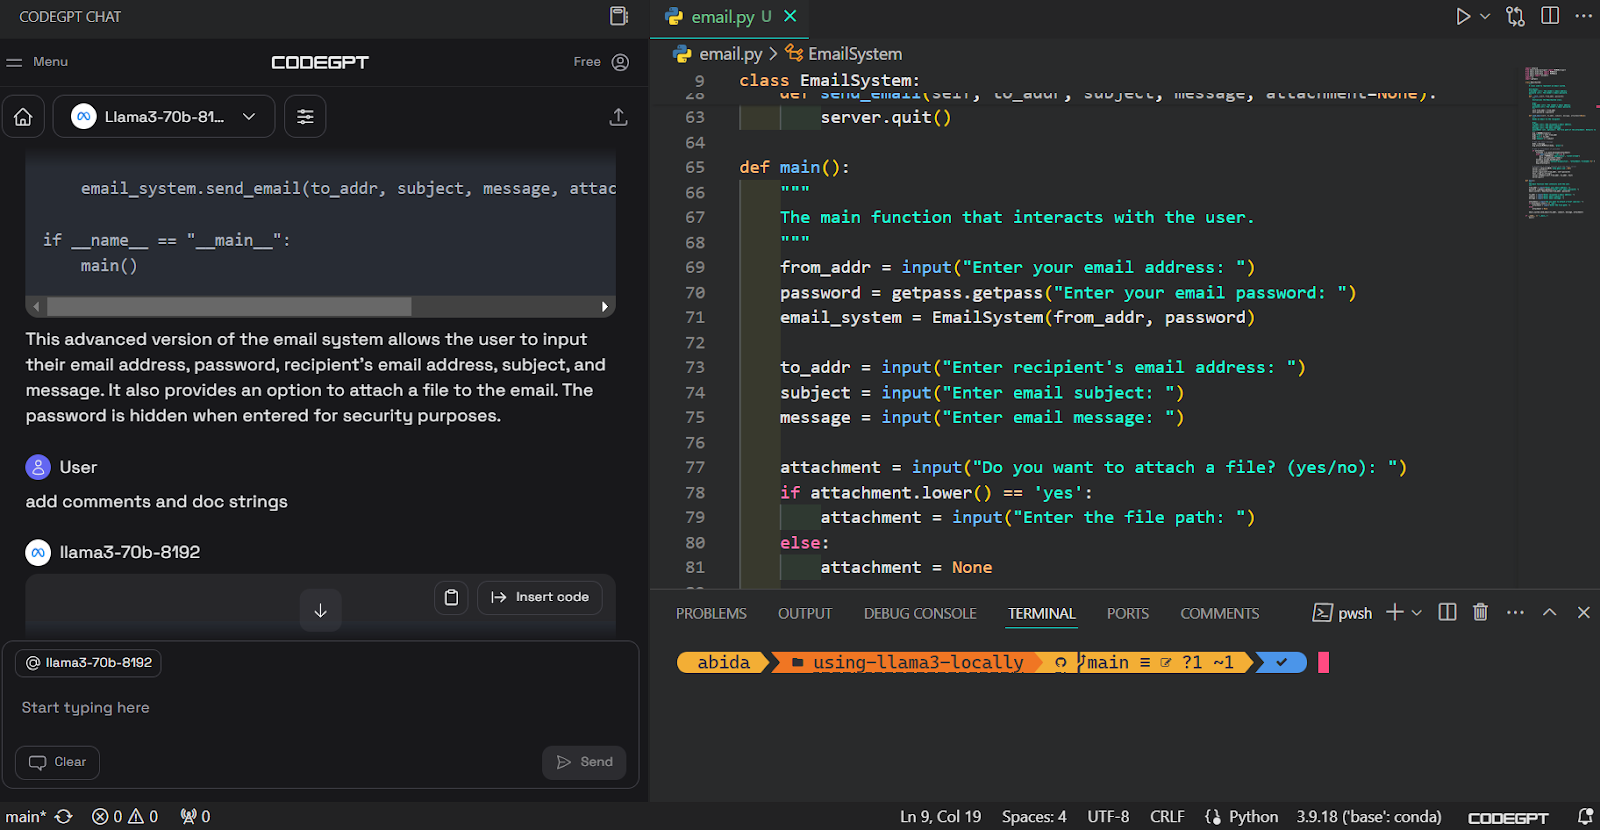
इसके बाद, हम चैट बॉक्स में प्रॉम्प्ट लिखकर कोड जनरेट कर सकते हैं। उपयुक्त कोड जनरेट करने और ईमेल सिस्टम बनाने में हमें कुछ ही सेकंड लगे।
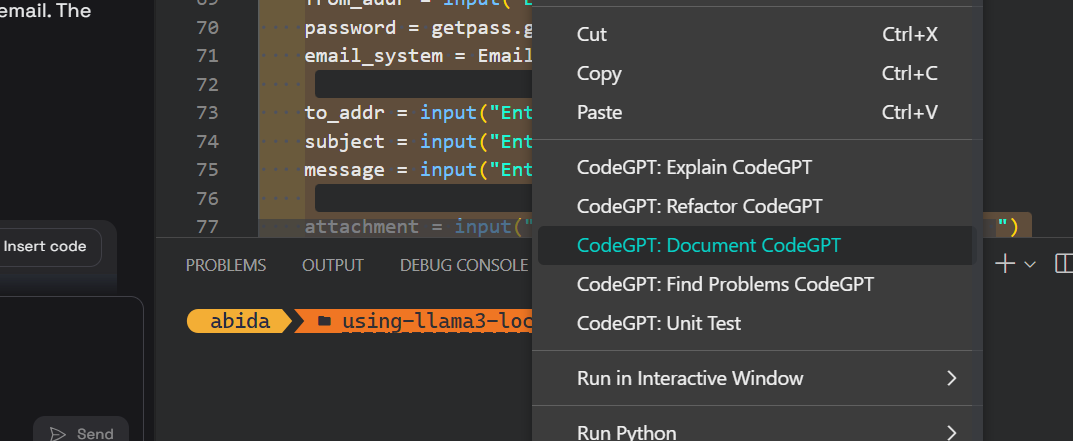
फिर हम बिल्ट-इन कमांड्स से कोड का डॉक्यूमेंटेशन कर सकते हैं, उसे रिफैक्टर कर सकते हैं, और यूनिट टेस्ट बना सकते हैं।
VSCode के बारे में जानने के लिए यह ट्यूटोरियल पढ़ें: setting up VSCode for Python।
इस खंड में, हम Groq Python API की बुनियादी बातें और इसकी प्रमुख विशेषताएँ जैसे स्ट्रीमिंग और async चैट कम्प्लीशन सीखेंगे।
इस गाइड के लिए, हम DataCamp के DataLab का उपयोग कर रहे हैं। DataLab एक AI Cloud Jupyter Notebook है जो कोड लिखने, डेटा विश्लेषण, और इनसाइट्स साझा करने के लिए ढेर सारी सुविधाओं के साथ आता है।
सबसे पहले, हमें बाएँ पैनल पर Environment बटन पर क्लिक करके और प्लस + बटन पर क्लिक करके एनवायरनमेंट वेरिएबल जोड़ते हुए DataLab में Groq API कुंजी सेट करनी होगी।
हम वेरिएबल का नाम लिख सकते हैं और नीचे दिखाए अनुसार Groq API कुंजी पेस्ट कर सकते हैं।
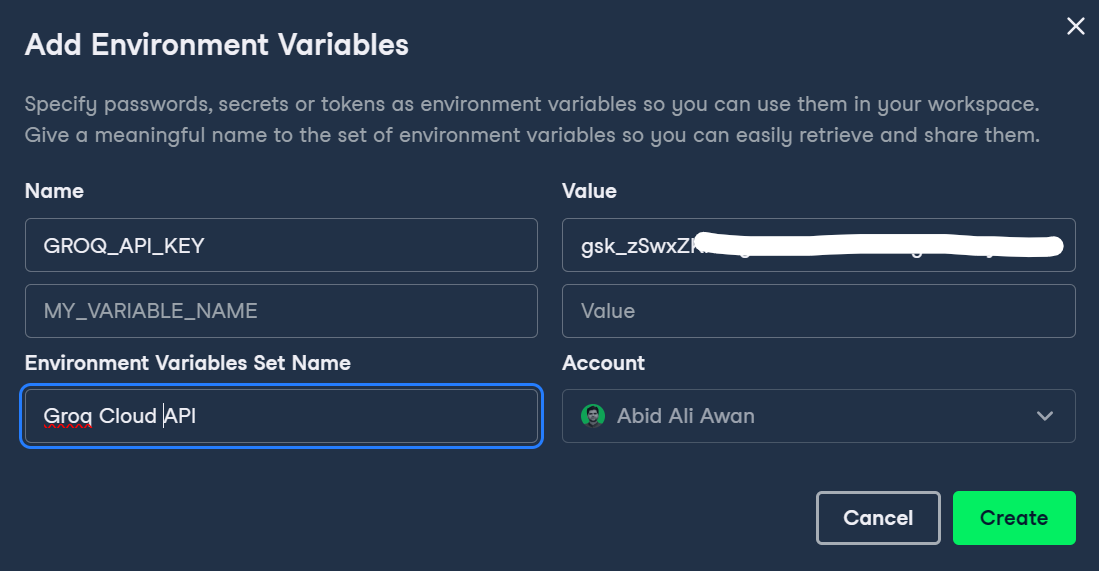
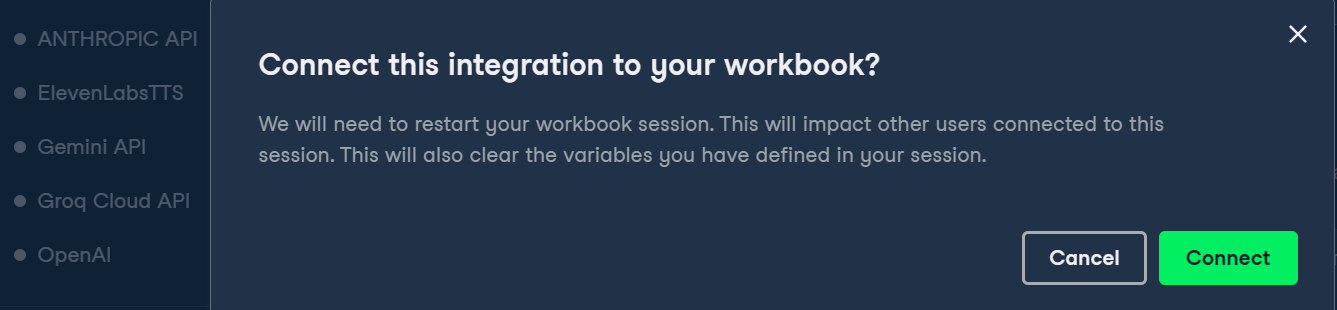
इसके बाद, हम Groq एनवायरनमेंट वेरिएबल के बगल में तीन डॉट्स पर क्लिक करके और Connect पर क्लिक करके एनवायरनमेंट वेरिएबल सक्रिय कर सकते हैं।
अंत में, हम pip कमांड का उपयोग करके Groq Python पैकेज इंस्टॉल करेंगे।
%pip install groq -qयदि आपने OpenAI Python API का उपयोग किया है, तो आपको कोड संरचना समान लगेगी। चैट कम्प्लीशन चलाने के लिए:
import os
from groq import Groq
from IPython.display import display, Markdown

client = Groq(
   api_key=os.environ.get("GROQ_API_KEY"),
)

chat_completion = client.chat.completions.create(
   messages=[
       {"role": "system", "content": "You are a professional Data Scientist."},
       {"role": "user", "content": "Can you explain how the neural networks work?"},
   ],
   model="llama3-70b-8192",)

Markdown(chat_completion.choices[0].message.content)
नतीजतन, हमें न्यूरल नेटवर्क क्या हैं इसकी अच्छी तरह से फॉर्मैट की गई व्याख्या मिली।
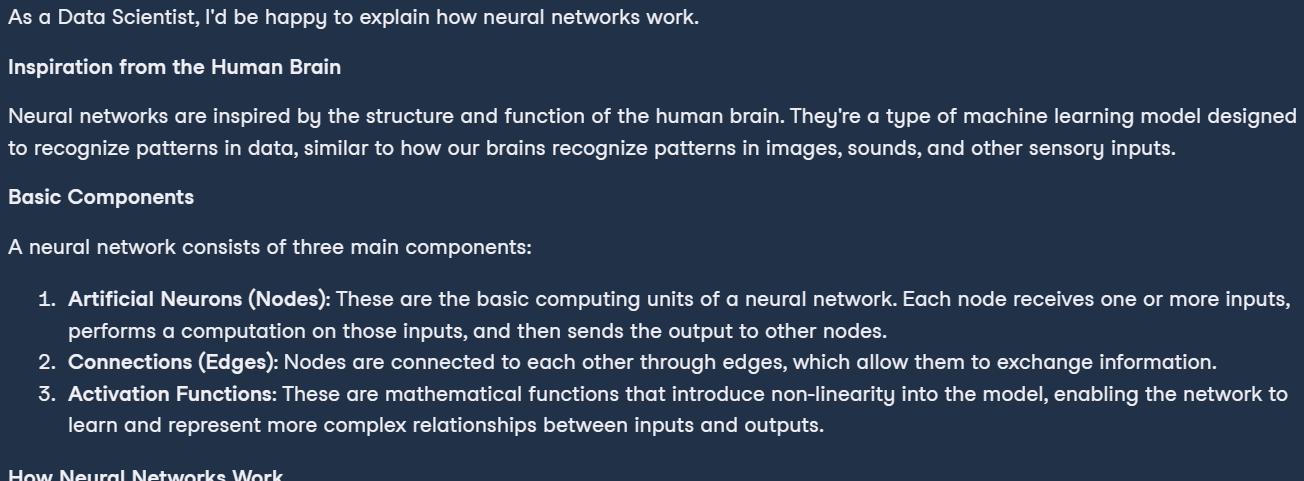
LLMs में स्ट्रीमिंग का मतलब है एक समय में एक टोकन को प्रोसेस और जनरेट करना, जिससे मेमोरी का कुशल उपयोग होता है और AI एप्लिकेशन की अनुभूत गति बेहतर होती है।
इन उदाहरणों में, हमने स्ट्रीमिंग सक्षम की और तापमान, max_tokens, और top_p जैसे हाइपरपैरामीटर्स बदलकर मॉडल को कस्टमाइज़ किया।
chat_streaming = client.chat.completions.create(
    messages=[
       {"role": "system", "content": "You are a monk from Thailand."},
       {"role": "user", "content": "Can you explain the meaning of life?"},
    ],
    model="llama3-70b-8192",
    temperature=0.3,
    max_tokens=360,
    top_p=1,
    stop=None,
    stream=True,
)

for chunk in chat_streaming:
    print(chunk.choices[0].delta.content, end="")
नतीजतन, हमने इस कोड को चलाते ही प्रतिक्रिया प्राप्त करना शुरू कर दिया।
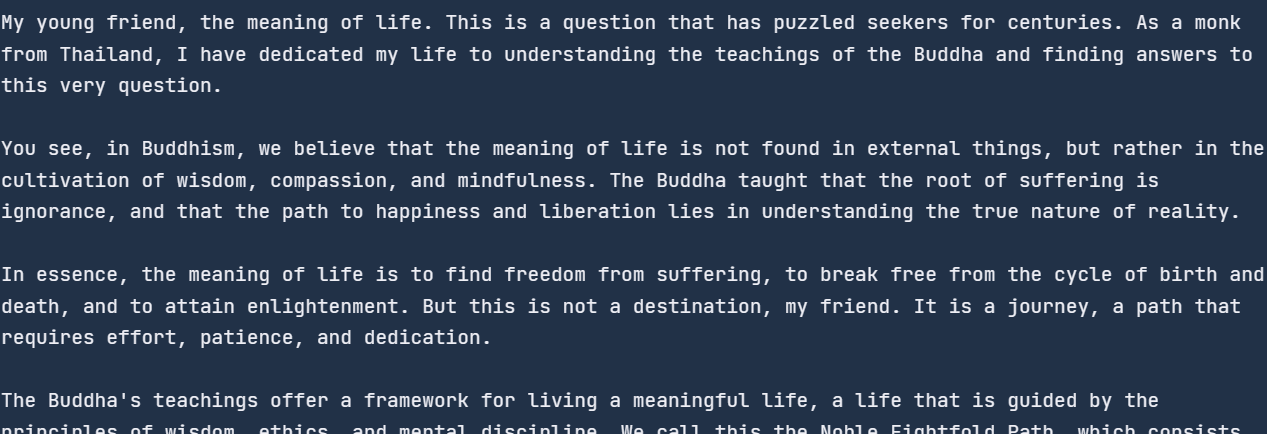
असिंक्रोनस APIs बिना ब्लॉक किए एक साथ कई अनुरोधों को संभालने में सक्षम बनाते हैं, जिससे सिस्टम प्रत्येक अनुरोध को स्वतंत्र रूप से प्रोसेस और उत्तर दे सकता है। यह तरीका अधिक कुशल और स्केलेबल है, क्योंकि यह अधिक मात्रा में अनुरोधों को संभाल सकता है और तेज़ प्रतिक्रिया समय प्रदान कर सकता है।
Async API कॉलिंग सक्षम करने के लिए, हमें कोड की संरचना बदलनी होगी। हम:
एक अतिरिक्त नोट के रूप में, नीचे दिया कोड Jupyter Notebook पर काम करता है, लेकिन यदि आप यह कोड Python फाइल में चला रहे हैं, तो आपको आखिरी पंक्ति को asyncio.run(main()) से बदलना पड़ सकता है।
import asyncio
from groq import AsyncGroq

client = AsyncGroq(

    api_key=os.environ.get("GROQ_API_KEY"),

)

async def main():

   chat_completion = await client.chat.completions.create(
       messages=[            {"role": "system", "content": "You are a psychiatrist helping young minds"},
                  {                "role": "user",                "content": "I panicked during the test, even though I knew everything on the test paper.",            },
                ],
                model="llama3-70b-8192",
                temperature=0.3,
                max_tokens=360,
                top_p=1,
                stop=None,
                stream=False,
       )

       print(chat_completion.choices[0].message.content)

await main()  # for Python file use asyncio.run(main())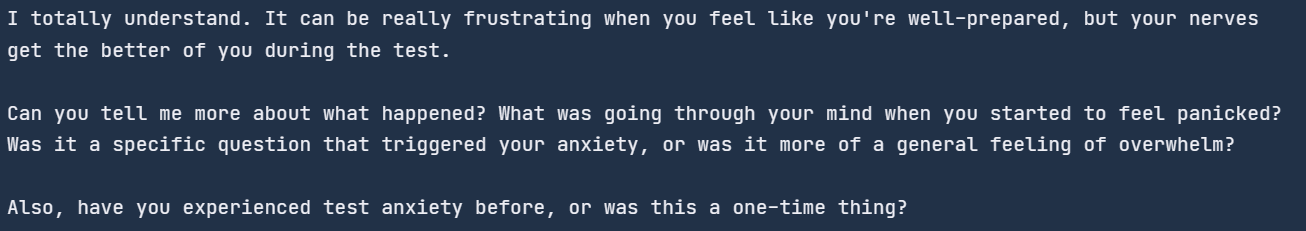
हम चैट कम्प्लीशन फ़ंक्शन में stream आर्ग्युमेंट सक्षम करके async API को भी स्ट्रीम कर सकते हैं और परिणाम प्रिंट करने के तरीके को बदल सकते हैं। हम async कमांड के साथ for लूप का उपयोग करके प्रत्येक चंक को प्रिंट करेंगे।
import asyncio

from groq import AsyncGroq


client = AsyncGroq()

async def main():

    chat_streaming = await client.chat.completions.create(
        messages=[
           {"role": "system", "content": "You are a psychiatrist helping young minds"},
           {                "role": "user",                "content": "I panicked during the test, even though I knew everything on the test paper.",            },
        ],
        model="llama3-70b-8192",
        temperature=0.3,
        max_tokens=360,
        top_p=1,
        stop=None,
        stream=True,
     )
     async for chunk in chat_streaming:
            print(chunk.choices[0].delta.content, end="")

await main()  # for Python file use asyncio.run(main())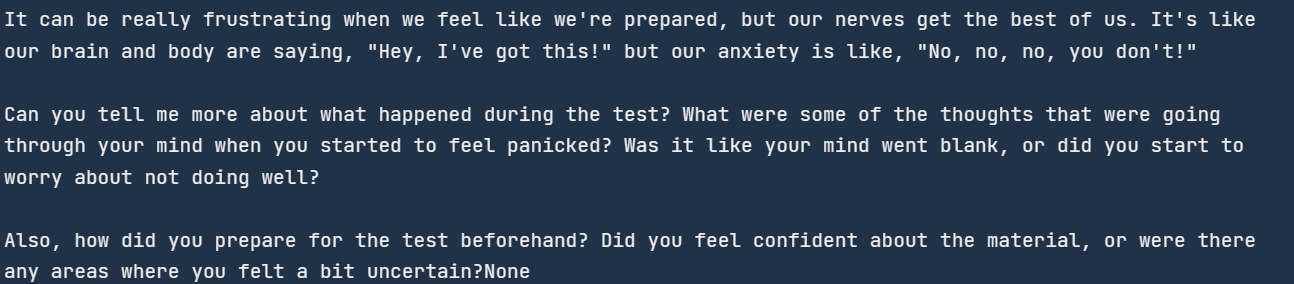
यदि आपको कोड चलाने में समस्या हो रही है, तो कृपया यह DataLab नोटबुक देखें: Groq Cloud API।
इस गाइड में, हम एक कदम आगे बढ़ेंगे और Groq API तथा LlamaIndex—जो एक LLM फ्रेमवर्क है—का उपयोग करके AI एप्लिकेशन बनाना सीखेंगे। हम ऐसा एप्लिकेशन बनाएंगे जो PDF फाइल से टेक्स्ट लोड करेगा, उसे एम्बेडिंग्स में बदलेगा, और वेक्टर स्टोर में सेव करेगा। उसके बाद, हम वेक्टर स्टोर को एक रिट्रीवर में बदलेंगे, जिसका उपयोग इतिहास सहित RAG चैट इंजन बनाने के लिए किया जाएगा।
संक्षेप में, हम एक संदर्भ-संज्ञानी ChatPDF एप्लिकेशन बना रहे हैं, जो आपको दस्तावेज़ को बहुत तेज़ी से समझने में मदद करेगा।
प्राकृतिक भाषा का उपयोग करके निजी और डोमेन-विशिष्ट डेटा को ingest, प्रबंधित और पुनर्प्राप्त करना कैसे है, यह सीखने के लिए यह ट्यूटोरियल देखें: LlamaIndex: A Data Framework for Large Language Models (LLMs)।
सबसे पहले, हम pip का उपयोग करके सभी आवश्यक Python पैकेज इंस्टॉल करेंगे। हम लॉग्स को दबाने के लिए %%capture मैजिक फ़ंक्शन का उपयोग करते हैं।
%%capture
%pip install llama-index
%pip install llama-index-llms-groq
%pip install llama-index-embeddings-huggingfaceहम llama_index फ़ंक्शन का उपयोग करके Groq LLM क्लाइंट बनाएँगे। LLM क्लाइंट को मॉडल नाम और API कुंजी की आवश्यकता होती है।
from llama_index.llms.groq import Groq
import os

llm =
Groq(model="llama3-70b-8192",api_key=os.environ.get("GROQ_API_KEY"))अब हम LlamaIndex embeddings API का उपयोग करके Hugging Face एम्बेडिंग मॉडल डाउनलोड और लोड करेंगे।
हमारे केस में, हम Hugging Face पर सबसे लोकप्रिय एम्बेडिंग मॉडल mxbai-embed-large-v1 लोड कर रहे हैं।
from llama_index.embeddings.huggingface import HuggingFaceEmbedding

embed_model =
HuggingFaceEmbedding(model_name="mixedbread-ai/mxbai-embed-large-v1")LlamaIndex हमें ग्लोबल कॉन्फ़िगरेशन सेट करने देता है, जिससे हर जगह LLM या एम्बेडिंग मॉडल ऑब्जेक्ट पास करने की ज़रूरत नहीं रहती।
from llama_index.core import Settings

Settings.llm = llm
Settings.embed_model = embed_model
डेटा के लिए, हम 14 Essential Data Engineering Tools to Use in 2024 ब्लॉग पोस्ट का उपयोग कर रहे हैं और उसे प्रिंट कमांड से PDF में बदल रहे हैं।
SimpleDirectoryReader फ़ंक्शन का उपयोग करके, आप फोल्डर से सभी प्रकार के दस्तावेज़ लोड कर सकते हैं। बस फोल्डर डायरेक्टरी और आवश्यक फाइल एक्सटेंशन्स प्रदान करें।
from llama_index.core import SimpleDirectoryReader

de_tools_blog = SimpleDirectoryReader("./",required_exts=[".pdf", ".docx"]).load_data()VectorStoreIndex दस्तावेज़ लोड करके और इंडेक्स बनाकर वेक्टर स्टोर बनाने का सबसे तेज़ तरीका प्रदान करता है। इंडेक्स का उपयोग क्वेरी इंजनों, रिट्रीवर्स, और क्वेरी पाइपलाइनों के लिए किया जा सकता है।
हमारे केस में, हम दस्तावेज़ों को वेक्टर स्टोर में देकर इंडेक्स बना रहे हैं, जो टेक्स्ट को एम्बेडिंग्स में बदलेगा और फिर उसे वेक्टर स्टोर में संग्रहीत करेगा।
इसके बाद, हम इंडेक्स को क्वेरी इंजन में बदलेंगे ताकि बेसिक RAG (retrieval augmented generation) किया जा सके, जो रिट्रीवल और AI मॉडलों को जोड़कर संदर्भ-संज्ञानी उत्तर उत्पन्न करता है।
from llama_index.core import VectorStoreIndex

index = VectorStoreIndex.from_documents(de_tools_blog)
query_engine = index.as_query_engine(similarity_top_k=3)

response = query_engine.query("How many tools are there?")
print(response)
अब हम इतिहास सहित RAG चैट इंजन बनाएँगे। इतिहास जोड़ने से चैट इंजन उपयोगकर्ता संदेशों और जनरेट की गई प्रतिक्रियाओं—दोनों—को याद रख सकेगा और संदर्भ-संज्ञानी उत्तर देगा।
यह एप्लिकेशन बनाने के लिए, हम 3900 टोकन का ChatMemoryBuffer बनाएँगे और उसे रिट्रीवर और LLM ऑब्जेक्ट के साथ चैट इंजन को प्रदान करेंगे।
जब आप कोई प्रश्न पूछेंगे, तो चैट इंजन संदर्भ के रूप में PDF दस्तावेज़ और पिछले संदेशों का उपयोग करेगा और उसी के अनुसार उत्तर देगा।
from llama_index.core.memory import ChatMemoryBuffer
from llama_index.core.chat_engine import CondensePlusContextChatEngine

memory = ChatMemoryBuffer.from_defaults(token_limit=3900)

chat_engine = CondensePlusContextChatEngine.from_defaults(
   index.as_retriever(),
   memory=memory,
   llm=llm
)

response = chat_engine.chat(
   "What tools are suitable for data processing?"
)
print(str(response))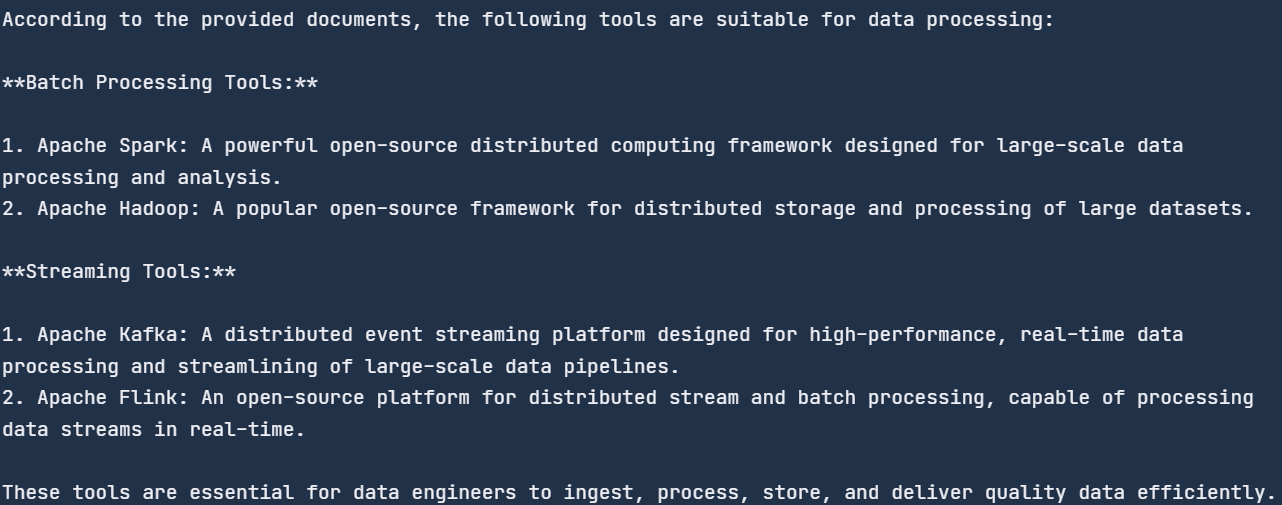
हमने सामान्य प्रश्न पूछे, और इसने दस्तावेज़ में डेटा प्रोसेसिंग टूल्स की खोज की और हमें सूची प्रदान की। ये सभी टूल ब्लॉग में उल्लिखित हैं।
मेमोरी भाग का परीक्षण करने के लिए एक फॉलो-अप प्रश्न पूछते हैं।
response = chat_engine.chat(
    "Can you create a diagram of a data pipeline using these tools?"
)
print(str(response))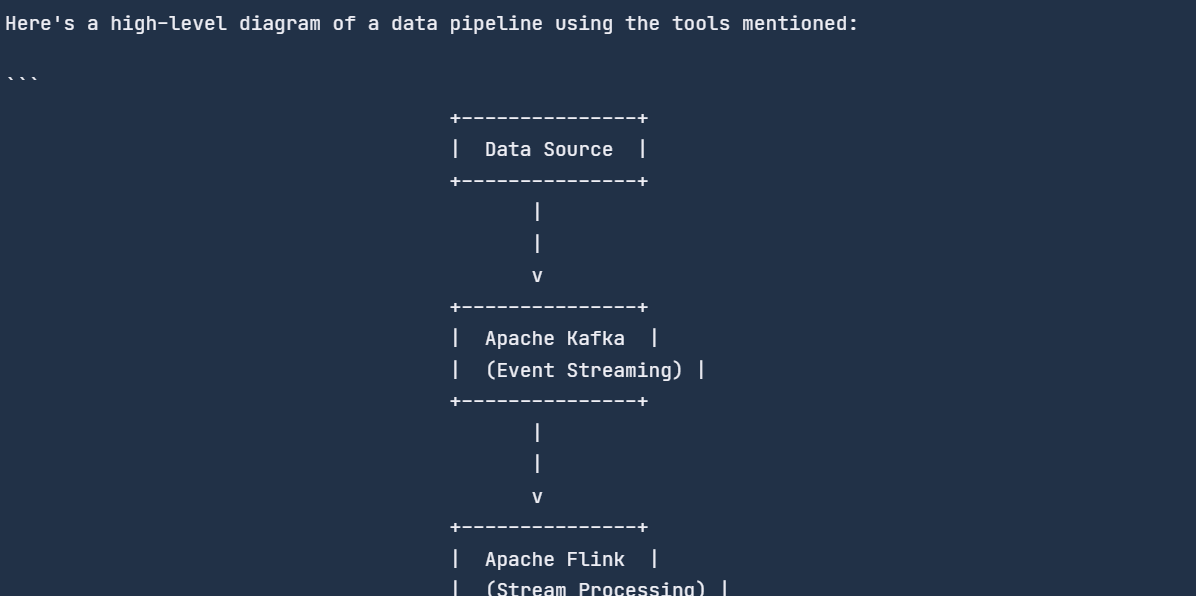
चैट इंजन ने पिछली बातचीत को याद रखा और उसी के अनुरूप उत्तर दिया।
हमारा सारा कोड इस DataLab नोटबुक पर उपलब्ध है: Groq Cloud API — DataLab।
Groq LPU इंफरेंस इंजन AI में गेम-चेंजर है। जहाँ OpenAI और Google जैसे बड़े खिलाड़ी उच्च-गुणवत्ता वाले LLMs विकसित करने पर ध्यान केंद्रित कर रहे हैं, वहीं Groq इन मॉडलों को तेज़ बनाता है। AI जगत में नया होने के बावजूद, Groq AI समुदाय में उल्लेखनीय प्रभाव डाल रहा है।
इस ब्लॉग में, हमने Groq LPU इंफरेंस इंजन के बारे में सीखा, Groq Cloud का अन्वेषण किया, और Groq API को VSCode और Jan AI एप्लिकेशन में इंटीग्रेट किया। साथ ही, हमने कोड उदाहरणों के साथ Groq Python पैकेज में गहराई से देखा और एक ऐसा संदर्भ-संज्ञानी AI एप्लिकेशन बनाना सीखा जो चैट इतिहास और PDF दस्तावेज़ों से सीख सकता है।
आपकी सीखने की यात्रा में अगला संभावित कदम कस्टम डेटा सेट पर LLMs को फाइन-ट्यून करना हो सकता है। आप यह कैसे करें, इसे इस ट्यूटोरियल से सीख सकते हैं: Fine Tuning Google Gemma: Enhancing LLMs with Customized Instructions।
DataCamp के साथ सीखें
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}
{count, plural, one {कोर्स} other {कोर्स}}
