
Corso
Concetti di IA generativa
2 ore
119.9K
Se hai provato la frustrazione di aspettare che ChatGPT risponda, sarai entusiasta di scoprire il motore di inferenza della LPU (Language Processing Unit) di Groq.
Con Groq puoi ottenere rapidamente la risposta alle tue domande, riducendo i tempi di attesa da 40 secondi a soli 2 secondi.
In questo tutorial:
Se sei alle prime armi con i large language model (LLM), ti consigliamo di seguire il percorso di competenze Developing Large Language Models per imparare le basi del fine-tuning degli LLM e costruire il tuo modello da zero.
La LPU (language processing unit) Inference Engine di Groq è un nuovo sistema di elaborazione che gestisce compiti computazionalmente intensivi con componenti sequenziali, in particolare nella generazione di risposte per i large language model. Questa tecnologia innovativa trasforma il modo in cui elaboriamo e generiamo testo, offrendo prestazioni e precisione senza precedenti.
Rispetto alle tradizionali CPU (central processing unit) e GPU (graphics processing unit), la LPU ha una capacità di calcolo superiore. Ciò significa che il tempo necessario per prevedere una parola è notevolmente ridotto, rendendo molto più veloce la generazione di sequenze di testo. Inoltre, la LPU affronta anche i colli di bottiglia della memoria, una limitazione comune delle GPU quando lavorano con gli LLM.
Groq ha progettato la LPU per risolvere sfide come densità di calcolo, ampiezza di banda della memoria, bassa latenza e alto throughput. Offre guadagni prestazionali che superano GPU e TPU (tensor processing unit). Ad esempio, la LPU può generare oltre 310 token al secondo per utente su Llama-3 70B.
Puoi approfondire l'architettura della LPU leggendo il paper ufficiale Groq ISCA 2022 Paper.
Attualmente possiamo accedere agli LLM Groq solo tramite groq.com, Groq Cloud API, Groq Playground e piattaforme di terze parti come Poe.
In questa sezione conosceremo le funzionalità e i modelli offerti da OpenAI e Groq Cloud. Inoltre, testeremo la velocità delle chiamate API usando CURL e confronteremo i design delle API.
L'API di OpenAI offre un'ampia gamma di funzionalità e modelli. Offre:
L'API di OpenAI è veloce e sta diventando più economica nel tempo.
Possiamo accedere al modello più recente di OpenAI digitando il seguente comando nel terminale. L'API richiede la chiave API di OpenAI, il nome del modello e i messaggi che contengono il prompt di sistema e la richiesta dell'utente.
curl -X POST https://api.openai.com/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -d '{
    "model": "gpt-4o",
    "messages": [
      {        "role": "system",
        "content": "You are a helpful assistant."
      },
      {
        "role": "user",
        "content": "How do I get better at programming?"
      }
    ]
  }'
La richiesta ha impiegato 13 secondi per essere completata.
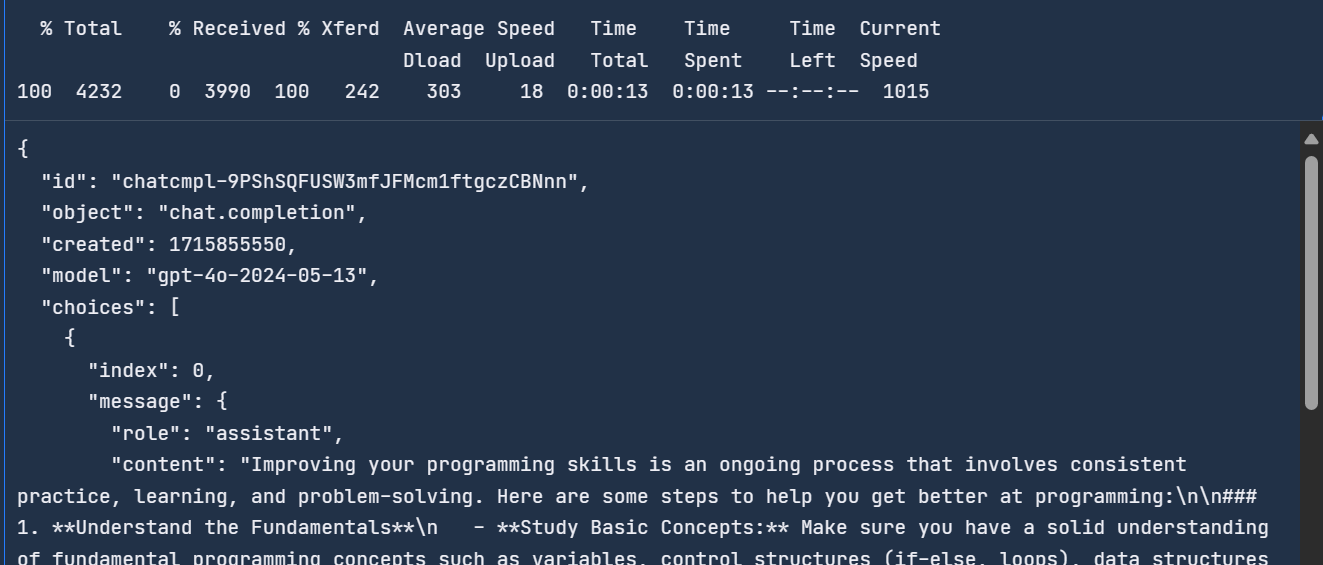
Per saperne di più sull'API e le funzionalità di OpenAI, dai un'occhiata a questa Guida per principianti all'API di OpenAI: tutorial pratico e best practice.
Groq è nuovo nel settore dell'AI e al momento offre funzionalità e modelli limitati. Offre:
La Groq Cloud API fornisce tempi di risposta più rapidi rispetto all'API di OpenAI. Per verificarlo, useremo il comando CURL nel terminale e forniremo lo stesso messaggio alla Groq API.
La Groq API è simile all'API di OpenAI, con l'unica differenza dell'URL.
curl -X POST "https://api.groq.com/openai/v1/chat/completions" \
    -H "Authorization: Bearer $GROQ_API_KEY" \
    -H "Content-Type: application/json" \
    -d '{"messages": [
     {
       "role": "system",
       "content": "You are a helpful assistant."
     },
     {        "role": "user",
       "content": "How do I get better at programming?"
     }
   ],
   "model": "llama3-70b-8192"}'
Ha impiegato due secondi per rispondere, risultando 6,5 volte più veloce rispetto all'API di OpenAI.
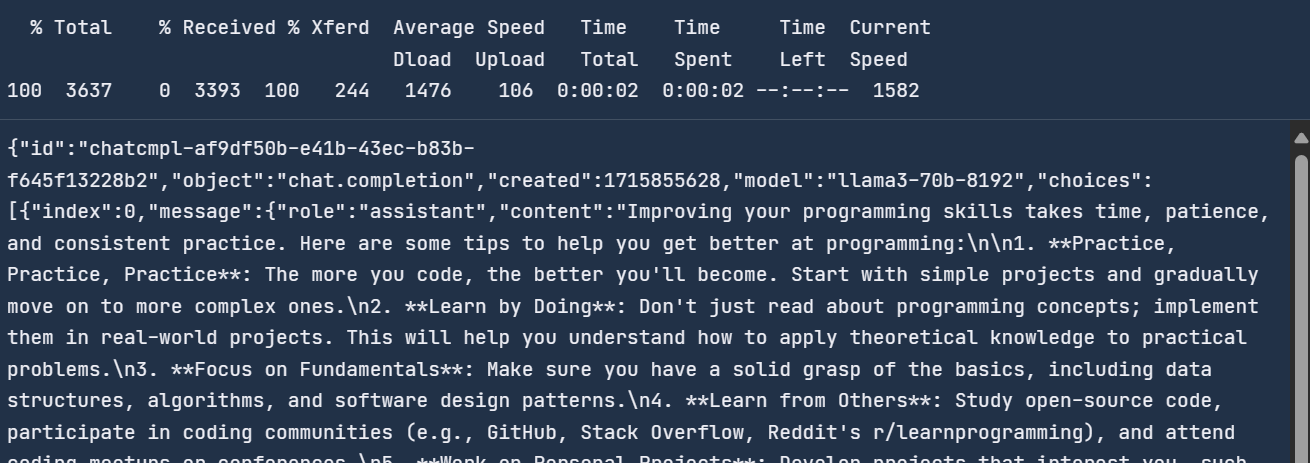
Con Groq ottieni una generazione della risposta in tempo reale, cruciale per alcune applicazioni.
Groq Cloud include un AI playground dove puoi testare tutti i modelli e le API che puoi utilizzare per creare prodotti e applicazioni AI.
Per accedere a Groq Cloud, devi prima creare un account accedendo a questo link.
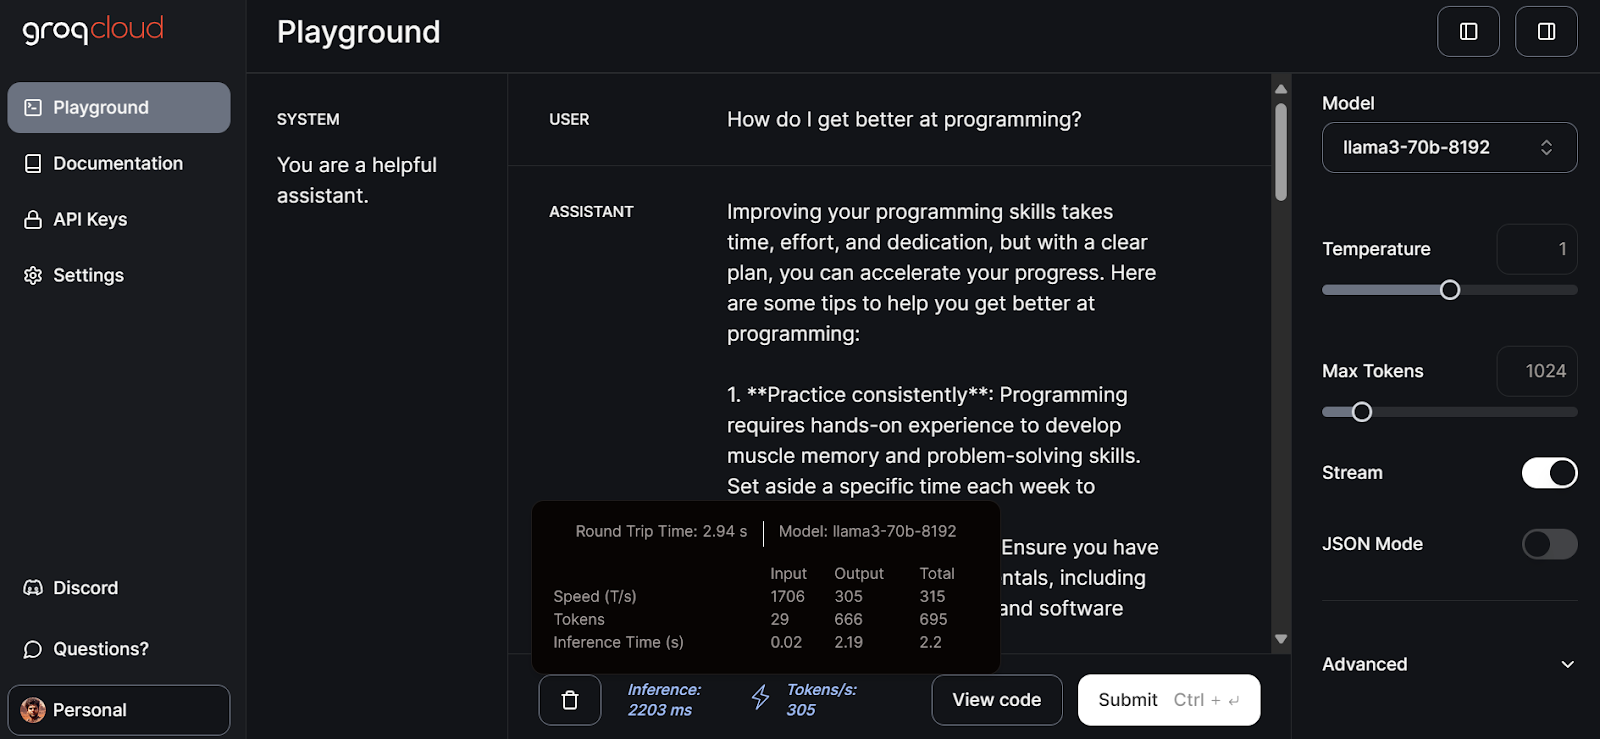
Dopodiché, fai clic sulla scheda playground nel pannello di sinistra, seleziona il modello llama3-70b-8192 e inizia a scrivere i prompt nel campo USER.
Ci sono voluti 2,94 secondi per generare la risposta completa con una velocità di 305 token al secondo. Questa è una prestazione di picco che non otterremo da ChatGPT.
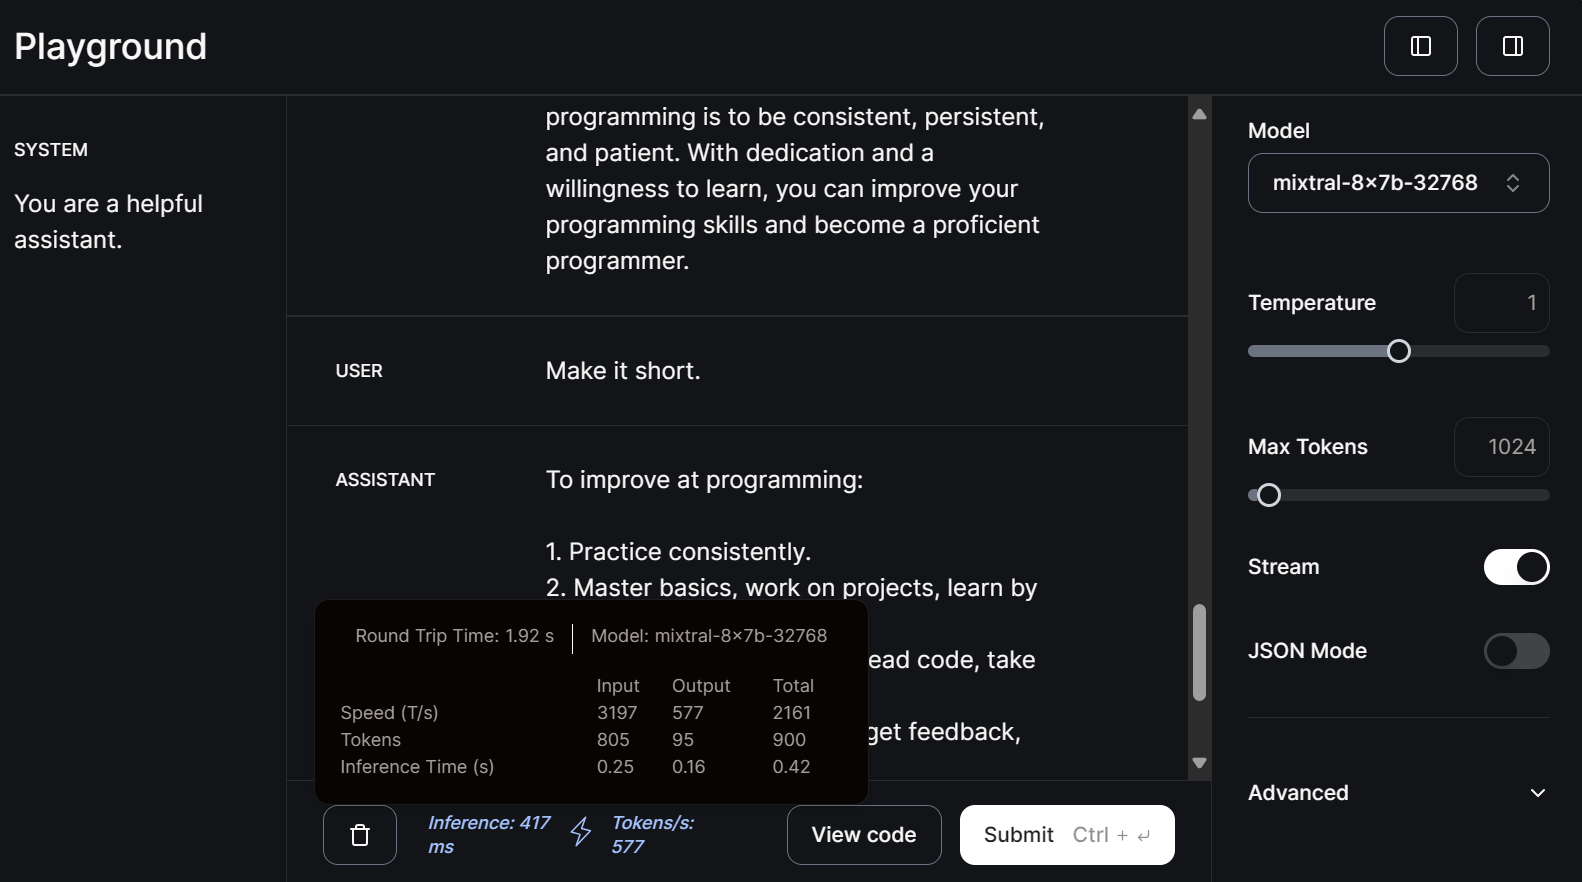
Selezioniamo ora il modello piccolo mitral-8x7b-32768 e scriviamo il prompt di follow-up.
I modelli più piccoli sono ancora più veloci nel generare risposte con una velocità di 577 token al secondo.
Puoi leggere questo tutorial su Classificazione LLM: come scegliere il miglior LLM per la tua applicazione per conoscere le opzioni disponibili e i fattori da considerare nella scelta.
Per accedere agli LLM Groq in locale, dobbiamo generare una chiave API andando alla scheda API Keys e facendo clic sul pulsante Create API Key.
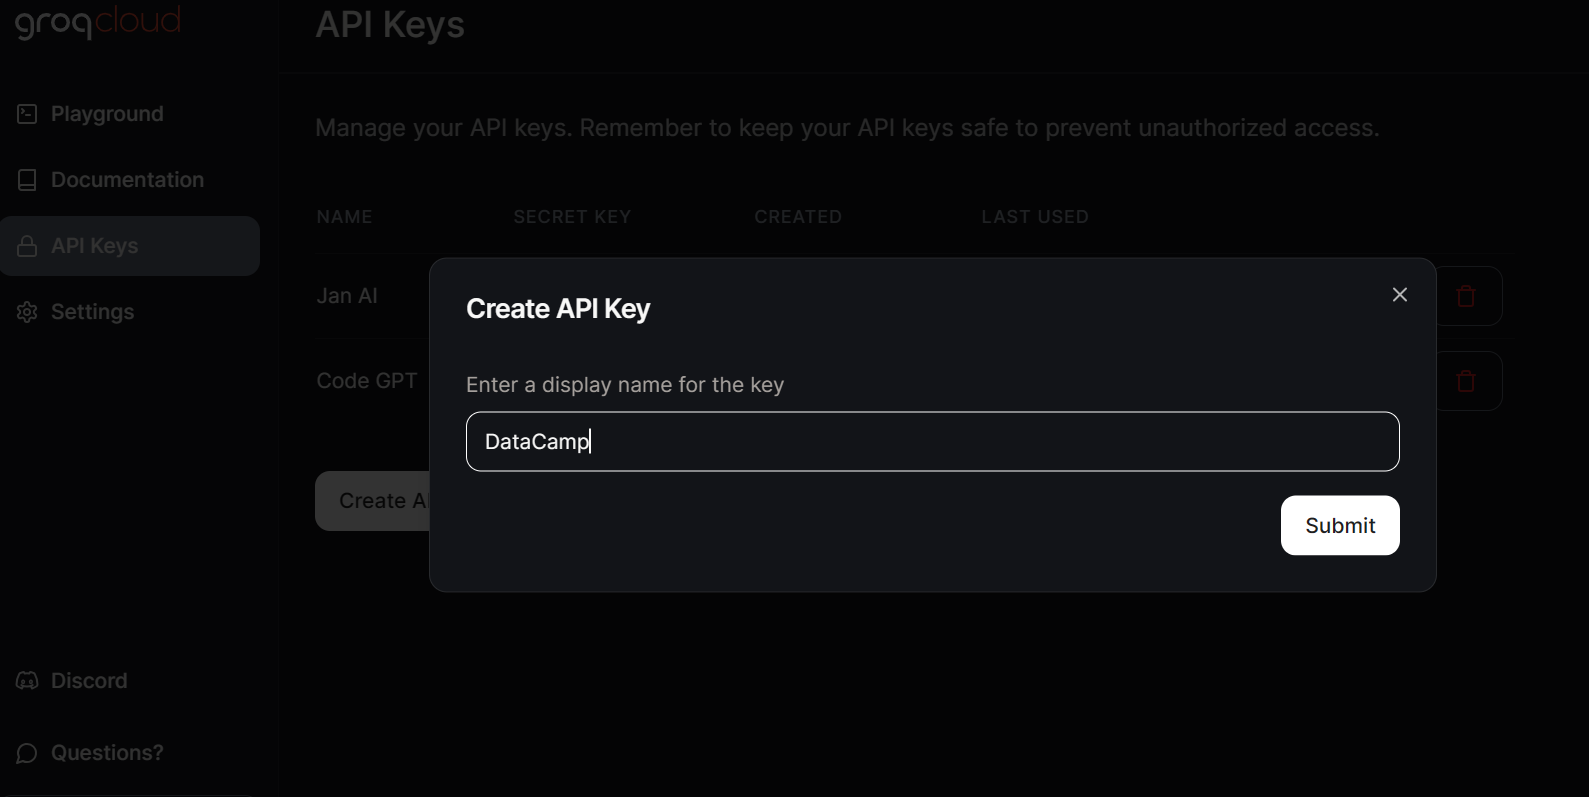
Jan AI ci permette di usare gli LLM in locale—sia modelli open source sia proprietari. Supporta provider di modelli come OpenAI, Anthropic, Cohere, MistralAI e Groq.
Scaricheremo e installeremo Jan AI andando sul sito ufficiale. Poi possiamo avviare l'applicazione.
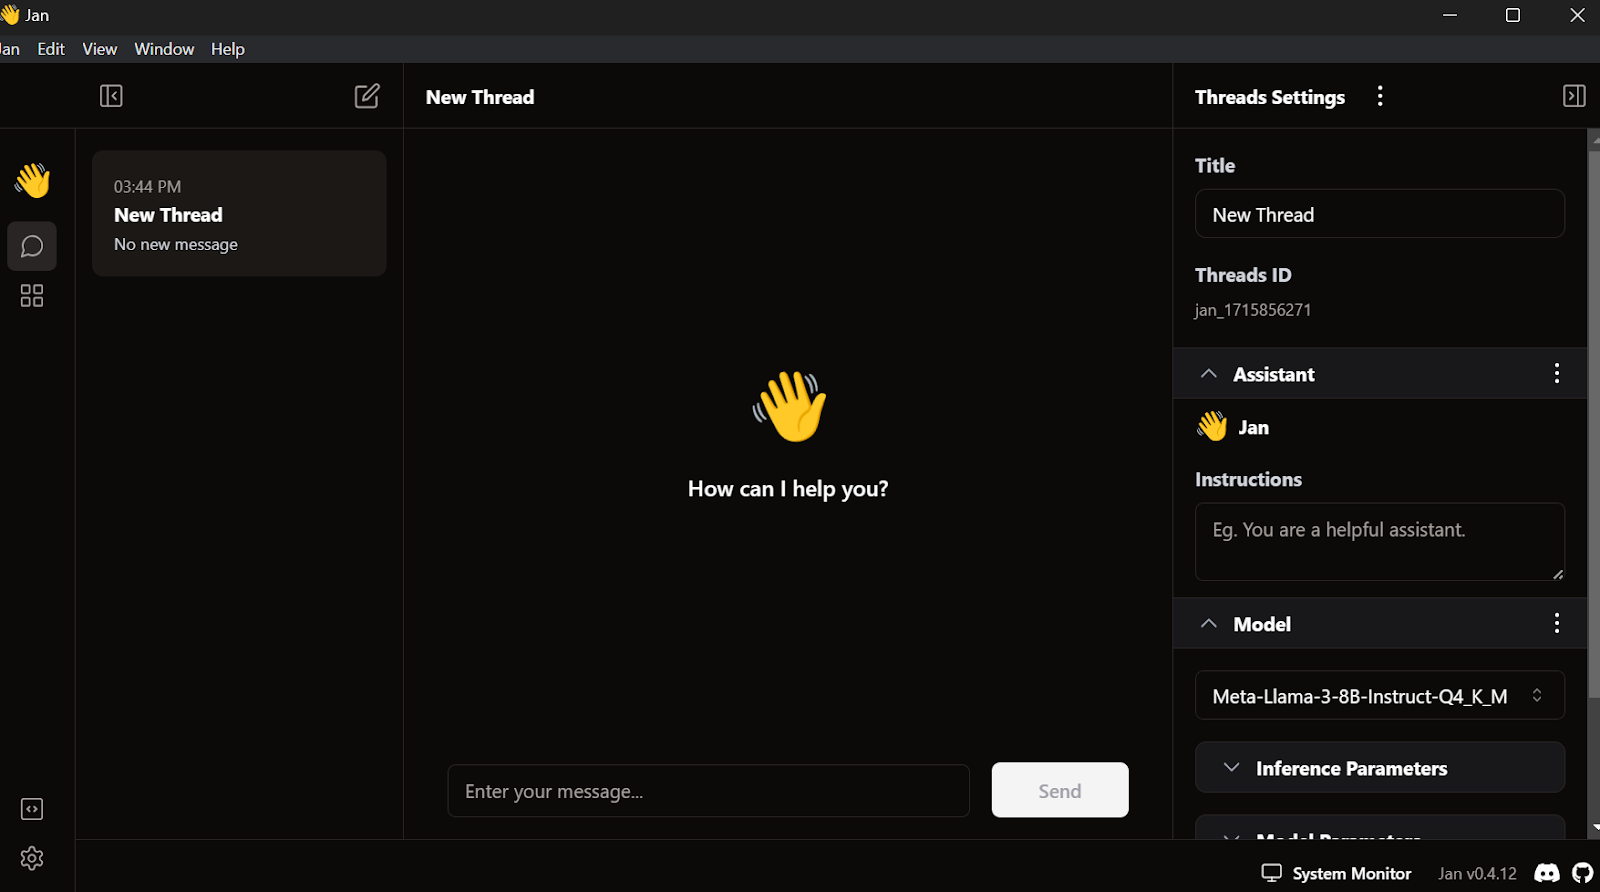
Vai alle impostazioni, seleziona la scheda Groq Inference Engine e incolla la chiave API che abbiamo appena creato.
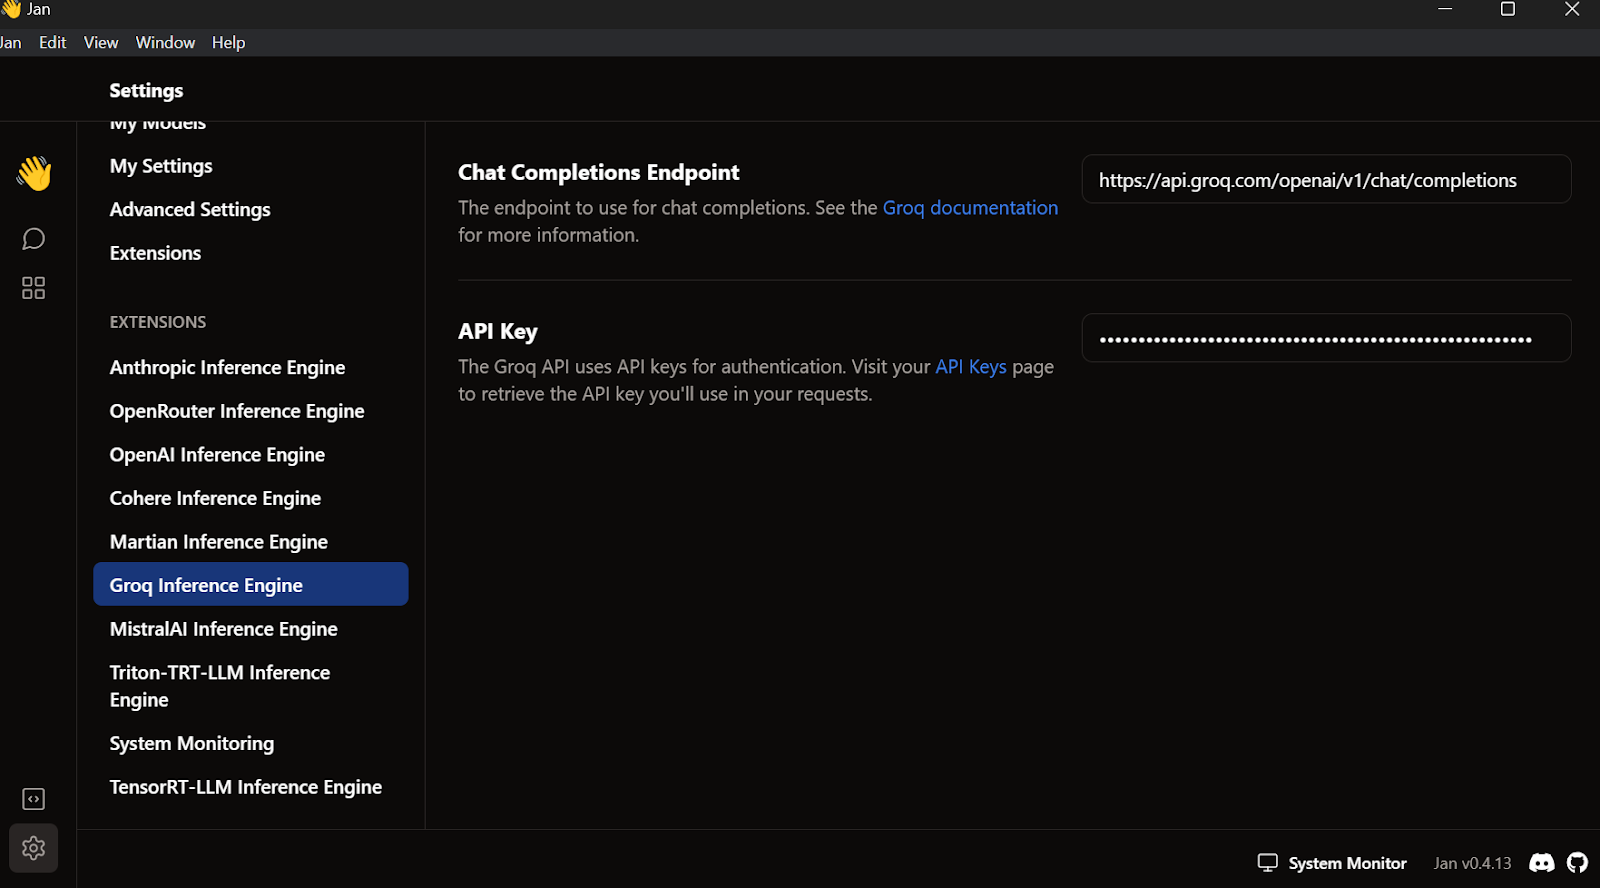
Esci dal menu delle impostazioni, vai su Thread e seleziona il modello Groq Llama 3 70b.
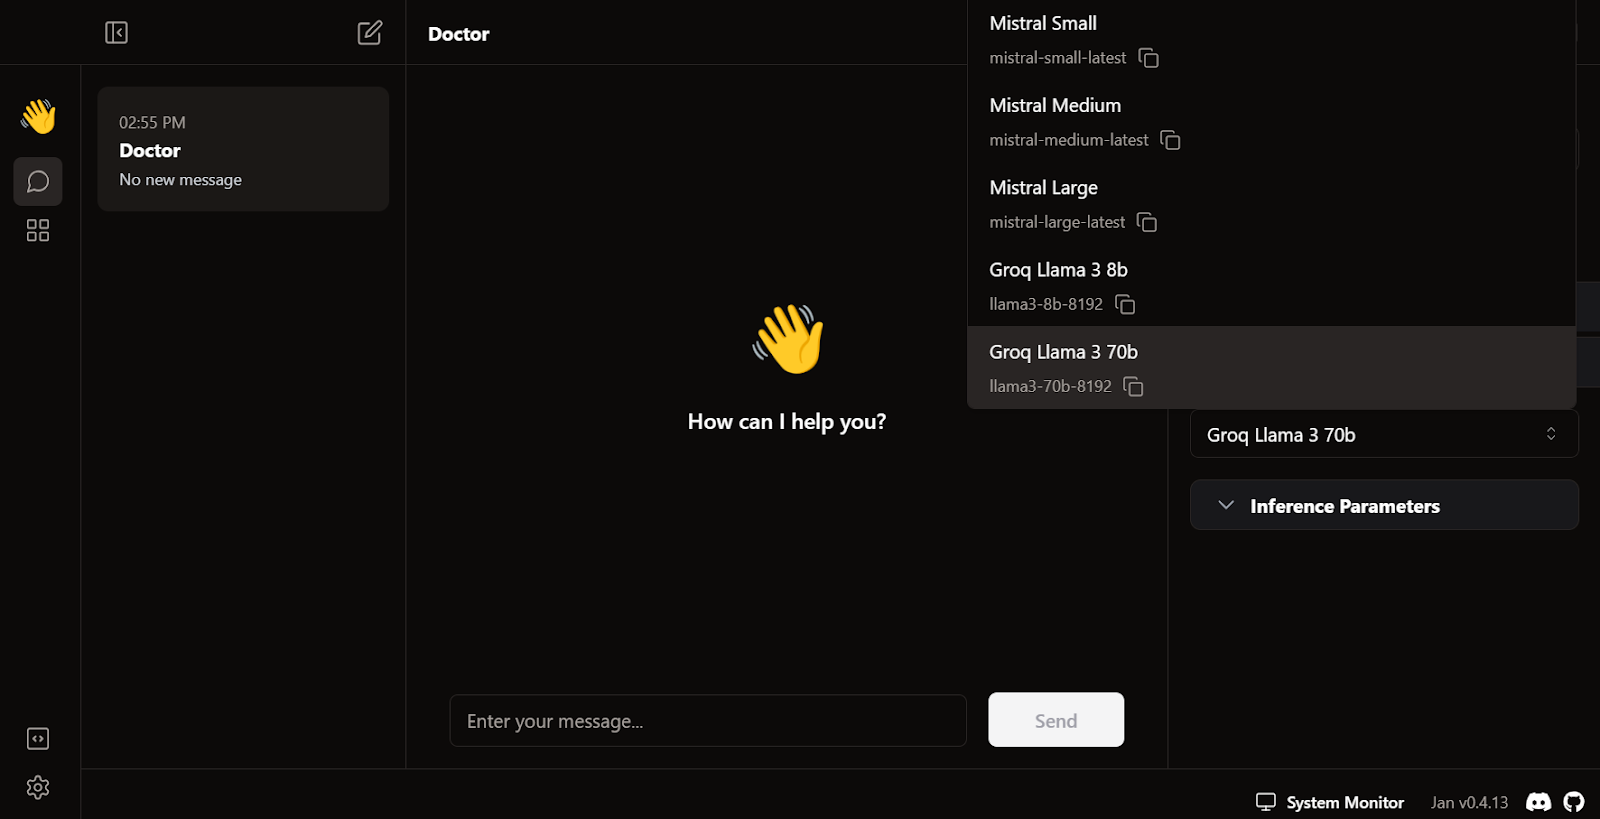
Scrivi una domanda o un prompt per generare la risposta in tempo reale:
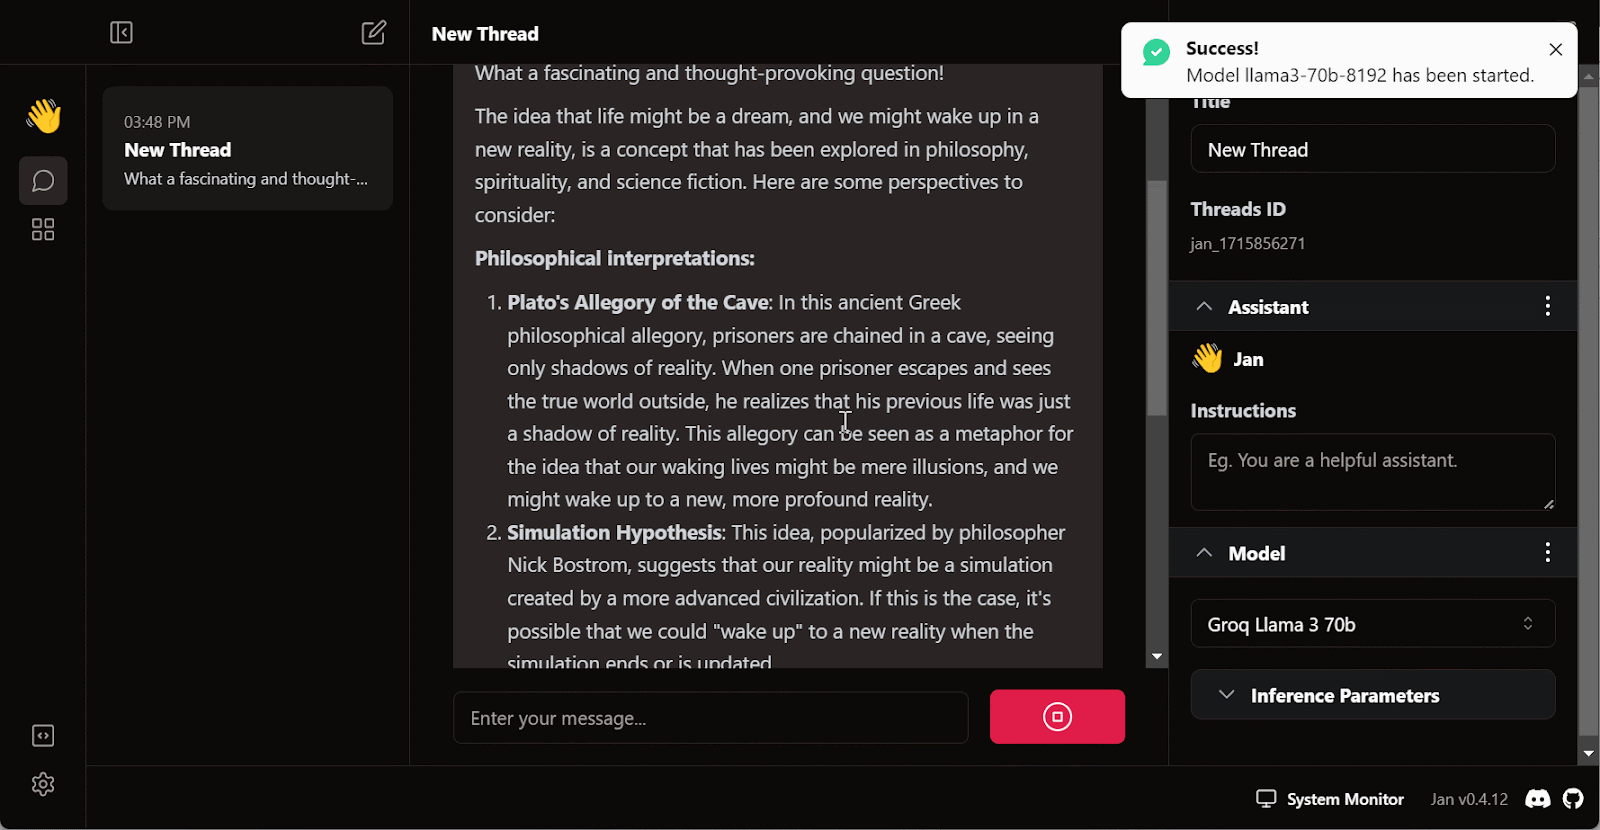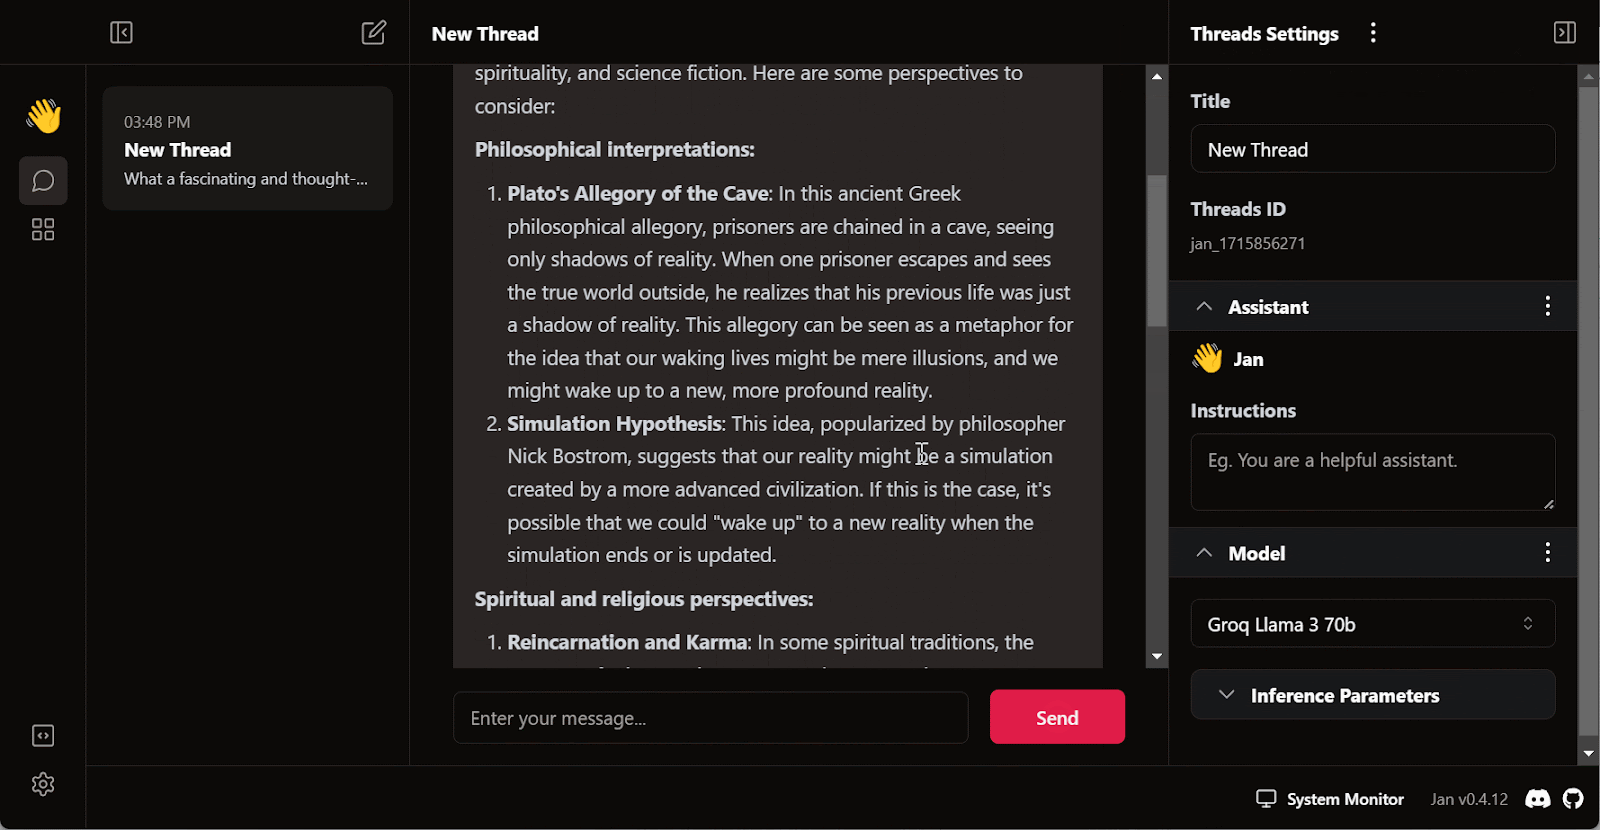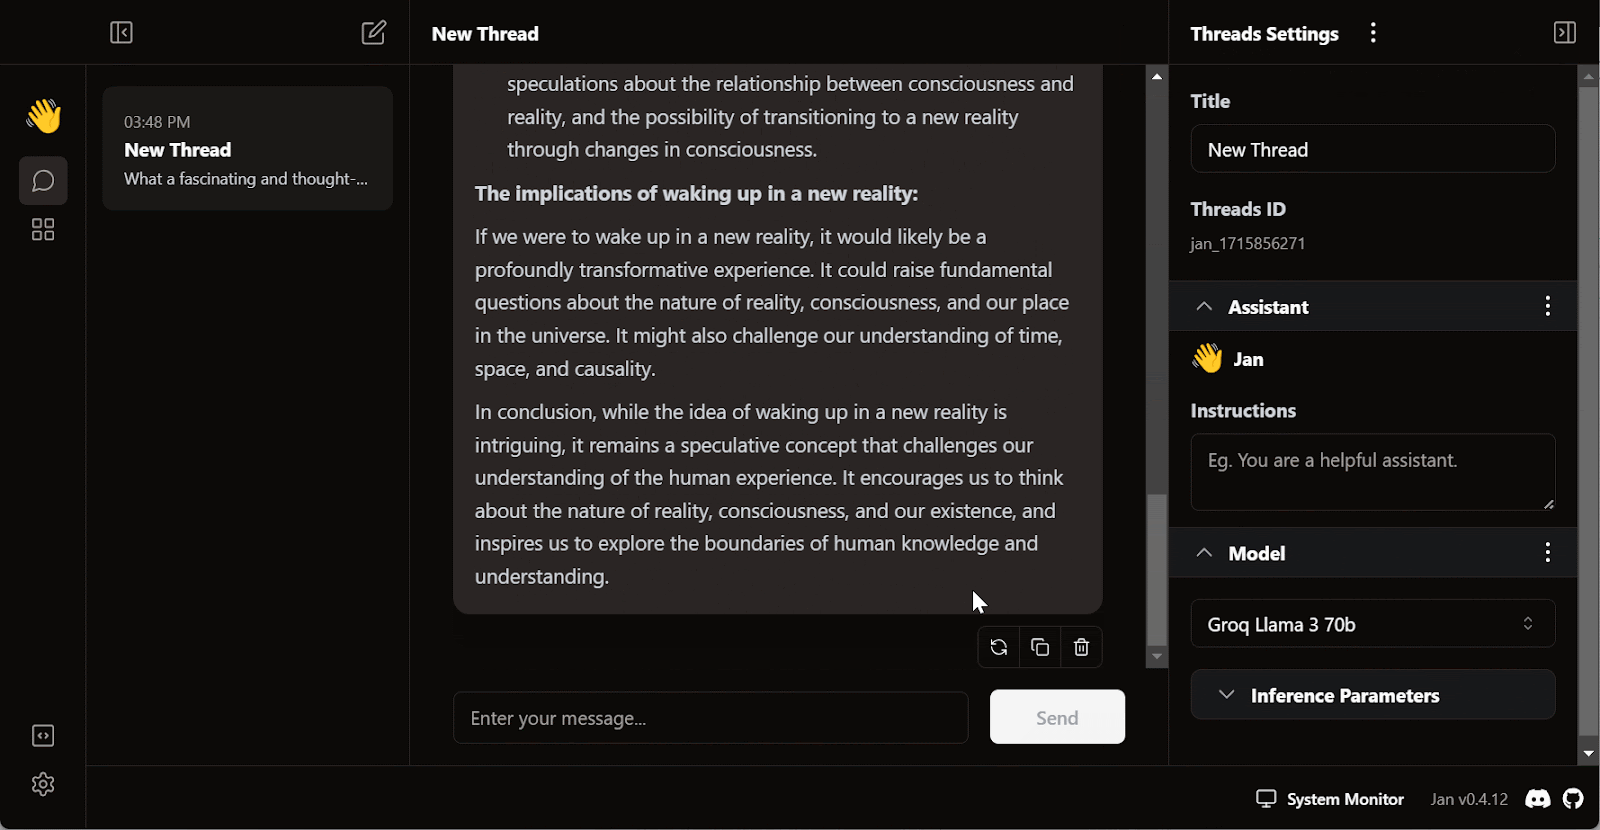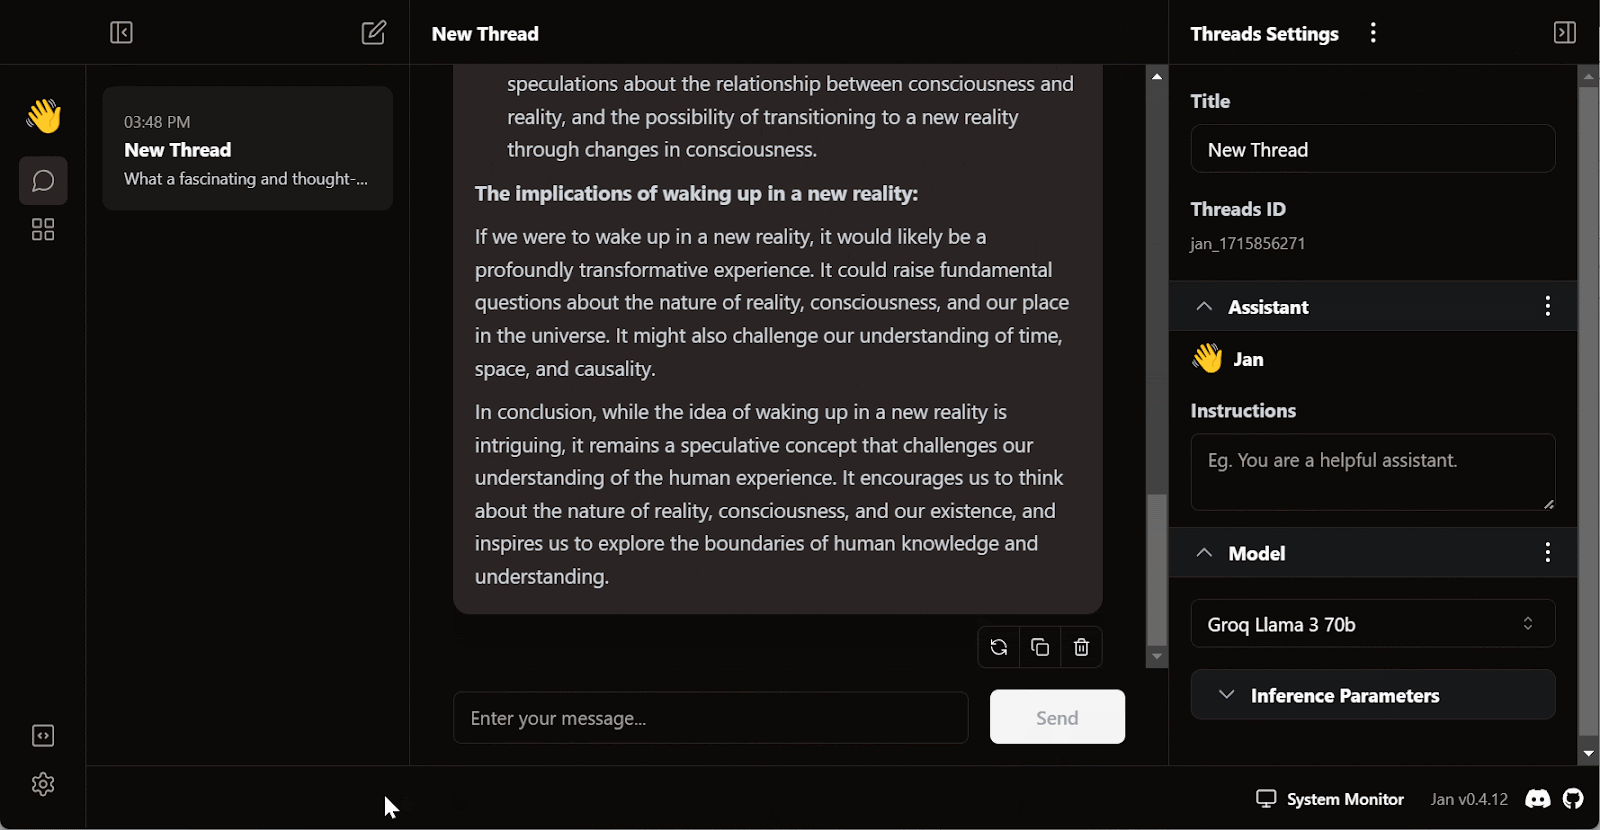
L'abbonamento gratuito a Groq Cloud prevede alcune limitazioni di rate. Ad esempio, il piano llama3-70b-8192 consente 30 richieste al minuto, 14.400 richieste al giorno e 6.000 token al minuto. Sebbene queste limitazioni siano generose, se intendi creare una vera applicazione AI utilizzando la Groq API, potresti valutare l'upgrade al pacchetto On Demand o Enterprise.
Puoi leggere questo tutorial su eseguire gli LLM in locale per esplorare sette modi semplici per far girare applicazioni AI in locale.
Oltre a usare la Groq API in un'applicazione chatbot, possiamo anche integrarla in VSCode tramite l'estensione CodeGPT. Sarà il nostro assistente di coding AI super veloce.
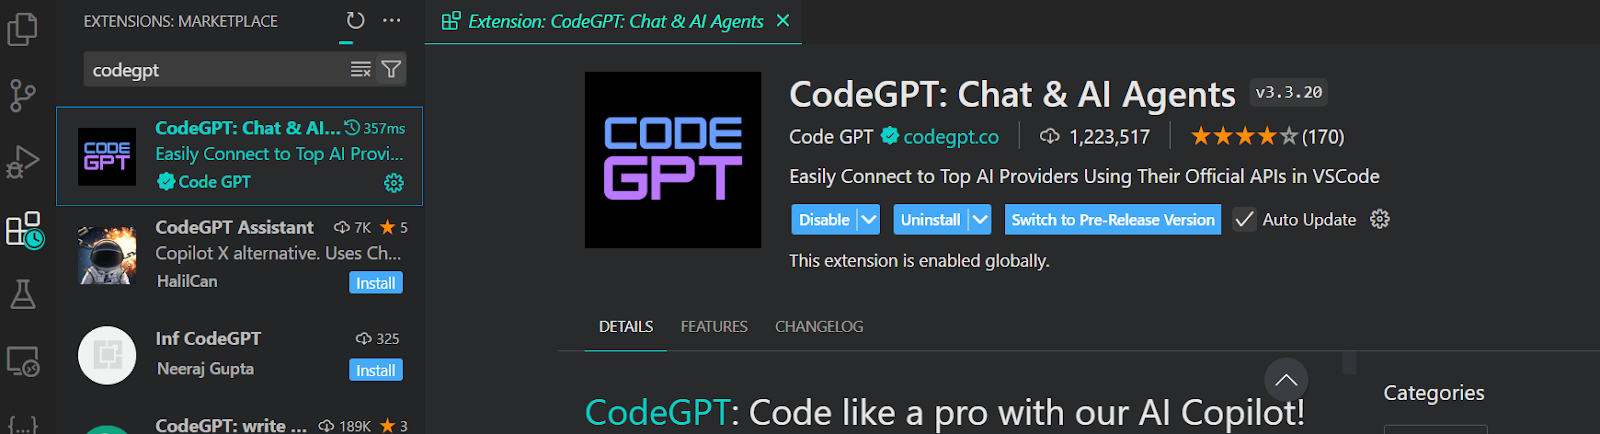
Per accedere al modello Groq in VSCode, dobbiamo installare l'estensione CodeGPT dallo store delle estensioni.
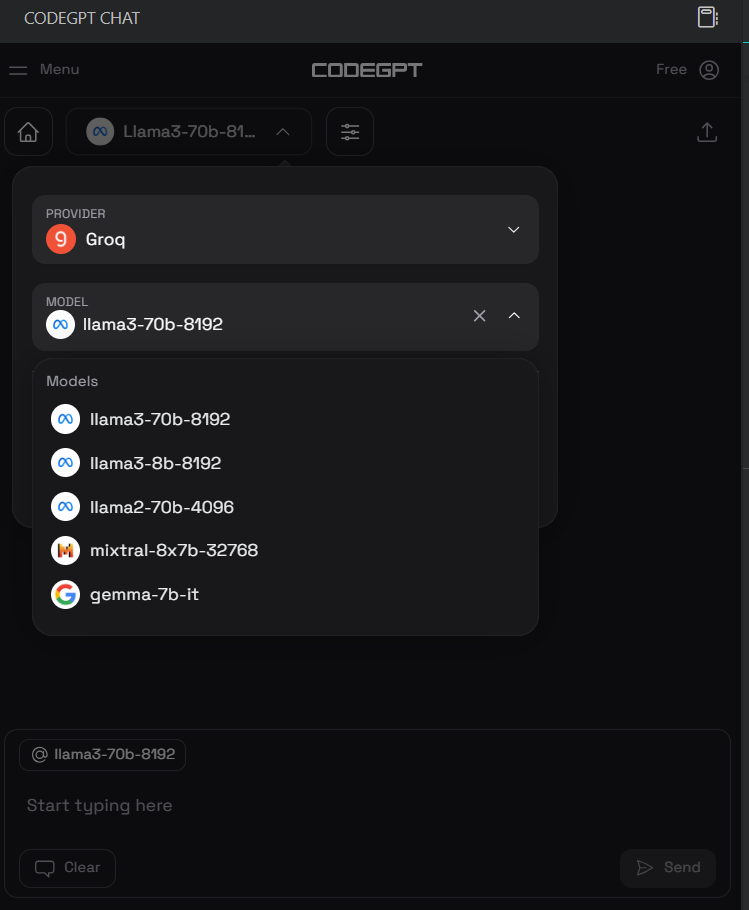
Una volta installata, imposteremo la chiave API di Groq facendo clic sull'icona della chat di CodeGPT nel pannello di sinistra e selezionando il provider e il modello. Abbiamo selezionato Groq come provider e llama3-70b-8192 come modello.
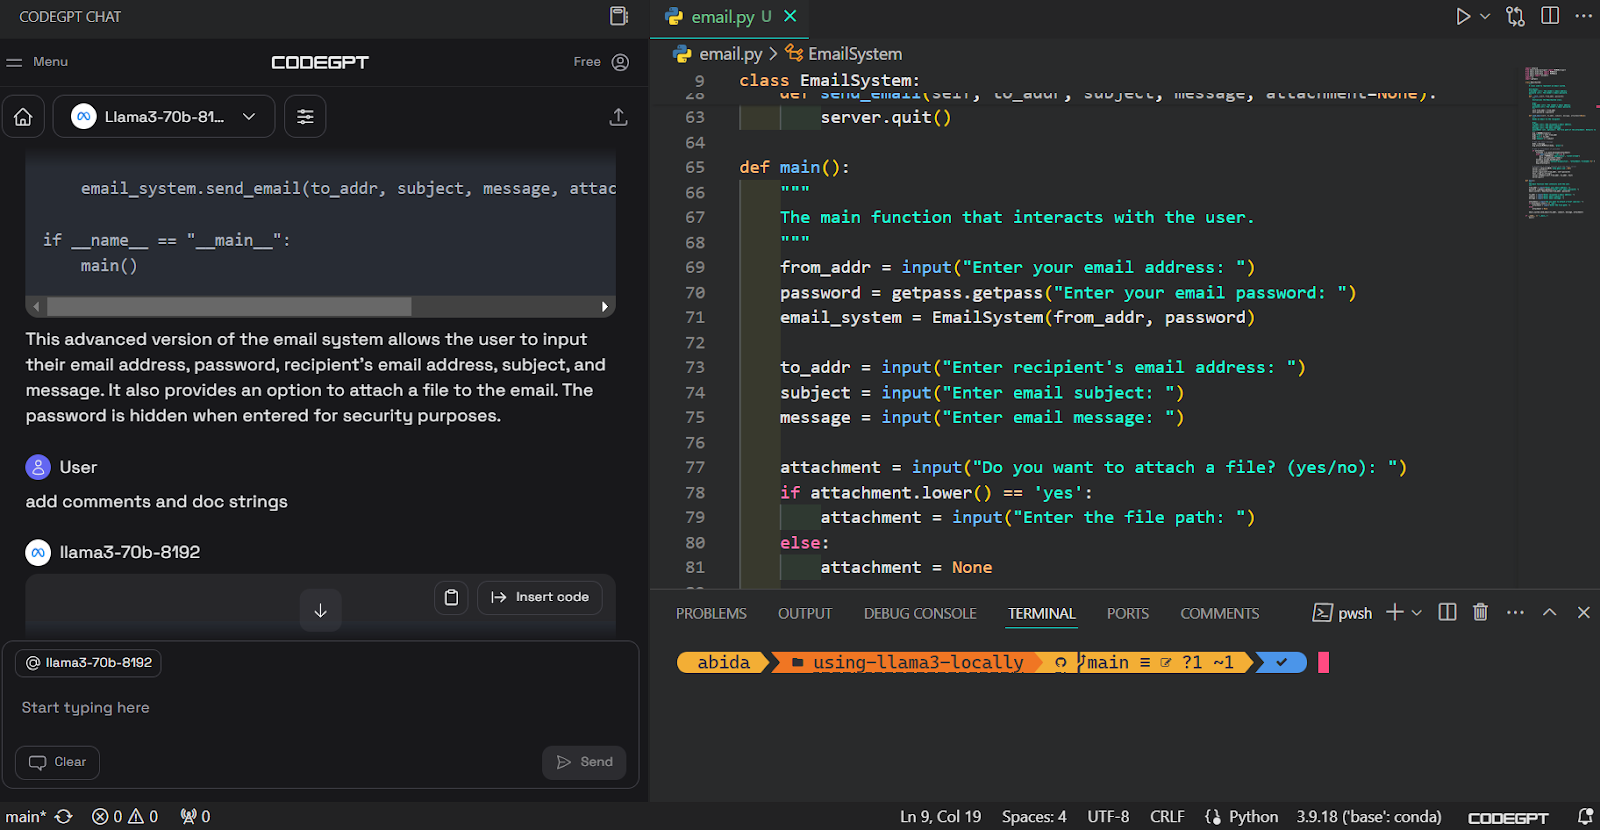
Dopodiché possiamo scrivere un prompt nella chat e generare il codice. Ci sono bastati pochi secondi per generare il codice giusto e costruire il sistema di email.
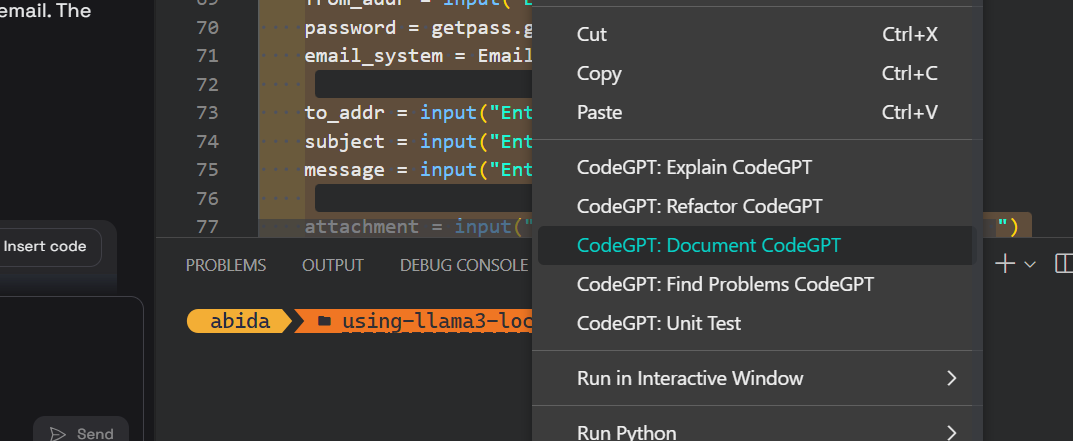
Possiamo poi documentare il codice, fare refactoring e creare i test unitari con i comandi integrati.
Puoi saperne di più su VSCode leggendo questo tutorial su come configurare VSCode per Python.
In questa sezione impareremo le basi della Groq Python API e le sue funzionalità chiave come streaming e async chat completion.
Per questa guida usiamo il DataLab di DataCamp. DataLab è un Jupyter Notebook in AI Cloud con tantissime funzionalità per scrivere codice, fare analisi dei dati e condividere insight.
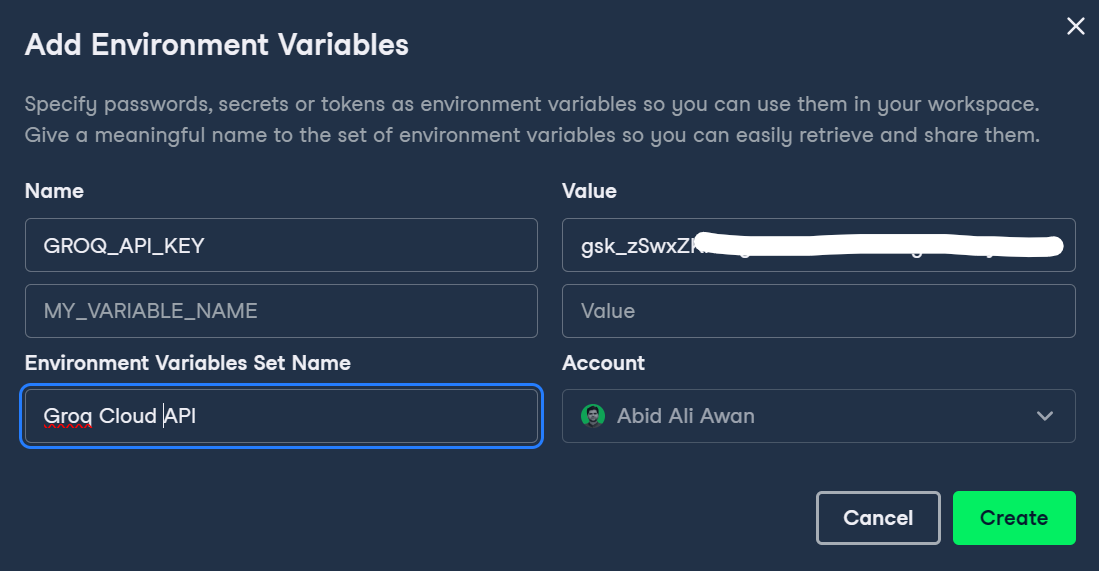
Per prima cosa dobbiamo impostare la chiave API di Groq in DataLab facendo clic sul pulsante Environment nel pannello di sinistra e aggiungendo la variabile d'ambiente tramite il pulsante più +.
Possiamo scrivere il nome della variabile e incollare la chiave API di Groq come mostrato di seguito.
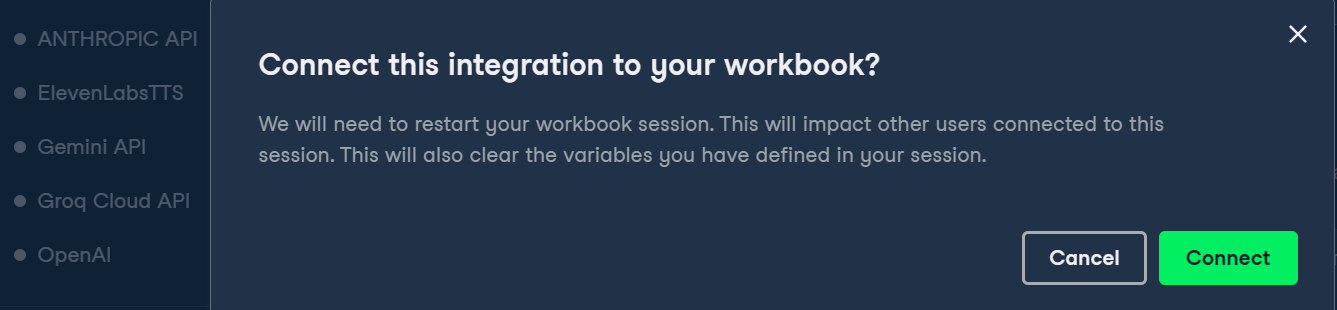
Poi possiamo attivare la variabile d'ambiente facendo clic sui tre puntini accanto alla variabile d'ambiente Groq e selezionando Connect.
Infine, installeremo il pacchetto Python di Groq usando il comando pip.
%pip install groq -qSe hai usato la Python API di OpenAI, potresti trovare simile la struttura del codice. Per eseguire una chat completion:
import os
from groq import Groq
from IPython.display import display, Markdown

client = Groq(
   api_key=os.environ.get("GROQ_API_KEY"),
)

chat_completion = client.chat.completions.create(
   messages=[
       {"role": "system", "content": "You are a professional Data Scientist."},
       {"role": "user", "content": "Can you explain how the neural networks work?"},
   ],
   model="llama3-70b-8192",)

Markdown(chat_completion.choices[0].message.content)
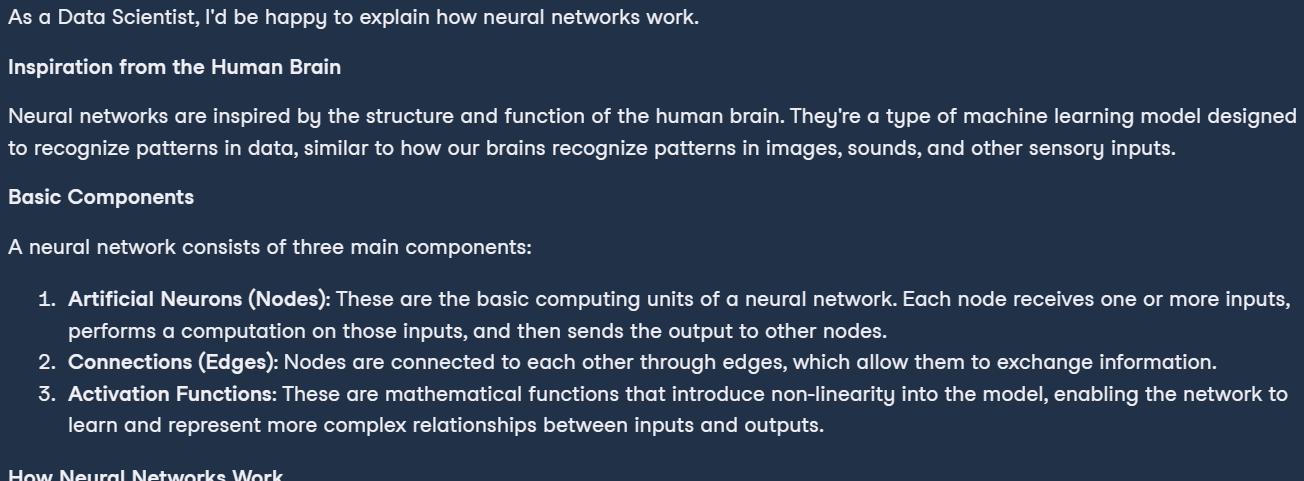
Come risultato, abbiamo una spiegazione perfettamente formattata di cosa sono le reti neurali.
Lo streaming negli LLM si riferisce all'elaborazione e generazione del testo un token alla volta, consentendo un uso efficiente della memoria e migliorando la velocità percepita dell'applicazione AI.
In questi esempi abbiamo abilitato lo streaming e personalizzato il modello modificando iperparametri come temperature, max_tokens e top_p.
chat_streaming = client.chat.completions.create(
    messages=[
       {"role": "system", "content": "You are a monk from Thailand."},
       {"role": "user", "content": "Can you explain the meaning of life?"},
    ],
    model="llama3-70b-8192",
    temperature=0.3,
    max_tokens=360,
    top_p=1,
    stop=None,
    stream=True,
)

for chunk in chat_streaming:
    print(chunk.choices[0].delta.content, end="")
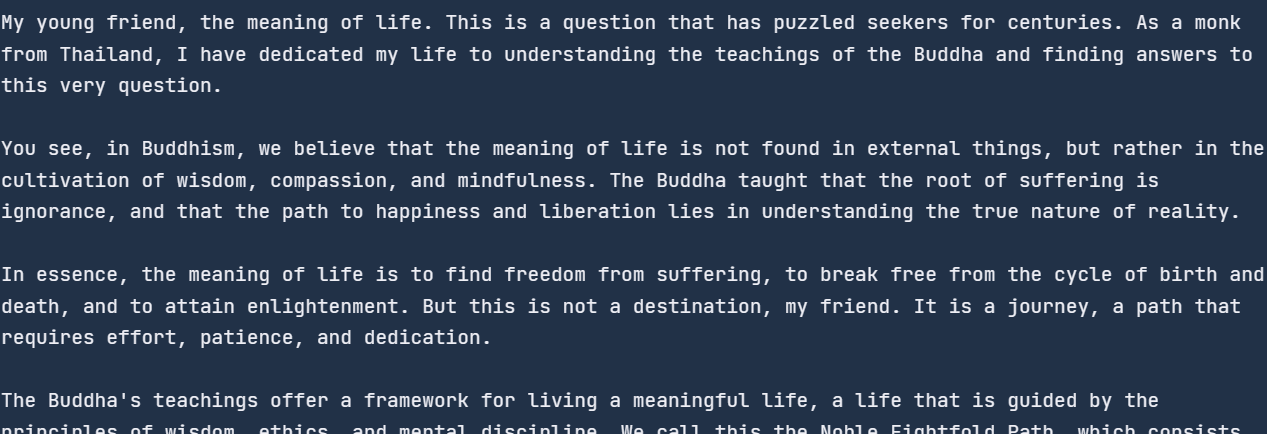
Di conseguenza, abbiamo iniziato a ricevere la risposta non appena abbiamo eseguito questo codice.
Le API asincrone permettono di gestire più richieste concorrenti senza bloccare, consentendo al sistema di elaborare e rispondere a ciascuna richiesta in modo indipendente. Questo approccio è più efficiente e scalabile, poiché può gestire un volume maggiore di richieste e fornire tempi di risposta più rapidi.
Per abilitare le chiamate API asincrone, dobbiamo cambiare la struttura del codice. In breve, noi:
Nota a margine: il codice qui sotto funziona su Jupyter Notebook, ma se stai eseguendo questo codice in un file Python, potresti dover sostituire l'ultima riga con asyncio.run(main()).
import asyncio
from groq import AsyncGroq

client = AsyncGroq(

    api_key=os.environ.get("GROQ_API_KEY"),

)

async def main():

   chat_completion = await client.chat.completions.create(
       messages=[            {"role": "system", "content": "You are a psychiatrist helping young minds"},
                  {                "role": "user",                "content": "I panicked during the test, even though I knew everything on the test paper.",            },
                ],
                model="llama3-70b-8192",
                temperature=0.3,
                max_tokens=360,
                top_p=1,
                stop=None,
                stream=False,
       )

       print(chat_completion.choices[0].message.content)

await main()  # for Python file use asyncio.run(main())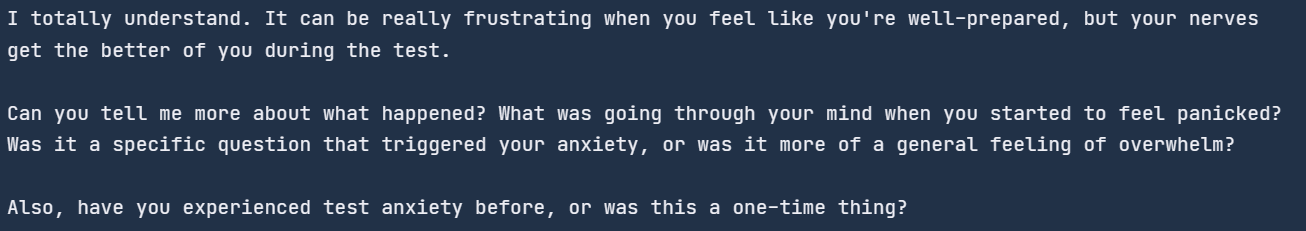
Possiamo anche effettuare lo streaming dell'API asincrona abilitando l'argomento stream nella funzione di chat completion e cambiando il modo in cui stampiamo i risultati. Stamperemo ogni chunk usando il ciclo for con il comando async.
import asyncio

from groq import AsyncGroq


client = AsyncGroq()

async def main():

    chat_streaming = await client.chat.completions.create(
        messages=[
           {"role": "system", "content": "You are a psychiatrist helping young minds"},
           {                "role": "user",                "content": "I panicked during the test, even though I knew everything on the test paper.",            },
        ],
        model="llama3-70b-8192",
        temperature=0.3,
        max_tokens=360,
        top_p=1,
        stop=None,
        stream=True,
     )
     async for chunk in chat_streaming:
            print(chunk.choices[0].delta.content, end="")

await main()  # for Python file use asyncio.run(main())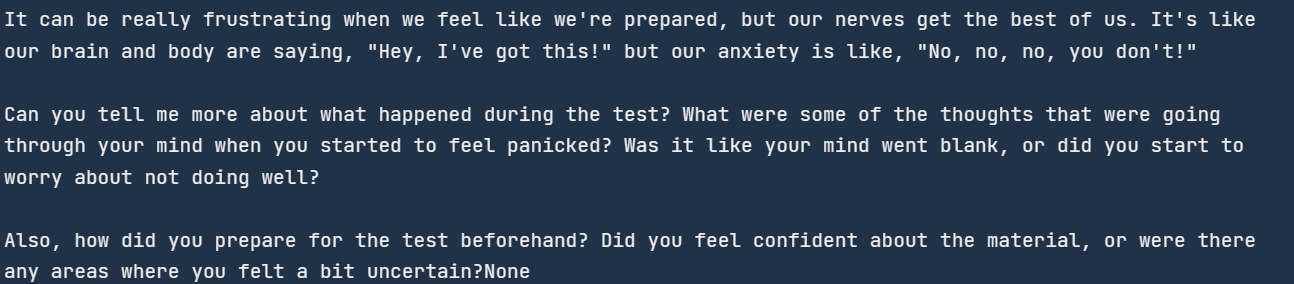
Se hai problemi a eseguire il codice, fai riferimento a questo notebook DataLab: Groq Cloud API.
In questa guida faremo un passo in più e impareremo a creare un'applicazione AI usando Groq API e LlamaIndex, un framework per LLM. Costruiremo un'applicazione che carica il testo da un file PDF, lo converte in embedding e lo salva nel vector store. Dopodiché, convertiremo il vector store in un retriever che verrà usato per costruire un motore di chat RAG con cronologia.
In breve, stiamo creando un'applicazione ChatPDF sensibile al contesto per aiutarti a comprendere il documento molto più rapidamente.
Per imparare come acquisire, gestire e recuperare dati privati e specifici del dominio usando il linguaggio naturale, dai un'occhiata a questo tutorial: LlamaIndex: un framework dati per i Large Language Model (LLM).
Per prima cosa installeremo tutti i pacchetti Python necessari usando pip. Usiamo la magic function %%capture per sopprimere i log.
%%capture
%pip install llama-index
%pip install llama-index-llms-groq
%pip install llama-index-embeddings-huggingfaceCreeremo il client LLM di Groq usando la funzione di llama_index. Il client LLM richiede un nome modello e la chiave API.
from llama_index.llms.groq import Groq
import os

llm =
Groq(model="llama3-70b-8192",api_key=os.environ.get("GROQ_API_KEY"))Ora scaricheremo e caricheremo il modello di embedding di Hugging Face usando la API di embedding di LlamaIndex.
Nel nostro caso, carichiamo il modello di embedding più popolare su Hugging Face chiamato mxbai-embed-large-v1.
from llama_index.embeddings.huggingface import HuggingFaceEmbedding

embed_model =
HuggingFaceEmbedding(model_name="mixedbread-ai/mxbai-embed-large-v1")LlamaIndex ci permette di impostare configurazioni globali, evitando la necessità di passare ovunque gli oggetti dell'LLM o del modello di embedding.
from llama_index.core import Settings

Settings.llm = llm
Settings.embed_model = embed_modelPer i dati, usiamo il post del blog 14 strumenti essenziali di Data Engineering da usare nel 2024 e lo convertiamo in PDF usando il comando di stampa.
Usando la funzione SimpleDirectoryReader, puoi caricare tutti i tipi di documenti dalla cartella. Basta fornire la directory della cartella e le estensioni di file richieste.
from llama_index.core import SimpleDirectoryReader

de_tools_blog = SimpleDirectoryReader("./",required_exts=[".pdf", ".docx"]).load_data()VectorStoreIndex fornisce il modo più veloce per creare il vector store caricando i documenti e costruendo l'indice. L'indice può essere usato per motori di query, retriever e pipeline di query.
Nel nostro caso, creiamo l'indice fornendo i documenti al vector store, che convertirà il testo in embedding e poi lo salverà nel vector store.
Dopodiché, convertiremo l'indice in un motore di query per eseguire il RAG (retrieval augmented generation) di base, che combina il recupero e i modelli AI per generare una risposta sensibile al contesto.
from llama_index.core import VectorStoreIndex

index = VectorStoreIndex.from_documents(de_tools_blog)
query_engine = index.as_query_engine(similarity_top_k=3)

response = query_engine.query("How many tools are there?")
print(response)
Ora creeremo il motore di chat RAG con cronologia. Aggiungere la cronologia consentirà al motore di ricordare sia i messaggi dell'utente sia le risposte generate e fornire risposte contestualizzate.
Per costruire questa applicazione, creeremo un ChatMemoryBuffer da 3900 token e lo forniremo al motore di chat insieme al retriever e all'oggetto LLM.
Quando poni una domanda, il motore di chat userà il documento PDF e i messaggi precedenti come contesto e risponderà di conseguenza.
from llama_index.core.memory import ChatMemoryBuffer
from llama_index.core.chat_engine import CondensePlusContextChatEngine

memory = ChatMemoryBuffer.from_defaults(token_limit=3900)

chat_engine = CondensePlusContextChatEngine.from_defaults(
   index.as_retriever(),
   memory=memory,
   llm=llm
)

response = chat_engine.chat(
   "What tools are suitable for data processing?"
)
print(str(response))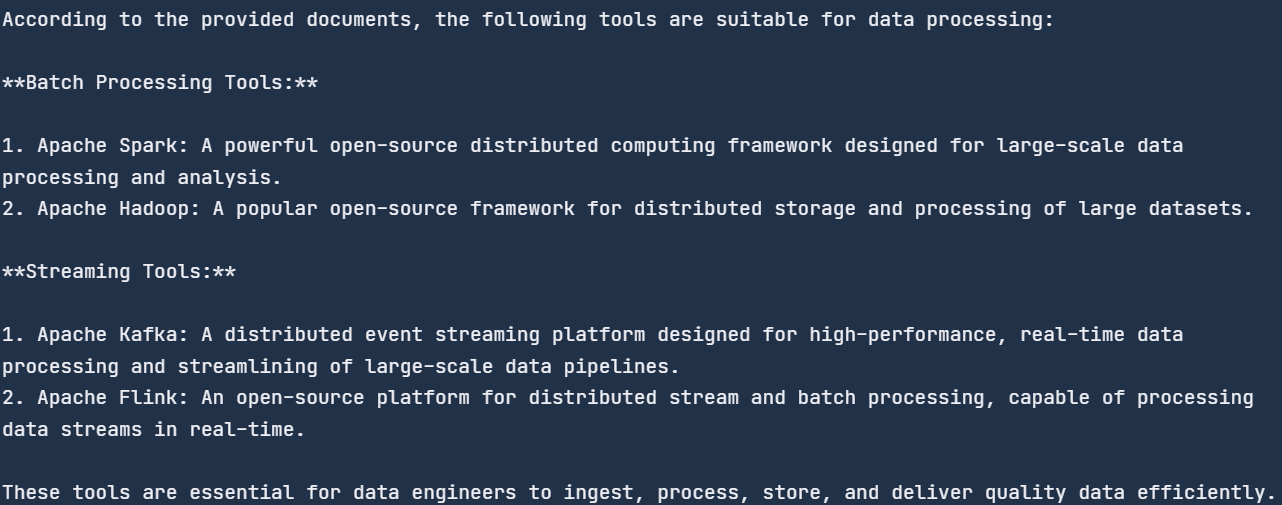
Abbiamo posto domande generiche e ha cercato nel documento gli strumenti per l'elaborazione dei dati, fornendoci l'elenco. Tutti gli strumenti sono citati nel post del blog.
Facciamo una domanda di follow-up per testare la parte di memoria del motore di chat.
response = chat_engine.chat(
    "Can you create a diagram of a data pipeline using these tools?"
)
print(str(response))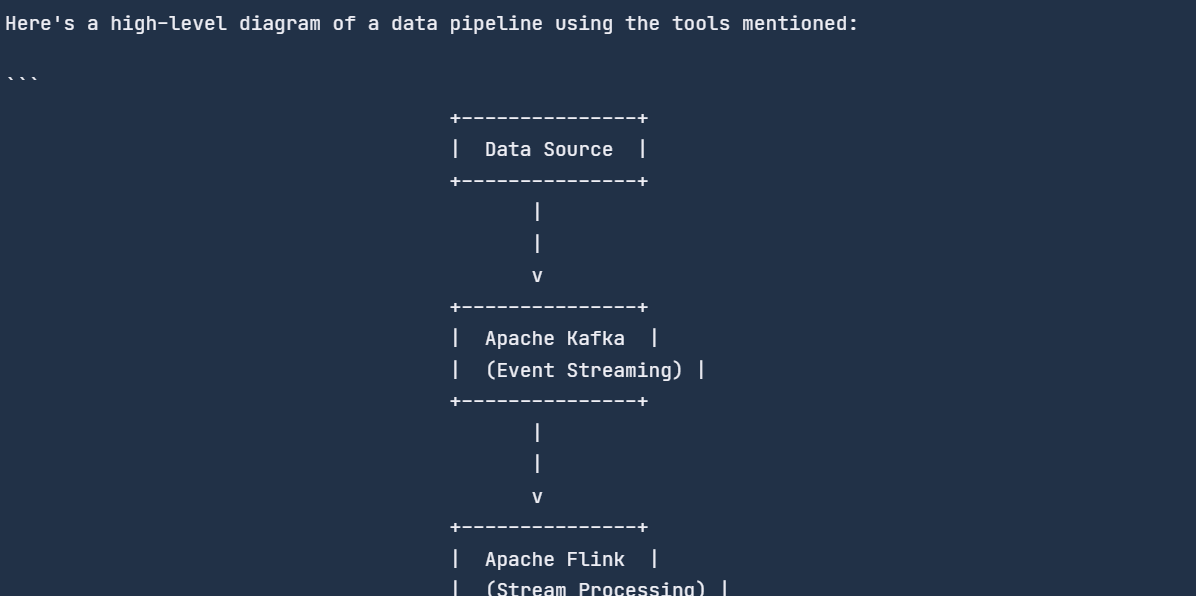
Il motore di chat ha ricordato la conversazione precedente e ha risposto di conseguenza.
Tutto il codice usato è disponibile in questo notebook DataLab: Groq Cloud API — DataLab.
Il motore di inferenza Groq LPU è un punto di svolta nell'AI. Mentre i grandi player come OpenAI e Google si concentrano sullo sviluppo di LLM di alta qualità, Groq rende questi modelli più veloci. Pur essendo nuovo sulla scena dell'AI, Groq sta facendo parlare molto di sé nella community.
In questo blog, abbiamo conosciuto il motore di inferenza Groq LPU, esplorato Groq Cloud e integrato la Groq API in VSCode e nell'applicazione Jan AI. Inoltre, abbiamo approfondito il pacchetto Python di Groq con esempi di codice e imparato a costruire un'applicazione AI sensibile al contesto che può apprendere dalla cronologia della chat e dai documenti PDF.
Un possibile prossimo passo nel tuo percorso di apprendimento è il fine-tuning degli LLM su un dataset personalizzato. Puoi imparare come farlo seguendo questo tutorial: Fine-tuning di Google Gemma: migliorare gli LLM con istruzioni personalizzate.
Impara con DataCamp
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



