
Cursus
Generatieve AI-concepten
2 uur
119.7K
Als je weleens gefrustreerd raakte door het wachten op een reactie van ChatGPT, dan word je vast blij van de Groq Language Processing Unit (LPU) Inference Engine.
Met Groq krijg je razendsnel antwoord op je vragen: de wachttijd gaat van 40 seconden naar slechts 2 seconden.
In deze tutorial:
Ben je nieuw met large language models (LLM's)? Volg dan de skill track Developing Large Language Models om de basis te leren van finetunen en het bouwen van je eigen model vanaf nul.
De LPU (language processing unit) Inference Engine van Groq is een nieuw verwerkingssysteem dat computationeel intensieve taken met sequentiële componenten afhandelt, met name bij het genereren van antwoorden voor large language models. Deze innovatieve technologie verandert hoe we tekst verwerken en genereren, met ongeëvenaarde prestaties en precisie.
Vergeleken met de traditionele centrale processor (CPU) en grafische processor (GPU) heeft de LPU een grotere rekencapaciteit. Daardoor wordt de tijd om een woord te voorspellen aanzienlijk verkort en kunnen tekstsequenties veel sneller worden gegenereerd. Bovendien pakt de LPU geheugenknelpunten aan, een veelvoorkomende beperking van GPU's bij LLM's.
Groq heeft de LPU ontworpen om uitdagingen aan te pakken zoals compute-dichtheid, geheugenbandbreedte, lage latentie en hoge doorvoer. Het levert prestatiewinsten die GPU en TPU (tensor processing unit) overtreffen. Zo kan de LPU meer dan 310 tokens per seconde per gebruiker genereren op Llama-3 70B.
Lees meer over de LPU-architectuur in het officiële onderzoeksartikel Groq ISCA 2022 Paper.
Op dit moment hebben we alleen toegang tot Groq LLM's via groq.com, de Groq Cloud API, de Groq Playground en platforms van derden zoals Poe.
In deze sectie bekijken we de functies en modellen van OpenAI en Groq Cloud. Daarnaast testen we de snelheid van API-calls met CURL en vergelijken we de API-designs.
De OpenAI API biedt een breed scala aan functies en modellen. Je krijgt onder meer:
De OpenAI API is snel en wordt in de loop van de tijd goedkoper.
We kunnen het nieuwste OpenAI-model aanroepen met de volgende opdracht in de terminal. De API vereist de API-sleutel van OpenAI, de modelnaam en messages met de systeemprompt en gebruikersvraag.
curl -X POST https://api.openai.com/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -d '{
    "model": "gpt-4o",
    "messages": [
      {        "role": "system",
        "content": "You are a helpful assistant."
      },
      {
        "role": "user",
        "content": "How do I get better at programming?"
      }
    ]
  }'
Het duurde 13 seconden om het verzoek te voltooien.
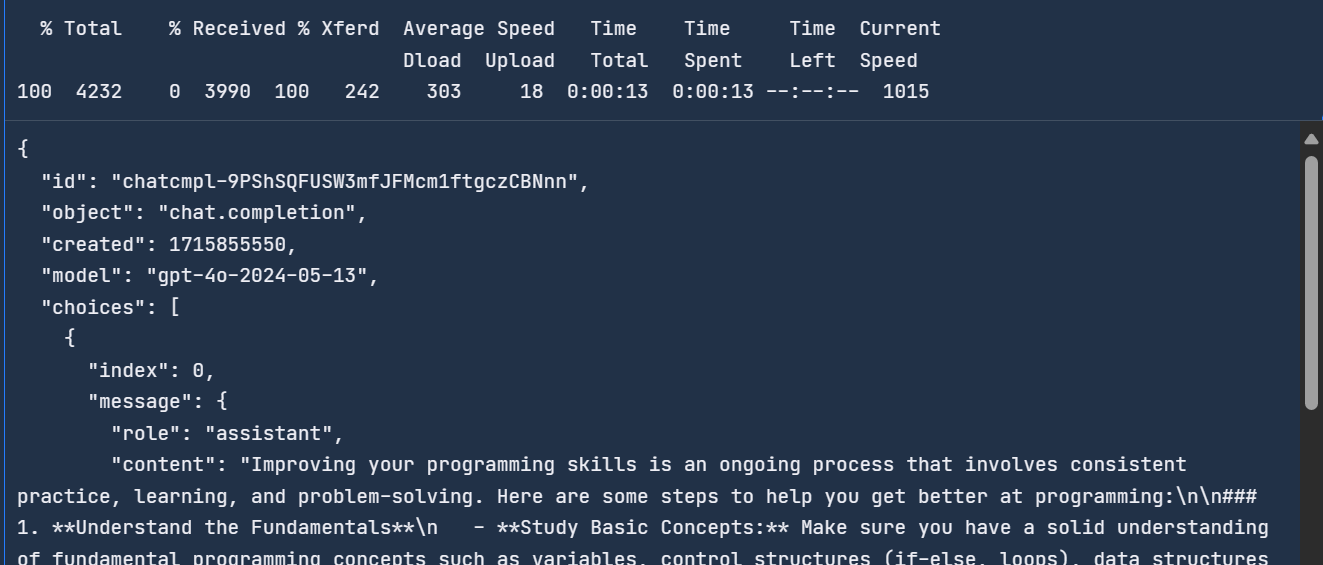
Wil je meer weten over de OpenAI API en functies? Bekijk dan deze Beginner's Guide to The OpenAI API: Hands-On Tutorial and Best Practices.
Groq is nieuw in de AI-industrie en biedt momenteel beperkte functies en modellen. Je krijgt onder meer:
De Groq Cloud API reageert sneller dan de OpenAI API. Om dat te testen, gebruiken we de CURL-opdracht in de terminal en geven we hetzelfde bericht mee aan de Groq API.
De Groq API lijkt op de OpenAI API; het enige verschil is de URL.
curl -X POST "https://api.groq.com/openai/v1/chat/completions" \
    -H "Authorization: Bearer $GROQ_API_KEY" \
    -H "Content-Type: application/json" \
    -d '{"messages": [
     {
       "role": "system",
       "content": "You are a helpful assistant."
     },
     {        "role": "user",
       "content": "How do I get better at programming?"
     }
   ],
   "model": "llama3-70b-8192"}'
Het antwoord kwam in twee seconden binnen, vergeleken met de OpenAI API, en is daarmee 6,5 keer sneller.
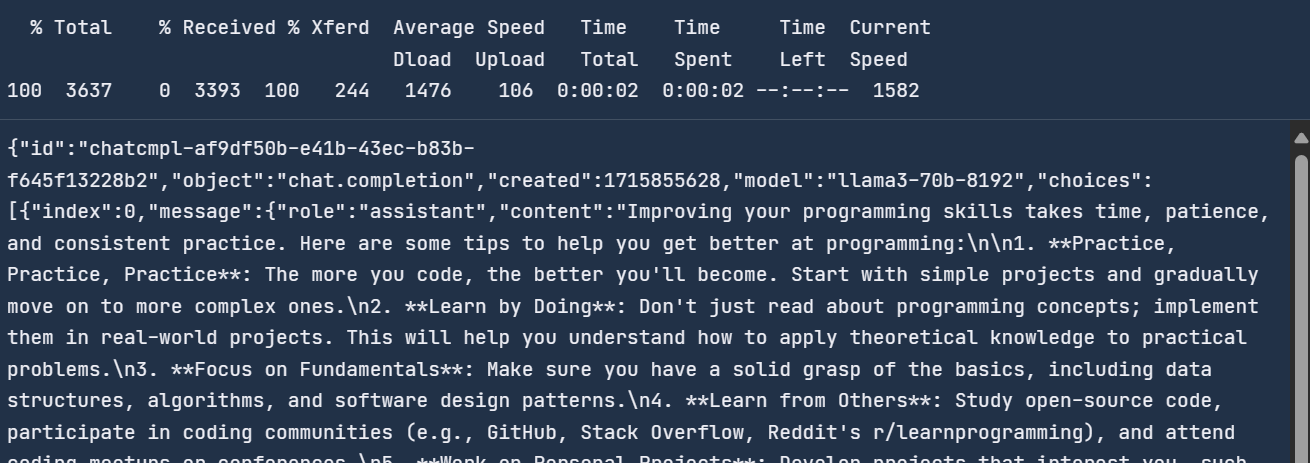
Met Groq krijg je realtime generatie van antwoorden, wat cruciaal is voor sommige toepassingen.
Groq Cloud heeft een AI playground waar je alle modellen en API's kunt testen die je kunt gebruiken om AI-producten en -applicaties te bouwen.
Om toegang te krijgen tot Groq Cloud moet je eerst een account aanmaken via deze link.
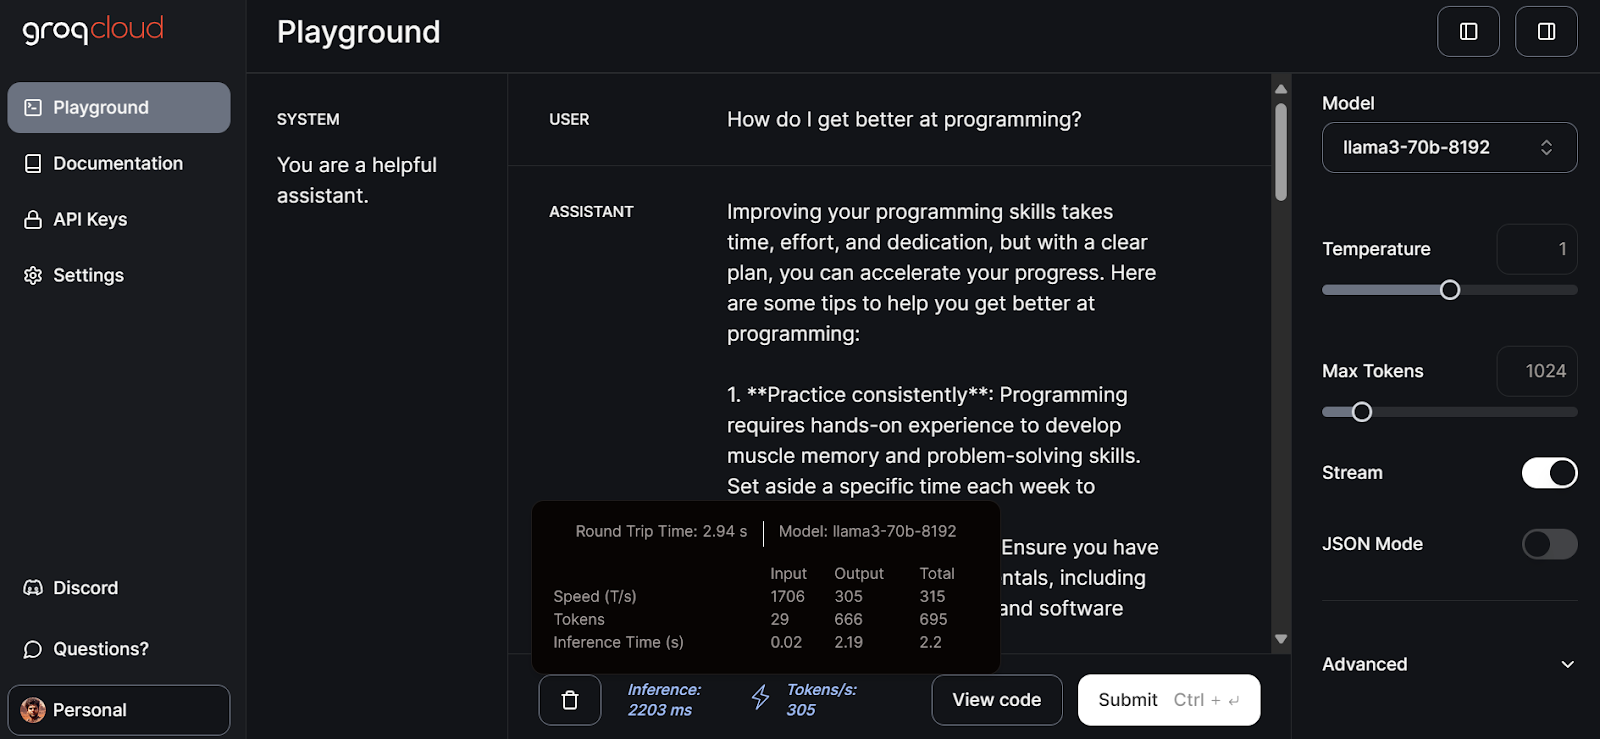
Klik daarna in het linkerpaneel op het tabblad Playground, selecteer het model llama3-70b-8192 en begin met het schrijven van prompts bij USER input.
Het kostte 2,94 seconden om het volledige antwoord te genereren met een snelheid van 305 tokens per seconde. Dit is piekprestatie die we niet uit ChatGPT zullen halen.
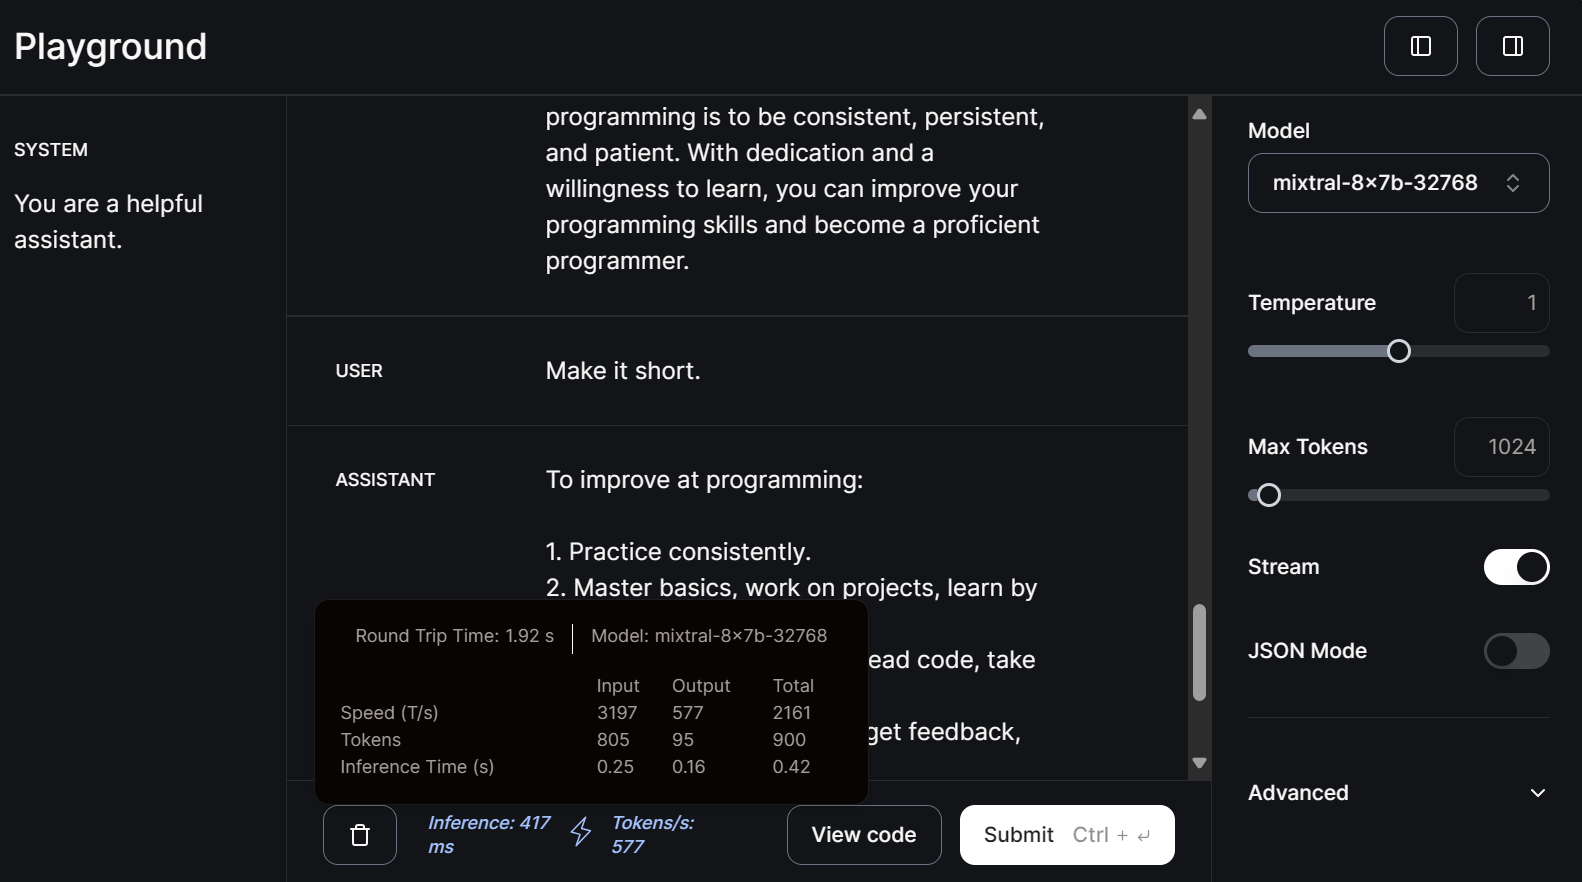
Laten we nu het kleine model mitral-8x7b-32768 selecteren en de vervolgprompt schrijven.
Kleinere modellen genereren antwoorden nog sneller, met 577 tokens per seconde.
Lees deze tutorial over LLM-classificatie: hoe kies je de beste LLM voor jouw toepassing om de beschikbare opties en keuzecriteria te leren kennen.
Om lokaal toegang te krijgen tot Groq LLM's, moeten we een API-sleutel genereren door naar het tabblad API Keys te gaan en op de knop Create API Key te klikken.
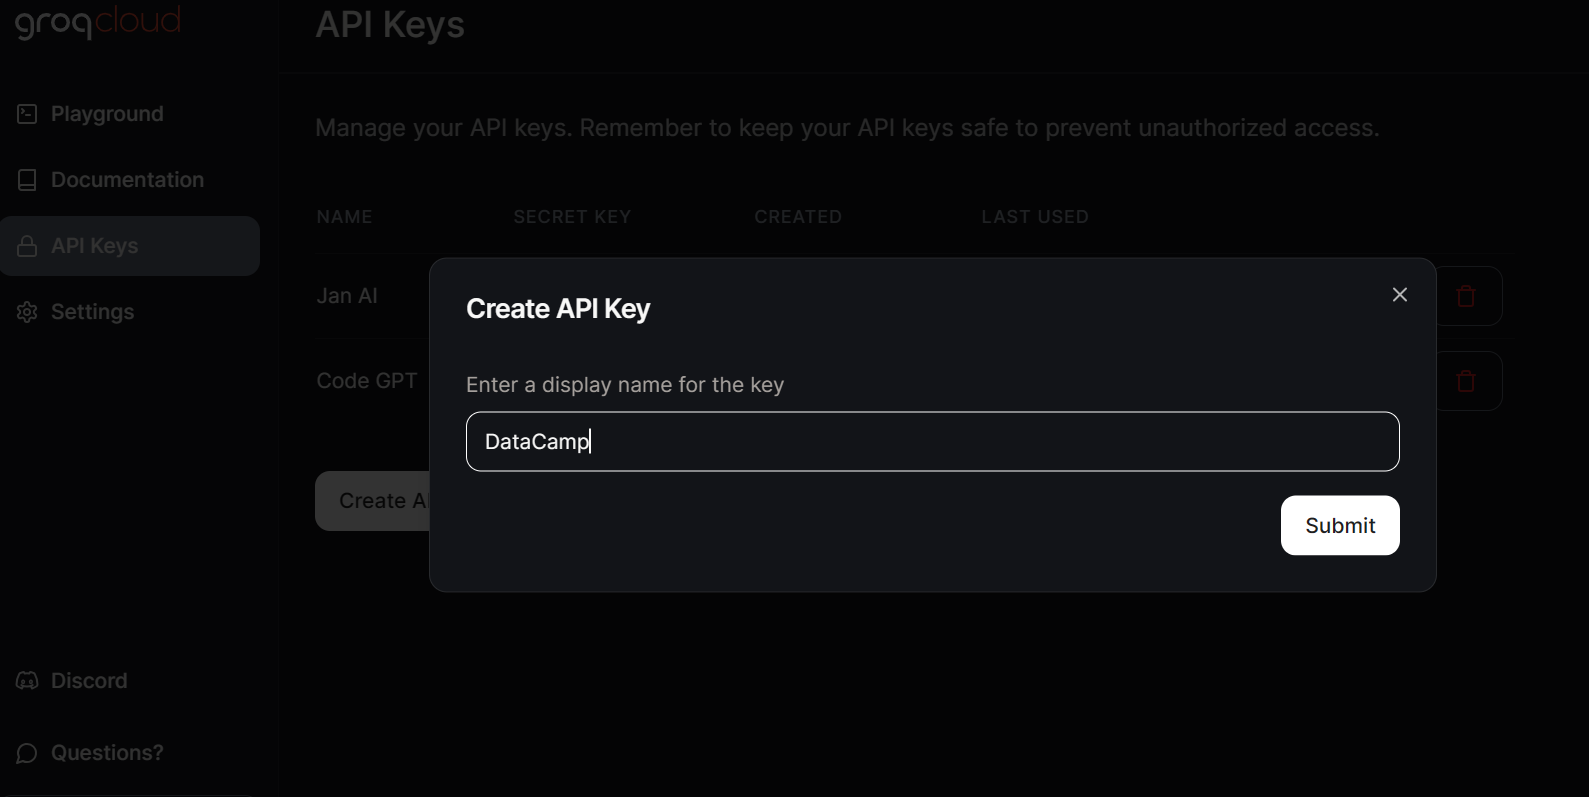
Jan AI laat ons LLM's lokaal gebruiken—zowel open-source als propriëtaire modellen. Het ondersteunt modelproviders zoals OpenAI, Anthropic, Cohere, MistralAI en Groq.
We downloaden en installeren Jan AI via de officiële website. Daarna kunnen we de applicatie starten.
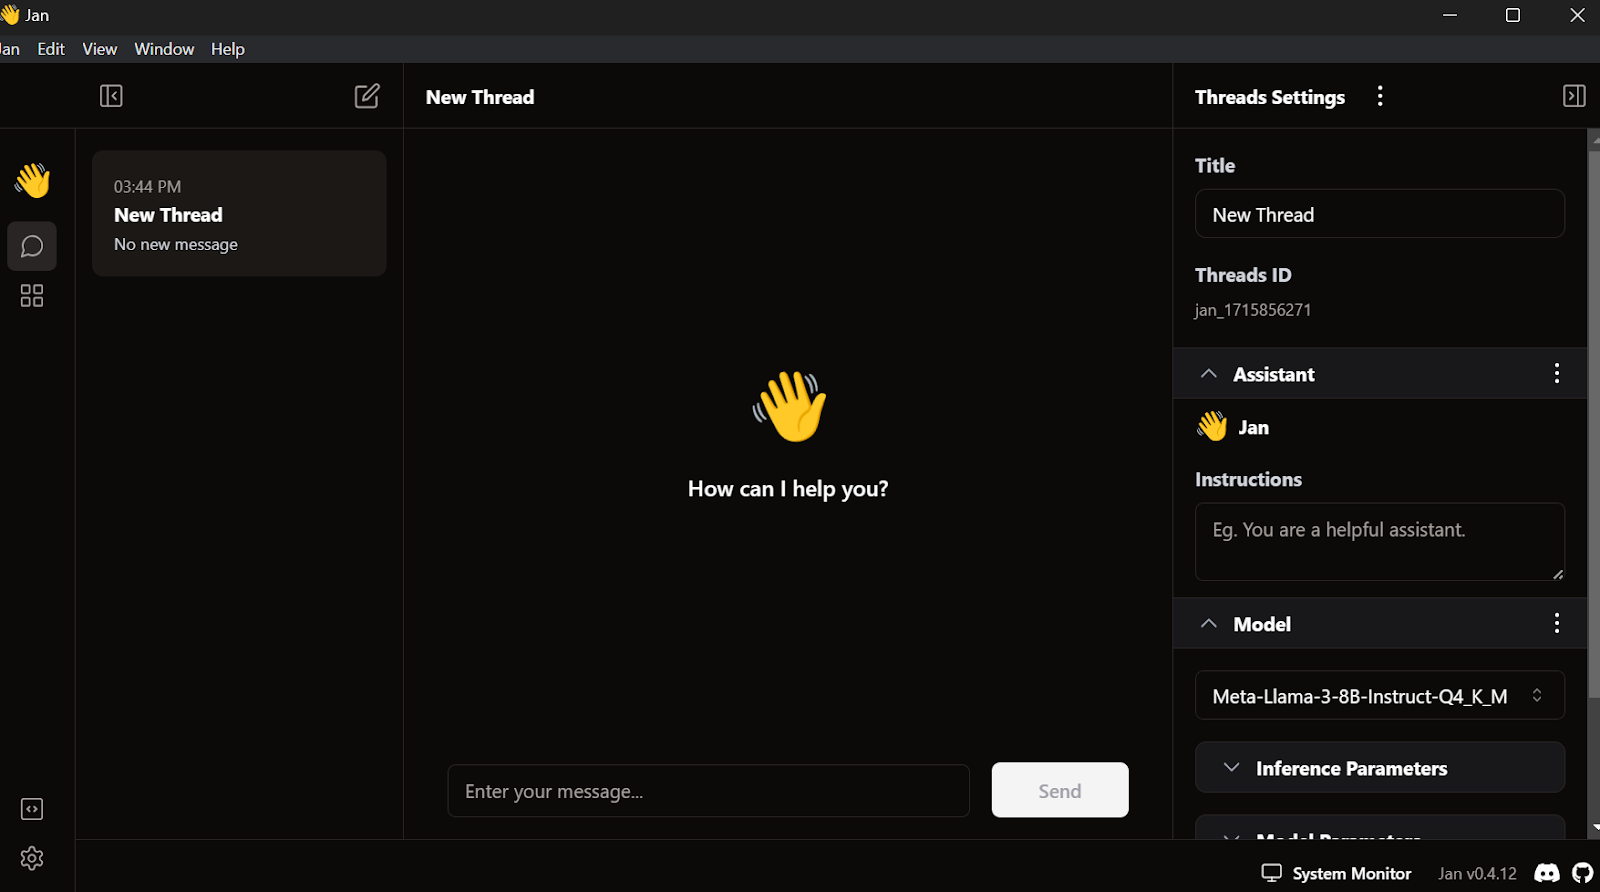
Ga naar de instellingen, selecteer het tabblad Groq Inference Engine en plak de zojuist aangemaakte API-sleutel.
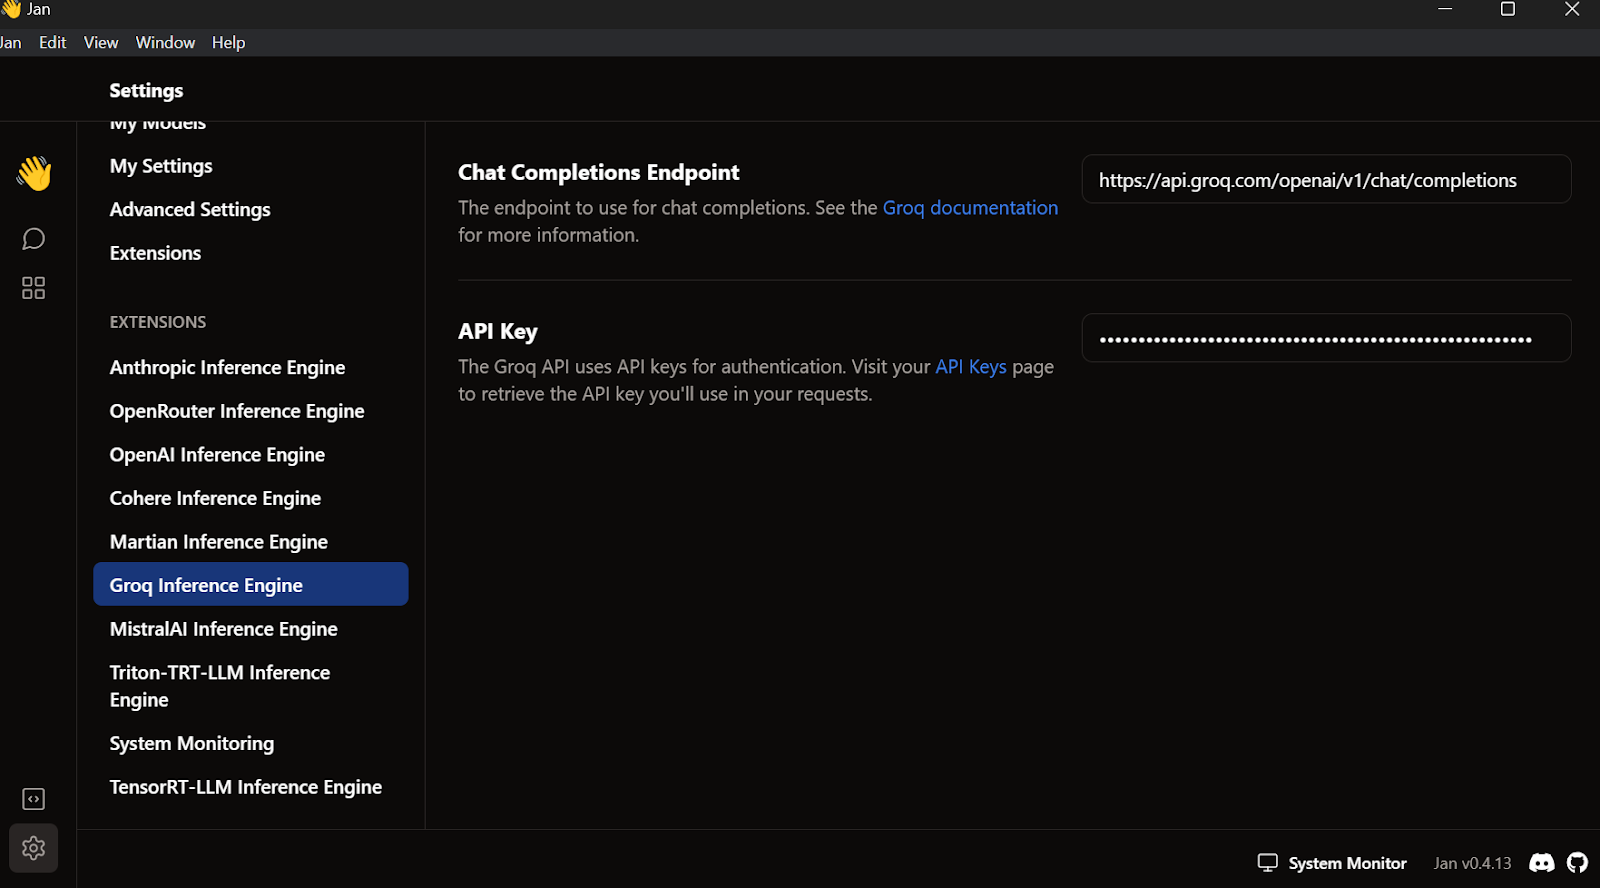
Sluit het instellingenmenu, ga naar Thread en selecteer het Groq Llama 3 70b-model.
Schrijf een vraag of prompt om het antwoord realtime te genereren:
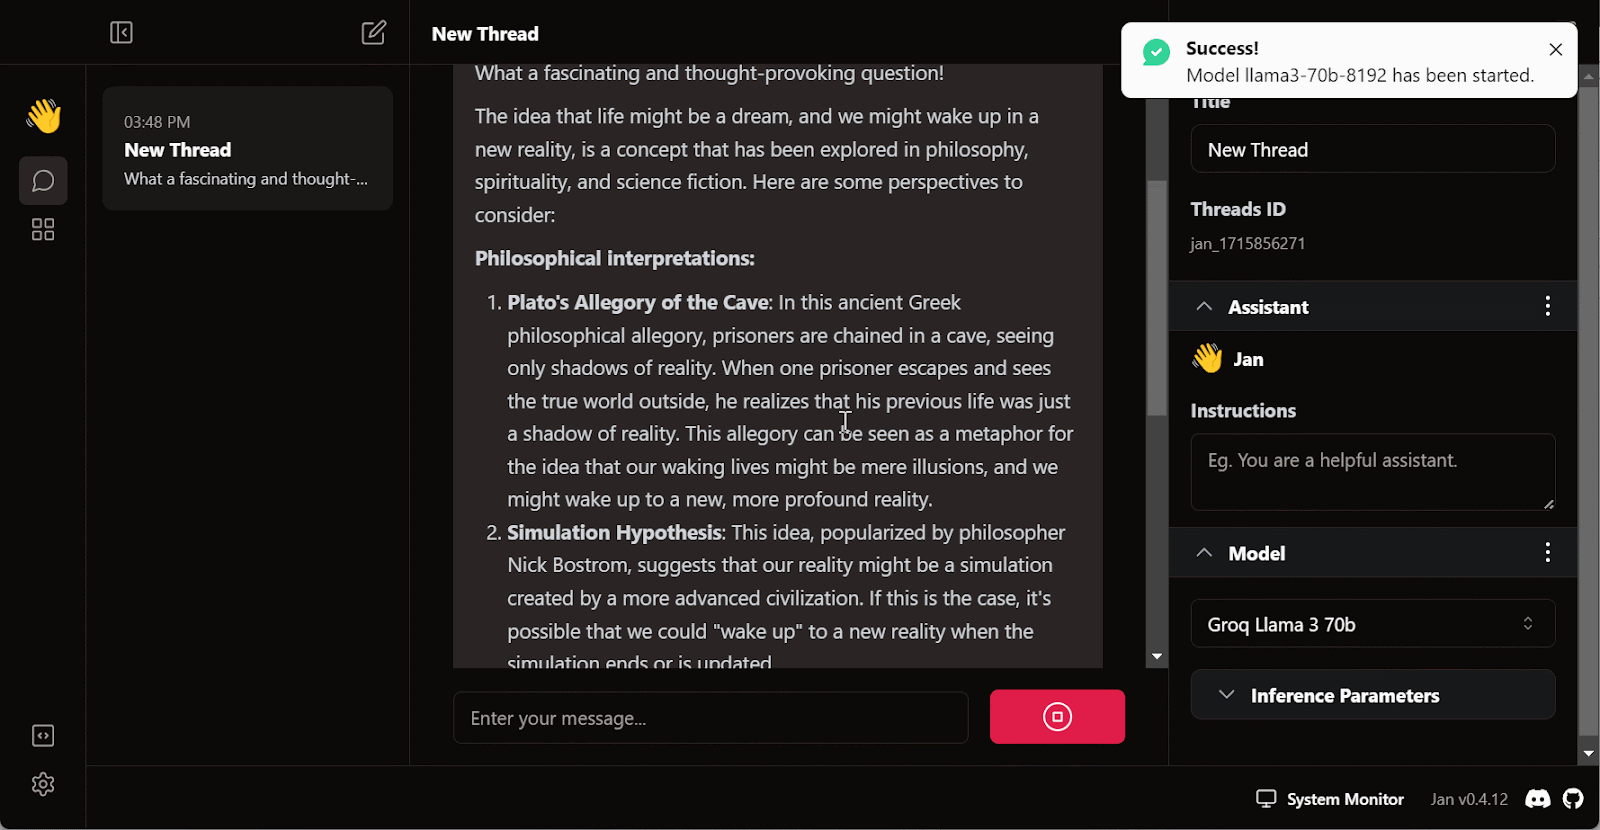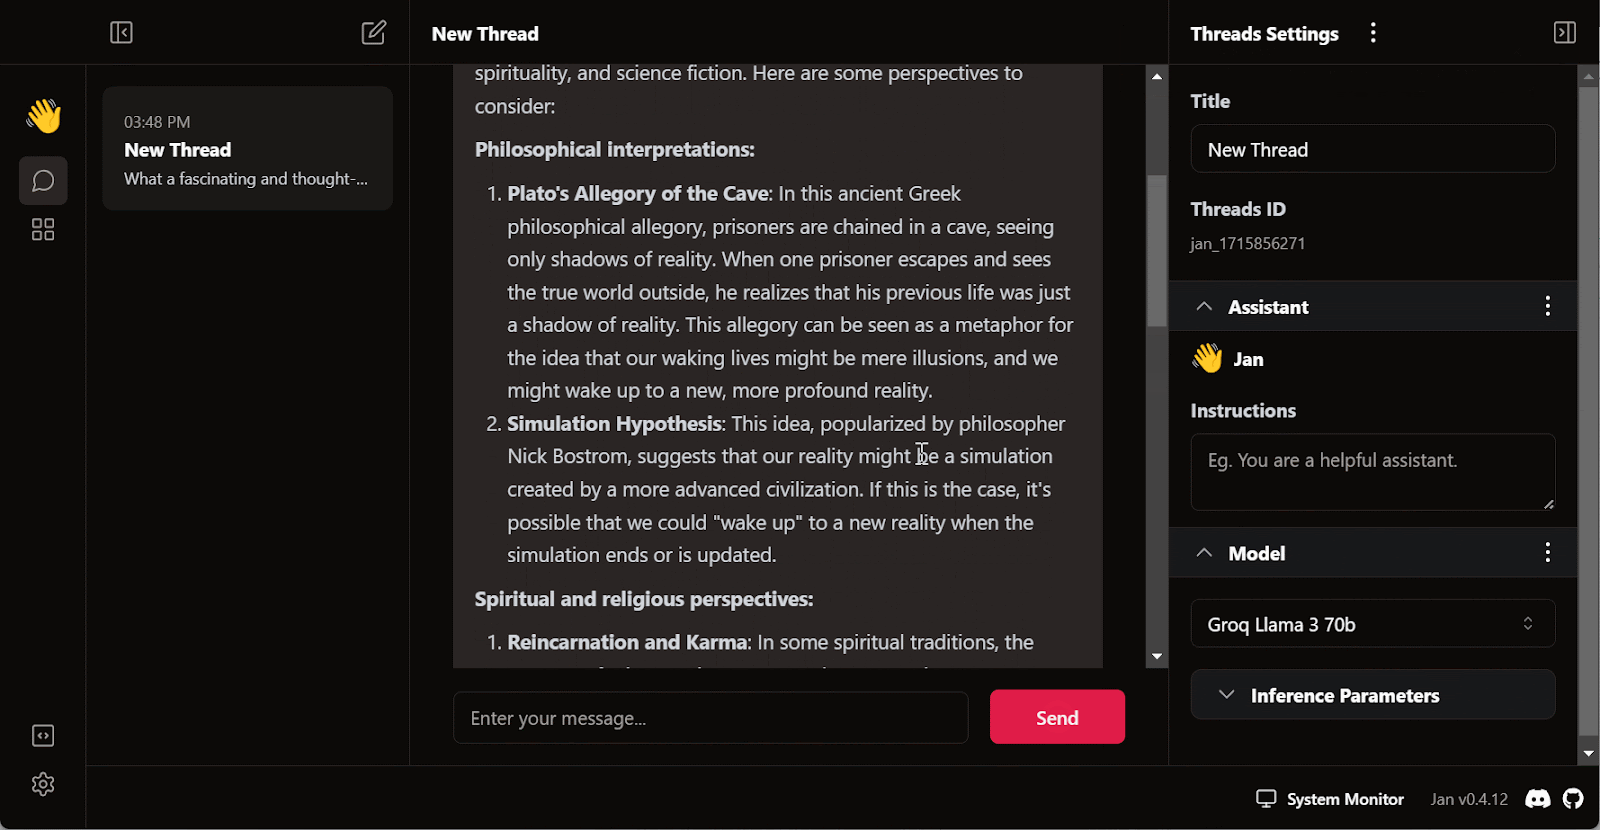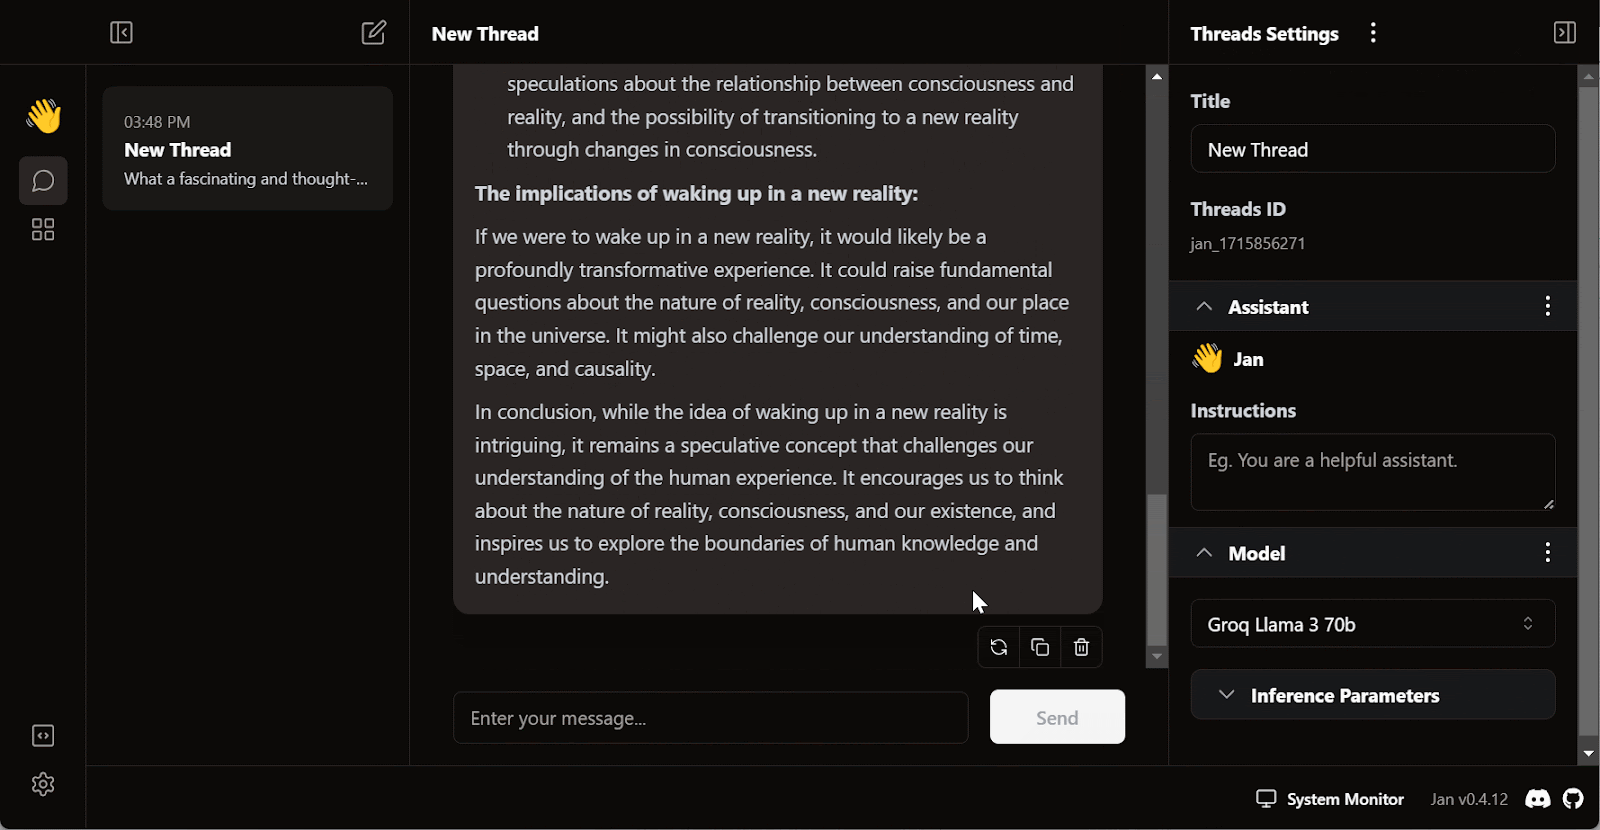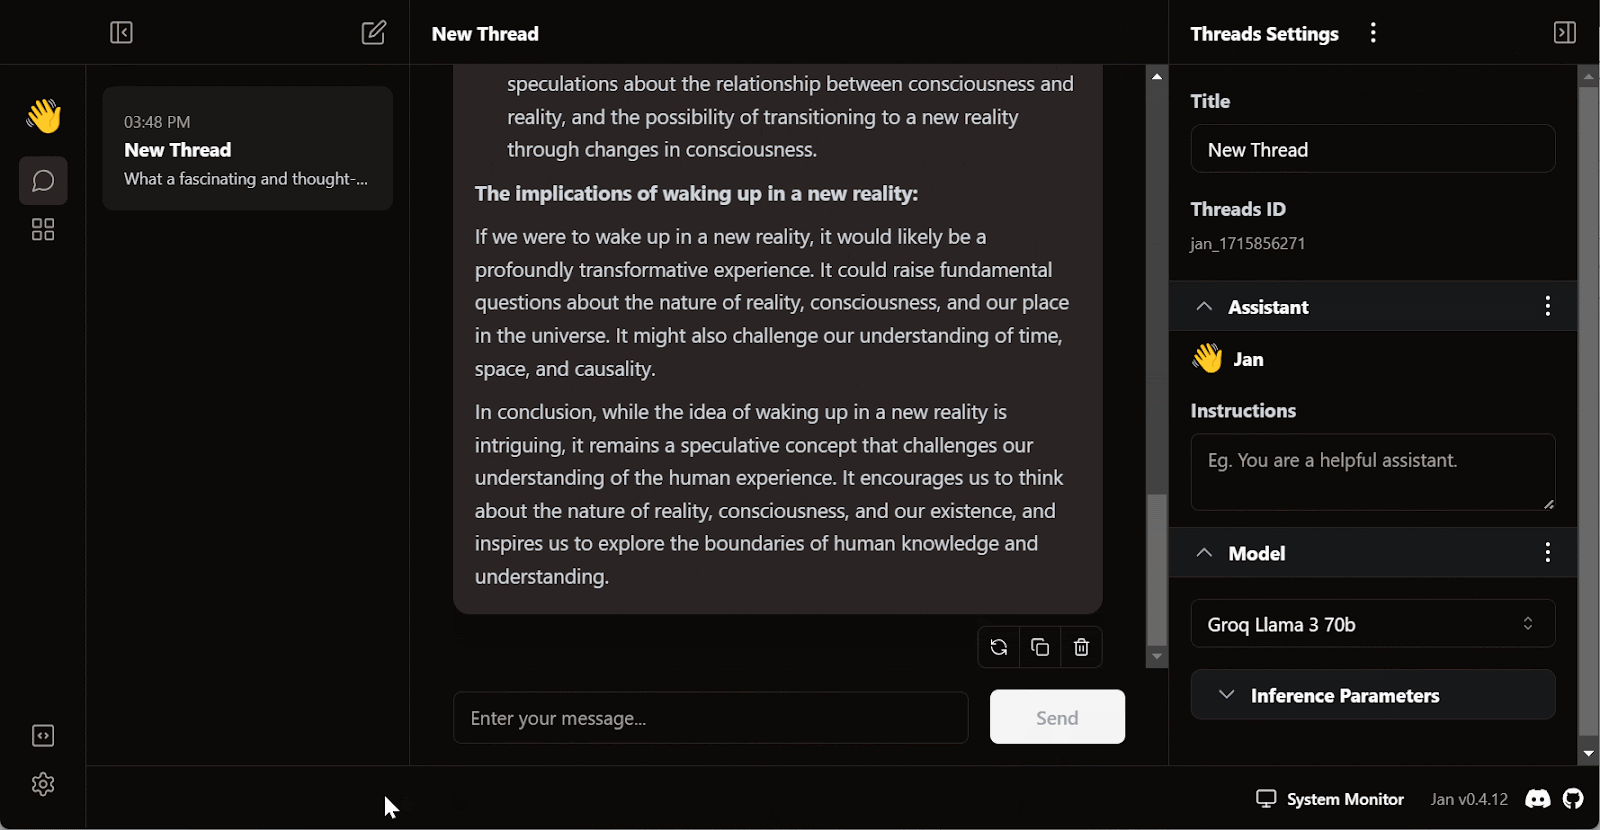
Het gratis abonnement voor Groq Cloud heeft bepaalde snelheidslimieten. Zo staat het llama3-70b-8192-plan 30 verzoeken per minuut toe, 14.400 per dag en 6.000 tokens per minuut. Hoewel deze limieten royaal zijn, kan een upgrade naar het On Demand- of Enterprise-pakket nodig zijn als je een volwaardige AI-toepassing met de Groq API wilt bouwen.
Lees deze tutorial over LLM's lokaal draaien voor zeven eenvoudige manieren om AI-toepassingen lokaal te draaien.
Behalve in een chatbottoepassing kunnen we de Groq API ook in VSCode integreren met de CodeGPT-extensie. Dat wordt onze supersnelle AI-coding assistant.
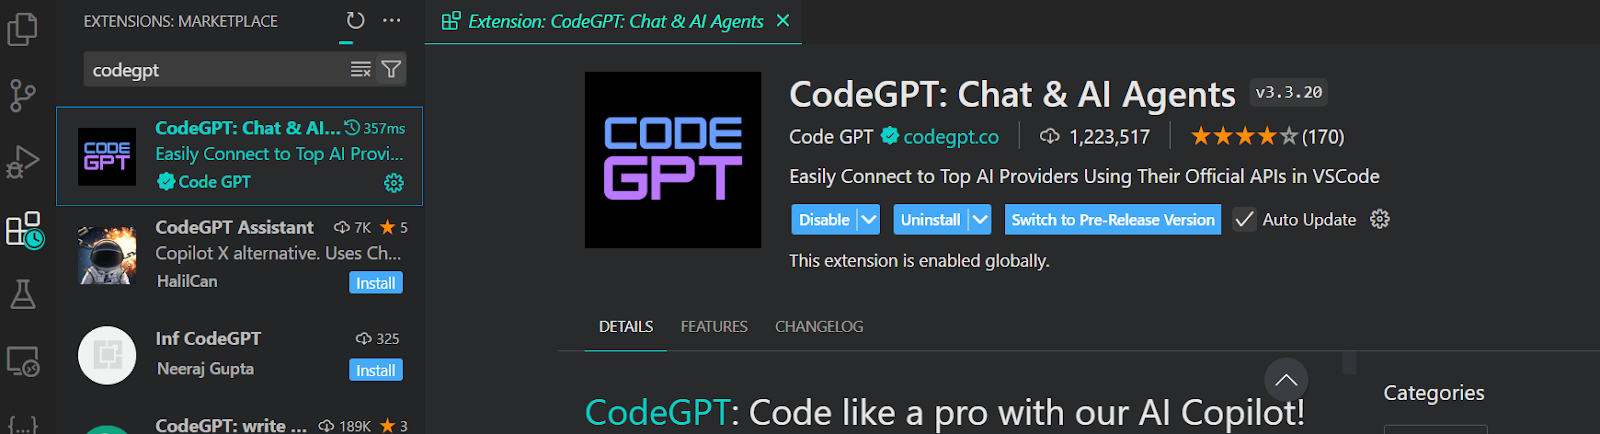
Om in VSCode toegang te krijgen tot het Groq-model, moeten we de CodeGPT-extensie installeren via de extensiemarketplace.
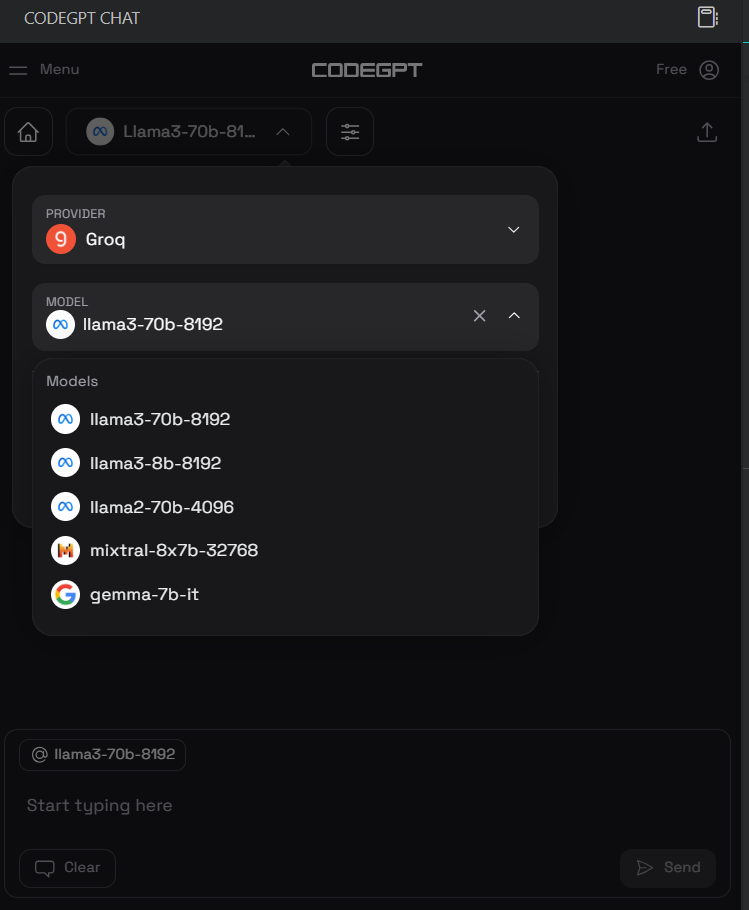
Na installatie stellen we de Groq API-sleutel in door op het CodeGPT-chatpictogram in het linkerpaneel te klikken en de provider en het model te selecteren. Wij hebben Groq als provider en llama3-70b-8192 als model gekozen.
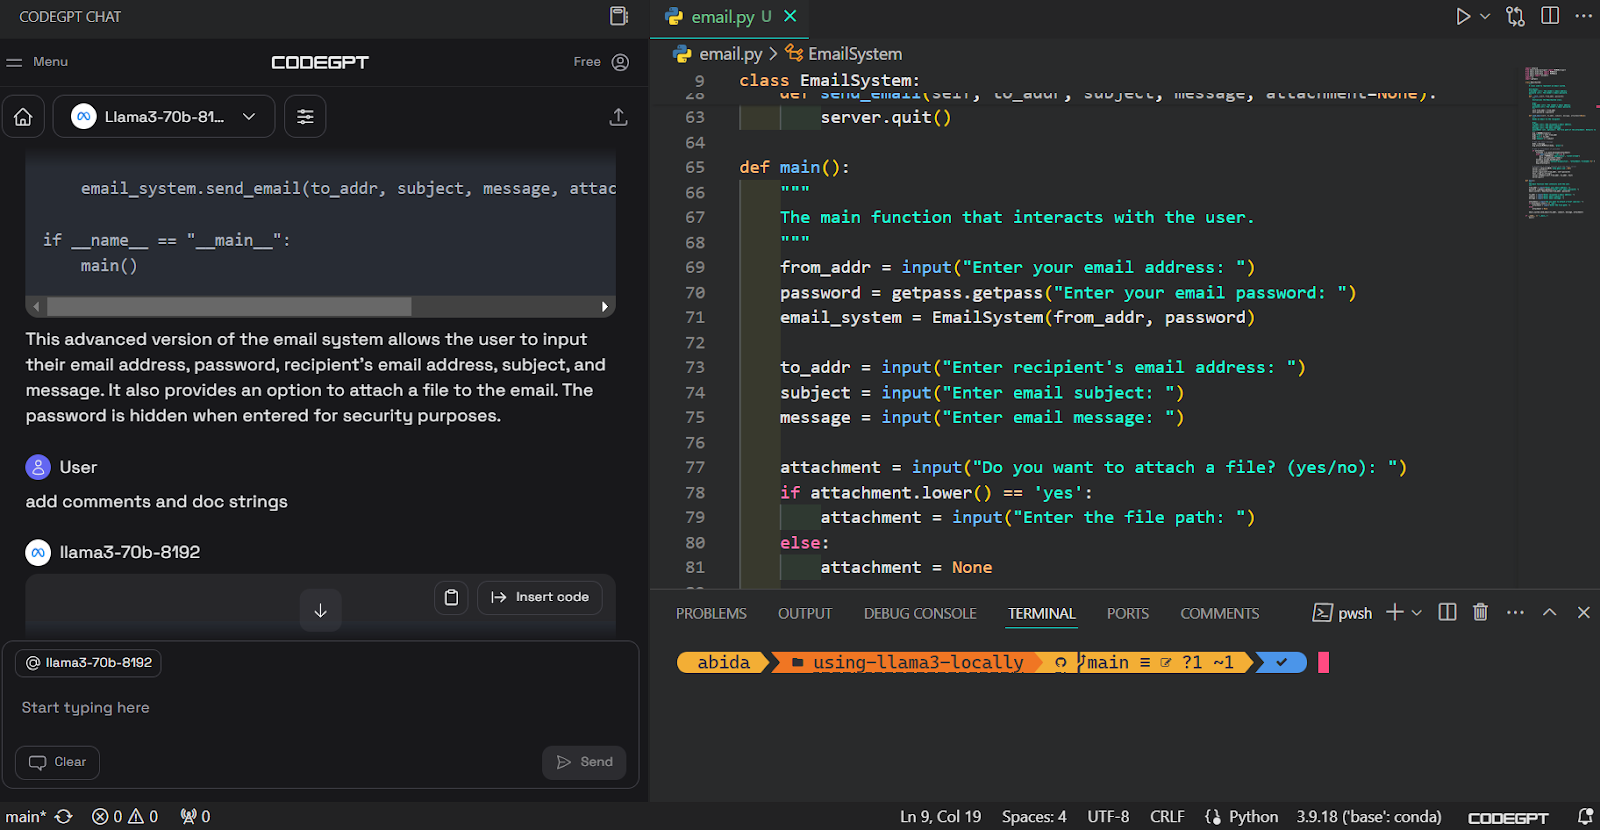
Daarna kunnen we een prompt in het chatvenster schrijven en de code genereren. Het kostte ons een paar seconden om de juiste code te genereren en het e-mailsysteem te bouwen.
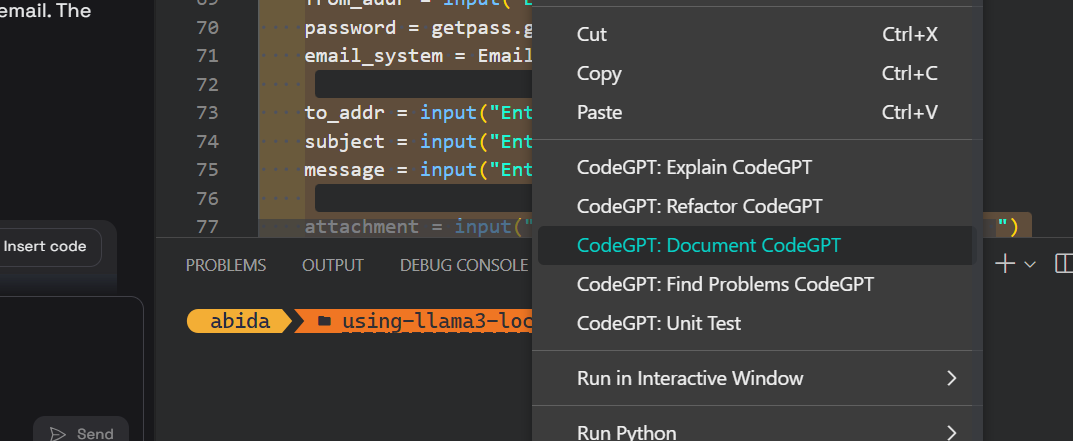
We kunnen de code daarna documenteren, refactoren en de unit test maken met ingebouwde opdrachten.
Meer weten over VSCode? Lees dan deze tutorial over VSCode instellen voor Python.
In deze sectie leren we de basis van de Groq Python API en de belangrijkste functies, zoals streaming en asynchrone chat completion.
Voor deze gids gebruiken we DataCamp's DataLab. DataLab is een AI Cloud Jupyter Notebook met talloze functies voor coderen, data-analyse en het delen van inzichten.
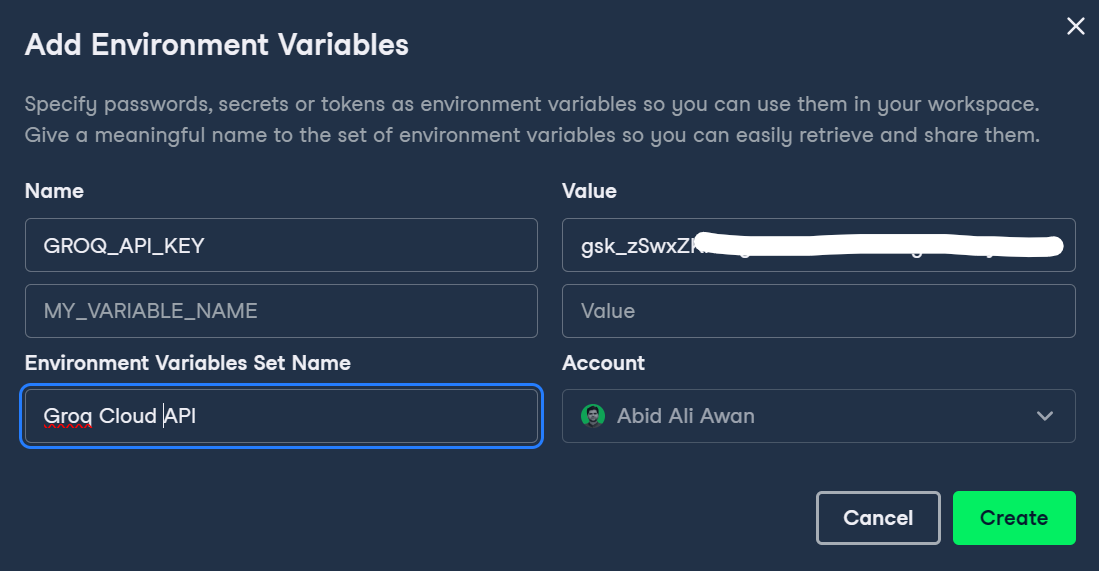
Eerst stellen we de Groq API-sleutel in DataLab in door op de knop Environment in het linkerpaneel te klikken en de omgevingsvariabele toe te voegen via de plusknop.
We kunnen de naam van de variabele invullen en de Groq API-sleutel plakken zoals hieronder getoond.
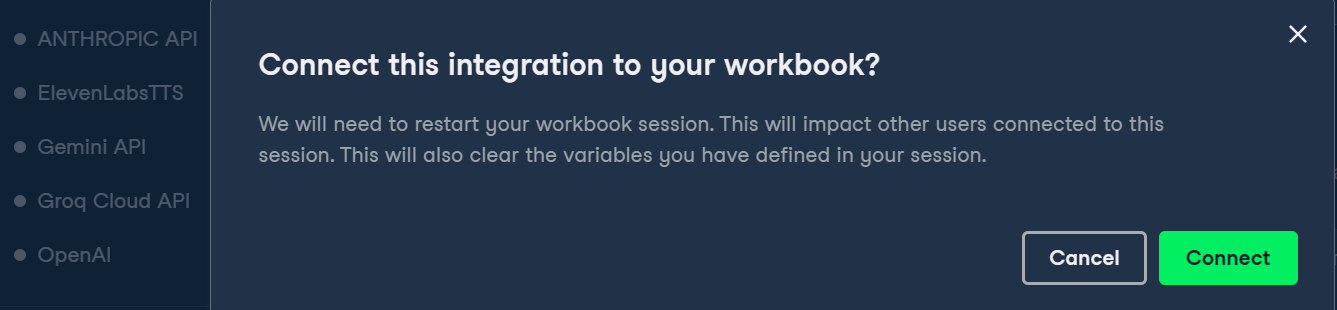
Vervolgens activeren we de omgevingsvariabele door op de drie puntjes naast de Groq-omgevingsvariabele te klikken en Connect te kiezen.
Tot slot installeren we het Groq Python-pakket met de pip-opdracht.
%pip install groq -qAls je de OpenAI Python API hebt gebruikt, zal de structuur herkenbaar zijn. Om chat completion te draaien:
import os
from groq import Groq
from IPython.display import display, Markdown

client = Groq(
   api_key=os.environ.get("GROQ_API_KEY"),
)

chat_completion = client.chat.completions.create(
   messages=[
       {"role": "system", "content": "You are a professional Data Scientist."},
       {"role": "user", "content": "Can you explain how the neural networks work?"},
   ],
   model="llama3-70b-8192",)

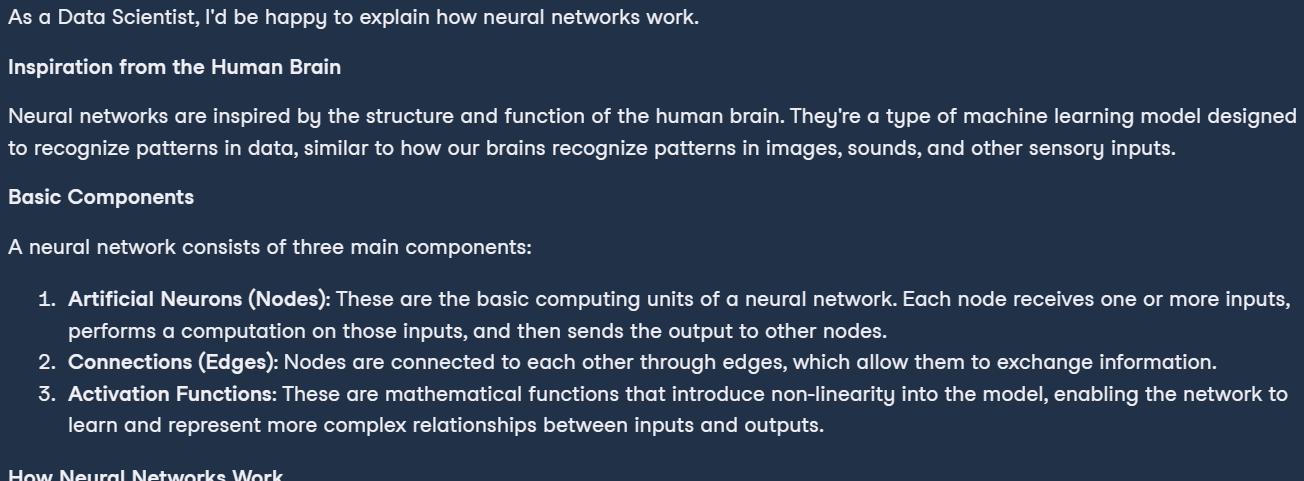
Markdown(chat_completion.choices[0].message.content)
Als resultaat krijgen we een keurig geformatteerde uitleg van wat neurale netwerken zijn.
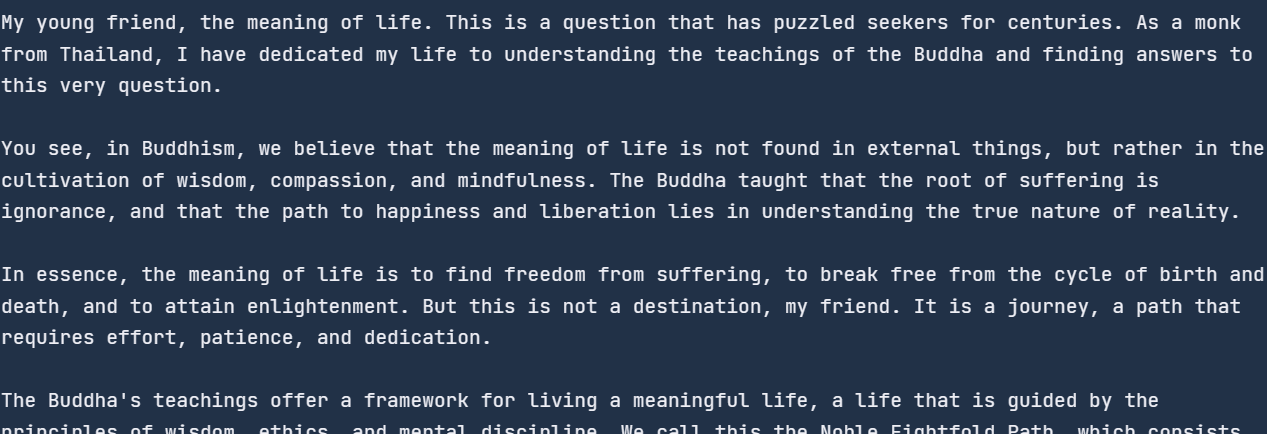
Streaming bij LLM's betekent dat tekst token voor token wordt verwerkt en gegenereerd, waardoor het geheugen efficiënt wordt gebruikt en de ervaren snelheid van de AI-toepassing toeneemt.
In deze voorbeelden hebben we streaming ingeschakeld en het model aangepast door hyperparameters zoals temperature, max_tokens en top_p te wijzigen.
chat_streaming = client.chat.completions.create(
    messages=[
       {"role": "system", "content": "You are a monk from Thailand."},
       {"role": "user", "content": "Can you explain the meaning of life?"},
    ],
    model="llama3-70b-8192",
    temperature=0.3,
    max_tokens=360,
    top_p=1,
    stop=None,
    stream=True,
)

for chunk in chat_streaming:
    print(chunk.choices[0].delta.content, end="")
Hierdoor begonnen we direct na het uitvoeren van de code het antwoord te ontvangen.
Asynchrone API's maken het mogelijk meerdere gelijktijdige verzoeken af te handelen zonder te blokkeren, zodat het systeem elk verzoek onafhankelijk kan verwerken en beantwoorden. Deze aanpak is efficiënter en schaalbaarder, omdat hij een groter volume aan verzoeken aankan en snellere reactietijden biedt.
Om asynchrone API-calls te gebruiken, moeten we de structuur van de code aanpassen. We:
Terzijde: de onderstaande code werkt in Jupyter Notebook, maar als je dit in een Python-bestand draait, moet je de laatste regel mogelijk vervangen door asyncio.run(main()).
import asyncio
from groq import AsyncGroq

client = AsyncGroq(

    api_key=os.environ.get("GROQ_API_KEY"),

)

async def main():

   chat_completion = await client.chat.completions.create(
       messages=[            {"role": "system", "content": "You are a psychiatrist helping young minds"},
                  {                "role": "user",                "content": "I panicked during the test, even though I knew everything on the test paper.",            },
                ],
                model="llama3-70b-8192",
                temperature=0.3,
                max_tokens=360,
                top_p=1,
                stop=None,
                stream=False,
       )

       print(chat_completion.choices[0].message.content)

await main()  # for Python file use asyncio.run(main())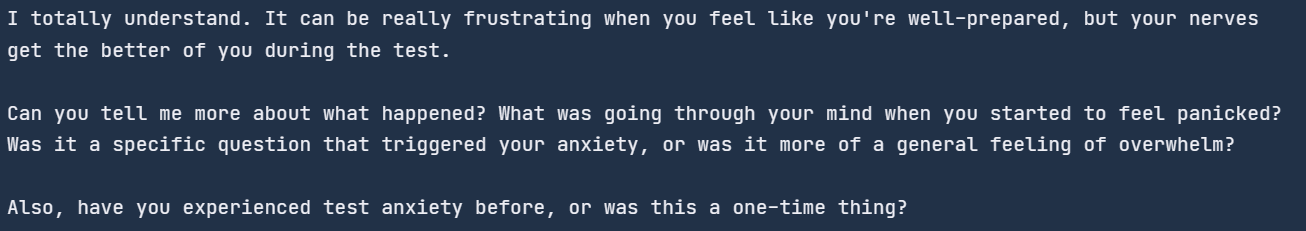
We kunnen de asynchrone API ook streamen door het stream-argument in de chat completion-functie in te schakelen en de manier waarop we de resultaten printen aan te passen. We printen elke chunk met een for-lus en het async-commando.
import asyncio

from groq import AsyncGroq


client = AsyncGroq()

async def main():

    chat_streaming = await client.chat.completions.create(
        messages=[
           {"role": "system", "content": "You are a psychiatrist helping young minds"},
           {                "role": "user",                "content": "I panicked during the test, even though I knew everything on the test paper.",            },
        ],
        model="llama3-70b-8192",
        temperature=0.3,
        max_tokens=360,
        top_p=1,
        stop=None,
        stream=True,
     )
     async for chunk in chat_streaming:
            print(chunk.choices[0].delta.content, end="")

await main()  # for Python file use asyncio.run(main())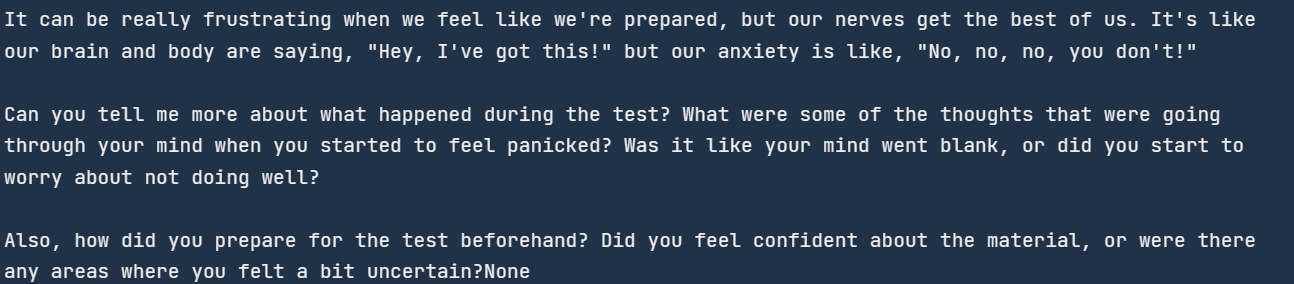
Heb je moeite om de code te draaien? Raadpleeg dan deze DataLab-notebook: Groq Cloud API.
In deze gids gaan we een stap verder en bouwen we een AI-toepassing met de Groq API en LlamaIndex, een LLM-framework. We bouwen een applicatie die tekst uit een PDF-bestand laadt, die omzet in embeddings en opslaat in de vector store. Daarna zetten we de vector store om in de retriever, die wordt gebruikt om een RAG-chatengine met geschiedenis te bouwen.
Kortom, we bouwen een contextbewuste ChatPDF-applicatie waarmee je documenten veel sneller begrijpt.
Wil je leren hoe je privé- en domeinspecifieke data met natuurlijke taal kunt inladen, beheren en ophalen? Bekijk dan deze tutorial: LlamaIndex: A Data Framework for Large Language Models (LLMs).
Eerst installeren we alle benodigde Python-pakketten met pip. We gebruiken de %%capture-magic om de logs te onderdrukken.
%%capture
%pip install llama-index
%pip install llama-index-llms-groq
%pip install llama-index-embeddings-huggingfaceWe maken de Groq LLM-client aan met de functie van llama_index. De LLM-client vereist een modelnaam en de API-sleutel.
from llama_index.llms.groq import Groq
import os

llm =
Groq(model="llama3-70b-8192",api_key=os.environ.get("GROQ_API_KEY"))We downloaden en laden nu het Hugging Face-embeddingmodel met de LlamaIndex-embeddings-API.
In ons geval laden we het populairste embeddingmodel op Hugging Face, mxbai-embed-large-v1.
from llama_index.embeddings.huggingface import HuggingFaceEmbedding

embed_model =
HuggingFaceEmbedding(model_name="mixedbread-ai/mxbai-embed-large-v1")Met LlamaIndex kunnen we globale configuraties instellen, zodat we de LLM- of embeddingobjecten niet overal hoeven mee te geven.
from llama_index.core import Settings

Settings.llm = llm
Settings.embed_model = embed_modelVoor de data gebruiken we de blogpost 14 Essential Data Engineering Tools to Use in 2024 en we zetten die via de printopdracht om naar PDF.
Met de functie SimpleDirectoryReader kun je allerlei documenten uit een map laden. Geef gewoon de maplocatie en de vereiste bestandsextensies op.
from llama_index.core import SimpleDirectoryReader

de_tools_blog = SimpleDirectoryReader("./",required_exts=[".pdf", ".docx"]).load_data()VectorStoreIndex is de snelste manier om een vector store te maken door de documenten te laden en de index op te bouwen. De index kan worden gebruikt voor query-engines, retrievers en querypipelines.
In ons geval maken we de index door de documenten aan de vector store te geven, die de tekst omzet in embeddings en vervolgens opslaat in de vector store.
Daarna zetten we de index om in de query-engine om basale RAG (retrieval augmented generation) uit te voeren, wat retrieval en AI-modellen combineert om een contextbewust antwoord te genereren.
from llama_index.core import VectorStoreIndex

index = VectorStoreIndex.from_documents(de_tools_blog)
query_engine = index.as_query_engine(similarity_top_k=3)

response = query_engine.query("How many tools are there?")
print(response)
We maken nu de RAG-chatengine met geschiedenis. Met geschiedenis kan de chatengine zowel gebruikersberichten als gegenereerde antwoorden onthouden en contextbewuste antwoorden geven.
Voor deze toepassing maken we een ChatMemoryBuffer van 3900 tokens en geven die mee aan de chatengine, samen met de retriever en het LLM-object.
Als je een vraag stelt, gebruikt de chatengine het PDF-document en eerdere berichten als context en reageert dienovereenkomstig.
from llama_index.core.memory import ChatMemoryBuffer
from llama_index.core.chat_engine import CondensePlusContextChatEngine

memory = ChatMemoryBuffer.from_defaults(token_limit=3900)

chat_engine = CondensePlusContextChatEngine.from_defaults(
   index.as_retriever(),
   memory=memory,
   llm=llm
)

response = chat_engine.chat(
   "What tools are suitable for data processing?"
)
print(str(response))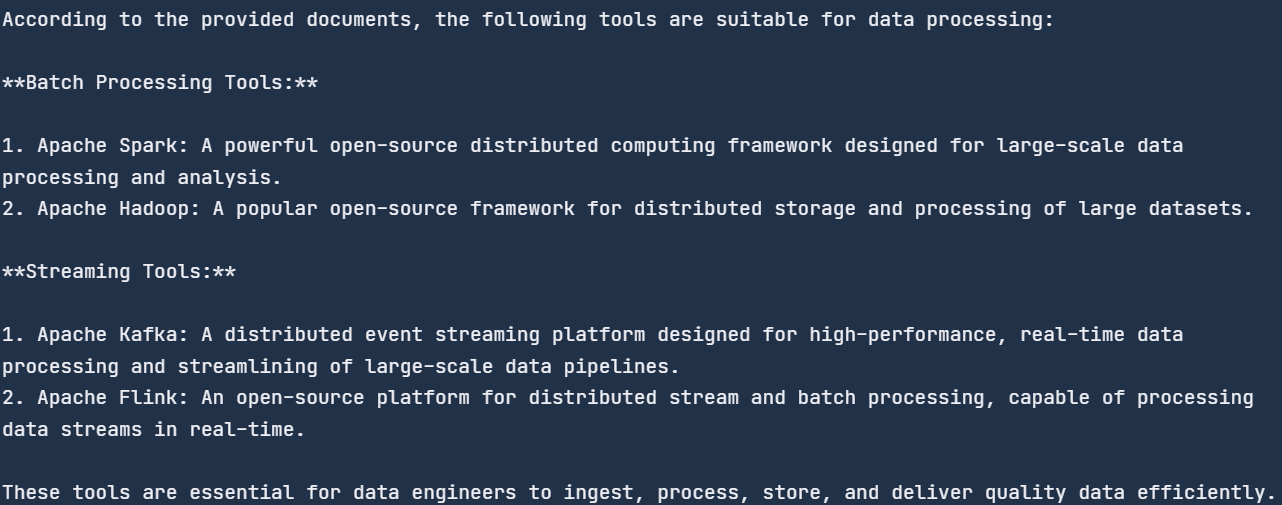
We stelden algemene vragen, en het zocht in het document naar de tools voor datapreparatie/-verwerking en gaf ons de lijst. Alle tools worden genoemd in de blog.
Laten we een vervolgvraag stellen om het geheugen van de chatengine te testen.
response = chat_engine.chat(
    "Can you create a diagram of a data pipeline using these tools?"
)
print(str(response))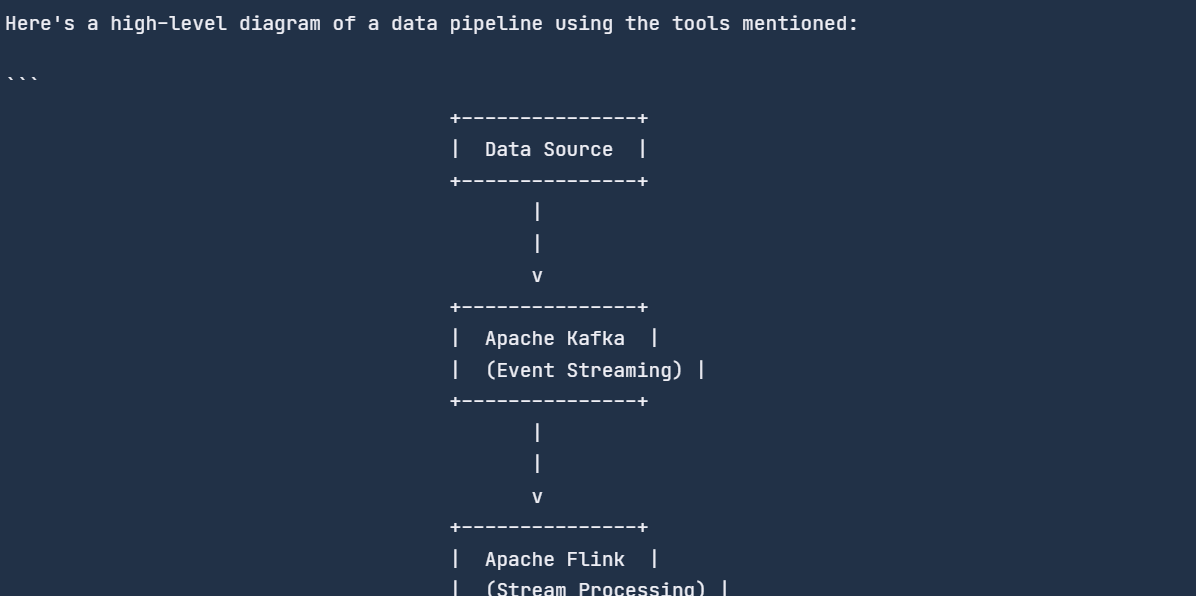
De chatengine onthield de vorige chat en reageerde daar passend op.
Alle code die we gebruikten, is beschikbaar in deze DataLab-notebook: Groq Cloud API — DataLab.
De Groq LPU Inference Engine is een gamechanger in AI. Terwijl grote spelers zoals OpenAI en Google zich richten op het ontwikkelen van hoogwaardige LLM's, maakt Groq deze modellen sneller. Ondanks dat Groq nieuw is op het AI-toneel, maakt het bedrijf veel indruk in de AI-community.
In deze blog leerden we over de Groq LPU Inference Engine, verkenden we Groq Cloud en integreerden we de Groq API in VSCode en de Jan AI-applicatie. Daarnaast doken we in het Groq Python-pakket met codevoorbeelden en leerden we een contextbewuste AI-toepassing bouwen die kan leren van chatgeschiedenis en PDF-documenten.
Een mogelijke volgende stap in je leertraject is het finetunen van LLM's op een eigen dataset. Leer hoe je dat doet in deze tutorial: Fine Tuning Google Gemma: Enhancing LLMs with Customized Instructions.
Leren met DataCamp
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

