

Geri Getirimle Zenginleştirilmiş Üretim (RAG) Nasıl Çalışır?
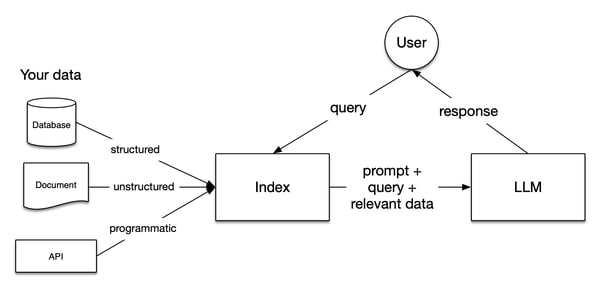
LlamaIndex Dokümantasyonu'ndan görsel
Geri Getirimle Zenginleştirilmiş Üretim (RAG) ardışık düzenleri üç adımdan oluşur: Dizinleme, Getirme ve Üretim.
Dizinleme
LLM’lerle doğru ve bağlama duyarlı yanıtlar almak için dizinleme temel bir adımdır. İlk olarak Word belgeleri, PDF dosyaları veya HTML dosyaları gibi farklı dosya biçimlerindeki veriler çıkarılır ve temizlenir. Veri temizlendikten sonra standart düz metne dönüştürülür. LLM’lerdeki bağlam sınırlamalarından kaçınmak için metin daha küçük parçalara bölünür. Bu işleme Parçalama (Chunking) denir. Ardından her parça bir gömme (embedding) modeli kullanılarak sayısal bir vektöre veya gömüye dönüştürülür. Son olarak, parçaları ve karşılık gelen gömmeleri anahtar-değer çiftleri olarak saklamak için bir dizin oluşturulur.
Getirme
Getirme aşamasında, kullanıcı sorgusu da aynı gömme modeli kullanılarak bir vektör gösterimine dönüştürülür. Daha sonra sorgu vektörü ile vektörleştirilmiş parçalar arasındaki benzerlik puanları hesaplanır. Sistem, kullanıcı sorgusuna en çok benzeyen ilk K parçayı getirir.
Üretim
Kullanıcı sorgusu ve getirilen parçalar bir istem (prompt) şablonuna beslenir. Önceki adımlardan elde edilen zenginleştirilmiş istem son olarak LLM’e girdi olarak verilir.
RAG'in Sınırlamaları
RAG sistemleri kurarken, yukarıda açıklanan üç adımın her birinde aşağıdaki gibi önemli zorluklarla karşılaşabilirsiniz:
- Dizinleme: RAG’in etkinliği, verinin kalitesinden ciddi ölçüde etkilenir. Harici veri kaynağı bilgi verici olmaktan çok gürültülü ise, LLM’in ürettiği yanıtlar faydalı olmayacaktır.
- Getirme: Dosya türlerinize ve RAG sisteminizi nasıl kurduğunuza bağlı olarak, sistem her zaman kullanıcı sorgularını yanıtlamaya yardımcı olacak parçaları getirmeyebilir.
- Üretim: RAG sistemi etkili bir şekilde kurulmuş olsa bile, LLM yine de hayali olgulara dayanarak hatalı yanıtlar üretebilir.
Aşağıda, bu sınırlamaları aşmak için stratejileri inceleyeceğiz. Üç geniş stratejiyi ele alacağız: Parçalama (Chunking), Yeniden Sıralama (Re-Ranking) ve Sorgu Dönüşümleri. Ayrıca, bu stratejilerin, LlamaIndex ve OpenAI API kullanarak Wikipedia maddeleri hakkında soruları yanıtlayan bir RAG sistemi kurarken RAG performansını nasıl iyileştirebileceğini göstereceğiz. Hadi derine inelim!
Temel (Baseline) RAG Sisteminin Kurulumu
Bir RAG sisteminin performansını artırma yöntemlerini incelemeden önce, basit bir RAG ardışık düzeni kurarak temel bir performans seviyesi belirlememiz gerekir. llama-index ve openai paketlerini kurarak başlayalım.
!pip install llama-index
!pip install openaiLlamaIndex, Büyük Dil Modelleri (LLM) tabanlı uygulamalar için bir veri çerçevesidir. Farklı türde harici veri kaynaklarının içe alınmasını, Geri Getirimle Zenginleştirilmiş Üretim (RAG) sistemleri kurmayı ve diğer LLM’lerle entegrasyonları birkaç satır koda sığdırmayı sağlar. Ayrıca, LLM’lerle daha doğru çıktılar üretmek için çeşitli teknikler sunar.
Varsayılan olarak, metin üretimi için OpenAI gpt-3.5-turbo modelini, getirme ve gömmeler için ise text-embedding-ada-002 modelini kullanır. Bu modelleri kullanmak için OpenAI platformunda ücretsiz bir hesap oluşturup bir OpenAI API anahtarı edinmek gerekir. Anahtarı almak için lütfen OpenAI API dokümantasyonunu ziyaret edin.
import os
os.environ["OPENAI_API_KEY"] = "YOUR_OPENAI_API_KEY"Paketlerimizi kurduğumuza göre, Emma Stone, Ryan Gosling ve La La Land’in Wikipedia sayfalarına dayalı soruları yanıtlayan bir RAG sistemi kuracağız. İlk olarak, Wikipedia sayfalarını çıkarmak için wikipedia kütüphanesini kurmamız gerekiyor:
!pip install wikipediaArdından, verileri Wikipedia’dan kolayca indirebiliriz:
# Import packages
from llama_index.core import (VectorStoreIndex,ServiceContext, download_loader)
# Download the documents from Wikipedia and load them
WikipediaReader = download_loader("WikipediaReader")
loader = WikipediaReader()
pages = ['Emma_Stone', 'La_La_Land', 'Ryan_Gosling']
documents = loader.load_data(pages=pages, auto_suggest=False, redirect = False)Veriler çıkarıldıktan sonra, belgeleri 256 karakterlik ve bindirme olmadan parçalara bölebiliriz. Daha sonra bu parçalar, gömme modeli kullanılarak sayısal vektörlere dönüştürülür ve bir Vektör Mağazasında dizinlenir.
# Initialize the gpt3.5 model
gpt3 = OpenAI(temperature=0, model="gpt-3.5-turbo-instruct", api_key=OPENAI_API_KEY)
# Initialize the embedding model
embed_model = OpenAIEmbedding(model= OpenAIEmbeddingModelType.TEXT_EMBED_ADA_002, api_key=OPENAI_API_KEY)
# Transform chunks into numerical vectors using the embedding model
service_context_gpt3 = ServiceContext.from_defaults(llm=gpt3, chunk_size = 256, chunk_overlap=0, embed_model=embed_model)
index = VectorStoreIndex.from_documents(documents, service_context=service_context_gpt3)
retriever = index.as_retriever(similarity_top_k=3)Halüsinasyon riskini azaltmak için, LLM yanıtlarının yalnızca sağlanan bağlama dayanmasını sağlamak üzere PromptTemplate modülünü kullanıyoruz.
from llama_index.core.prompts import PromptTemplate
# Build a prompt template to only provide answers based on the loaded documents
template = (
"We have provided context information below. \n"
"---------------------\n"
"{context_str}"
"\n---------------------\n"
"Given this information, please answer the question: {query_str}\n"
"Don't give an answer unless it is supported by the context above.\n"
)
qa_template = PromptTemplate(template)Artık RAG sistemimizi kurduğumuza göre, getirilen belgelere dayalı sorularla test edebiliriz. Haydi deneyelim!
Sorgu 1: “Emma Stone’un ilk Akademi Ödülünü kazanmasına yol açan filmin konusu nedir?”
Bu ilk sorgu zorlu çünkü modelin farklı bilgi parçalarına bakmasını gerektiriyor:
- Emma Stone’un ilk Akademi Ödülünü kazanmasına yol açan filmin adı (bu durumda La La Land)
- Bu belirli filmin konusu.
# Create a prompt for the model
question = "What is the plot of the film that led Emma Stone to win her first Academy Award?"
# Retrieve the context from the model
contexts = retriever.retrieve(question)
context_list = [n.get_content() for n in contexts]
prompt = qa_template.format(context_str="\n\n".join(context_list), query_str=question)
# Generate the response
response = gpt3.complete(prompt)
print(str(response))Çıktı:
The plot of the film that made Emma Stone win her first Academy Award is not explicitly mentioned in the provided context.Sorgu 2: "Emma Stone ve Ryan Gosling’in ailelerini karşılaştırın”
Bu ikinci sorgu, iki oyuncunun ailelerine ilişkin ilgili parçaların seçilmesini istediği için bir öncekinden de zorlu.
# Create a prompt for the model
question = "Compare the families of Emma Stone and Ryan Gosling"
# Retrieve the context from the model
contexts = retriever.retrieve(question)
context_list = [n.get_content() for n in contexts]
prompt = qa_template.format(context_str="\n\n".join(context_list), query_str=question)
# Generate the response
response = gpt3.complete(prompt)
print(str(response))Aşağıdaki çıktıyı alıyoruz:
Based on the context provided, it is not possible to compare the families of Emma Stone and Ryan Gosling as the information focuses on their professional collaboration and experiences while working on the film "La La Land." There is no mention of their personal family backgrounds or relationships in the context provided.Gördüğünüz gibi, her iki durumda da vasat yanıtlar aldık. Bir sonraki bölümlerde, bu RAG sisteminin performansını iyileştirmenin yollarını keşfedelim!
Parça Boyutunu Güncelleyerek RAG Performansını İyileştirme
Parça boyutunu ve parça bindirmesini özelleştirerek başlayabiliriz. Yukarıda belirttiğimiz gibi, belgeler belirli bir bindirme ile parçalara bölünür. Varsayılan olarak LlamaIndex, varsayılan parça boyutu olarak 1024 ve varsayılan parça bindirmesi olarak 20 kullanır. Bu hiperparametrelerin yanı sıra, sistem varsayılan olarak ilk 2 parçayı getirir.
Örneğin, parça boyutunu 512’ye, parça bindirmesini 50’ye ayarlayabilir ve getirilen parça sayısını artırabiliriz:
# modify default values of chunk size and chunk overlap
service_context_gpt3 = ServiceContext.from_defaults(llm=gpt3, chunk_size = 512, chunk_overlap=50, embed_model=embed_model)
# build index
index = VectorStoreIndex.from_documents(
documents, service_context=service_context_gpt3
)
# returns the engine for the index
query_engine = index.as_query_engine(similarity_top_k=4)Sorgu 1: “Emma Stone’un ilk Akademi Ödülünü kazanmasına yol açan filmin konusu nedir?”
# generate the response
response = query_engine.query("What is the plot of the film that led Emma Stone to win her first Academy Award?")
print(response)Çıktı:
The film that made Emma Stone win her first Academy Award is a romantic musical called La La Land.Önceki yanıta kıyasla biraz daha iyi. Emma Stone’un ilk Akademi Ödülünü kazanmasına yol açan filmin La La Land olduğunu başarıyla tanımladı, ancak filmin konusunu anlatamadı.
Sorgu 2: "Emma Stone ve Ryan Gosling’in ailelerini karşılaştırın”
# generate the response
response = query_engine.query("Compare the families of Emma Stone and Ryan Gosling")
print(response)Çıktı:
Emma Stone has expressed her close relationship with her family and mentioned being blessed with great family and people around her. She has also shared about her mother's battle with breast cancer and their celebration by getting matching tattoos. On the other hand, there is no specific information provided about Ryan Gosling's family or his personal relationships in the context.Yine, RAG ardışık düzeninin çıktısı iyileşti, ancak hâlâ Ryan Gosling’in ailesi hakkında bilgi yakalayamıyor.
Yeniden Sıralama (Re-Ranking) ile RAG Performansını İyileştirme
Veri kümesi boyut ve karmaşıklık olarak büyüdükçe, karmaşık sorgulara özel yanıtlar döndürmek için ilgili bilgileri seçmek kritik hâle gelir. Bu amaçla, Yeniden Sıralama (Re-Ranking) olarak adlandırılan teknikler ailesi, metin içindeki hangi parçaların önemli olduğunu anlamanızı sağlar. Belgeleri yeniden sıralar ve filtreler, en ilgili olanları önce sıralar.
Yeniden Sıralama için iki ana yaklaşım vardır:
- Yeniden Sıralama modellerini gömme modellerine alternatif teknikler olarak kullanmak. Bunlar, girdi olarak sorgu ve bağlamı alır ve gömme yerine benzerlik puanları döndürür.
- LLM’leri kullanmak ve belgelerdeki anlamsal bilgiyi daha verimli yakalamak.
Bu Yeniden Sıralama yaklaşımlarını uygulamadan önce, ikinci sorgumuz için temel RAG sisteminin ilk üç parça olarak neleri döndürdüğünü değerlendirelim:
# Retrieve the top three chunks for the second query
retriever = index.as_retriever(similarity_top_k=3)
query = "Compare the families of Emma Stone and Ryan Gosling"
nodes = retriever.retrieve(query)
# Print the chunks
for node in nodes:
print('----------------------------------------------------')
display_source_node(node, source_length = 500)Bu, Yeniden Sıralama öncesi çıktıdır; her parçanın bir Node ID’si ve benzerlik puanı vardır.
Node ID: 9b3817fe-3a3f-4417-83d2-2e2996c8b468
Similarity: 0.8415899563985404
Text: Emily Jean "Emma" Stone (born November 6, 1988) is an American actress and producer. She is the recipient of various accolades, including two Academy Awards, two British Academy Film Awards, and two Golden Globe Awards. In 2017, she was the world's highest-paid actress and named by Time magazine as one of the 100 most influential people in the world. Born and raised in Scottsdale, Arizona, Stone began acting as a child in a theater production of The Wind in the Willows in 2000. As a teenager,...
----------------------------------------------------
Node ID: 1bef0308-8b0f-4f7e-9cd6-92ce5acf811f
Similarity: 0.831147173341674
Text: Coincidentally, Gosling turned down the Beast role in Beauty and the Beast in favor of La La Land. Chazelle subsequently decided to make his characters somewhat older, with experience in struggling to make their dreams, rather than younger newcomers just arriving in Los Angeles. Emma Stone plays Mia, an aspiring actress in Los Angeles. Stone has loved musicals since she saw Les Misérables when she was eight years old. She said "bursting into song has always been a real dream of mine", and her ...
----------------------------------------------------
Node ID: 576ae445-b12e-4d20-99b7-5e5a91ee7d74
Similarity: 0.8289486590392277
Text: Stone was named the best-dressed woman of 2012 by Vogue and was included on similar listings by Glamour in 2013 and 2015, and People in 2014.
== Personal life == Stone moved from Los Angeles to Greenwich Village, New York, in 2009. In 2016, she moved back to Los Angeles. Despite significant media attention, she refuses to publicly discuss her personal life. Concerned with living a normal life, Stone has said she dislikes receiving paparazzi attention outside her home. She has expressed her ...FlagEmbeddingReranker ile Yeniden Sıralama
İlgili parçaları getirmek için, Hugging Face’ten bge-ranker-base adlı açık kaynaklı bir Yeniden Sıralama modelini kullanabiliriz.
OpenAI API’sinde olduğu gibi, Hugging Face kullanmak da bir kullanıcı erişim belirteci almayı gerektirir. Bu dokümantasyonu izleyerek Hugging Face’te bir kullanıcı erişim belirteci oluşturabilirsiniz.
HF_TOKEN = userdata.get('HF_TOKEN')
os.environ['HF_TOKEN'] = HF_TOKENİlerlemeye geçmeden önce, Yeniden Sıralama modelini kullanmak için gerekli kütüphaneleri de kurmamız gerekir:
%pip install llama-index-postprocessor-flag-embedding-reranker
!pip install git+https://github.com/FlagOpen/FlagEmbedding.gitSon olarak, en alakalı parçaları döndürmek için bge-ranker-base modelini kullanıyoruz.
# Import packages
from llama_index.postprocessor.flag_embedding_reranker import FlagEmbeddingReranker
from llama_index.core.schema import QueryBundle
# Re-Rank chunks based on the bge-reranker-base-model
reranker = FlagEmbeddingReranker(
top_n = 3,
model = "BAAI/bge-reranker-base",
)
# Return the updated chunks
query_bundle = QueryBundle(query_str=query)
ranked_nodes = reranker._postprocess_nodes(nodes, query_bundle = query_bundle)
for ranked_node in ranked_nodes:
print('----------------------------------------------------')
display_source_node(ranked_node, source_length = 500)Yeniden Sıralama sonrası sonuç:
Node ID: 9b3817fe-3a3f-4417-83d2-2e2996c8b468
Similarity: 3.0143558979034424
Text: Emily Jean "Emma" Stone (born November 6, 1988) is an American actress and producer. She is the recipient of various accolades, including two Academy Awards, two British Academy Film Awards, and two Golden Globe Awards. In 2017, she was the world's highest-paid actress and named by Time magazine as one of the 100 most influential people in the world. Born and raised in Scottsdale, Arizona, Stone began acting as a child in a theater production of The Wind in the Willows in 2000. As a teenager,...
----------------------------------------------------
Node ID: 576ae445-b12e-4d20-99b7-5e5a91ee7d74
Similarity: 2.2117154598236084
Text: Stone was named the best-dressed woman of 2012 by Vogue and was included on similar listings by Glamour in 2013 and 2015, and People in 2014.
== Personal life == Stone moved from Los Angeles to Greenwich Village, New York, in 2009. In 2016, she moved back to Los Angeles. Despite significant media attention, she refuses to publicly discuss her personal life. Concerned with living a normal life, Stone has said she dislikes receiving paparazzi attention outside her home. She has expressed her ...
----------------------------------------------------
Node ID: 1bef0308-8b0f-4f7e-9cd6-92ce5acf811f
Similarity: 1.6185210943222046
Text: Coincidentally, Gosling turned down the Beast role in Beauty and the Beast in favor of La La Land. Chazelle subsequently decided to make his characters somewhat older, with experience in struggling to make their dreams, rather than younger newcomers just arriving in Los Angeles.Emma Stone plays Mia, an aspiring actress in Los Angeles. Stone has loved musicals since she saw Les Misérables when she was eight years old. She said "bursting into song has always been a real dream of mine", and her ...Çıktıdan, 1bef0308-8b0f-4f7e-9cd6-92ce5acf811f kimlikli düğümün ikinci sıradan üçüncü sıraya geçtiği açıkça görülüyor. Ayrıca, benzerlik puanlarında daha fazla değişkenlik olduğuna dikkat etmek gerekir.
Yeniden Sıralamayı kullandığımıza göre, orijinal sorguya verilen RAG yanıtı şimdi nasıl görünüyor, değerlendirelim:
# Initialize the query engine with Re-Ranking
query_engine = index.as_query_engine(
similarity_top_k = 3,
node_postprocessors=[reranker]
)
# Print the response from the model
response = query_engine.query("Compare the families of Emma Stone and Ryan Gosling")
print(response)Yeniden Sıralama modeli uygulandıktan sonra alınan yanıt:
Both Emma Stone and Ryan Gosling have close relationships with their families. Stone has expressed her gratitude for having a great family and people around her who keep her grounded. Gosling, on the other hand, has drawn from his own experiences as an aspiring artist, indicating a connection to his personal background.Önceki yanıtlara kıyasla belirgin bir iyileşme var, ancak hâlâ eksik. LLM tabanlı bir Yeniden Sıralama yaklaşımının RAG performansını nasıl artırabileceğini değerlendirelim.
RankGPTRerank ile Yeniden Sıralama
Bu kez bir LLM’den bir Yeniden Sıralayıcı olarak yararlanabiliriz. Burada, GPT modelinin RAG sistemi içindeki belgeleri sıralama yeteneklerinden yararlanan RankGPT modülünü kullanıyoruz. Başlamak için gerekli paketleri kuruyoruz:
%pip install llama-index-postprocessor-rankgpt-rerankRankGPTRerank işlevini kullanarak parçaları gpt-3.5-turbo-0125 modeliyle yeniden sıralıyoruz.
# Import packages
from llama_index.postprocessor.rankgpt_rerank import RankGPTRerank
# Re-Rank the top 3 chunks based on the gpt-3.5-turbo-0125 model
reranker = RankGPTRerank(
top_n = 3,
llm = OpenAI(model="gpt-3.5-turbo-0125"),
)
# Display the top 3 chunks based on RankGPT
query_bundle = QueryBundle(query_str=query)
ranked_nodes = reranker._postprocess_nodes(nodes, query_bundle = query_bundle)
for ranked_node in ranked_nodes:
print('----------------------------------------------------')
display_source_node(ranked_node, source_length = 500)RankGPT kullanarak şu parçaları elde ediyoruz:
----------------------------------------------------
Node ID: 1bef0308-8b0f-4f7e-9cd6-92ce5acf811f
Similarity: 1.6185210943222046
Text: Coincidentally, Gosling turned down the Beast role in Beauty and the Beast in favor of La La Land. Chazelle subsequently decided to make his characters somewhat older, with experience in struggling to make their dreams, rather than younger newcomers just arriving in Los Angeles.Emma Stone plays Mia, an aspiring actress in Los Angeles. Stone has loved musicals since she saw Les Misérables when she was eight years old. She said "bursting into song has always been a real dream of mine", and her ...
----------------------------------------------------
Node ID: 9b3817fe-3a3f-4417-83d2-2e2996c8b468
Similarity: 3.0143558979034424
Text: Emily Jean "Emma" Stone (born November 6, 1988) is an American actress and producer. She is the recipient of various accolades, including two Academy Awards, two British Academy Film Awards, and two Golden Globe Awards. In 2017, she was the world's highest-paid actress and named by Time magazine as one of the 100 most influential people in the world. Born and raised in Scottsdale, Arizona, Stone began acting as a child in a theater production of The Wind in the Willows in 2000. As a teenager,...
----------------------------------------------------
Node ID: 576ae445-b12e-4d20-99b7-5e5a91ee7d74
Similarity: 2.2117154598236084
Text: Stone was named the best-dressed woman of 2012 by Vogue and was included on similar listings by Glamour in 2013 and 2015, and People in 2014.
== Personal life == Stone moved from Los Angeles to Greenwich Village, New York, in 2009. In 2016, she moved back to Los Angeles. Despite significant media attention, she refuses to publicly discuss her personal life. Concerned with living a normal life, Stone has said she dislikes receiving paparazzi attention outside her home. She has expressed her ...RankGPT pasajları benzerlik puanına göre sıralamadığından, çıktıda sunulan puanlar güncellenmez. Çıktıdan, en ilgili kabul edilen ilk düğümün hem Emma Stone hem de Ryan Gosling’ten bahsettiğini, kalan düğümlerin ise Emma Stone’un hayatına dair daha fazla ayrıntı içerdiğini görebiliriz.
Şimdi, bu Yeniden Sıralama metodolojisiyle modelin yanıtını yazdırırsak şu çıktıyı alıyoruz:
Both Emma Stone and Ryan Gosling have close relationships with their families. Stone has expressed gratitude for having a great family and supportive people around her, while Gosling has drawn from his own experiences as an aspiring artist, indicating a connection to his family as well. Stone's family has played a significant role in her life, supporting her career pursuits and celebrating important milestones with her. Similarly, Gosling's experiences as an actor have likely been influenced by his family dynamics and relationships.Yanıt, önceki Yeniden Sıralama tekniğine göre daha uzun ve daha fazla ayrıntı içeriyor.
Sorgu Dönüşümleri ile RAG Performansını İyileştirme
Sorgu dönüşümü, diğer adıyla sorgu yeniden yazımı, ham sorgu yerine bir sorguyu başka bir sorguya dönüştüren bir yaklaşımdır; bu, en iyi k parçayı getirmek için kullanılır. Şu teknikleri inceleyeceğiz:
- HyDE: Kullanıcı sorgularını ve varsayımsal yanıtlarını gömmelere dönüştürerek vektör uzayında en yakın eşleşen belgeleri getirme.
- Çok Adımlı Sorgu Dönüşümleri: Karmaşık bir kullanıcı sorgusunu, etkili işleme için sıralı alt sorulara bölme.
HyDE ile RAG Performansını İyileştirme
HyDE, Varsayımsal Belge Gömmeleri (Hypothetical Document Embeddings) anlamına gelir. İki adımdan oluşur. İlk olarak, bir kullanıcı sorgusuna varsayımsal bir yanıt oluşturur. Varsayımsal yanıt/belge belirlendikten sonra yanıt ve sorgu gömmelere dönüştürülür. Ardından, sistem vektör uzayında bu gömmelere en yakın belgeleri getirir. Hadi uygulamada görelim!
# Import packages
from llama_index.core.indices.query.query_transform import HyDEQueryTransform
from llama_index.core.query_engine.transform_query_engine import (
TransformQueryEngine,
)
# build index and query engine for the index
index = VectorStoreIndex.from_documents(documents, service_context=service_context_gpt3)
query_engine = index.as_query_engine(similarity_top_k=4)
# HyDE setup
hyde = HyDEQueryTransform(include_original=True)
# Transform the query engine using HyDE
hyde_query_engine = TransformQueryEngine(query_engine, hyde)
# Print the response from the model
response = hyde_query_engine.query("Compare the families of Emma Stone and Ryan Gosling")
print(response)Çıktı:
Both Emma Stone and Ryan Gosling come from diverse family backgrounds. Ryan Gosling's parents were of part French Canadian descent, along with some German, English, Scottish, and Irish. He grew up in a family that practiced the Church of Jesus Christ of Latter-day Saints. On the other hand, Emma Stone was born and raised in Scottsdale, Arizona, without specific details provided about her family's ethnic background or religious affiliation.Yeniden Sıralama yöntemleriyle karşılaştırıldığında kısmi bir iyileşme görüyoruz. Önceden çıktılar daha çok oyuncuların aileleriyle ilişkilerine dairken, şimdi kökenlere daha çok odaklanıyor.
Çok Adımlı Sorgu Dönüşümleri ile RAG Performansını İyileştirme
Çok adımlı sorgu dönüşümü yaklaşımı, kullanıcının sorgusunu sıralı alt sorulara böler. Bu yöntem, karmaşık sorularla çalışırken kullanışlı olabilir.
Gözlemlediğimiz üzere, LLM’ler iki olguyu karşılaştırmada zorlanma eğilimindedir; soru yalnızca belirli bir konuyla ilgili olduğunda doğru yanıtlayabilseler bile. Burada çok adımlı sorgu dönüşümlerini uygulamada görebiliriz.
# Multi-step query setup
step_decompose_transform_gpt3 = StepDecomposeQueryTransform(gpt3, verbose=True)
index_summary = "Breaks down the initial query"
# Return query engine for the index
multi_step_query_engine = MultiStepQueryEngine(
query_engine=query_engine,
query_transform=step_decompose_transform_gpt3,
index_summary=index_summary
)
# print the response from the model
response = multi_step_query_engine.query("Compare the families of Emma Stone and Ryan Gosling")Nihai çıktıya ulaşmamızı sağlayan ara soruları görebiliriz:
> Current query: Compare the families of Emma Stone and Ryan Gosling
> New query: What is the family background of Emma Stone and Ryan Gosling?
> Current query: Compare the families of Emma Stone and Ryan Gosling
> New query: What is the specific family background of Emma Stone?
> Current query: Compare the families of Emma Stone and Ryan Gosling
> New query: What is Emma Stone's relationship with her family like?Kullanıcı sorgusuna verilen yanıt şöyledir:
Both Ryan Gosling and Emma Stone have strong family connections, with Emma Stone emphasizing the importance of her family in keeping her grounded. Ryan Gosling's family background includes a mix of French Canadian, German, English, Scottish, and Irish heritage.Bu durumda, Emma Stone ve Ryan Gosling’in ailelerini karşılaştırmak için çok adımlı sorgu dönüşümü kullanmak faydalı oldu.
Sonuç
Bu yazıda, RAG performansını iyileştirmek için çeşitli teknikler öğrendiniz. İster Parçalama, ister Yeniden Sıralama, ister Sorgu Dönüşümleri olsun, en iyi yaklaşım çoğu zaman kullanım senaryosuna ve belirli bir sorgu için istediğiniz çıktıya bağlıdır.
Daha derine inmek isterseniz, LlamaIndex ile Geri Getirimle Zenginleştirilmiş Üretim ve GPT ve Milvus ile Geri Getirimle Zenginleştirilmiş Üretim kod eşli anlatımlarımızı izlemenizi öneririz. Bu videolar, farklı kullanım senaryolarında geri getirimle zenginleştirilmiş üretimi kullanarak LLM’leri vektör veritabanlarıyla nasıl birleştireceğinizi gösterir.

Veri Bilimci - CRIF



Geri Getirimle Zenginleştirilmiş Üretim (Retrieval Augmented Generation, RAG), Büyük Dil Modellerinin (LLM) doğruluğunu ve güvenilirliğini artırmak için en popüler tekniklerden biridir. Bu, harici veri kaynaklarından ek bilgi sağlayarak mümkün olur. Böylece yanıtlar belirli bağlamlara göre uyarlanabilir ve ince ayar ya da yeniden eğitime gerek kalmadan güncellenebilir.
RAG popüler olsa da her bağlamda iyi çalışmaz. Bu yazıda, RAG ardışık düzenlerini adım adım nasıl etkili şekilde kuracağınızı açıklayacak, RAG'in sınırlamalarını ve bu sınırlamaların nasıl ele alınacağını inceleyeceğiz. Haydi başlayalım!