Kursus
Pengembangan Kode Berbantuan AI Lanjutan untuk Developer
1 jam 30 menit
1.8K
Setelah Fable 5 dan Mythos 5 dihentikan, para pengembang open-source mulai bereksperimen dengan model lokal yang lebih kecil yang dilatih pada data pengkodean sintetis berkualitas tinggi dan data agensi. Fable 5-Enhanced Gemma 4 adalah salah satu contohnya.
Ini adalah fine-tune Gemma 4 12B yang dilatih pada dataset yang dihasilkan oleh Fable 5 dan Composer 2.5. Tujuannya adalah mentransfer perilaku pengkodean dan agensi yang berguna ke dalam model yang lebih kecil yang dapat dijalankan secara lokal.
Pelatihannya berfokus pada alur kerja praktis, seperti memahami tugas, membaca file, menggunakan alat, mengedit kode, menjalankan perintah, dan memverifikasi hasil akhir.
Dalam panduan ini, saya akan menunjukkan cara menjalankan model Gemma 4 yang ditingkatkan Fable 5 secara lokal pada RTX 5070 Ti menggunakan llama.cpp.
Kita akan memasang llama.cpp, mengunduh model GGUF dan model draf MTP, meluncurkan server lokal yang kompatibel dengan OpenAI, dan mengujinya dengan cURL serta WebUI bawaan.
Terakhir, kita akan menyambungkan model ke Pi Coding Agent dan memberinya tugas pengkodean nyata. Pertanyaan utamanya adalah apakah model 12B yang ringkas ini dapat menghadirkan perilaku coding-agent yang berguna dan bersaing dengan model lokal yang lebih besar seperti Qwen 3.6 27B atau Gemma 4 31B.
Fable 5-Enhanced Gemma 4 adalah model pengkodean dan agensi yang ringkas berdasarkan model instruksi Gemma 4 12B dari Google. Model ini dibuat oleh Yuxin Lu dan dirilis dalam format GGUF untuk penggunaan lokal dengan llama.cpp dan alat kompatibel lainnya.
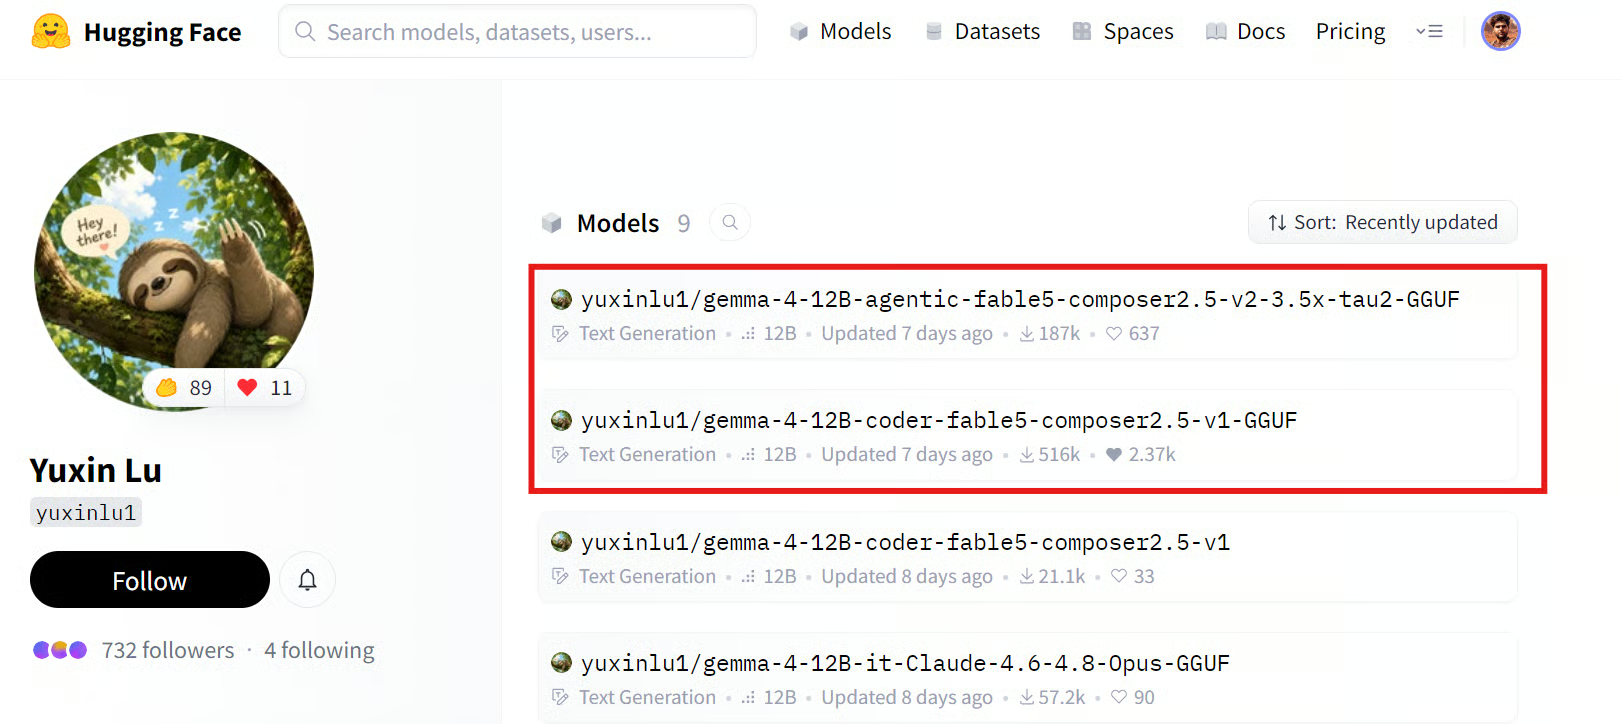
Sumber: yuxinlu1 (Yuxin Lu)
Panduan ini menggunakan rilis v2. Model ini melanjutkan model pengkodean v1 namun menambahkan fokus yang lebih kuat pada pekerjaan teknis berbasis agensi.
Alih-alih hanya menghasilkan kode, model ini dirancang untuk memeriksa file, menalar melalui masalah, menggunakan alat, mengedit kode, menjalankan perintah, dan memverifikasi hasil akhir.
Model asli difine-tune pada data pengkodean Python terverifikasi yang dihasilkan oleh Composer 2.5 dan Fable 5.
Set pelatihan utama menggunakan jejak penalaran Composer 2.5 dan solusi kode untuk tugas-tugas Python dengan pengujian deterministik. Hanya contoh di mana kode yang dihasilkan lulus pengujian yang dipertahankan.
Fable 5 digunakan untuk tugas yang lebih sulit saat Composer 2.5 gagal. Ia menghasilkan proses penalaran baru dan solusi yang dikoreksi untuk contoh-contoh ini, yang juga diverifikasi melalui eksekusi sebelum ditambahkan ke data pelatihan.
Untuk v2, model menambahkan lintasan terminal multi-langkah dan penggunaan alat. Ini mengajarkannya untuk mengikuti alur kerja baca, nalar, bertindak, dan verifikasi alih-alih menghasilkan satu jawaban lalu berhenti.
Setelah Fable 5 tidak lagi tersedia, beberapa jejak penalaran bergaya Fable 5 yang hilang dibangun kembali dengan Opus 4.8.
--jinja tetap aktif di llama.cpp agar model dapat menggunakan template chat dan format pemanggilan alat yang dimaksudkan oleh Gemma 4.Dalam perbandingan tau2-bench telecom lokal, model v2 mencapai sekitar 55%, dibandingkan sekitar 15% untuk model instruksi Gemma 4 12B dasar.
Ini menunjukkan bahwa peningkatan utama berasal dari perilaku agensi. Model fine-tune lebih baik dalam memeriksa tugas, mengambil tindakan berikutnya, menggunakan alat, dan memverifikasi hasil alih-alih berhenti setelah respons awal.
Ini adalah cara tercepat dan termudah untuk memasang llama.cpp pada mesin Linux. Alih-alih mengkloning repositori dan mengompilasinya dari sumber, penginstal akan mengunduh biner siap pakai dan menyiapkannya untuk Anda.
Jalankan perintah berikut di terminal Anda:
curl -LsSf https://llama.app/install.sh | shDalam beberapa detik, penginstal akan mengunduh biner llama.cpp dan menyelesaikan penyiapan.
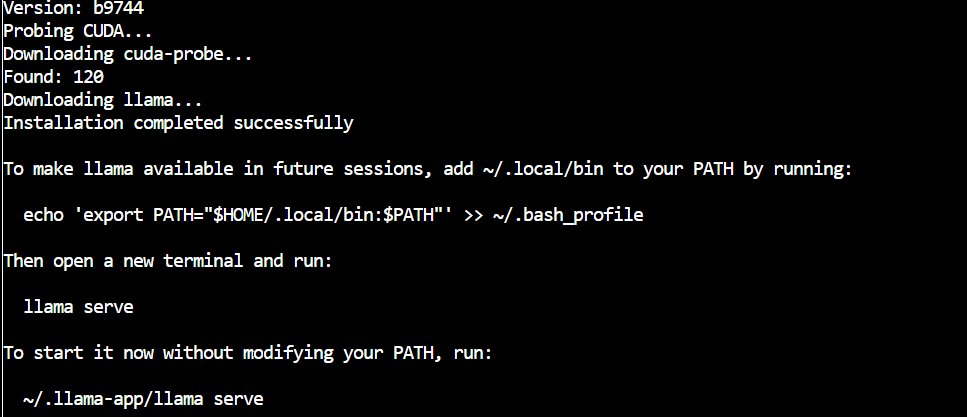
Selanjutnya, tambahkan llama.cpp ke PATH agar Anda dapat menjalankan perintah llama dari direktori mana pun, bahkan setelah memulai ulang terminal:
echo 'export PATH="$HOME/.local/bin:$PATH"' >> ~/.bashrc
source ~/.bashrc
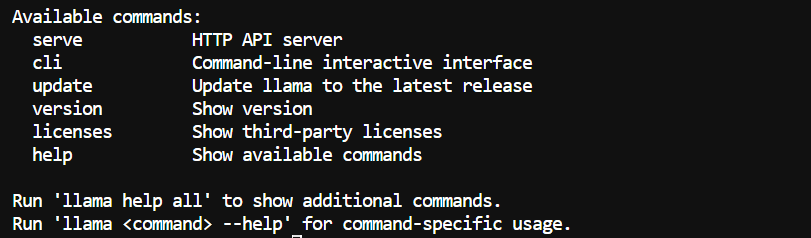
Terakhir, verifikasi bahwa pemasangan berhasil:
llama helpSekarang Anda seharusnya melihat perintah-perintah yang tersedia dari llama.cpp.
Selanjutnya, pasang CLI Hugging Face dan hf-xet. Ini memungkinkan Anda mengunduh file model langsung dari Hugging Face, termasuk repositori yang menggunakan penyimpanan Xet untuk file besar.
pip install -U "huggingface_hub[cli]" hf-xet Buat direktori untuk file model:
MODEL_DIR="/workspace/Fable5-Gemma4"
mkdir -p "$MODEL_DIR"
Aktifkan unduhan Xet yang lebih cepat, lalu unduh hanya file yang diperlukan untuk panduan ini:
export HF_XET_HIGH_PERFORMANCE=1


hf download \
  yuxinlu1/gemma-4-12B-agentic-fable5-composer2.5-v2-3.5x-tau2-GGUF \
  --include "gemma4-v2-Q4_K_M.gguf" \
  --include "MTP/gemma-4-12B-it-MTP-Q8_0.gguf" \
  --local-dir "$MODEL_DIR"
Ini mengunduh dua file:
gemma4-v2-Q4_K_M.gguf, model utama Fable 5 Enhanced Gemma 4.MTP/gemma-4-12B-it-MTP-Q8_0.gguf, model draf yang nantinya digunakan untuk MTP speculative decoding.Model Q4_K_M berukuran sekitar 7 GB. Waktu unduh bergantung pada koneksi internet Anda, tetapi menggunakan Xet dapat meningkatkan performa transfer untuk file model besar.
Setelah unduhan selesai, file Anda seharusnya tersimpan di sini:
/workspace/Fable5-Gemma4Sekarang mulai server lokal dengan model utama dan model draf MTP:
MODEL_DIR="/workspace/Fable5-Gemma4"

llama serve \
  --model "$MODEL_DIR/gemma4-v2-Q4_K_M.gguf" \
  --alias Fable5-Gemma4 \
  --model-draft "$MODEL_DIR/MTP/gemma-4-12B-it-MTP-Q8_0.gguf" \
  --spec-type draft-mtp \
  --spec-draft-n-max 2 \
  -ngl 99 \
  -ngld 99 \
  --ctx-size 262144 \
  --parallel 1 \
  --cache-type-k q8_0 \
  --cache-type-v q8_0 \
  --flash-attn on \
  --jinja \
  --temp 1.0 \
  --top-p 0.95 \
  --top-k 64 \
  --repeat-penalty 1.1 \
  --host 0.0.0.0 \
  --port 8910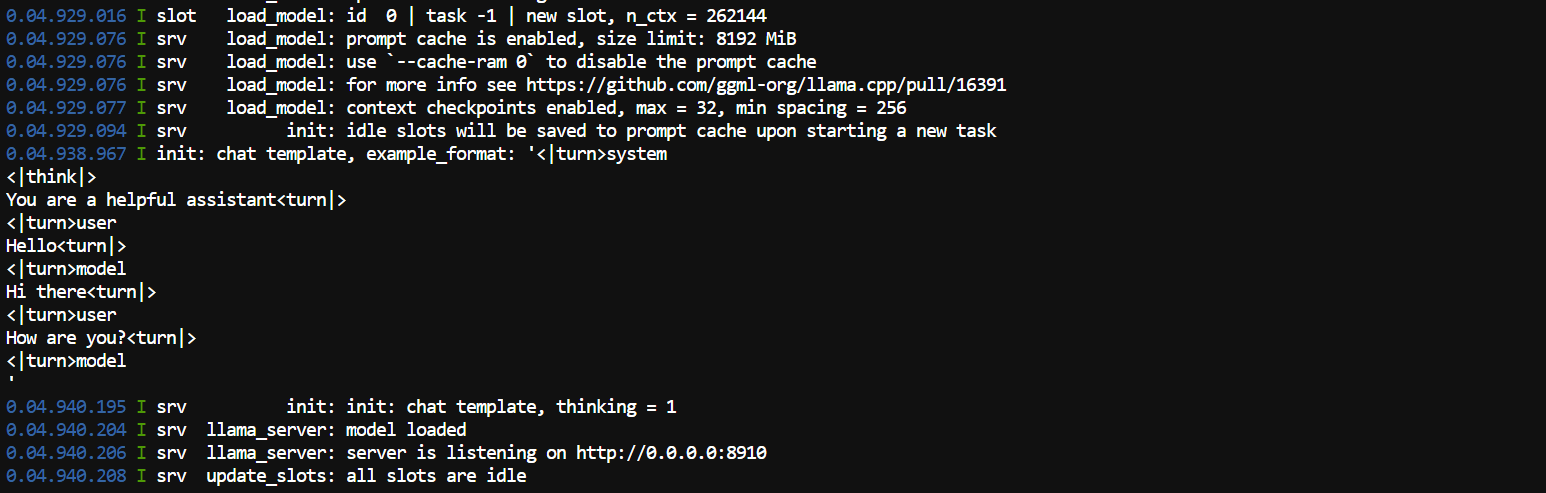
Argumen --model-draft memuat model draf MTP.
MTP berarti Multi Token Prediction. Model draf yang lebih kecil memprediksi beberapa token mendatang terlebih dahulu, dan model utama memverifikasinya secara paralel. Ini dapat meningkatkan kecepatan generasi tanpa mengubah peran model utama.
--spec-type draft-mtp mengaktifkan pengaturan MTP speculative decoding ini. --spec-draft-n-max 2 memungkinkan model draf mengusulkan hingga dua token sekaligus. Dua adalah titik awal yang masuk akal karena nilai yang lebih besar tidak selalu menghasilkan peningkatan kecepatan.
-ngl 99 memindahkan model utama ke GPU, sedangkan -ngld 99 melakukan hal yang sama untuk model draf MTP. Nilai 99 berarti mengalihkan semua lapisan yang tersedia.
--ctx-size 262144 menetapkan jendela konteks maksimum 256K token. Ini berguna untuk basis kode yang lebih besar dan sesi terminal yang panjang, tetapi juga memerlukan lebih banyak VRAM. --parallel 1 memesan seluruh konteks untuk satu permintaan aktif alih-alih membaginya di antara banyak pengguna.
Pengaturan KV-cache Q8 mengurangi memori yang dibutuhkan untuk jendela konteks panjang. --flash-attn on membantu membuat perhitungan attention lebih efisien, terutama dengan prompt panjang.
Biarkan --jinja aktif. Ini menerapkan template chat bawaan model agar prompt, penalaran, dan pemanggilan alat diformat dengan benar.
Pengaturan sampling yang tersisa mengontrol cara model menghasilkan teks. --temp 1.0, --top-p 0.95, dan --top-k 64 memungkinkan respons yang variatif, sementara --repeat-penalty 1.1 membantu mengurangi pengulangan teks.
Setelah server dimuat, buka WebUI:
http://localhost:8910 Anda juga dapat memeriksa penggunaan GPU dari terminal kedua:
nvidia-smi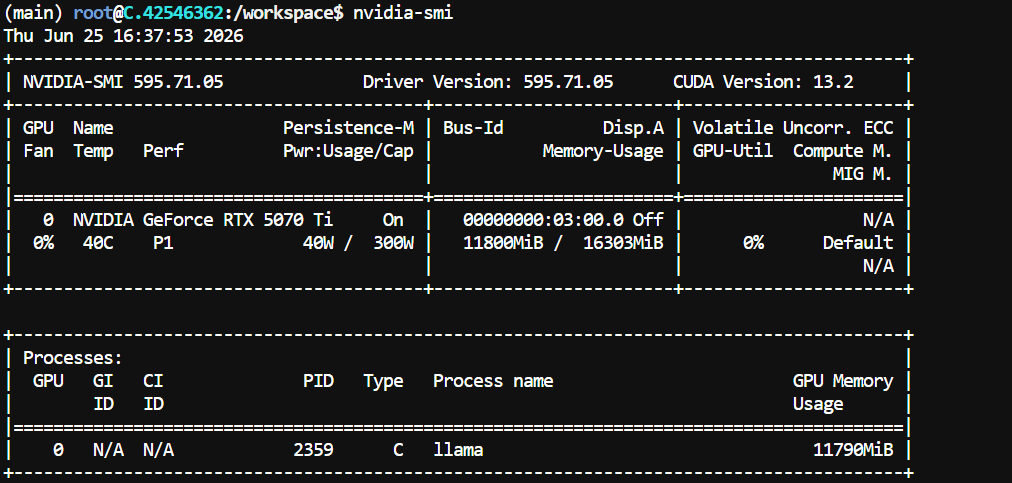
Pada setelan RTX 5070 Ti saya, model menggunakan sekitar 11,8 GB VRAM dengan konfigurasi konteks 256K, menyisakan lebih dari 4 GB yang tersedia.
Penggunaan memori Anda mungkin berbeda tergantung pada build llama.cpp, driver GPU, dan pengaturan konteks.
Biarkan terminal llama serve tetap berjalan, lalu buka terminal ketiga untuk menguji API lokal.
curl http://127.0.0.1:8910/v1/messages \
  -H "Content-Type: application/json" \
  -d '{
    "model": "Fable5-Gemma4",
    "max_tokens": 512,
    "messages": [
      {
        "role": "user",
        "content": "Create a simple Python script that prints Hello, I am running locally! "
      }
    ]
  }'
Responsnya harus berisi teks yang dihasilkan model, beserta keluaran pemikirannya. Dalam pengujian ini, model mengembalikan kode Python berikut:
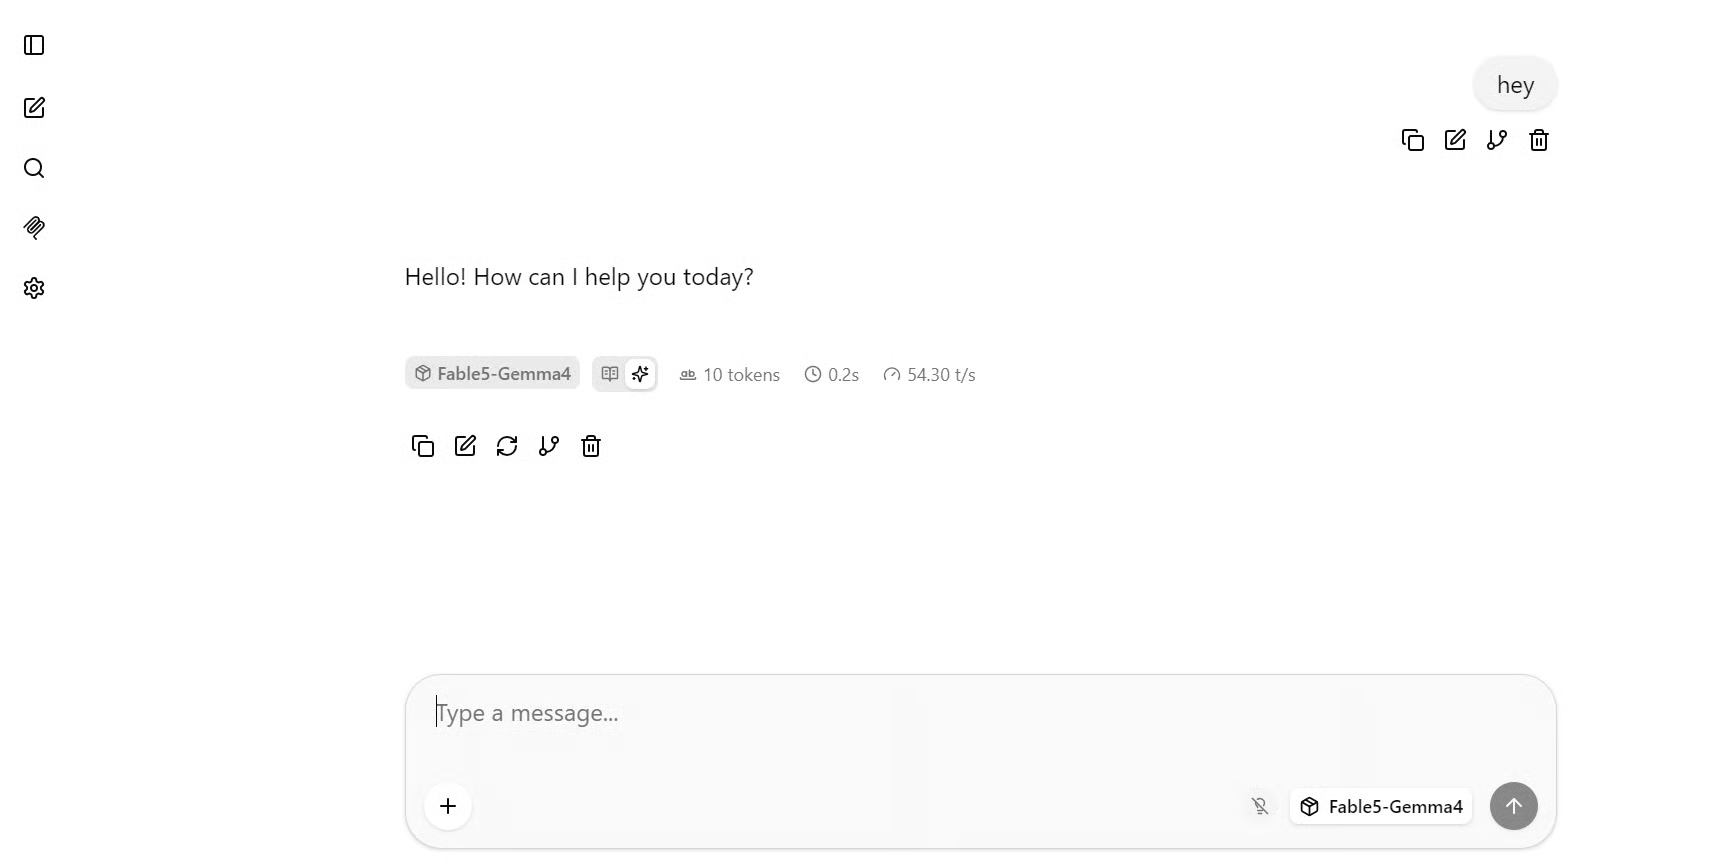
print("Hello, I am running locally!")Respons JSON mengonfirmasi bahwa server lokal berfungsi dengan benar. Dalam uji cepat saya, model menghasilkan sekitar 54 token per detik.
Anda juga dapat menggunakan antarmuka chat bawaan. Buka alamat berikut di browser Anda:
http://localhost:8910WebUI berfungsi seperti aplikasi chat biasa. Pilih model Fable5-Gemma4, tulis prompt, dan kirimkan ke server lokal.
Untuk uji pengkodean yang lebih besar, gunakan prompt ini:
Create a calming, premium spa treatment center website in one self-contained HTML file
with all CSS and JavaScript included inline, elegant booking CTAs, treatment packages,
therapist profiles, testimonials, and high-quality spa imagery.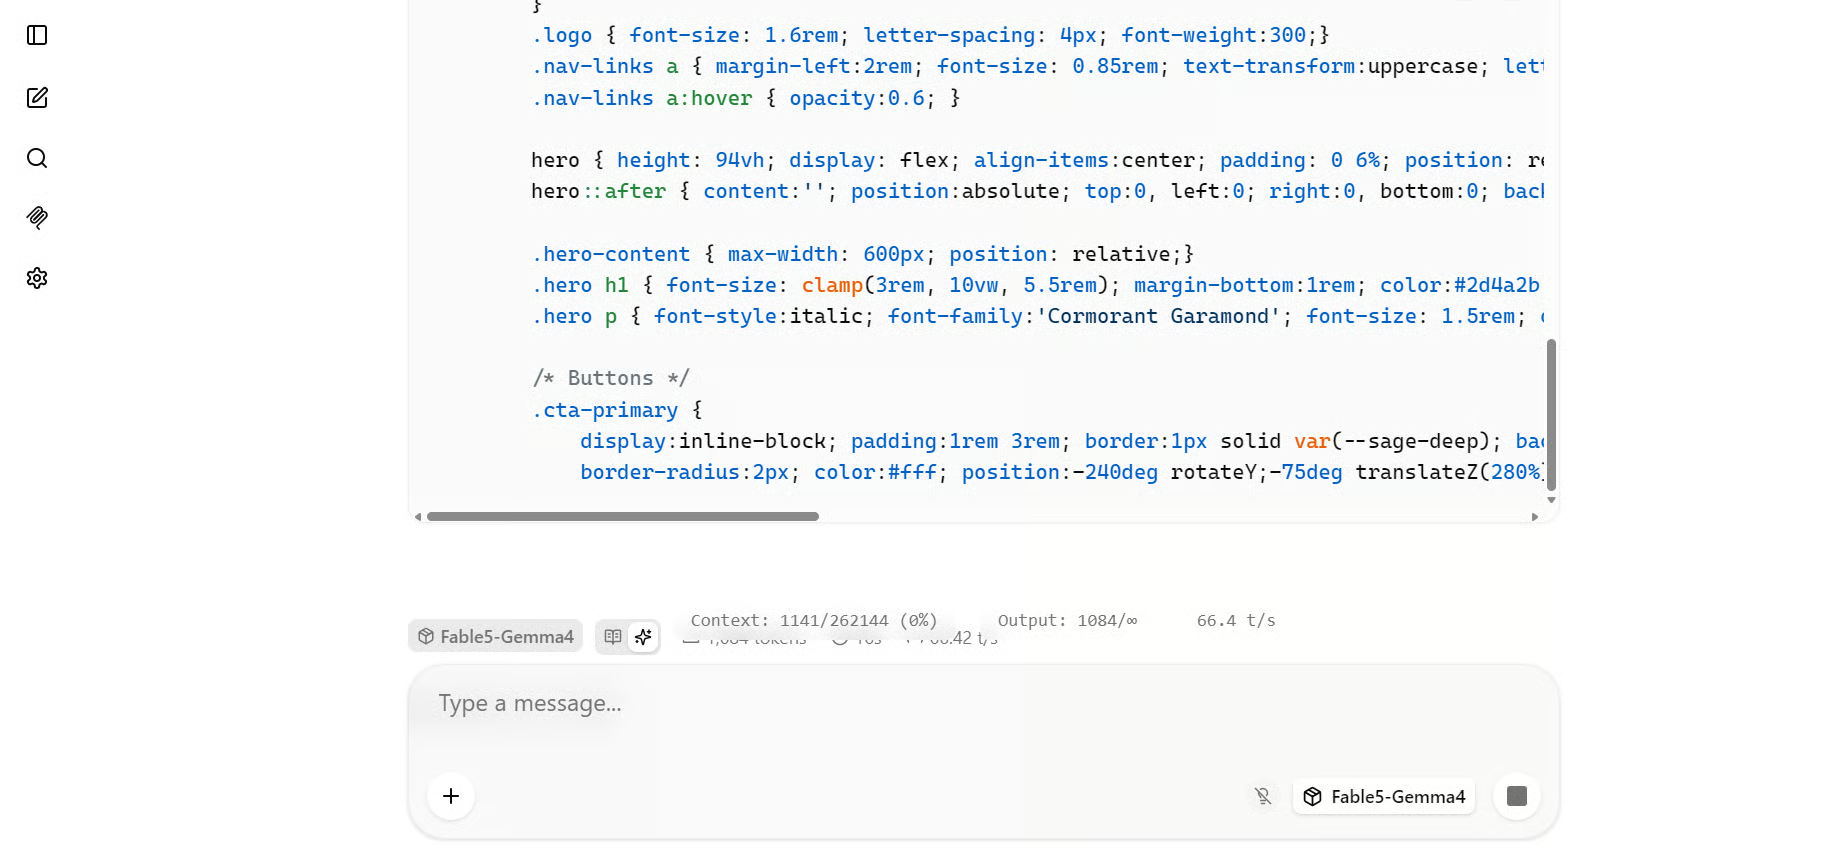
Untuk tugas pembuatan HTML yang lebih panjang ini, saya melihat sekitar 66 hingga 70 token per detik. Tugas pengkodean yang lebih panjang terkadang menghasilkan performa speculative decoding yang lebih baik karena model menghasilkan urutan token kode yang lebih kontinu dan dapat diprediksi.
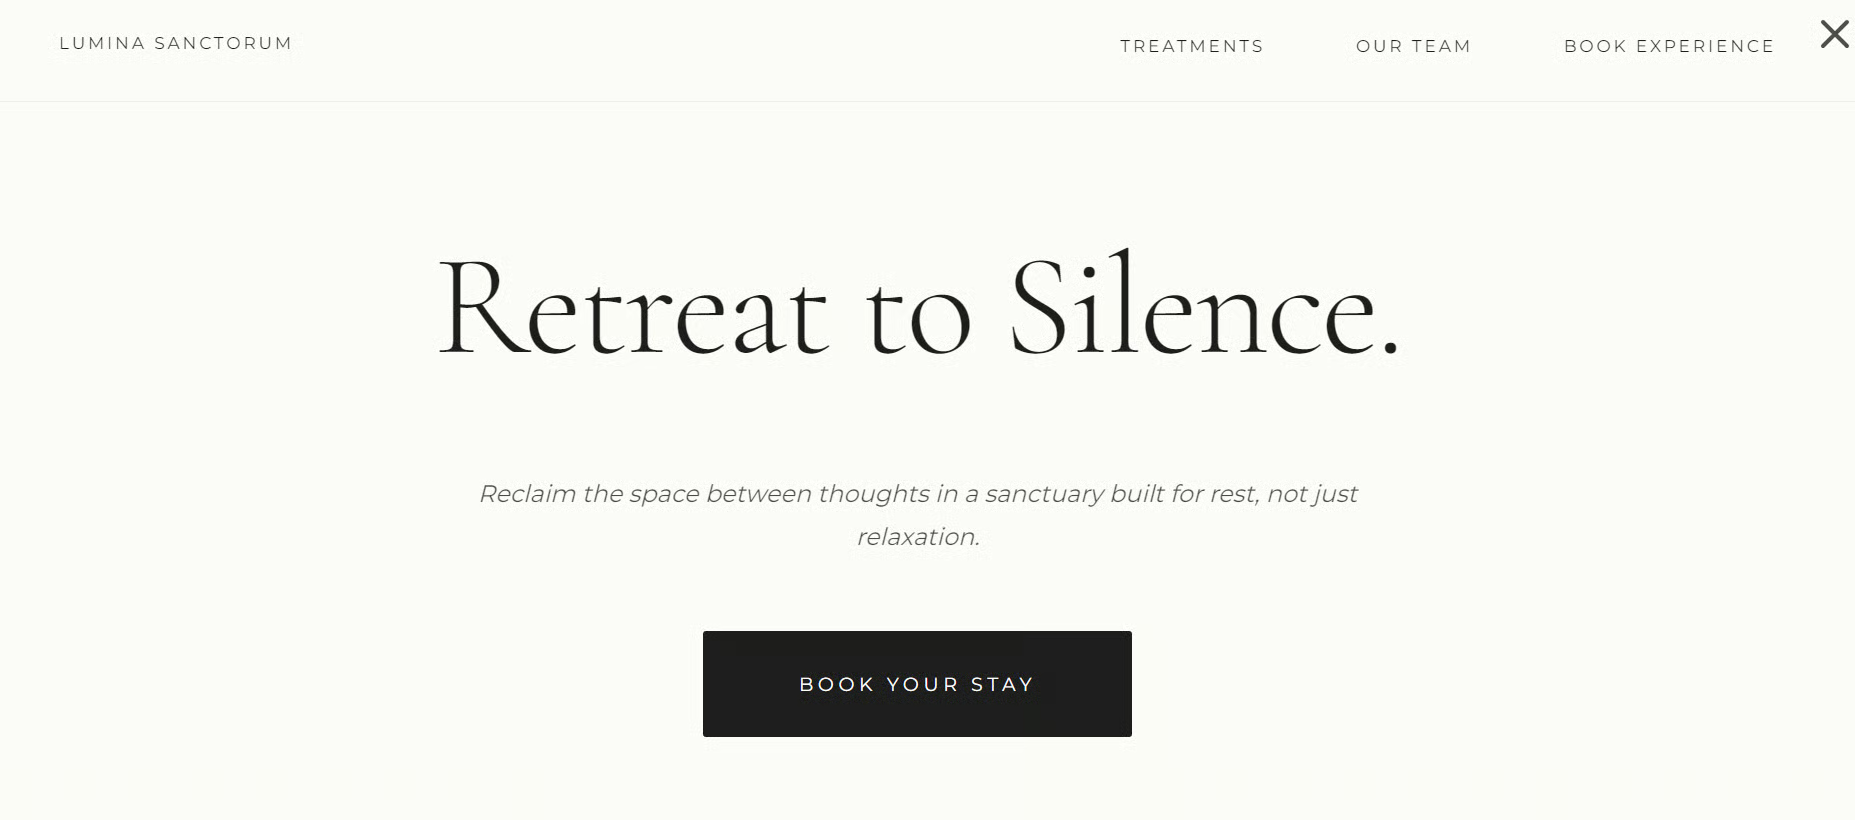
Hasil pertama di bawah ini dihasilkan dengan pengaturan reasoning Medium. Ia membuat landing page spa yang bersih dengan tata letak minimal, tautan navigasi, dan ajakan bertindak pemesanan yang besar.
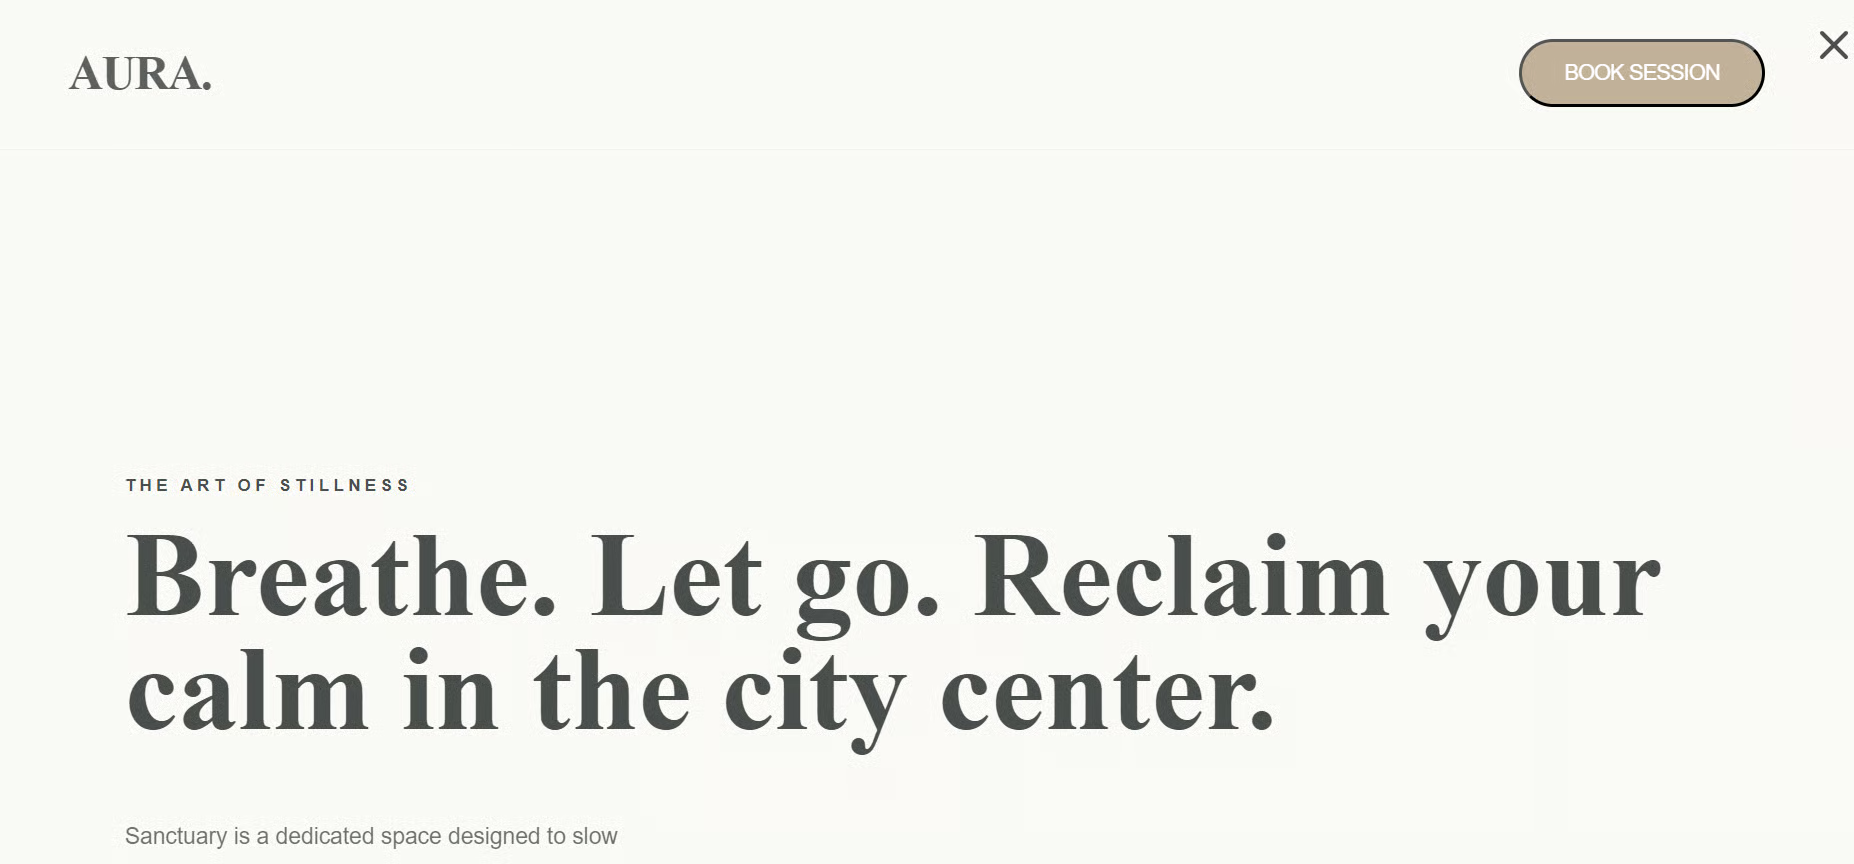
Hasil kedua dihasilkan tanpa reasoning. Ia menghasilkan arah visual yang berbeda, dengan tajuk utama yang lebih besar dan gaya landing page yang lebih editorial.
Kedua hasilnya terlihat rapi, tetapi versi dengan reasoning memberikan hasil yang lebih terstruktur dalam uji ini.
Kecepatan token dapat bervariasi tergantung panjang prompt, gaya keluaran, beban GPU, dan seberapa sering model utama menerima token draf yang diusulkan oleh MTP.
Pi adalah agen pengkodean terminal yang ringan. Ia dapat terhubung ke server Fable 5-Enhanced Gemma 4 lokal dan menggunakannya untuk membaca file, mengedit kode, menjalankan perintah, dan menyelesaikan tugas pengkodean.
Buka terminal keempat dan pasang Pi:
curl -fsSL https://pi.dev/install.sh | sh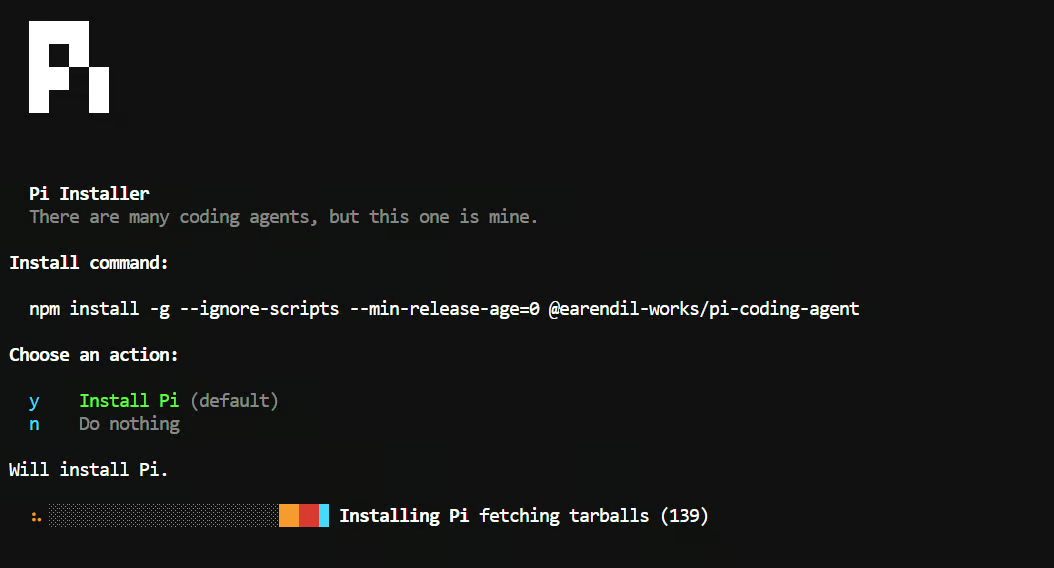 Penginstal mungkin meminta untuk memasang Node.js. Terima prompt tersebut dan tunggu hingga pemasangan selesai.
Muat ulang konfigurasi terminal Anda, lalu pastikan Pi tersedia:
source ~/.bashrc
pi --version
Selanjutnya, pasang plugin pi-llama:
pi install git:github.com/huggingface/pi-llamaPlugin ini menghubungkan Pi ke server llama.cpp yang berjalan dan secara otomatis menemukan model lokal yang tersedia.
Secara default, plugin mencari llama.cpp pada port 8080. Server kita menggunakan port 8910, jadi atur alamat API lokal yang benar sebelum memulai Pi:
export LLAMA_BASE_URL="http://127.0.0.1:8910/v1"Buat direktori proyek baru, inisialisasi Git, dan jalankan Pi:
mkdir -p /workspace/data-app
cd /workspace/data-app
git init
pi
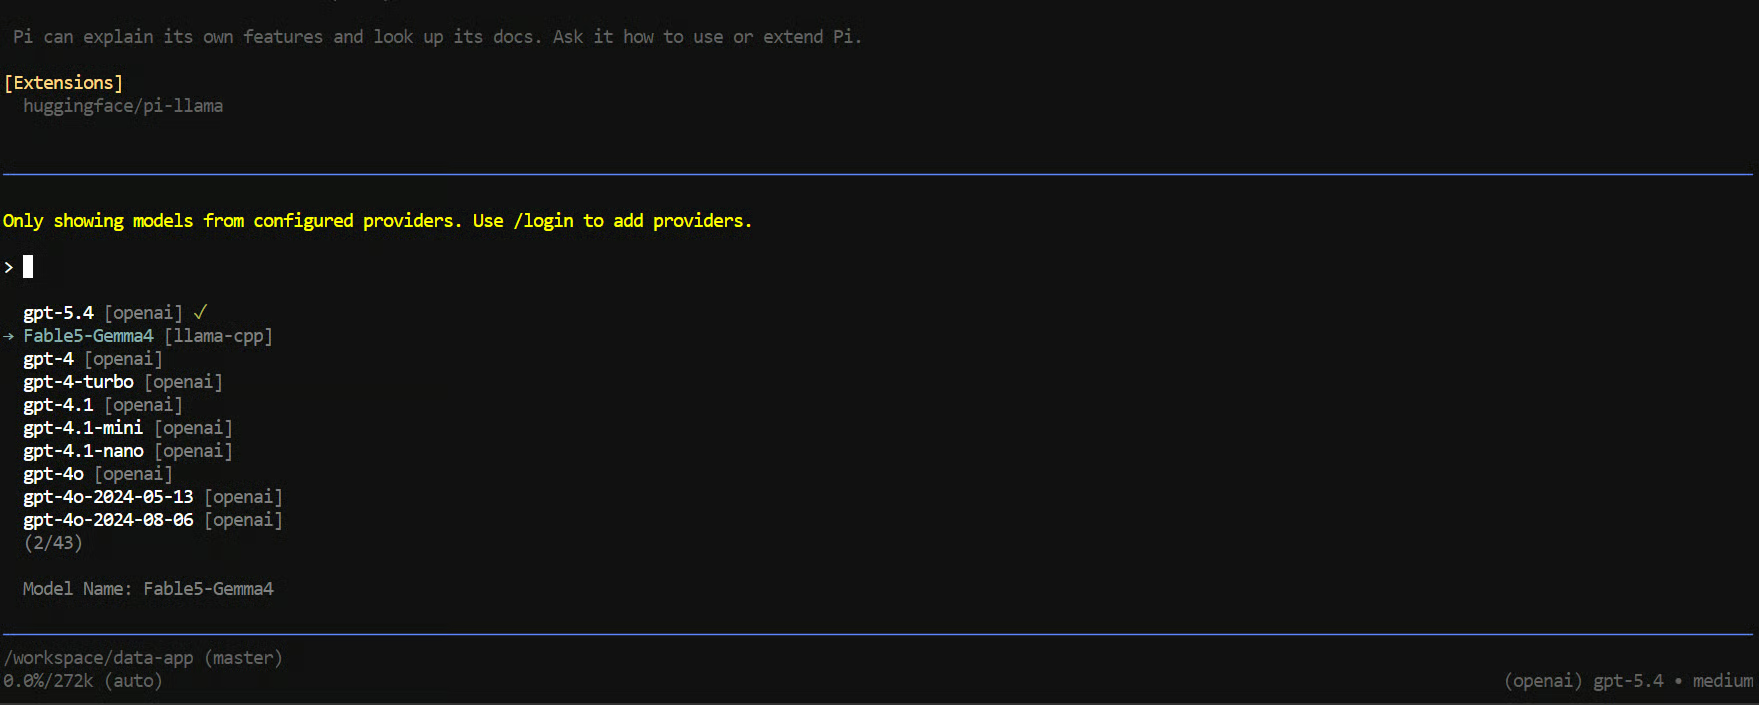
Di dalam Pi, ketik:
/modelPilih model “Fable5-Gemma4”.
Selanjutnya, berikan agen tugas pengkodean yang praktis:
Create a simple data analytics dashboard using Streamlit that lets users
upload a CSV file, view the data, and explore clear visualizations.
Include a sample CSV file and test the full app to make sure it works correctly.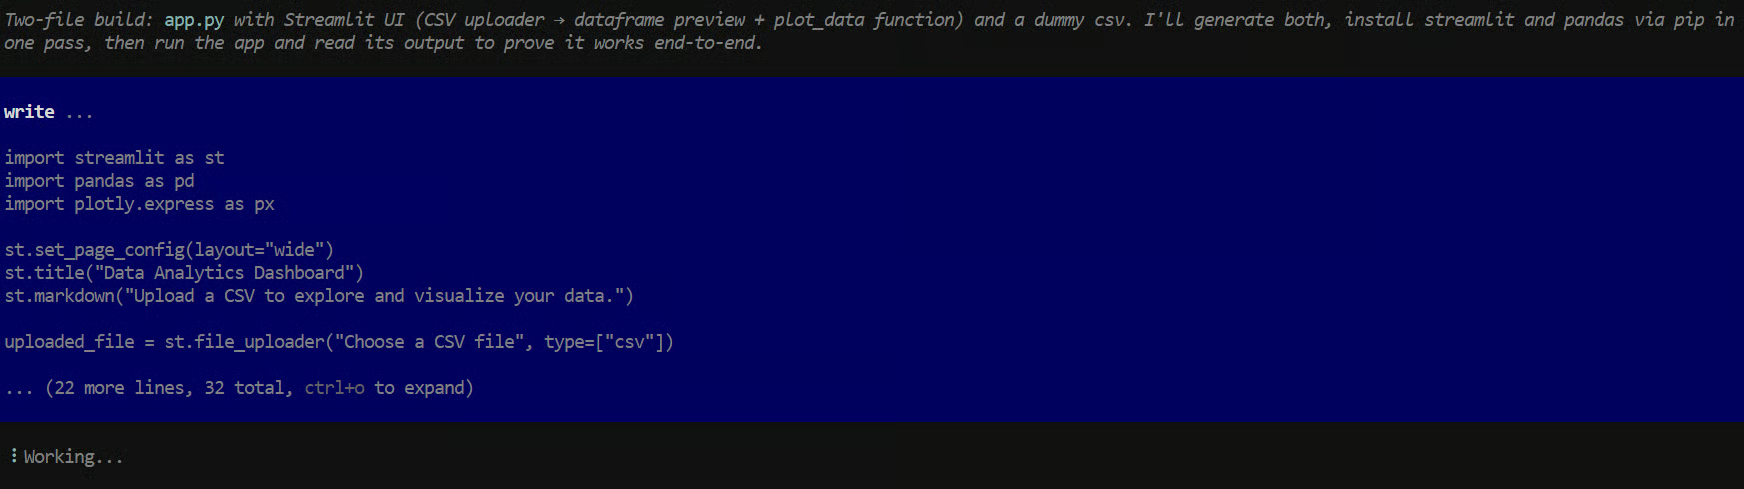
Model akhirnya membuat dashboard Streamlit yang berfungsi dengan dukungan unggah CSV dan visualisasi.
Namun, prosesnya jauh lebih sulit dari yang diharapkan.
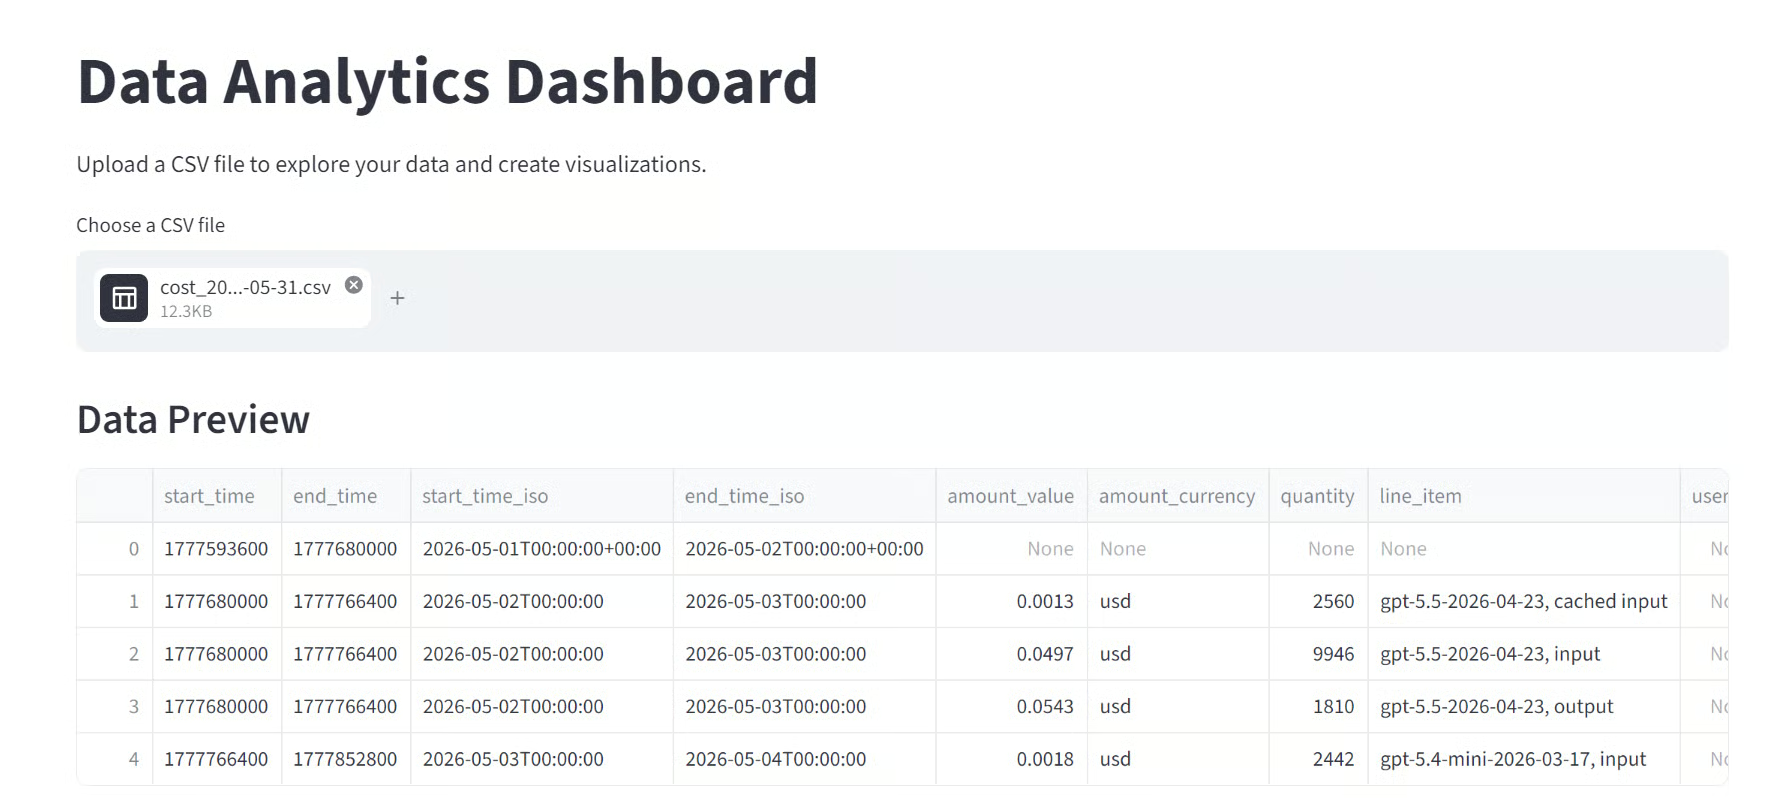
Model berulang kali kesulitan dengan pemanggilan alat, perintah terminal, dan penulisan file proyek.
Sering kali gagal menyelesaikan tindakan berikutnya setelah merencanakan apa yang harus dilakukan, sehingga saya harus terus membimbingnya melalui error dan mengulangi perintah.
Saya tidak dapat memastikan apakah ini disebabkan oleh model, integrasi Pi, perizinan lokal, atau kombinasi masalah tersebut.
Setelah sekitar 20 menit mencoba ulang, ia menghasilkan hasil yang berfungsi. Untuk tugas Streamlit yang relatif sederhana, ini terasa terlalu lambat dan tidak andal.
Tugas yang sama memakan waktu sekitar satu menit dengan GLM 5.2 dalam uji terpisah saya.
Memang tidak sepenuhnya adil membandingkan model lokal 12B dengan model frontier yang jauh lebih besar.
Namun, kesenjangannya tetap terasa.
Fable 5-Enhanced Gemma 4 dapat menghasilkan kode yang rapi dan keluaran single-turn yang kuat, tetapi performa agensinya yang nyata tidak konsisten dalam uji ini. Dibutuhkan terlalu banyak intervensi untuk tugas yang seharusnya dapat diselesaikan dengan cepat dan mandiri oleh coding agent yang mumpuni.
Kesimpulan saya adalah model ini menarik untuk eksperimen lokal, pembuatan kode privat, dan alur kerja ringan.
Namun berdasarkan uji ini, saya belum akan mengandalkannya untuk tugas coding-agent multi-langkah yang andal.
Meskipun panduan ini memberikan cara sederhana untuk menguji model, Anda mungkin menghadapi masalah tergantung pada perangkat keras, penyiapan lokal, dan build llama.cpp Anda.
Jika server crash saat memuat model draf MTP dan menampilkan error seperti:
invalid vector subscriptMasalahnya mungkin pada build llama.cpp Anda, bukan pada file model.
Repositori model melaporkan bahwa build llama.cpp b9553 berfungsi dengan model draf MTP Gemma 4, sementara build yang lebih baru seperti b9702 dan b9717 dapat gagal saat pemuatan model draf.
Sebagai langkah cepat, hapus argumen MTP dari perintah server dan jalankan hanya model utama. Model tetap akan berfungsi dengan benar, tetapi generasi mungkin lebih lambat.
Hapus baris-baris ini:
--model-draft "$MODEL_DIR/MTP/gemma-4-12B-it-MTP-Q8_0.gguf"
--spec-type draft-mtp
--spec-draft-n-max 2
-ngld 99Jika Anda melihat token seperti <|tool_call> atau <|channel> dalam respons, klien tidak menerapkan format pemanggilan alat asli Gemma 4 dengan benar.
Pastikan perintah server Anda menyertakan:
--jinjaLalu mulai ulang server. Ini menerapkan template chat yang benar untuk penalaran model dan pemanggilan alat terstruktur.
Pertama, periksa apakah server llama.cpp masih berjalan:
curl http://127.0.0.1:8910/v1/modelsAnda seharusnya melihat Fable5-Gemma4 dalam respons.
Selanjutnya, pastikan Pi diarahkan ke port 8910 alih-alih port default llama.cpp 8080:
export LLAMA_BASE_URL="http://127.0.0.1:8910/v1"
pi
Jalankan kedua perintah dalam sesi terminal yang sama.
Mulai Pi di dalam direktori proyek yang dapat ditulis:
cd /workspace/data-app
pi
Anda dapat menguji apakah direktori saat ini memungkinkan pembuatan file:
touch write-test.txt && rm write-test.txtJika perintah ini gagal, masalahnya adalah perizinan workspace, bukan model. Pindah ke direktori yang dapat ditulis sebelum meluncurkan Pi.
Jika model mulai mengulang teks, angka, atau simbol, periksa pengaturan sampling pada perintah server Anda.
Gunakan nilai berikut:
--temp 1.0 \
--top-p 0.95 \
--top-k 64 \
--repeat-penalty 1.1
Penalti pengulangan sangat penting. Tanpanya, model dapat menghasilkan output yang berulang atau kacau.
Jendela konteks 256K memerlukan KV cache yang besar. Jika server kehabisan VRAM, kurangi ukuran konteks terlebih dahulu:
--ctx-size 32768Anda juga bisa menonaktifkan model draf MTP untuk membebaskan lebih banyak VRAM. Periksa penggunaan memori GPU Anda saat ini dengan:
nvidia-smiModel dapat menghasilkan kode yang kuat, tetapi masih mungkin kesulitan menyelesaikan tugas yang lebih panjang tanpa intervensi. Dalam pengujian saya, terkadang ia merencanakan tindakan yang benar tetapi gagal saat menjalankan perintah, menulis file, atau melanjutkan setelah error.
Untuk hasil yang lebih baik, pecah permintaan besar menjadi tugas-tugas yang lebih kecil:
Ini memberi model sasaran yang lebih kecil di setiap langkah dan memudahkan untuk mengidentifikasi apakah kegagalan berasal dari model, Pi, server, atau perizinan workspace.
Saya tidak berpikir hype seputar model ini sepenuhnya beralasan, setidaknya berdasarkan pengujian saya. Dengan dan tanpa MTP, saya mendapatkan kecepatan hampir sama untuk tugas umum. Selama tugas pengkodean, MTP memang membantu, dan saya melihat peningkatan kecepatan sekitar 20% hingga 30%. Itu berguna, tetapi tidak memperbaiki masalah yang lebih besar: keandalan.
Saya juga menguji model ini di WebUI.
Terkadang, saat menulis kode untuk sebuah file, ia tiba-tiba berhenti tanpa alasan yang jelas. Saat saya memintanya melanjutkan, ia menulis kelanjutannya sebagai teks pada respons chat berikutnya alih-alih benar-benar melanjutkan file.
Saya juga melihat bahwa mengaktifkan pemikiran terkadang membuat keluaran menjadi lebih buruk, yang cukup mengejutkan.
Saya juga mengujinya dengan Claude Code, dan pengalaman itu bahkan lebih membuat frustrasi.
Model terus membuat file tambahan, file sementara, dan hal-hal lain yang tidak relevan yang tidak dibutuhkan oleh proyek sederhana. Akhirnya tugas selesai, tetapi butuh terlalu banyak panduan dan terlalu banyak waktu.
Saya tahu membandingkan model lokal 12B dengan GPT-5.5 atau GLM 5.2 tidak sepenuhnya adil. Namun bahkan dibandingkan dengan model lokal yang lebih kecil, saya tidak terkesan.
Menurut pengalaman saya, Qwen3.6 27B jauh lebih baik untuk tugas pengkodean dan agensi, meskipun ukurannya lebih besar.
Untuk saat ini, saya melihat model ini lebih sebagai eksperimen menarik daripada coding agent yang dapat diandalkan.
Saya lebih tertarik pada model Qwen3.6 27B yang di-tune Fable yang akan datang dari pembuat yang sama. Saya juga melihat beberapa kontributor open-source lainnya merilis model distilasi pengkodean serupa, tetapi sejauh ini, saya belum melihat peningkatan besar dalam tugas coding-agent nyata.
Model ini dapat menghasilkan kode yang enak dilihat dan keluaran single-turn yang rapi. Namun saat Anda memintanya bekerja seperti agen, menggunakan alat, membuat file, memperbaiki error, dan memverifikasi hasil, model ini masih terasa tidak konsisten dan membuat frustrasi untuk digunakan.
Kursus Teratas di DataCamp
Kursus
Kursus
Program
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt