
Cursus
Geavanceerd AI-ondersteund coderen voor ontwikkelaars
1 uur 30 min
1.8K
Nadat Fable 5 en Mythos 5 werden stopgezet, begonnen open-sourc ontwikkelaars te experimenteren met kleinere lokale modellen die getraind zijn op hoogwaardige synthetische codeer- en agentdata. Fable 5-Enhanced Gemma 4 is daar een voorbeeld van.
Het is een Gemma 4 12B fine-tune, getraind op datasets die zijn gegenereerd door Fable 5 en Composer 2.5. Het doel is om nuttig codeer- en agentgedrag over te brengen naar een kleiner model dat lokaal kan draaien.
De training richt zich op praktische workflows, zoals een taak begrijpen, bestanden lezen, tools gebruiken, code bewerken, commando’s uitvoeren en het eindresultaat verifiëren.
In deze gids laat ik je zien hoe je het Fable 5-enhanced Gemma 4-model lokaal draait op een RTX 5070 Ti met llama.cpp.
We installeren llama.cpp, downloaden het GGUF-model en het MTP-draftmodel, starten een lokale server die compatibel is met OpenAI, en testen deze met cURL en de ingebouwde WebUI.
Tot slot verbinden we het model met Pi Coding Agent en geven we het een echte coderingstaak. De hoofdvraag is of dit compacte 12B-model bruikbaar agentgedrag voor coderen kan leveren en kan concurreren met grotere lokale modellen zoals Qwen 3.6 27B of Gemma 4 31B.
Fable 5-Enhanced Gemma 4 is een compact codeer- en agentmodel gebaseerd op Google’s Gemma 4 12B instructiemodel. Het is gemaakt door Yuxin Lu en uitgebracht in GGUF-formaat voor lokaal gebruik met llama.cpp en andere compatibele tools.
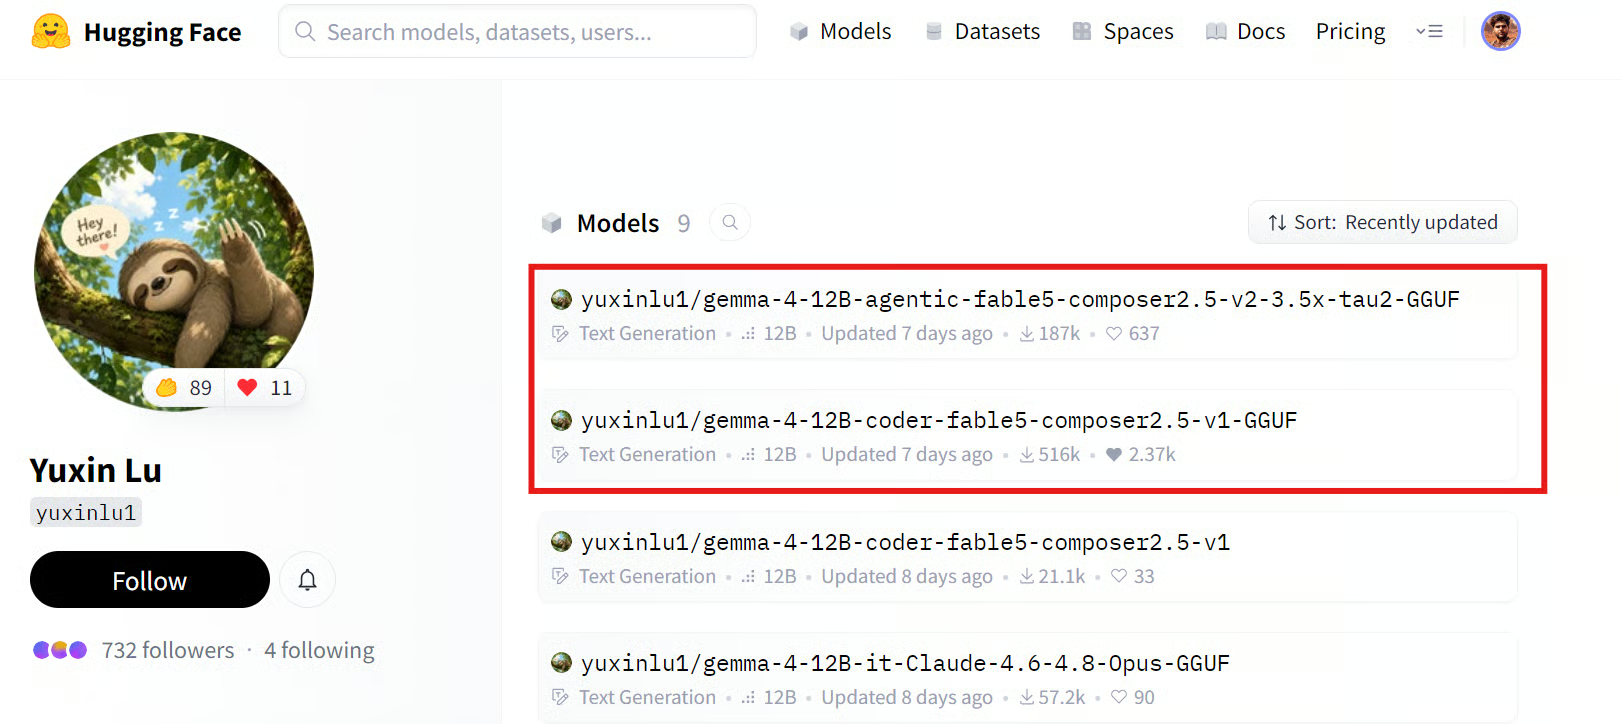
Bron: yuxinlu1 (Yuxin Lu)
Deze gids gebruikt de v2-release. Die bouwt voort op het v1-codeermodel maar legt een sterkere nadruk op technisch agentwerk.
In plaats van alleen code te genereren, is het ontworpen om bestanden te inspecteren, door problemen te redeneren, tools te gebruiken, code te bewerken, commando’s uit te voeren en het eindresultaat te verifiëren.
Het oorspronkelijke model is fijn-afgesteld op gevalideerde Python-codeerdata die zijn gegenereerd door Composer 2.5 en Fable 5.
De hoofdtrainingsset gebruikt Composer 2.5 redeneringssporen en codeoplossingen voor Python-taken met deterministische tests. Alleen voorbeelden waarbij de gegenereerde code de tests doorstond, zijn behouden.
Fable 5 werd gebruikt voor moeilijkere taken waar Composer 2.5 faalde. Het genereerde een nieuw redeneerproces en gecorrigeerde oplossingen voor deze voorbeelden, die ook via uitvoering zijn geverifieerd voordat ze aan de trainingsdata werden toegevoegd.
Voor v2 voegt het model meerstaps terminal- en toolgebruik-trajecten toe. Die leren het om een lees-, redeneer-, handel- en verifieerworkflow te volgen in plaats van één antwoord te geven en te stoppen.
Nadat Fable 5 onbeschikbaar werd, zijn enkele ontbrekende Fable 5-achtige redeneringssporen herbouwd met Opus 4.8.
--jinja ingeschakeld in llama.cpp zodat het model Gemma 4’s beoogde chattemplate en tool-call-formaat kan gebruiken.In een lokale tau2-bench telecom-vergelijking haalde het v2-model ongeveer 55%, vergeleken met ongeveer 15% voor het basis Gemma 4 12B instructiemodel.
Dit suggereert dat de belangrijkste verbetering voortkomt uit agentgedrag. Het fijn-afgestelde model is beter in het inspecteren van een taak, de volgende actie ondernemen, tools gebruiken en resultaten verifiëren, in plaats van te stoppen na een eerste reactie.
Dit is de snelste en eenvoudigste manier om llama.cpp op een Linux-machine te installeren. In plaats van de repository te clonen en vanaf de bron te compileren, downloadt de installer een vooraf gebouwde binary en zet die voor je klaar.
Voer het volgende commando uit in je terminal:
curl -LsSf https://llama.app/install.sh | shBinnen enkele seconden downloadt de installer de llama.cpp-binary en rondt de installatie af.
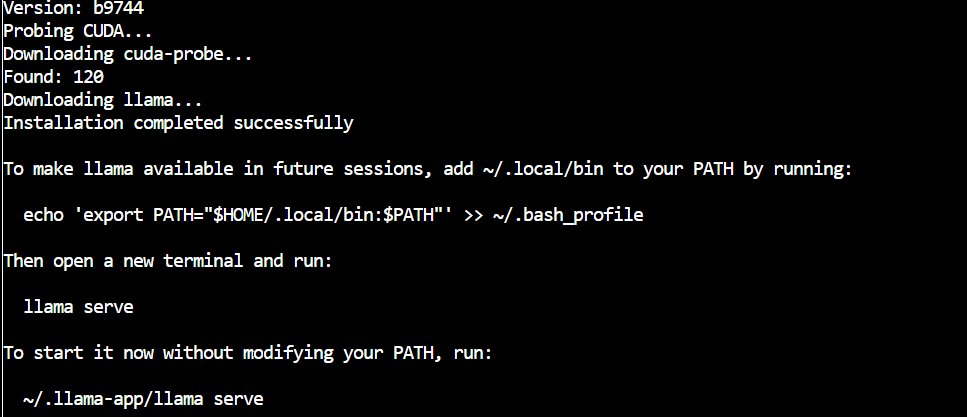
Voeg vervolgens llama.cpp toe aan je PATH zodat je het llama-commando vanuit elke map kunt uitvoeren, ook na het herstarten van de terminal:
echo 'export PATH="$HOME/.local/bin:$PATH"' >> ~/.bashrc
source ~/.bashrc
Controleer tot slot of de installatie is gelukt:
llama helpJe zou nu de beschikbare llama.cpp-commando’s moeten zien.
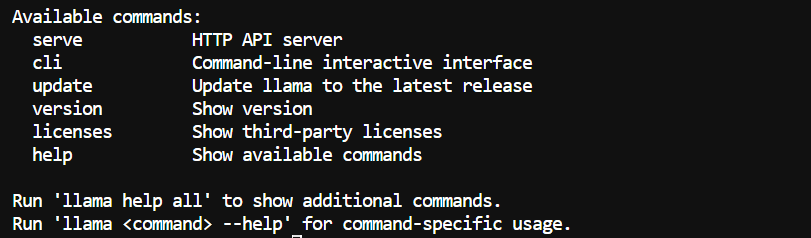
Installeer vervolgens de Hugging Face CLI en hf-xet. Hiermee kun je modelbestanden rechtstreeks van Hugging Face downloaden, inclusief repositories die Xet-opslag gebruiken voor grote bestanden.
pip install -U "huggingface_hub[cli]" hf-xet Maak een map voor de modelbestanden:
MODEL_DIR="/workspace/Fable5-Gemma4"
mkdir -p "$MODEL_DIR"
Schakel snellere Xet-downloads in en download vervolgens alleen de bestanden die voor deze gids nodig zijn:
export HF_XET_HIGH_PERFORMANCE=1


hf download \
  yuxinlu1/gemma-4-12B-agentic-fable5-composer2.5-v2-3.5x-tau2-GGUF \
  --include "gemma4-v2-Q4_K_M.gguf" \
  --include "MTP/gemma-4-12B-it-MTP-Q8_0.gguf" \
  --local-dir "$MODEL_DIR"
Dit downloadt twee bestanden:
gemma4-v2-Q4_K_M.gguf, het hoofdmodel Fable 5 Enhanced Gemma 4.MTP/gemma-4-12B-it-MTP-Q8_0.gguf, het draftmodel dat later wordt gebruikt voor MTP speculatieve decodering.Het Q4_K_M-model is ongeveer 7 GB. De downloadtijd hangt af van je internetverbinding, maar Xet kan de overdrachtsprestaties voor grote modelbestanden verbeteren.
Zodra de download is voltooid, zouden je bestanden hier moeten staan:
/workspace/Fable5-Gemma4Start nu de lokale server met het hoofdmodel en het MTP-draftmodel:
MODEL_DIR="/workspace/Fable5-Gemma4"

llama serve \
  --model "$MODEL_DIR/gemma4-v2-Q4_K_M.gguf" \
  --alias Fable5-Gemma4 \
  --model-draft "$MODEL_DIR/MTP/gemma-4-12B-it-MTP-Q8_0.gguf" \
  --spec-type draft-mtp \
  --spec-draft-n-max 2 \
  -ngl 99 \
  -ngld 99 \
  --ctx-size 262144 \
  --parallel 1 \
  --cache-type-k q8_0 \
  --cache-type-v q8_0 \
  --flash-attn on \
  --jinja \
  --temp 1.0 \
  --top-p 0.95 \
  --top-k 64 \
  --repeat-penalty 1.1 \
  --host 0.0.0.0 \
  --port 8910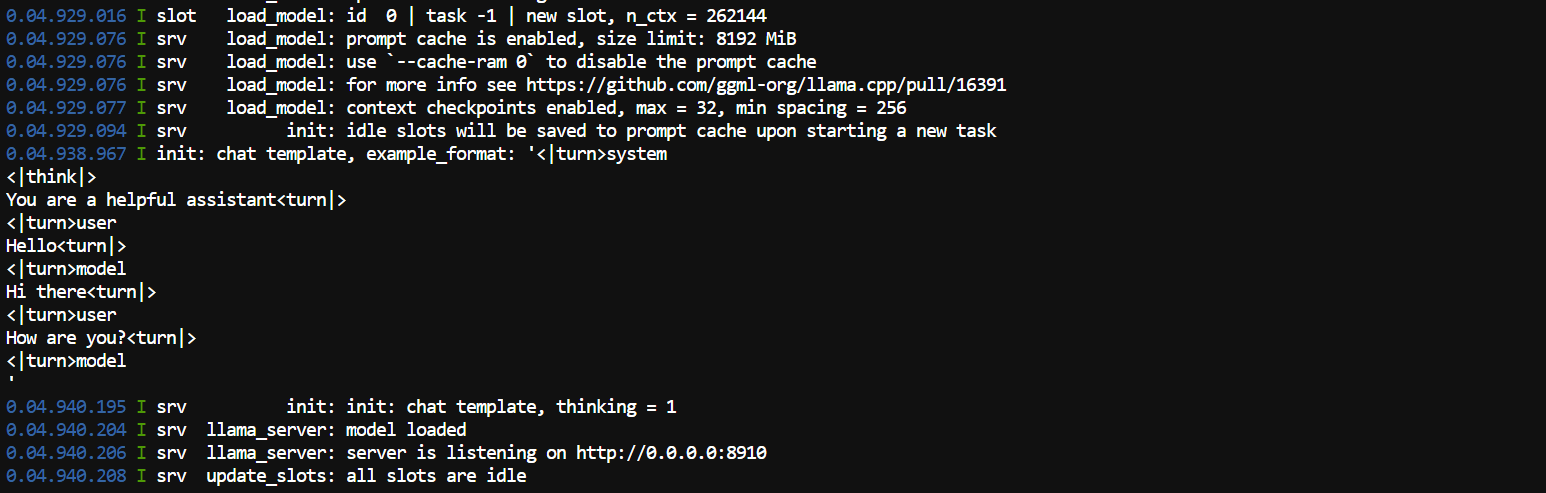
Het argument --model-draft laadt het MTP-draftmodel.
MTP betekent Multi Token Prediction. Het kleinere draftmodel voorspelt eerst een paar aankomende tokens en het hoofdmodel verifieert die parallel. Dit kan de genereersnelheid verbeteren zonder de rol van het hoofdmodel te veranderen.
--spec-type draft-mtp schakelt deze MTP speculatieve decodering in. --spec-draft-n-max 2 laat het draftmodel tot twee tokens tegelijk voorstellen. Twee is een logisch startpunt, omdat grotere waarden niet altijd snelheidswinst opleveren.
-ngl 99 verplaatst het hoofdmodel naar de GPU, terwijl -ngld 99 hetzelfde doet voor het MTP-draftmodel. De waarde 99 betekent simpelweg: alle beschikbare lagen offloaden.
--ctx-size 262144 stelt een maximale contextwindow van 256K tokens in. Dit is handig voor grotere codebases en lange terminalsessies, maar vereist ook meer VRAM. --parallel 1 reserveert de volledige context voor één actieve aanvraag in plaats van deze over meerdere gebruikers te verdelen.
De Q8 KV-cache-instellingen verlagen het geheugen dat nodig is voor het lange contextvenster. --flash-attn on maakt aandachtberekeningen efficiënter, vooral bij lange prompts.
Laat --jinja ingeschakeld. Dit past de ingebouwde chattemplate van het model toe, zodat prompts, redenering en tool-calls correct worden geformatteerd.
De overige sampling-instellingen bepalen hoe het model tekst genereert. --temp 1.0, --top-p 0.95 en --top-k 64 zorgen voor gevarieerde reacties, terwijl --repeat-penalty 1.1 helpt herhaling te verminderen.
Zodra de server is geladen, open je de WebUI:
http://localhost:8910 Je kunt ook het GPU-gebruik controleren vanuit een tweede terminal:
nvidia-smi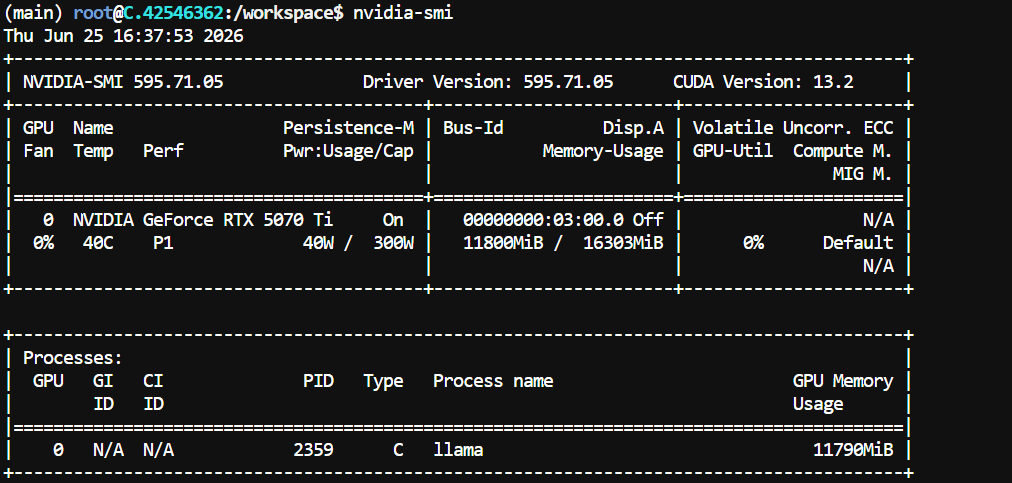
Op mijn RTX 5070 Ti-setup gebruikte het model ongeveer 11,8 GB VRAM met de 256K-contextconfiguratie, met meer dan 4 GB over.
Je geheugengebruik kan variëren afhankelijk van de llama.cpp-build, GPU-driver en contextinstellingen.
Laat de llama serve-terminal draaien en open vervolgens een derde terminal om de lokale API te testen.
curl http://127.0.0.1:8910/v1/messages \
  -H "Content-Type: application/json" \
  -d '{
    "model": "Fable5-Gemma4",
    "max_tokens": 512,
    "messages": [
      {
        "role": "user",
        "content": "Create a simple Python script that prints Hello, I am running locally! "
      }
    ]
  }'
De reactie zou de door het model gegenereerde tekst moeten bevatten, samen met zijn denkoutput. In deze test gaf het model de volgende Python-code terug:
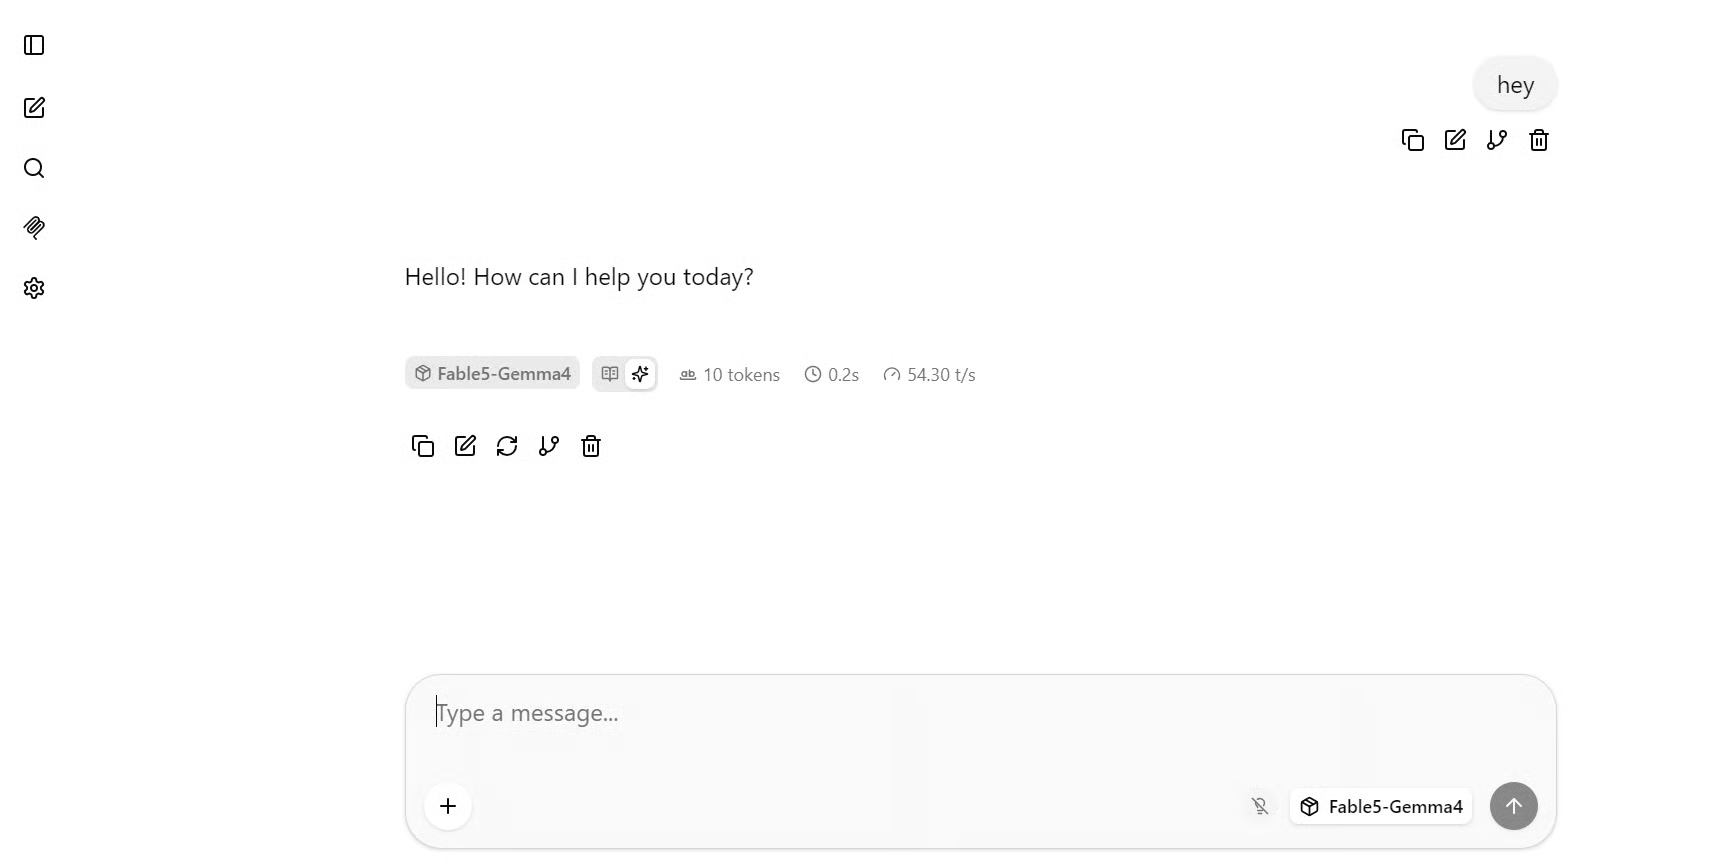
print("Hello, I am running locally!")Een JSON-reactie bevestigt dat de lokale server correct werkt. In mijn snelle test genereerde het model met ongeveer 54 tokens per seconde.
Je kunt ook de ingebouwde chatinterface gebruiken. Open het volgende adres in je browser:
http://localhost:8910De WebUI werkt als een normale chatapplicatie. Selecteer het Fable5-Gemma4-model, schrijf een prompt en stuur die naar de lokale server.
Voor een grotere coderingstest kun je deze prompt gebruiken:
Create a calming, premium spa treatment center website in one self-contained HTML file
with all CSS and JavaScript included inline, elegant booking CTAs, treatment packages,
therapist profiles, testimonials, and high-quality spa imagery.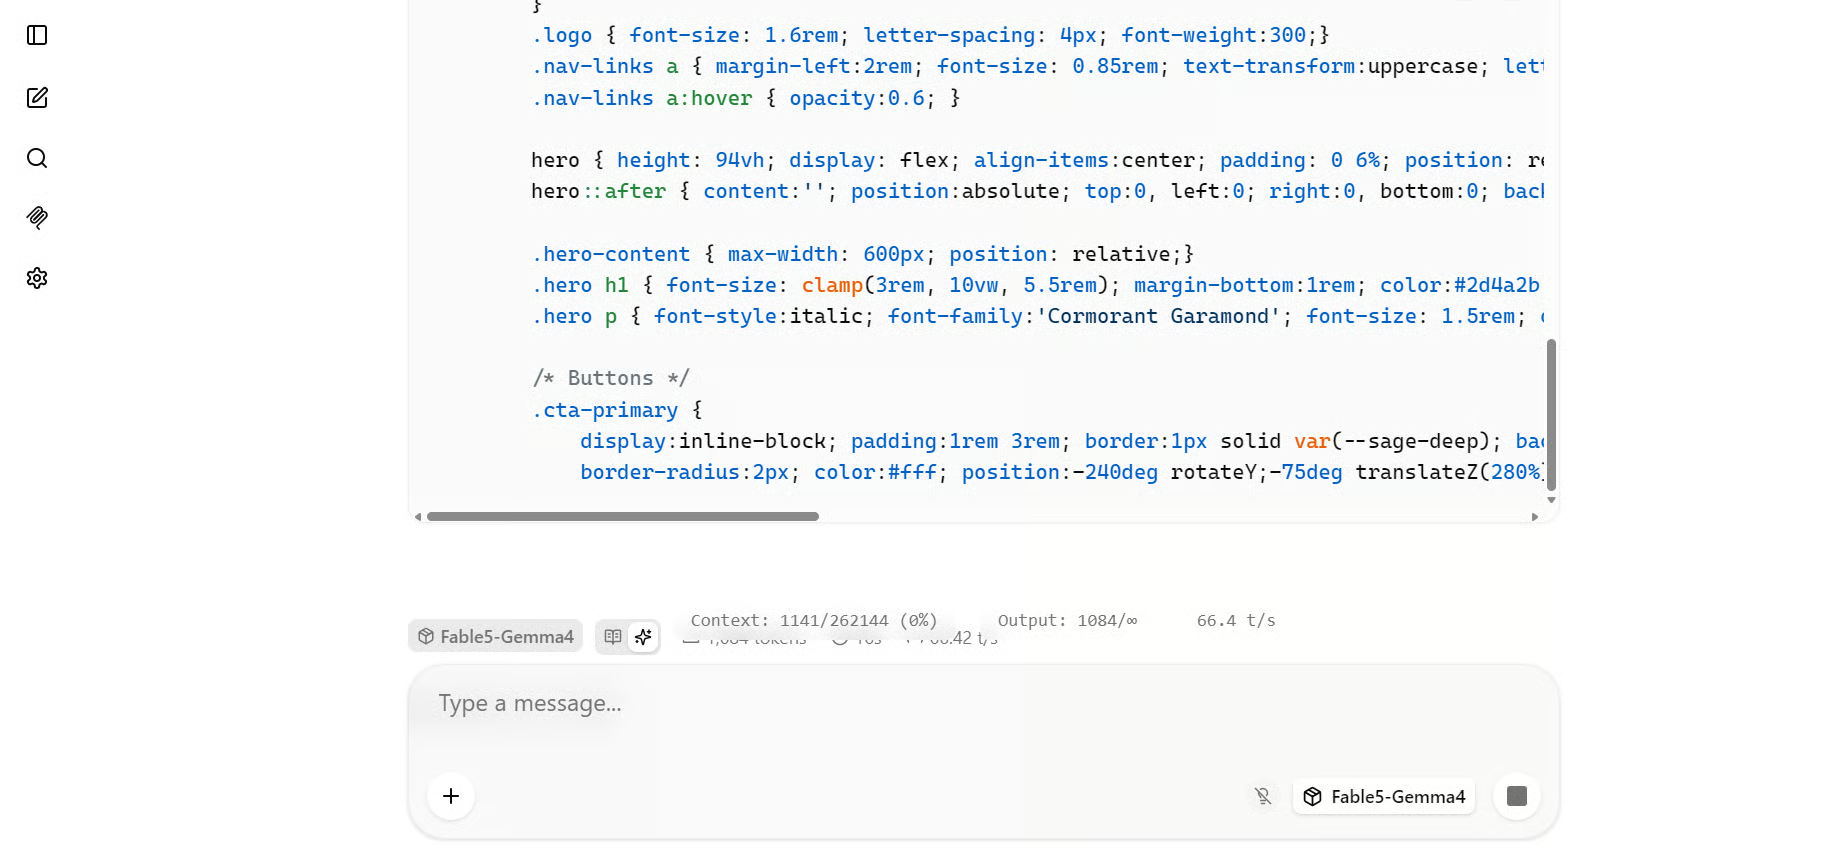
Voor deze langere HTML-generatietaak zag ik ongeveer 66 tot 70 tokens per seconde. Langere coderingstaken kunnen soms betere prestaties bij speculatieve decodering opleveren, omdat het model een meer continue reeks voorspelbare codetokens genereert.
Het eerste resultaat hieronder is gegenereerd met redeneren ingesteld op Medium. Het maakte een strakke spa-landingspagina met een minimale lay-out, navigatielinks en een grote boekings-CTA.
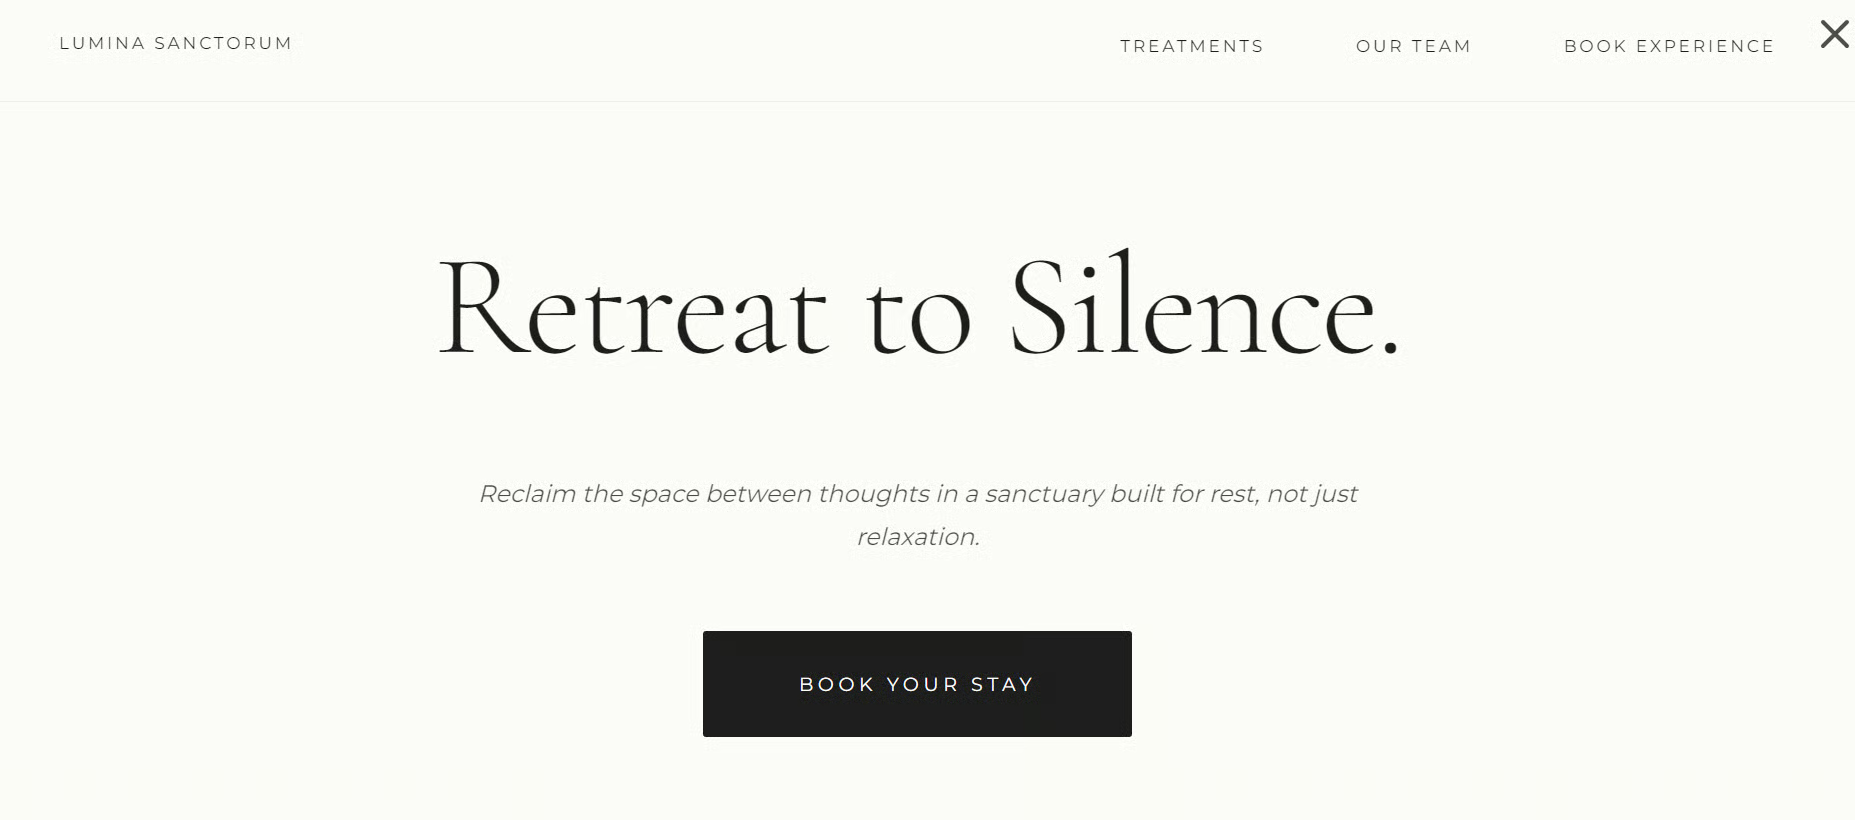
Het tweede resultaat is gegenereerd zonder redeneren. Het gaf een andere visuele richting, met een grotere kop en een meer redactionele landingspaginstijl.
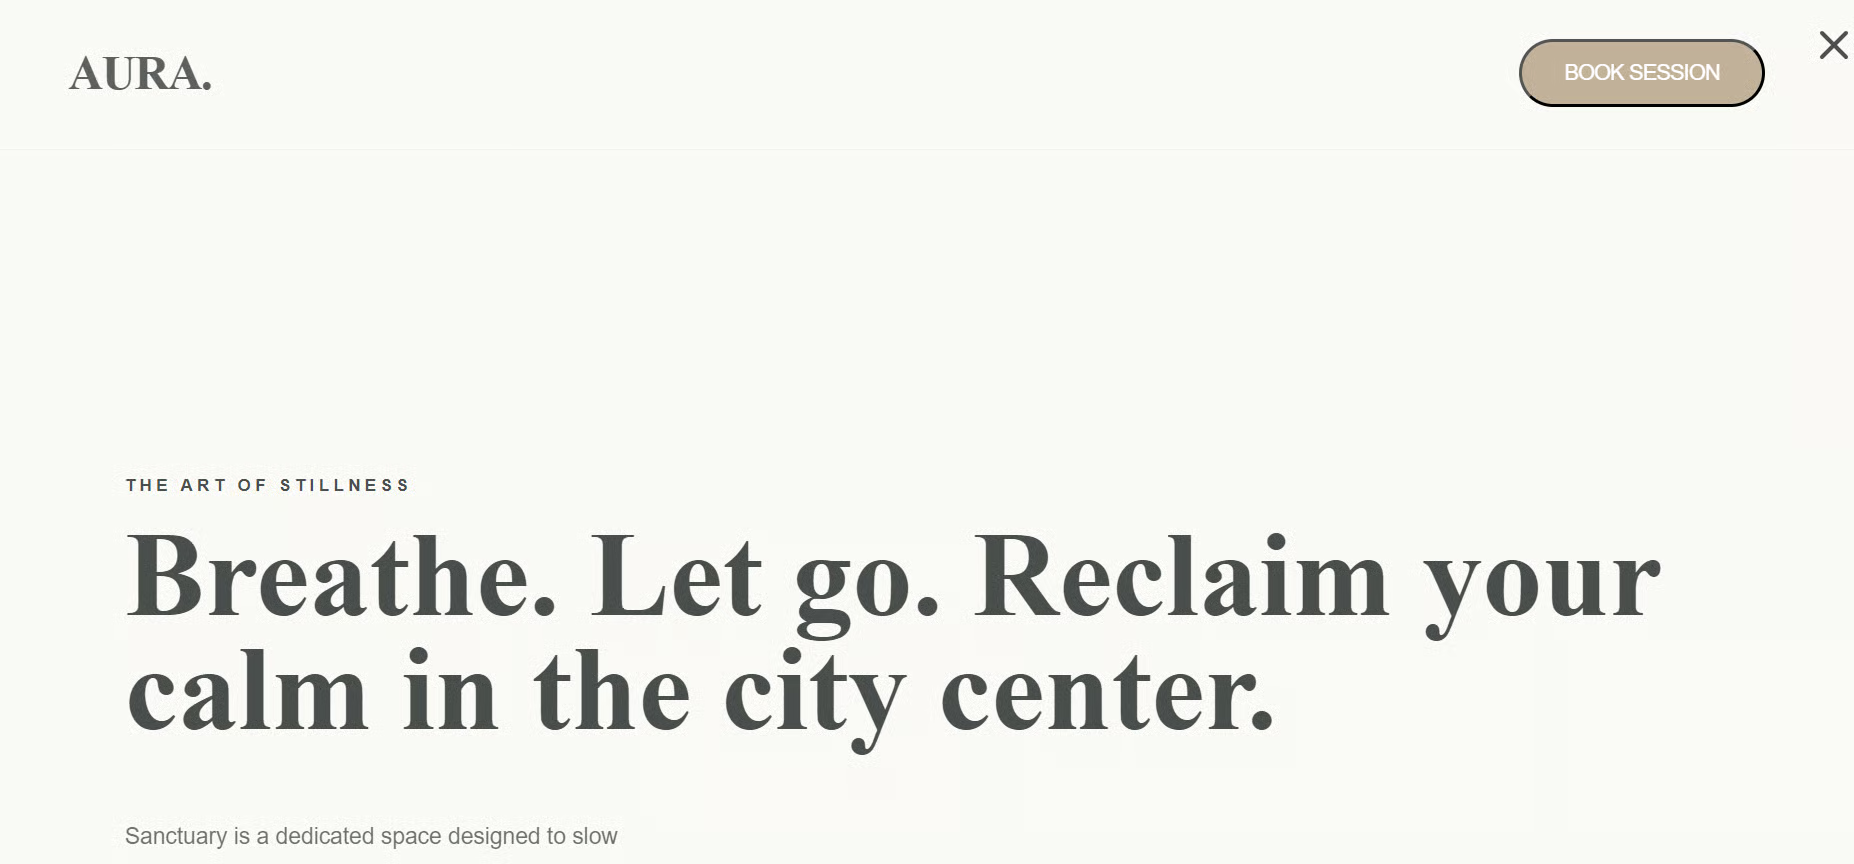
Beide resultaten zagen er visueel verzorgd uit, maar de versie met redeneren gaf in deze test een meer gestructureerd resultaat.
De tokensnelheid kan variëren afhankelijk van de promptlengte, de uitvoerstijl, de GPU-belasting en hoe vaak het hoofdmodel de door MTP voorgestelde drafttokens accepteert.
Pi is een lichtgewicht terminal-codeeragent. Het kan verbinding maken met de lokale Fable 5-Enhanced Gemma 4-server en die gebruiken om bestanden te lezen, code te bewerken, commando’s uit te voeren en coderingstaken af te ronden.
Open een vierde terminal en installeer Pi:
curl -fsSL https://pi.dev/install.sh | sh De installer kan vragen om Node.js te installeren. Accepteer de prompt en wacht tot de installatie is voltooid.
Herlaad je terminalconfiguratie en controleer vervolgens of Pi beschikbaar is:
source ~/.bashrc
pi --version
Installeer daarna de pi-llama-plugin:
pi install git:github.com/huggingface/pi-llamaDeze plugin verbindt Pi met een draaiende llama.cpp-server en ontdekt automatisch de beschikbare lokale modellen.
Standaard zoekt de plugin naar llama.cpp op poort 8080. Onze server gebruikt poort 8910, dus stel voor je Pi start het juiste lokale API-adres in:
export LLAMA_BASE_URL="http://127.0.0.1:8910/v1"Maak een nieuwe projectmap, initialiseer Git en start Pi:
mkdir -p /workspace/data-app
cd /workspace/data-app
git init
pi
Typ binnen Pi:
/modelSelecteer het “Fable5-Gemma4”-model.
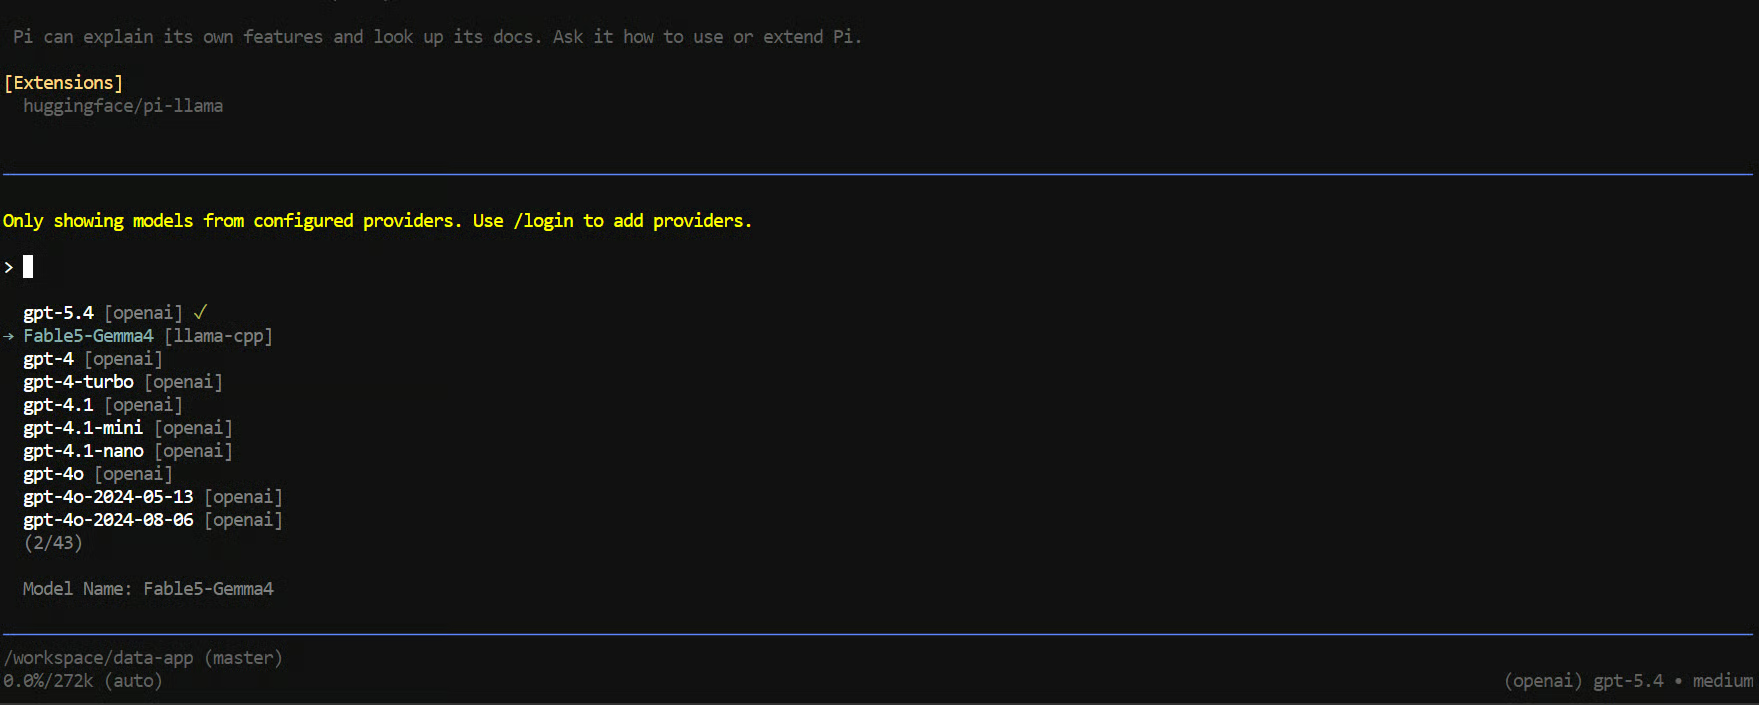
Geef de agent vervolgens een praktische coderingstaak:
Create a simple data analytics dashboard using Streamlit that lets users
upload a CSV file, view the data, and explore clear visualizations.
Include a sample CSV file and test the full app to make sure it works correctly.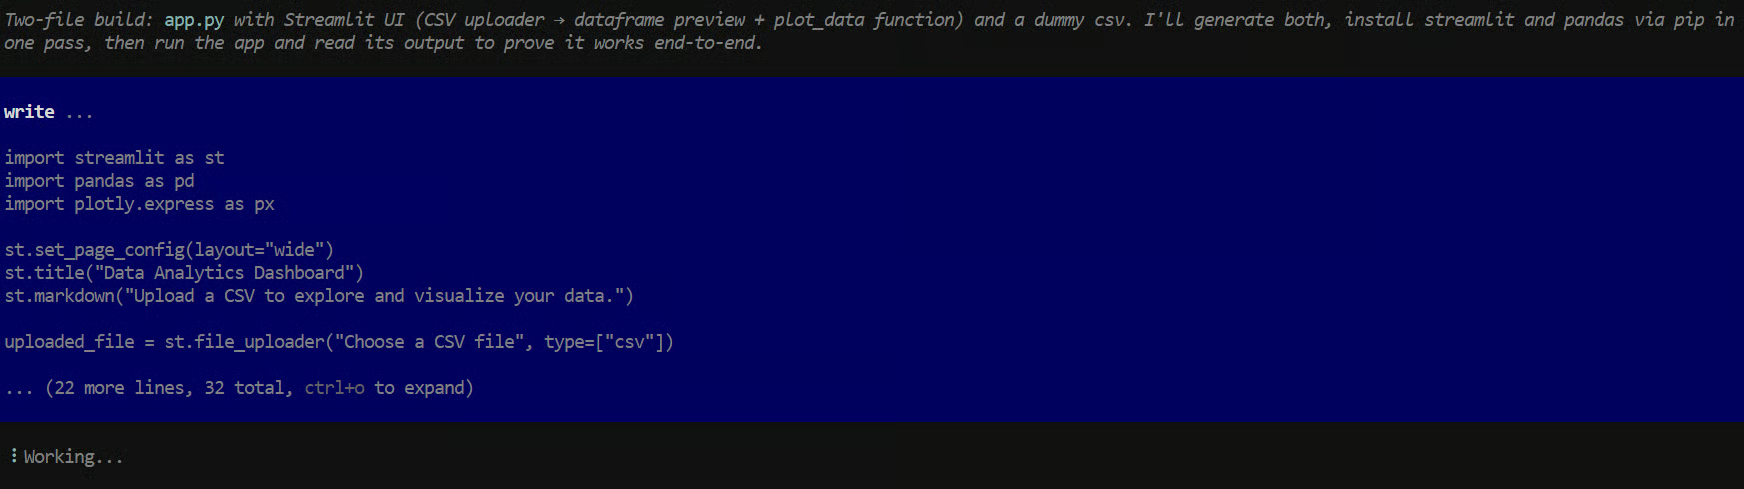
Het model maakte uiteindelijk een werkend Streamlit-dashboard met CSV-uploadondersteuning en visualisaties.
Toch was het proces veel moeilijker dan verwacht.
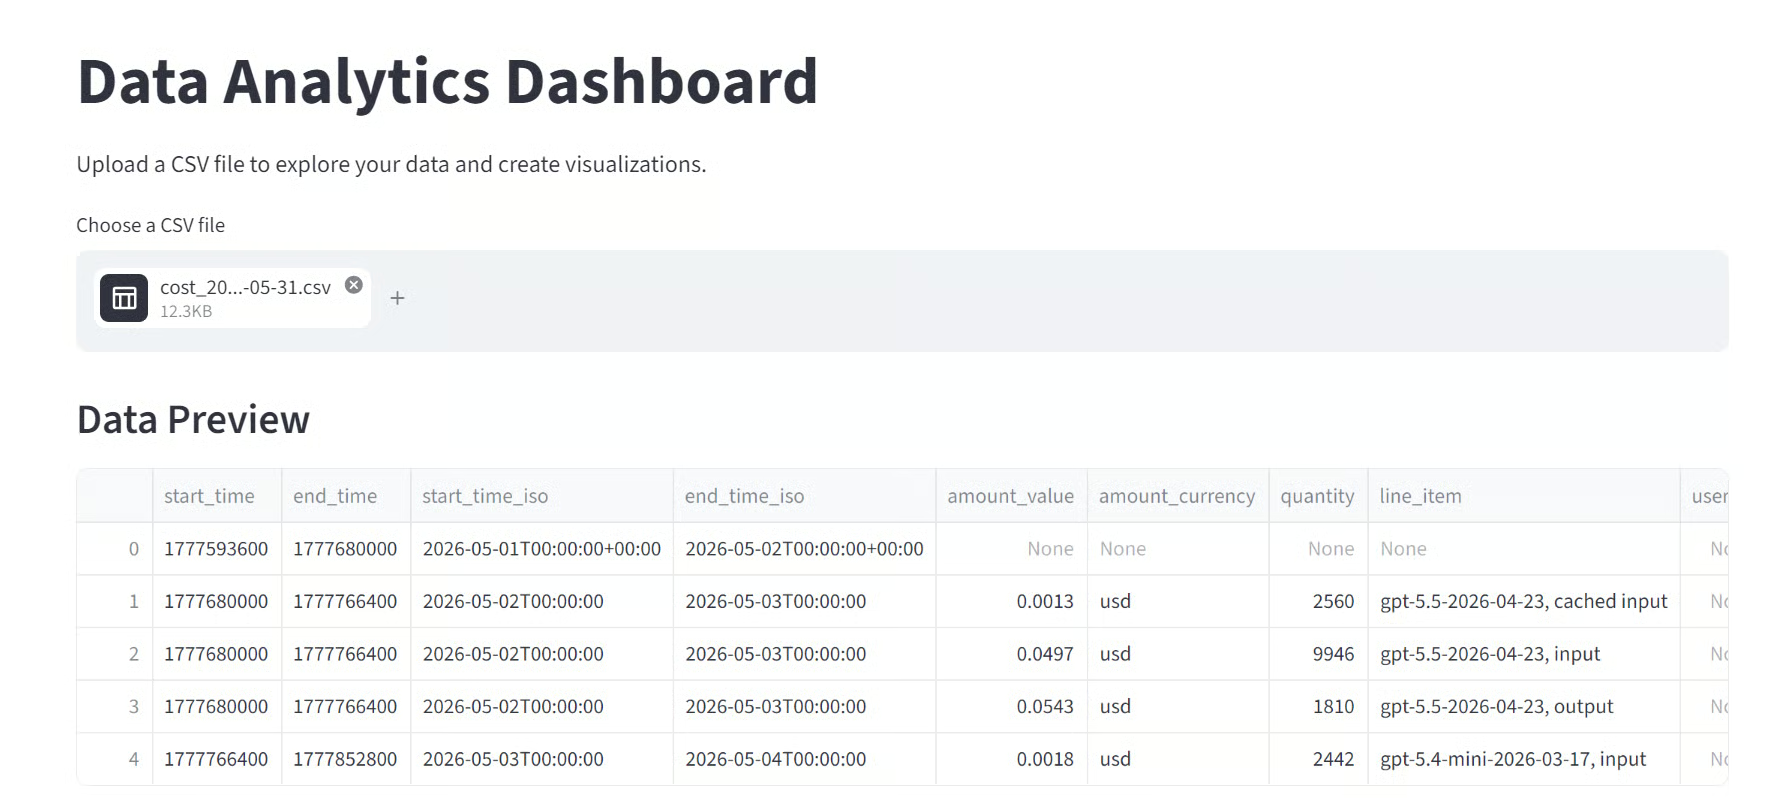
Het worstelde herhaaldelijk met tool-calls, terminalcommando’s en het schrijven van projectbestanden.
Vaak lukte het niet om de volgende actie te voltooien nadat het had gepland wat te doen, dus moest ik het blijven begeleiden door fouten en commando’s opnieuw uitvoeren.
Ik kon niet bevestigen of dit werd veroorzaakt door het model, de Pi-integratie, lokale permissies of een combinatie daarvan.
Na ongeveer 20 minuten opnieuw proberen leverde het een werkend resultaat op. Voor een relatief eenvoudige Streamlit-taak voelde dit te traag en onbetrouwbaar.
Dezelfde taak duurde ongeveer één minuut met GLM 5.2 in mijn aparte test.
Het is niet helemaal eerlijk om een 12B lokaal model te vergelijken met een veel groter frontiermodel.
Toch was het verschil duidelijk merkbaar.
Fable 5-Enhanced Gemma 4 kan verzorgde code en sterke single-turn outputs produceren, maar zijn echte agentprestatie was in deze test inconsistent. Het had te veel sturing nodig voor een taak die een capabele codeeragent snel en zelfstandig zou moeten afronden.
Mijn conclusie is dat het model interessant is voor lokale experimenten, private codegeneratie en lichtgewicht workflows.
Maar op basis van deze test zou ik er nog niet op vertrouwen voor betrouwbare meerstaps codeeragent-taken.
Hoewel deze gids een eenvoudige manier biedt om het model te testen, kun je problemen ondervinden afhankelijk van je hardware, lokale setup en llama.cpp-build.
Als de server crasht tijdens het laden van het MTP-draftmodel en een fout toont zoals:
invalid vector subscriptDan ligt het probleem mogelijk aan je llama.cpp-build in plaats van aan de modelbestanden.
De modelrepository meldt dat llama.cpp-build b9553 werkt met het Gemma 4 MTP-draftmodel, terwijl nieuwere builds zoals b9702 en b9717 kunnen falen tijdens het laden van het draftmodel.
Als snelle fallback kun je de MTP-argumenten uit het servercommando verwijderen en alleen het hoofdmodel draaien. Het model werkt dan nog steeds correct, maar genereren kan trager zijn.
Verwijder deze regels:
--model-draft "$MODEL_DIR/MTP/gemma-4-12B-it-MTP-Q8_0.gguf"
--spec-type draft-mtp
--spec-draft-n-max 2
-ngld 99Als je tokens zoals <|tool_call> of <|channel> in de reactie ziet, past de client het native tool-call-formaat van Gemma 4 niet correct toe.
Zorg dat je servercommando dit bevat:
--jinjaStart daarna de server opnieuw. Dit past de juiste chattemplate toe voor de redenering en gestructureerde tool-calls van het model.
Controleer eerst of de llama.cpp-server nog draait:
curl http://127.0.0.1:8910/v1/modelsJe zou Fable5-Gemma4 in de reactie moeten zien.
Zorg er vervolgens voor dat Pi naar poort 8910 verwijst in plaats van de standaard llama.cpp-poort 8080:
export LLAMA_BASE_URL="http://127.0.0.1:8910/v1"
pi
Voer beide commando’s uit in dezelfde terminalsessie.
Start Pi binnen een schrijfbare projectmap:
cd /workspace/data-app
pi
Je kunt testen of in de huidige map bestanden aangemaakt kunnen worden:
touch write-test.txt && rm write-test.txtAls dit commando faalt, is het probleem een werkruimtepermissie en niet het model zelf. Ga naar een schrijfbare map voordat je Pi start.
Als het model tekst, cijfers of symbolen begint te herhalen, controleer dan de sampling-instellingen in je servercommando.
Gebruik deze waarden:
--temp 1.0 \
--top-p 0.95 \
--top-k 64 \
--repeat-penalty 1.1
De herhalingsstraf is hierbij vooral belangrijk. Zonder die kan het model herhaalde of onleesbare output produceren.
Een 256K-contextwindow vereist een grote KV-cache. Als de server zonder VRAM komt te zitten, verlaag dan eerst de contextgrootte:
--ctx-size 32768Je kunt ook het MTP-draftmodel uitschakelen om meer VRAM vrij te maken. Controleer je huidige GPU-geheugengebruik met:
nvidia-smiHet model kan sterke code genereren, maar kan nog steeds moeite hebben om langere taken zonder interventie te voltooien. In mijn tests plande het soms de juiste acties, maar faalde het bij het uitvoeren van commando’s, het schrijven van bestanden of het doorgaan na een fout.
Voor betere resultaten kun je grote verzoeken opsplitsen in kleinere taken:
Dit geeft het model een kleiner doel bij elke stap en maakt het makkelijker om te bepalen of een mislukking komt door het model, Pi, de server of werkruimtepermissies.
Ik vind niet dat de hype rond dit model volledig gerechtvaardigd is, althans op basis van mijn tests. Met en zonder MTP haalde ik bijna dezelfde snelheid voor algemene taken. Tijdens coderingstaken hielp MTP wel, en zag ik zo’n 20% tot 30% snelheidswinst. Dat is nuttig, maar het lost het grotere probleem niet op: betrouwbaarheid.
Ik testte het model ook in de WebUI.
Soms, tijdens het schrijven van code voor een bestand, stopte het om onduidelijke redenen. Toen ik vroeg om door te gaan, schreef het de voortzetting als tekst in het volgende chatantwoord in plaats van het bestand daadwerkelijk te vervolgen.
Ik merkte ook dat het inschakelen van denken de output soms juist slechter maakte, wat verrassend was.
Ik heb het ook getest met Claude Code, en die ervaring was nog frusterender.
Het model bleef extra bestanden, tijdelijke bestanden en andere irrelevante zaken aanmaken die een simpel project niet nodig had. Het voltooide de taak uiteindelijk, maar het kostte te veel begeleiding en te veel tijd.
Ik weet dat een 12B lokaal model vergelijken met GPT-5.5 of GLM 5.2 niet helemaal eerlijk is. Maar zelfs vergeleken met kleinere lokale modellen was ik niet onder de indruk.
Naar mijn ervaring is Qwen3.6 27B veel beter voor coderen en agenttaken, ook al is het groter.
Voor nu zie ik dit model als een interessant experiment in plaats van een betrouwbare codeeragent.
Ik ben meer geïnteresseerd in het aankomende Fable-afgestemde Qwen3.6 27B-model van dezelfde maker. Ik heb ook verschillende andere open-source bijdragers soortgelijke gedistilleerde codeermodellen zien uitbrengen, maar tot nu toe heb ik geen grote verbetering gezien in echte codeeragent-taken.
Het model kan fraai ogende code en verzorgde single-turn outputs genereren. Maar als je het vraagt om als agent te werken, tools te gebruiken, bestanden te maken, fouten te herstellen en het resultaat te verifiëren, voelt het nog steeds inconsistent en frustrerend in gebruik.
Topcursussen bij DataCamp
Cursus
Cursus
Leerpad
blog
Adel Nehme
15 min

