
课程
高级 AI 辅助开发
1 小时 30 分钟
1.8K
在 Fable 5 和 Mythos 5 停止服务后,开源开发者开始尝试在本地运行更小的模型,这些模型使用高质量的合成编程与代理数据进行训练。Fable 5 增强版 Gemma 4 就是一个例子。
它是基于 Gemma 4 12B 的微调模型,训练数据来自 Fable 5 和 Composer 2.5 生成的数据集。目标是将有用的编程与代理行为迁移到可在本地运行的更小模型中。
其训练重点在于实用工作流,例如理解任务、读取文件、使用工具、编辑代码、运行命令以及验证最终结果。
在本指南中,我将向您展示如何在 RTX 5070 Ti 上使用 llama.cpp 本地运行 Fable 5 增强版 Gemma 4 模型。
我们将安装 llama.cpp,下载 GGUF 模型和 MTP 草稿模型,启动一个兼容 OpenAI 的本地服务器,并使用 cURL 和内置 WebUI 进行测试。
最后,我们会将模型连接到 Pi Coding Agent,并交给它一个真实的编码任务。核心问题在于,这个紧凑的 12B 模型能否提供有用的编码代理行为,并与更大的本地模型(如 Qwen 3.6 27B 或 Gemma 4 31B)竞争。
Fable 5 增强版 Gemma 4 是一款基于 Google Gemma 4 12B 指令模型的紧凑型编程与代理模型。它由 Yuxin Lu 创建,并以 GGUF 格式发布,便于在 llama.cpp 及其他兼容工具中本地使用。
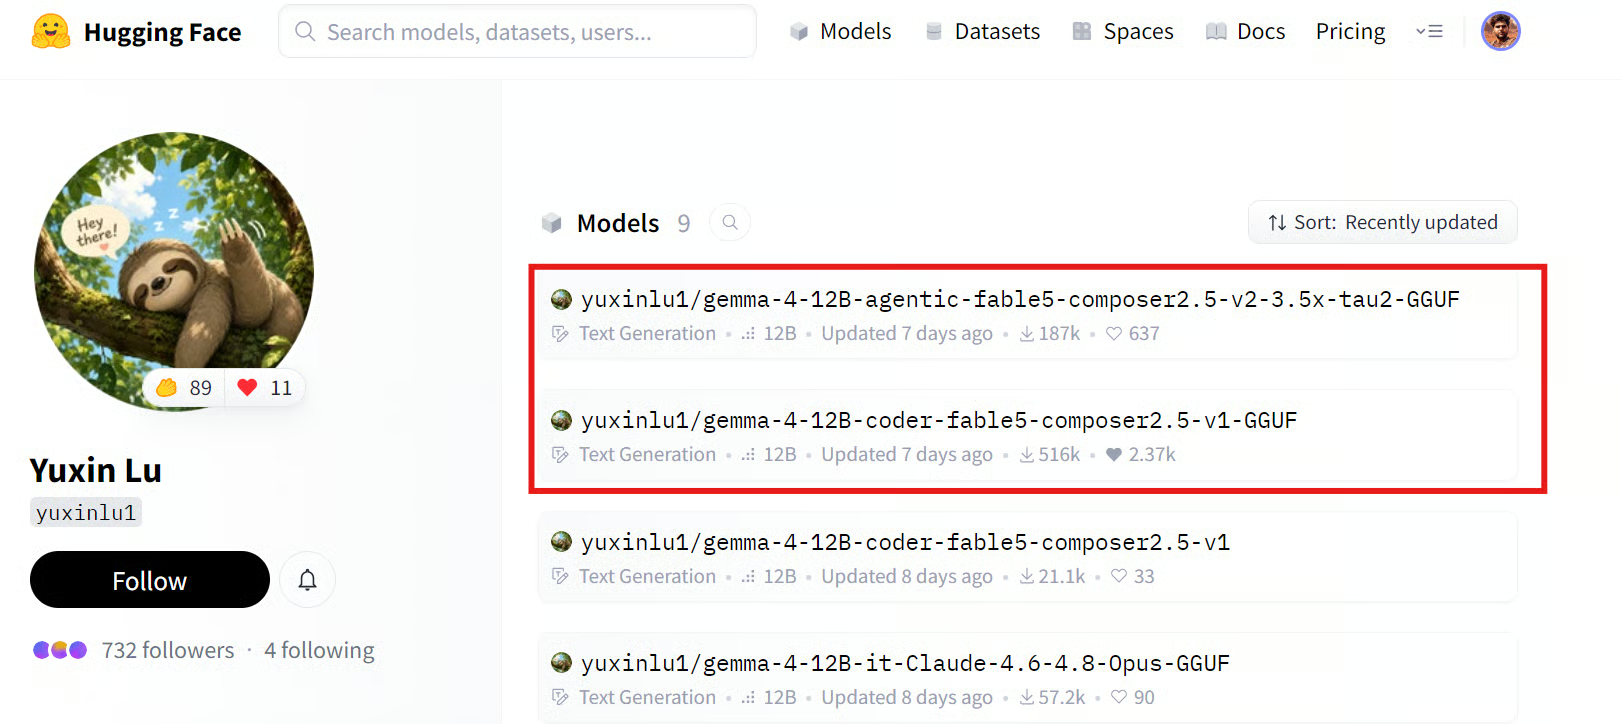
本指南使用的是 v2 版本。它延续了 v1 的编程能力,但更侧重于代理式技术工作。
它并非只生成代码,而是被设计为可以检查文件、进行推理、使用工具、编辑代码、运行命令并验证最终结果。
原始模型在由 Composer 2.5 和 Fable 5 生成的、经验证的 Python 编程数据上进行微调。
主要训练集使用 Composer 2.5 的推理轨迹和针对具有确定性测试的 Python 任务的代码解法。仅保留通过测试的样例。
对于 Composer 2.5 失败的较难任务,则使用 Fable 5 生成新的推理过程与修正后的解法,并在执行验证通过后纳入训练数据。
在 v2 中,模型加入了多步终端与工具使用轨迹。这让模型学习按“读取、推理、行动、验证”的流程工作,而不是给出一个答案后就停止。
在 Fable 5 不再可用后,一些缺失的 Fable 5 风格推理轨迹使用 Opus 4.8 重建。
--jinja,以便模型使用 Gemma 4 设计的聊天模板与工具调用格式。在本地 tau2-bench telecom 对比中,v2 模型达到了约 55%,而基础 Gemma 4 12B 指令模型约为 15%。
这表明主要提升来自代理行为。微调后的模型更擅长检查任务、采取下一步行动、使用工具并验证结果,而不是在首次回复后就停止。
这是在 Linux 机器上安装 llama.cpp 的最快、最简单方法。安装器会下载预构建的二进制文件并为您完成设置,而无需克隆仓库并从源代码编译。
在终端中运行以下命令:
curl -LsSf https://llama.app/install.sh | sh几秒钟内,安装器会下载 llama.cpp 二进制文件并完成设置。
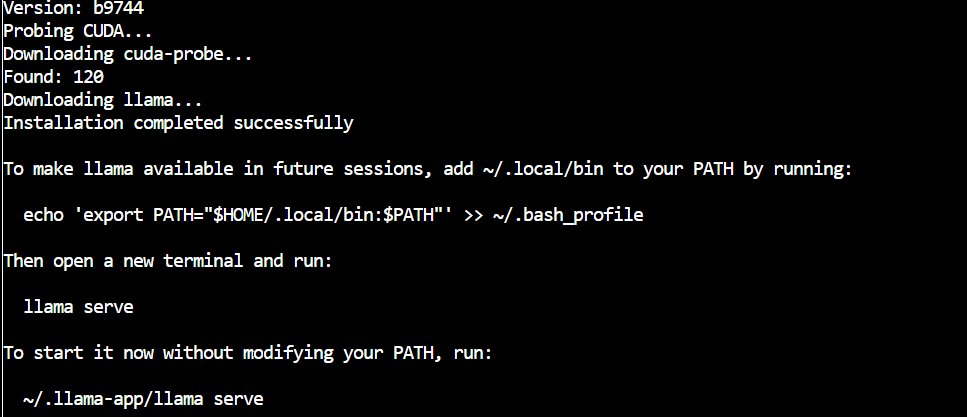
接着,将 llama.cpp 添加到您的 PATH,这样即便重启终端,您也能在任意目录运行 llama 命令:
echo 'export PATH="$HOME/.local/bin:$PATH"' >> ~/.bashrc
source ~/.bashrc
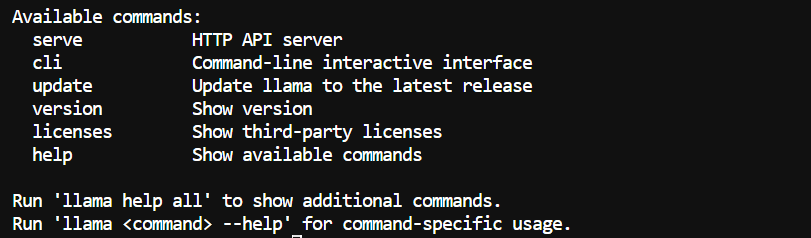
最后,验证安装是否成功:
llama help现在您应该能看到可用的 llama.cpp 命令。
接着,安装 Hugging Face CLI 与 hf-xet。这可以让您直接从 Hugging Face 下载模型文件,包括使用 Xet 存储大文件的仓库。
pip install -U "huggingface_hub[cli]" hf-xet 为模型文件创建一个目录:
MODEL_DIR="/workspace/Fable5-Gemma4"
mkdir -p "$MODEL_DIR"
启用更快的 Xet 下载,然后仅下载本指南所需的文件:
export HF_XET_HIGH_PERFORMANCE=1


hf download \
  yuxinlu1/gemma-4-12B-agentic-fable5-composer2.5-v2-3.5x-tau2-GGUF \
  --include "gemma4-v2-Q4_K_M.gguf" \
  --include "MTP/gemma-4-12B-it-MTP-Q8_0.gguf" \
  --local-dir "$MODEL_DIR"
将会下载两个文件:
gemma4-v2-Q4_K_M.gguf:Fable 5 增强版 Gemma 4 的主模型。MTP/gemma-4-12B-it-MTP-Q8_0.gguf:稍后用于 MTP 推测解码的草稿模型。Q4_K_M 模型约 7 GB。下载时间取决于您的网络连接,但使用 Xet 能提升大模型文件的传输性能。
下载完成后,文件将存放在:
/workspace/Fable5-Gemma4现在,使用主模型与 MTP 草稿模型启动本地服务器:
MODEL_DIR="/workspace/Fable5-Gemma4"

llama serve \
  --model "$MODEL_DIR/gemma4-v2-Q4_K_M.gguf" \
  --alias Fable5-Gemma4 \
  --model-draft "$MODEL_DIR/MTP/gemma-4-12B-it-MTP-Q8_0.gguf" \
  --spec-type draft-mtp \
  --spec-draft-n-max 2 \
  -ngl 99 \
  -ngld 99 \
  --ctx-size 262144 \
  --parallel 1 \
  --cache-type-k q8_0 \
  --cache-type-v q8_0 \
  --flash-attn on \
  --jinja \
  --temp 1.0 \
  --top-p 0.95 \
  --top-k 64 \
  --repeat-penalty 1.1 \
  --host 0.0.0.0 \
  --port 8910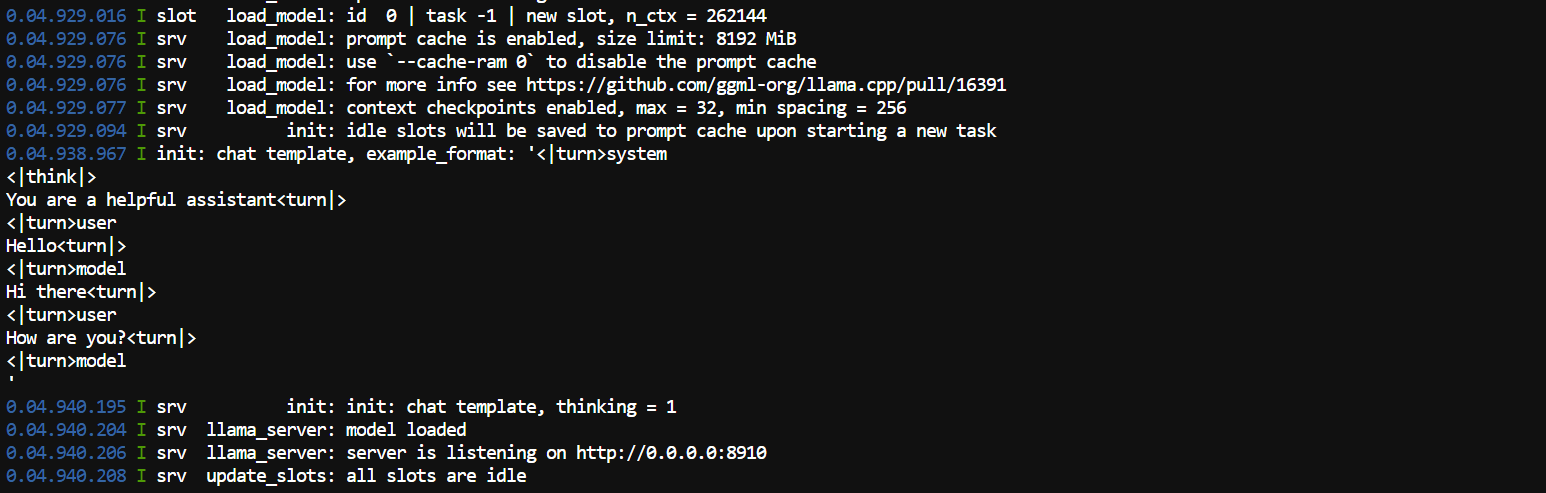
--model-draft 参数用于加载 MTP 草稿模型。
MTP 意为多 Token 预测。较小的草稿模型会先预测接下来的少量 token,主模型再并行验证。这样可以在不改变主模型角色的前提下提升生成速度。
--spec-type draft-mtp 启用该 MTP 推测解码方案。--spec-draft-n-max 2 允许草稿模型一次最多提出两个 token。由于更大的值不一定带来速度提升,2 是一个合理的起点。
-ngl 99 将主模型迁移到 GPU,-ngld 99 则对 MTP 草稿模型执行相同操作。值 99 表示尽可能卸载全部可用层到 GPU。
--ctx-size 262144 设置最大 256K token 的上下文窗口。这对大型代码库与长时间终端会话很有用,但也需要更多显存。--parallel 1 将全部上下文保留给一个活动请求,而不是在多用户间分配。
Q8 KV 缓存设置可降低长上下文窗口所需的内存。--flash-attn on 有助于提升注意力计算效率,尤其在长提示词情况下。
请保持启用 --jinja。它会应用模型内置的聊天模板,从而正确格式化提示、推理与工具调用。
其余采样设置用于控制模型的文本生成方式。--temp 1.0、--top-p 0.95 与 --top-k 64 允许更丰富的回复,而 --repeat-penalty 1.1 有助于减少重复文本。
服务器加载完成后,打开 WebUI:
http://localhost:8910 您也可以在另一个终端查看 GPU 使用情况:
nvidia-smi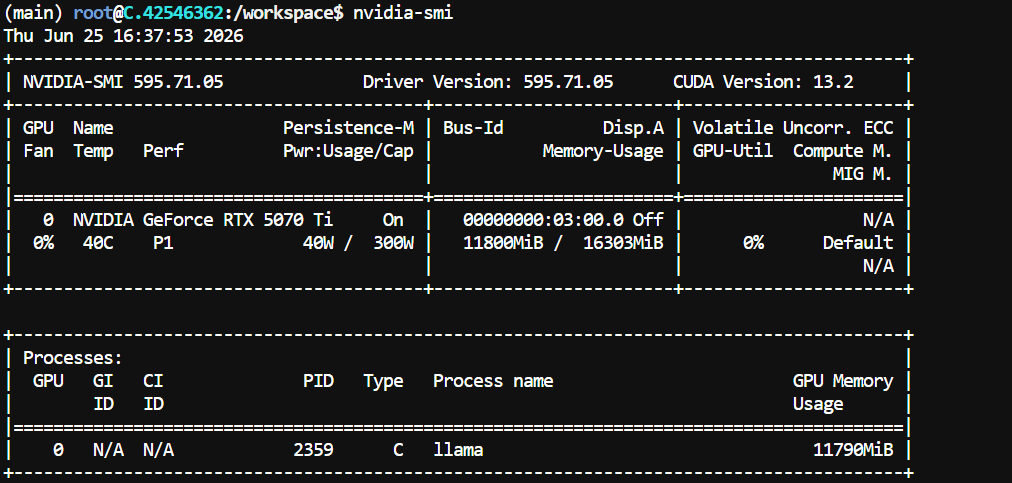
在我的 RTX 5070 Ti 上,使用 256K 上下文配置时,模型约占用 11.8 GB 显存,仍有 4 GB 以上可用。
您的内存占用可能会因 llama.cpp 构建版本、GPU 驱动与上下文设置不同而变化。
保持运行 llama serve 的终端不关闭,然后打开第三个终端测试本地 API。
curl http://127.0.0.1:8910/v1/messages \
  -H "Content-Type: application/json" \
  -d '{
    "model": "Fable5-Gemma4",
    "max_tokens": 512,
    "messages": [
      {
        "role": "user",
        "content": "Create a simple Python script that prints Hello, I am running locally! "
      }
    ]
  }'
响应应包含模型生成的文本以及其思维输出。在此测试中,模型返回如下 Python 代码:
print("Hello, I am running locally!")JSON 响应确认本地服务器工作正常。在我的快速测试中,模型生成速度约为 每秒 54 个 token。
您也可以使用内置聊天界面。在浏览器中打开以下地址:
http://localhost:8910WebUI 的使用就像普通聊天应用。选择 Fable5-Gemma4 模型,编写提示并发送给本地服务器。
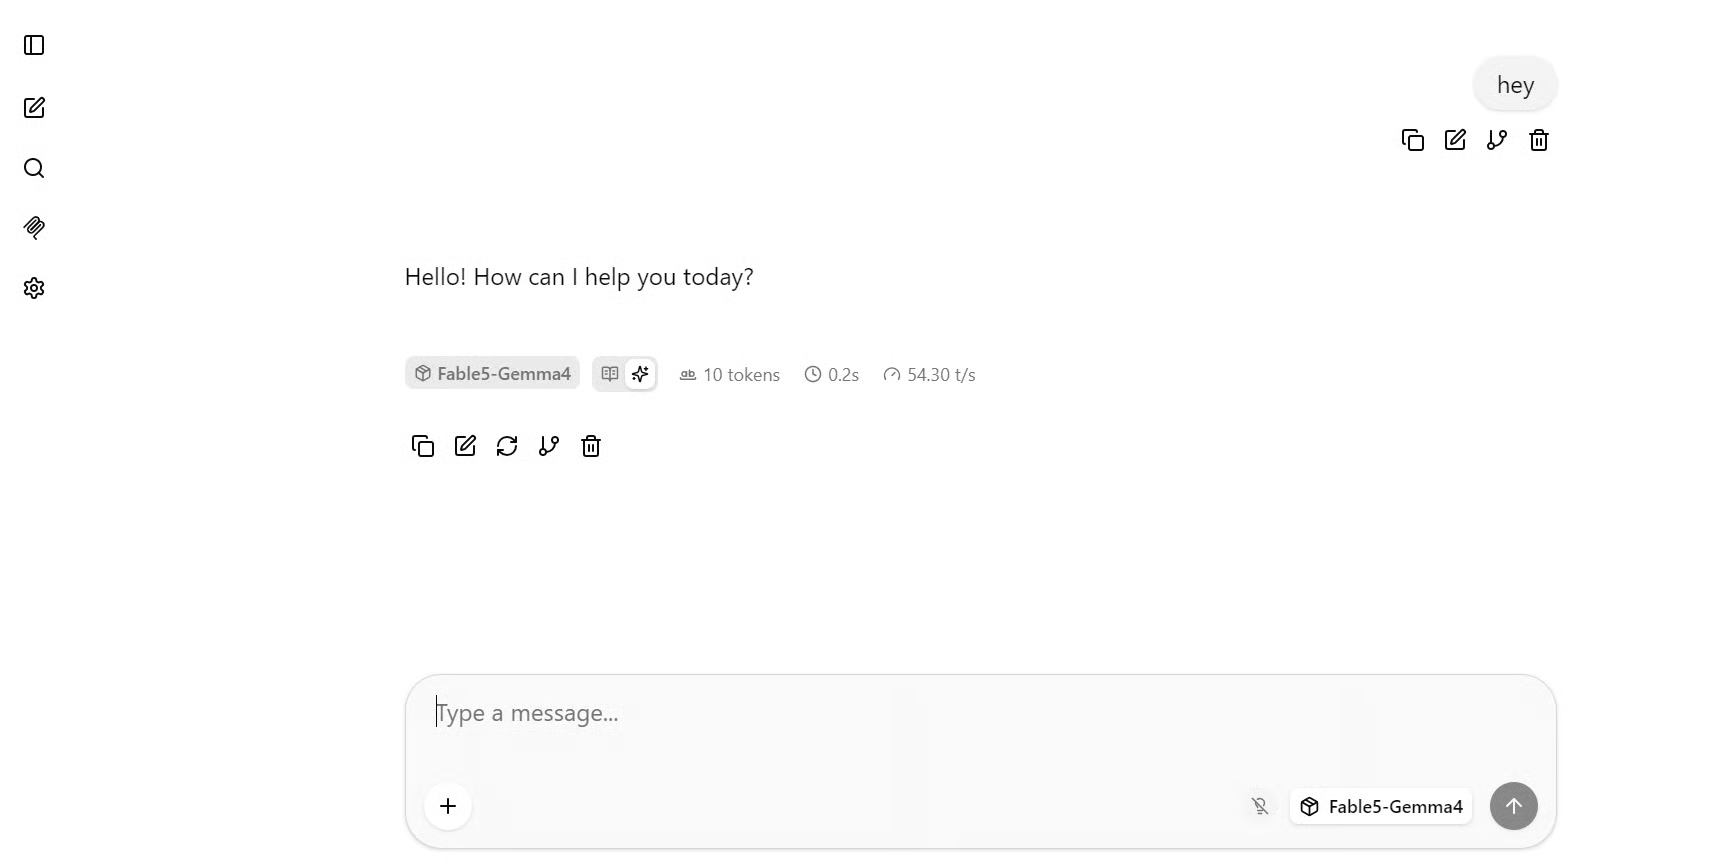
对于更大的编码测试,使用以下提示:
Create a calming, premium spa treatment center website in one self-contained HTML file
with all CSS and JavaScript included inline, elegant booking CTAs, treatment packages,
therapist profiles, testimonials, and high-quality spa imagery.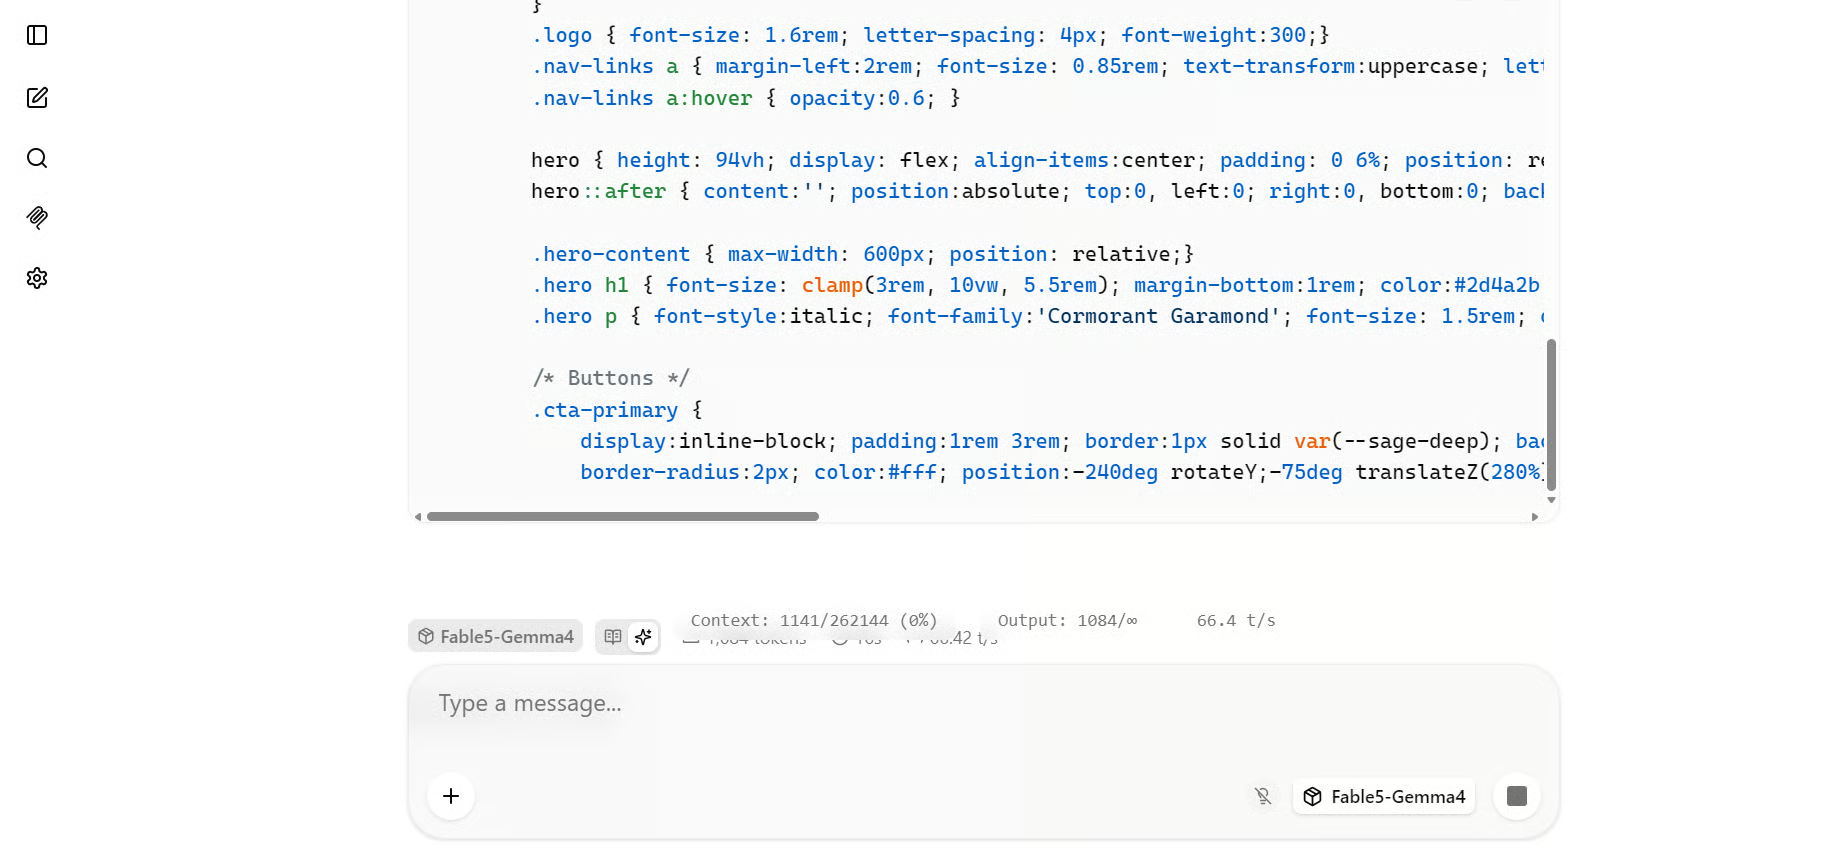
对于这个较长的 HTML 生成任务,我看到的速度大约为 每秒 66 到 70 个 token。较长的编码任务有时能带来更好的推测解码性能,因为模型会生成更连续、更可预测的代码 token 序列。
下面第一个结果在将推理设置为 Medium 时生成。它创建了一个干净的水疗落地页,采用极简布局、导航链接和醒目的预订 CTA。
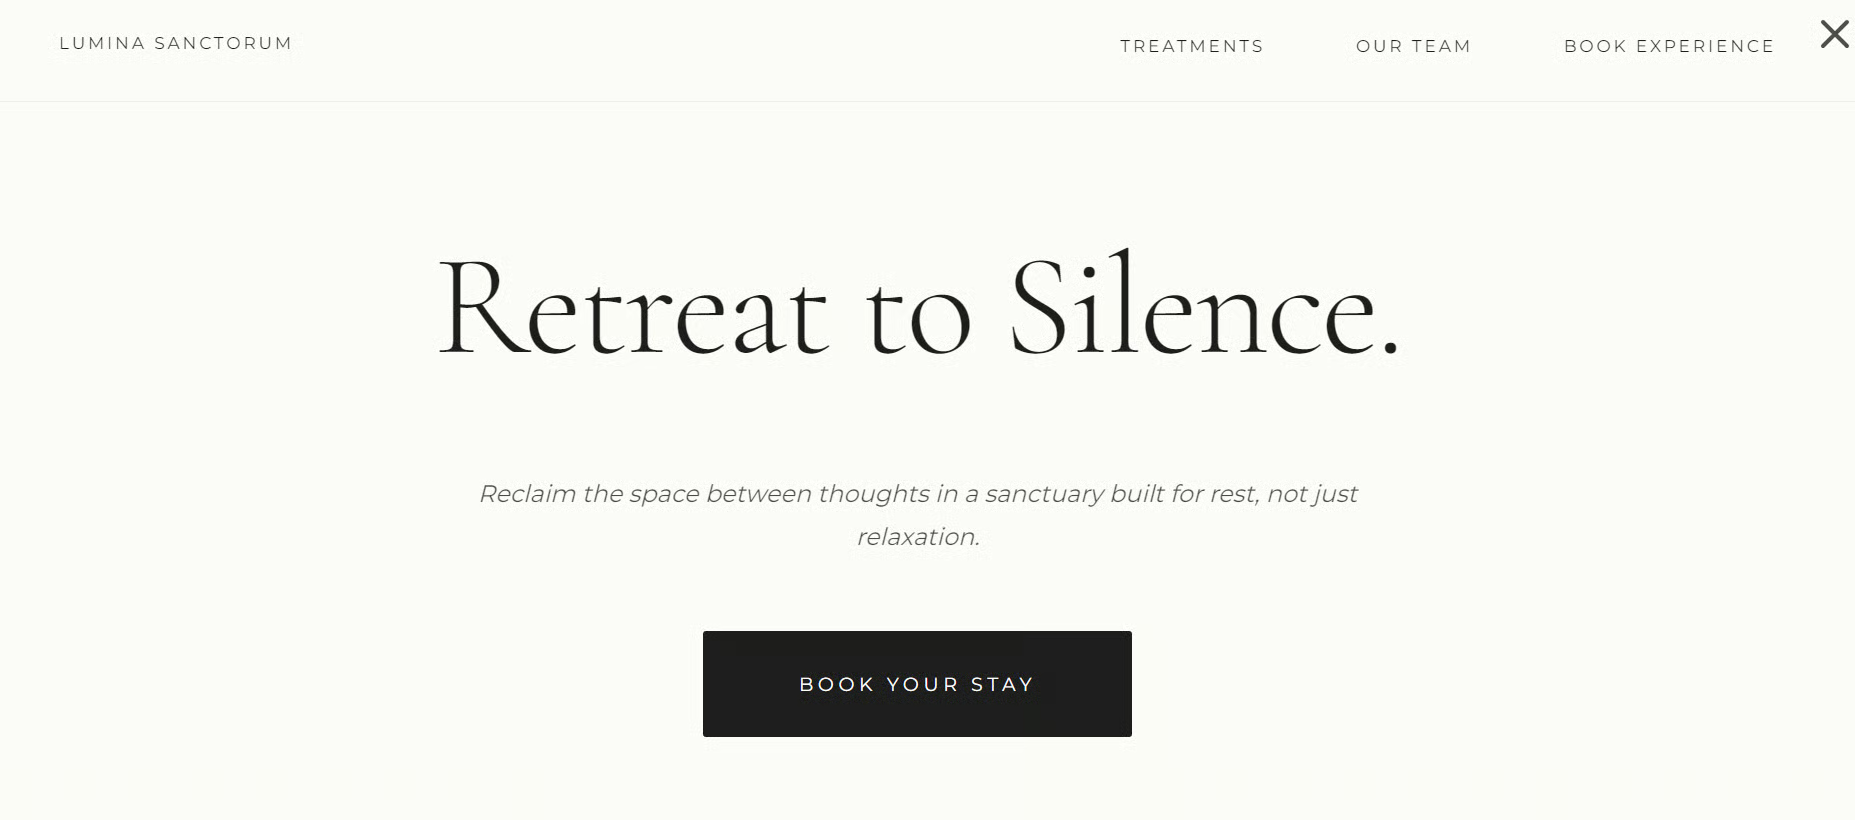
第二个结果是在不启用推理的情况下生成的。它呈现了不同的视觉方向,标题更大,整体更偏编辑型的落地页风格。
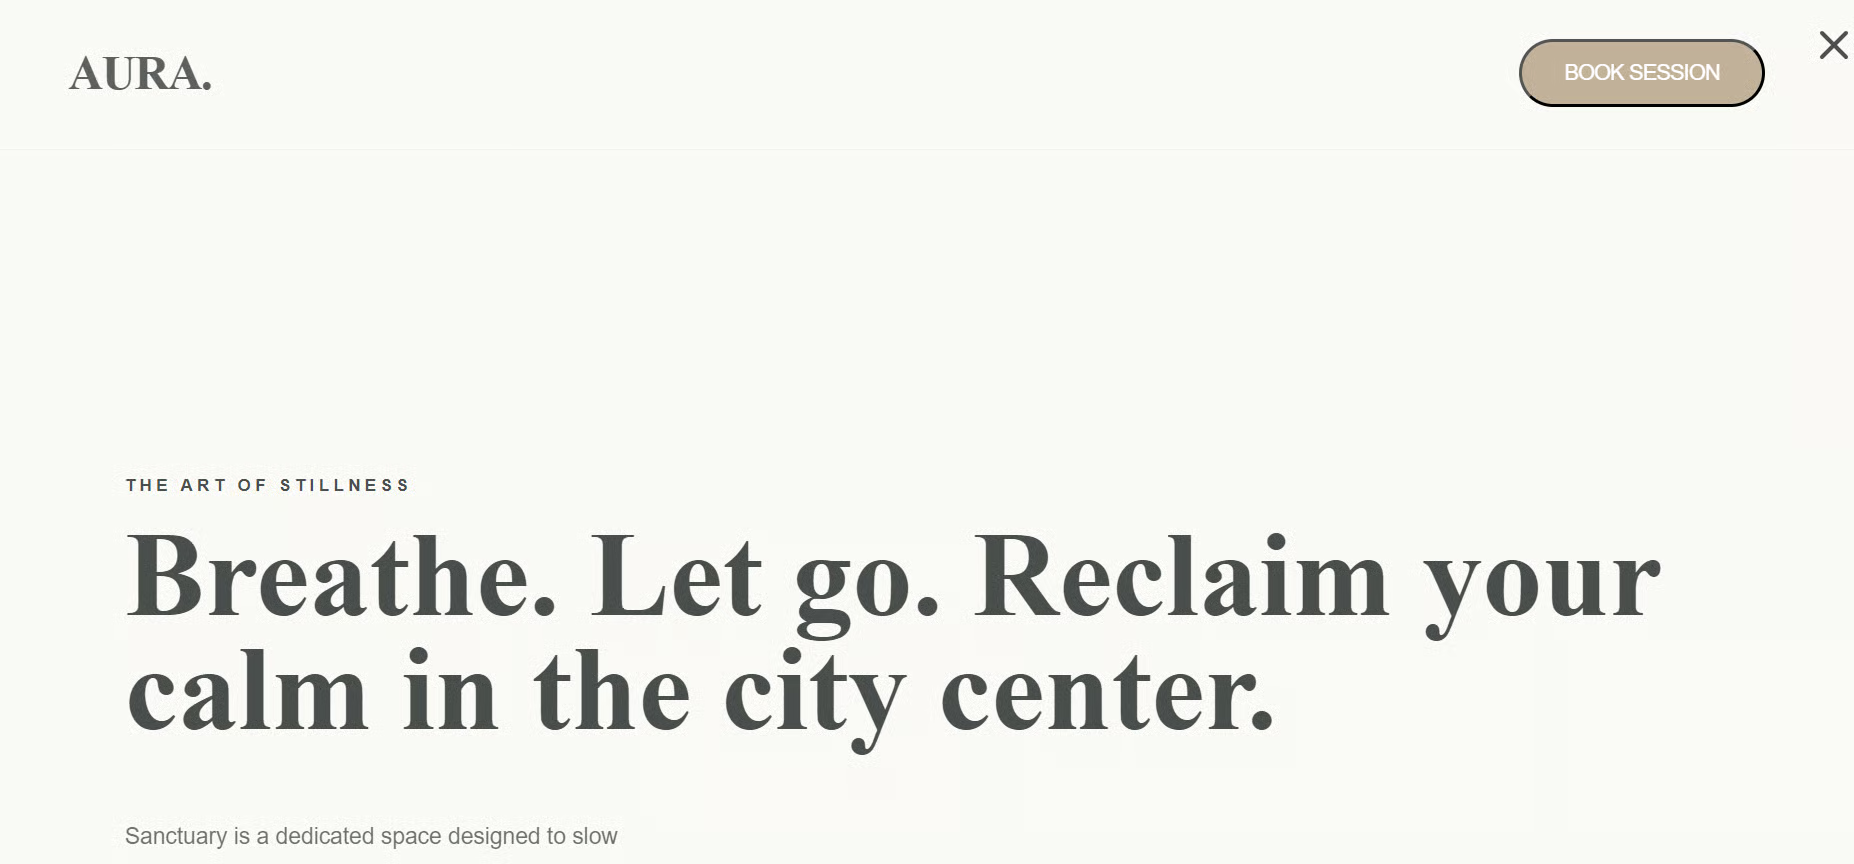
两种结果都较为精致,但在此次测试中,启用推理的版本给出了更有结构的结果。
token 速度会因提示长度、输出风格、GPU 负载以及主模型对 MTP 草稿 token 的接受频率而变化。
Pi 是一个轻量级终端编码代理。它可以连接到本地的 Fable 5 增强版 Gemma 4 服务器,读取文件、编辑代码、运行命令并完成编码任务。
打开第四个终端并安装 Pi:
curl -fsSL https://pi.dev/install.sh | sh 安装程序可能会提示安装 Node.js。请接受提示并等待安装完成。
重新加载您的终端配置,然后确认 Pi 可用:
source ~/.bashrc
pi --version
接着,安装 pi-llama 插件:
pi install git:github.com/huggingface/pi-llama该插件会将 Pi 连接到正在运行的 llama.cpp 服务器,并自动发现可用的本地模型。
默认情况下,插件会在端口 8080 查找 llama.cpp。我们的服务器使用 8910 端口,因此在启动 Pi 之前请设置正确的本地 API 地址:
export LLAMA_BASE_URL="http://127.0.0.1:8910/v1"创建新项目目录、初始化 Git 并启动 Pi:
mkdir -p /workspace/data-app
cd /workspace/data-app
git init
pi
在 Pi 中输入:
/model选择“Fable5-Gemma4”模型。
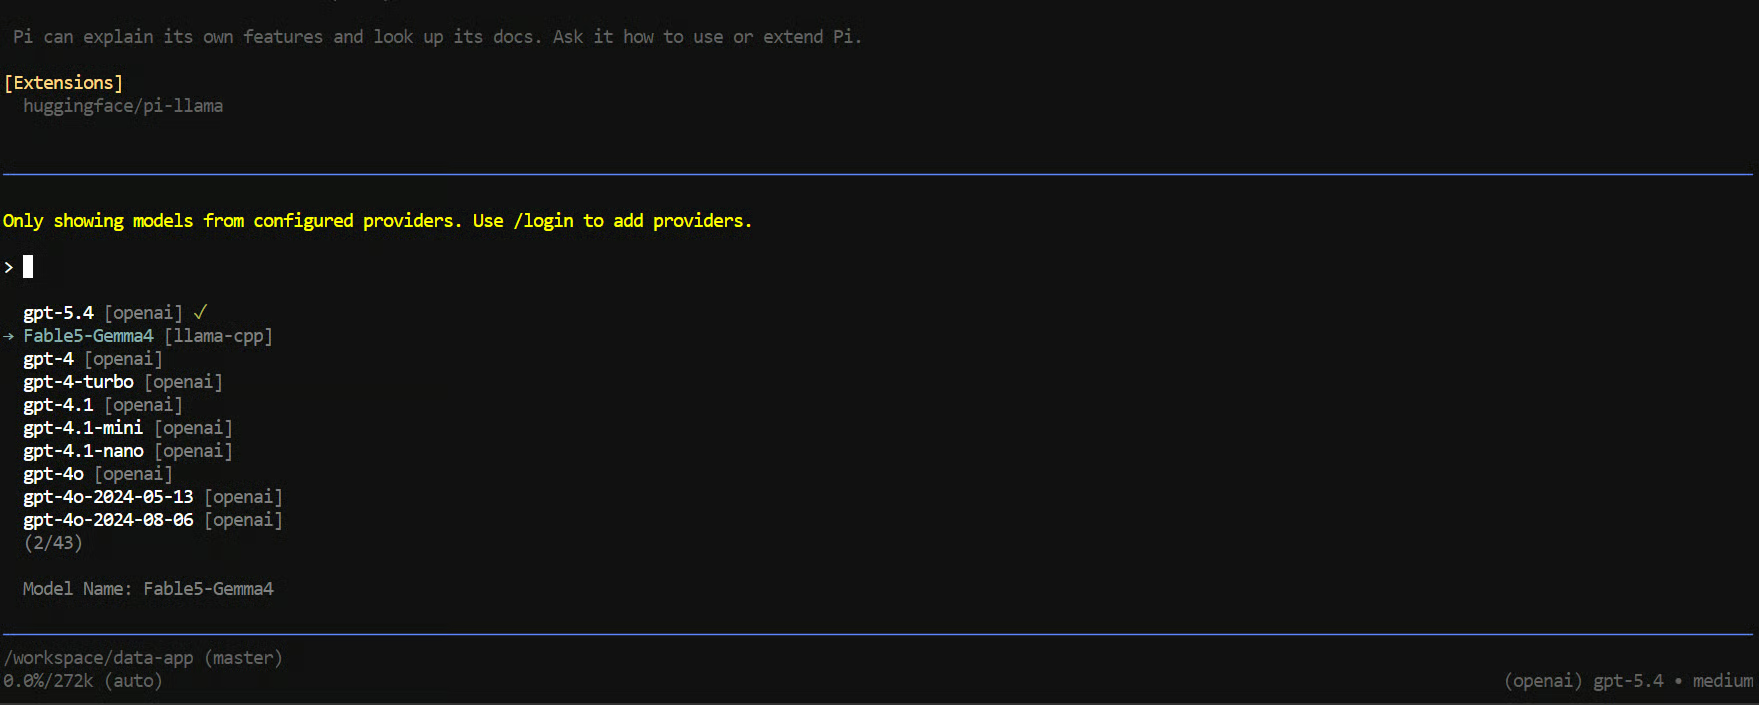
然后,给代理一个实用的编码任务:
Create a simple data analytics dashboard using Streamlit that lets users
upload a CSV file, view the data, and explore clear visualizations.
Include a sample CSV file and test the full app to make sure it works correctly.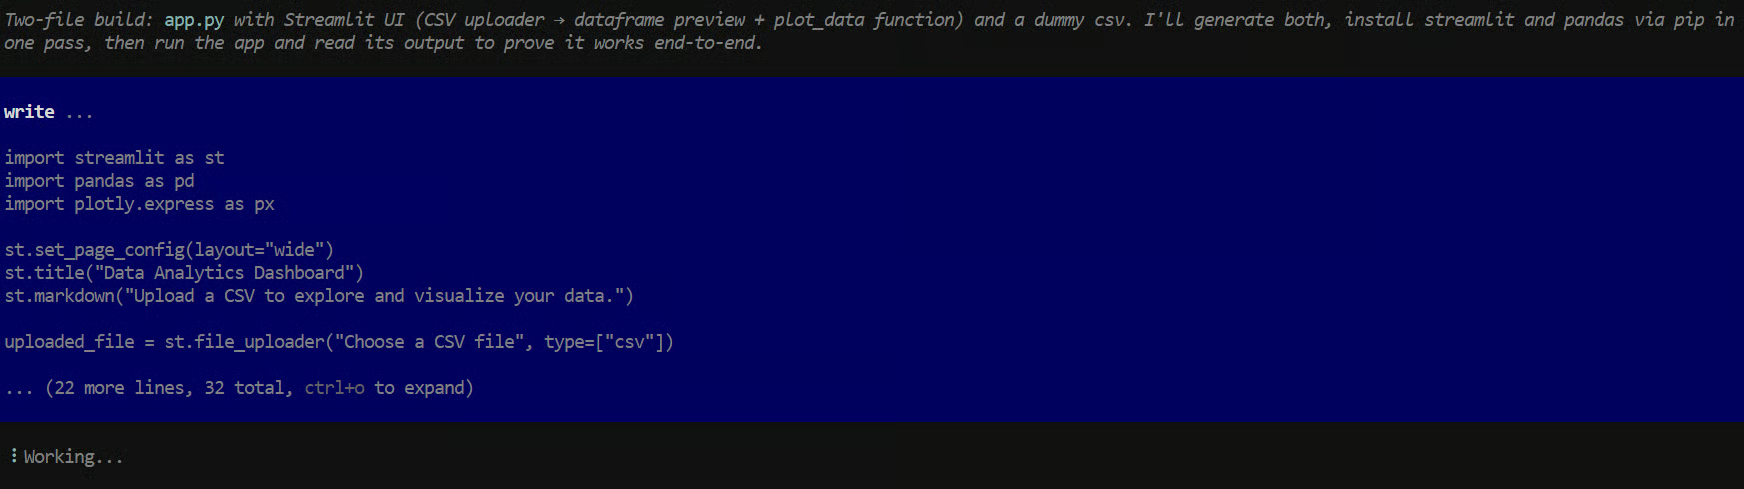
模型最终创建了一个可用的 Streamlit 仪表盘,支持 CSV 上传与可视化。
不过,这个过程远比预期更困难。
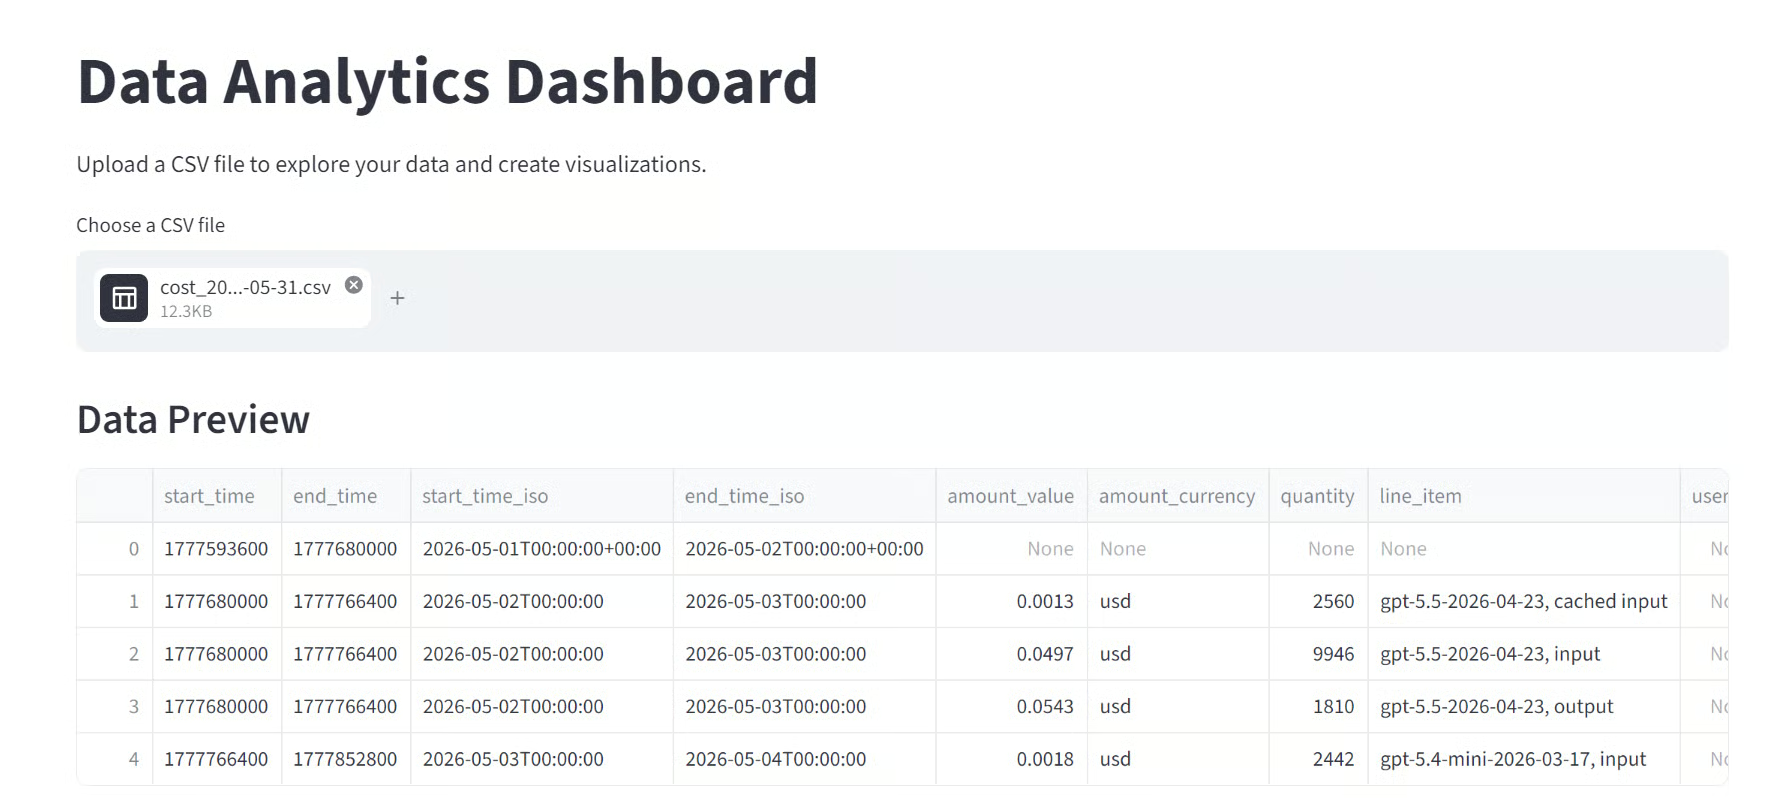
它在工具调用、终端命令与项目文件写入方面反复遇到困难。
它常常在规划好下一步之后无法完成行动,因此我不得不不断引导它处理错误并重试命令。
我无法确认问题是否来自模型、Pi 集成、本地权限,或这些因素的组合。
大约重试了 20 分钟后,它给出了可用结果。对于一个相对简单的 Streamlit 任务,这样的效率显得过慢且不稳定。
在我另一次测试中,使用 GLM 5.2 完成同一任务大约只用了一分钟。
将一个 12B 的本地模型与更大的前沿模型比较并不完全公平。
不过,差距依然明显。
Fable 5 增强版 Gemma 4 能生成精致的代码与强劲的单轮输出,但在此次测试中的真实代理表现并不稳定。对于本应由有能力的编码代理快速且独立完成的任务,它需要过多干预。
我的结论是,该模型适合用于本地试验、私有代码生成与轻量级工作流。
但基于此次测试,我暂时不会将其用于需要可靠性的多步编码代理任务。
虽然本指南提供了简便的模型测试方法,但您仍可能因硬件、本地环境与 llama.cpp 构建差异而遇到问题。
如果服务器在加载 MTP 草稿模型时崩溃,并显示如下错误:
invalid vector subscript问题可能出在您的 llama.cpp 构建版本,而非模型文件。
模型仓库报告称,llama.cpp 构建 b9553 可与 Gemma 4 的 MTP 草稿模型配合使用,而较新的构建如 b9702 与 b9717 可能在加载草稿模型时失败。
快速的回退方案是从服务器命令中移除 MTP 参数,只运行主模型。模型仍能正常工作,但生成速度可能会更慢。
移除以下行:
--model-draft "$MODEL_DIR/MTP/gemma-4-12B-it-MTP-Q8_0.gguf"
--spec-type draft-mtp
--spec-draft-n-max 2
-ngld 99如果在响应中看到 <|tool_call> 或 <|channel> 等标记,说明客户端没有正确应用 Gemma 4 的原生工具调用格式。
确保服务器命令中包含:
--jinja然后重启服务器。这将为模型的推理与结构化工具调用应用正确的聊天模板。
首先,检查 llama.cpp 服务器是否仍在运行:
curl http://127.0.0.1:8910/v1/models您应当能在响应中看到 Fable5-Gemma4。
然后,确保 Pi 指向的是 8910 端口,而不是 llama.cpp 默认的 8080:
export LLAMA_BASE_URL="http://127.0.0.1:8910/v1"
pi
请在同一终端会话中运行这两个命令。
在可写的项目目录中启动 Pi:
cd /workspace/data-app
pi
您可以测试当前目录是否允许创建文件:
touch write-test.txt && rm write-test.txt如果此命令失败,问题在于工作区权限,而非模型本身。请切换到可写目录后再启动 Pi。
如果模型开始重复文本、数字或符号,请检查服务器命令中的采样设置。
使用以下取值:
--temp 1.0 \
--top-p 0.95 \
--top-k 64 \
--repeat-penalty 1.1
重复惩罚尤为重要。没有它,模型可能会产生重复或乱码输出。
256K 上下文窗口需要较大的 KV 缓存。如果服务器显存不足,请先减小上下文大小:
--ctx-size 32768您也可以禁用 MTP 草稿模型以释放更多显存。使用以下命令查看当前 GPU 显存占用:
nvidia-smi模型可以生成高质量代码,但在未经干预的情况下仍可能难以完成较长任务。在我的测试中,它有时会规划出正确行动,但在运行命令、写入文件或出错后继续执行时失败。
为获得更好的结果,请将大型请求拆分为小任务:
这样可以让模型在每一步拥有更小的目标,并更容易定位故障来自模型、Pi、服务器还是工作区权限。
就我的测试而言,我认为围绕该模型的热度并不完全合理。无论是否启用 MTP,在通用任务中速度几乎相同;在编码任务中,MTP 确实有所帮助,我看到大约 20% 到 30% 的提速。这有用,但并不能解决更大的问题:可靠性。
我也在 WebUI 中测试了该模型。
有时在为某个文件写代码时,它会莫名其妙地停下。当我让它继续时,它会把续写内容作为下一条聊天回复的文本输出,而不是继续写入文件。
我也注意到,启用“思考”有时会让输出更差,这有些出乎意料。
我还在 Claude Code 中测试过,体验更令人挫败。
该模型不断创建多余文件、临时文件和其他与简单项目无关的内容。它最终完成了任务,但过程需要过多引导,耗时过长。
我知道将一个 12B 的本地模型与 GPT-5.5 或 GLM 5.2 比较并不完全公平。但即便与更小的本地模型相比,我也并不惊艳。
就我的经验而言,Qwen3.6 27B 在编程与代理任务上要出色得多,尽管它更大。
目前,我更将此模型视为一个有趣的实验,而非可靠的编码代理。
我对同一创作者即将推出的 Fable 调优版 Qwen3.6 27B 更感兴趣。我也看到其他一些开源贡献者发布了类似的蒸馏编码模型,但截至目前,我尚未在真实的编码代理任务上看到显著改进。
该模型可以生成好看的代码和精致的单轮输出。但当您要求它像代理一样工作、使用工具、创建文件、修复错误并验证结果时,它的表现仍不稳定,使用起来令人沮丧。
Top DataCamp Courses
课程
课程
学习路径