
कोर्स
एडवांस्ड AI-असिस्टेड कोडिंग फॉर डेवलपर्स
1 घंटा 30 मिनट
1.8K
जब Fable 5 और Mythos 5 बंद हो गए, तो ओपन-सोर्स डेवलपर्स ने उच्च-गुणवत्ता वाले सिंथेटिक कोडिंग और एजेंटिक डेटा पर प्रशिक्षित छोटे लोकल मॉडलों के साथ प्रयोग करना शुरू किया। Fable 5-Enhanced Gemma 4 ऐसा ही एक उदाहरण है।
यह Gemma 4 12B का एक फाइन-ट्यून है, जिसे Fable 5 और Composer 2.5 द्वारा जनित डेटासेट्स पर प्रशिक्षित किया गया है। लक्ष्य है कि उपयोगी कोडिंग और एजेंटिक व्यवहारों को एक छोटे मॉडल में ट्रांसफर किया जाए, जो लोकल पर चल सके।
इसका प्रशिक्षण व्यावहारिक वर्कफ़्लोज़ पर केंद्रित है—कार्य को समझना, फाइलें पढ़ना, टूल्स का उपयोग करना, कोड संपादित करना, कमांड चलाना, और अंतिम परिणाम की जाँच करना।
इस गाइड में, मैं आपको दिखाऊँगा कि RTX 5070 Ti पर llama.cpp का उपयोग करके Fable 5-एन्हांस्ड Gemma 4 मॉडल को लोकल पर कैसे चलाएँ।
हम llama.cpp इंस्टॉल करेंगे, GGUF मॉडल और MTP ड्राफ्ट मॉडल डाउनलोड करेंगे, OpenAI-कम्पैटिबल लोकल सर्वर लॉन्च करेंगे, और उसे cURL तथा बिल्ट-इन WebUI से टेस्ट करेंगे।
अंत में, हम मॉडल को Pi Coding Agent से जोड़ेंगे और उसे एक वास्तविक कोडिंग टास्क देंगे। मुख्य सवाल यह है कि क्या यह कॉम्पैक्ट 12B मॉडल उपयोगी कोडिंग-एजेंट व्यवहार दे सकता है और Qwen 3.6 27B या Gemma 4 31B जैसे बड़े लोकल मॉडलों से टक्कर ले सकता है।
Fable 5-Enhanced Gemma 4 Google के Gemma 4 12B इंस्ट्रक्शन मॉडल पर आधारित एक कॉम्पैक्ट कोडिंग और एजेंटिक मॉडल है। इसे Yuxin Lu ने बनाया है और इसे GGUF फ़ॉर्मैट में लोकल उपयोग के लिए llama.cpp और अन्य कम्पैटिबल टूल्स के साथ जारी किया गया है।
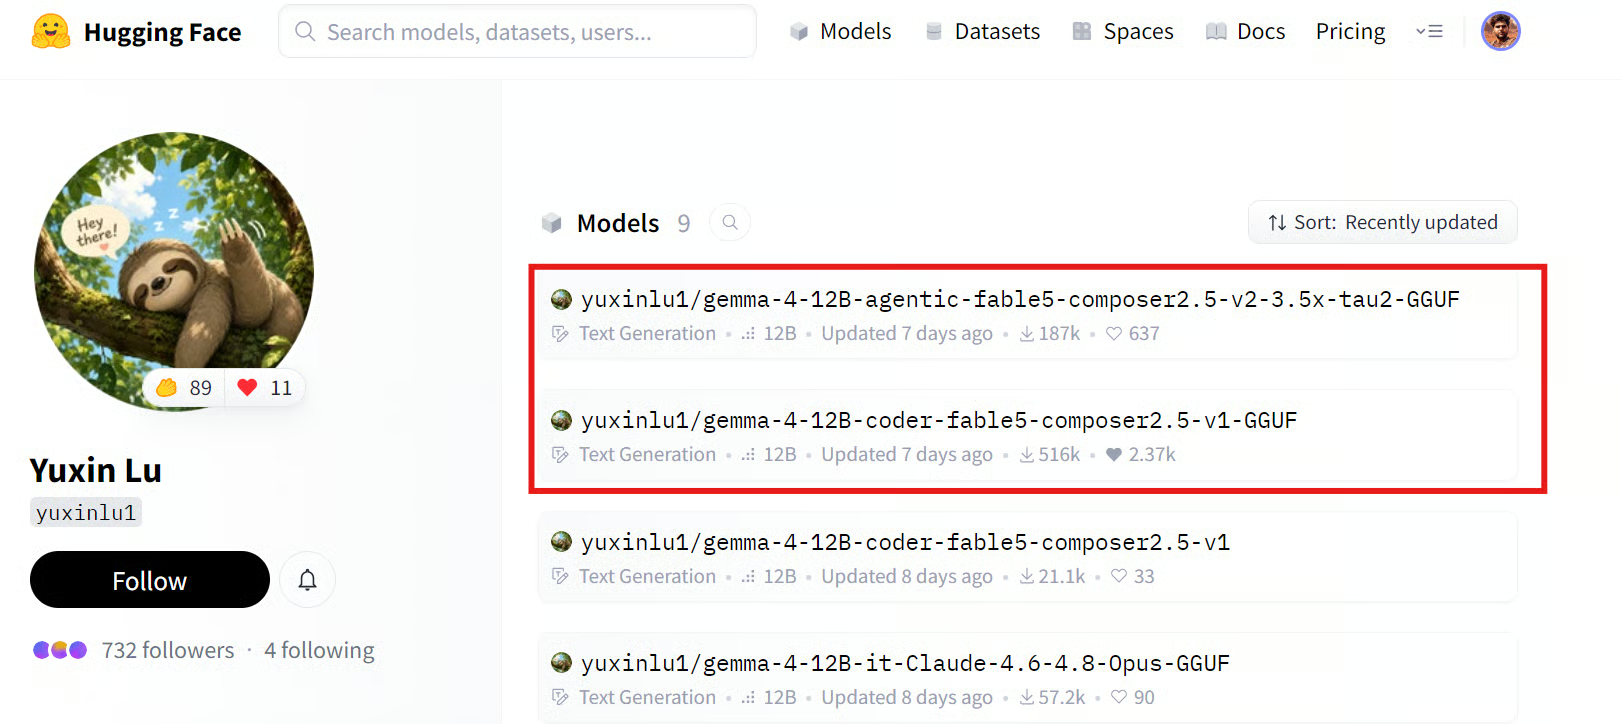
स्रोत: yuxinlu1 (Yuxin Lu)
यह गाइड v2 रिलीज़ उपयोग करता है। यह v1 कोडिंग मॉडल को आगे बढ़ाता है, लेकिन एजेंटिक तकनीकी कार्य पर और अधिक फोकस जोड़ता है।
सिर्फ कोड जनरेट करने के बजाय, इसे फाइलें जाँचने, समस्याओं पर तर्क करने, टूल्स का उपयोग करने, कोड एडिट करने, कमांड चलाने और अंतिम परिणाम की पुष्टि करने के लिए डिज़ाइन किया गया है।
मूल मॉडल को Composer 2.5 और Fable 5 द्वारा जनरेट किए गए सत्यापित Python कोडिंग डेटा पर फाइन-ट्यून किया गया था।
मुख्य ट्रेनिंग सेट में Composer 2.5 के रीजनिंग ट्रेसेज़ और निश्चित परीक्षणों वाले Python कार्यों के कोड समाधान शामिल हैं। केवल वही उदाहरण रखे गए, जिनमें जनित कोड ने परीक्षण पास किए।
जहाँ Composer 2.5 असफल रहा, वहाँ कठिन कार्यों के लिए Fable 5 का उपयोग किया गया। इसने उन उदाहरणों के लिए नया रीजनिंग प्रोसेस और संशोधित समाधान बनाए, जिन्हें ट्रेनिंग डेटा में जोड़ने से पहले निष्पादन के जरिए सत्यापित किया गया।
v2 में, मॉडल मल्टी-स्टेप टर्मिनल और टूल-यूज़ ट्रैजेक्टरीज़ जोड़ता है। ये इसे एक उत्तर देकर रुकने के बजाय पढ़ो, सोचो, करो, और सत्यापित करो वर्कफ़्लो का पालन करना सिखाते हैं।
Fable 5 अनुपलब्ध होने के बाद, कुछ गायब Fable 5-शैली के रीजनिंग ट्रेसेज़ को Opus 4.8 से पुनर्निर्मित किया गया।
--jinja सक्षम रखें ताकि मॉडल Gemma 4 के इच्छित चैट टेम्पलेट और टूल-कॉल फ़ॉर्मैट का उपयोग कर सके।लोकल tau2-bench टेलीकॉम तुलना में, v2 मॉडल लगभग 55% तक पहुँचा, जबकि बेस Gemma 4 12B इंस्ट्रक्शन मॉडल के लिए यह लगभग 15% था।
यह संकेत देता है कि मुख्य सुधार एजेंटिक व्यवहार से आता है। फाइन-ट्यून मॉडल किसी कार्य का निरीक्षण करने, अगला कदम उठाने, टूल्स का उपयोग करने और परिणामों की जाँच करने में बेहतर है—सिर्फ शुरुआती प्रतिक्रिया के बाद रुकने की बजाय।
Linux मशीन पर llama.cpp इंस्टॉल करने का यह सबसे तेज़ और सरल तरीका है। रेपो क्लोन कर के सोर्स से कम्पाइल करने की बजाय, इंस्टॉलर प्रीबिल्ट बायनरी डाउनलोड करता है और सेटअप कर देता है।
अपने टर्मिनल में यह कमांड चलाएँ:
curl -LsSf https://llama.app/install.sh | shकुछ ही सेकंड में इंस्टॉलर llama.cpp बाइनरी डाउनलोड कर लेगा और सेटअप पूरा कर देगा।
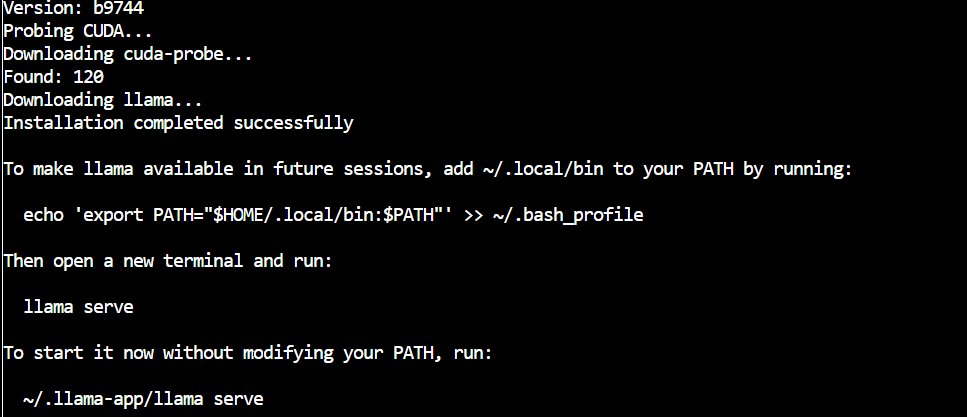
इसके बाद, llama.cpp को अपने PATH में जोड़ें ताकि आप llama कमांड को किसी भी डायरेक्टरी से चला सकें, यहाँ तक कि टर्मिनल रीस्टार्ट करने के बाद भी:
echo 'export PATH="$HOME/.local/bin:$PATH"' >> ~/.bashrc
source ~/.bashrc
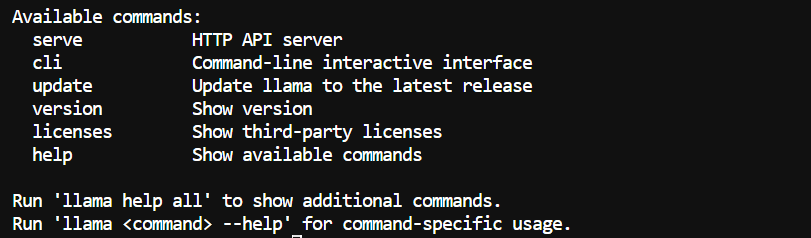
अंत में, सुनिश्चित करें कि इंस्टॉलेशन सफल रहा:
llama helpअब आपको उपलब्ध llama.cpp कमांड्स दिखने चाहिए।
अब Hugging Face CLI और hf-xet इंस्टॉल करें। इससे आप Hugging Face से सीधे मॉडल फाइलें डाउनलोड कर पाएँगे, जिनमें Xet स्टोरेज का उपयोग करने वाले बड़े फाइल रेपोजिटरी भी शामिल हैं।
pip install -U "huggingface_hub[cli]" hf-xet मॉडल फाइलों के लिए एक डायरेक्टरी बनाएँ:
MODEL_DIR="/workspace/Fable5-Gemma4"
mkdir -p "$MODEL_DIR"
तेज़ Xet डाउनलोड सक्षम करें, फिर केवल इस गाइड के लिए आवश्यक फाइलें डाउनलोड करें:
export HF_XET_HIGH_PERFORMANCE=1


hf download \
  yuxinlu1/gemma-4-12B-agentic-fable5-composer2.5-v2-3.5x-tau2-GGUF \
  --include "gemma4-v2-Q4_K_M.gguf" \
  --include "MTP/gemma-4-12B-it-MTP-Q8_0.gguf" \
  --local-dir "$MODEL_DIR"
यह दो फाइलें डाउनलोड करता है:
gemma4-v2-Q4_K_M.gguf, मुख्य Fable 5 Enhanced Gemma 4 मॉडल।MTP/gemma-4-12B-it-MTP-Q8_0.gguf, MTP speculative decoding के लिए बाद में उपयोग होने वाला ड्राफ्ट मॉडल।Q4_K_M मॉडल लगभग 7 GB का है। डाउनलोड समय आपके इंटरनेट कनेक्शन पर निर्भर करेगा, लेकिन Xet का उपयोग बड़े मॉडल फाइलों के ट्रांसफर प्रदर्शन में सुधार कर सकता है।
डाउनलोड पूरा होने के बाद, आपकी फाइलें यहाँ संग्रहीत होंगी:
/workspace/Fable5-Gemma4अब मुख्य मॉडल और MTP ड्राफ्ट मॉडल के साथ लोकल सर्वर शुरू करें:
MODEL_DIR="/workspace/Fable5-Gemma4"

llama serve \
  --model "$MODEL_DIR/gemma4-v2-Q4_K_M.gguf" \
  --alias Fable5-Gemma4 \
  --model-draft "$MODEL_DIR/MTP/gemma-4-12B-it-MTP-Q8_0.gguf" \
  --spec-type draft-mtp \
  --spec-draft-n-max 2 \
  -ngl 99 \
  -ngld 99 \
  --ctx-size 262144 \
  --parallel 1 \
  --cache-type-k q8_0 \
  --cache-type-v q8_0 \
  --flash-attn on \
  --jinja \
  --temp 1.0 \
  --top-p 0.95 \
  --top-k 64 \
  --repeat-penalty 1.1 \
  --host 0.0.0.0 \
  --port 8910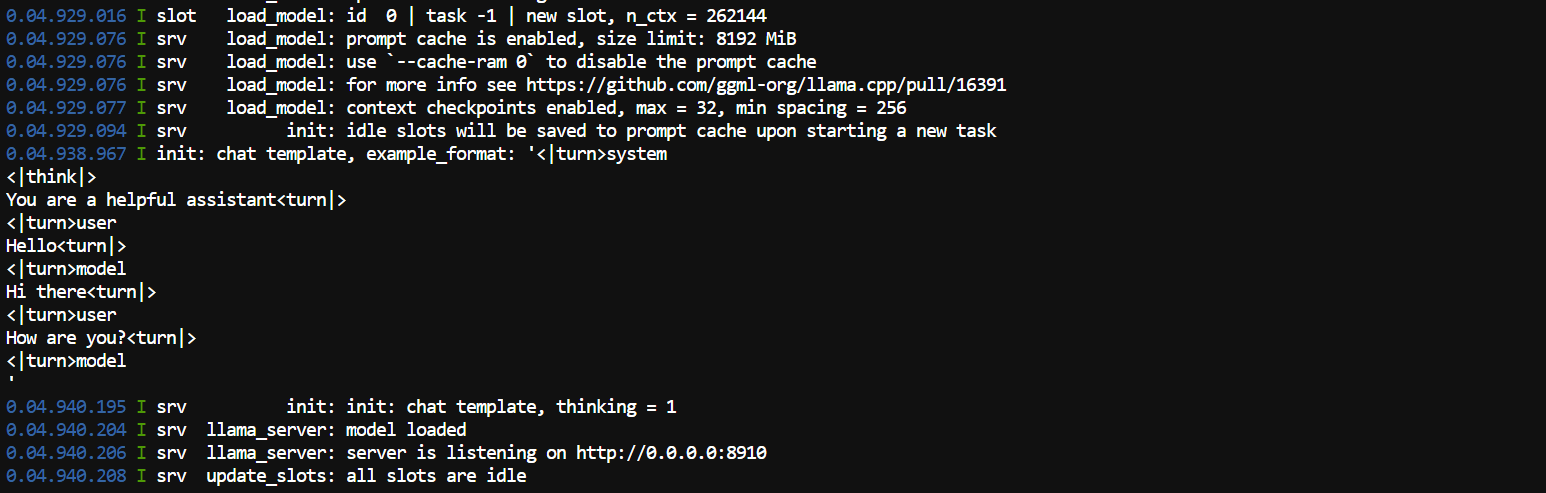
--model-draft आर्ग्यूमेंट MTP ड्राफ्ट मॉडल को लोड करता है।
MTP का अर्थ Multi Token Prediction है। छोटा ड्राफ्ट मॉडल पहले कुछ आने वाले टोकन्स का अनुमान लगाता है, और मुख्य मॉडल उन्हें समानांतर में वेरिफाई करता है। इससे मुख्य मॉडल की भूमिका बदले बिना जेनरेशन स्पीड में सुधार हो सकता है।
--spec-type draft-mtp इस MTP speculative decoding सेटअप को सक्षम करता है। --spec-draft-n-max 2 ड्राफ्ट मॉडल को एक समय में अधिकतम दो टोकन प्रस्तावित करने देता है। दो एक समझदार शुरुआती बिंदु है क्योंकि बड़े मान हमेशा स्पीड सुधार नहीं देते।
-ngl 99 मुख्य मॉडल को GPU पर ले जाता है, जबकि -ngld 99 MTP ड्राफ्ट मॉडल के लिए भी यही करता है। 99 का अर्थ है सभी उपलब्ध लेयर्स को ऑफ़लोड करना।
--ctx-size 262144 अधिकतम 256K टोकन का कॉन्टेक्स्ट विंडो सेट करता है। यह बड़े कोडबेस और लंबे टर्मिनल सत्रों के लिए उपयोगी है, लेकिन इसके लिए अधिक VRAM भी चाहिए। --parallel 1 पूरे कॉन्टेक्स्ट को एक सक्रिय अनुरोध के लिए आरक्षित करता है, उसे कई उपयोगकर्ताओं में बाँटने के बजाय।
Q8 KV-कैश सेटिंग्स लंबे कॉन्टेक्स्ट विंडो के लिए आवश्यक मेमोरी को कम करती हैं। --flash-attn on ध्यान (attention) की गणनाओं को अधिक कुशल बनाने में मदद करता है, खासकर लंबे प्रॉम्प्ट्स पर।
--jinja सक्षम रखें। यह मॉडल के बिल्ट-इन चैट टेम्पलेट को लागू करता है ताकि प्रॉम्प्ट्स, रीजनिंग और टूल कॉल्स सही फ़ॉर्मैट में हों।
शेष सैंपलिंग सेटिंग्स नियंत्रित करती हैं कि मॉडल टेक्स्ट कैसे जेनरेट करता है। --temp 1.0, --top-p 0.95 और --top-k 64 विविध प्रतिक्रियाएँ संभव बनाते हैं, जबकि --repeat-penalty 1.1 दोहराव वाले टेक्स्ट को घटाने में मदद करता है।
सर्वर लोड होने के बाद, WebUI खोलें:
http://localhost:8910 आप दूसरे टर्मिनल से GPU उपयोग भी देख सकते हैं:
nvidia-smi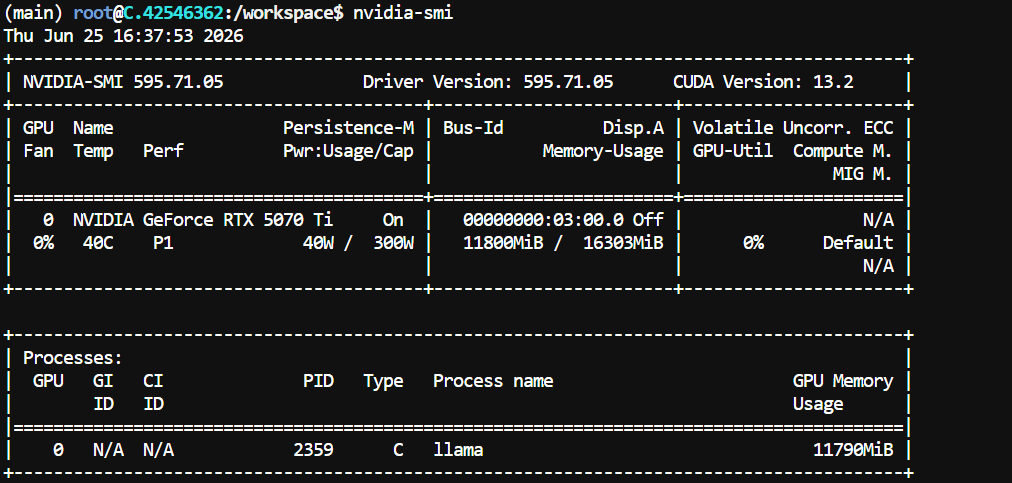
मेरे RTX 5070 Ti सेटअप पर, 256K कॉन्टेक्स्ट कॉन्फ़िगरेशन के साथ मॉडल ने लगभग 11.8 GB VRAM उपयोग की, जिससे 4 GB से अधिक उपलब्ध रहा।
आपका मेमोरी उपयोग llama.cpp बिल्ड, GPU ड्राइवर, और कॉन्टेक्स्ट सेटिंग्स पर निर्भर कर सकता है।
llama serve वाला टर्मिनल चलने दें, फिर लोकल API को टेस्ट करने के लिए तीसरा टर्मिनल खोलें।
curl http://127.0.0.1:8910/v1/messages \
  -H "Content-Type: application/json" \
  -d '{
    "model": "Fable5-Gemma4",
    "max_tokens": 512,
    "messages": [
      {
        "role": "user",
        "content": "Create a simple Python script that prints Hello, I am running locally! "
      }
    ]
  }'
रेस्पॉन्स में मॉडल का जनित टेक्स्ट और उसका सोच (thinking) आउटपुट होना चाहिए। इस टेस्ट में, मॉडल ने निम्नलिखित Python कोड लौटाया:
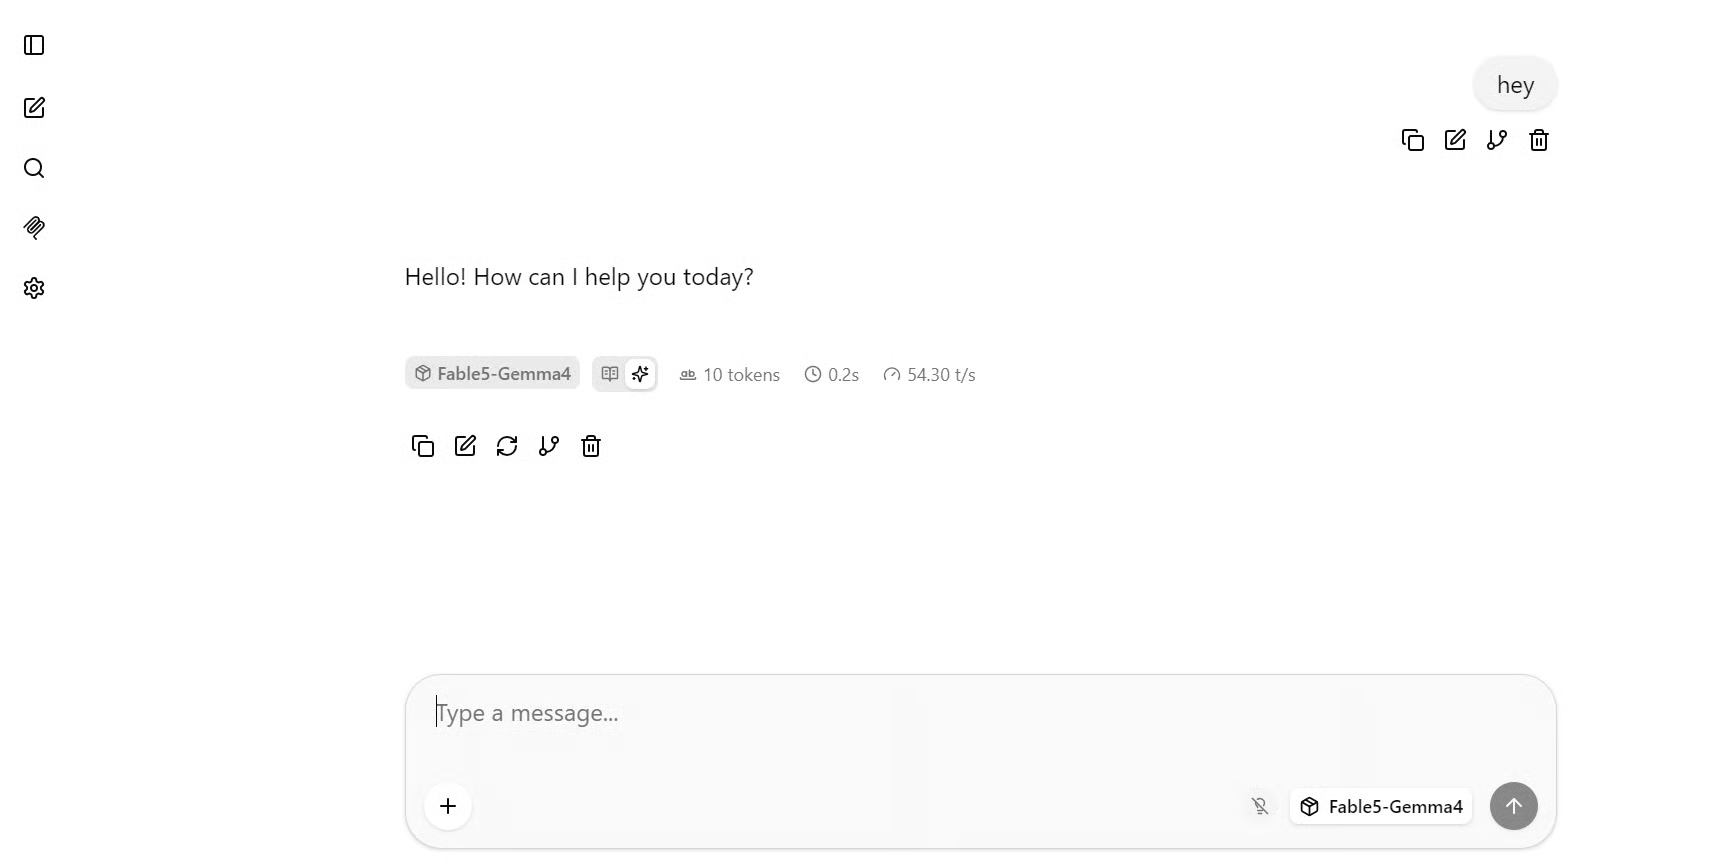
print("Hello, I am running locally!")एक JSON रेस्पॉन्स पुष्टि करता है कि लोकल सर्वर सही काम कर रहा है। मेरी त्वरित जाँच में, मॉडल लगभग 54 टोकन प्रति सेकंड की दर से जेनरेट कर रहा था।
आप बिल्ट-इन चैट इंटरफ़ेस का भी उपयोग कर सकते हैं। अपने ब्राउज़र में यह पता खोलें:
http://localhost:8910WebUI सामान्य चैट ऐप की तरह काम करता है। Fable5-Gemma4 मॉडल चुनें, प्रॉम्प्ट लिखें, और उसे लोकल सर्वर को भेजें।
बड़े कोडिंग टेस्ट के लिए, यह प्रॉम्प्ट उपयोग करें:
Create a calming, premium spa treatment center website in one self-contained HTML file
with all CSS and JavaScript included inline, elegant booking CTAs, treatment packages,
therapist profiles, testimonials, and high-quality spa imagery.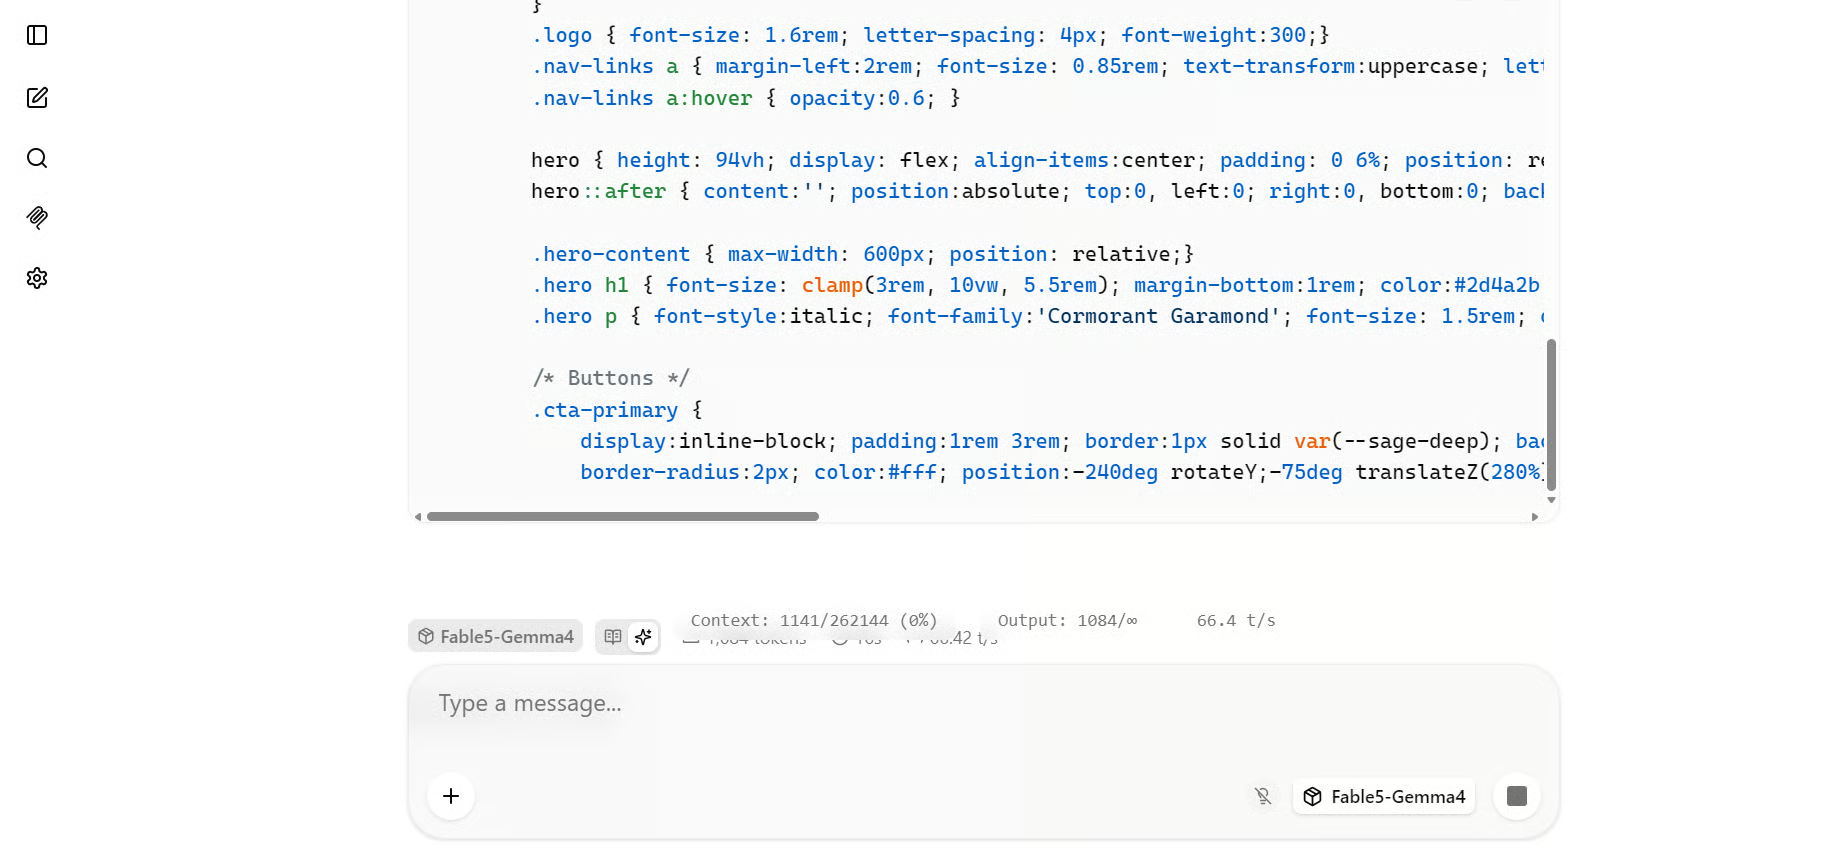
इस लंबे HTML जनरेशन कार्य के लिए, मुझे लगभग 66 से 70 टोकन प्रति सेकंड की रफ्तार दिखी। लंबे कोडिंग कार्य कभी-कभी बेहतर speculative-decoding प्रदर्शन देते हैं क्योंकि मॉडल अधिक सतत और अनुमानित कोड टोकनों का क्रम जेनरेट करता है।
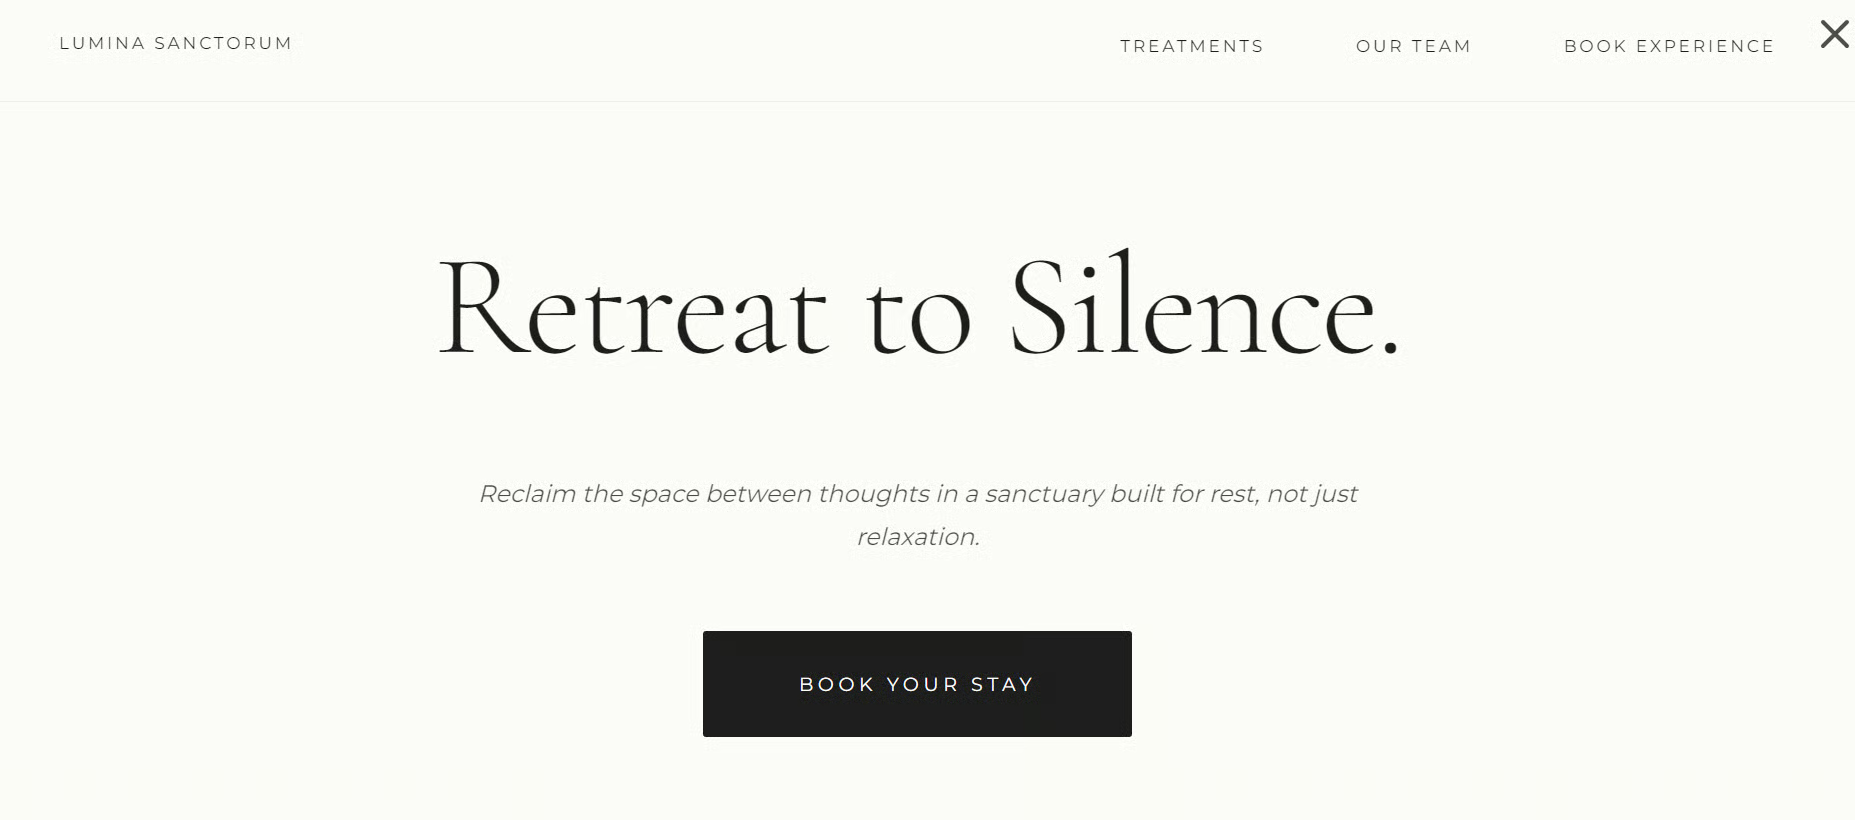
नीचे पहला परिणाम Medium रीजनिंग पर जेनरेट किया गया था। इसने न्यूनतम लेआउट, नेविगेशन लिंक्स और बड़े बुकिंग कॉल-टू-एक्शन के साथ एक साफ-सुथरा स्पा लैंडिंग पेज बनाया।
दूसरा परिणाम बिना रीजनिंग के जेनरेट किया गया था। इसमें बड़े हेडलाइन और अधिक एडिटोरियल लैंडिंग-पेज स्टाइल के साथ अलग विज़ुअल डायरेक्शन मिला।
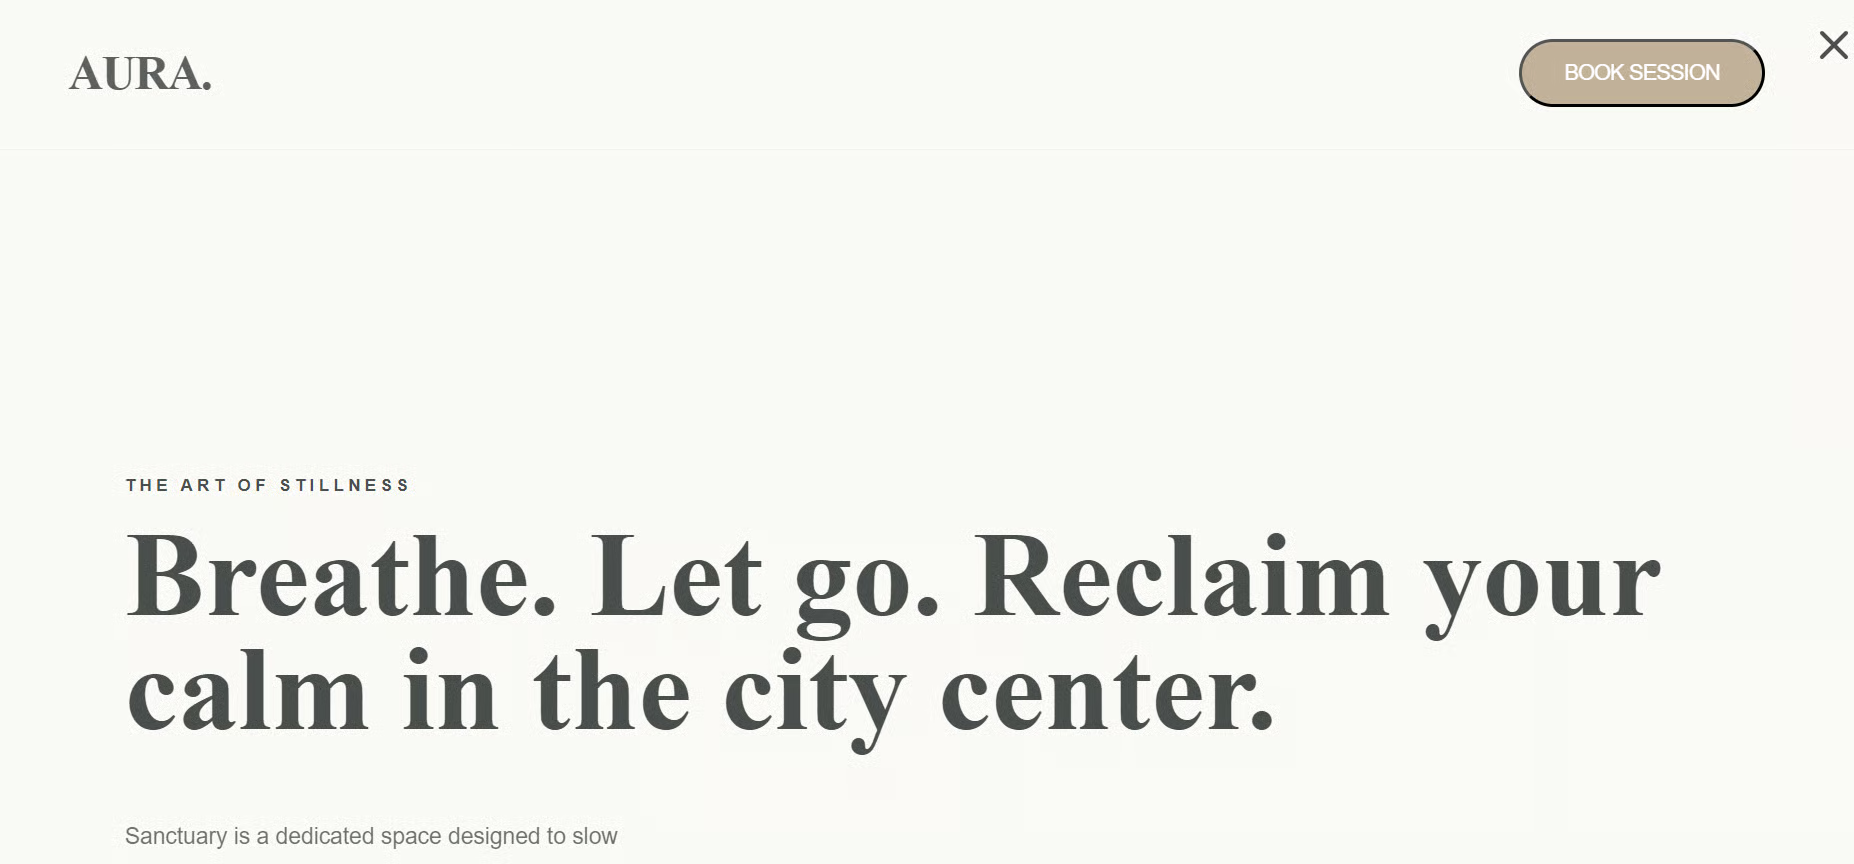
दोनों परिणाम विज़ुअली पॉलिश थे, लेकिन इस परीक्षण में रीजनिंग-सक्षम संस्करण ने अधिक संरचित परिणाम दिया।
टोकन स्पीड प्रॉम्प्ट की लंबाई, आउटपुट स्टाइल, GPU लोड, और MTP द्वारा प्रस्तावित ड्राफ्ट टोकनों को मुख्य मॉडल द्वारा स्वीकार किए जाने की दर पर निर्भर कर सकती है।
Pi एक हल्का टर्मिनल कोडिंग एजेंट है। यह लोकल Fable 5-Enhanced Gemma 4 सर्वर से कनेक्ट हो सकता है और फाइलें पढ़ने, कोड एडिट करने, कमांड चलाने और कोडिंग टास्क पूरे करने के लिए इसका उपयोग कर सकता है।
चौथा टर्मिनल खोलें और Pi इंस्टॉल करें:
curl -fsSL https://pi.dev/install.sh | sh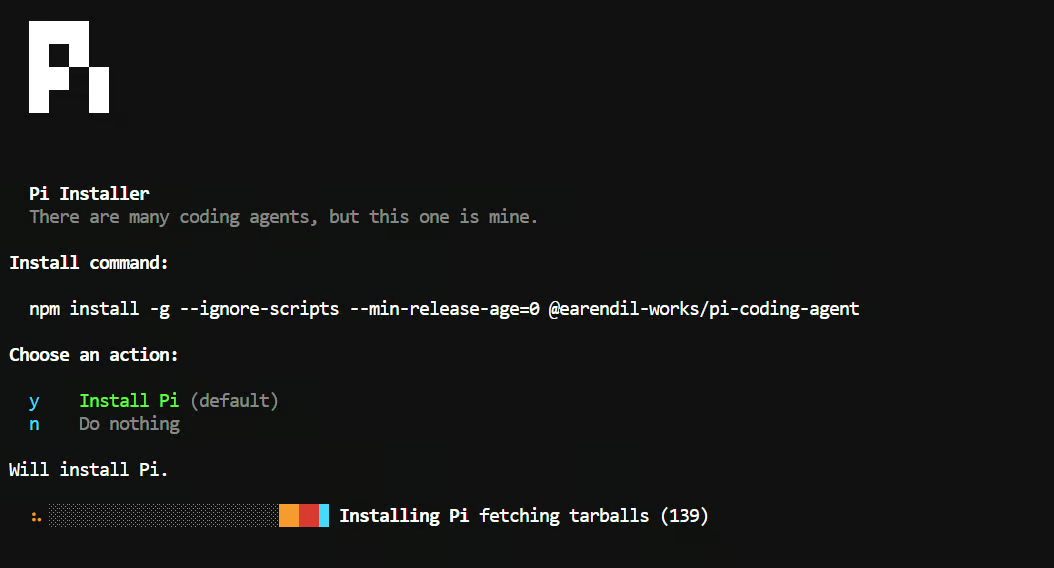 इंस्टॉलर Node.js इंस्टॉल करने के लिए कह सकता है। प्रॉम्प्ट स्वीकार करें और इंस्टॉलेशन पूरा होने तक प्रतीक्षा करें।
अपनी टर्मिनल कॉन्फ़िगरेशन रीलोड करें, फिर पुष्टि करें कि Pi उपलब्ध है:
source ~/.bashrc
pi --version
इसके बाद pi-llama प्लगइन इंस्टॉल करें:
pi install git:github.com/huggingface/pi-llamaयह प्लगइन Pi को चल रहे llama.cpp सर्वर से जोड़ता है और उपलब्ध लोकल मॉडलों को स्वचालित रूप से खोजता है।
डिफ़ॉल्ट रूप से, प्लगइन पोर्ट 8080 पर llama.cpp ढूँढता है। हमारा सर्वर 8910 पोर्ट उपयोग करता है, इसलिए Pi शुरू करने से पहले सही लोकल API पता सेट करें:
export LLAMA_BASE_URL="http://127.0.0.1:8910/v1"नया प्रोजेक्ट डायरेक्टरी बनाएँ, Git इनिशियलाइज़ करें, और Pi शुरू करें:
mkdir -p /workspace/data-app
cd /workspace/data-app
git init
pi
Pi के अंदर टाइप करें:
/model“Fable5-Gemma4” मॉडल चुनें।
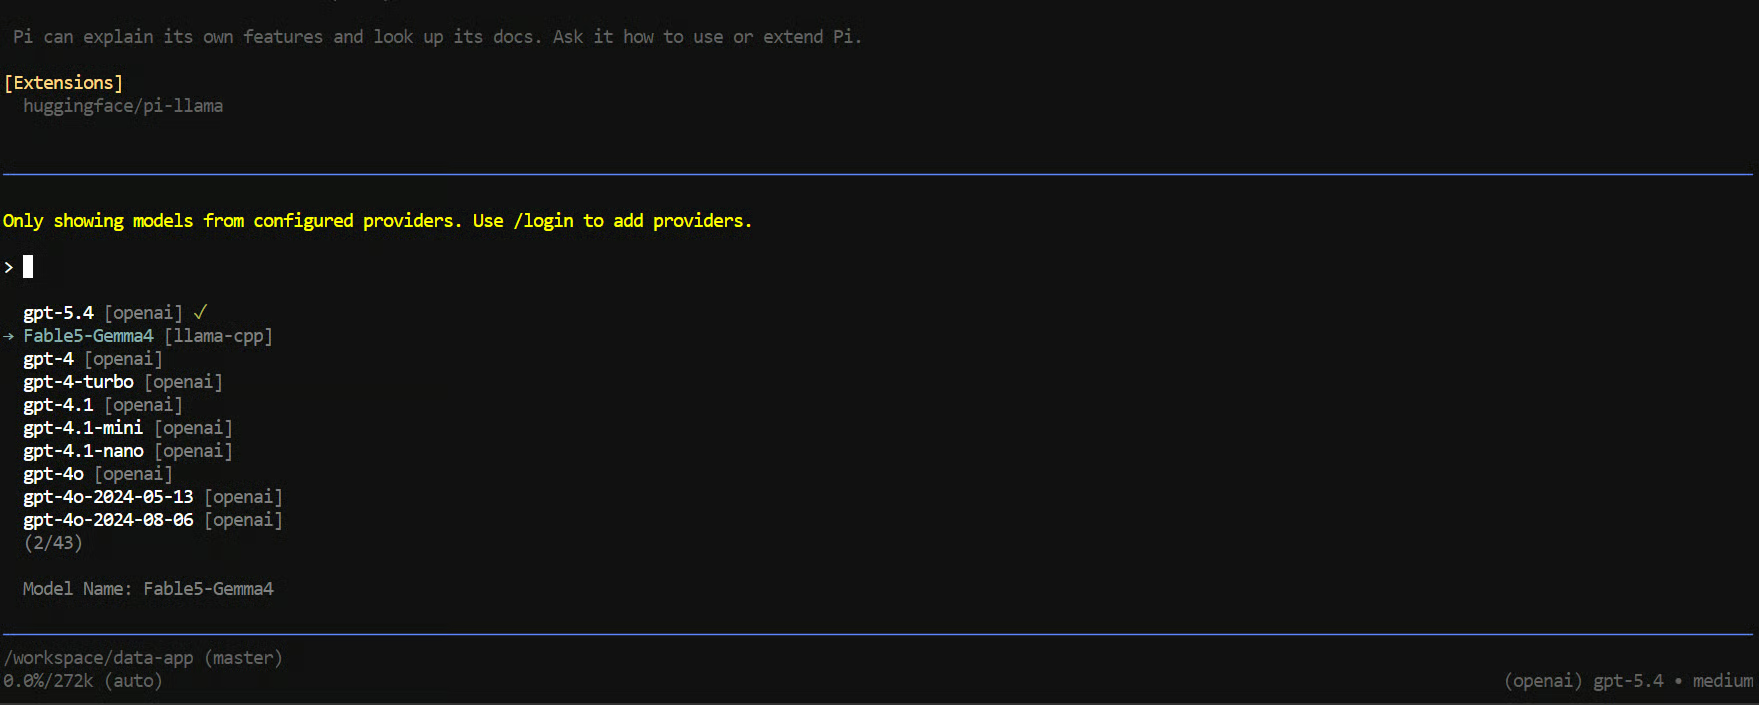
इसके बाद एजेंट को एक व्यावहारिक कोडिंग टास्क दें:
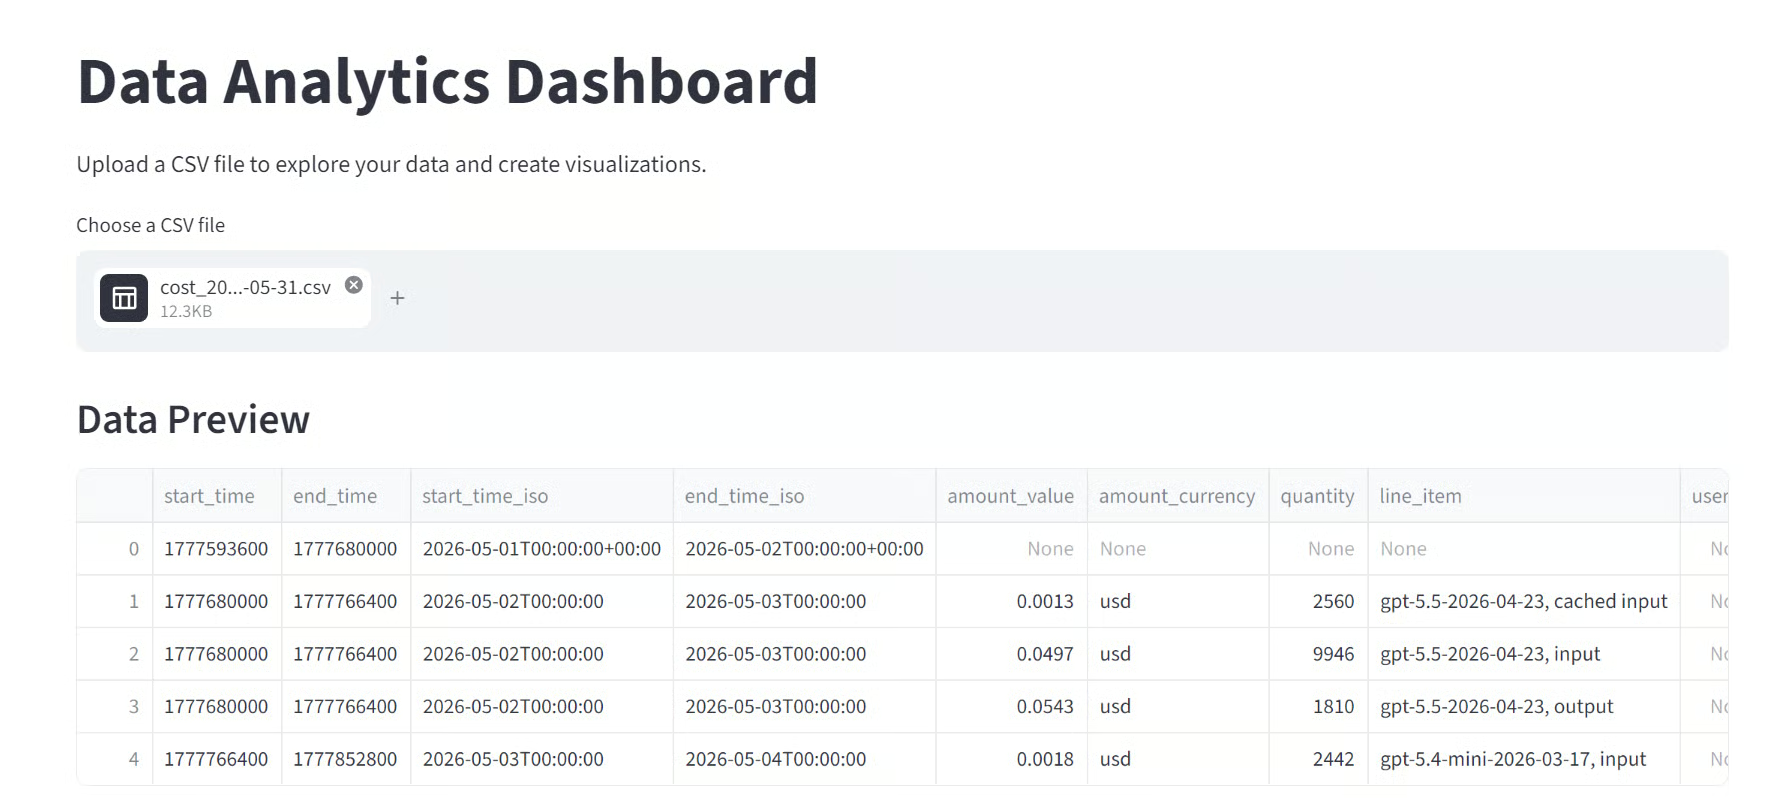
Create a simple data analytics dashboard using Streamlit that lets users
upload a CSV file, view the data, and explore clear visualizations.
Include a sample CSV file and test the full app to make sure it works correctly.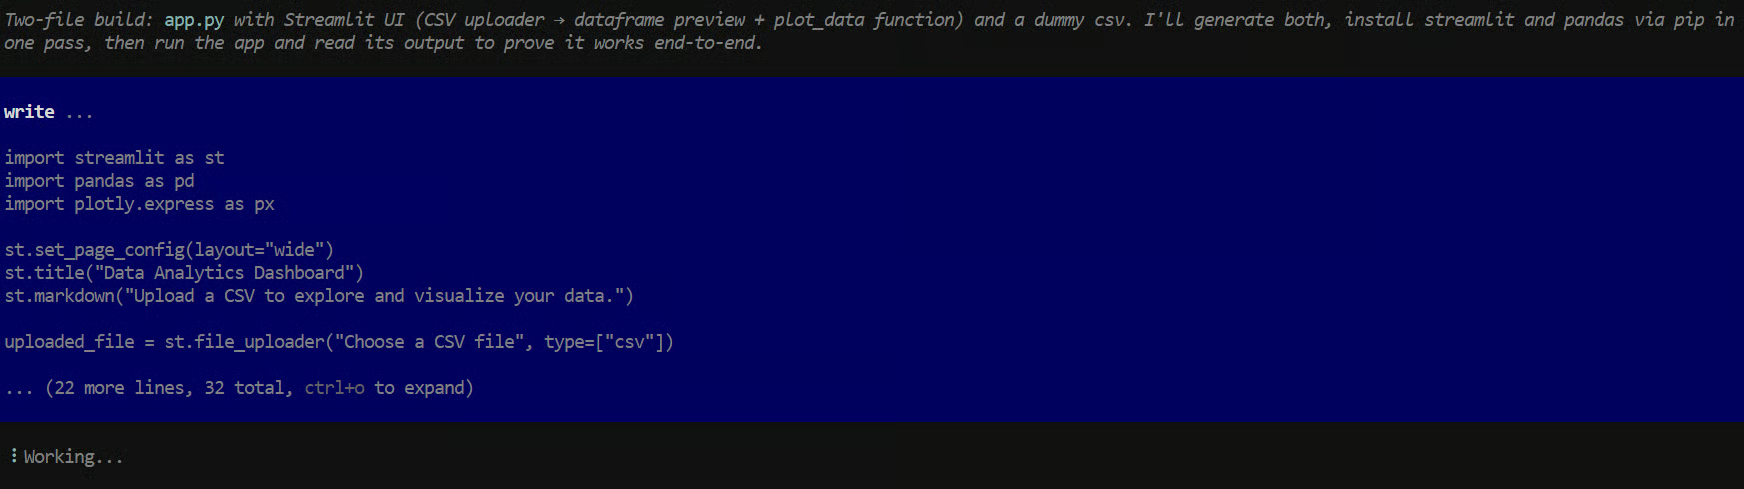
मॉडल ने अंततः CSV अपलोड सपोर्ट और विज़ुअलाइज़ेशन के साथ एक काम करता हुआ Streamlit डैशबोर्ड बना दिया।
हालाँकि, प्रक्रिया उम्मीद से कहीं ज़्यादा कठिन रही।
यह बार-बार टूल कॉल्स, टर्मिनल कमांड्स और प्रोजेक्ट फाइलें लिखने में अटकता रहा।
यह अक्सर योजना बनाने के बाद अगला कदम पूरा करने में विफल रहा, इसलिए मुझे त्रुटियों के माध्यम से इसे गाइड करना और कमांड्स को फिर से आज़माना पड़ा।
मैं पुष्टि नहीं कर सका कि यह मॉडल, Pi इंटीग्रेशन, लोकल परमिशन्स या इन कारकों के संयोजन के कारण था।
लगभग 20 मिनट के रिट्राय के बाद, इसने काम करता हुआ परिणाम दिया। इतने सरल Streamlit कार्य के लिए यह बहुत धीमा और अविश्वसनीय लगा।
उसी कार्य में मेरी अलग टेस्ट में GLM 5.2 को लगभग एक मिनट लगा।
एक 12B लोकल मॉडल की तुलना कहीं बड़े फ्रंटियर मॉडल से करना पूरी तरह उचित नहीं है।
फिर भी, अंतर स्पष्ट था।
Fable 5-Enhanced Gemma 4 पॉलिश्ड कोड और मजबूत सिंगल-टर्न आउटपुट दे सकता है, लेकिन इस टेस्ट में इसका वास्तविक एजेंटिक प्रदर्शन असंगत रहा। ऐसा कार्य जिसे एक सक्षम कोडिंग एजेंट को शीघ्र और स्वतन्त्र रूप से पूरा करना चाहिए, उसके लिए इसे बहुत अधिक हस्तक्षेप की आवश्यकता पड़ी।
मेरा निष्कर्ष है कि यह मॉडल लोकल प्रयोग, निजी कोड जेनरेशन और हल्के वर्कफ़्लोज़ के लिए दिलचस्प है।
लेकिन इस परीक्षण के आधार पर, मैं अभी इसे भरोसेमंद मल्टी-स्टेप कोडिंग-एजेंट कार्यों के लिए उपयोग करने की सलाह नहीं दूँगा।
यह गाइड मॉडल को टेस्ट करने का सरल तरीका देता है, लेकिन आपके हार्डवेयर, लोकल सेटअप और llama.cpp बिल्ड के आधार पर समस्याएँ आ सकती हैं।
यदि सर्वर MTP ड्राफ्ट मॉडल लोड करते समय क्रैश हो जाए और ऐसा एरर दिखे:
invalid vector subscriptतो समस्या मॉडल फाइलों के बजाय आपके llama.cpp बिल्ड में हो सकती है।
मॉडल रेपोजिटरी में बताया गया है कि llama.cpp बिल्ड b9553 Gemma 4 MTP ड्राफ्ट मॉडल के साथ काम करता है, जबकि b9702 और b9717 जैसे नए बिल्ड ड्राफ्ट-मॉडल लोडिंग के दौरान फेल हो सकते हैं।
जल्दी फॉलबैक के तौर पर, सर्वर कमांड से MTP आर्ग्यूमेंट्स हटा दें और केवल मुख्य मॉडल चलाएँ। मॉडल फिर भी सही काम करेगा, लेकिन जेनरेशन धीमी हो सकती है।
इन लाइनों को हटाएँ:
--model-draft "$MODEL_DIR/MTP/gemma-4-12B-it-MTP-Q8_0.gguf"
--spec-type draft-mtp
--spec-draft-n-max 2
-ngld 99अगर आपको रेस्पॉन्स में <|tool_call> या <|channel> जैसे टोकन दिखते हैं, तो क्लाइंट Gemma 4 के नेटिव टूल-कॉल फ़ॉर्मैट को सही से लागू नहीं कर रहा है।
पक्का करें कि आपके सर्वर कमांड में यह शामिल है:
--jinjaफिर सर्वर रीस्टार्ट करें। यह मॉडल की रीजनिंग और संरचित टूल कॉल्स के लिए सही चैट टेम्पलेट लागू करता है।
पहले जाँचें कि llama.cpp सर्वर अभी भी चल रहा है:
curl http://127.0.0.1:8910/v1/modelsआपको रेस्पॉन्स में Fable5-Gemma4 दिखना चाहिए।
इसके बाद, सुनिश्चित करें कि Pi डिफ़ॉल्ट llama.cpp पोर्ट 8080 की बजाय 8910 पोर्ट की ओर पॉइंट कर रहा है:
export LLAMA_BASE_URL="http://127.0.0.1:8910/v1"
pi
दोनों कमांड्स उसी टर्मिनल सत्र में चलाएँ।
Pi को किसी writable प्रोजेक्ट डायरेक्टरी के अंदर शुरू करें:
cd /workspace/data-app
pi
आप जाँच सकते हैं कि मौजूदा डायरेक्टरी फाइल बनाना अनुमति देती है या नहीं:
touch write-test.txt && rm write-test.txtयदि यह कमांड असफल हो, तो समस्या मॉडल नहीं बल्कि वर्कस्पेस परमिशन की है। Pi लॉन्च करने से पहले किसी writable डायरेक्टरी में जाएँ।
यदि मॉडल टेक्स्ट, संख्याएँ या प्रतीक दोहराने लगे, तो अपने सर्वर कमांड की सैंपलिंग सेटिंग्स जाँचें।
इन मानों का उपयोग करें:
--temp 1.0 \
--top-p 0.95 \
--top-k 64 \
--repeat-penalty 1.1
रिपीटेशन पेनल्टी विशेष रूप से महत्वपूर्ण है। इसके बिना, मॉडल दोहरावदार या गड़बड़ आउटपुट दे सकता है।
256K कॉन्टेक्स्ट विंडो के लिए बड़ा KV कैश चाहिए। यदि सर्वर VRAM से बाहर हो जाए, तो पहले कॉन्टेक्स्ट साइज घटाएँ:
--ctx-size 32768आप अधिक VRAM मुक्त करने के लिए MTP ड्राफ्ट मॉडल को भी अक्षम कर सकते हैं। अपनी मौजूदा GPU मेमोरी उपयोग जाँचें:
nvidia-smiमॉडल मजबूत कोड जनरेट कर सकता है, लेकिन बिना हस्तक्षेप के लंबे कार्य पूरे करने में अब भी जूझ सकता है। मेरे परीक्षण में, यह कभी-कभी सही कदम प्लान करता था, लेकिन कमांड चलाते, फाइलें लिखते, या त्रुटि के बाद आगे बढ़ते समय फेल हो जाता था।
बेहतर परिणामों के लिए, बड़े अनुरोधों को छोटे टास्क में बाँटें:
इससे मॉडल को हर स्टेप पर छोटा लक्ष्य मिलता है और यह पहचानना आसान हो जाता है कि विफलता मॉडल, Pi, सर्वर या वर्कस्पेस परमिशन्स में से कहाँ से आ रही है।
मेरे परीक्षण के आधार पर, मुझे नहीं लगता कि इस मॉडल के बारे में हो रहा हाइप पूरी तरह उचित है। MTP के साथ और बिना, मुझे सामान्य कार्यों के लिए लगभग समान स्पीड मिली। कोडिंग टास्क के दौरान MTP ने मदद की, और मुझे लगभग 20% से 30% स्पीड बूस्ट दिखा। यह उपयोगी है, लेकिन यह बड़ी समस्या ठीक नहीं करता: विश्वसनीयता।
मैंने मॉडल को WebUI में भी टेस्ट किया।
कभी-कभी, किसी फाइल के लिए कोड लिखते हुए यह बिना स्पष्ट कारण के रुक जाता था। जब मैंने इसे जारी रखने को कहा, तो उसने वास्तव में फाइल जारी रखने के बजाय अगली चैट प्रतिक्रिया में टेक्स्ट के रूप में कंटिन्यूएशन लिख दिया।
मैंने देखा कि कभी-कभी thinking सक्षम करने से आउटपुट और खराब हो जाता था, जो चौंकाने वाला था।
मैंने इसे Claude Code में भी आज़माया, और वह अनुभव और अधिक निराशाजनक था।
मॉडल बार-बार अतिरिक्त फाइलें, अस्थायी फाइलें और अन्य अप्रासंगिक चीज़ें बनाता रहा, जिनकी किसी साधारण प्रोजेक्ट को ज़रूरत नहीं थी। अंततः उसने कार्य पूरा किया, लेकिन इसमें बहुत अधिक गाइडेंस और बहुत अधिक समय लगा।
मुझे पता है कि 12B लोकल मॉडल की तुलना GPT-5.5 या GLM 5.2 से करना पूरी तरह उचित नहीं है। लेकिन छोटे लोकल मॉडलों की तुलना में भी, मैं प्रभावित नहीं हुआ।
मेरे अनुभव में, Qwen3.6 27B कोडिंग और एजेंटिक कार्यों के लिए कहीं बेहतर है, भले ही यह बड़ा हो।
फ़िलहाल, मैं इस मॉडल को भरोसेमंद कोडिंग एजेंट की बजाय एक दिलचस्प प्रयोग के रूप में देखता हूँ।
मैं उसी निर्माता के आगामी Fable-ट्यून Qwen3.6 27B मॉडल में अधिक रुचि रखता हूँ। मैंने अन्य कई ओपन-सोर्स योगदानकर्ताओं को भी इसी तरह के डिस्टिल्ड कोडिंग मॉडल जारी करते देखा है, लेकिन अब तक वास्तविक कोडिंग-एजेंट कार्यों में बड़ा सुधार नहीं देखा।
मॉडल अच्छा दिखने वाला कोड और पॉलिश्ड सिंगल-टर्न आउटपुट जेनरेट कर सकता है। लेकिन जब आप इसे एजेंट की तरह काम करने, टूल्स उपयोग करने, फाइलें बनाने, त्रुटियाँ ठीक करने और परिणाम वेरिफाई करने को कहते हैं, तो उपयोग में यह अभी भी असंगत और निराशाजनक लगता है।
Top DataCamp Courses
कोर्स
कोर्स
लर्निंग पाथ