Cours
Programmation assistée par IA avancée pour les développeurs
1 h 30 min
1.8K
Après l’arrêt de Fable 5 et Mythos 5, la communauté open source a commencé à expérimenter des modèles locaux plus petits, entraînés sur des données synthétiques de qualité pour le code et l’agentisation. Fable 5-Enhanced Gemma 4 en est un exemple.
Il s’agit d’un affinement (fine-tune) de Gemma 4 12B entraîné sur des jeux de données générés par Fable 5 et Composer 2.5. L’objectif est de transférer des comportements utiles de codage et d’agent dans un modèle plus compact pouvant tourner en local.
La formation cible des flux de travail concrets : comprendre une tâche, lire des fichiers, utiliser des outils, éditer du code, exécuter des commandes et vérifier le résultat final.
Dans ce guide, je vous montre comment exécuter le modèle Fable 5-enhanced Gemma 4 en local sur un RTX 5070 Ti avec llama.cpp.
Nous allons installer llama.cpp, télécharger le modèle GGUF et le modèle d’ébauche MTP, lancer un serveur local compatible OpenAI, puis le tester avec cURL et l’interface Web intégrée.
Enfin, nous connecterons le modèle à Pi Coding Agent et lui confierons une véritable tâche de code. La question principale : ce modèle compact de 12B peut-il adopter un comportement d’agent de code utile et rivaliser avec des modèles locaux plus grands comme Qwen 3.6 27B ou Gemma 4 31B ?
Fable 5-Enhanced Gemma 4 est un modèle compact axé sur le code et l’agentisation, basé sur le modèle instruction Gemma 4 12B de Google. Il a été créé par Yuxin Lu et publié au format GGUF pour un usage local avec llama.cpp et d’autres outils compatibles.
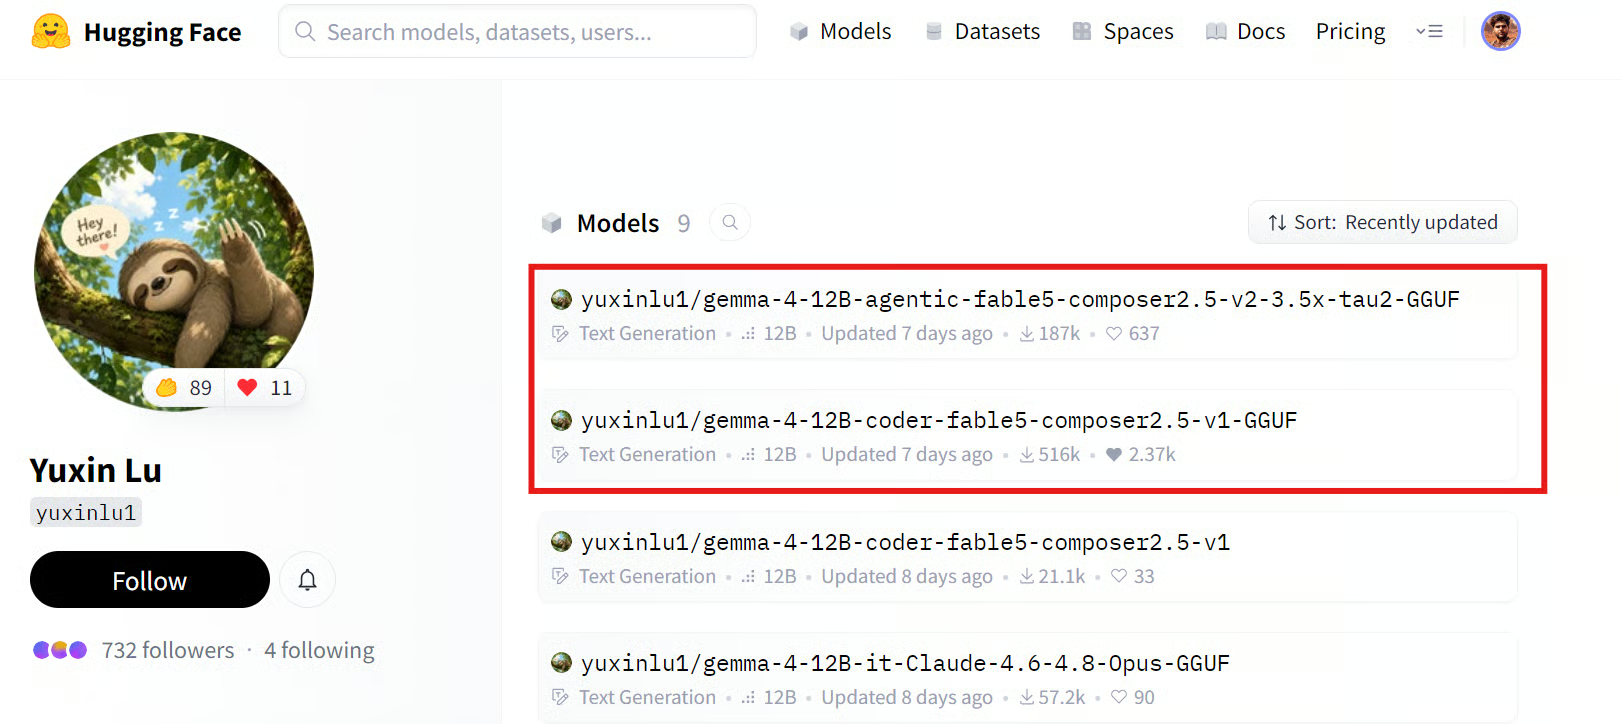
Source : yuxinlu1 (Yuxin Lu)
Ce guide utilise la version v2. Elle prolonge le modèle de code v1, tout en renforçant l’accent sur le travail technique agentique.
Plutôt que de seulement générer du code, elle est conçue pour inspecter des fichiers, raisonner sur des problèmes, utiliser des outils, modifier du code, exécuter des commandes et valider le résultat final.
Le modèle d’origine a été affiné sur des données Python vérifiées, générées par Composer 2.5 et Fable 5.
L’essentiel du jeu d’entraînement utilise les traces de raisonnement de Composer 2.5 et des solutions de code pour des tâches Python avec tests déterministes. Seuls les exemples dont le code généré passait les tests ont été conservés.
Fable 5 a été mobilisé pour les tâches plus difficiles où Composer 2.5 échouait. Il a produit un nouveau cheminement de raisonnement et des corrections, vérifiés par exécution avant d’être ajoutés aux données d’entraînement.
Pour la v2, le modèle ajoute des trajectoires multi-étapes au terminal et à l’usage d’outils. L’objectif est d’enseigner un cycle lire, raisonner, agir et vérifier, plutôt que de donner une seule réponse puis s’arrêter.
Après l’indisponibilité de Fable 5, certaines traces de raisonnement manquantes de style Fable 5 ont été reconstruites avec Opus 4.8.
--jinja activé dans llama.cpp pour que le modèle utilise le gabarit de chat et le format d’appels d’outils prévus pour Gemma 4.Dans une comparaison locale tau2-bench télécom, le modèle v2 atteint environ 55 %, contre environ 15 % pour le modèle instruction Gemma 4 12B de base.
Cela suggère que le principal gain provient du comportement agentique. Le modèle affiné inspecte mieux la tâche, choisit l’action suivante, utilise des outils et vérifie les résultats au lieu de s’arrêter après une première réponse.
C’est la méthode la plus rapide et la plus simple pour installer llama.cpp sur une machine Linux. Plutôt que de cloner le dépôt et de compiler depuis les sources, l’installeur télécharge un binaire précompilé et fait la configuration pour vous.
Exécutez la commande suivante dans votre terminal :
curl -LsSf https://llama.app/install.sh | shEn quelques secondes, l’installeur télécharge le binaire llama.cpp et finalise la configuration.
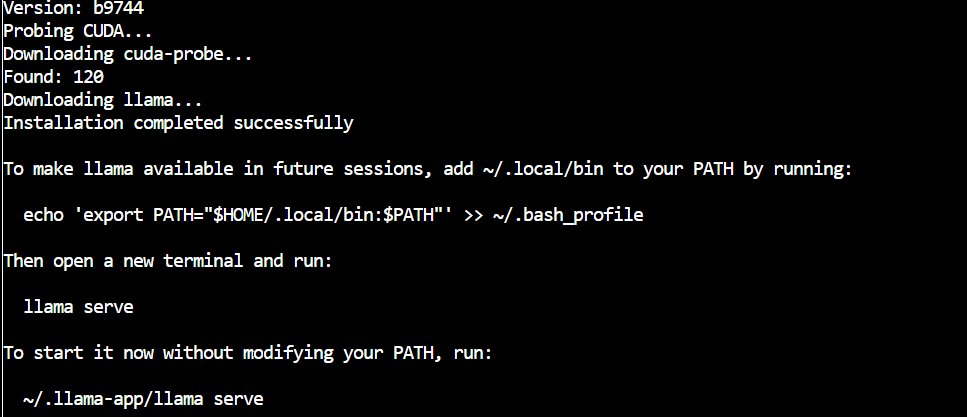
Ajoutez ensuite llama.cpp à votre PATH pour pouvoir lancer la commande llama depuis n’importe quel répertoire, y compris après avoir redémarré le terminal :
echo 'export PATH="$HOME/.local/bin:$PATH"' >> ~/.bashrc
source ~/.bashrc
Enfin, vérifiez que l’installation a fonctionné :
llama helpVous devriez voir apparaître les commandes disponibles de llama.cpp.
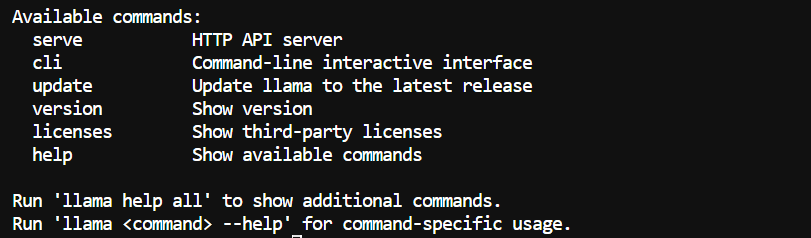
Installez ensuite le CLI Hugging Face et hf-xet. Vous pourrez ainsi télécharger directement les fichiers du modèle depuis Hugging Face, y compris les dépôts qui utilisent le stockage Xet pour les gros fichiers.
pip install -U "huggingface_hub[cli]" hf-xet Créez un répertoire pour les fichiers du modèle :
MODEL_DIR="/workspace/Fable5-Gemma4"
mkdir -p "$MODEL_DIR"
Activez des téléchargements Xet plus rapides, puis ne récupérez que les fichiers requis pour ce guide :
export HF_XET_HIGH_PERFORMANCE=1


hf download \
  yuxinlu1/gemma-4-12B-agentic-fable5-composer2.5-v2-3.5x-tau2-GGUF \
  --include "gemma4-v2-Q4_K_M.gguf" \
  --include "MTP/gemma-4-12B-it-MTP-Q8_0.gguf" \
  --local-dir "$MODEL_DIR"
Deux fichiers sont téléchargés :
gemma4-v2-Q4_K_M.gguf, le modèle principal Fable 5 Enhanced Gemma 4.MTP/gemma-4-12B-it-MTP-Q8_0.gguf, le modèle d’ébauche utilisé ensuite pour le décodage spéculatif MTP.Le modèle Q4_K_M pèse environ 7 Go. Le temps de téléchargement dépendra de votre connexion, mais l’utilisation de Xet peut améliorer le transfert pour de gros fichiers de modèles.
Une fois le téléchargement terminé, vos fichiers se trouveront ici :
/workspace/Fable5-Gemma4Démarrez maintenant le serveur local avec le modèle principal et le modèle d’ébauche MTP :
MODEL_DIR="/workspace/Fable5-Gemma4"

llama serve \
  --model "$MODEL_DIR/gemma4-v2-Q4_K_M.gguf" \
  --alias Fable5-Gemma4 \
  --model-draft "$MODEL_DIR/MTP/gemma-4-12B-it-MTP-Q8_0.gguf" \
  --spec-type draft-mtp \
  --spec-draft-n-max 2 \
  -ngl 99 \
  -ngld 99 \
  --ctx-size 262144 \
  --parallel 1 \
  --cache-type-k q8_0 \
  --cache-type-v q8_0 \
  --flash-attn on \
  --jinja \
  --temp 1.0 \
  --top-p 0.95 \
  --top-k 64 \
  --repeat-penalty 1.1 \
  --host 0.0.0.0 \
  --port 8910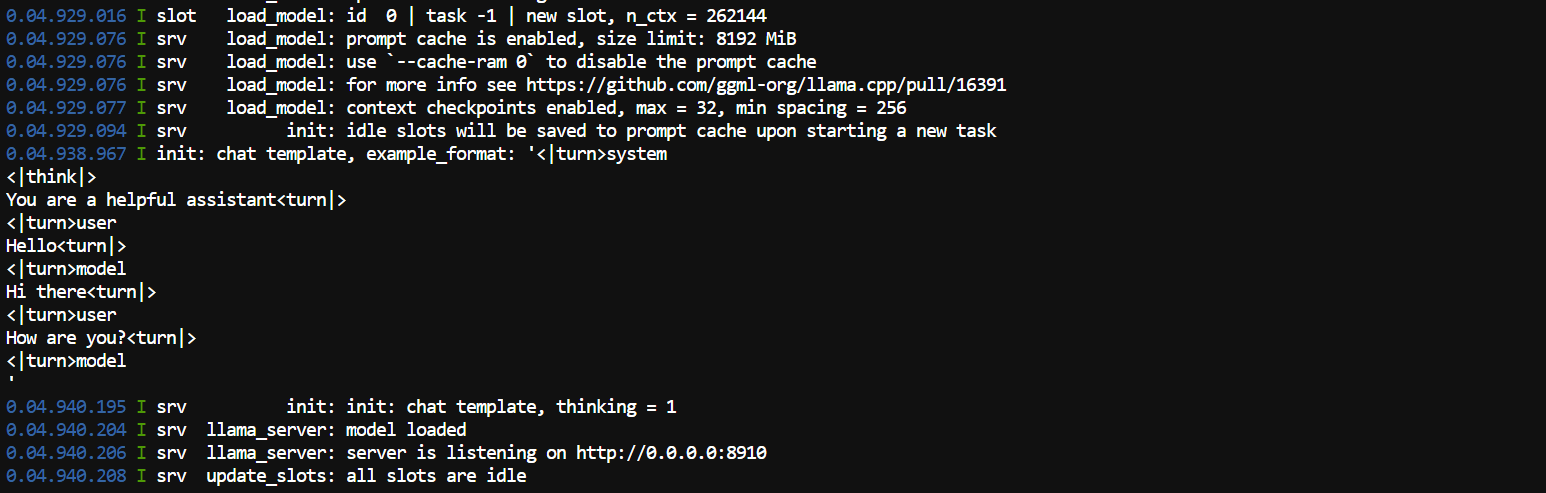
L’argument --model-draft charge le modèle d’ébauche MTP.
MTP signifie Multi Token Prediction. Le modèle d’ébauche, plus petit, prédit d’abord quelques jetons à venir, et le modèle principal les vérifie en parallèle. Cela peut accélérer la génération sans changer le rôle du modèle principal.
--spec-type draft-mtp active ce schéma de décodage spéculatif MTP. --spec-draft-n-max 2 permet au modèle d’ébauche de proposer jusqu’à deux jetons à la fois. Deux est un bon point de départ, car des valeurs plus élevées n’apportent pas toujours de gain de vitesse.
-ngl 99 déporte le modèle principal sur le GPU, tandis que -ngld 99 fait de même pour le modèle d’ébauche MTP. La valeur 99 signifie simplement : déporter toutes les couches disponibles.
--ctx-size 262144 définit une fenêtre de contexte maximale de 256 K jetons. Utile pour de gros codebases et de longues sessions terminal, mais cela requiert plus de VRAM. --parallel 1 réserve tout le contexte à une requête active au lieu de le partager entre plusieurs utilisateurs.
Les réglages de KV-cache en Q8 réduisent la mémoire nécessaire pour la fenêtre de contexte longue. --flash-attn on rend les calculs d’attention plus efficaces, notamment avec de longs prompts.
Laissez --jinja activé. Cela applique le gabarit de chat intégré du modèle pour formater correctement prompts, raisonnement et appels d’outils.
Les autres réglages d’échantillonnage pilotent la génération de texte. --temp 1.0, --top-p 0.95 et --top-k 64 autorisent des réponses variées, tandis que --repeat-penalty 1.1 aide à limiter les répétitions.
Une fois le serveur chargé, ouvrez le WebUI :
http://localhost:8910 Vous pouvez également contrôler l’usage GPU depuis un second terminal :
nvidia-smi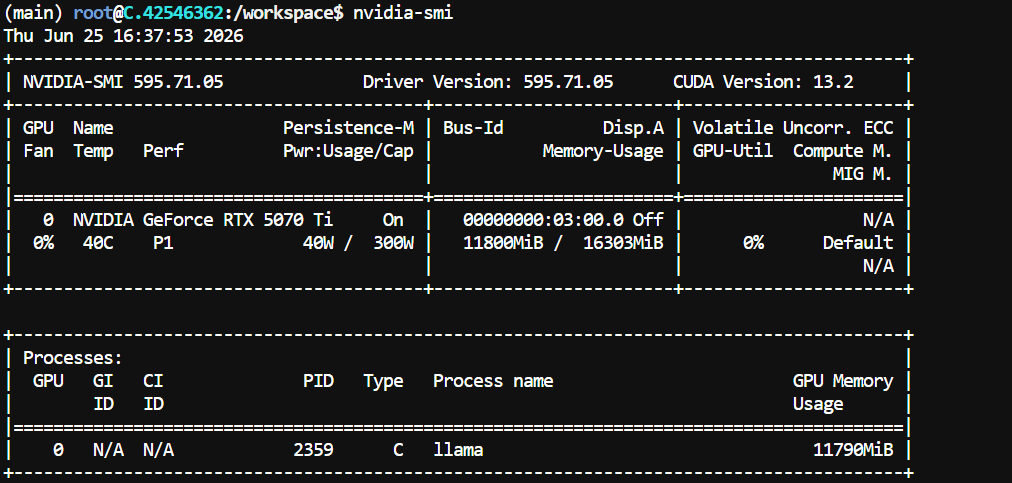
Sur mon RTX 5070 Ti, le modèle utilise environ 11,8 Go de VRAM avec un contexte 256 K, laissant plus de 4 Go disponibles.
Votre consommation mémoire peut varier selon la build de llama.cpp, le pilote GPU et les réglages de contexte.
Laissez le terminal llama serve ouvert, puis lancez un troisième terminal pour tester l’API locale.
curl http://127.0.0.1:8910/v1/messages \
  -H "Content-Type: application/json" \
  -d '{
    "model": "Fable5-Gemma4",
    "max_tokens": 512,
    "messages": [
      {
        "role": "user",
        "content": "Create a simple Python script that prints Hello, I am running locally! "
      }
    ]
  }'
La réponse doit contenir le texte généré par le modèle, ainsi que sa sortie de raisonnement. Dans ce test, le modèle a renvoyé le code Python suivant :
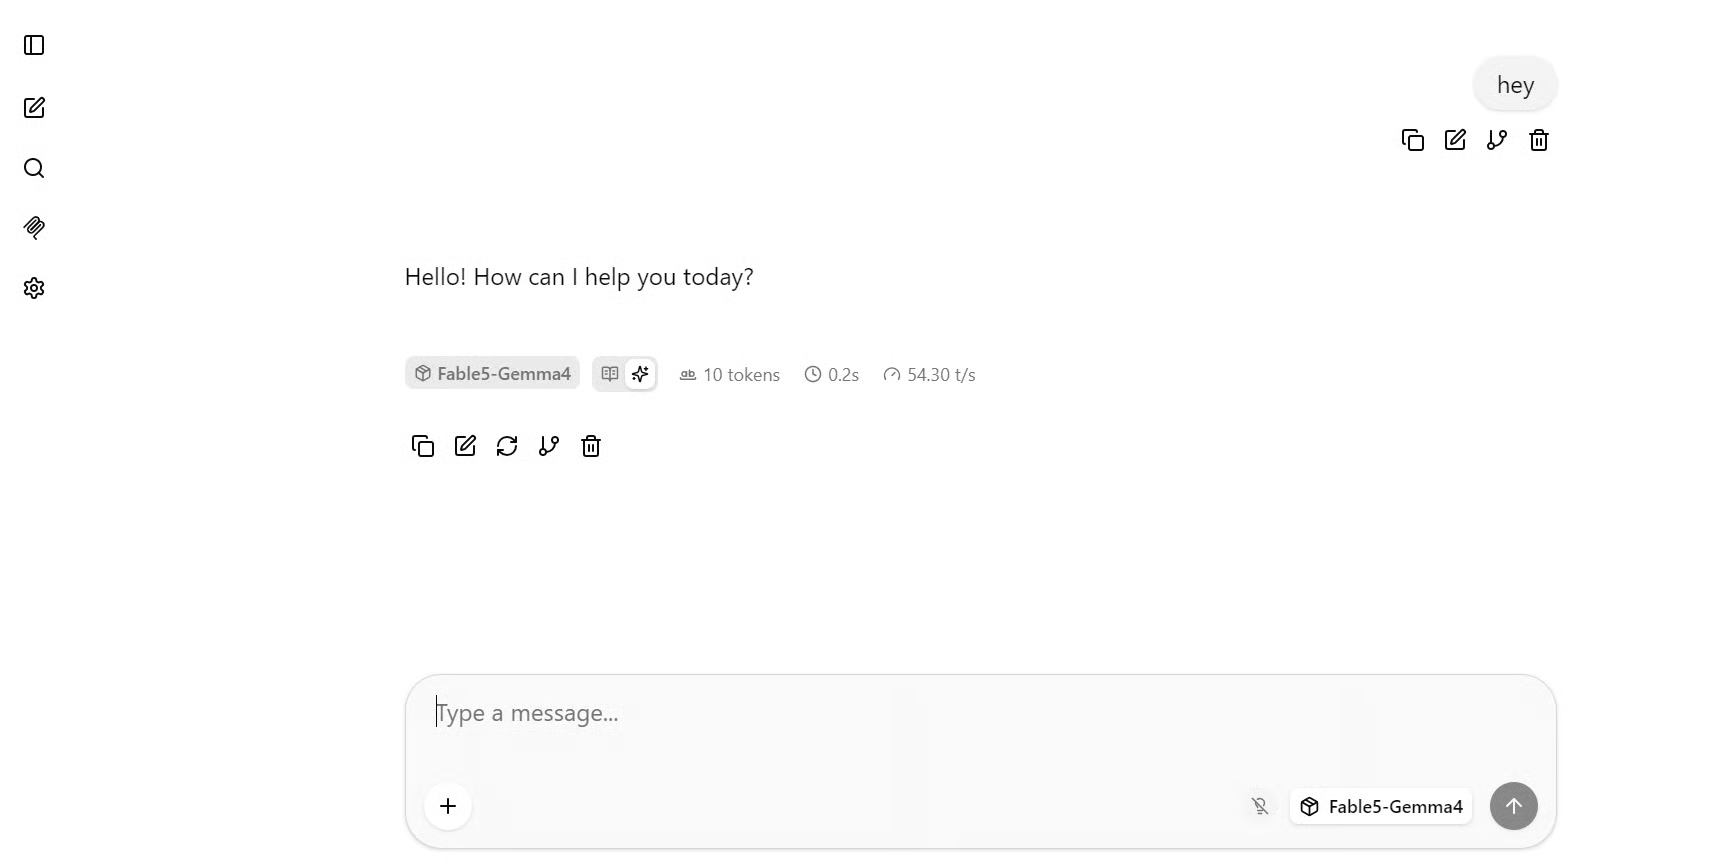
print("Hello, I am running locally!")Une réponse JSON confirme que le serveur local fonctionne correctement. Lors de mon test rapide, le modèle a généré environ 54 jetons par seconde.
Vous pouvez aussi utiliser l’interface de chat intégrée. Ouvrez l’adresse suivante dans votre navigateur :
http://localhost:8910Le WebUI fonctionne comme une application de chat classique. Sélectionnez le modèle Fable5-Gemma4, rédigez un prompt et envoyez‑le au serveur local.
Pour un test de code plus conséquent, utilisez ce prompt :
Create a calming, premium spa treatment center website in one self-contained HTML file
with all CSS and JavaScript included inline, elegant booking CTAs, treatment packages,
therapist profiles, testimonials, and high-quality spa imagery.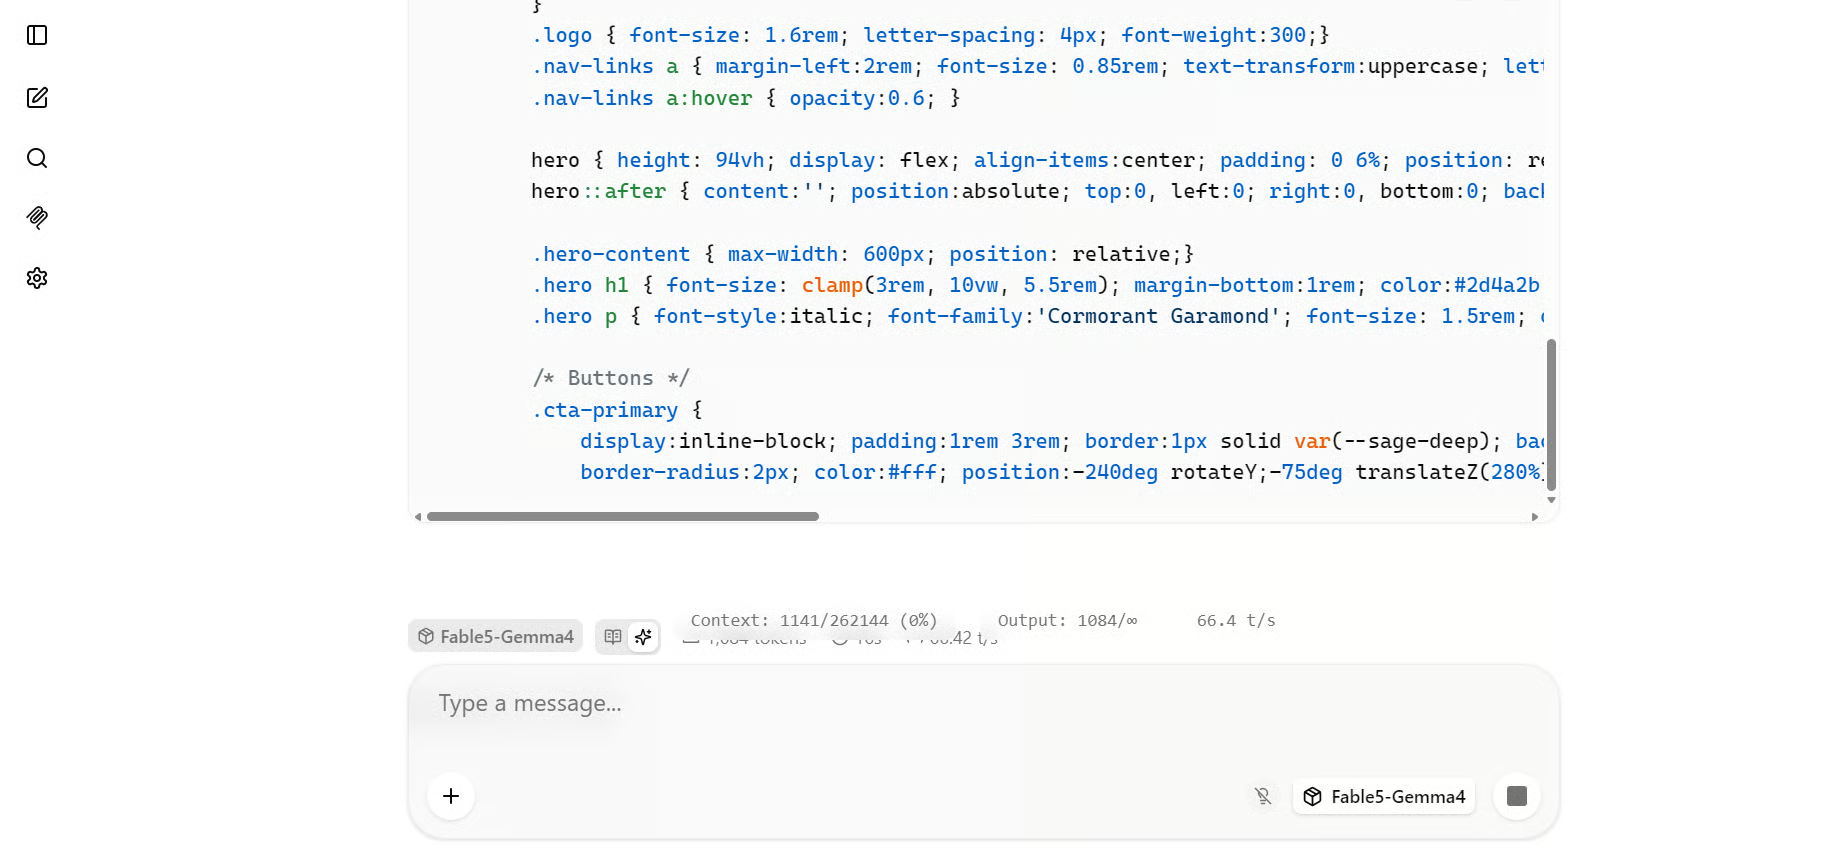
Sur cette génération HTML plus longue, j’ai observé environ 66 à 70 jetons par seconde. Les tâches de code étendues peuvent parfois mieux tirer parti du décodage spéculatif, car le modèle génère une séquence plus continue de jetons de code prévisibles.
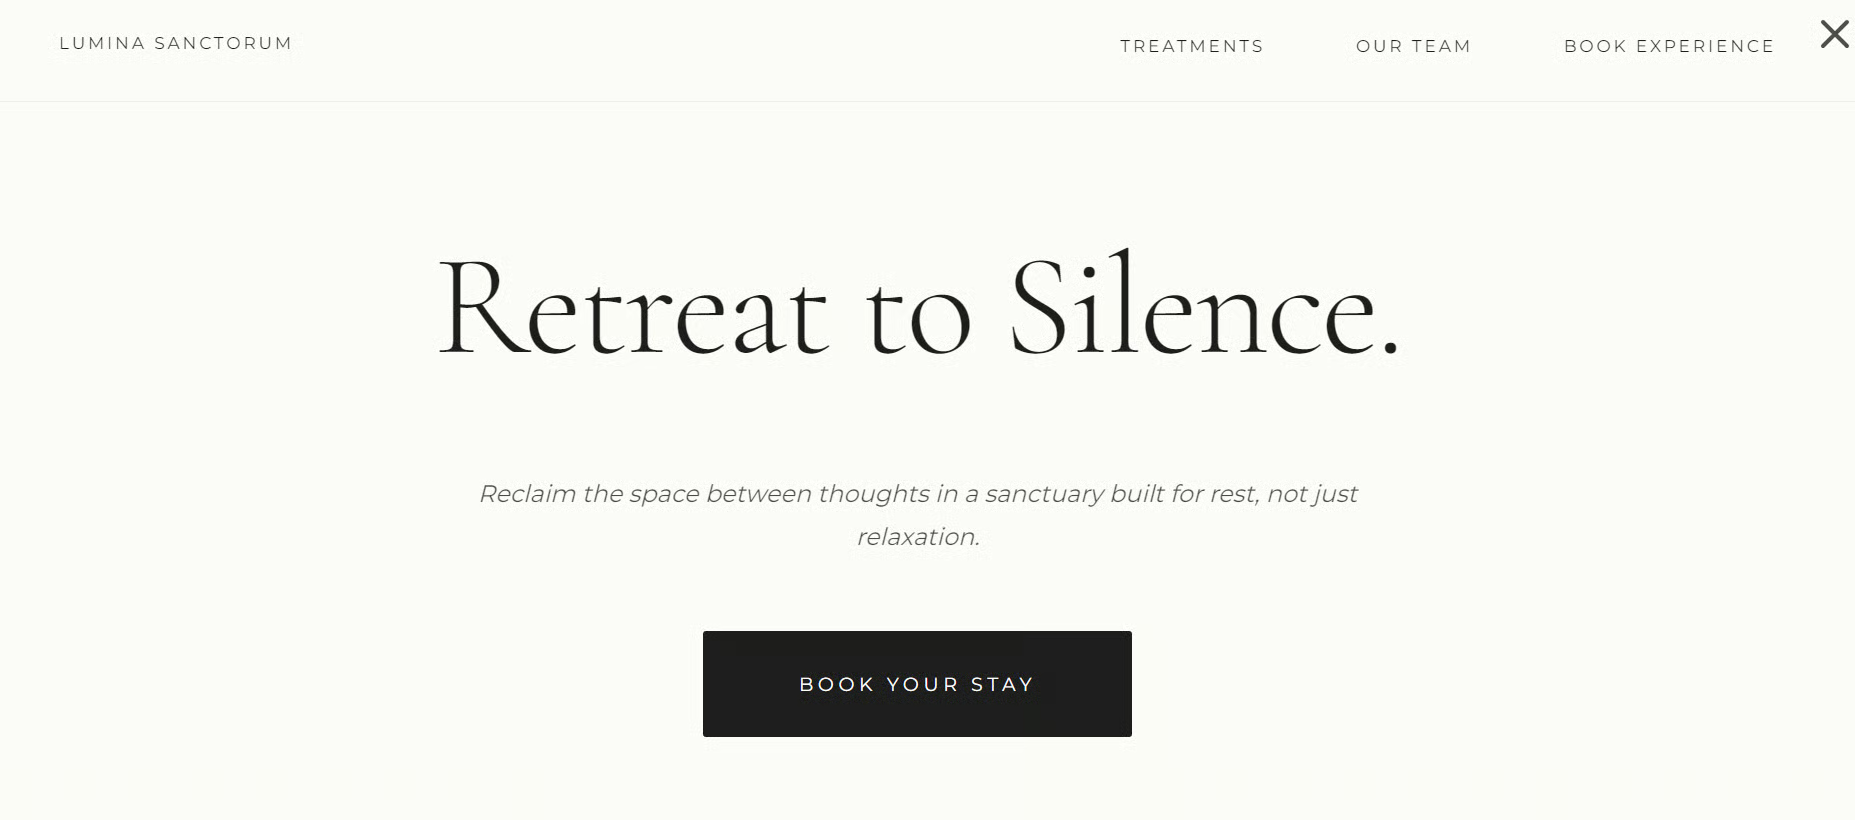
Le premier résultat ci‑dessous a été généré avec le raisonnement réglé sur Medium. Il a produit une landing page spa épurée, avec une mise en page minimale, des liens de navigation et un appel à l’action de réservation bien mis en avant.
Le second résultat a été généré sans raisonnement. Il propose une autre direction visuelle, avec un titre plus imposant et un style de landing page plus éditorial.
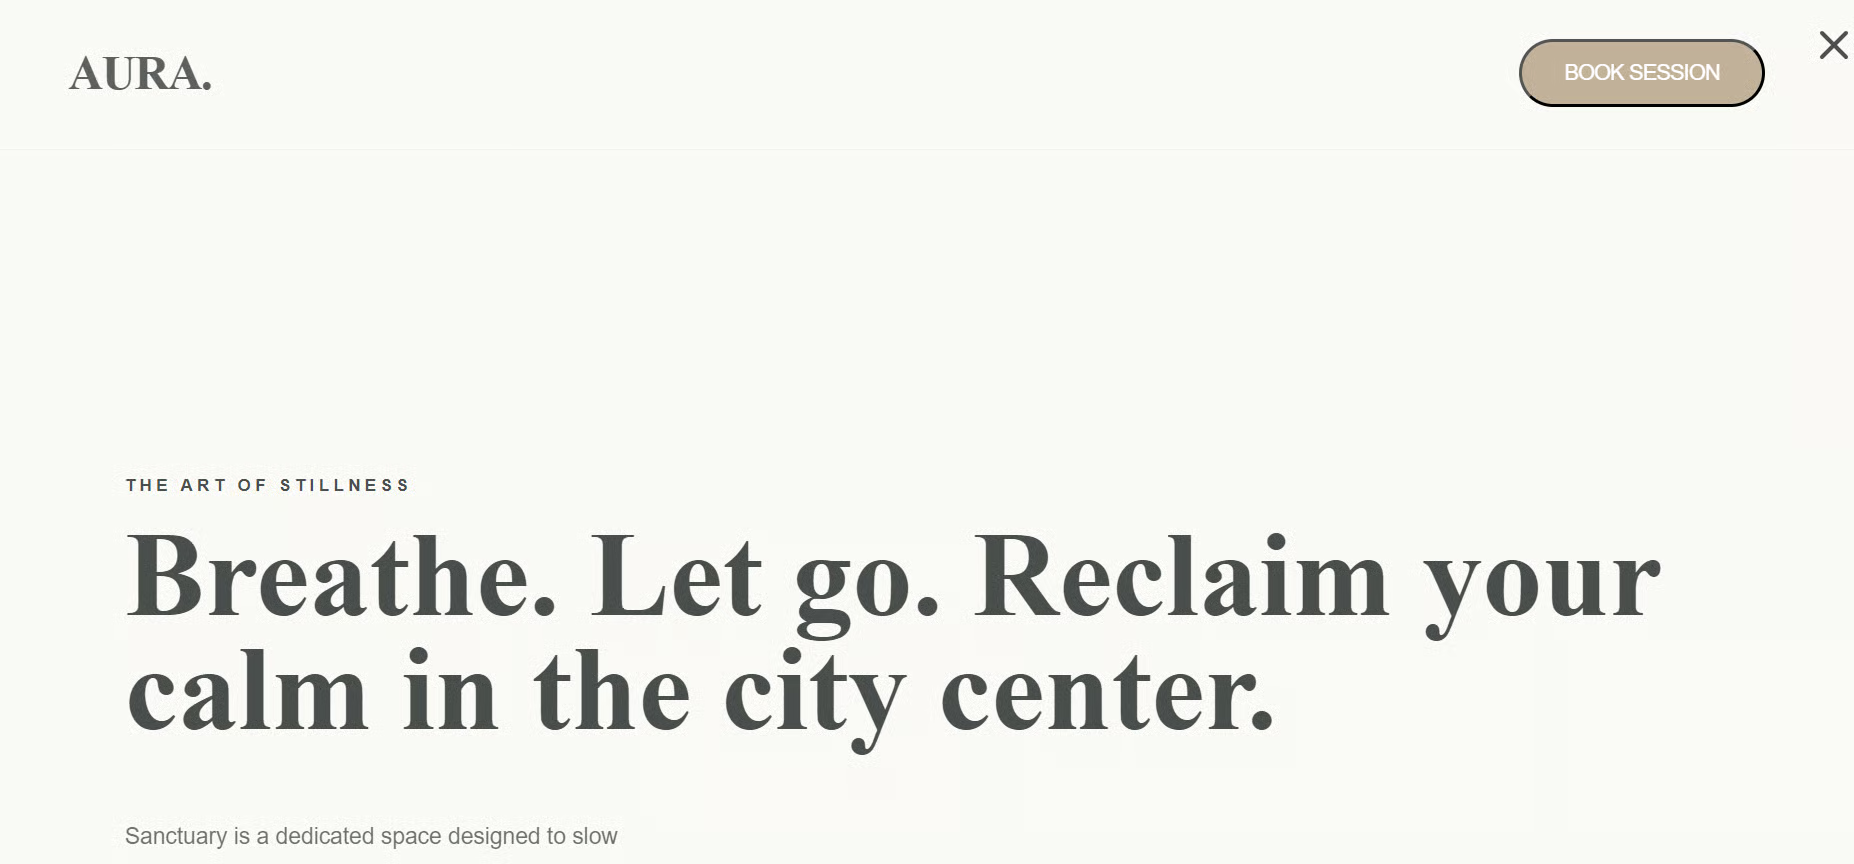
Les deux résultats sont visuellement soignés, mais la version avec raisonnement s’est révélée plus structurée dans ce test.
La vitesse en jetons varie selon la longueur du prompt, le style de sortie, la charge GPU et la fréquence à laquelle le modèle principal accepte les jetons proposés par MTP.
Pi est un agent de code léger en terminal. Il peut se connecter au serveur local Fable 5-Enhanced Gemma 4 pour lire des fichiers, modifier du code, exécuter des commandes et accomplir des tâches de développement.
Ouvrez un quatrième terminal et installez Pi :
curl -fsSL https://pi.dev/install.sh | sh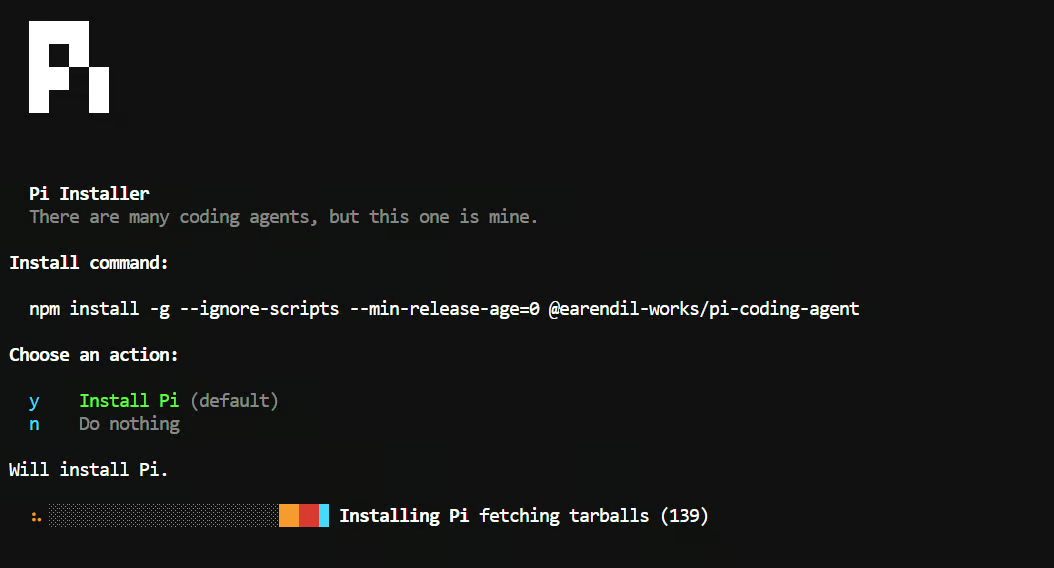 L’installeur peut vous proposer d’installer Node.js. Acceptez et patientez jusqu’à la fin de l’installation.
Rechargez la configuration de votre terminal, puis confirmez que Pi est disponible :
source ~/.bashrc
pi --version
Installez ensuite le plugin pi-llama :
pi install git:github.com/huggingface/pi-llamaCe plugin relie Pi à un serveur llama.cpp en cours d’exécution et détecte automatiquement les modèles locaux disponibles.
Par défaut, le plugin cherche llama.cpp sur le port 8080. Notre serveur utilise le port 8910 ; renseignez donc l’URL locale correcte avant de démarrer Pi :
export LLAMA_BASE_URL="http://127.0.0.1:8910/v1"Créez un nouveau répertoire de projet, initialisez Git et lancez Pi :
mkdir -p /workspace/data-app
cd /workspace/data-app
git init
pi
Dans Pi, tapez :
/modelSélectionnez le modèle « Fable5-Gemma4 ».
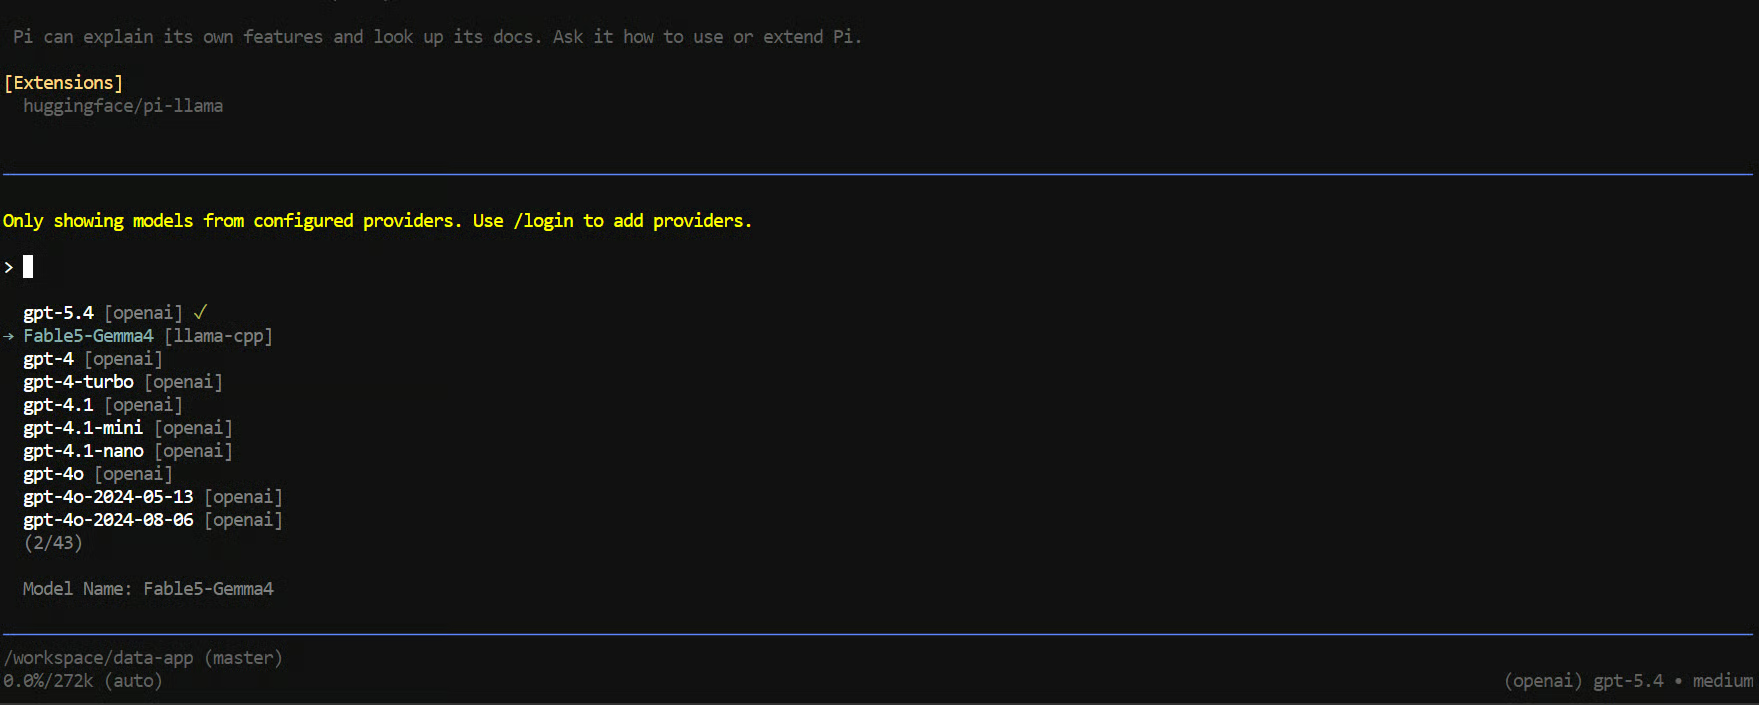
Donnez ensuite à l’agent une tâche de développement concrète :
Create a simple data analytics dashboard using Streamlit that lets users
upload a CSV file, view the data, and explore clear visualizations.
Include a sample CSV file and test the full app to make sure it works correctly.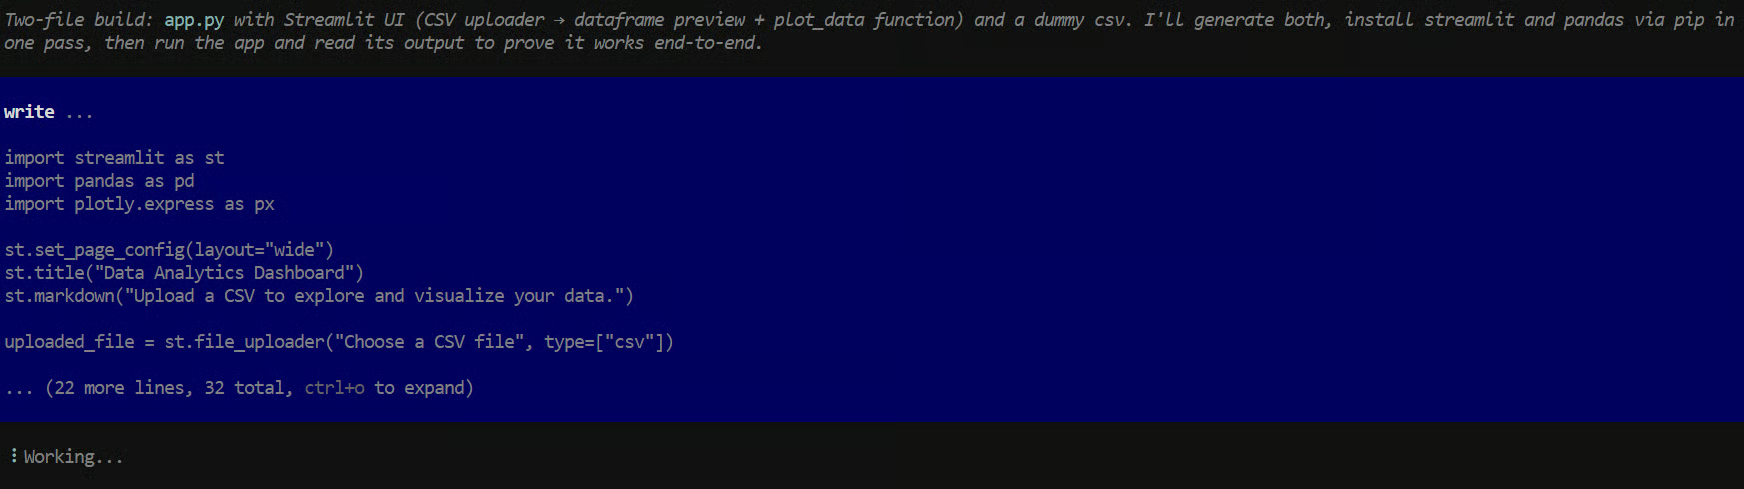
Le modèle a fini par créer un tableau de bord Streamlit fonctionnel avec import CSV et visualisations.
Cependant, le processus s’est avéré bien plus laborieux que prévu.
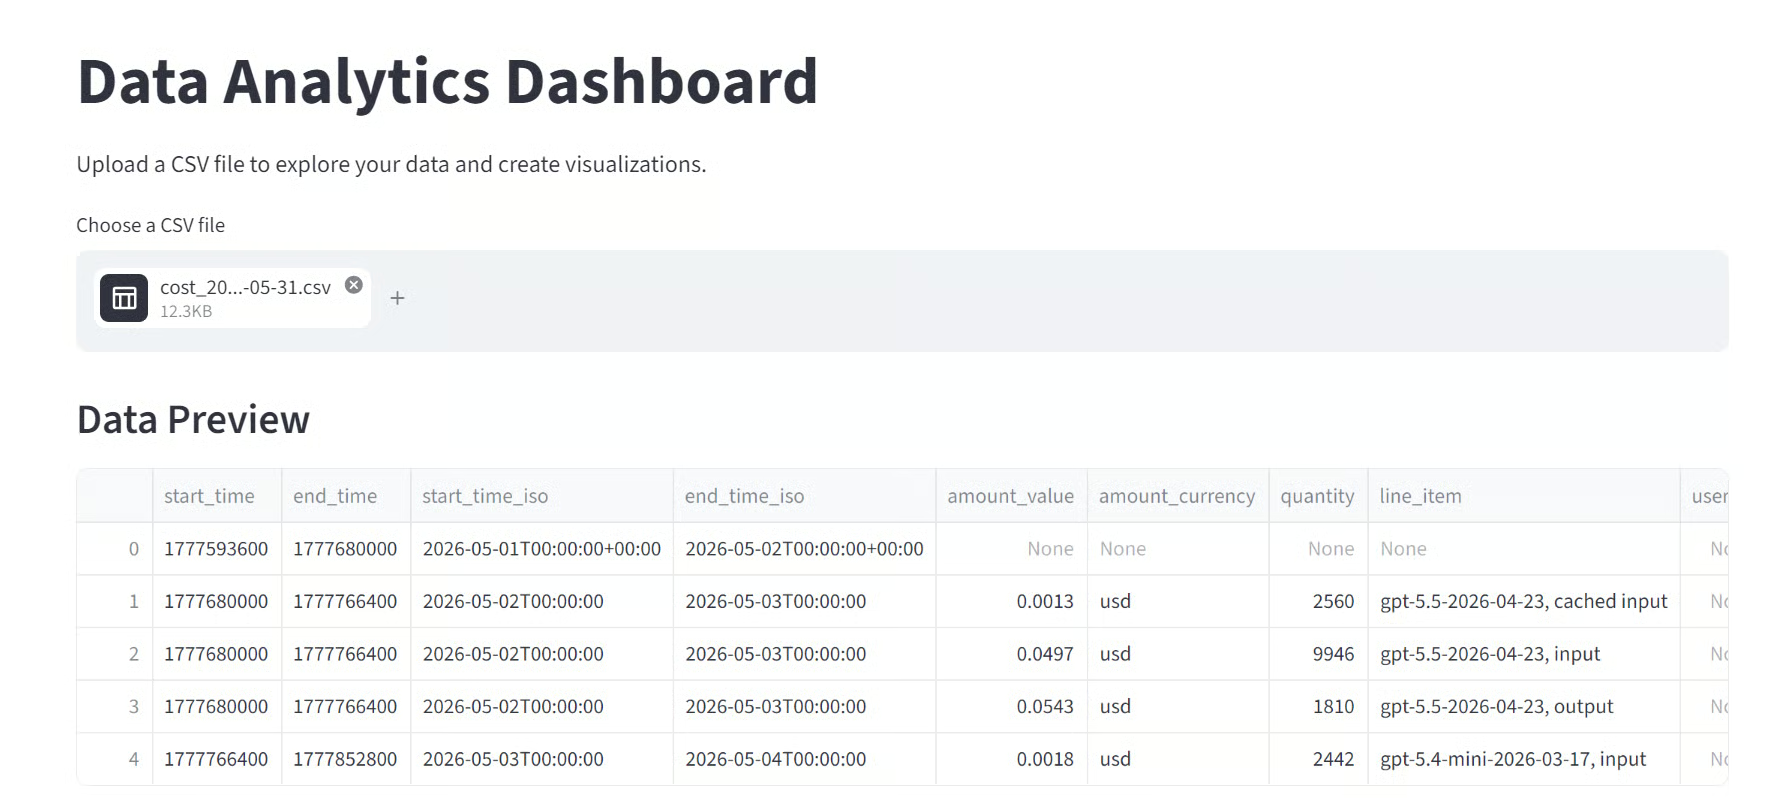
Il a souvent eu des difficultés avec les appels d’outils, les commandes terminal et l’écriture des fichiers du projet.
Souvent, après avoir planifié la prochaine action, il ne la menait pas à terme ; j’ai dû le guider parmi les erreurs et relancer des commandes.
Impossible de déterminer si cela venait du modèle, de l’intégration Pi, des permissions locales, ou d’un mélange de ces facteurs.
Au bout d’environ 20 minutes de tentatives, il a fourni un résultat opérationnel. Pour une tâche Streamlit relativement simple, c’était trop lent et peu fiable.
La même tâche a pris environ une minute avec GLM 5.2 dans un test séparé.
Comparer un modèle local 12B à un modèle de pointe bien plus grand n’est pas entièrement juste.
Néanmoins, l’écart était net.
Fable 5-Enhanced Gemma 4 sait produire du code propre et de bons résultats en tour unique, mais ses performances d’agent « réel » ont été inconstantes dans ce test. Il a demandé trop d’intervention pour une tâche qu’un agent de code compétent devrait boucler rapidement et de façon autonome.
J’en retiens que le modèle est intéressant pour l’expérimentation locale, la génération de code privée et des flux légers.
Mais, sur la base de ce test, je n’en ferais pas encore un agent de code multi‑étapes sur lequel compter.
Bien que ce guide propose une méthode simple pour tester le modèle, vous pouvez rencontrer des problèmes selon votre matériel, votre configuration locale et la build de llama.cpp.
Si le serveur plante lors du chargement du modèle d’ébauche MTP, avec une erreur du type :
invalid vector subscriptLe problème peut venir de votre build de llama.cpp plutôt que des fichiers du modèle.
Le dépôt du modèle indique que la build b9553 de llama.cpp fonctionne avec le modèle d’ébauche MTP de Gemma 4, alors que des builds plus récentes comme b9702 et b9717 peuvent échouer au chargement du draft.
En solution de repli rapide, supprimez les arguments MTP de la commande serveur et exécutez uniquement le modèle principal. Le modèle fonctionnera toujours correctement, mais la génération sera potentiellement plus lente.
Retirez ces lignes :
--model-draft "$MODEL_DIR/MTP/gemma-4-12B-it-MTP-Q8_0.gguf"
--spec-type draft-mtp
--spec-draft-n-max 2
-ngld 99Si vous voyez des jetons comme <|tool_call> ou <|channel> dans la réponse, le client n’applique pas correctement le format natif d’appels d’outils de Gemma 4.
Assurez‑vous que votre commande serveur inclut :
--jinjaPuis redémarrez le serveur. Cela applique le gabarit de chat adéquat pour le raisonnement du modèle et ses appels d’outils structurés.
Commencez par vérifier que le serveur llama.cpp est toujours en cours d’exécution :
curl http://127.0.0.1:8910/v1/modelsVous devriez voir Fable5-Gemma4 dans la réponse.
Ensuite, assurez‑vous que Pi pointe vers le port 8910 et non vers le port par défaut 8080 de llama.cpp :
export LLAMA_BASE_URL="http://127.0.0.1:8910/v1"
pi
Exécutez les deux commandes dans la même session de terminal.
Démarrez Pi dans un répertoire de projet accessible en écriture :
cd /workspace/data-app
pi
Vous pouvez tester si le répertoire courant permet la création de fichiers :
touch write-test.txt && rm write-test.txtSi cette commande échoue, le problème vient des permissions de l’espace de travail et non du modèle lui‑même. Déplacez‑vous dans un répertoire accessible en écriture avant de lancer Pi.
Si le modèle commence à répéter du texte, des nombres ou des symboles, vérifiez les réglages d’échantillonnage dans votre commande serveur.
Utilisez ces valeurs :
--temp 1.0 \
--top-p 0.95 \
--top-k 64 \
--repeat-penalty 1.1
La pénalité de répétition est particulièrement importante. Sans elle, le modèle peut produire une sortie répétitive ou brouillée.
Une fenêtre de contexte 256 K exige un KV‑cache volumineux. Si le serveur manque de VRAM, réduisez d’abord la taille du contexte :
--ctx-size 32768Vous pouvez également désactiver le modèle d’ébauche MTP pour libérer de la VRAM. Vérifiez l’utilisation actuelle de la mémoire GPU avec :
nvidia-smiLe modèle sait générer du bon code, mais peut peiner à boucler des tâches longues sans intervention. Dans mes tests, il planifiait parfois les bonnes actions mais échouait à l’exécution de commandes, à l’écriture de fichiers ou à la reprise après une erreur.
Pour de meilleurs résultats, découpez les grandes requêtes en tâches plus petites :
Chaque étape donne au modèle un objectif plus restreint et facilite l’identification de l’origine des échecs : modèle, Pi, serveur ou permissions de l’espace de travail.
Je ne pense pas que l’engouement autour de ce modèle soit totalement mérité, du moins d’après mes tests. Avec ou sans MTP, j’ai obtenu quasiment la même vitesse pour des tâches générales. En code, MTP a aidé et j’ai constaté un gain d’environ 20 % à 30 %. C’est utile, mais cela ne résout pas le problème majeur : la fiabilité.
Je l’ai aussi testé dans le WebUI.
Parfois, en écrivant le code d’un fichier, il s’arrêtait sans raison claire. En demandant de continuer, il ajoutait la suite comme texte dans la réponse suivante, au lieu de vraiment poursuivre le fichier.
J’ai aussi remarqué que l’activation du raisonnement dégradait parfois la qualité de sortie, ce qui est surprenant.
Je l’ai testé avec Claude Code également, et l’expérience a été encore plus frustrante.
Le modèle créait des fichiers supplémentaires, temporaires et d’autres éléments superflus dont un projet simple n’avait pas besoin. Il a fini par terminer la tâche, mais avec trop de guidage et trop de temps.
Je sais que comparer un modèle local 12B à GPT‑5.5 ou GLM 5.2 n’est pas totalement équitable. Mais même face à des modèles locaux plus petits, je n’ai pas été convaincu.
D’après mon expérience, Qwen 3.6 27B est bien meilleur pour le code et les tâches agentiques, même s’il est plus grand.
Pour l’instant, je considère ce modèle comme une expérimentation intéressante, plutôt qu’un agent de code fiable.
Je suis davantage intéressé par le prochain modèle Qwen 3.6 27B affiné avec Fable du même auteur. J’ai aussi vu d’autres contributeurs open source publier des modèles de code distillés similaires, mais, jusqu’ici, pas de progrès majeur sur de vraies tâches d’agent de code.
Le modèle sait générer du code agréable et des sorties soignées en un seul tour. Mais dès qu’on lui demande d’agir en agent, d’utiliser des outils, de créer des fichiers, de corriger des erreurs et de valider le résultat, l’expérience reste inconstante et frustrante.
Meilleures formations DataCamp
Cours
Cours
Cursus
blog
Kurtis Pykes
9 min
blog
Nisha Arya Ahmed
15 min
Tutoriel
Tutoriel
Laiba Siddiqui
6 min
Tutoriel
DataCamp Team
3 min
Tutoriel
Kurtis Pykes
15 min