Corso
Sviluppo avanzato con AI per programmatori
1 ore 30 min
1.8K
Dopo la chiusura di Fable 5 e Mythos 5, gli sviluppatori open source hanno iniziato a sperimentare modelli locali più piccoli addestrati su dati sintetici di qualità per il coding e il comportamento agentico. Fable 5-Enhanced Gemma 4 è un esempio.
Si tratta di un fine-tune di Gemma 4 12B addestrato su dataset generati da Fable 5 e Composer 2.5. L'obiettivo è trasferire utili capacità di coding e comportamento agentico in un modello più piccolo che possa girare in locale.
L'addestramento è focalizzato su workflow pratici, come comprendere un compito, leggere file, usare strumenti, modificare codice, eseguire comandi e verificare il risultato finale.
In questa guida ti mostrerò come eseguire in locale il modello Fable 5-enhanced Gemma 4 su una RTX 5070 Ti utilizzando llama.cpp.
Installeremo llama.cpp, scaricheremo il modello GGUF e il modello MTP draft, avvieremo un server locale compatibile con OpenAI e lo testeremo con cURL e la WebUI integrata.
Infine, collegheremo il modello a Pi Coding Agent e gli affideremo un vero compito di programmazione. La domanda principale è se questo modello compatto da 12B riesca a offrire un comportamento utile da coding agent e competere con modelli locali più grandi come Qwen 3.6 27B o Gemma 4 31B.
Fable 5-Enhanced Gemma 4 è un modello compatto per coding e agentic basato sul modello instruction Gemma 4 12B di Google. È stato creato da Yuxin Lu e rilasciato in formato GGUF per l'uso locale con llama.cpp e altri strumenti compatibili.
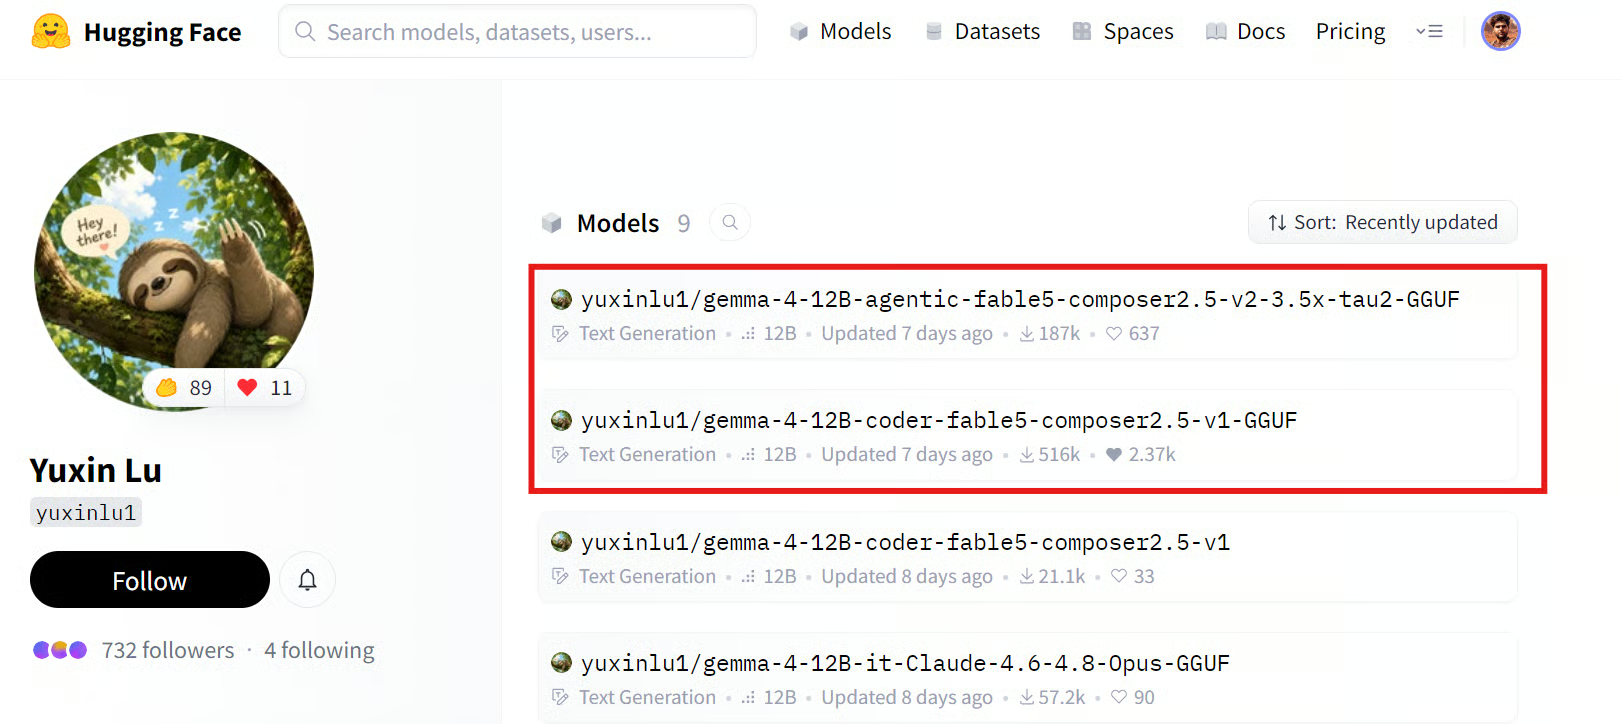
Fonte: yuxinlu1 (Yuxin Lu)
Questa guida utilizza la release v2. Prosegue il modello di coding v1 ma aggiunge un focus più forte sul lavoro tecnico agentico.
Invece di limitarsi a generare codice, è progettato per ispezionare file, ragionare sui problemi, usare strumenti, modificare codice, eseguire comandi e verificare il risultato finale.
Il modello originale è stato fine-tunato su dati di coding Python verificati generati da Composer 2.5 e Fable 5.
Il set di training principale utilizza tracce di ragionamento di Composer 2.5 e soluzioni di codice per task Python con test deterministici. Sono stati mantenuti solo gli esempi in cui il codice generato superava i test.
Fable 5 è stato utilizzato per i compiti più difficili in cui Composer 2.5 falliva. Ha generato un nuovo processo di ragionamento e soluzioni corrette per questi esempi, anch'essi verificati tramite esecuzione prima di essere aggiunti ai dati di training.
Per la v2, il modello aggiunge traiettorie multi-step di terminale e uso degli strumenti. Questo gli insegna a seguire un flusso di lettura, ragionamento, azione e verifica invece di produrre una risposta e fermarsi.
Dopo che Fable 5 è diventato indisponibile, alcune tracce di ragionamento in stile Fable 5 mancanti sono state ricostruite con Opus 4.8.
--jinja attivo in llama.cpp così il modello può usare il chat template e il formato tool-call previsti da Gemma 4.In un confronto locale tau2-bench per telecom, il modello v2 ha raggiunto circa 55%, contro circa 15% del modello instruction base Gemma 4 12B.
Questo suggerisce che il miglioramento principale derivi dal comportamento agentico. Il modello fine-tunato è migliore nell'ispezionare un compito, eseguire l'azione successiva, usare strumenti e verificare i risultati invece di fermarsi dopo una prima risposta.
Questo è il modo più veloce e semplice per installare llama.cpp su una macchina Linux. Invece di clonare il repository e compilarlo dai sorgenti, l'installer scarica un binario precompilato e lo configura per te.
Esegui il seguente comando nel terminale:
curl -LsSf https://llama.app/install.sh | shIn pochi secondi, l'installer scaricherà il binario di llama.cpp e completerà la configurazione.
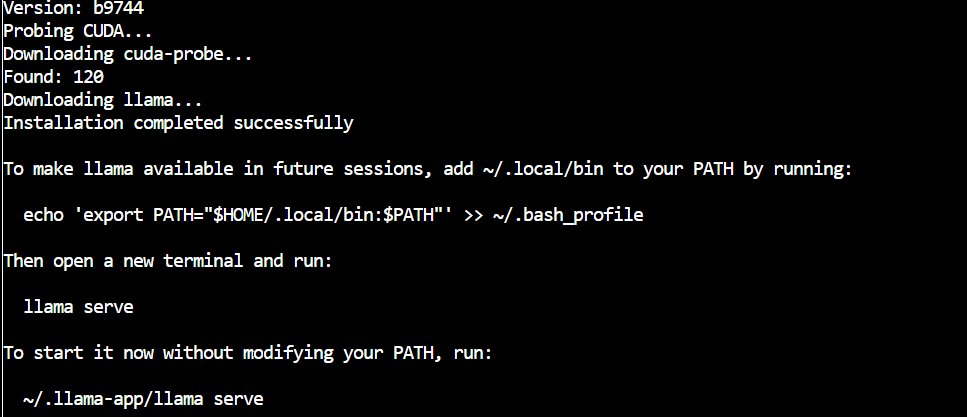
Poi aggiungi llama.cpp al tuo PATH così da poter eseguire il comando llama da qualsiasi directory, anche dopo aver riavviato il terminale:
echo 'export PATH="$HOME/.local/bin:$PATH"' >> ~/.bashrc
source ~/.bashrc
Infine, verifica che l'installazione sia andata a buon fine:
llama helpDovresti ora vedere i comandi disponibili di llama.cpp.
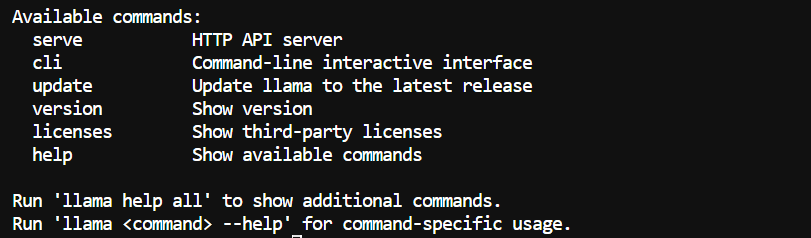
Poi installa la CLI di Hugging Face e hf-xet. Questo ti permette di scaricare i file del modello direttamente da Hugging Face, inclusi i repository che usano lo storage Xet per file di grandi dimensioni.
pip install -U "huggingface_hub[cli]" hf-xet Crea una directory per i file del modello:
MODEL_DIR="/workspace/Fable5-Gemma4"
mkdir -p "$MODEL_DIR"
Abilita download Xet più rapidi, quindi scarica solo i file necessari per questa guida:
export HF_XET_HIGH_PERFORMANCE=1


hf download \
  yuxinlu1/gemma-4-12B-agentic-fable5-composer2.5-v2-3.5x-tau2-GGUF \
  --include "gemma4-v2-Q4_K_M.gguf" \
  --include "MTP/gemma-4-12B-it-MTP-Q8_0.gguf" \
  --local-dir "$MODEL_DIR"
Questo scarica due file:
gemma4-v2-Q4_K_M.gguf, il modello principale Fable 5 Enhanced Gemma 4.MTP/gemma-4-12B-it-MTP-Q8_0.gguf, il modello draft usato più avanti per la speculative decoding MTP.Il modello Q4_K_M è circa 7 GB. Il tempo di download dipende dalla tua connessione internet, ma usare Xet può migliorare le prestazioni di trasferimento per file di grandi dimensioni.
Una volta completato il download, i tuoi file dovrebbero trovarsi qui:
/workspace/Fable5-Gemma4Ora avvia il server locale con il modello principale e il modello MTP draft:
MODEL_DIR="/workspace/Fable5-Gemma4"

llama serve \
  --model "$MODEL_DIR/gemma4-v2-Q4_K_M.gguf" \
  --alias Fable5-Gemma4 \
  --model-draft "$MODEL_DIR/MTP/gemma-4-12B-it-MTP-Q8_0.gguf" \
  --spec-type draft-mtp \
  --spec-draft-n-max 2 \
  -ngl 99 \
  -ngld 99 \
  --ctx-size 262144 \
  --parallel 1 \
  --cache-type-k q8_0 \
  --cache-type-v q8_0 \
  --flash-attn on \
  --jinja \
  --temp 1.0 \
  --top-p 0.95 \
  --top-k 64 \
  --repeat-penalty 1.1 \
  --host 0.0.0.0 \
  --port 8910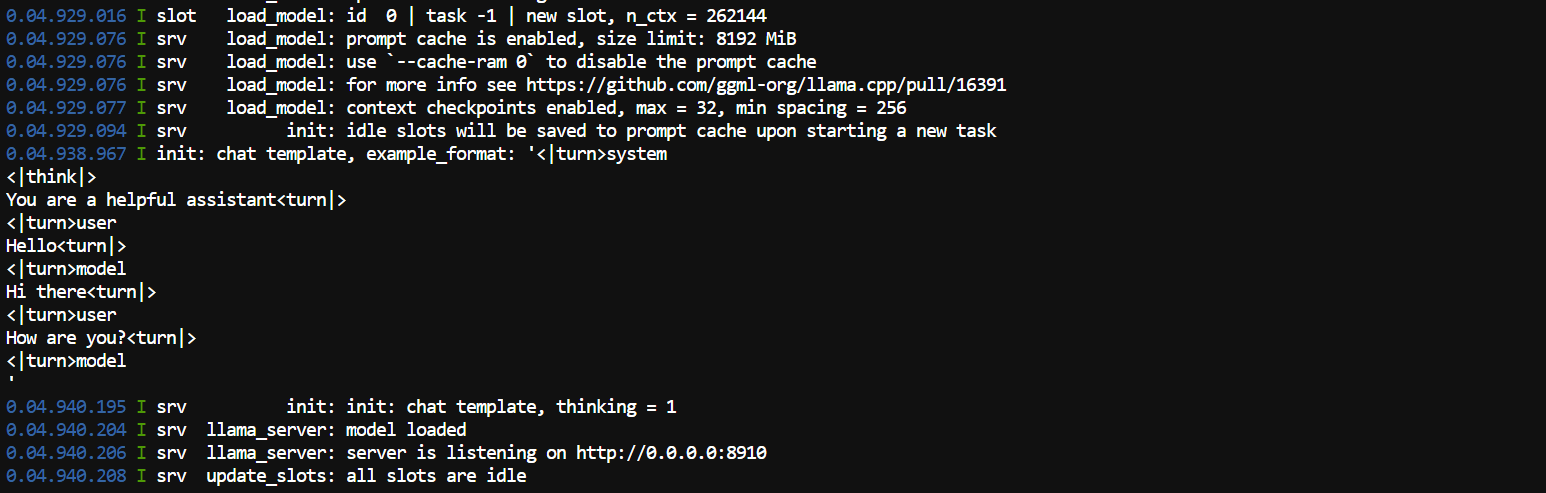
L'argomento --model-draft carica il modello MTP draft.
MTP significa Multi Token Prediction. Il modello draft più piccolo prevede per primo alcuni token successivi, e il modello principale li verifica in parallelo. Questo può migliorare la velocità di generazione senza cambiare il ruolo del modello principale.
--spec-type draft-mtp abilita questa configurazione di speculative decoding MTP. --spec-draft-n-max 2 consente al modello draft di proporre fino a due token alla volta. Due è un punto di partenza sensato perché valori maggiori non sempre portano a un miglioramento della velocità.
-ngl 99 sposta il modello principale sulla GPU, mentre -ngld 99 fa lo stesso per il modello MTP draft. Il valore 99 significa semplicemente di offloadare tutti i layer disponibili.
--ctx-size 262144 imposta una finestra di contesto massima di 256K token. È utile per codebase più grandi e lunghe sessioni da terminale, ma richiede anche più VRAM. --parallel 1 riserva l'intero contesto a una sola richiesta attiva invece di suddividerlo tra più utenti.
Le impostazioni KV-cache Q8 riducono la memoria richiesta per la finestra di contesto lunga. --flash-attn on aiuta a rendere più efficienti i calcoli di attention, soprattutto con prompt lunghi.
Mantieni abilitato --jinja. Applica il chat template integrato del modello in modo che prompt, ragionamento e tool call siano formattati correttamente.
Le restanti impostazioni di campionamento controllano come il modello genera testo. --temp 1.0, --top-p 0.95 e --top-k 64 consentono risposte varie, mentre --repeat-penalty 1.1 aiuta a ridurre il testo ripetuto.
Una volta caricato il server, apri la WebUI:
http://localhost:8910 Puoi anche controllare l'uso della GPU da un secondo terminale:
nvidia-smi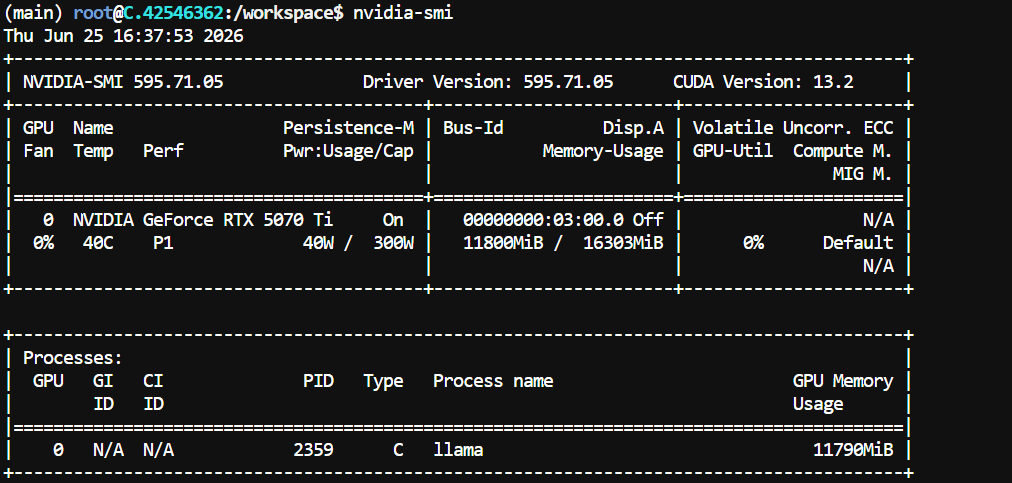
Sulla mia configurazione con RTX 5070 Ti, il modello ha utilizzato circa 11,8 GB di VRAM con la configurazione del contesto a 256K, lasciando più di 4 GB disponibili.
L'uso della memoria può variare a seconda della build di llama.cpp, del driver GPU e delle impostazioni del contesto.
Lascia il terminale con llama serve in esecuzione, quindi apri un terzo terminale per testare le API locali.
curl http://127.0.0.1:8910/v1/messages \
  -H "Content-Type: application/json" \
  -d '{
    "model": "Fable5-Gemma4",
    "max_tokens": 512,
    "messages": [
      {
        "role": "user",
        "content": "Create a simple Python script that prints Hello, I am running locally! "
      }
    ]
  }'
La risposta dovrebbe contenere il testo generato dal modello, insieme al suo output di thinking. In questo test, il modello ha restituito il seguente codice Python:
print("Hello, I am running locally!")Una risposta JSON conferma che il server locale funziona correttamente. Nel mio test rapido, il modello ha generato a circa 54 token al secondo.
Puoi anche usare l'interfaccia chat integrata. Apri il seguente indirizzo nel browser:
http://localhost:8910La WebUI funziona come una normale app di chat. Seleziona il modello Fable5-Gemma4, scrivi un prompt e invialo al server locale.
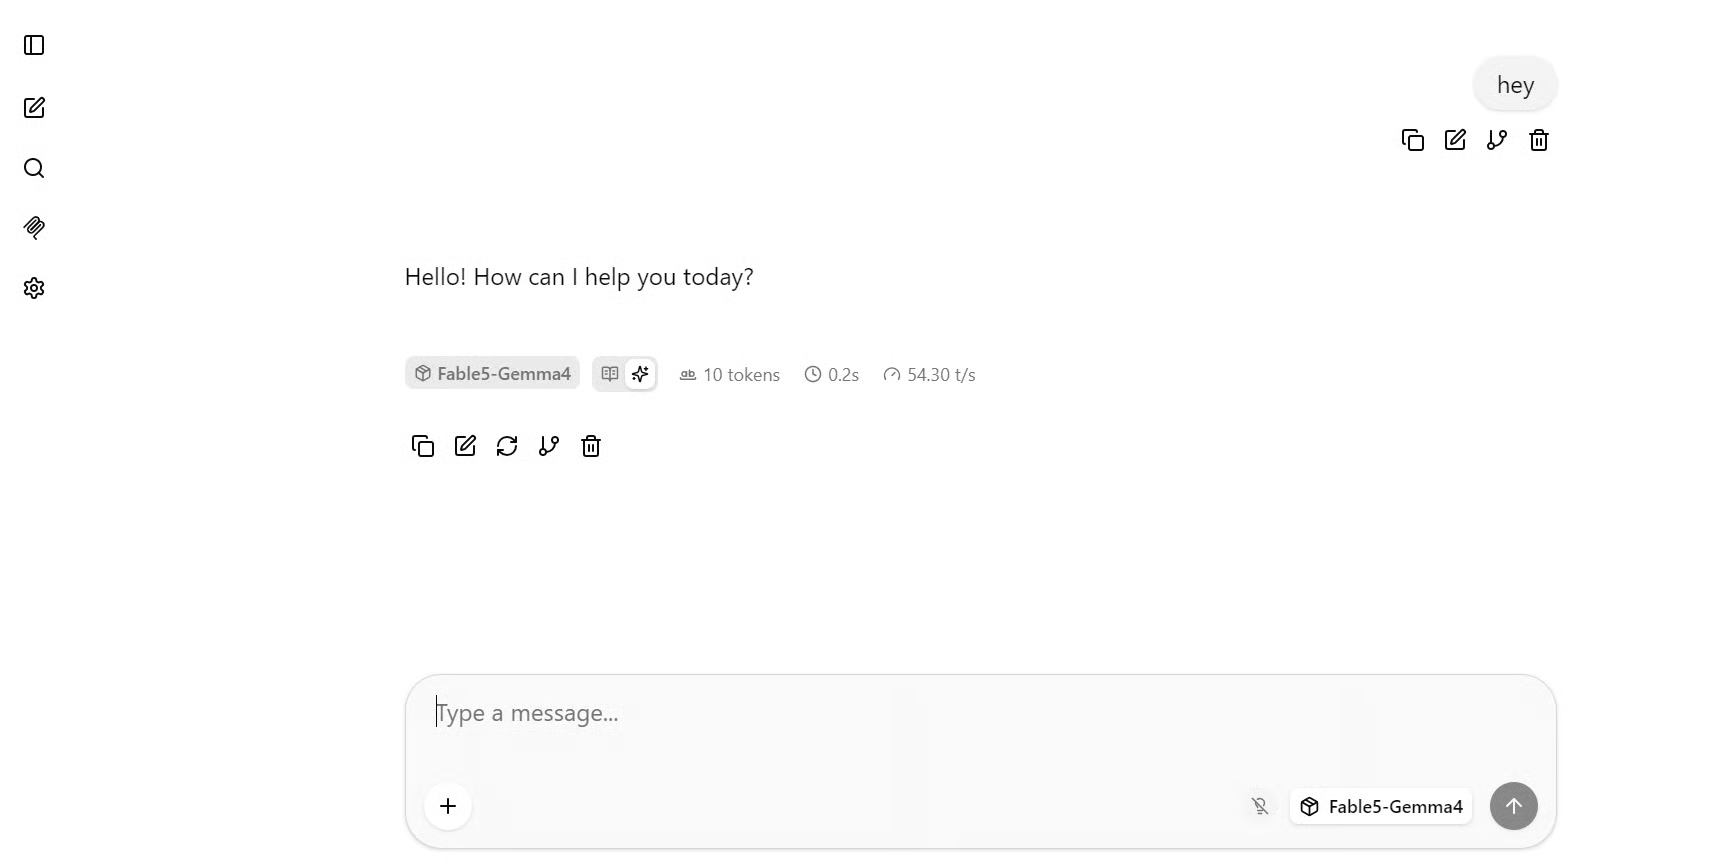
Per un test di coding più ampio, usa questo prompt:
Create a calming, premium spa treatment center website in one self-contained HTML file
with all CSS and JavaScript included inline, elegant booking CTAs, treatment packages,
therapist profiles, testimonials, and high-quality spa imagery.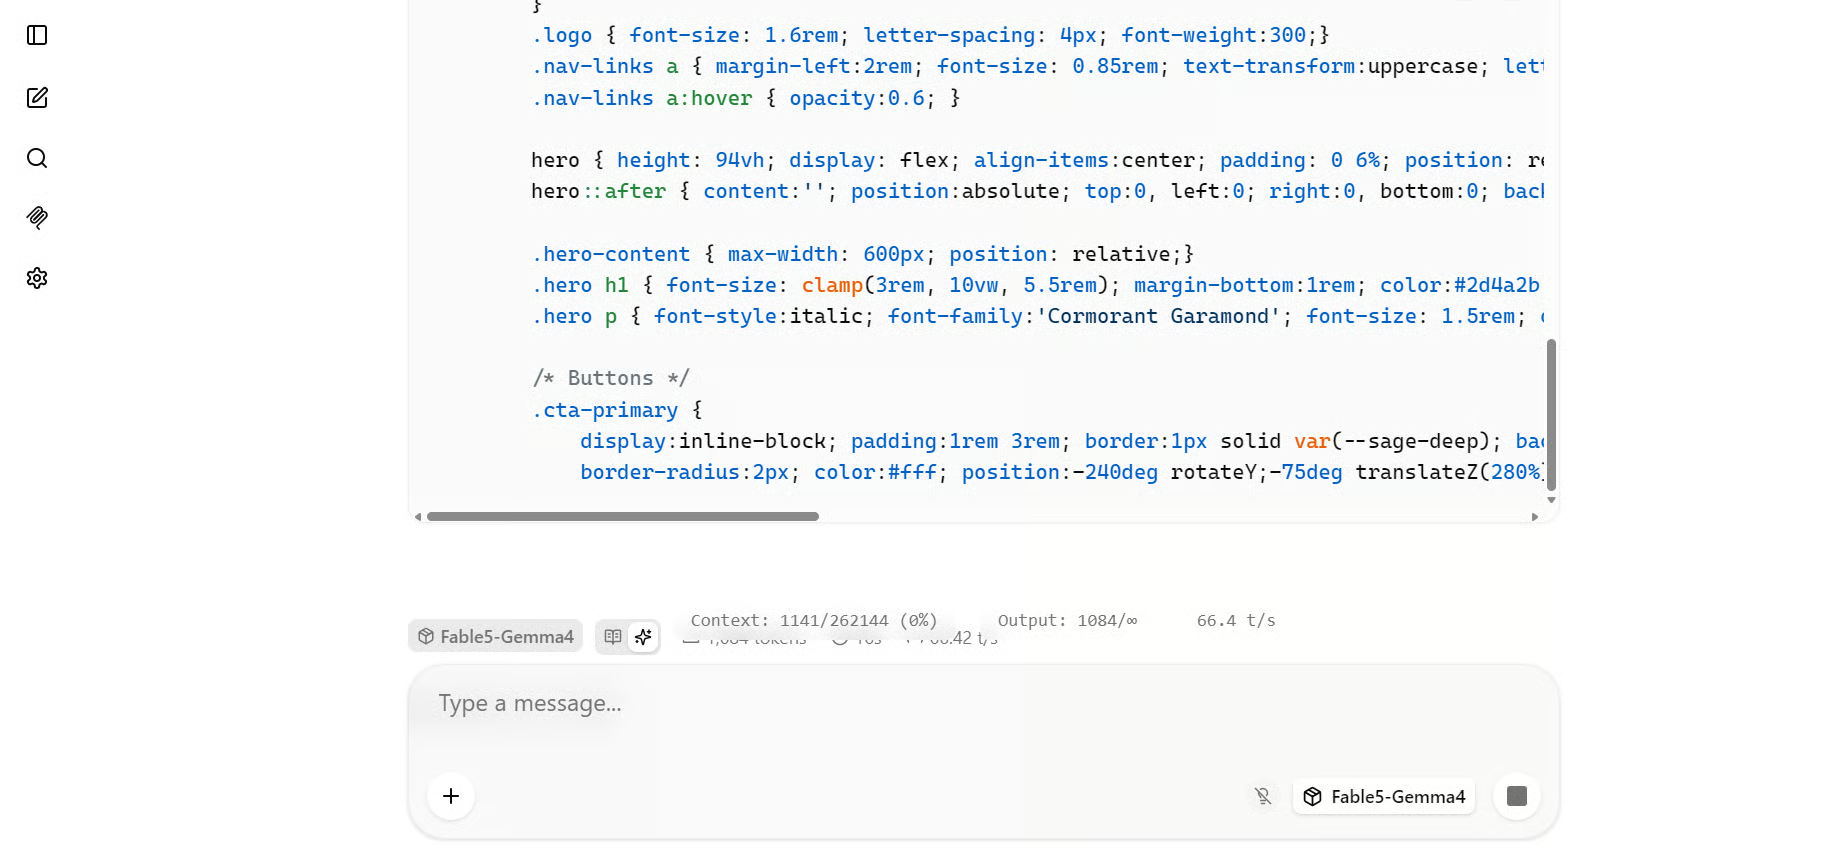
Per questo compito più lungo di generazione HTML, ho visto circa 66–70 token al secondo. I compiti di coding più lunghi a volte possono dare migliori prestazioni di speculative decoding perché il modello genera una sequenza più continua di token di codice prevedibili.
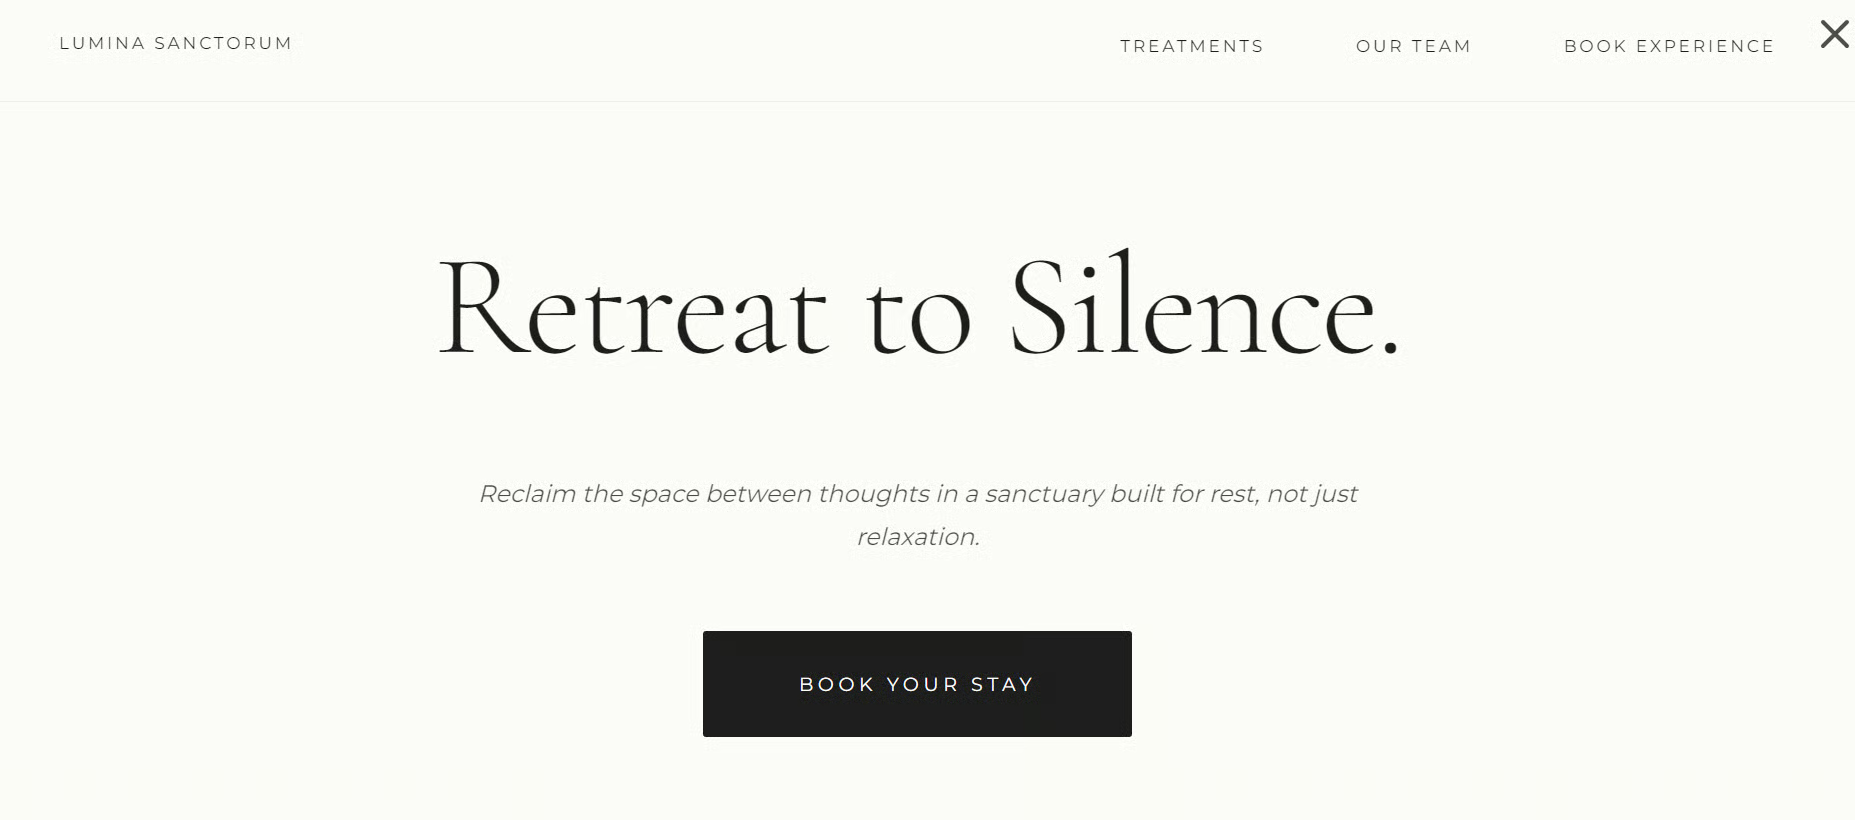
Il primo risultato qui sotto è stato generato con il ragionamento impostato su Medium. Ha creato una landing page per una spa pulita, con layout minimale, link di navigazione e una grande call to action per la prenotazione.
Il secondo risultato è stato generato senza ragionamento. Ha prodotto una direzione visiva diversa, con un titolo più grande e uno stile di landing page più editoriale.
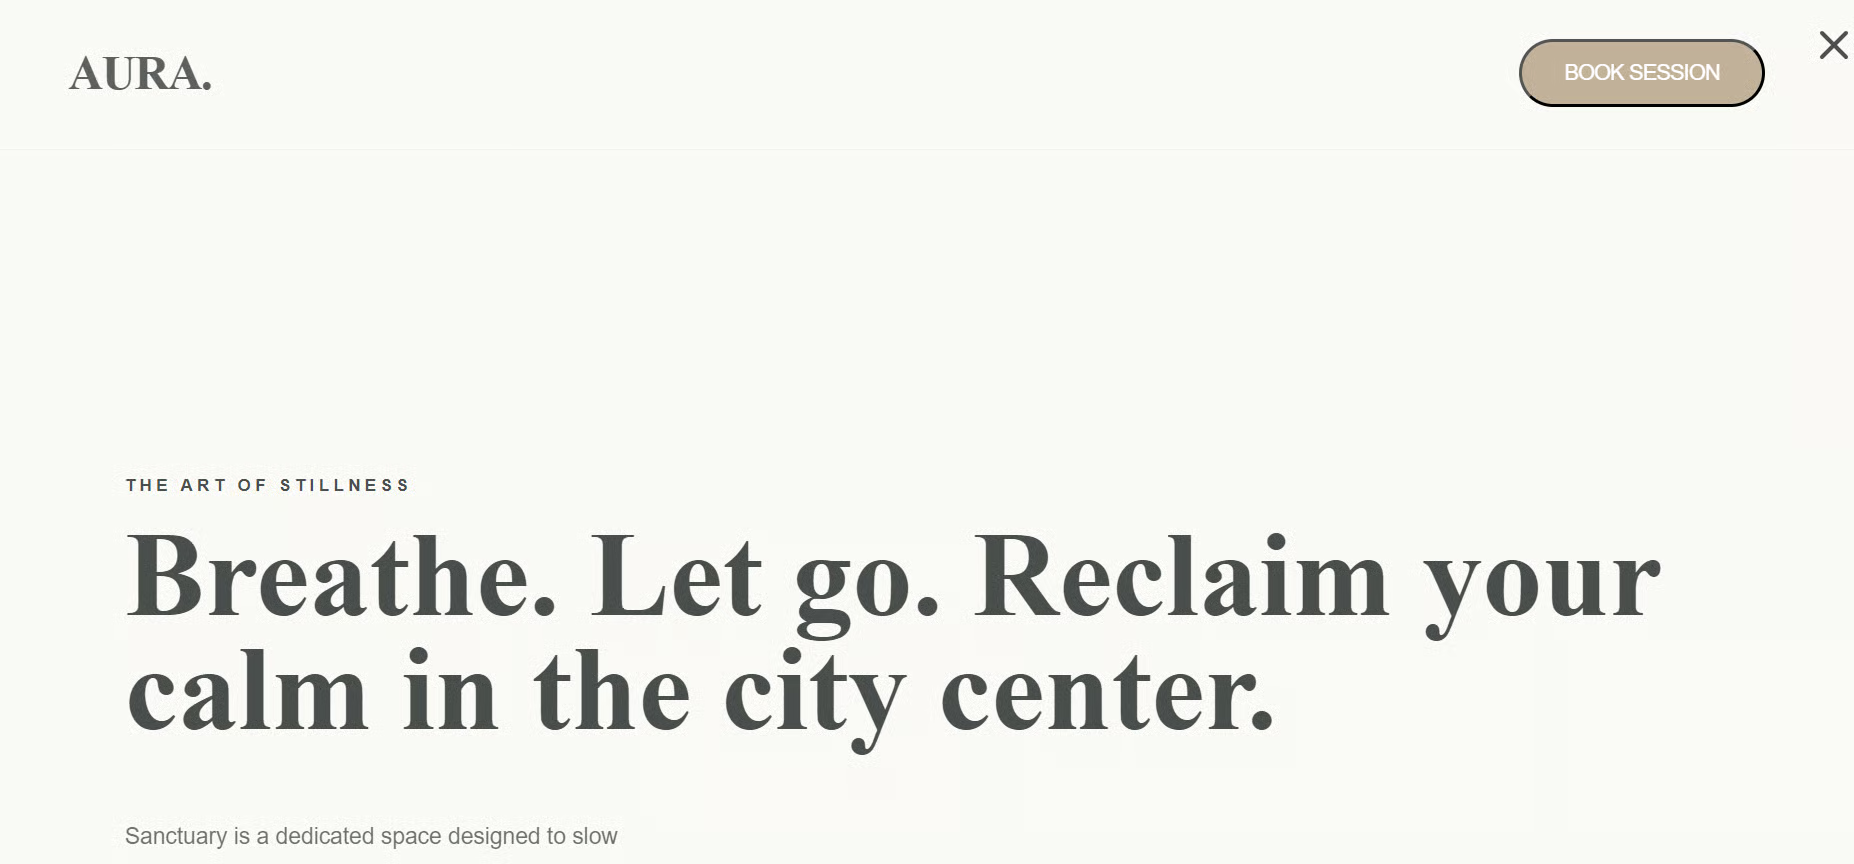
Entrambi i risultati erano visivamente curati, ma nella prova la versione con ragionamento ha dato un esito più strutturato.
La velocità in token può variare in base alla lunghezza del prompt, allo stile dell'output, al carico della GPU e a quanto spesso il modello principale accetta i token proposti dall'MTP.
Pi è un leggero agente di coding da terminale. Può connettersi al server locale Fable 5-Enhanced Gemma 4 e usarlo per leggere file, modificare codice, eseguire comandi e completare attività di programmazione.
Apri un quarto terminale e installa Pi:
curl -fsSL https://pi.dev/install.sh | sh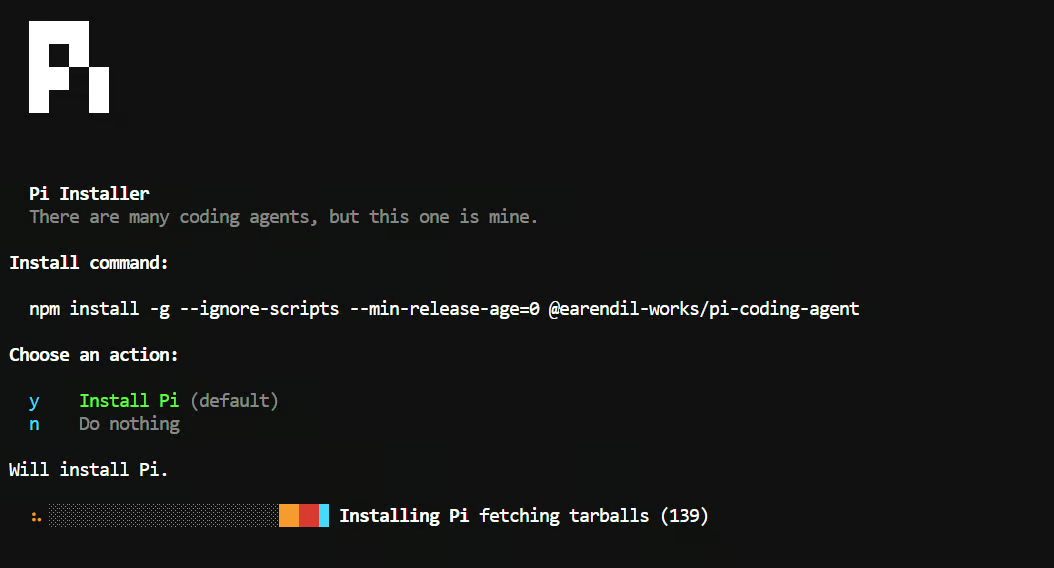 L'installer potrebbe chiedere di installare Node.js. Accetta il prompt e attendi il completamento dell'installazione.
Ricarica la configurazione del terminale, quindi conferma che Pi sia disponibile:
source ~/.bashrc
pi --version
Poi installa il plugin pi-llama:
pi install git:github.com/huggingface/pi-llamaQuesto plugin collega Pi a un server llama.cpp in esecuzione e rileva automaticamente i modelli locali disponibili.
Per impostazione predefinita, il plugin cerca llama.cpp sulla porta 8080. Il nostro server usa la porta 8910, quindi imposta l'indirizzo corretto dell'API locale prima di avviare Pi:
export LLAMA_BASE_URL="http://127.0.0.1:8910/v1"Crea una nuova directory di progetto, inizializza Git e avvia Pi:
mkdir -p /workspace/data-app
cd /workspace/data-app
git init
pi
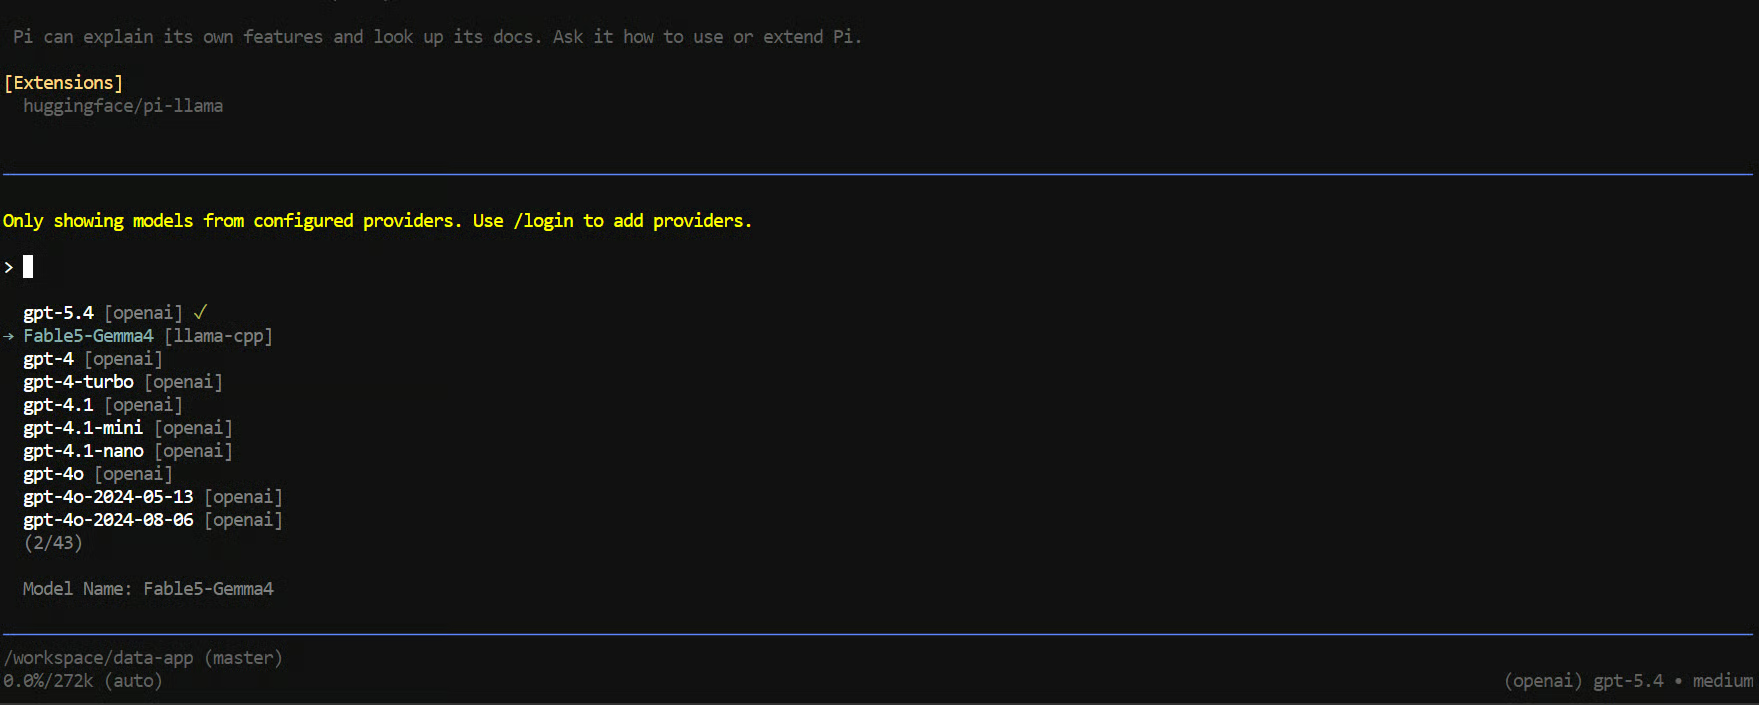
Dentro Pi, digita:
/modelSeleziona il modello “Fable5-Gemma4”.
Poi assegna all'agente un compito pratico di coding:
Create a simple data analytics dashboard using Streamlit that lets users
upload a CSV file, view the data, and explore clear visualizations.
Include a sample CSV file and test the full app to make sure it works correctly.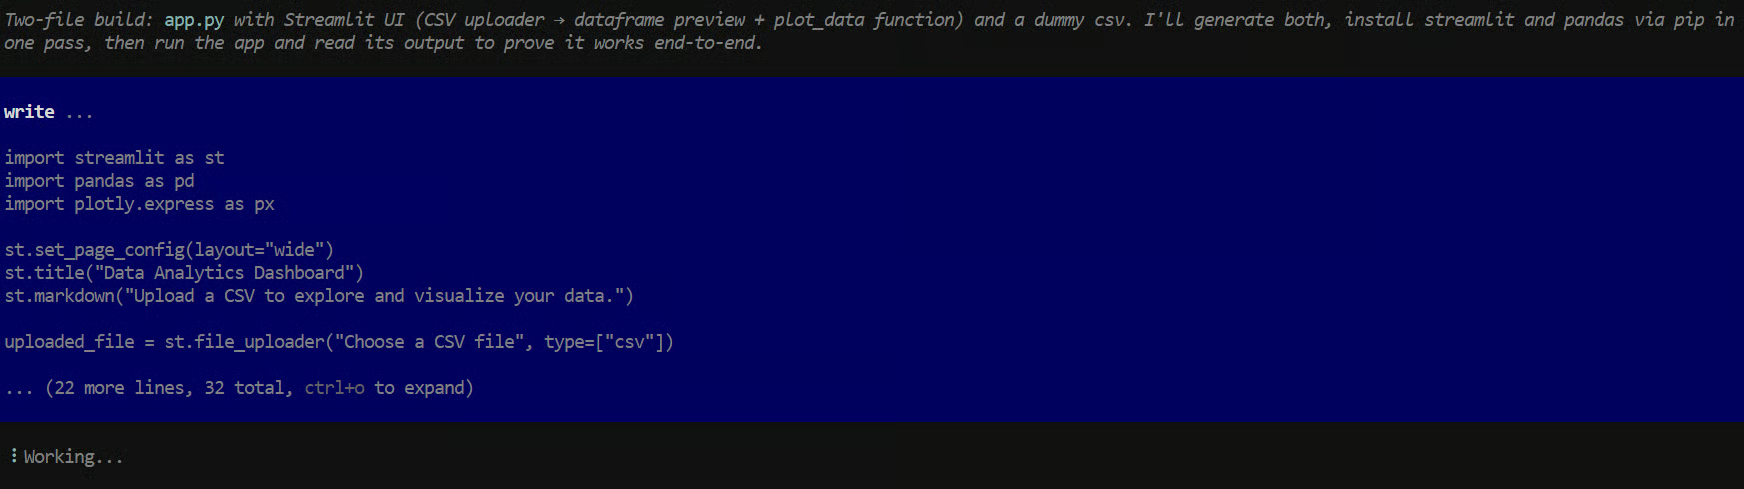
Il modello alla fine ha creato una dashboard Streamlit funzionante con supporto per upload CSV e visualizzazioni.
Tuttavia, il processo è stato molto più difficile del previsto.
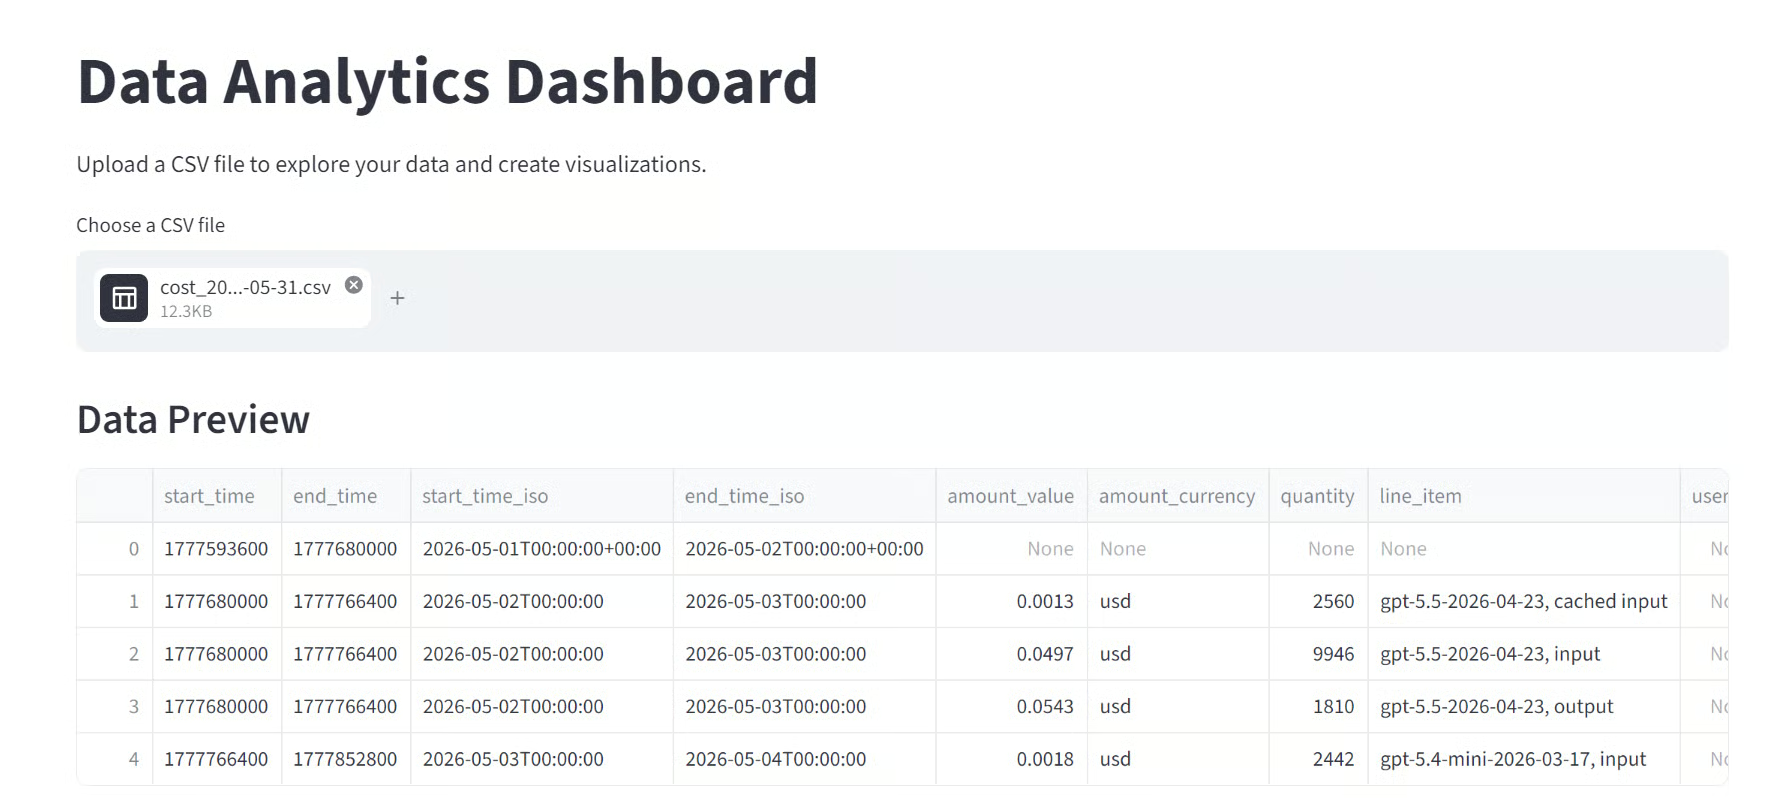
Ha avuto difficoltà ripetute con le chiamate agli strumenti, i comandi da terminale e la scrittura dei file di progetto.
Spesso non riusciva a completare l'azione successiva dopo aver pianificato cosa fare, quindi ho dovuto continuare a guidarlo tra gli errori e rilanciare i comandi.
Non sono riuscito a capire se ciò fosse causato dal modello, dall'integrazione con Pi, dai permessi locali o da una combinazione di questi fattori.
Dopo circa 20 minuti di tentativi, ha prodotto un risultato funzionante. Per un compito Streamlit relativamente semplice, è sembrato troppo lento e inaffidabile.
Lo stesso compito ha richiesto circa un minuto con GLM 5.2 in un mio test separato.
Non è del tutto corretto confrontare un modello locale da 12B con un modello frontier molto più grande.
Tuttavia, il divario era comunque evidente.
Fable 5-Enhanced Gemma 4 può produrre codice curato e output single-turn solidi, ma le sue prestazioni agentiche reali sono state incoerenti in questo test. Ha richiesto troppa supervisione per un compito che un coding agent capace dovrebbe completare in modo rapido e autonomo.
La mia conclusione è che il modello è interessante per sperimentazioni locali, generazione di codice privata e workflow leggeri.
Ma, in base a questo test, non mi affiderei ancora a lui per compiti da coding agent multi-step affidabili.
Sebbene questa guida offra un modo semplice per testare il modello, potresti incontrare problemi in base all'hardware, alla configurazione locale e alla build di llama.cpp.
Se il server va in crash durante il caricamento del modello MTP draft e mostra un errore come:
invalid vector subscriptIl problema potrebbe essere la tua build di llama.cpp piuttosto che i file del modello.
Il repository del modello riporta che la build b9553 di llama.cpp funziona con il modello MTP draft di Gemma 4, mentre build più recenti come b9702 e b9717 possono fallire durante il caricamento del modello draft.
Come soluzione rapida, rimuovi gli argomenti MTP dal comando del server ed esegui solo il modello principale. Il modello funzionerà comunque correttamente, ma la generazione potrebbe essere più lenta.
Rimuovi queste righe:
--model-draft "$MODEL_DIR/MTP/gemma-4-12B-it-MTP-Q8_0.gguf"
--spec-type draft-mtp
--spec-draft-n-max 2
-ngld 99Se vedi token come <|tool_call> o <|channel> nella risposta, il client non sta applicando correttamente il formato nativo delle tool-call di Gemma 4.
Assicurati che il comando del server includa:
--jinjaPoi riavvia il server. Questo applica il chat template corretto per il ragionamento del modello e le chiamate a strumenti strutturate.
Per prima cosa, verifica che il server llama.cpp sia ancora in esecuzione:
curl http://127.0.0.1:8910/v1/modelsDovresti vedere Fable5-Gemma4 nella risposta.
Poi assicurati che Pi punti alla porta 8910 invece della porta predefinita di llama.cpp 8080:
export LLAMA_BASE_URL="http://127.0.0.1:8910/v1"
pi
Esegui entrambi i comandi nella stessa sessione del terminale.
Avvia Pi dentro una directory di progetto scrivibile:
cd /workspace/data-app
pi
Puoi testare se la directory corrente consente la creazione di file:
touch write-test.txt && rm write-test.txtSe questo comando fallisce, il problema è un tema di permessi del workspace e non del modello. Spostati in una directory scrivibile prima di lanciare Pi.
Se il modello inizia a ripetere testo, numeri o simboli, controlla le impostazioni di campionamento nel comando del server.
Usa questi valori:
--temp 1.0 \
--top-p 0.95 \
--top-k 64 \
--repeat-penalty 1.1
La penalità di ripetizione è particolarmente importante. Senza di essa, il modello può produrre output ripetuti o confusi.
Una finestra di contesto da 256K richiede una KV cache ampia. Se il server esaurisce la VRAM, riduci prima la dimensione del contesto:
--ctx-size 32768Puoi anche disabilitare il modello MTP draft per liberare più VRAM. Controlla l'uso corrente della memoria GPU con:
nvidia-smiIl modello può generare codice valido, ma può comunque faticare a completare task più lunghi senza intervento. Nei miei test, a volte pianificava le azioni corrette ma falliva durante l'esecuzione dei comandi, la scrittura dei file o la continuazione dopo un errore.
Per risultati migliori, suddividi le richieste grandi in task più piccoli:
Questo dà al modello un obiettivo più piccolo a ogni step e rende più facile capire se un fallimento dipende dal modello, da Pi, dal server o dai permessi del workspace.
Non penso che l'hype su questo modello sia del tutto giustificato, almeno in base ai miei test. Con e senza MTP, ottenevo quasi la stessa velocità per i compiti generali. Durante i compiti di coding, MTP ha aiutato e ho visto un incremento di velocità intorno al 20–30%. È utile, ma non risolve il problema più grande: la affidabilità.
Ho testato il modello anche nella WebUI.
A volte, mentre scriveva il codice per un file, si fermava senza un motivo chiaro. Quando gli chiedevo di continuare, scriveva la continuazione come testo nella risposta successiva in chat invece di continuare effettivamente il file.
Ho anche notato che abilitare il thinking a volte peggiorava l'output, cosa sorprendente.
L'ho testato anche con Claude Code, e quell'esperienza è stata ancora più frustrante.
Il modello continuava a creare file extra, file temporanei e altre cose irrilevanti di cui un progetto semplice non aveva bisogno. Alla fine ha completato il compito, ma ha richiesto troppa guida e troppo tempo.
So che confrontare un modello locale da 12B con GPT-5.5 o GLM 5.2 non è del tutto corretto. Ma anche rispetto a modelli locali più piccoli, non sono rimasto impressionato.
Per la mia esperienza, Qwen3.6 27B è molto migliore per compiti di coding e agentici, anche se è più grande.
Per ora, vedo questo modello più come un esperimento interessante che come un coding agent affidabile.
Sono più interessato al prossimo modello Qwen3.6 27B con tuning Fable dallo stesso creatore. Ho visto anche altri contributori open source rilasciare modelli di coding distillati simili, ma finora non ho visto un miglioramento significativo nei veri compiti da coding agent.
Il modello può generare codice gradevole e output single-turn curati. Ma quando gli chiedi di lavorare come un agente, usare strumenti, creare file, correggere errori e verificare il risultato, risulta ancora incostante e frustrante da usare.
I migliori corsi DataCamp
Corso
Corso
Programma
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min