Kurs
Fortgeschrittenes, KI-gestütztes Programmieren für Entwickler:innen
1 Std. 30 Min.
1.8K
Nachdem Fable 5 und Mythos 5 eingestellt wurden, begannen Open-Source-Entwickler mit kleineren lokalen Modellen zu experimentieren, die auf hochwertig erzeugten synthetischen Coding- und Agentik-Daten trainiert sind. Fable 5–Enhanced Gemma 4 ist ein Beispiel dafür.
Es handelt sich um ein Gemma 4 12B-Fine-Tune, trainiert auf Datensätzen von Fable 5 und Composer 2.5. Ziel ist es, nützliche Coding- und Agentik-Verhaltensweisen in ein kleineres Modell zu übertragen, das lokal läuft.
Das Training fokussiert auf praktische Workflows: Aufgaben verstehen, Dateien lesen, Tools nutzen, Code bearbeiten, Befehle ausführen und das Endergebnis prüfen.
In diesem Guide zeige ich dir, wie du das Fable 5–erweiterte Gemma 4-Modell mit llama.cpp lokal auf einer RTX 5070 Ti betreibst.
Wir installieren llama.cpp, laden das GGUF-Modell und das MTP-Draft-Modell, starten einen OpenAI-kompatiblen lokalen Server und testen ihn mit cURL und der integrierten WebUI.
Zum Schluss verbinden wir das Modell mit dem Pi Coding Agent und geben ihm eine echte Coding-Aufgabe. Die Kernfrage ist, ob dieses kompakte 12B-Modell nützliches Coding-Agent-Verhalten liefern und mit größeren lokalen Modellen wie Qwen 3.6 27B oder Gemma 4 31B mithalten kann.
Fable 5–Enhanced Gemma 4 ist ein kompaktes Coding- und Agentik-Modell auf Basis von Googles Gemma 4 12B Instruction-Modell. Es wurde von Yuxin Lu erstellt und im GGUF-Format für die lokale Nutzung mit llama.cpp und anderen kompatiblen Tools veröffentlicht.
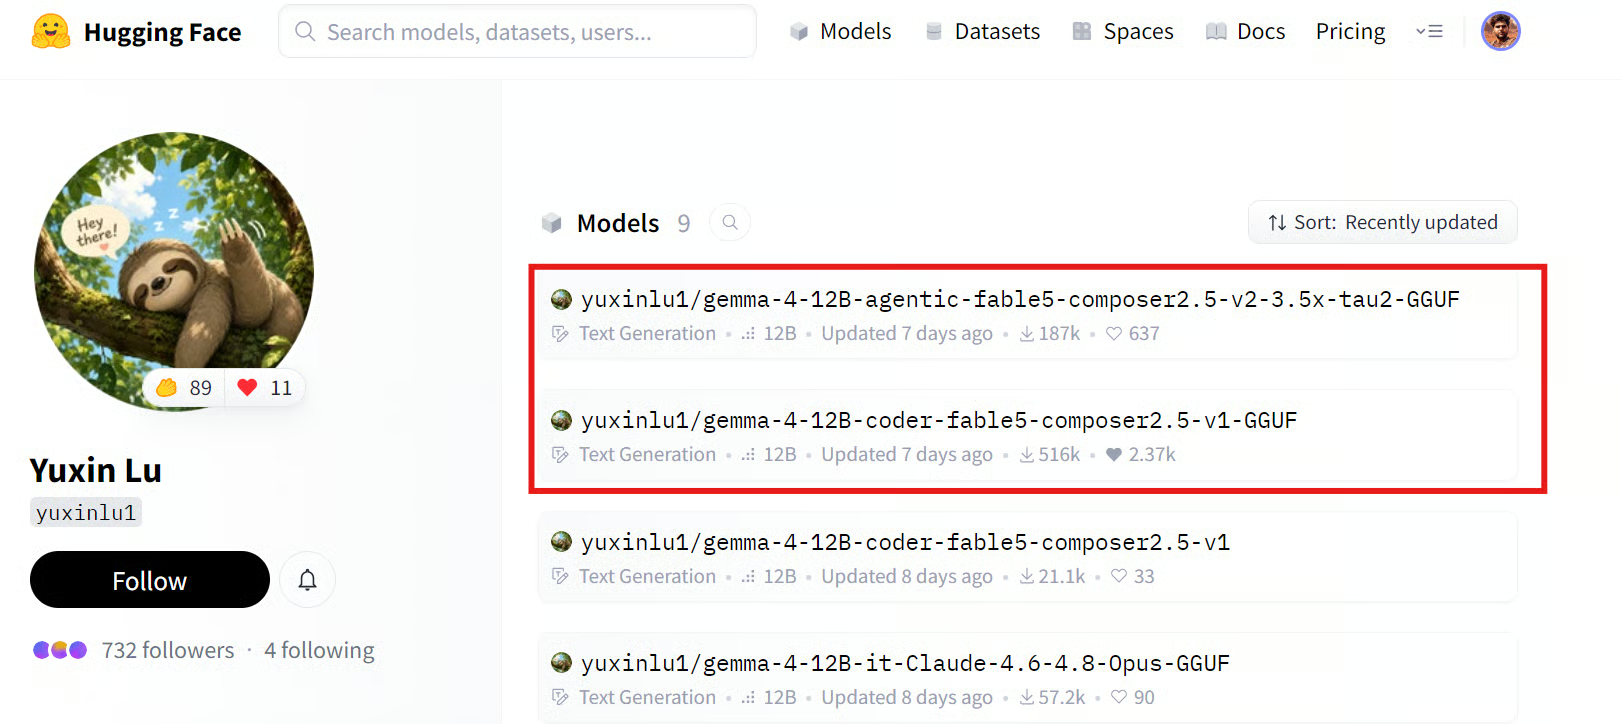
Quelle: yuxinlu1 (Yuxin Lu)
Dieser Guide nutzt das v2-Release. Es führt das v1-Coding-Modell fort, legt aber einen stärkeren Fokus auf agentische Technikarbeit.
Statt nur Code zu generieren, ist es dafür gedacht, Dateien zu inspizieren, Probleme durchzudenken, Tools zu nutzen, Code zu bearbeiten, Befehle auszuführen und das Endergebnis zu verifizieren.
Das Ausgangsmodell wurde mit verifizierten Python-Coding-Daten feinabgestimmt, die von Composer 2.5 und Fable 5 generiert wurden.
Der Haupt-Trainingssatz nutzt Composer 2.5-Reasoning-Traces und Code-Lösungen für Python-Aufgaben mit deterministischen Tests. Es wurden nur Beispiele behalten, bei denen der generierte Code die Tests bestanden hat.
Fable 5 kam bei schwierigeren Aufgaben zum Einsatz, bei denen Composer 2.5 scheiterte. Es erzeugte neue Denkprozesse und korrigierte Lösungen, die ebenfalls per Ausführung verifiziert wurden, bevor sie ins Training einflossen.
Für v2 fügt das Modell mehrstufige Terminal- und Tool-Nutzungs-Trajektorien hinzu. So lernt es, einem „lesen, überlegen, handeln, verifizieren“-Workflow zu folgen, statt nach einer ersten Antwort zu stoppen.
Nachdem Fable 5 nicht mehr verfügbar war, wurden einige fehlende Reasoning-Traces im Fable-5-Stil mit Opus 4.8 rekonstruiert.
--jinja in llama.cpp aktiviert, damit das Modell das vorgesehene Chat-Template und das Tool-Call-Format von Gemma 4 verwenden kann.In einem lokalen tau2-bench-Telekom-Vergleich erreichte das v2-Modell etwa 55 % gegenüber rund 15 % für das Base Gemma 4 12B Instruction-Modell.
Das deutet darauf hin, dass die Hauptverbesserung aus agentischem Verhalten stammt. Das Fine-Tune ist besser darin, eine Aufgabe zu inspizieren, den nächsten Schritt zu gehen, Tools zu nutzen und Ergebnisse zu verifizieren, statt nach der ersten Antwort aufzuhören.
Das ist der schnellste und einfachste Weg, llama.cpp auf einer Linux-Maschine zu installieren. Statt das Repository zu klonen und aus dem Quellcode zu bauen, lädt der Installer ein vorgefertigtes Binary und richtet es ein.
Führe folgenden Befehl im Terminal aus:
curl -LsSf https://llama.app/install.sh | shNach wenigen Sekunden lädt der Installer das llama.cpp-Binary herunter und schließt die Einrichtung ab.
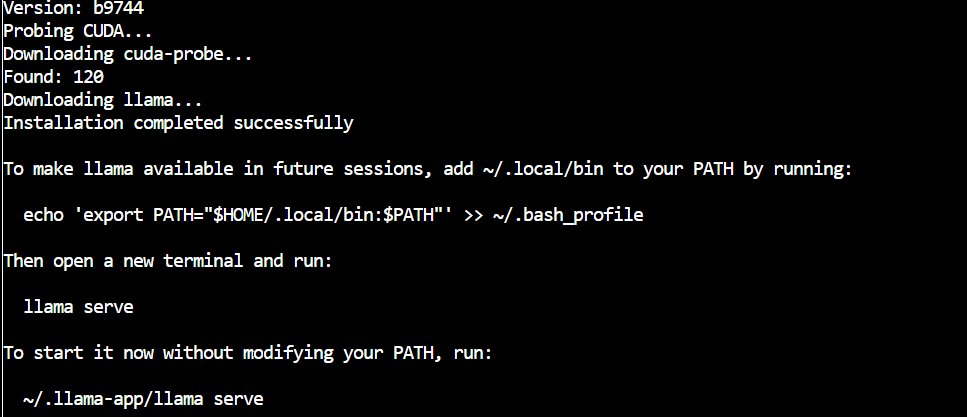
Füge anschließend llama.cpp zu deinem PATH hinzu, damit du den llama-Befehl aus jedem Verzeichnis nutzen kannst – auch nach einem Neustart des Terminals:
echo 'export PATH="$HOME/.local/bin:$PATH"' >> ~/.bashrc
source ~/.bashrc
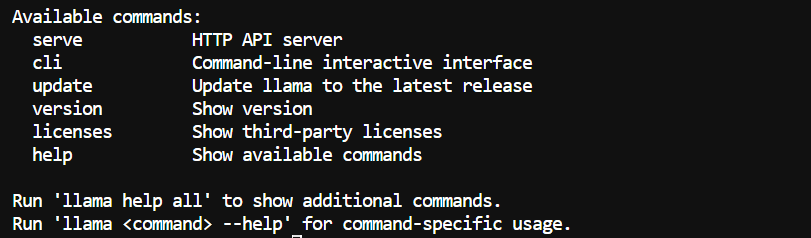
Prüfe zum Schluss, ob die Installation funktioniert hat:
llama helpJetzt solltest du die verfügbaren llama.cpp-Befehle sehen.
Installiere als Nächstes die Hugging Face CLI und hf-xet. Damit lädst du Modelldateien direkt von Hugging Face herunter – inklusive Repositories, die Xet-Speicher für große Dateien nutzen.
pip install -U "huggingface_hub[cli]" hf-xet Lege ein Verzeichnis für die Modelldateien an:
MODEL_DIR="/workspace/Fable5-Gemma4"
mkdir -p "$MODEL_DIR"
Aktiviere schnellere Xet-Downloads und lade dann nur die für diesen Guide benötigten Dateien:
export HF_XET_HIGH_PERFORMANCE=1


hf download \
  yuxinlu1/gemma-4-12B-agentic-fable5-composer2.5-v2-3.5x-tau2-GGUF \
  --include "gemma4-v2-Q4_K_M.gguf" \
  --include "MTP/gemma-4-12B-it-MTP-Q8_0.gguf" \
  --local-dir "$MODEL_DIR"
Dabei werden zwei Dateien heruntergeladen:
gemma4-v2-Q4_K_M.gguf, das eigentliche Fable 5–Enhanced Gemma 4-Modell.MTP/gemma-4-12B-it-MTP-Q8_0.gguf, das Draft-Modell für MTP Speculative Decoding.Das Q4_K_M-Modell ist etwa 7 GB groß. Die Downloadzeit hängt von deiner Internetverbindung ab, aber Xet kann die Übertragung großer Modelldateien beschleunigen.
Nach Abschluss sollten deine Dateien hier liegen:
/workspace/Fable5-Gemma4Starte jetzt den lokalen Server mit dem Hauptmodell und dem MTP-Draft-Modell:
MODEL_DIR="/workspace/Fable5-Gemma4"

llama serve \
  --model "$MODEL_DIR/gemma4-v2-Q4_K_M.gguf" \
  --alias Fable5-Gemma4 \
  --model-draft "$MODEL_DIR/MTP/gemma-4-12B-it-MTP-Q8_0.gguf" \
  --spec-type draft-mtp \
  --spec-draft-n-max 2 \
  -ngl 99 \
  -ngld 99 \
  --ctx-size 262144 \
  --parallel 1 \
  --cache-type-k q8_0 \
  --cache-type-v q8_0 \
  --flash-attn on \
  --jinja \
  --temp 1.0 \
  --top-p 0.95 \
  --top-k 64 \
  --repeat-penalty 1.1 \
  --host 0.0.0.0 \
  --port 8910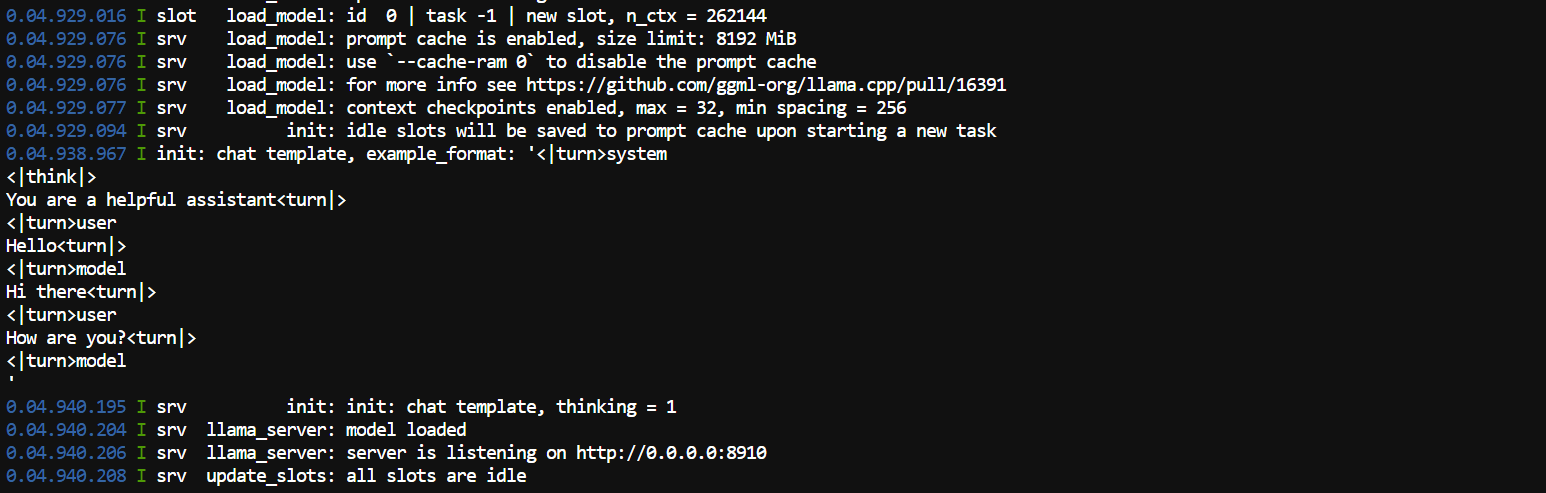
Das Argument --model-draft lädt das MTP-Draft-Modell.
MTP steht für Multi Token Prediction. Das kleinere Draft-Modell sagt zunächst einige kommende Token voraus, und das Hauptmodell verifiziert diese parallel. Das kann die Generationsgeschwindigkeit erhöhen, ohne die Rolle des Hauptmodells zu ändern.
--spec-type draft-mtp aktiviert dieses MTP-Setup für Speculative Decoding. --spec-draft-n-max 2 lässt das Draft-Modell bis zu zwei Token auf einmal vorschlagen. Zwei ist ein sinnvoller Startwert, da größere Werte nicht immer schneller sind.
-ngl 99 verschiebt das Hauptmodell auf die GPU, während -ngld 99 dasselbe für das MTP-Draft-Modell tut. Der Wert 99 bedeutet schlicht, alle verfügbaren Layer auszulagern.
--ctx-size 262144 setzt ein maximales Kontextfenster von 256K Token. Das ist hilfreich für größere Codebasen und lange Terminal-Sessions, benötigt aber auch mehr VRAM. --parallel 1 reserviert den gesamten Kontext für eine aktive Anfrage, statt ihn auf mehrere Nutzer aufzuteilen.
Die Q8-KV-Cache-Einstellungen reduzieren den Speicherbedarf für das lange Kontextfenster. --flash-attn on macht die Attention-Berechnungen effizienter, besonders bei langen Prompts.
Lass --jinja aktiviert. Dadurch wird das eingebaute Chat-Template des Modells angewendet, sodass Prompts, Reasoning und Tool-Calls korrekt formatiert sind.
Die restlichen Sampling-Einstellungen steuern die Textgenerierung. --temp 1.0, --top-p 0.95 und --top-k 64 erlauben variablere Antworten, während --repeat-penalty 1.1 Wiederholungen reduziert.
Sobald der Server geladen ist, öffne die WebUI:
http://localhost:8910 Du kannst die GPU-Auslastung auch in einem zweiten Terminal prüfen:
nvidia-smi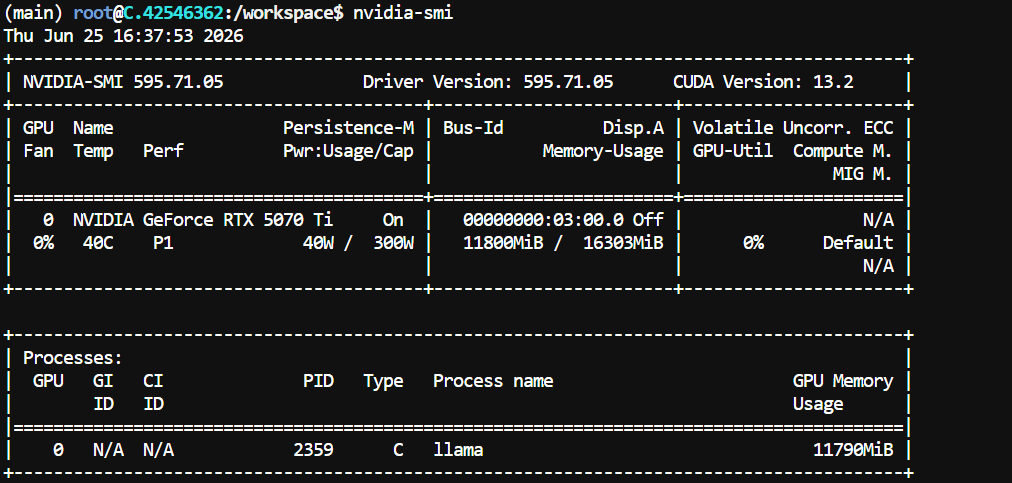
In meinem Setup mit einer RTX 5070 Ti belegte das Modell rund 11,8 GB VRAM bei 256K-Kontext und ließ mehr als 4 GB frei.
Dein Speicherverbrauch kann je nach llama.cpp-Build, GPU-Treiber und Kontext-Einstellungen variieren.
Lass das llama serve-Terminal geöffnet und öffne dann ein drittes Terminal, um die lokale API zu testen.
curl http://127.0.0.1:8910/v1/messages \
  -H "Content-Type: application/json" \
  -d '{
    "model": "Fable5-Gemma4",
    "max_tokens": 512,
    "messages": [
      {
        "role": "user",
        "content": "Create a simple Python script that prints Hello, I am running locally! "
      }
    ]
  }'
Die Antwort sollte den generierten Text des Modells enthalten – inklusive seiner Thinking-Ausgabe. In diesem Test lieferte das Modell folgenden Python-Code:
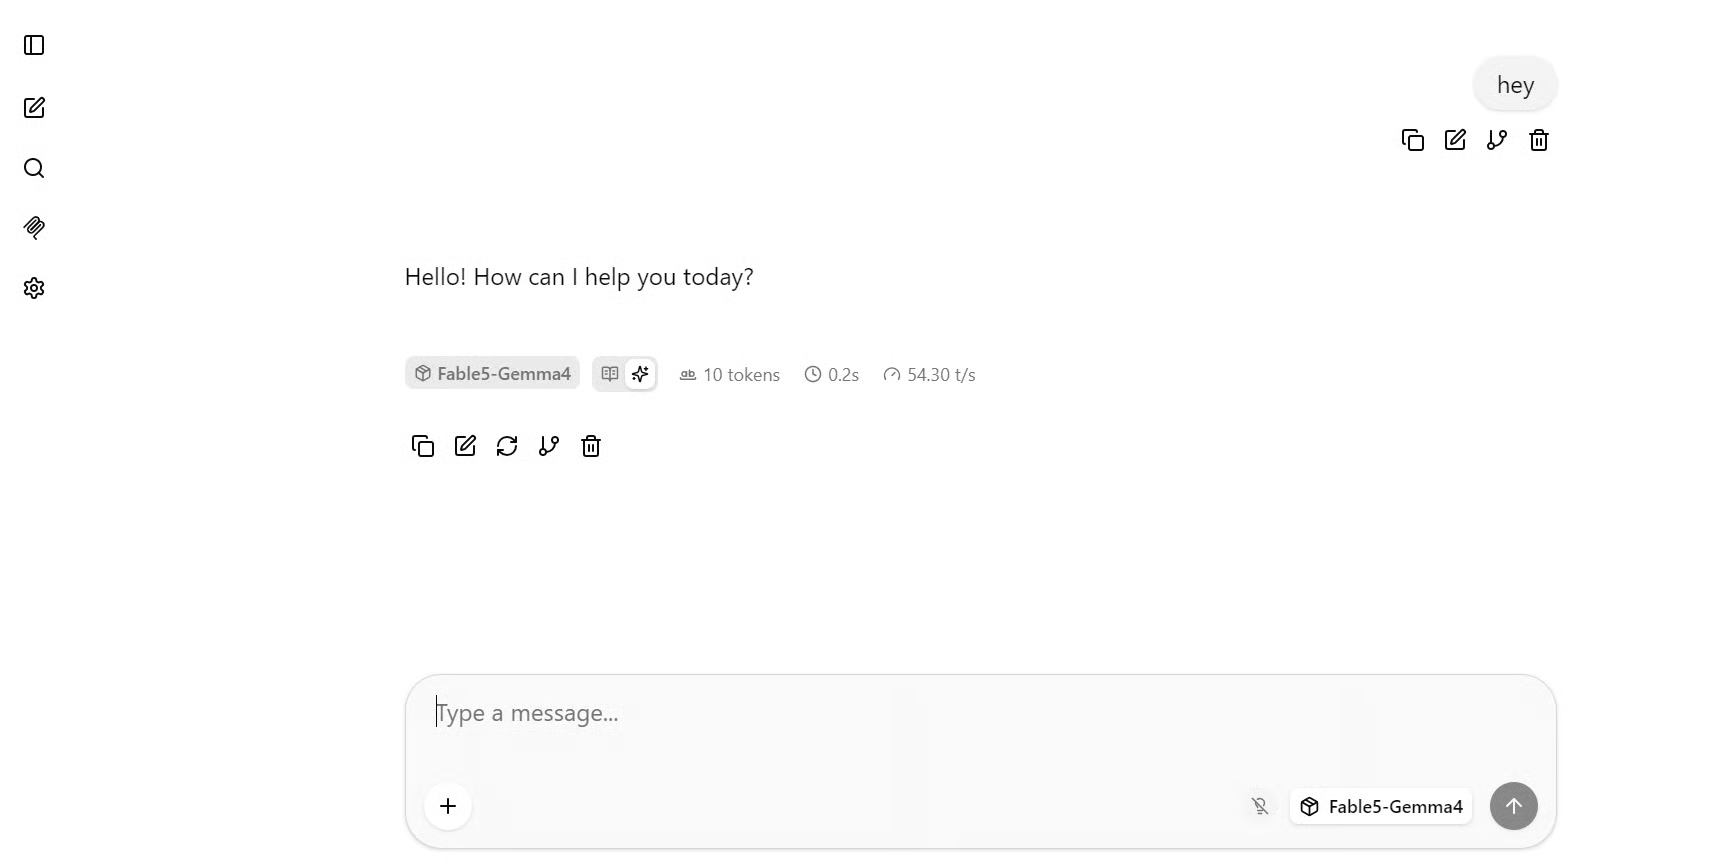
print("Hello, I am running locally!")Eine JSON-Antwort bestätigt, dass der lokale Server korrekt läuft. In meinem kurzen Test generierte das Modell mit etwa 54 Token pro Sekunde.
Du kannst auch die integrierte Chat-Oberfläche nutzen. Öffne folgende Adresse im Browser:
http://localhost:8910Die WebUI funktioniert wie eine normale Chat-App. Wähle das Modell Fable5-Gemma4, schreibe einen Prompt und sende ihn an den lokalen Server.
Für einen größeren Coding-Test nutze diesen Prompt:
Create a calming, premium spa treatment center website in one self-contained HTML file
with all CSS and JavaScript included inline, elegant booking CTAs, treatment packages,
therapist profiles, testimonials, and high-quality spa imagery.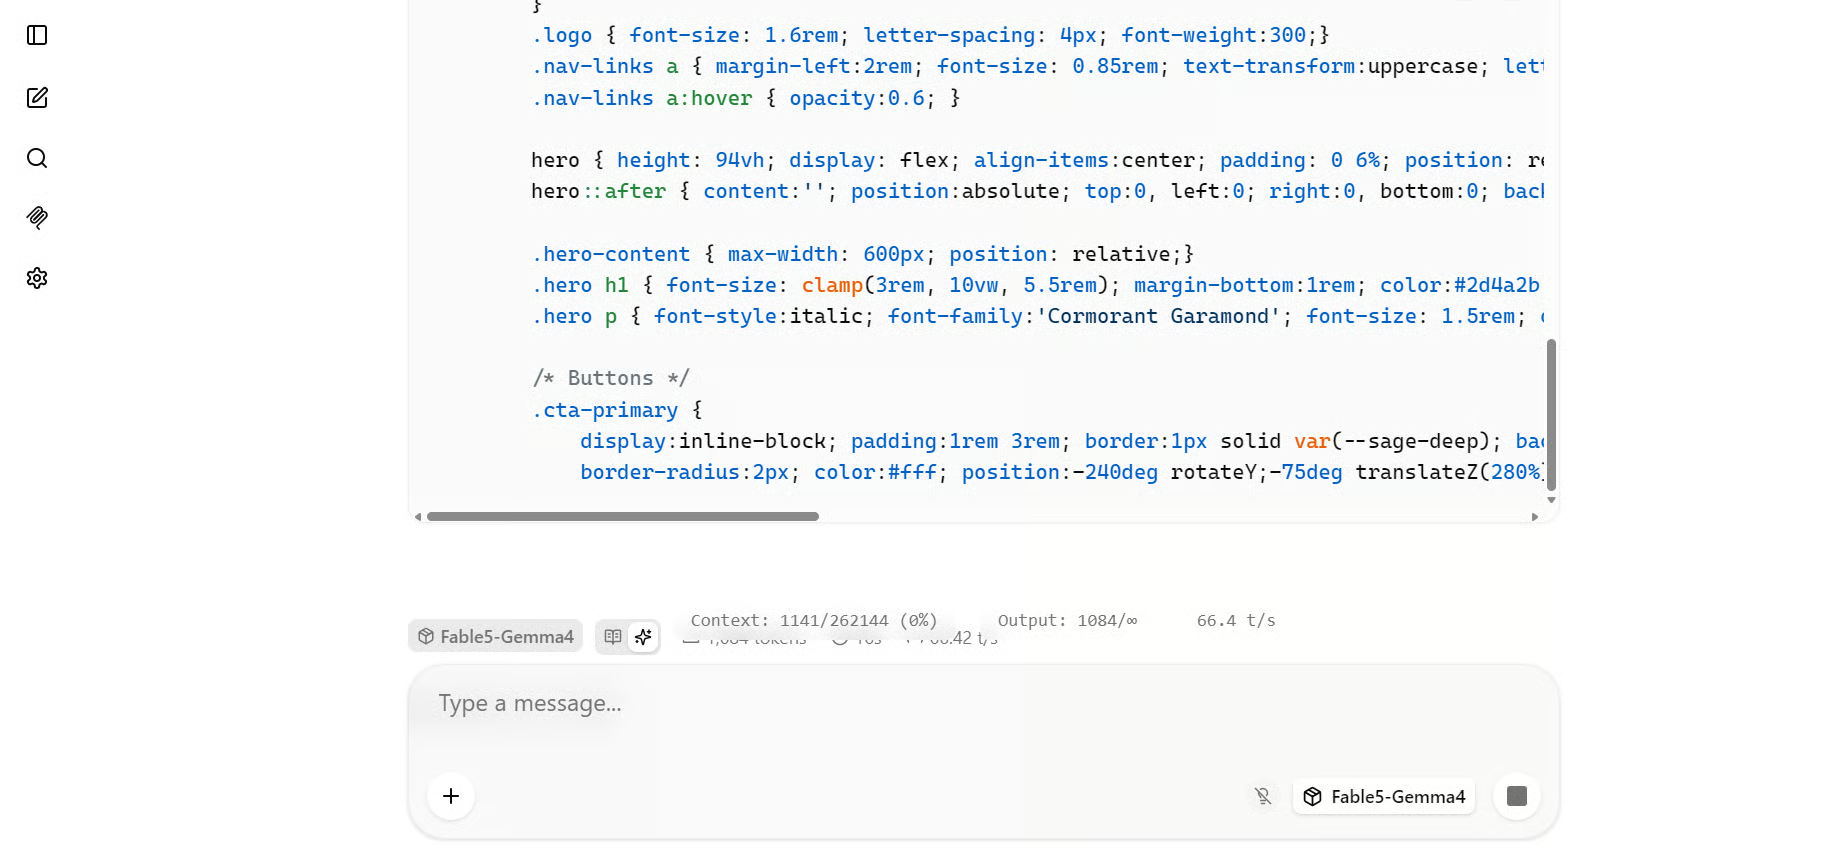
Bei dieser längeren HTML-Generierung sah ich grob 66 bis 70 Token pro Sekunde. Längere Coding-Aufgaben können die Speculative-Decoding-Performance verbessern, weil das Modell eine kontinuierlichere Sequenz vorhersehbarer Code-Token generiert.
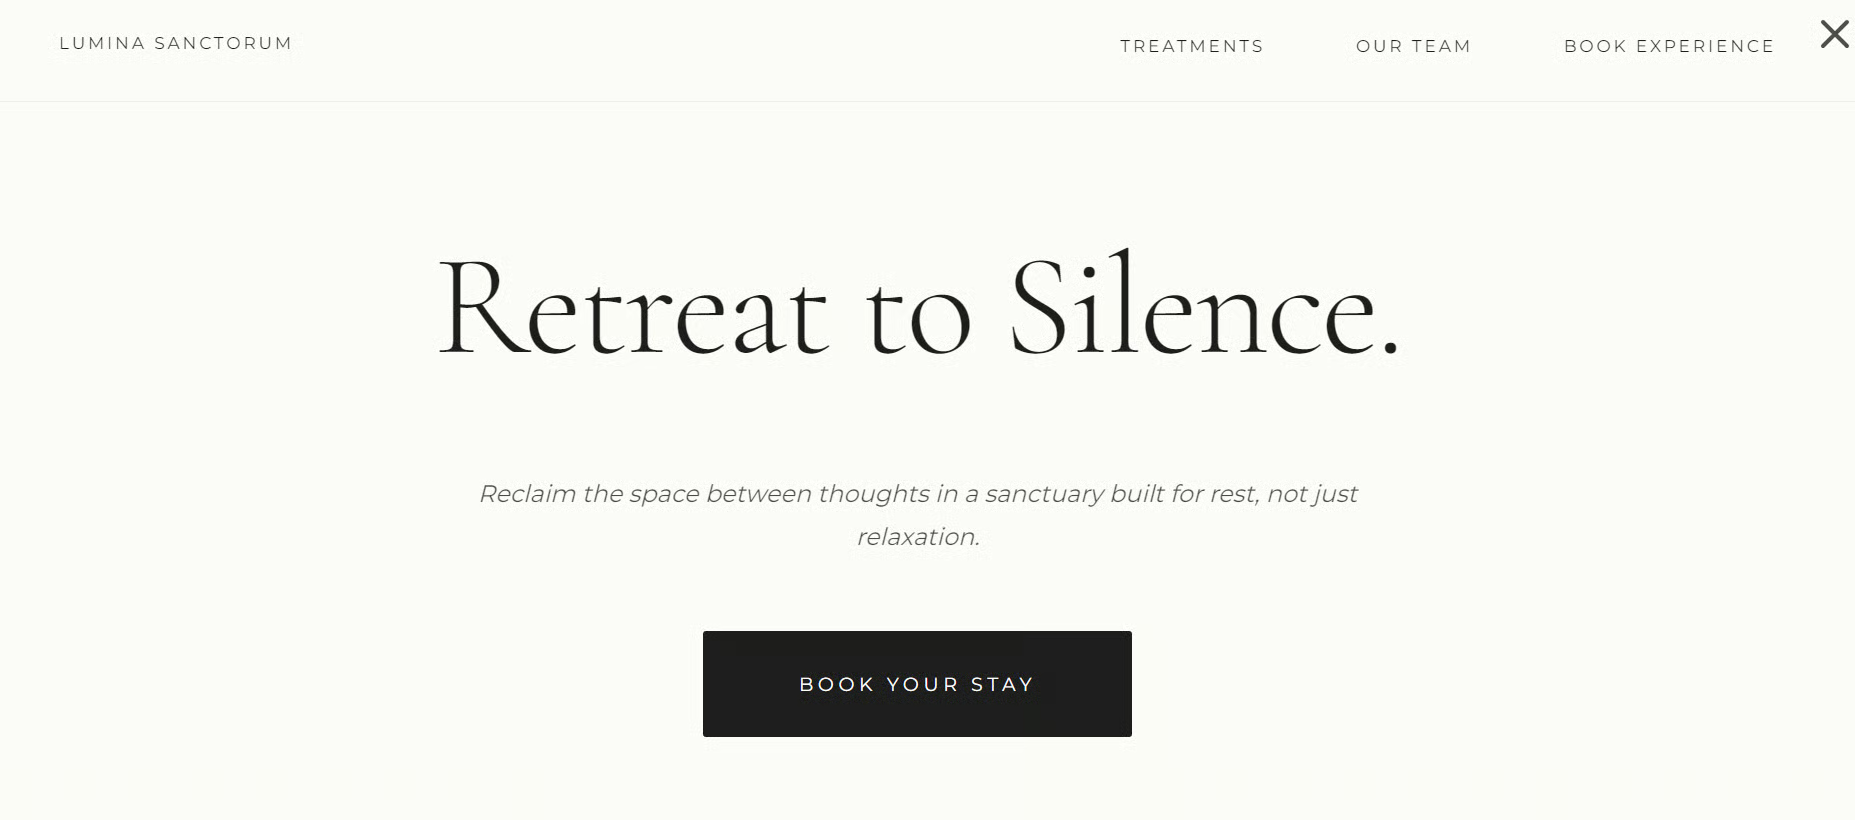
Das erste Ergebnis unten wurde mit Reasoning auf Medium erzeugt. Es entstand eine saubere Spa-Landingpage mit minimalem Layout, Navigationslinks und einem großen Buchungs-CTA.
Das zweite Ergebnis wurde ohne Reasoning generiert. Es ergab eine andere visuelle Richtung, mit größerer Headline und einem stärker redaktionellen Landingpage-Stil.
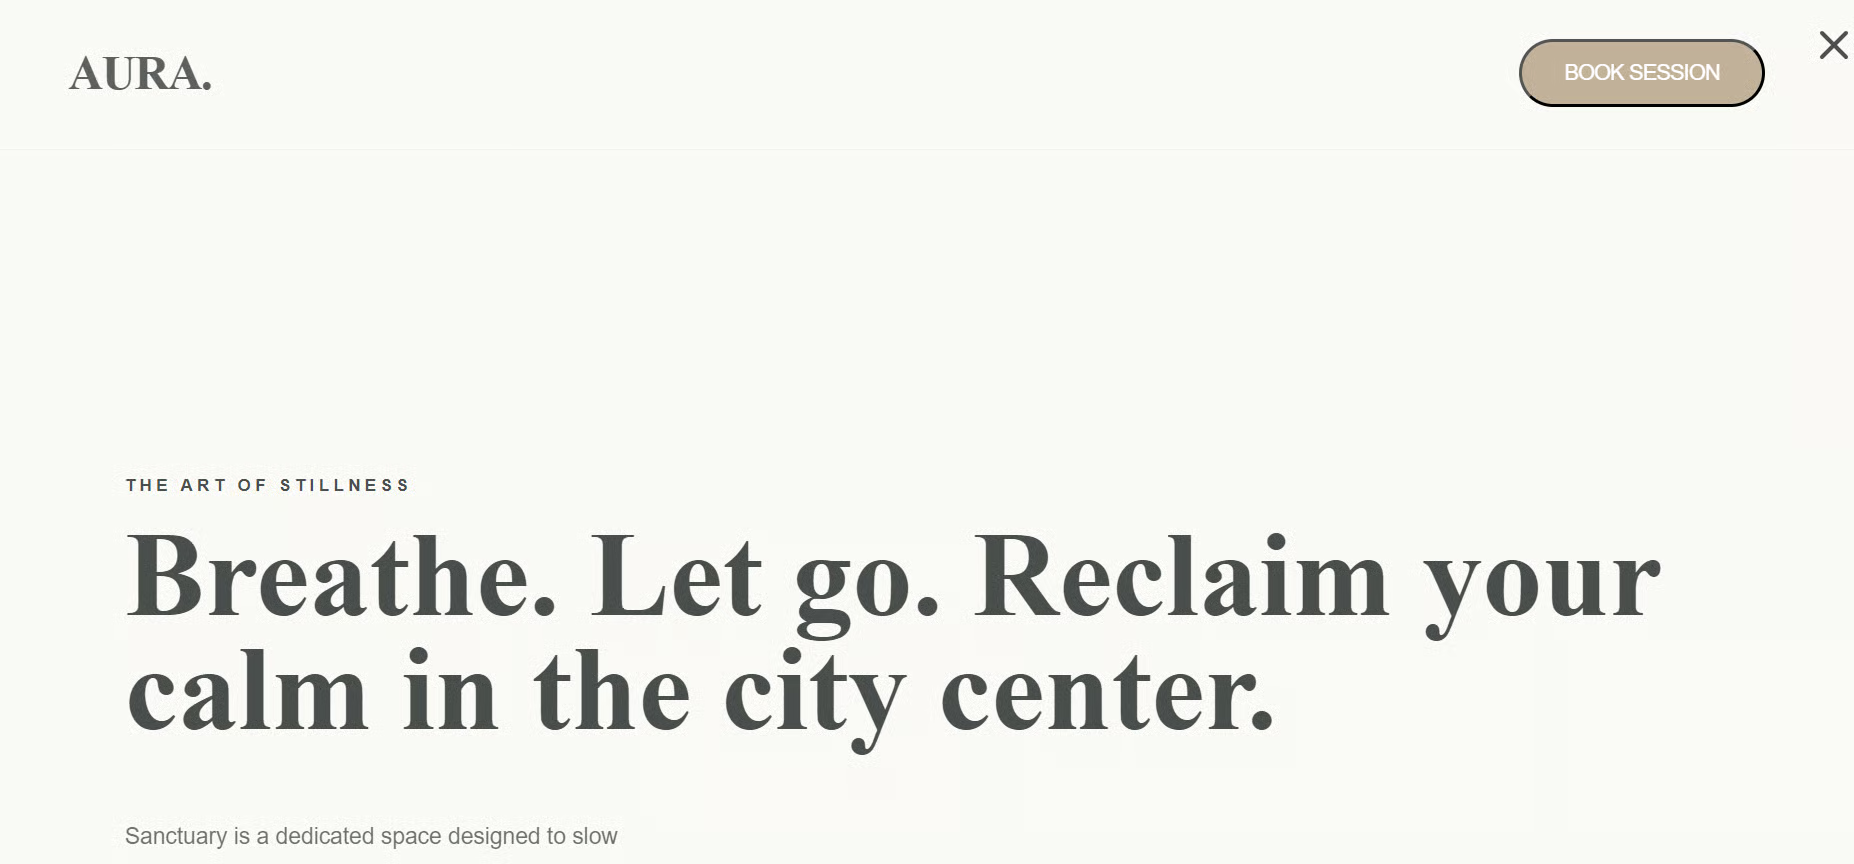
Beide Ergebnisse waren visuell sorgfältig, aber die Version mit Reasoning war in diesem Test strukturierter.
Die Token-Rate variiert je nach Prompt-Länge, Ausgabestil, GPU-Last und der Häufigkeit, mit der das Hauptmodell die vom MTP vorgeschlagenen Draft-Token akzeptiert.
Pi ist ein schlanker Terminal-Coding-Agent. Er kann sich mit dem lokalen Fable 5–Enhanced Gemma 4-Server verbinden und damit Dateien lesen, Code bearbeiten, Befehle ausführen und Coding-Aufgaben erledigen.
Öffne ein viertes Terminal und installiere Pi:
curl -fsSL https://pi.dev/install.sh | sh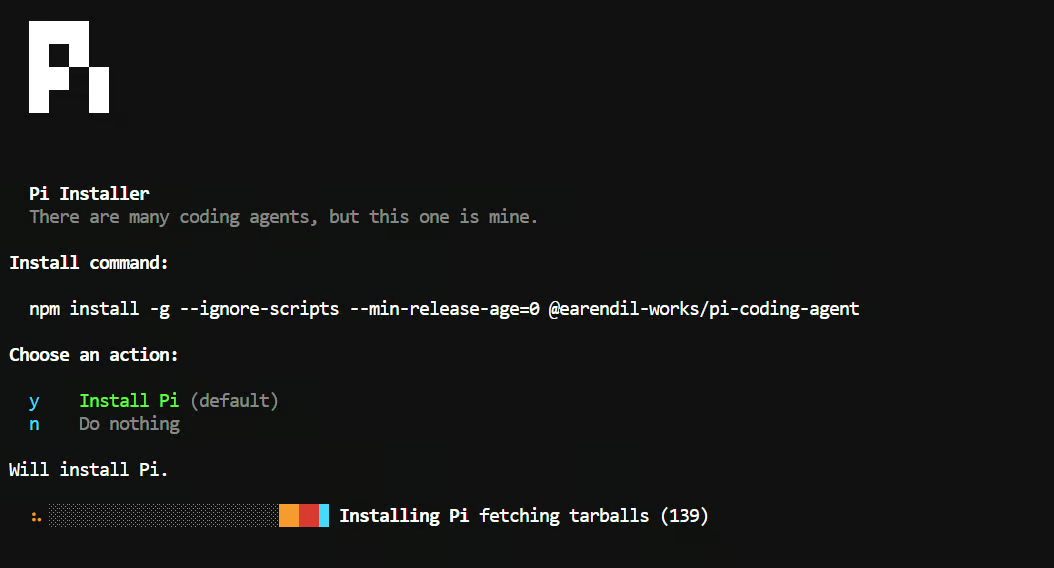 Der Installer fragt ggf. nach der Installation von Node.js. Bestätige die Abfrage und warte, bis die Installation abgeschlossen ist.
Lade deine Terminal-Konfiguration neu und prüfe, ob Pi verfügbar ist:
source ~/.bashrc
pi --version
Installiere als Nächstes das pi-llama-Plugin:
pi install git:github.com/huggingface/pi-llamaDieses Plugin verbindet Pi mit einem laufenden llama.cpp-Server und erkennt automatisch verfügbare lokale Modelle.
Standardmäßig sucht das Plugin auf Port 8080 nach llama.cpp. Unser Server läuft auf Port 8910, daher musst du vor dem Start von Pi die richtige lokale API-Adresse setzen:
export LLAMA_BASE_URL="http://127.0.0.1:8910/v1"Erstelle ein neues Projektverzeichnis, initialisiere Git und starte Pi:
mkdir -p /workspace/data-app
cd /workspace/data-app
git init
pi
Gib innerhalb von Pi ein:
/modelWähle das Modell „Fable5-Gemma4“.
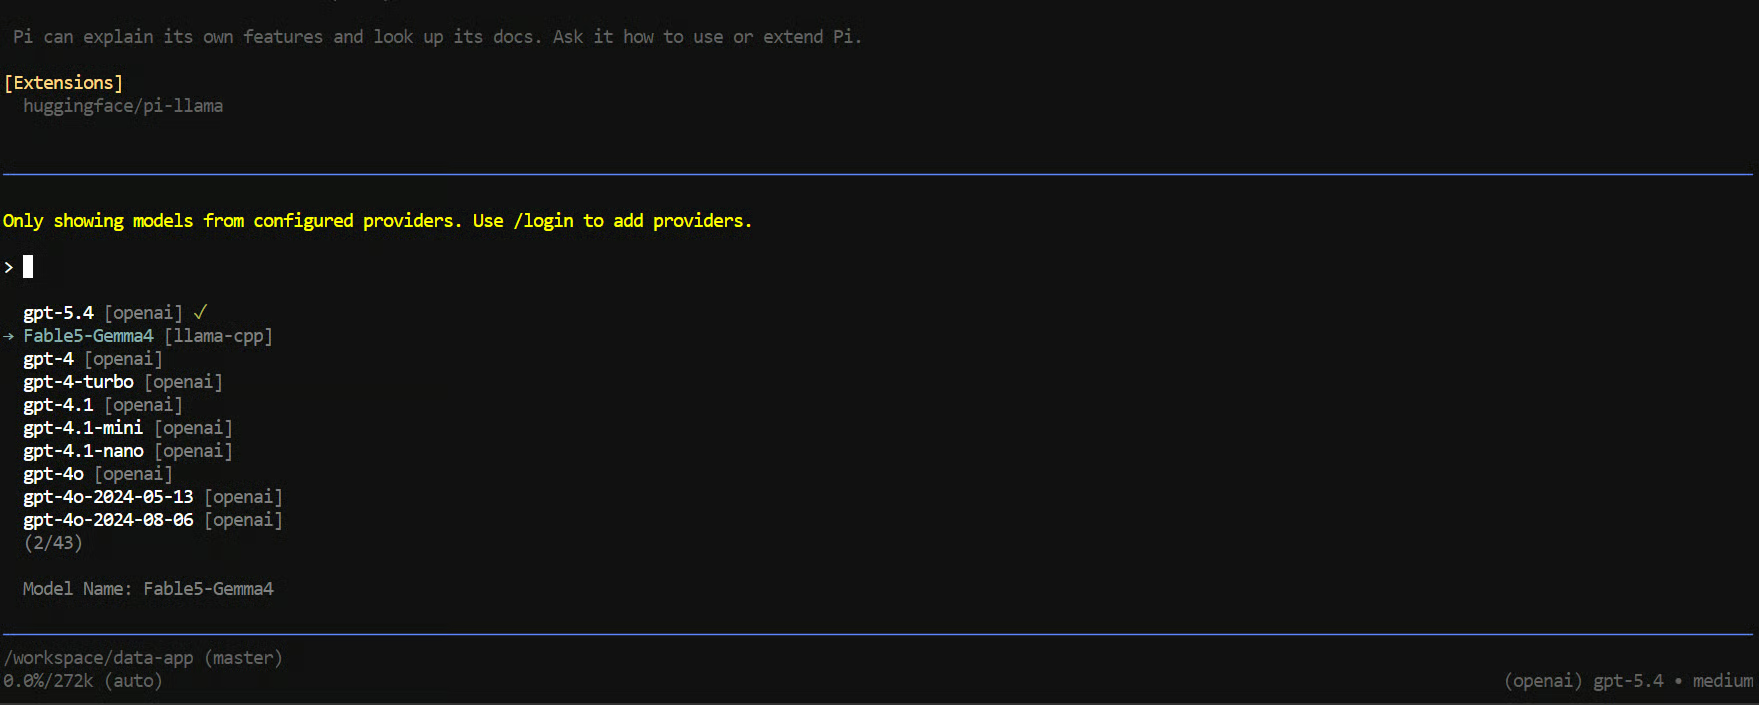
Gib dem Agenten anschließend eine praktische Coding-Aufgabe:
Create a simple data analytics dashboard using Streamlit that lets users
upload a CSV file, view the data, and explore clear visualizations.
Include a sample CSV file and test the full app to make sure it works correctly.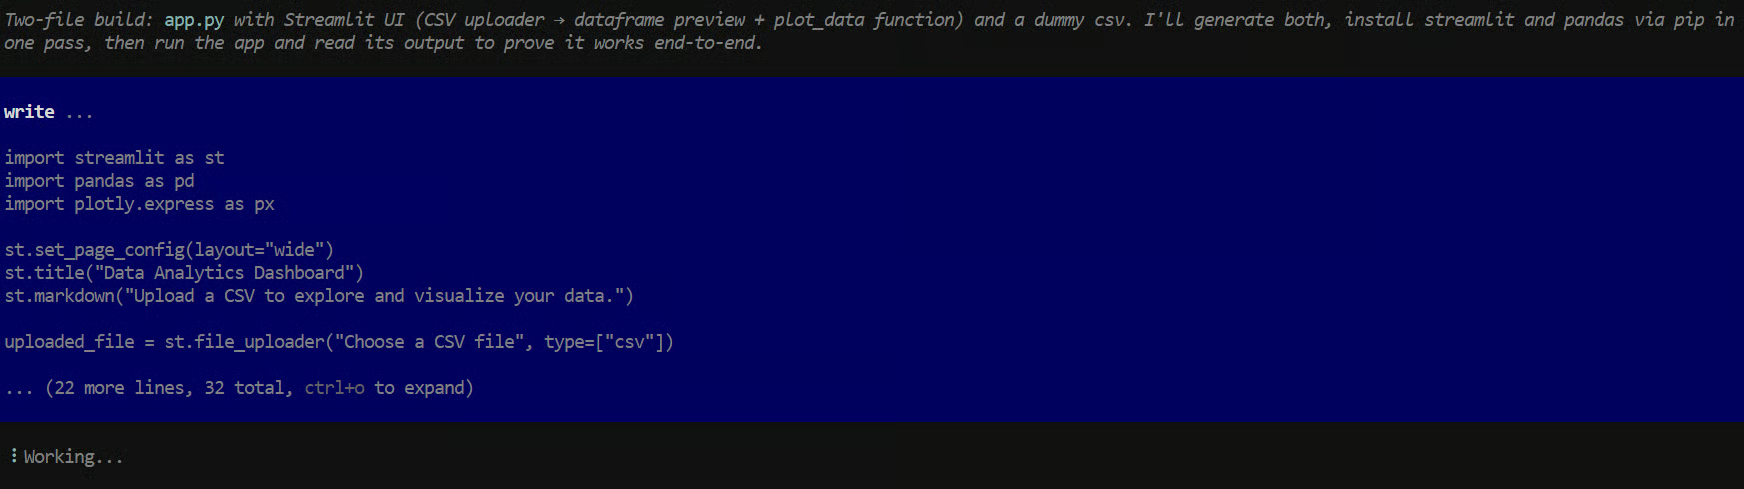
Das Modell erstellte schließlich ein funktionierendes Streamlit-Dashboard mit CSV-Upload und Visualisierungen.
Der Prozess war jedoch deutlich mühsamer als erwartet.
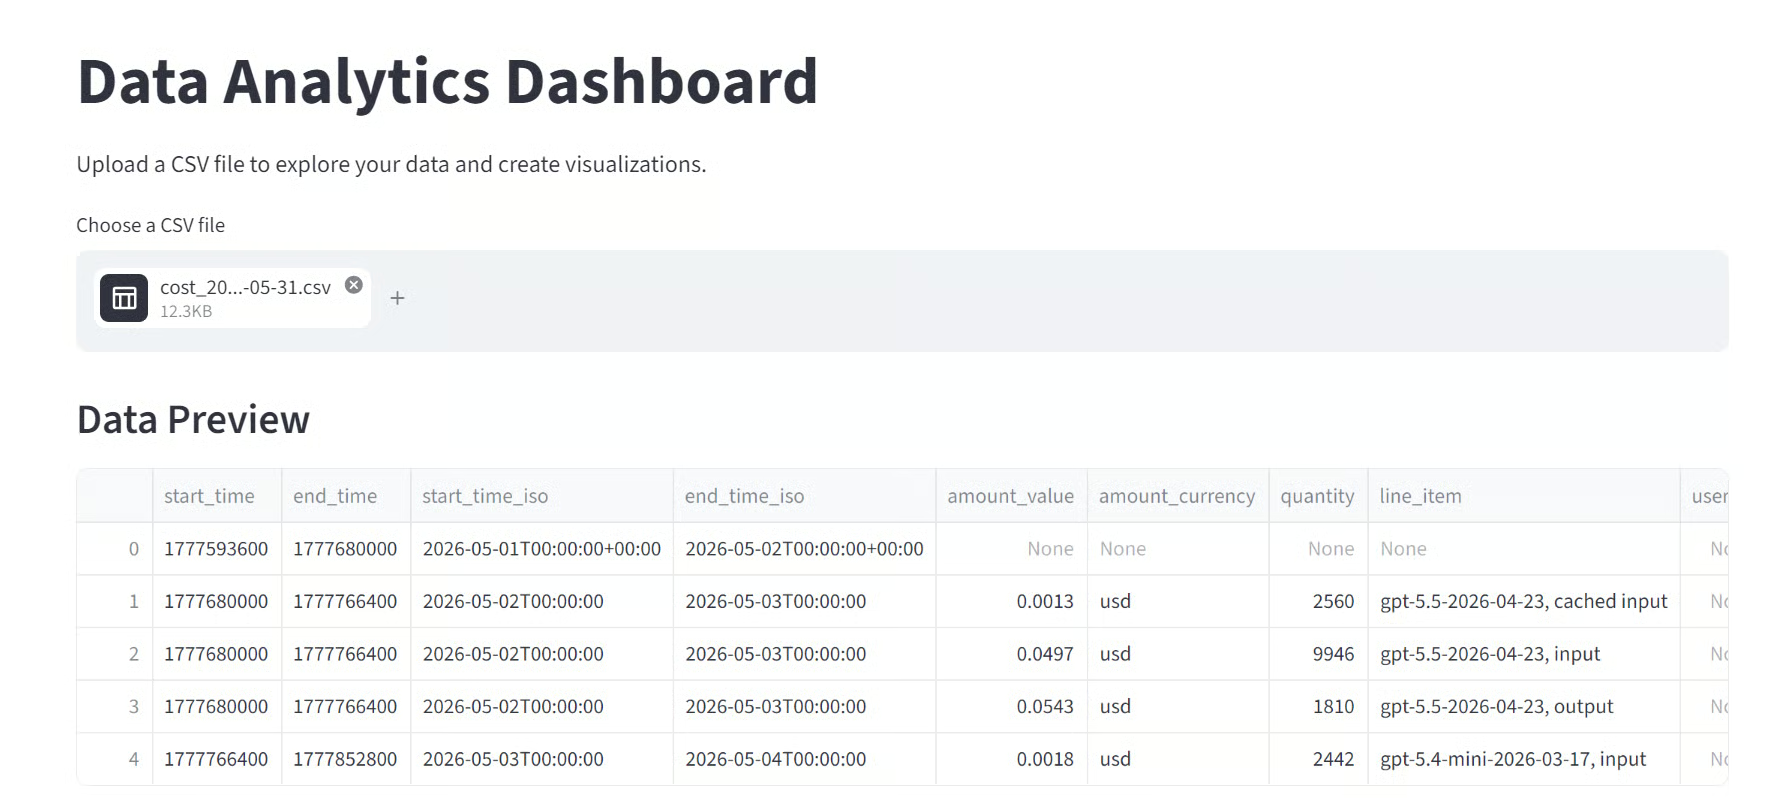
Es hatte wiederholt Schwierigkeiten mit Tool-Calls, Terminalbefehlen und dem Schreiben von Projektdateien.
Häufig setzte es nach der Planung den nächsten Schritt nicht um, sodass ich es durch Fehler hindurch lotsen und Befehle erneut ausführen lassen musste.
Ich konnte nicht klären, ob das am Modell, an der Pi-Integration, an lokalen Berechtigungen oder an einer Kombination dieser Punkte lag.
Nach rund 20 Minuten mit mehreren Versuchen lag ein funktionierendes Ergebnis vor. Für eine relativ einfache Streamlit-Aufgabe fühlte sich das zu langsam und unzuverlässig an.
Dieselbe Aufgabe dauerte in meinem separaten Test mit GLM 5.2 etwa eine Minute.
Ein 12B-Lokalmodell mit einem deutlich größeren Frontier-Modell zu vergleichen, ist nicht ganz fair.
Die Lücke war dennoch sichtbar.
Fable 5–Enhanced Gemma 4 kann polierten Code und starke Single-Turn-Ausgaben liefern, aber seine echte Agentik-Performance war in diesem Test inkonsistent. Es brauchte zu viel Eingriff für eine Aufgabe, die ein fähiger Coding-Agent schnell und eigenständig erledigen sollte.
Mein Fazit: Das Modell eignet sich für lokale Experimente, private Codegenerierung und leichte Workflows.
Für verlässliche mehrstufige Coding-Agent-Aufgaben würde ich es basierend auf diesem Test noch nicht einsetzen.
Dieser Guide ermöglicht einen einfachen Test des Modells, dennoch können je nach Hardware, lokaler Umgebung und llama.cpp-Build Probleme auftreten.
Wenn der Server beim Laden des MTP-Draft-Modells abstürzt und eine Fehlermeldung wie diese zeigt:
invalid vector subscriptkönnte das Problem eher an deinem llama.cpp-Build als an den Modelldateien liegen.
Im Modell-Repository wird berichtet, dass llama.cpp-Build b9553 mit dem Gemma 4 MTP-Draft-Modell funktioniert, während neuere Builds wie b9702 und b9717 beim Laden des Draft-Modells fehlschlagen können.
Als schnelle Notlösung entferne die MTP-Argumente aus dem Serverbefehl und starte nur das Hauptmodell. Das Modell funktioniert weiterhin korrekt, aber die Generierung kann langsamer sein.
Entferne diese Zeilen:
--model-draft "$MODEL_DIR/MTP/gemma-4-12B-it-MTP-Q8_0.gguf"
--spec-type draft-mtp
--spec-draft-n-max 2
-ngld 99Wenn du Token wie <|tool_call> oder <|channel> in der Antwort siehst, wendet der Client das native Tool-Call-Format von Gemma 4 nicht korrekt an.
Stelle sicher, dass dein Server-Befehl Folgendes enthält:
--jinjaStarte dann den Server neu. Dadurch wird das korrekte Chat-Template für Reasoning und strukturierte Tool-Calls angewendet.
Prüfe zuerst, ob der llama.cpp-Server noch läuft:
curl http://127.0.0.1:8910/v1/modelsDu solltest Fable5-Gemma4 in der Antwort sehen.
Stelle als Nächstes sicher, dass Pi auf Port 8910 zeigt und nicht auf den Standard-llama.cpp-Port 8080:
export LLAMA_BASE_URL="http://127.0.0.1:8910/v1"
pi
Führe beide Befehle in derselben Terminal-Session aus.
Starte Pi in einem beschreibbaren Projektverzeichnis:
cd /workspace/data-app
pi
Du kannst testen, ob im aktuellen Verzeichnis Dateien angelegt werden können:
touch write-test.txt && rm write-test.txtWenn dieser Befehl fehlschlägt, liegt ein Berechtigungsproblem im Workspace vor, nicht am Modell. Wechsle vor dem Start von Pi in ein beschreibbares Verzeichnis.
Wenn das Modell beginnt, Text, Zahlen oder Symbole zu wiederholen, prüfe die Sampling-Einstellungen in deinem Serverbefehl.
Verwende diese Werte:
--temp 1.0 \
--top-p 0.95 \
--top-k 64 \
--repeat-penalty 1.1
Die Wiederholungsstrafe ist besonders wichtig. Ohne sie kann das Modell wiederholte oder verstümmelte Ausgaben erzeugen.
Ein 256K-Kontextfenster benötigt einen großen KV-Cache. Wenn dem Server der VRAM ausgeht, reduziere zuerst die Kontextgröße:
--ctx-size 32768Du kannst auch das MTP-Draft-Modell deaktivieren, um VRAM freizugeben. Prüfe die aktuelle GPU-Speicherauslastung mit:
nvidia-smiDas Modell kann starken Code generieren, hat aber womöglich dennoch Mühe, längere Aufgaben ohne Eingriff abzuschließen. In meinen Tests plante es teils korrekt, scheiterte jedoch beim Ausführen von Befehlen, Schreiben von Dateien oder beim Fortsetzen nach Fehlern.
Für bessere Ergebnisse teile große Anforderungen in kleinere Schritte auf:
So gibst du dem Modell pro Schritt ein kleineres Ziel und erkennst leichter, ob ein Fehler am Modell, an Pi, am Server oder an Berechtigungen liegt.
Meiner Ansicht nach ist der Hype um dieses Modell nicht voll gerechtfertigt – zumindest basierend auf meinen Tests. Mit und ohne MTP hatte ich bei allgemeinen Aufgaben nahezu die gleiche Geschwindigkeit. Bei Coding-Aufgaben half MTP, und ich sah etwa 20 bis 30 % Speedup. Das ist nützlich, löst aber nicht das größere Problem: Zuverlässigkeit.
Ich habe das Modell auch in der WebUI getestet.
Manchmal hörte es beim Schreiben von Code für eine Datei ohne erkennbaren Grund einfach auf. Als ich um Fortsetzung bat, schrieb es die Fortsetzung als Text in die nächste Chat-Antwort, statt die Datei wirklich weiterzuführen.
Mir fiel auch auf, dass das Aktivieren von Thinking die Ausgabe teils verschlechterte – was überrascht hat.
Ich habe es außerdem mit Claude Code getestet – das war noch frustrierender.
Das Modell erstellte immer wieder Zusatz- und temporäre Dateien sowie anderes Irrelevantes, das ein simples Projekt nicht braucht. Am Ende war die Aufgabe erledigt, aber mit zu viel Anleitung und zu viel Zeitaufwand.
Mir ist klar, dass der Vergleich eines 12B-Lokalmodells mit GPT-5.5 oder GLM 5.2 nicht ganz fair ist. Aber selbst im Vergleich mit kleineren lokalen Modellen war ich nicht beeindruckt.
Aus meiner Erfahrung ist Qwen3.6 27B für Coding- und Agentik-Aufgaben deutlich besser, auch wenn es größer ist.
Aktuell sehe ich dieses Modell eher als interessantes Experiment denn als verlässlichen Coding-Agenten.
Spannender finde ich das kommende, Fable-getunte Qwen3.6 27B-Modell desselben Erstellers. Auch von anderen Open-Source-Mitwirkenden gab es ähnliche destillierte Coding-Modelle, aber bislang habe ich keinen großen Sprung bei echten Coding-Agent-Aufgaben gesehen.
Das Modell kann gut aussehenden Code und polierte Single-Turn-Ausgaben erzeugen. Aber wenn du es wie einen Agenten arbeiten lässt, Tools verwendest, Dateien erstellst, Fehler behebst und das Ergebnis prüfst, fühlt es sich noch inkonsistent und frustrierend an.
Top-DataCamp-Kurse
Kurs
Kurs
Lernpfad
Blog
Hesam Sheikh Hassani
15 Min.
Blog
Zoumana Keita
15 Min.
Blog
Tutorial
Laiba Siddiqui
6 Min.
Tutorial
Mark Pedigo
10 Min.
Tutorial
Kurtis Pykes
15 Min.