Curso
Programación asistida por IA avanzada para desarrolladores
1 h 30 min
1.8K
Tras el cierre de Fable 5 y Mythos 5, la comunidad open source empezó a experimentar con modelos locales más pequeños entrenados con datos sintéticos de alta calidad para programación y comportamiento agente. Fable 5-Enhanced Gemma 4 es un buen ejemplo.
Se trata de un fine-tune de Gemma 4 12B entrenado con conjuntos de datos generados por Fable 5 y Composer 2.5. El objetivo es transferir comportamientos útiles de programación y de agente a un modelo más pequeño que puedas ejecutar en local.
Su entrenamiento se centra en flujos de trabajo prácticos: entender una tarea, leer archivos, usar herramientas, editar código, ejecutar comandos y verificar el resultado final.
En esta guía, te muestro cómo ejecutar en local el modelo Fable 5-Enhanced Gemma 4 en una RTX 5070 Ti usando llama.cpp.
Instalaremos llama.cpp, descargaremos el modelo GGUF y el modelo borrador MTP, lanzaremos un servidor local compatible con OpenAI y lo probaremos con cURL y la WebUI integrada.
Por último, conectaremos el modelo a Pi Coding Agent y le daremos una tarea real de programación. La gran pregunta es si este modelo compacto de 12B puede ofrecer un comportamiento útil como agente de código y competir con modelos locales más grandes como Qwen 3.6 27B o Gemma 4 31B.
Fable 5-Enhanced Gemma 4 es un modelo compacto para programación y tareas de agente basado en el modelo de instrucciones Gemma 4 12B de Google. Lo creó Yuxin Lu y se publicó en formato GGUF para uso local con llama.cpp y otras herramientas compatibles.
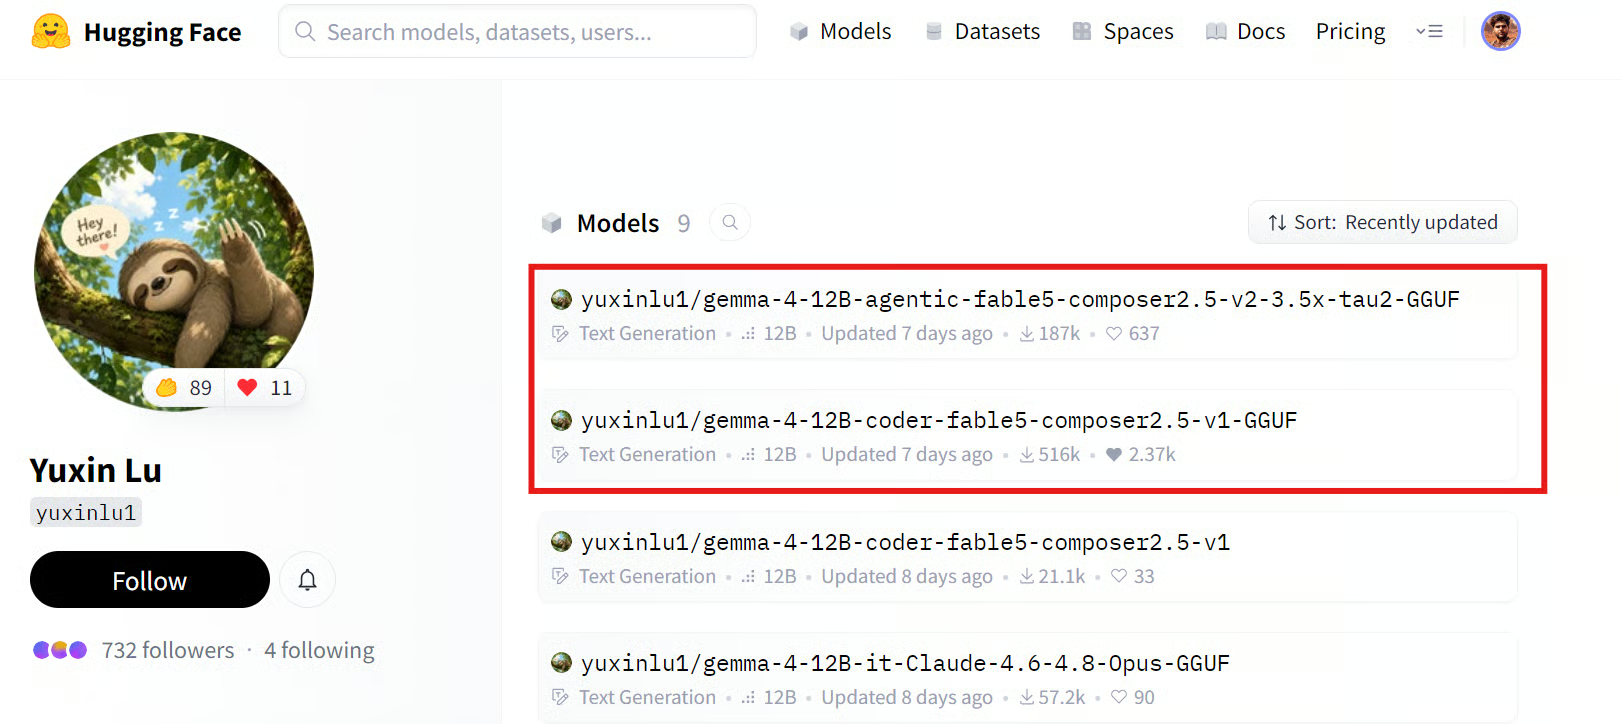
Fuente: yuxinlu1 (Yuxin Lu)
Esta guía usa la versión v2. Continúa la línea del modelo de código v1 pero con un enfoque más marcado en trabajo técnico como agente.
En lugar de limitarse a generar código, está diseñado para inspeccionar archivos, razonar sobre problemas, usar herramientas, editar código, ejecutar comandos y validar el resultado final.
El modelo original se afinó con datos verificados de programación en Python generados por Composer 2.5 y Fable 5.
El conjunto principal usa trazas de razonamiento de Composer 2.5 y soluciones de código para tareas de Python con tests deterministas. Solo se conservaron los ejemplos cuyo código generado superó las pruebas.
Fable 5 se utilizó para las tareas más difíciles donde Composer 2.5 fallaba. Generó un proceso de razonamiento nuevo y soluciones corregidas para esos ejemplos, que también se verificaron por ejecución antes de añadirlos al entrenamiento.
En v2, el modelo añade trayectorias de terminal y uso de herramientas en varios pasos. Así aprende a seguir un flujo de leer, razonar, actuar y verificar en lugar de dar una respuesta y parar.
Después de que Fable 5 dejara de estar disponible, algunas trazas de razonamiento al estilo Fable 5 que faltaban se reconstruyeron con Opus 4.8.
--jinja activado en llama.cpp para que el modelo use la plantilla de chat y el formato de tool-calls previstos en Gemma 4.En una comparativa local con tau2-bench (telecom), el modelo v2 alcanzó alrededor de 55%, frente a aproximadamente un 15% del modelo base Gemma 4 12B de instrucciones.
Esto sugiere que la mejora principal viene del comportamiento como agente. El modelo afinado es mejor inspeccionando una tarea, ejecutando la siguiente acción, usando herramientas y verificando resultados, en lugar de detenerse tras una primera respuesta.
Es la forma más rápida y sencilla de instalar llama.cpp en una máquina Linux. En lugar de clonar el repositorio y compilar desde fuente, el instalador descarga un binario precompilado y lo deja listo.
Ejecuta este comando en tu terminal:
curl -LsSf https://llama.app/install.sh | shEn pocos segundos, el instalador descargará el binario de llama.cpp y completará la configuración.
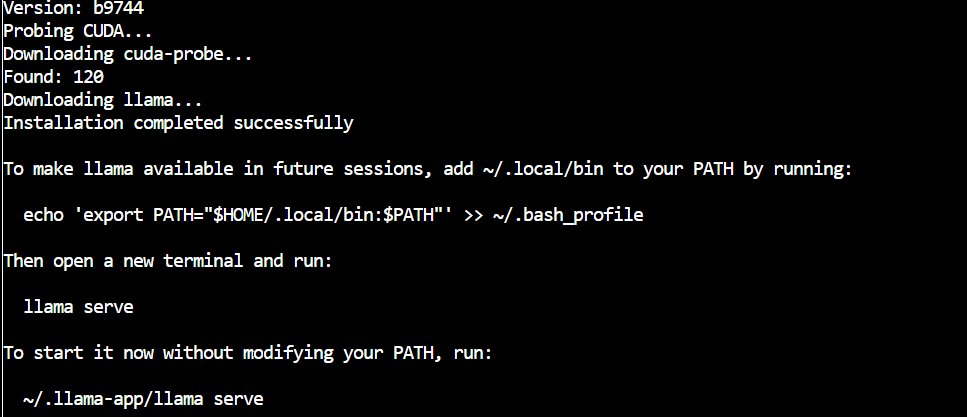
Ahora añade llama.cpp a tu PATH para poder ejecutar el comando llama desde cualquier directorio, incluso tras reiniciar la terminal:
echo 'export PATH="$HOME/.local/bin:$PATH"' >> ~/.bashrc
source ~/.bashrc
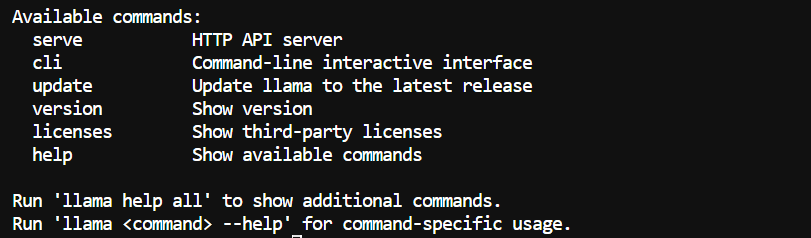
Por último, verifica que la instalación ha funcionado:
llama helpDeberías ver ahora los comandos disponibles de llama.cpp.
A continuación, instala la CLI de Hugging Face y hf-xet. Así podrás descargar los archivos del modelo directamente desde Hugging Face, incluidos repos que usan almacenamiento Xet para ficheros grandes.
pip install -U "huggingface_hub[cli]" hf-xet Crea un directorio para los archivos del modelo:
MODEL_DIR="/workspace/Fable5-Gemma4"
mkdir -p "$MODEL_DIR"
Activa las descargas rápidas de Xet y baja solo los archivos necesarios para esta guía:
export HF_XET_HIGH_PERFORMANCE=1


hf download \
  yuxinlu1/gemma-4-12B-agentic-fable5-composer2.5-v2-3.5x-tau2-GGUF \
  --include "gemma4-v2-Q4_K_M.gguf" \
  --include "MTP/gemma-4-12B-it-MTP-Q8_0.gguf" \
  --local-dir "$MODEL_DIR"
Esto descargará dos archivos:
gemma4-v2-Q4_K_M.gguf, el modelo principal Fable 5-Enhanced Gemma 4.MTP/gemma-4-12B-it-MTP-Q8_0.gguf, el modelo borrador que usaremos después para la decodificación especulativa MTP.El modelo Q4_K_M pesa unos 7 GB. El tiempo de descarga dependerá de tu conexión, pero usar Xet puede mejorar la transferencia de modelos grandes.
Una vez completado, tus archivos deberían estar aquí:
/workspace/Fable5-Gemma4Inicia ahora el servidor local con el modelo principal y el borrador MTP:
MODEL_DIR="/workspace/Fable5-Gemma4"

llama serve \
  --model "$MODEL_DIR/gemma4-v2-Q4_K_M.gguf" \
  --alias Fable5-Gemma4 \
  --model-draft "$MODEL_DIR/MTP/gemma-4-12B-it-MTP-Q8_0.gguf" \
  --spec-type draft-mtp \
  --spec-draft-n-max 2 \
  -ngl 99 \
  -ngld 99 \
  --ctx-size 262144 \
  --parallel 1 \
  --cache-type-k q8_0 \
  --cache-type-v q8_0 \
  --flash-attn on \
  --jinja \
  --temp 1.0 \
  --top-p 0.95 \
  --top-k 64 \
  --repeat-penalty 1.1 \
  --host 0.0.0.0 \
  --port 8910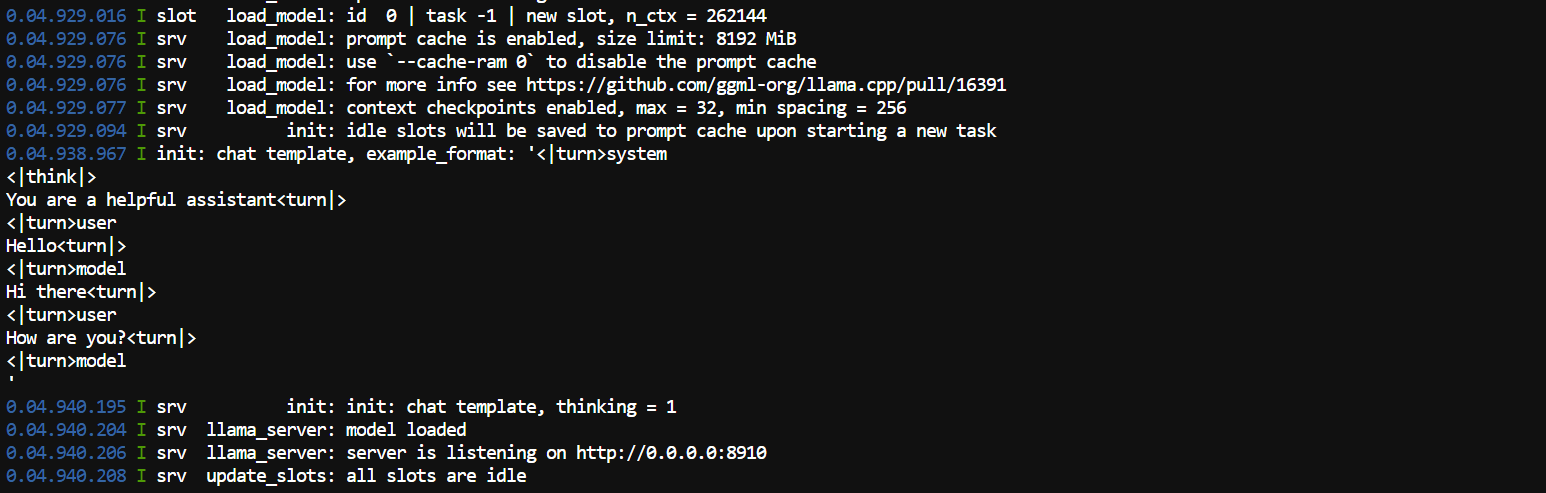
El argumento --model-draft carga el modelo borrador MTP.
MTP significa Multi Token Prediction. El modelo borrador, más pequeño, predice primero algunos tokens siguientes y el modelo principal los verifica en paralelo. Esto puede mejorar la velocidad de generación sin cambiar el papel del modelo principal.
--spec-type draft-mtp habilita esta configuración de decodificación especulativa MTP. --spec-draft-n-max 2 permite que el borrador proponga hasta dos tokens a la vez. Dos es un buen punto de partida: valores mayores no siempre aumentan la velocidad.
-ngl 99 mueve el modelo principal a la GPU, mientras que -ngld 99 hace lo mismo con el borrador MTP. El valor 99 indica que se descarguen todas las capas posibles en la GPU.
--ctx-size 262144 establece una ventana de contexto máxima de 256K tokens. Es útil para bases de código grandes y sesiones largas de terminal, pero también requiere más VRAM. --parallel 1 reserva todo el contexto para una solicitud activa en lugar de repartirlo entre varios usuarios.
Los ajustes Q8 de la KV-cache reducen la memoria necesaria para la ventana de contexto larga. --flash-attn on optimiza los cálculos de atención, especialmente con prompts largos.
Mantén --jinja activado. Aplica la plantilla de chat nativa del modelo para que los prompts, el razonamiento y las llamadas a herramientas tengan el formato correcto.
El resto de parámetros de muestreo controlan cómo genera texto el modelo. --temp 1.0, --top-p 0.95 y --top-k 64 permiten respuestas variadas, mientras que --repeat-penalty 1.1 ayuda a reducir repeticiones.
Con el servidor cargado, abre la WebUI:
http://localhost:8910 También puedes comprobar el uso de la GPU desde otra terminal:
nvidia-smi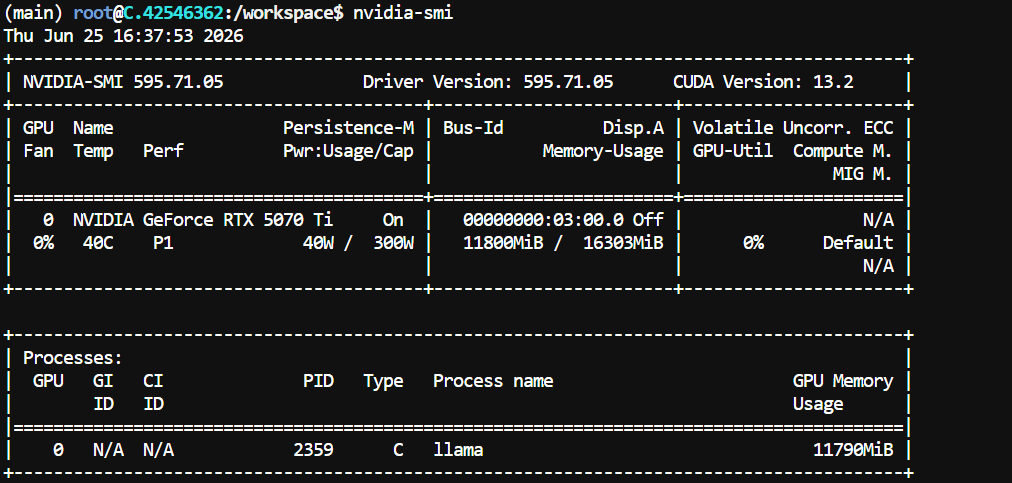
En mi RTX 5070 Ti, el modelo usó unos 11,8 GB de VRAM con el contexto de 256K, dejando más de 4 GB libres.
Tu consumo puede variar según la build de llama.cpp, el driver de la GPU y la configuración de contexto.
Deja la terminal de llama serve ejecutándose y abre una tercera terminal para probar la API local.
curl http://127.0.0.1:8910/v1/messages \
  -H "Content-Type: application/json" \
  -d '{
    "model": "Fable5-Gemma4",
    "max_tokens": 512,
    "messages": [
      {
        "role": "user",
        "content": "Create a simple Python script that prints Hello, I am running locally! "
      }
    ]
  }'
La respuesta debería incluir el texto generado por el modelo junto con su salida de razonamiento. En esta prueba, el modelo devolvió el siguiente código en Python:
print("Hello, I am running locally!")Una respuesta en JSON confirma que el servidor local funciona correctamente. En mi prueba rápida, el modelo generó a unos 54 tokens por segundo.
También puedes usar la interfaz de chat integrada. Abre esta dirección en tu navegador:
http://localhost:8910La WebUI funciona como una app de chat normal. Selecciona el modelo Fable5-Gemma4, escribe un prompt y envíalo al servidor local.
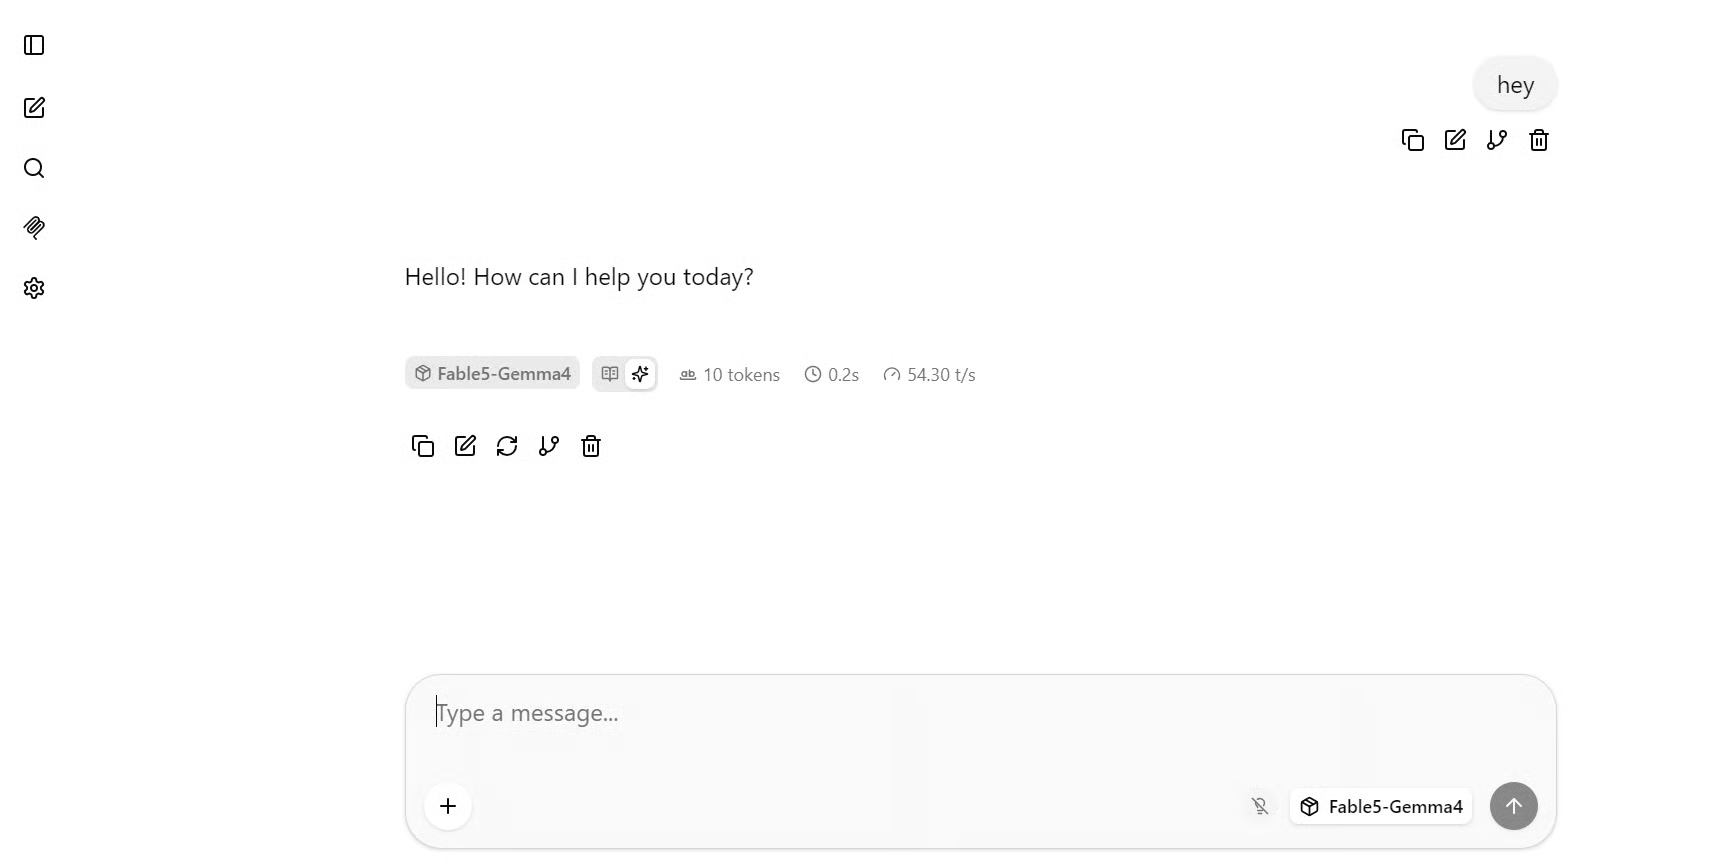
Para una prueba de código más extensa, usa este prompt:
Create a calming, premium spa treatment center website in one self-contained HTML file
with all CSS and JavaScript included inline, elegant booking CTAs, treatment packages,
therapist profiles, testimonials, and high-quality spa imagery.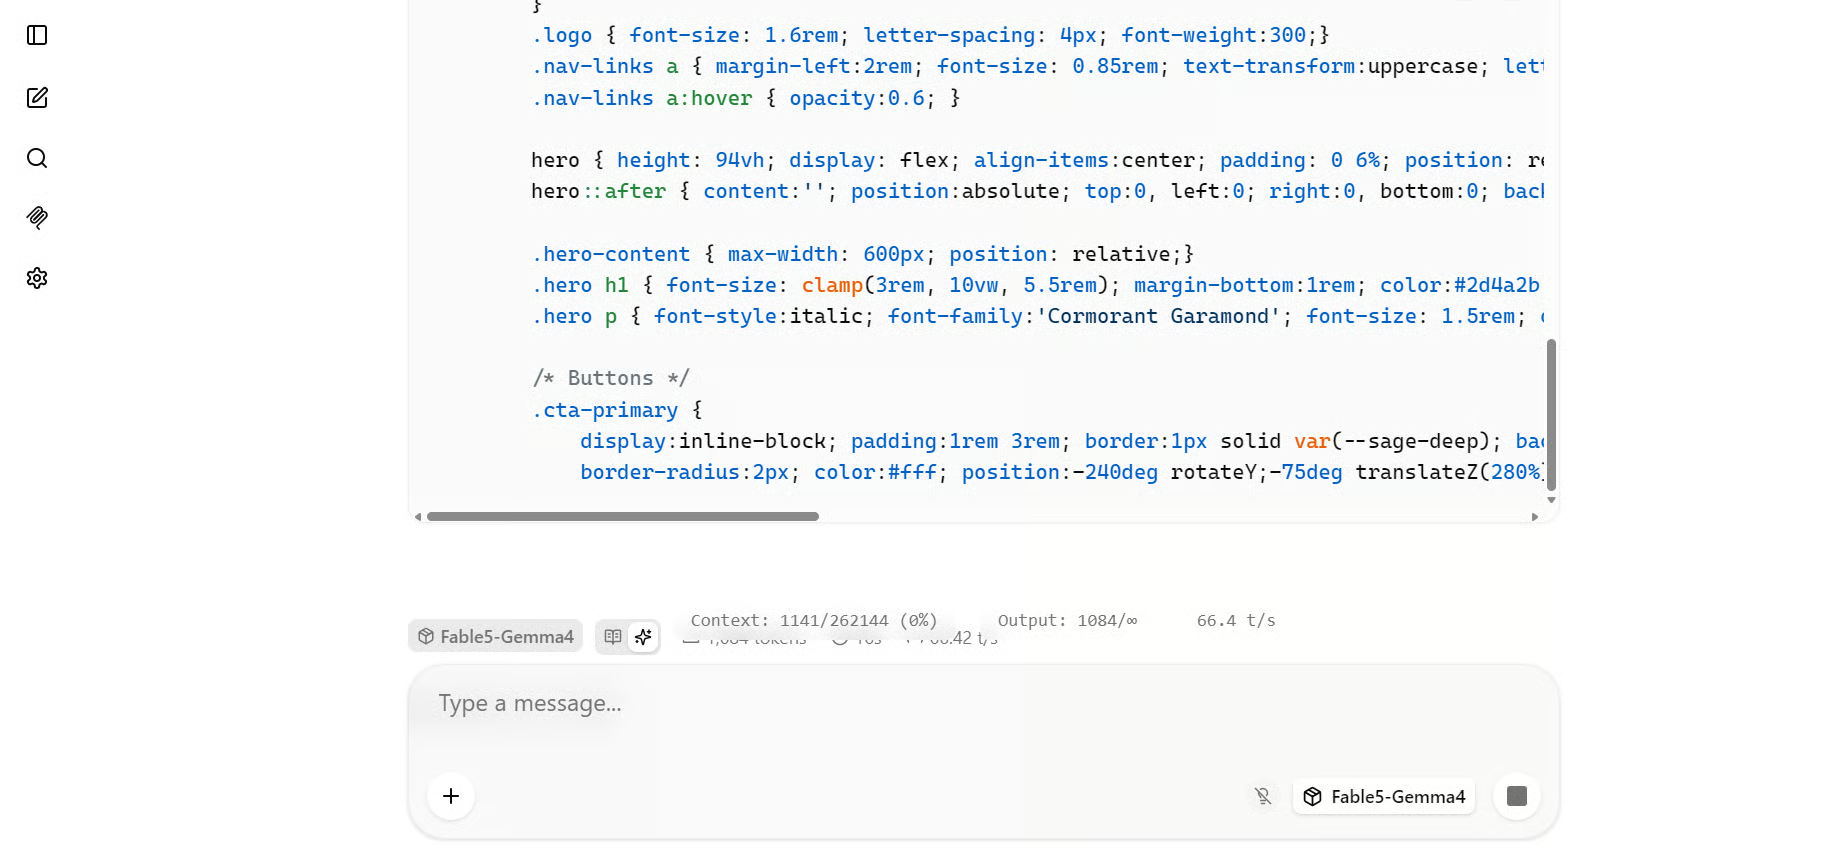
En esta tarea larga de generación de HTML, vi aproximadamente 66 a 70 tokens por segundo. En tareas largas de código, la decodificación especulativa puede rendir mejor porque el modelo genera una secuencia más continua y predecible de tokens.
El primer resultado se generó con el razonamiento en Medium. Creó una landing de spa limpia, con diseño minimalista, enlaces de navegación y un gran CTA de reserva.
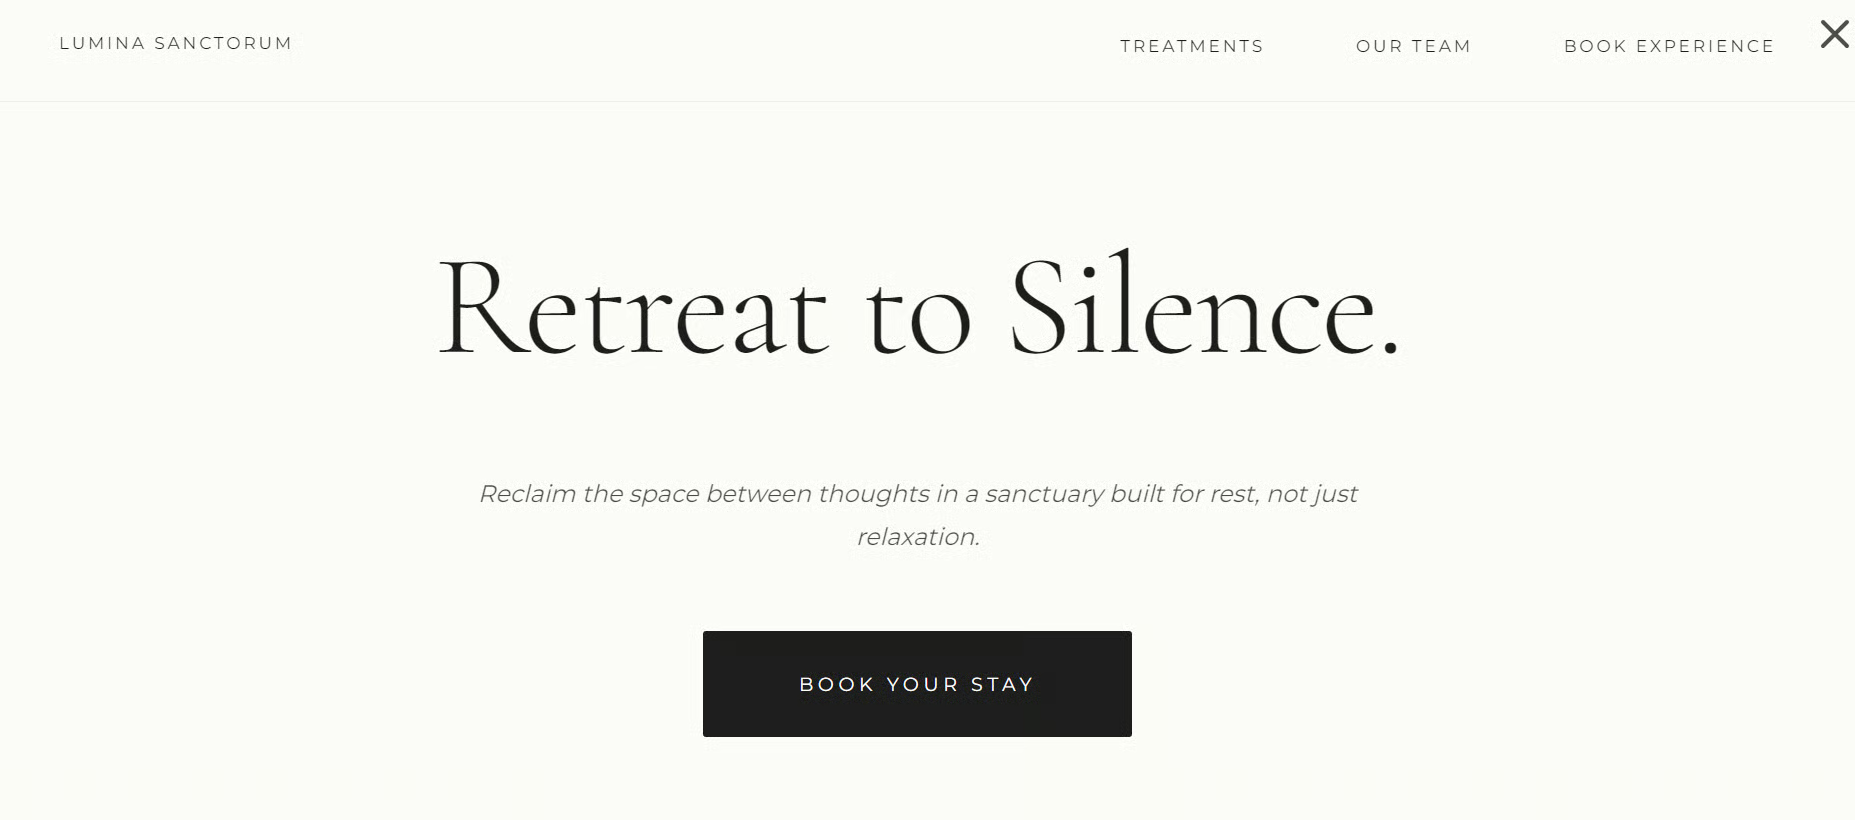
El segundo resultado se generó sin razonamiento. Produjo una línea visual diferente, con un titular más grande y un estilo de landing más editorial.
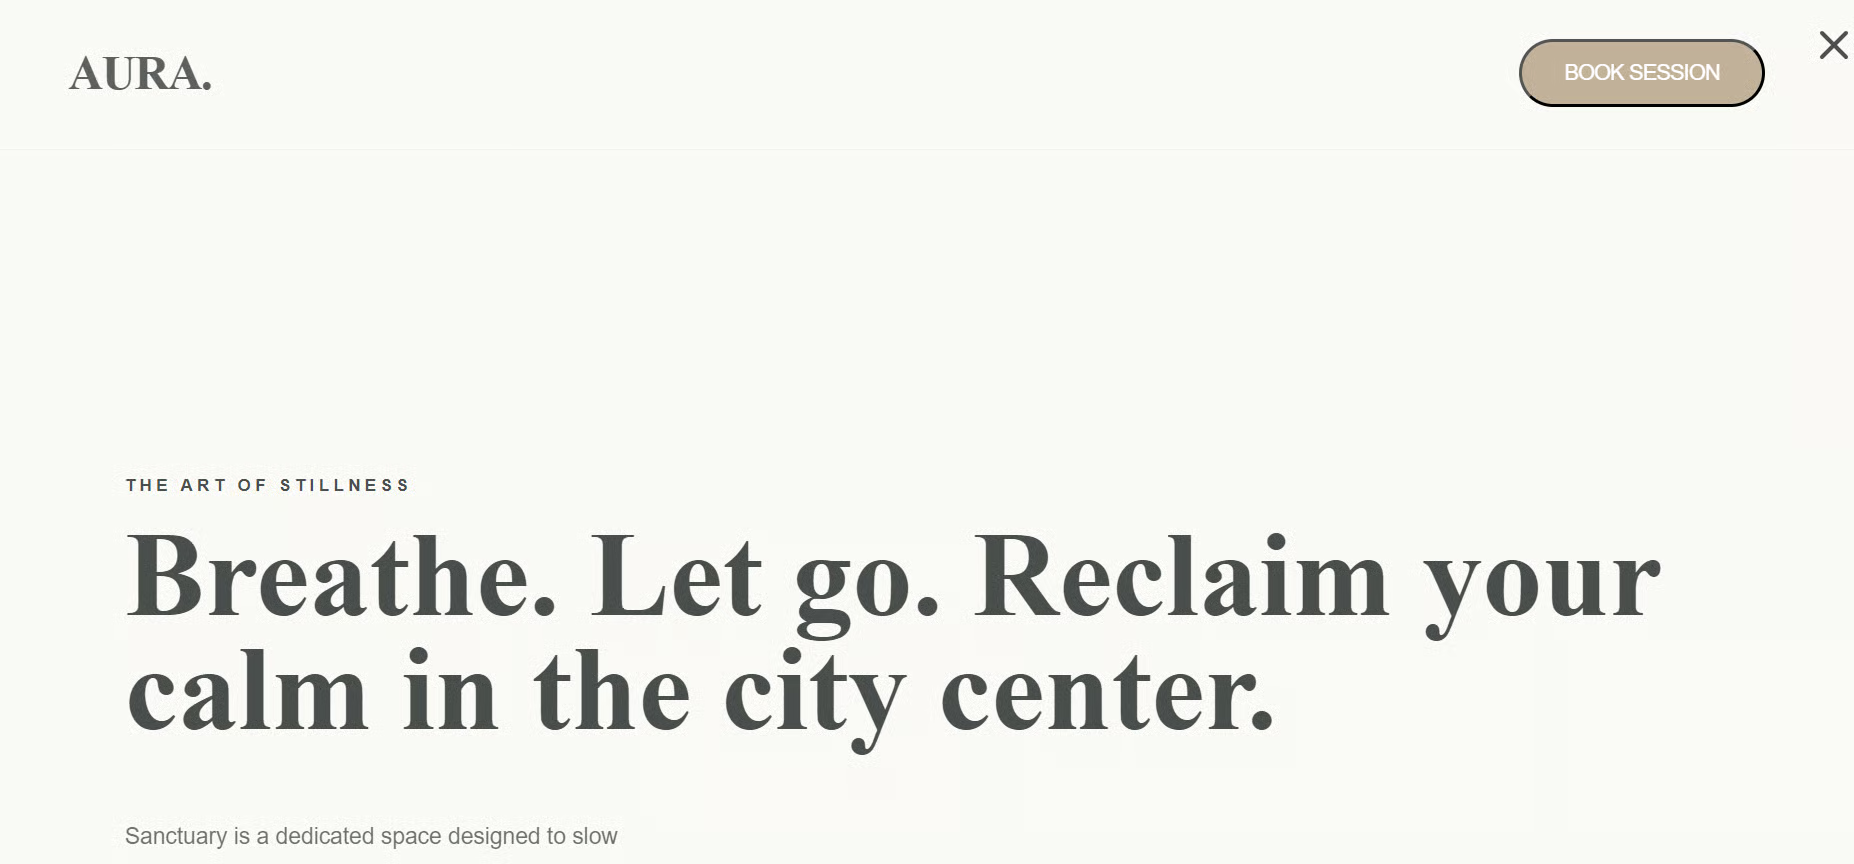
Ambos resultados se ven pulidos, pero con razonamiento activado el resultado fue más estructurado en esta prueba.
La velocidad de tokens puede variar según la longitud del prompt, el estilo de salida, la carga de la GPU y con qué frecuencia el modelo principal acepta los tokens propuestos por MTP.
Pi es un agente ligero de programación en terminal. Puede conectarse al servidor local de Fable 5-Enhanced Gemma 4 y usarlo para leer archivos, editar código, ejecutar comandos y completar tareas de programación.
Abre una cuarta terminal e instala Pi:
curl -fsSL https://pi.dev/install.sh | sh El instalador puede pedir instalar Node.js. Acepta y espera a que termine.
Recarga la configuración de tu terminal y confirma que Pi está disponible:
source ~/.bashrc
pi --version
Después, instala el plugin pi-llama:
pi install git:github.com/huggingface/pi-llamaEste plugin conecta Pi a un servidor llama.cpp en ejecución y detecta automáticamente los modelos locales disponibles.
Por defecto, el plugin busca llama.cpp en el puerto 8080. Nuestro servidor usa el puerto 8910, así que establece la dirección correcta antes de iniciar Pi:
export LLAMA_BASE_URL="http://127.0.0.1:8910/v1"Crea un nuevo directorio de proyecto, inicializa Git y arranca Pi:
mkdir -p /workspace/data-app
cd /workspace/data-app
git init
pi
Dentro de Pi, escribe:
/modelSelecciona el modelo “Fable5-Gemma4”.
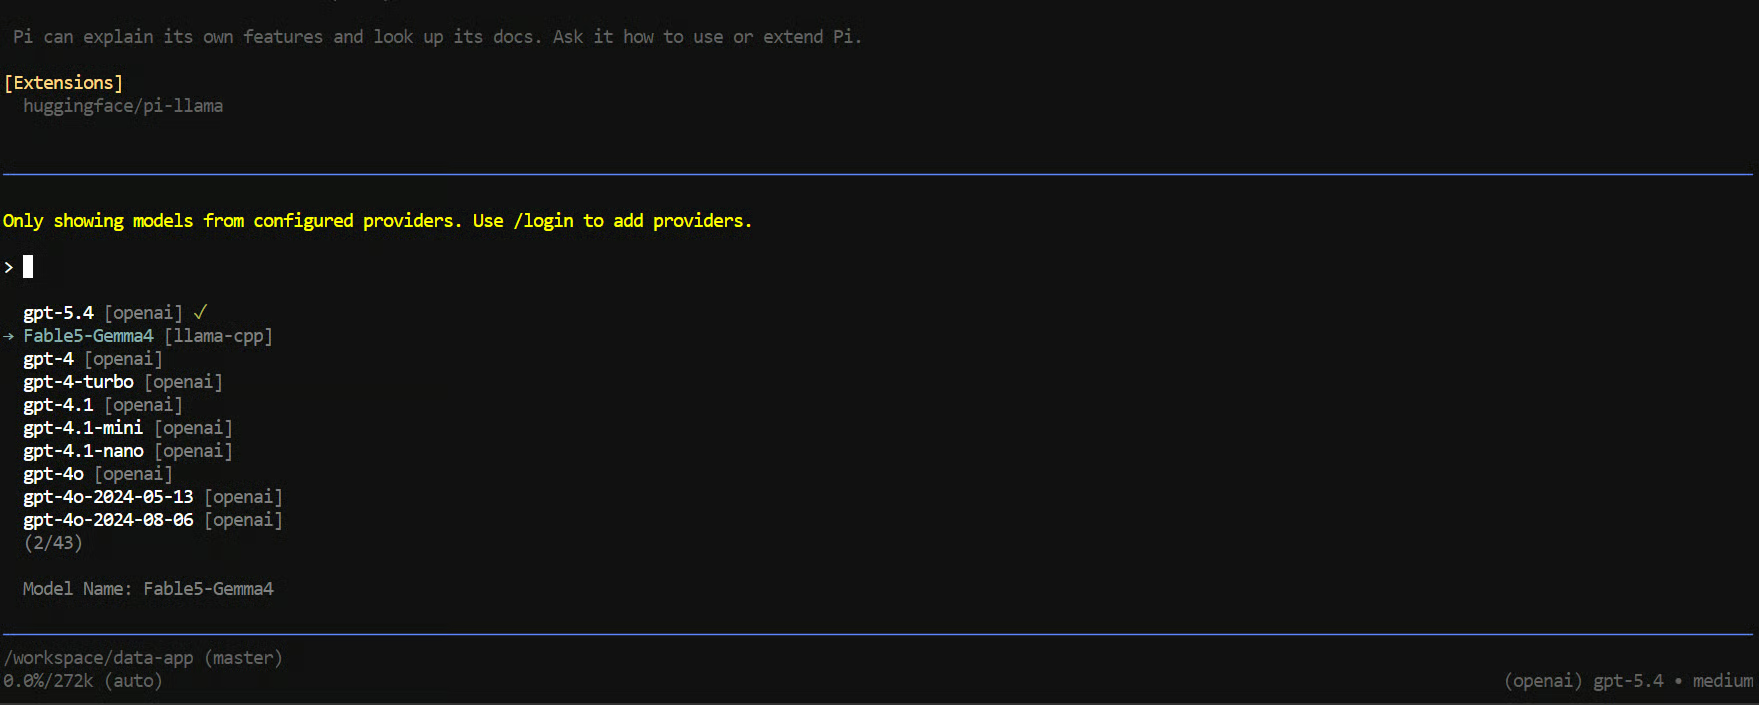
A continuación, dale una tarea práctica:
Create a simple data analytics dashboard using Streamlit that lets users
upload a CSV file, view the data, and explore clear visualizations.
Include a sample CSV file and test the full app to make sure it works correctly.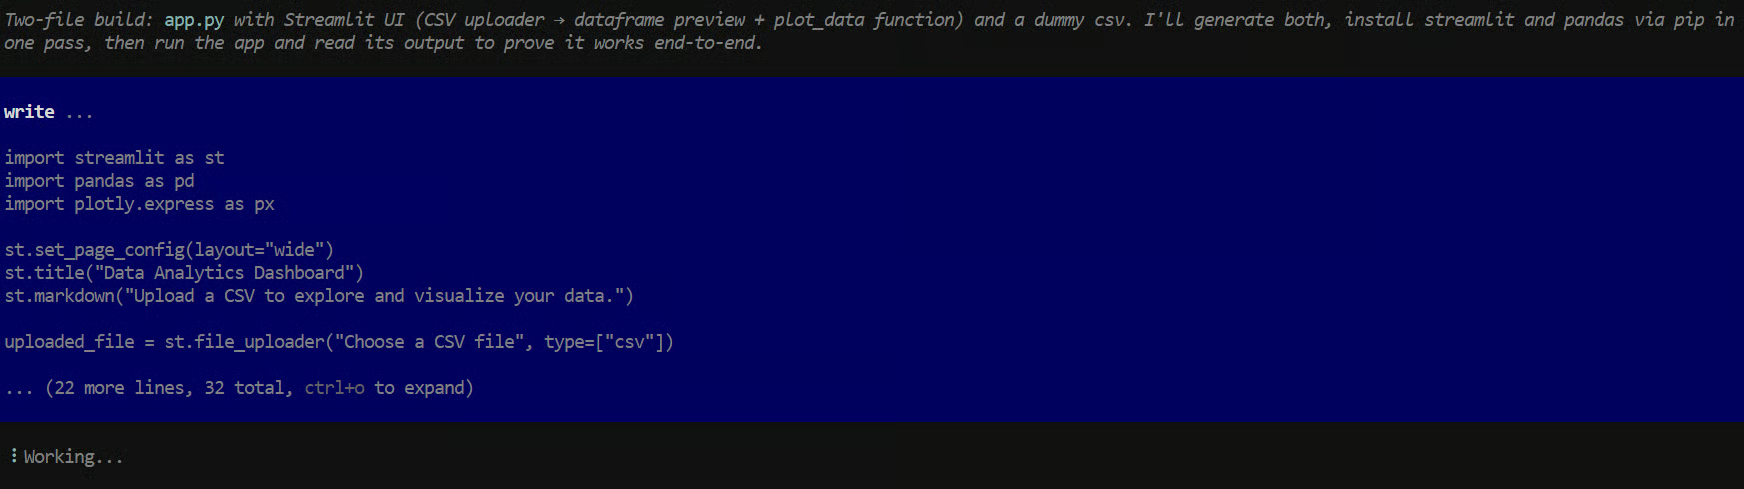
El modelo acabó creando un panel en Streamlit funcional, con carga de CSV y visualizaciones.
Sin embargo, el proceso fue bastante más complicado de lo esperado.
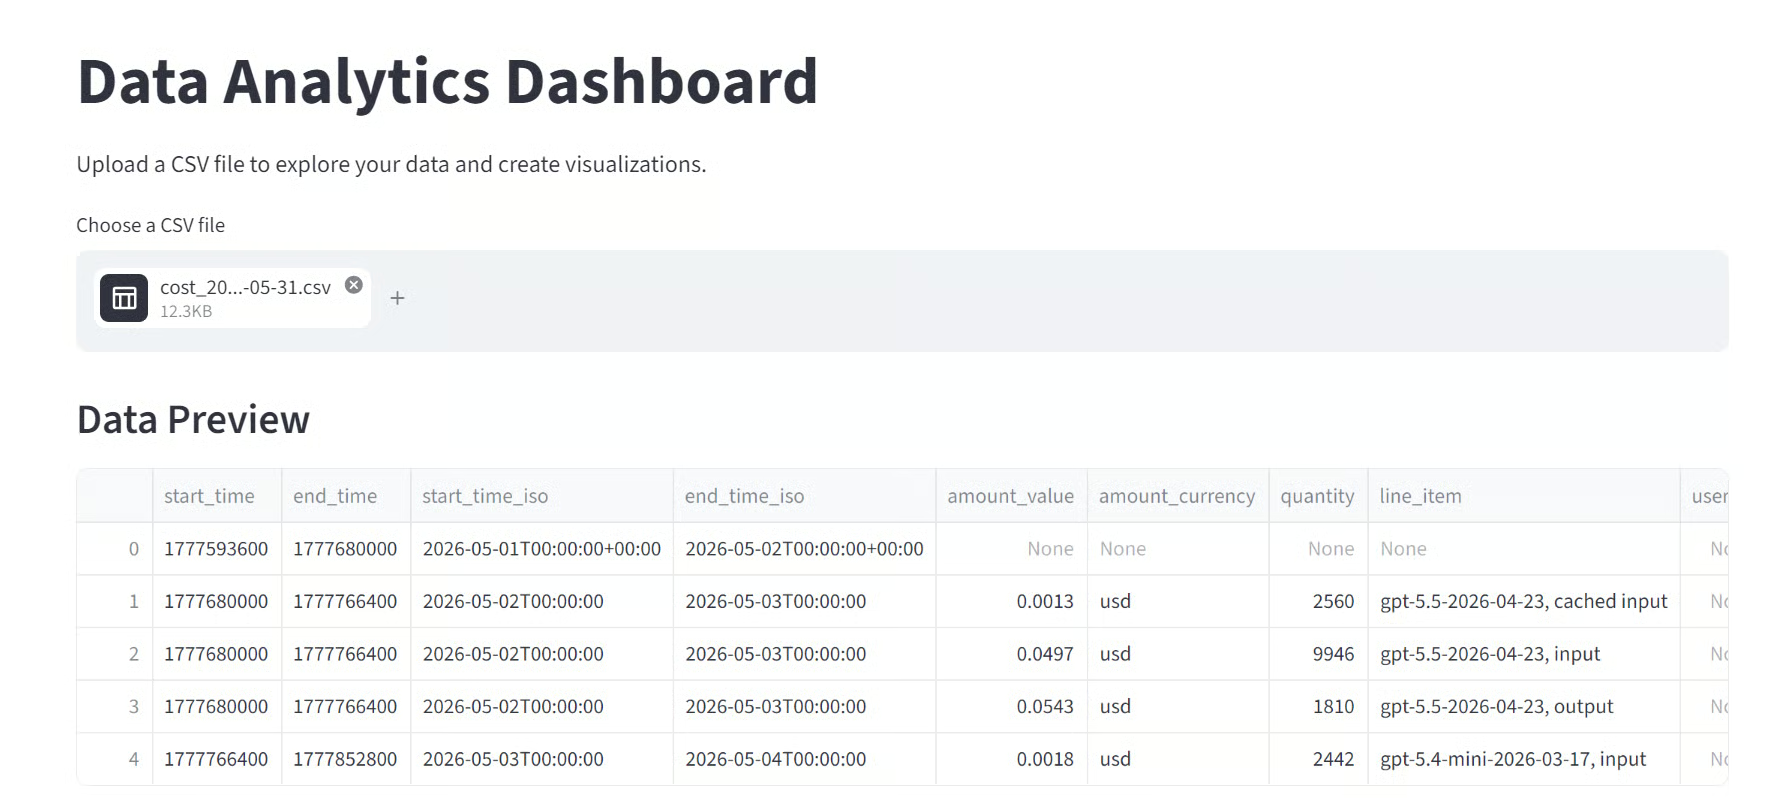
Tuvo problemas repetidos con las llamadas a herramientas, los comandos de terminal y la escritura de archivos del proyecto.
A menudo no completaba la siguiente acción tras planearla, así que tuve que ir guiándolo entre errores y reintentos.
No pude confirmar si era por el modelo, por la integración con Pi, por permisos locales o por una mezcla de todo.
Tras unos 20 minutos de reintentos, generó un resultado funcional. Para una tarea relativamente simple en Streamlit, resultó demasiado lento e inestable.
La misma tarea me llevó alrededor de un minuto con GLM 5.2 en otra prueba aparte.
No es del todo justo comparar un modelo local de 12B con un modelo mucho más grande de primera línea.
Aun así, la diferencia fue evidente.
Fable 5-Enhanced Gemma 4 puede producir código pulido y respuestas sólidas en una sola interacción, pero su rendimiento real como agente fue inconsistente en esta prueba. Necesitó demasiada intervención para una tarea que un agente competente debería completar rápido y en autonomía.
Mi conclusión es que el modelo resulta interesante para experimentar en local, generar código en privado y flujos ligeros.
Pero, según esta prueba, aún no confiaría en él para tareas fiables de agente de código en varios pasos.
Aunque esta guía propone una forma sencilla de probar el modelo, podrías encontrar problemas según tu hardware, tu entorno local y la build de llama.cpp.
Si el servidor se cae al cargar el borrador MTP y muestra un error como:
invalid vector subscriptPuede deberse a tu build de llama.cpp y no a los archivos del modelo.
El repo del modelo indica que la build b9553 de llama.cpp funciona con el borrador MTP de Gemma 4, mientras que builds más recientes como b9702 y b9717 pueden fallar al cargar el borrador.
Como alternativa rápida, elimina los argumentos de MTP del comando del servidor y ejecuta solo el modelo principal. Seguirá funcionando, pero la generación puede ser más lenta.
Elimina estas líneas:
--model-draft "$MODEL_DIR/MTP/gemma-4-12B-it-MTP-Q8_0.gguf"
--spec-type draft-mtp
--spec-draft-n-max 2
-ngld 99Si ves tokens como <|tool_call> o <|channel> en la respuesta, el cliente no está aplicando correctamente el formato nativo de llamadas a herramientas de Gemma 4.
Asegúrate de que tu comando del servidor incluye:
--jinjaDespués reinicia el servidor. Esto aplica la plantilla de chat correcta para el razonamiento del modelo y sus tool-calls estructurados.
Primero, comprueba que el servidor de llama.cpp sigue ejecutándose:
curl http://127.0.0.1:8910/v1/modelsDeberías ver Fable5-Gemma4 en la respuesta.
Luego, asegúrate de que Pi apunta al puerto 8910 en lugar del puerto por defecto 8080 de llama.cpp:
export LLAMA_BASE_URL="http://127.0.0.1:8910/v1"
pi
Ejecuta ambos comandos en la misma sesión de terminal.
Inicia Pi dentro de un directorio de proyecto con permisos de escritura:
cd /workspace/data-app
pi
Puedes comprobar si el directorio actual permite crear archivos:
touch write-test.txt && rm write-test.txtSi este comando falla, el problema son los permisos del espacio de trabajo y no el modelo. Muévete a un directorio con escritura antes de lanzar Pi.
Si el modelo empieza a repetir texto, números o símbolos, revisa los parámetros de muestreo en tu comando del servidor.
Usa estos valores:
--temp 1.0 \
--top-p 0.95 \
--top-k 64 \
--repeat-penalty 1.1
La penalización por repetición es especialmente importante. Sin ella, el modelo puede producir salida repetitiva o confusa.
Una ventana de contexto de 256K requiere una KV-cache grande. Si el servidor se queda sin VRAM, reduce primero el tamaño de contexto:
--ctx-size 32768También puedes desactivar el modelo borrador MTP para liberar VRAM. Consulta el uso actual de memoria de la GPU con:
nvidia-smiEl modelo puede generar buen código, pero aún puede tener dificultades para completar tareas largas sin intervención. En mis pruebas, a veces planeaba las acciones correctas pero fallaba al ejecutar comandos, escribir archivos o continuar tras un error.
Para mejores resultados, divide las solicitudes grandes en tareas pequeñas:
Así le das al modelo un objetivo más acotado en cada paso y es más fácil detectar si el fallo viene del modelo, de Pi, del servidor o de los permisos del espacio de trabajo.
No creo que el hype en torno a este modelo esté del todo justificado, al menos según mis pruebas. Con y sin MTP, obtuve prácticamente la misma velocidad en tareas generales. En tareas de código, MTP sí ayudó y vi un aumento de velocidad del 20% al 30%. Es útil, pero no arregla el mayor problema: la fiabilidad.
También lo probé en la WebUI.
A veces, al escribir el código de un archivo, simplemente se detenía sin motivo claro. Cuando le pedía continuar, escribía la continuación como texto en el siguiente mensaje del chat en lugar de seguir el archivo.
También noté que activar el razonamiento a veces empeoraba la salida, lo cual sorprendió.
Lo probé también con Claude Code y la experiencia fue aún más frustrante.
El modelo creaba archivos extra, temporales y otras cosas irrelevantes que un proyecto simple no necesitaba. Al final completó la tarea, pero requirió demasiada guía y demasiado tiempo.
Sé que no es del todo justo comparar un modelo local de 12B con GPT-5.5 o GLM 5.2. Pero incluso frente a modelos locales más pequeños, no me convenció.
En mi experiencia, Qwen3.6 27B es mucho mejor para programación y tareas de agente, aunque sea más grande.
Por ahora, veo este modelo más como un experimento interesante que como un agente de código fiable.
También me interesa más el próximo modelo Qwen3.6 27B afinado con Fable del mismo creador. He visto a otras personas de la comunidad open source publicar modelos destilados similares para programación, pero de momento no he visto una mejora grande en tareas reales de agente.
El modelo puede generar código con buena apariencia y salidas pulidas en un solo turno. Pero cuando le pides que actúe como agente, use herramientas, cree archivos, solucione errores y verifique el resultado, sigue siendo inconsistente y frustrante de usar.
Top DataCamp Courses
Curso
Curso
Programa
blog
Abid Ali Awan
9 min
Tutorial
Zoumana Keita
15 min
Tutorial
Moez Ali
11 min
Tutorial
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Moez Ali
9 min