Kurs
Geliştiriciler için İleri Seviye AI Destekli Kodlama
1 sa 30 dk
1.8K
Fable 5 ve Mythos 5 kapatıldıktan sonra, açık kaynak geliştiricileri yüksek kaliteli sentetik kodlama ve aracısal (agentic) verilerle eğitilmiş daha küçük yerel modelleri denemeye başladı. Fable 5-Enhanced Gemma 4 buna bir örnektir.
Bu, Fable 5 ve Composer 2.5 tarafından üretilen veri kümeleri üzerinde eğitilmiş bir Gemma 4 12B ince ayarıdır. Amaç, kullanışlı kodlama ve aracısal davranışları yerelde çalışabilen daha küçük bir modele aktarmaktır.
Eğitimi; bir görevi anlama, dosya okuma, araç kullanma, kod düzenleme, komut çalıştırma ve nihai sonucu doğrulama gibi pratik iş akışlarına odaklanır.
Bu rehberde, llama.cpp kullanarak RTX 5070 Ti üzerinde Fable 5-enhanced Gemma 4 modelini yerelde nasıl çalıştıracağınızı göstereceğim.
llama.cpp’yi kuracağız, GGUF modeli ve MTP taslak modelini indireceğiz, OpenAI uyumlu yerel bir sunucu başlatacağız ve cURL ile yerleşik WebUI üzerinden test edeceğiz.
Son olarak modeli Pi Coding Agent’a bağlayıp gerçek bir kodlama görevi vereceğiz. Asıl soru, bu kompakt 12B modelin faydalı kodlama-aracısı davranışı sunup sunamayacağı ve Qwen 3.6 27B veya Gemma 4 31B gibi daha büyük yerel modellerle rekabet edip edemeyeceğidir.
Fable 5-Enhanced Gemma 4, Google’ın Gemma 4 12B talimat modelini temel alan kompakt bir kodlama ve aracısal modeldir. Yuxin Lu tarafından oluşturuldu ve llama.cpp ile diğer uyumlu araçlarla yerelde kullanım için GGUF formatında yayımlandı.
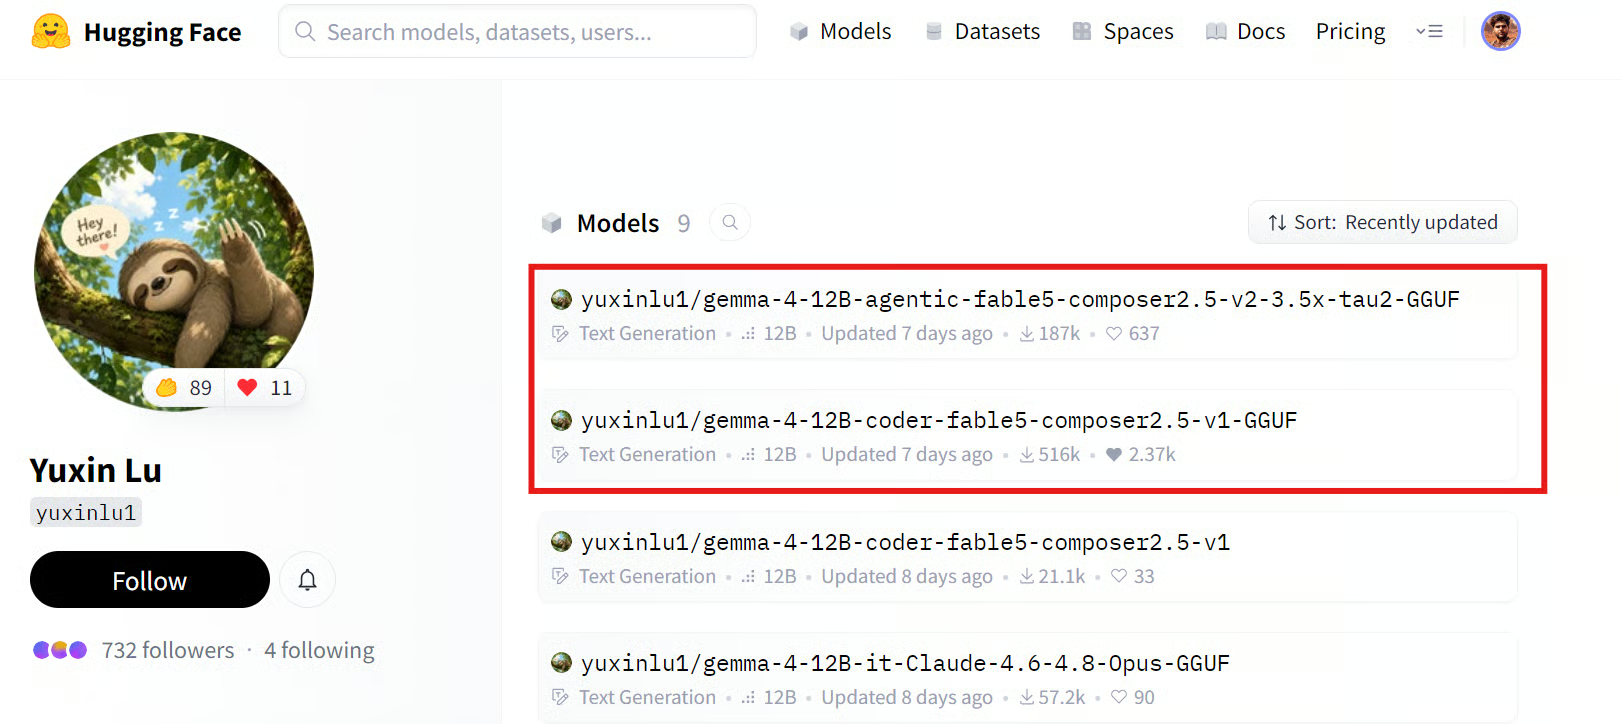
Kaynak: yuxinlu1 (Yuxin Lu)
Bu rehber v2 sürümünü kullanıyor. v1 kodlama modelini devam ettiriyor ancak aracısal teknik çalışmalara daha güçlü bir odak ekliyor.
Yalnızca kod üretmek yerine; dosyaları incelemek, sorunlar üzerinde akıl yürütmek, araçlar kullanmak, kod düzenlemek, komut çalıştırmak ve nihai sonucu doğrulamak üzere tasarlanmıştır.
Orijinal model, Composer 2.5 ve Fable 5 tarafından üretilen doğrulanmış Python kodlama verileri üzerinde ince ayarlandı.
Ana eğitim seti; Composer 2.5 akıl yürütme izlerini ve deterministik testlere sahip Python görevlerine yönelik kod çözümlerini kullanır. Yalnızca üretilen kodun testleri geçtiği örnekler tutulmuştur.
Composer 2.5’in başarısız olduğu daha zorlu görevlerde Fable 5 kullanıldı. Bu örnekler için yeni bir akıl yürütme süreci ve düzeltilmiş çözümler üretti; eğitim verisine eklenmeden önce bunlar da çalıştırma yoluyla doğrulandı.
v2 için model, çok adımlı terminal ve araç kullanımı yörüngeleri ekler. Bu, tek bir yanıt üretip durmak yerine okuma, akıl yürütme, eyleme geçme ve doğrulama iş akışını izlemesini öğretir.
Fable 5 kullanılamaz hale geldikten sonra, eksik bazı Fable 5 tarzı akıl yürütme izleri Opus 4.8 ile yeniden inşa edildi.
--jinja etkin kalsın.Yerel tau2-bench telekom karşılaştırmasında v2 model yaklaşık %55’e ulaştı; temel Gemma 4 12B talimat modeli ise yaklaşık %15 civarındaydı.
Bu, ana iyileştirmenin aracısal davranıştan geldiğini düşündürür. İnce ayarlı model, bir görevi inceleme, bir sonraki eylemi alma, araç kullanma ve sonuçları doğrulama konusunda, ilk yanıttan sonra durmak yerine daha iyidir.
Bu, bir Linux makinede llama.cpp kurmanın en hızlı ve en basit yoludur. Depoyu klonlayıp kaynaktan derlemek yerine, yükleyici önceden derlenmiş bir ikiliyi indirir ve kurar.
Terminalinizde aşağıdaki komutu çalıştırın:
curl -LsSf https://llama.app/install.sh | shBirkaç saniye içinde yükleyici llama.cpp ikilisini indirip kurulumu tamamlayacaktır.
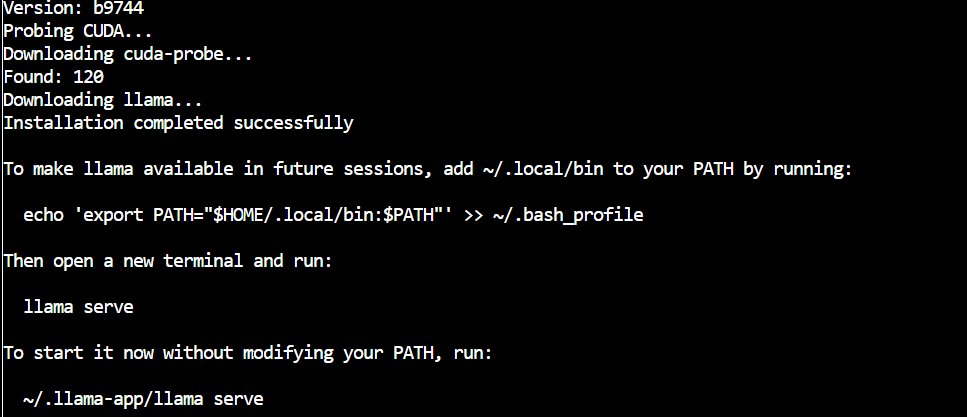
Ardından llama.cpp’yi PATH’inize ekleyin; böylece llama komutunu terminali yeniden başlattıktan sonra bile herhangi bir dizinden çalıştırabilirsiniz:
echo 'export PATH="$HOME/.local/bin:$PATH"' >> ~/.bashrc
source ~/.bashrc
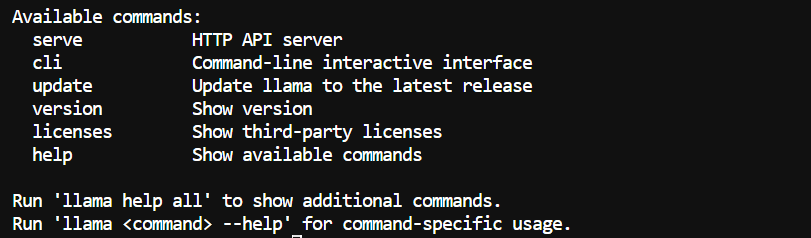
Son olarak, kurulumun çalıştığını doğrulayın:
llama helpArtık kullanılabilir llama.cpp komutlarını görmelisiniz.
Sırada Hugging Face CLI ve hf-xet’i kurun. Bu sayede, büyük dosyalar için Xet depolama kullanan repolar dahil olmak üzere, model dosyalarını doğrudan Hugging Face’ten indirebilirsiniz.
pip install -U "huggingface_hub[cli]" hf-xet Model dosyaları için bir dizin oluşturun:
MODEL_DIR="/workspace/Fable5-Gemma4"
mkdir -p "$MODEL_DIR"
Daha hızlı Xet indirmelerini etkinleştirin, ardından bu rehber için gerekli dosyaları indirin:
export HF_XET_HIGH_PERFORMANCE=1


hf download \
  yuxinlu1/gemma-4-12B-agentic-fable5-composer2.5-v2-3.5x-tau2-GGUF \
  --include "gemma4-v2-Q4_K_M.gguf" \
  --include "MTP/gemma-4-12B-it-MTP-Q8_0.gguf" \
  --local-dir "$MODEL_DIR"
Bu, iki dosya indirir:
gemma4-v2-Q4_K_M.gguf, ana Fable 5 Enhanced Gemma 4 modeli.MTP/gemma-4-12B-it-MTP-Q8_0.gguf, daha sonra MTP spekülatif kod çözme için kullanılacak taslak model.Q4_K_M modeli yaklaşık 7 GB’tır. İndirme süresi internet bağlantınıza bağlıdır; ancak Xet kullanmak büyük model dosyaları için aktarım performansını artırabilir.
İndirme tamamlandığında dosyalarınız şu konumda olmalıdır:
/workspace/Fable5-Gemma4Şimdi yerel sunucuyu ana model ve MTP taslak modeliyle başlatın:
MODEL_DIR="/workspace/Fable5-Gemma4"

llama serve \
  --model "$MODEL_DIR/gemma4-v2-Q4_K_M.gguf" \
  --alias Fable5-Gemma4 \
  --model-draft "$MODEL_DIR/MTP/gemma-4-12B-it-MTP-Q8_0.gguf" \
  --spec-type draft-mtp \
  --spec-draft-n-max 2 \
  -ngl 99 \
  -ngld 99 \
  --ctx-size 262144 \
  --parallel 1 \
  --cache-type-k q8_0 \
  --cache-type-v q8_0 \
  --flash-attn on \
  --jinja \
  --temp 1.0 \
  --top-p 0.95 \
  --top-k 64 \
  --repeat-penalty 1.1 \
  --host 0.0.0.0 \
  --port 8910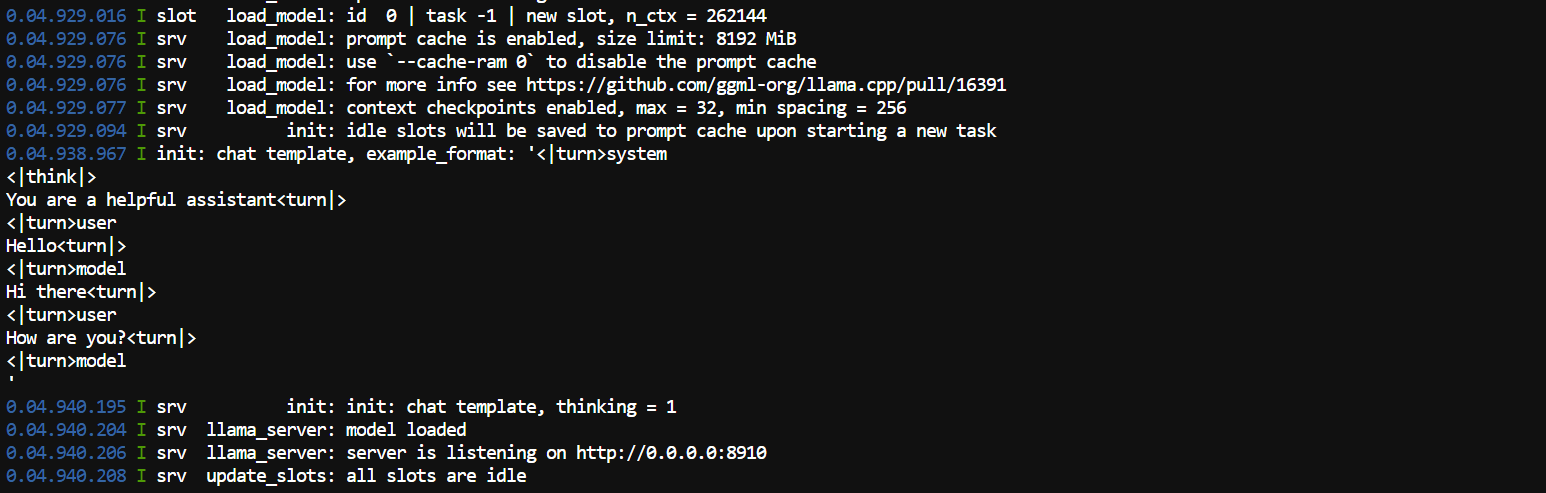
--model-draft argümanı MTP taslak modelini yükler.
MTP, Çoklu Token Tahmini (Multi Token Prediction) anlamına gelir. Daha küçük taslak model önce birkaç yaklaşan token’ı tahmin eder ve ana model bunları paralel olarak doğrular. Bu, ana modelin rolünü değiştirmeden üretim hızını artırabilir.
--spec-type draft-mtp bu MTP spekülatif kod çözme kurulumunu etkinleştirir. --spec-draft-n-max 2, taslak modelin aynı anda en fazla iki token önermesine izin verir. İki, makul bir başlangıç noktasıdır; çünkü daha büyük değerler her zaman hız artışı sağlamaz.
-ngl 99 ana modeli GPU’ya taşır; -ngld 99 ise MTP taslak modeli için aynısını yapar. 99 değeri, tüm kullanılabilir katmanların taşınmasını ifade eder.
--ctx-size 262144 maksimum 256K token bağlam penceresi ayarlar. Bu, daha büyük kod tabanları ve uzun terminal oturumları için kullanışlıdır; ancak daha fazla VRAM gerektirir. --parallel 1, bağlamın tamamını bir etkin istek için ayırır; birden fazla kullanıcı arasında bölmez.
Q8 KV-önbellek ayarları, uzun bağlam penceresi için gereken belleği azaltır. --flash-attn on özellikle uzun girdilerde dikkat hesaplamalarını daha verimli hale getirmeye yardımcı olur.
--jinja etkin kalsın. Bu, istemlerin, akıl yürütmenin ve araç çağrılarının doğru biçimlendirilmesi için modelin yerleşik sohbet şablonunu uygular.
Geriye kalan örnekleme ayarları modelin metin üretimini kontrol eder. --temp 1.0, --top-p 0.95 ve --top-k 64 çeşitli yanıtlar sağlar; --repeat-penalty 1.1 ise tekrarları azaltmaya yardımcı olur.
Sunucu yüklendikten sonra WebUI’ı açın:
http://localhost:8910 Ayrıca ikinci bir terminalden GPU kullanımını kontrol edebilirsiniz:
nvidia-smi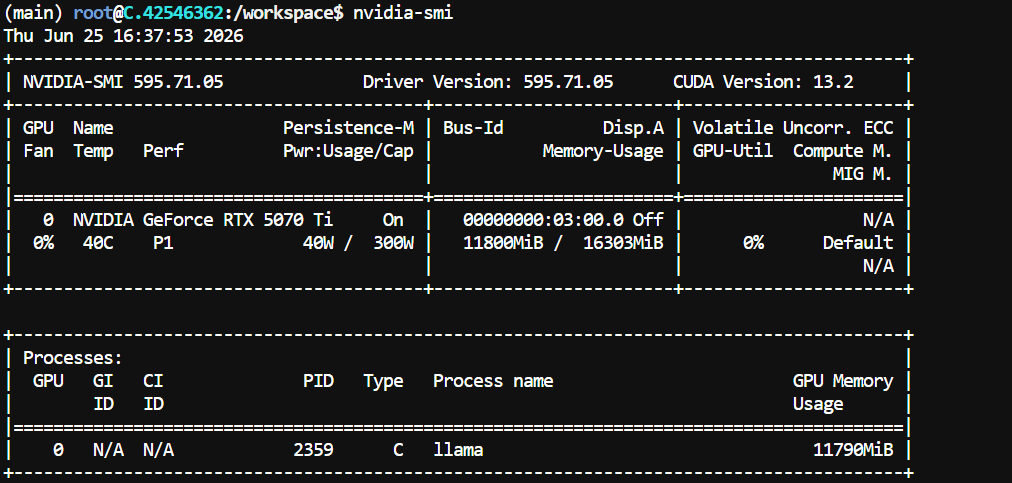
RTX 5070 Ti kurulumumda, model 256K bağlam yapılandırmasıyla yaklaşık 11.8 GB VRAM kullandı ve 4 GB’tan fazla boş kaldı.
Bellek kullanımı, llama.cpp derlemesine, GPU sürücüsüne ve bağlam ayarlarına bağlı olarak değişebilir.
llama serve terminalini açık tutun ve yerel API’yi test etmek için üçüncü bir terminal açın.
curl http://127.0.0.1:8910/v1/messages \
  -H "Content-Type: application/json" \
  -d '{
    "model": "Fable5-Gemma4",
    "max_tokens": 512,
    "messages": [
      {
        "role": "user",
        "content": "Create a simple Python script that prints Hello, I am running locally! "
      }
    ]
  }'
Yanıt, modelin ürettiği metni ve düşünme çıktısını içermelidir. Bu testte model aşağıdaki Python kodunu döndürdü:
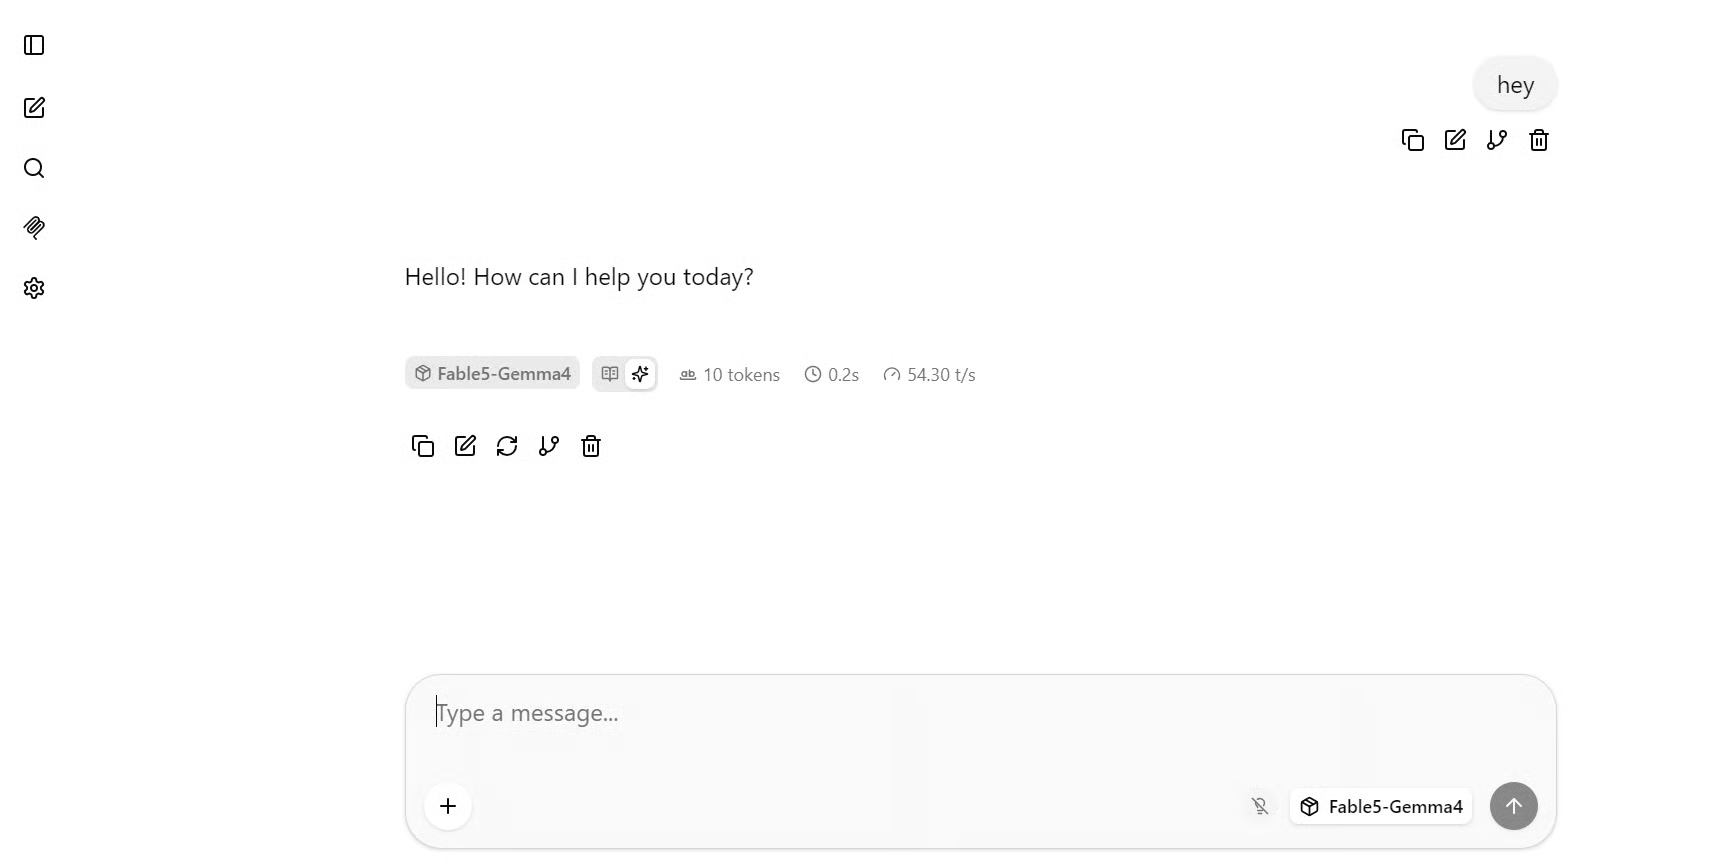
print("Hello, I am running locally!")Bir JSON yanıtı, yerel sunucunun doğru çalıştığını doğrular. Hızlı testimde model yaklaşık saniyede 54 token üretti.
Yerleşik sohbet arayüzünü de kullanabilirsiniz. Tarayıcınızda aşağıdaki adresi açın:
http://localhost:8910WebUI normal bir sohbet uygulaması gibi çalışır. Fable5-Gemma4 modelini seçin, bir istem yazın ve yerel sunucuya gönderin.
Daha büyük bir kodlama testi için bu istemi kullanın:
Create a calming, premium spa treatment center website in one self-contained HTML file
with all CSS and JavaScript included inline, elegant booking CTAs, treatment packages,
therapist profiles, testimonials, and high-quality spa imagery.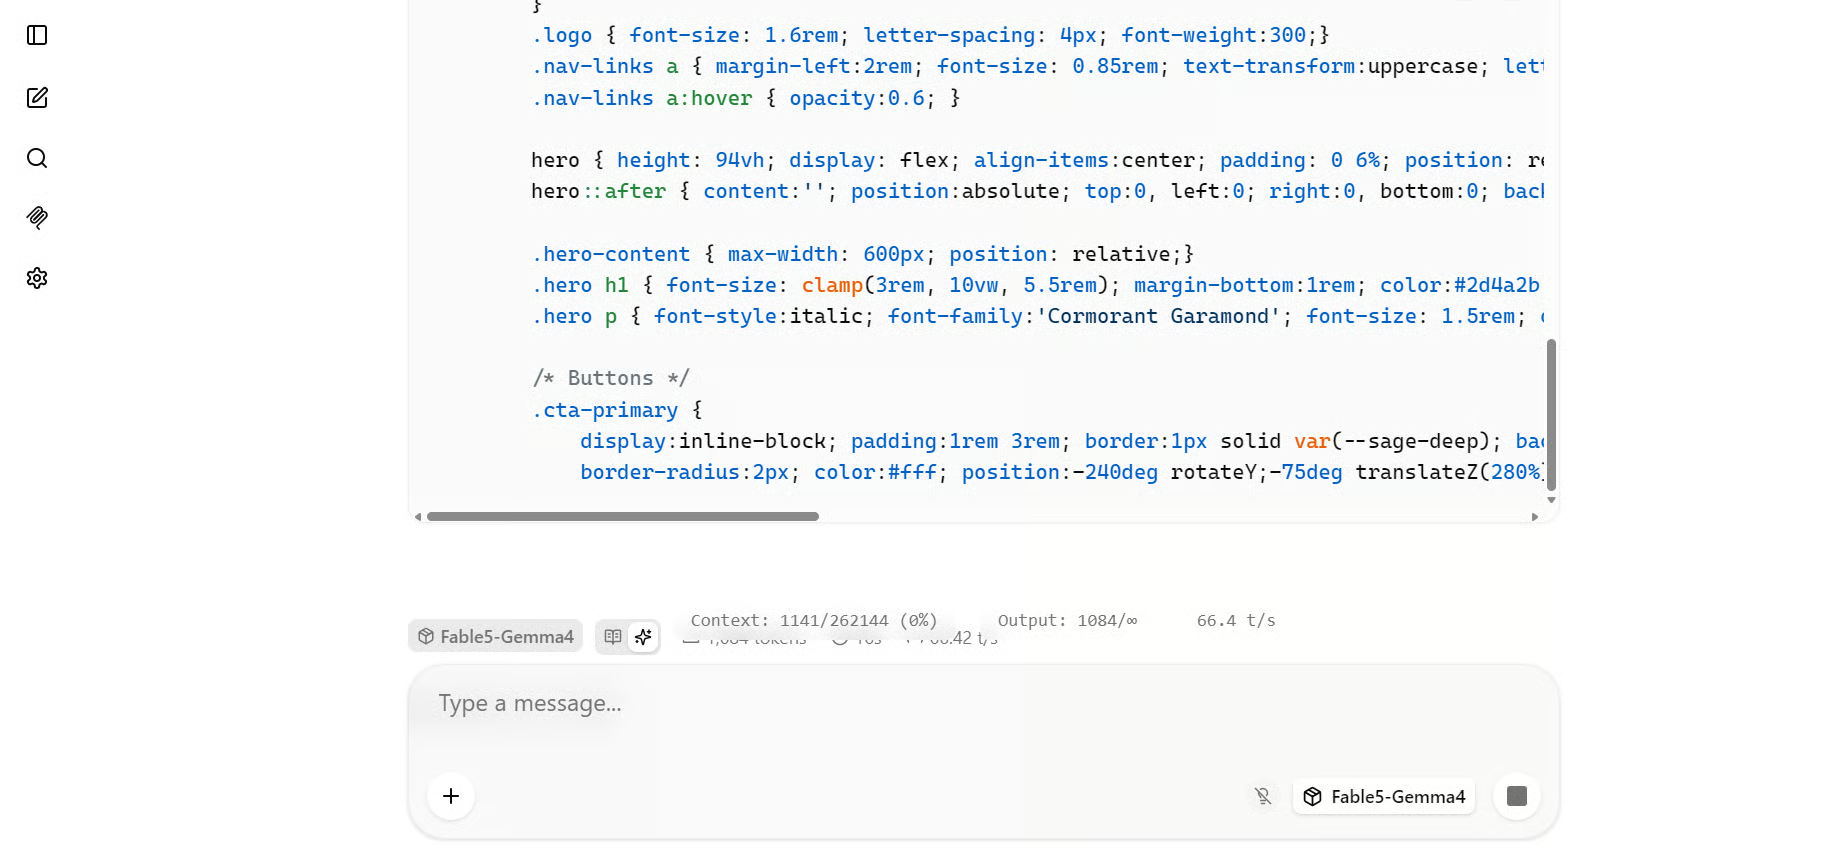
Bu daha uzun HTML üretim görevinde yaklaşık saniyede 66 ila 70 token gördüm. Daha uzun kodlama görevleri bazen daha iyi spekülatif kod çözme performansı sağlayabilir; çünkü model daha kesintisiz ve öngörülebilir kod token dizileri üretir.
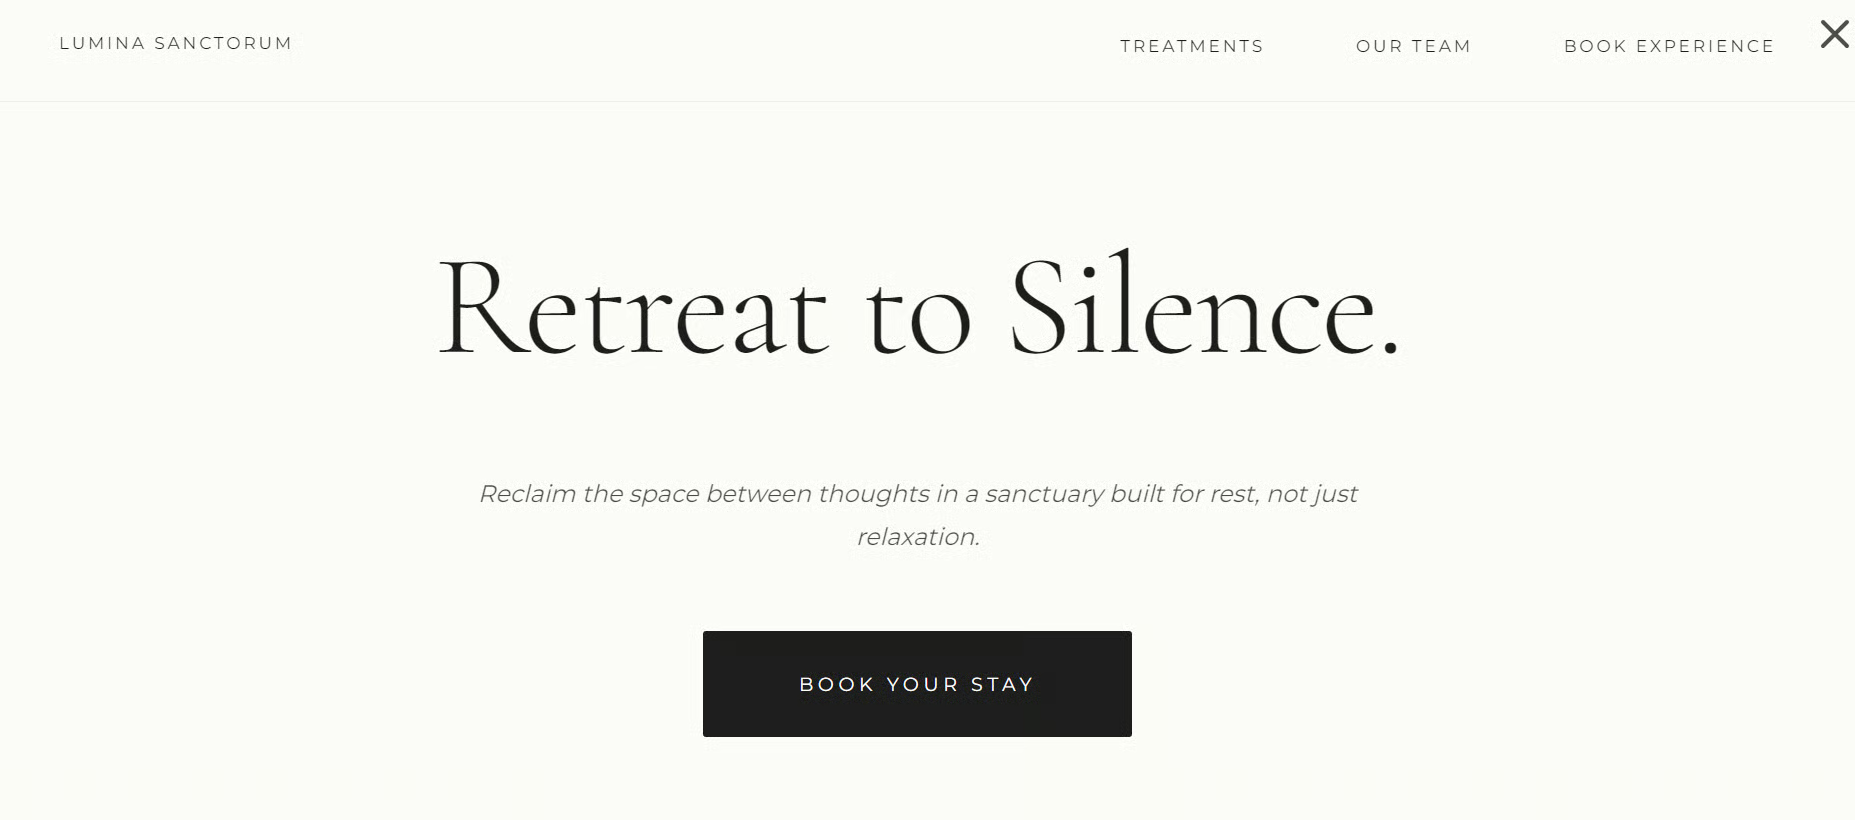
Aşağıdaki ilk sonuç, düşünme seviyesi Orta olarak ayarlanmışken üretildi. Minimal bir düzen, gezinme bağlantıları ve büyük bir rezervasyon çağrısı içeren temiz bir spa açılış sayfası oluşturdu.
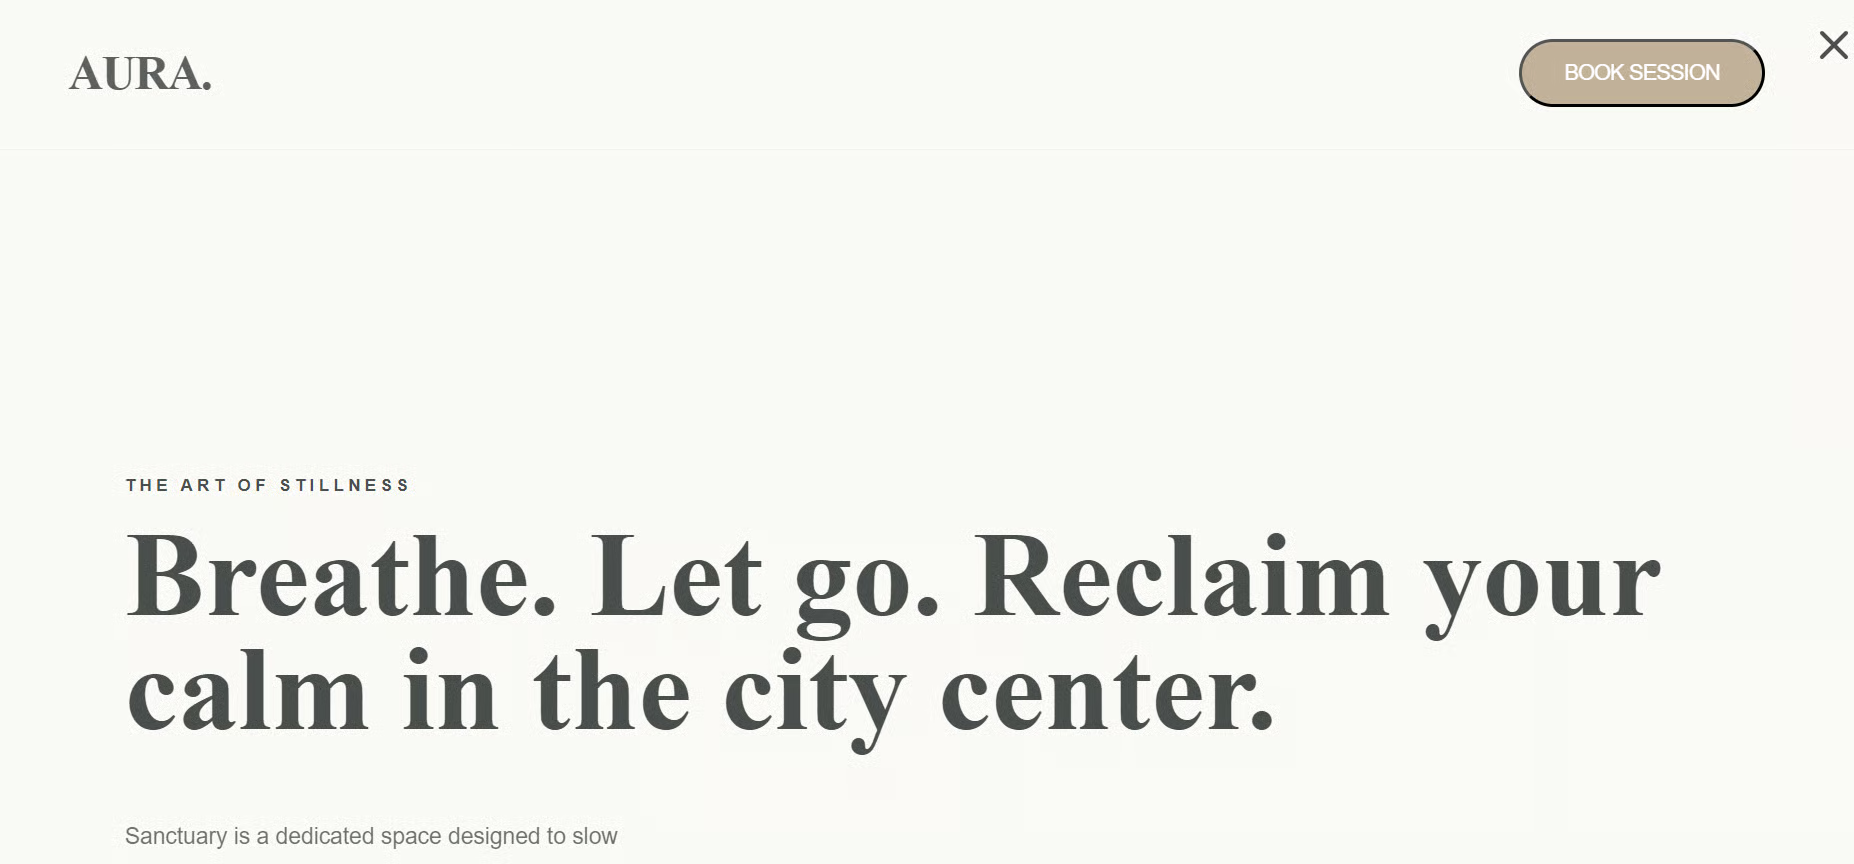
İkinci sonuç ise düşünme olmadan üretildi. Daha büyük bir başlık ve daha editoryal bir açılış sayfası stiliyle farklı bir görsel yön verdi.
Her iki sonuç da görsel olarak cilalıydı; ancak bu testte akıl yürütme etkin sürüm daha yapılandırılmış bir sonuç verdi.
Token hızı; istem uzunluğu, çıktı stili, GPU yükü ve ana modelin MTP’nin önerdiği taslak token’ları ne sıklıkla kabul ettiğine bağlı olarak değişebilir.
Pi hafif bir terminal kodlama aracısıdır. Yerel Fable 5-Enhanced Gemma 4 sunucusuna bağlanabilir ve dosya okuma, kod düzenleme, komut çalıştırma ve kodlama görevlerini tamamlama için onu kullanabilir.
Dördüncü bir terminal açın ve Pi’yi kurun:
curl -fsSL https://pi.dev/install.sh | sh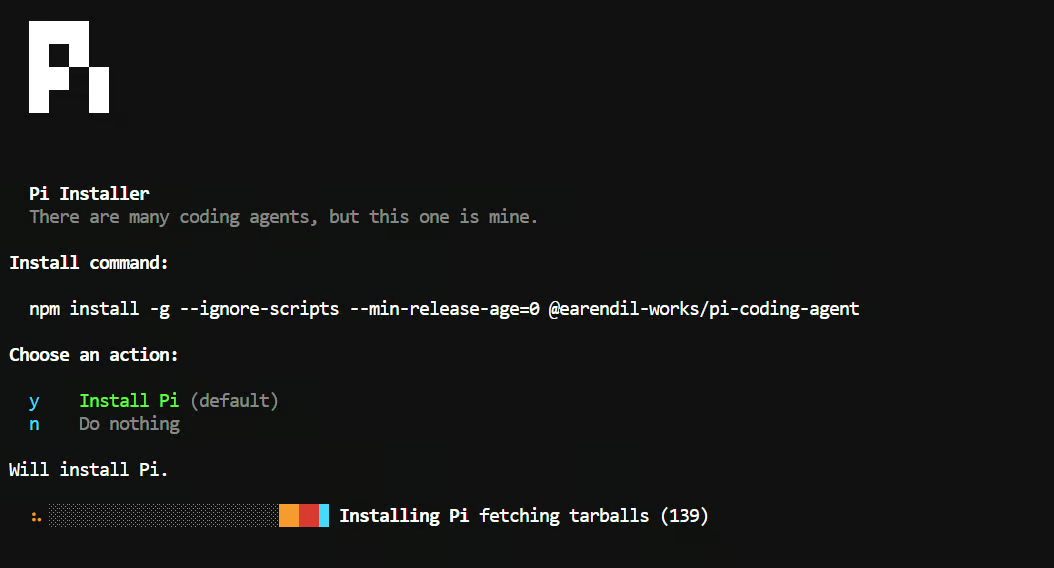 Yükleyici Node.js kurulumu isteyebilir. İstemi onaylayın ve kurulumun bitmesini bekleyin.
Terminal yapılandırmanızı yeniden yükleyin ve ardından Pi’nin kullanılabilir olduğunu doğrulayın:
source ~/.bashrc
pi --version
Ardından pi-llama eklentisini kurun:
pi install git:github.com/huggingface/pi-llamaBu eklenti, Pi’yi çalışan bir llama.cpp sunucusuna bağlar ve mevcut yerel modelleri otomatik olarak keşfeder.
Varsayılan olarak eklenti, llama.cpp’yi 8080 portunda arar. Bizim sunucumuz 8910 portunu kullanıyor; bu nedenle Pi’yi başlatmadan önce doğru yerel API adresini ayarlayın:
export LLAMA_BASE_URL="http://127.0.0.1:8910/v1"Yeni bir proje dizini oluşturun, Git’i başlatın ve Pi’yi çalıştırın:
mkdir -p /workspace/data-app
cd /workspace/data-app
git init
pi
Pi içinde şunu yazın:
/model“Fable5-Gemma4” modelini seçin.
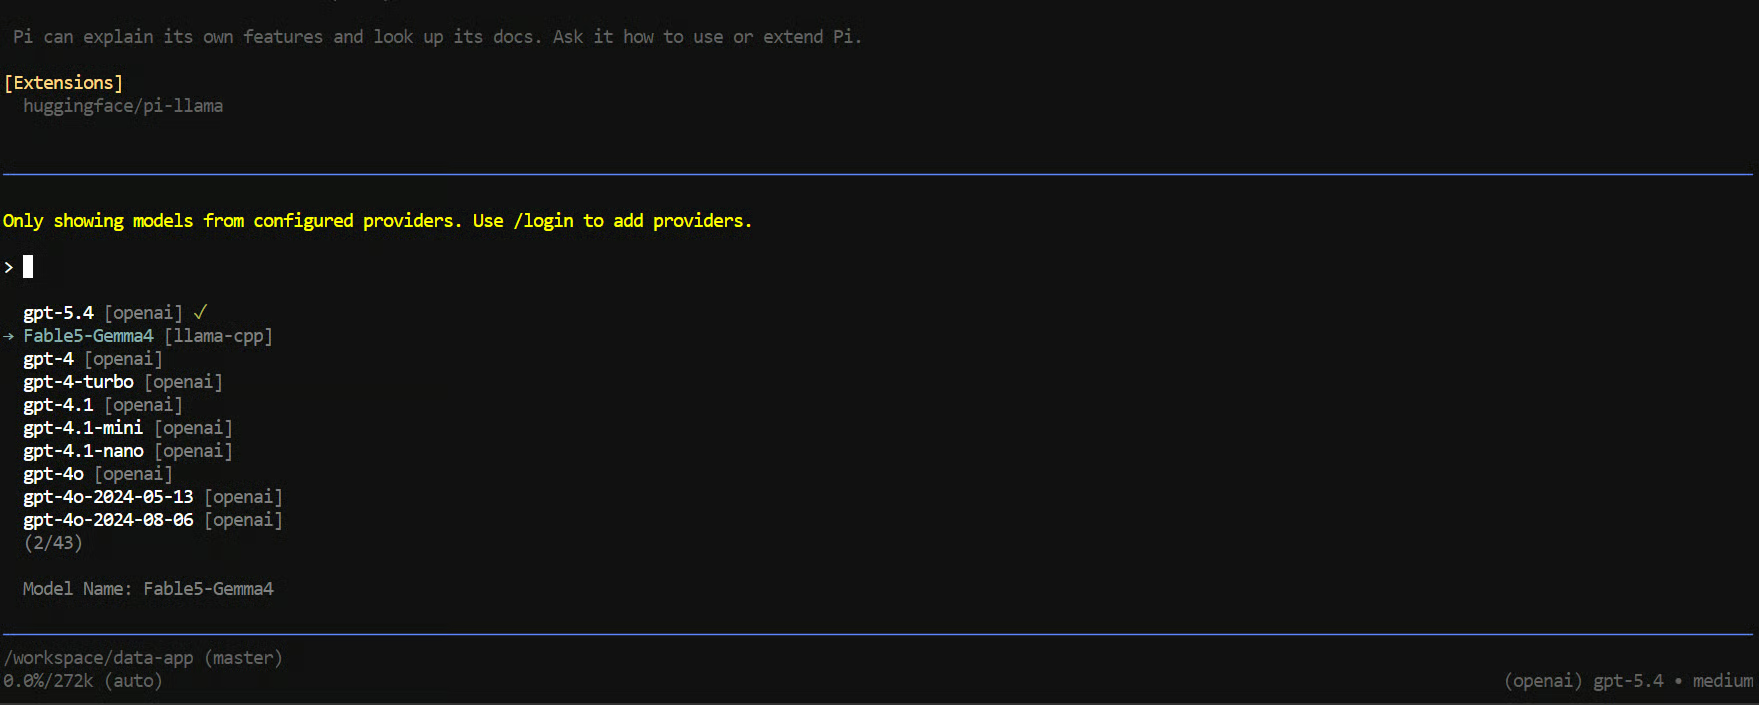
Ardından aracısına pratik bir kodlama görevi verin:
Create a simple data analytics dashboard using Streamlit that lets users
upload a CSV file, view the data, and explore clear visualizations.
Include a sample CSV file and test the full app to make sure it works correctly.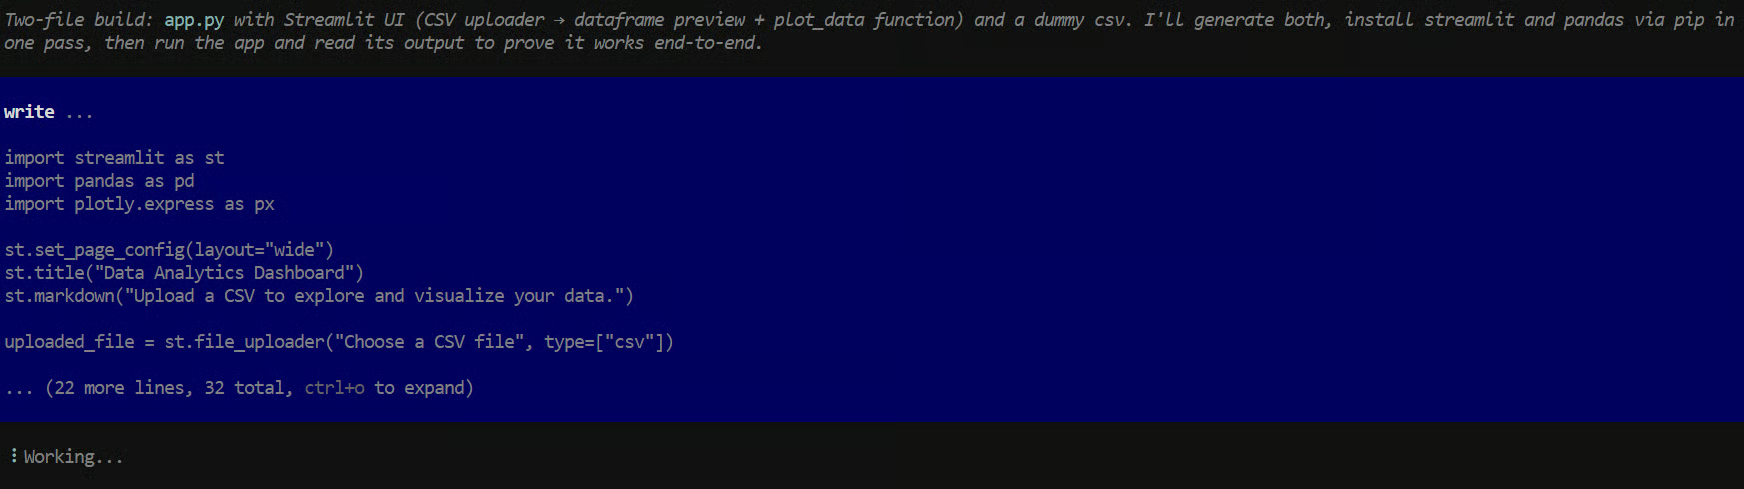
Model sonunda CSV yükleme desteği ve görselleştirmelerle çalışan bir Streamlit panosu oluşturdu.
Ancak süreç beklediğimden çok daha zorluydu.
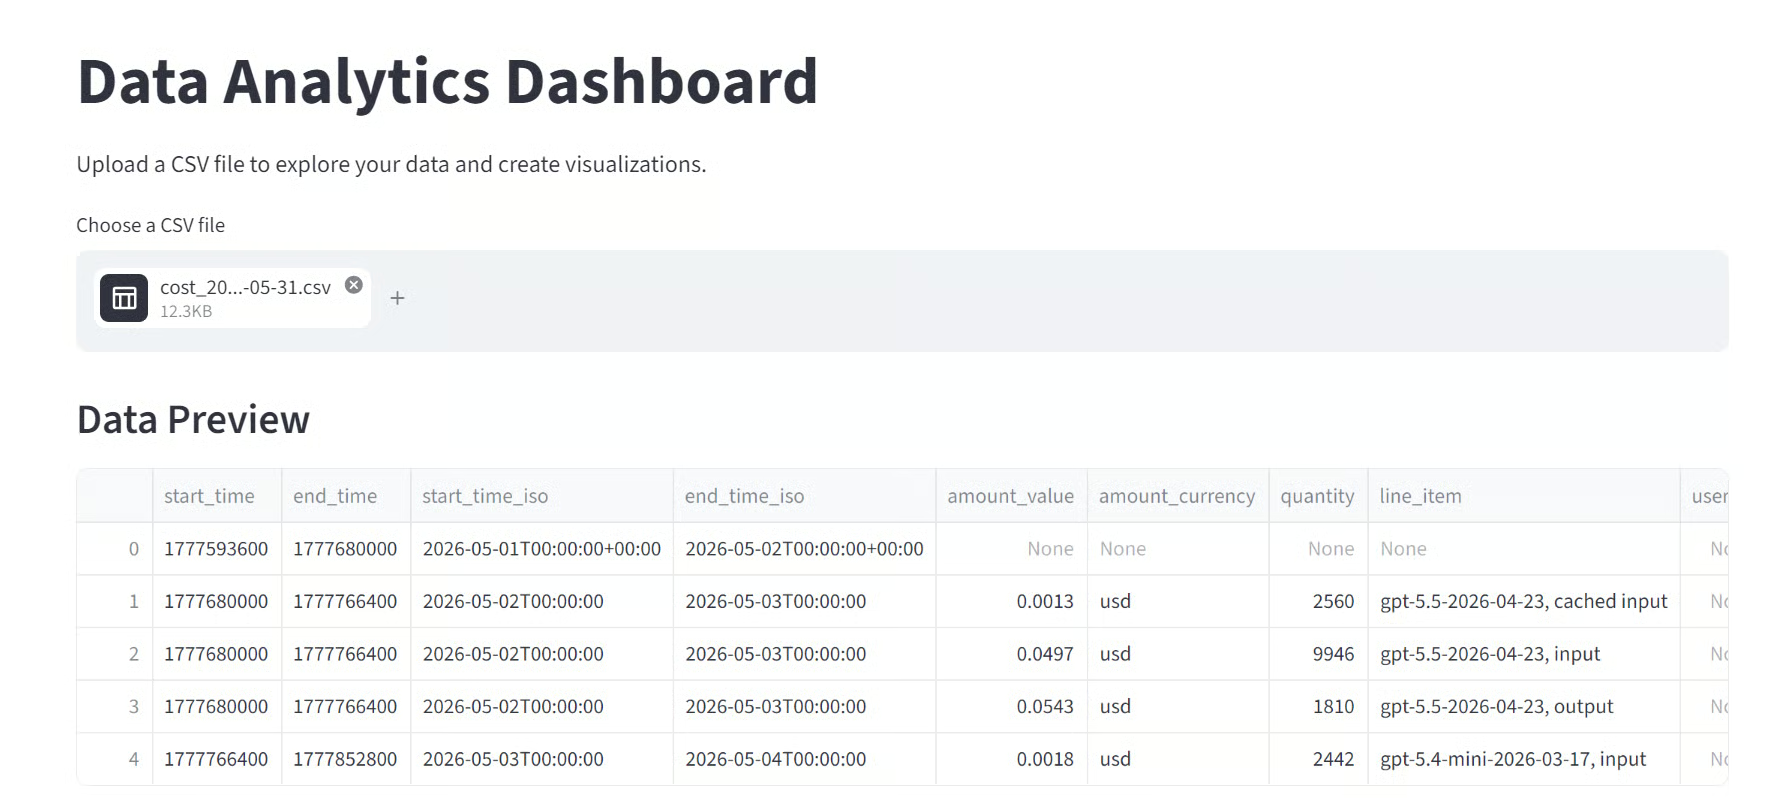
Araç çağrıları, terminal komutları ve proje dosyalarını yazma konusunda tekrar tekrar zorlandı.
Ne yapacağını planladıktan sonra çoğu zaman bir sonraki eylemi tamamlayamadı; bu nedenle hatalar boyunca rehberlik etmeye ve komutları yeniden denemeye devam etmek zorunda kaldım.
Bunun modelden mi, Pi entegrasyonundan mı, yerel izinlerden mi yoksa bu sorunların bir kombinasyonundan mı kaynaklandığını doğrulayamadım.
Yaklaşık 20 dakikalık yeniden denemelerden sonra çalışan bir sonuç üretti. Görece basit bir Streamlit görevi için bu fazla yavaş ve güvenilmez hissettirdi.
Aynı görev, ayrı testimde GLM 5.2 ile yaklaşık bir dakika sürdü.
12B bir yerel modeli çok daha büyük bir sınır (frontier) modeliyle karşılaştırmak tamamen adil değil.
Yine de fark belirgindi.
Fable 5-Enhanced Gemma 4, cilalı kod ve güçlü tek adımlı çıktılar üretebilir; ancak bu testte gerçek aracısal performansı tutarsızdı. Yetkin bir kodlama aracısının hızlı ve bağımsızca tamamlaması gereken bir görev için çok fazla müdahale gerektirdi.
Benim çıkarım, modelin yerel deneyler, özel kod üretimi ve hafif iş akışları için ilgi çekici olduğudur.
Ancak bu teste dayanarak, güvenilir çok adımlı kodlama-aracısı görevleri için henüz ona güvenmezdim.
Bu rehber modeli test etmek için basit bir yol sunsa da, donanımınıza, yerel kurulumunuza ve llama.cpp derlemenize bağlı olarak sorunlarla karşılaşabilirsiniz.
Sunucu MTP taslak modelini yüklerken çöküyor ve şu tür bir hata gösteriyorsa:
invalid vector subscriptSorun model dosyalarından ziyade llama.cpp derlemeniz olabilir.
Model deposu, llama.cpp’nin b9553 derlemesinin Gemma 4 MTP taslak modeliyle çalıştığını; b9702 ve b9717 gibi daha yeni derlemelerin taslak model yükleme sırasında başarısız olabildiğini bildiriyor.
Hızlı bir geri dönüş olarak, sunucu komutundan MTP argümanlarını kaldırın ve yalnızca ana modeli çalıştırın. Model yine doğru çalışacaktır; ancak üretim daha yavaş olabilir.
Şu satırları kaldırın:
--model-draft "$MODEL_DIR/MTP/gemma-4-12B-it-MTP-Q8_0.gguf"
--spec-type draft-mtp
--spec-draft-n-max 2
-ngld 99Yanıtta <|tool_call> veya <|channel> gibi token’lar görüyorsanız, istemci Gemma 4’ün yerel araç çağrısı formatını doğru uygulamıyor demektir.
Sunucu komutunuzun şunu içerdiğinden emin olun:
--jinjaArdından sunucuyu yeniden başlatın. Bu, modelin akıl yürütmesi ve yapılandırılmış araç çağrıları için doğru sohbet şablonunu uygular.
Önce llama.cpp sunucusunun hâlâ çalıştığını kontrol edin:
curl http://127.0.0.1:8910/v1/modelsYanıtta Fable5-Gemma4 görmelisiniz.
Ardından Pi’nin varsayılan llama.cpp portu 8080 yerine 8910 portuna yönlendirildiğinden emin olun:
export LLAMA_BASE_URL="http://127.0.0.1:8910/v1"
pi
Her iki komutu da aynı terminal oturumunda çalıştırın.
Pi’yi yazılabilir bir proje dizini içinde başlatın:
cd /workspace/data-app
pi
Geçerli dizinin dosya oluşturulmasına izin verip vermediğini test edebilirsiniz:
touch write-test.txt && rm write-test.txtBu komut başarısız olursa, sorun modelden ziyade bir çalışma alanı izin problemidir. Pi’yi başlatmadan önce yazılabilir bir dizine geçin.
Model metin, sayı veya sembolleri tekrar etmeye başlarsa, sunucu komutunuzdaki örnekleme ayarlarını kontrol edin.
Şu değerleri kullanın:
--temp 1.0 \
--top-p 0.95 \
--top-k 64 \
--repeat-penalty 1.1
Özellikle tekrar cezası önemlidir. Bu olmadan model tekrarlı veya bozuk çıktı üretebilir.
256K bağlam penceresi büyük bir KV önbelleği gerektirir. Sunucu VRAM’den taşarsa, önce bağlam boyutunu azaltın:
--ctx-size 32768Daha fazla VRAM boşaltmak için MTP taslak modelini de devre dışı bırakabilirsiniz. Mevcut GPU bellek kullanımınızı şununla kontrol edin:
nvidia-smiModel güçlü kod üretebilir; ancak müdahale olmadan daha uzun görevleri tamamlamakta yine de zorlanabilir. Testlerimde bazen doğru eylemleri planladı; fakat komut çalıştırırken, dosya yazarken veya bir hatadan sonra devam ederken başarısız oldu.
Daha iyi sonuçlar için büyük istekleri daha küçük görevlere bölün:
Bu, modele her adımda daha küçük bir hedef verir ve bir hatanın modelden mi, Pi’den mi, sunucudan mı yoksa çalışma alanı izinlerinden mi kaynaklandığını belirlemeyi kolaylaştırır.
En azından benim testlerime göre, bu model etrafındaki abartının tamamen haklı olduğunu düşünmüyorum. MTP ile ve MTP olmadan genel görevlerde neredeyse aynı hızı aldım. Kodlama görevlerinde MTP yardımcı oldu ve yaklaşık %20 ile %30 arasında hız artışı gördüm. Bu faydalı; ancak daha büyük sorunu çözmüyor: güvenilirlik.
Modeli WebUI’da da test ettim.
Bazen bir dosya için kod yazarken, net bir neden olmadan duruyordu. Devam etmesini istediğimde ise devamı gerçekten dosyaya yazmak yerine bir sonraki sohbet yanıtında metin olarak yazıyordu.
Ayrıca düşünmeyi etkinleştirmenin bazen çıktıyı kötüleştirdiğini gözlemledim; bu şaşırtıcıydı.
Claude Code ile de test ettim ve o deneyim daha da sinir bozucuydu.
Model sürekli olarak basit bir projenin ihtiyaç duymadığı fazladan dosyalar, geçici dosyalar ve ilgisiz şeyler oluşturdu. Sonunda görevi tamamladı; ancak çok fazla yönlendirme ve çok fazla zaman aldı.
12B bir yerel modeli GPT-5.5 veya GLM 5.2 ile karşılaştırmanın tamamen adil olmadığını biliyorum. Ancak daha küçük yerel modellerle karşılaştırıldığında bile etkilenmedim.
Deneyimlerime göre Qwen3.6 27B, daha büyük olmasına rağmen kodlama ve aracısal görevlerde çok daha iyi.
Şimdilik bu modeli, güvenilir bir kodlama aracısından ziyade ilginç bir deney olarak görüyorum.
Aynı yaratıcının yakında çıkacak Fable ile ince ayarlı Qwen3.6 27B modeline daha çok ilgi duyuyorum. Benzer damıtılmış (distilled) kodlama modelleri yayımlayan diğer açık kaynak katkıcılarını da gördüm; ancak şimdiye kadar gerçek kodlama-aracısı görevlerinde büyük bir iyileşme görmedim.
Model, göze hoş gelen kod ve cilalı tek-adımlı çıktılar üretebilir. Ancak ondan bir aracı gibi çalışmasını, araçları kullanmasını, dosyalar oluşturmasını, hataları düzeltmesini ve sonucu doğrulamasını istediğinizde hâlâ tutarsız ve kullanımı yorucu hissettiriyor.
En İyi DataCamp Kursları
Kurs
Kurs
Program
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.