
Khóa học
Lập trình hỗ trợ bởi AI nâng cao cho nhà phát triển
1 giờ 30 phút
1.8K
Sau khi Fable 5 và Mythos 5 bị đóng cửa, cộng đồng mã nguồn mở bắt đầu thử nghiệm các mô hình nhỏ chạy cục bộ, được huấn luyện trên dữ liệu mã hóa tổng hợp chất lượng cao và dữ liệu tác tử. Fable 5-Enhanced Gemma 4 là một ví dụ.
Đây là bản fine-tune của Gemma 4 12B, được huấn luyện trên các bộ dữ liệu do Fable 5 và Composer 2.5 tạo ra. Mục tiêu là chuyển giao các hành vi mã hóa và tác tử hữu ích vào một mô hình nhỏ hơn có thể chạy cục bộ.
Quá trình huấn luyện tập trung vào các quy trình làm việc thực tiễn như hiểu nhiệm vụ, đọc tệp, sử dụng công cụ, chỉnh sửa mã, chạy lệnh và xác minh kết quả cuối cùng.
Trong hướng dẫn này, tôi sẽ chỉ bạn cách chạy mô hình Gemma 4 tăng cường bởi Fable 5 trên máy cục bộ với RTX 5070 Ti bằng llama.cpp.
Chúng ta sẽ cài đặt llama.cpp, tải xuống mô hình GGUF và mô hình nháp MTP, khởi chạy máy chủ cục bộ tương thích OpenAI, và kiểm thử bằng cURL và WebUI tích hợp sẵn.
Cuối cùng, chúng ta sẽ kết nối mô hình với Pi Coding Agent và giao cho nó một tác vụ mã hóa thực tế. Câu hỏi chính là liệu mô hình 12B gọn nhẹ này có thể mang lại hành vi tác tử mã hóa hữu ích và cạnh tranh với các mô hình cục bộ lớn hơn như Qwen 3.6 27B hoặc Gemma 4 31B.
Fable 5-Enhanced Gemma 4 là mô hình mã hóa và tác tử gọn nhẹ dựa trên mô hình hướng dẫn Gemma 4 12B của Google. Nó được tạo bởi Yuxin Lu và phát hành dưới định dạng GGUF để dùng cục bộ với llama.cpp và các công cụ tương thích khác.
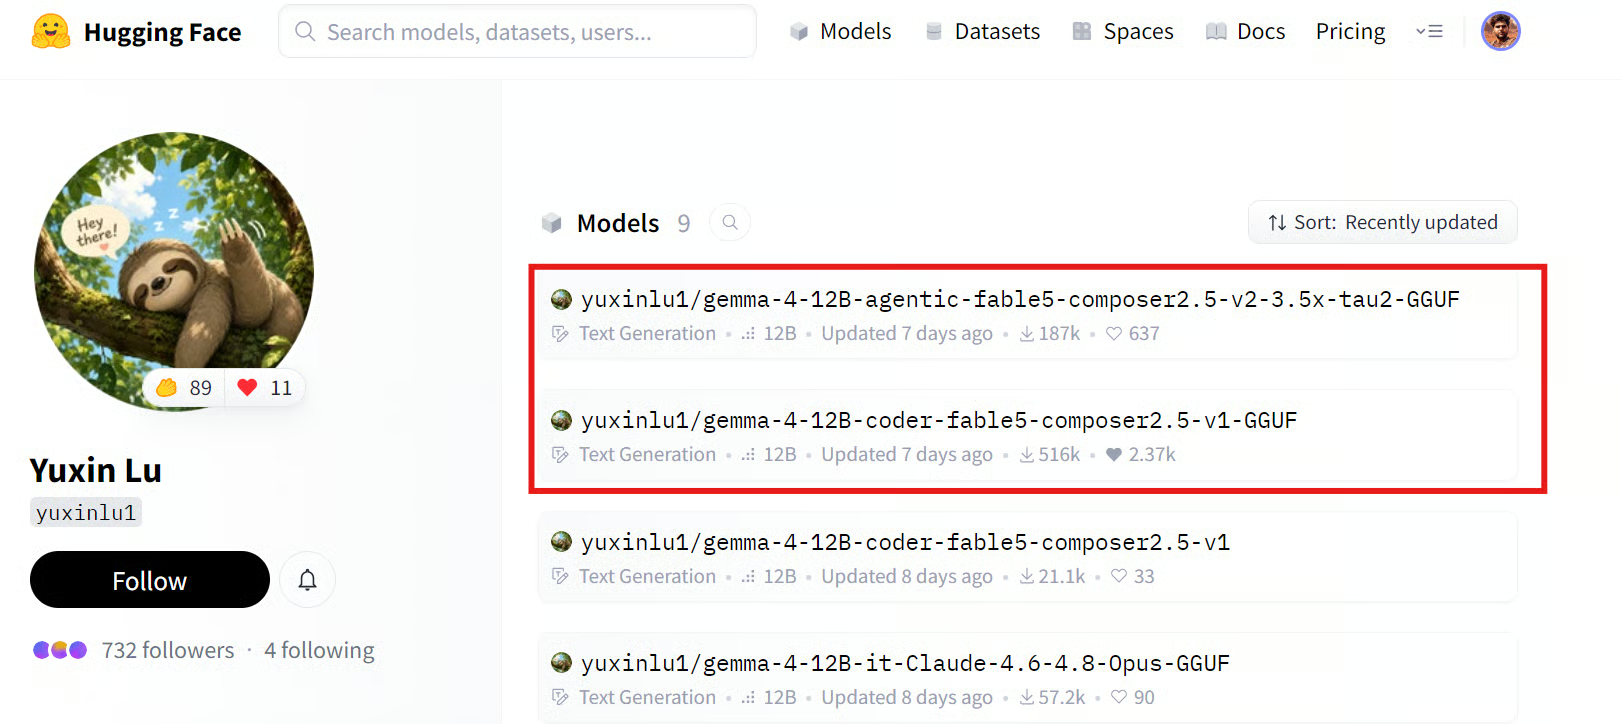
Nguồn: yuxinlu1 (Yuxin Lu)
Hướng dẫn này sử dụng bản phát hành v2. Nó tiếp nối mô hình mã hóa v1 nhưng tập trung mạnh hơn vào công việc kỹ thuật kiểu tác tử.
Thay vì chỉ sinh mã, mô hình được thiết kế để kiểm tra tệp, lý giải vấn đề, sử dụng công cụ, chỉnh sửa mã, chạy lệnh và xác minh kết quả cuối cùng.
Mô hình gốc được fine-tune trên dữ liệu mã Python đã xác minh, do Composer 2.5 và Fable 5 tạo ra.
Bộ huấn luyện chính sử dụng các vết suy luận và lời giải mã cho các tác vụ Python với bài kiểm thử xác định. Chỉ giữ lại các ví dụ mà mã sinh ra vượt qua bài kiểm thử.
Fable 5 được dùng cho các tác vụ khó hơn nơi Composer 2.5 thất bại. Nó tạo ra quy trình suy luận mới và lời giải đã hiệu chỉnh cho các ví dụ này, cũng được xác minh qua thực thi trước khi thêm vào dữ liệu huấn luyện.
Với v2, mô hình bổ sung các quỹ đạo nhiều bước cho terminal và sử dụng công cụ. Điều này dạy mô hình tuân theo quy trình đọc, lý giải, hành động và xác minh thay vì đưa ra một câu trả lời rồi dừng lại.
Sau khi Fable 5 không còn khả dụng, một số vết suy luận phong cách Fable 5 bị thiếu đã được tái tạo bằng Opus 4.8.
--jinja bật trong llama.cpp để mô hình dùng đúng mẫu chat và định dạng lời gọi công cụ của Gemma 4.Trong so sánh cục bộ tau2-bench mảng viễn thông, mô hình v2 đạt khoảng 55%, so với khoảng 15% của mô hình hướng dẫn Gemma 4 12B gốc.
Điều này gợi ý cải thiện chính đến từ hành vi tác tử. Mô hình fine-tune giỏi hơn trong việc kiểm tra nhiệm vụ, thực hiện hành động kế tiếp, dùng công cụ và xác minh kết quả thay vì dừng lại sau phản hồi ban đầu.
Đây là cách nhanh và đơn giản nhất để cài đặt llama.cpp trên máy Linux. Thay vì clone repo và biên dịch từ mã nguồn, trình cài đặt sẽ tải binary dựng sẵn và thiết lập cho bạn.
Chạy lệnh sau trong terminal:
curl -LsSf https://llama.app/install.sh | shTrong vài giây, trình cài đặt sẽ tải binary llama.cpp và hoàn tất thiết lập.
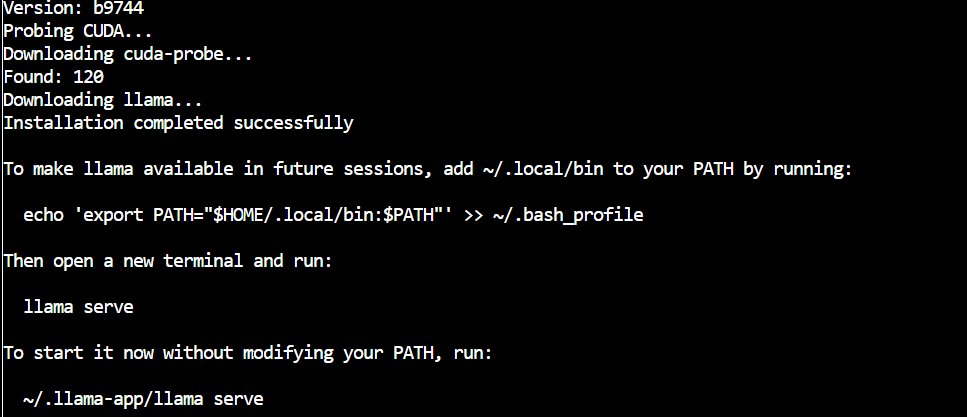
Tiếp theo, thêm llama.cpp vào PATH để bạn có thể chạy lệnh llama từ bất kỳ thư mục nào, ngay cả sau khi khởi động lại terminal:
echo 'export PATH="$HOME/.local/bin:$PATH"' >> ~/.bashrc
source ~/.bashrc
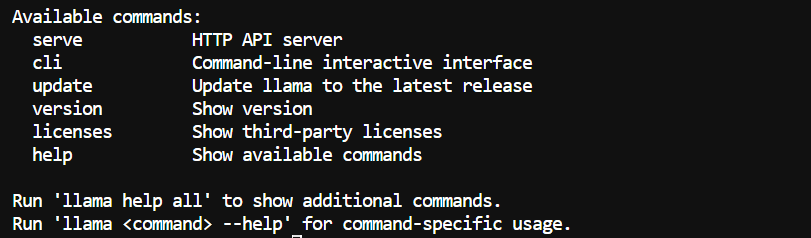
Cuối cùng, kiểm tra cài đặt đã thành công:
llama helpBạn sẽ thấy các lệnh có sẵn của llama.cpp.
Tiếp theo, cài đặt Hugging Face CLI và hf-xet. Điều này cho phép bạn tải trực tiếp tệp mô hình từ Hugging Face, bao gồm cả các kho sử dụng lưu trữ Xet cho tệp lớn.
pip install -U "huggingface_hub[cli]" hf-xet Tạo thư mục lưu tệp mô hình:
MODEL_DIR="/workspace/Fable5-Gemma4"
mkdir -p "$MODEL_DIR"
Bật tải Xet nhanh hơn, rồi chỉ tải các tệp cần cho hướng dẫn này:
export HF_XET_HIGH_PERFORMANCE=1


hf download \
  yuxinlu1/gemma-4-12B-agentic-fable5-composer2.5-v2-3.5x-tau2-GGUF \
  --include "gemma4-v2-Q4_K_M.gguf" \
  --include "MTP/gemma-4-12B-it-MTP-Q8_0.gguf" \
  --local-dir "$MODEL_DIR"
Lệnh này tải hai tệp:
gemma4-v2-Q4_K_M.gguf, mô hình Fable 5 Enhanced Gemma 4 chính.MTP/gemma-4-12B-it-MTP-Q8_0.gguf, mô hình nháp dùng sau cho MTP speculative decoding.Mô hình Q4_K_M khoảng 7 GB. Thời gian tải phụ thuộc vào kết nối mạng của bạn, nhưng dùng Xet có thể cải thiện hiệu năng truyền đối với tệp mô hình lớn.
Sau khi tải xong, tệp của bạn sẽ nằm tại:
/workspace/Fable5-Gemma4Giờ hãy khởi chạy máy chủ cục bộ với mô hình chính và mô hình nháp MTP:
MODEL_DIR="/workspace/Fable5-Gemma4"

llama serve \
  --model "$MODEL_DIR/gemma4-v2-Q4_K_M.gguf" \
  --alias Fable5-Gemma4 \
  --model-draft "$MODEL_DIR/MTP/gemma-4-12B-it-MTP-Q8_0.gguf" \
  --spec-type draft-mtp \
  --spec-draft-n-max 2 \
  -ngl 99 \
  -ngld 99 \
  --ctx-size 262144 \
  --parallel 1 \
  --cache-type-k q8_0 \
  --cache-type-v q8_0 \
  --flash-attn on \
  --jinja \
  --temp 1.0 \
  --top-p 0.95 \
  --top-k 64 \
  --repeat-penalty 1.1 \
  --host 0.0.0.0 \
  --port 8910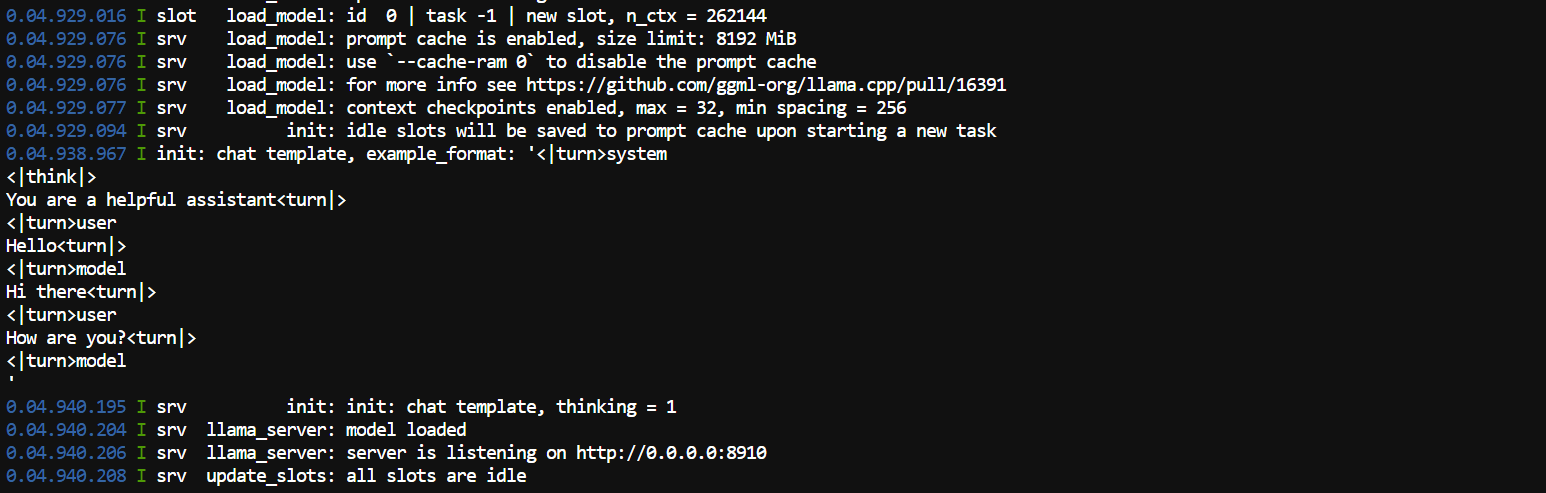
Tham số --model-draft nạp mô hình nháp MTP.
MTP là Multi Token Prediction. Mô hình nháp nhỏ hơn dự đoán trước vài token sắp tới, và mô hình chính kiểm chứng song song. Điều này có thể cải thiện tốc độ sinh mà không thay đổi vai trò của mô hình chính.
--spec-type draft-mtp bật cấu hình MTP speculative decoding. --spec-draft-n-max 2 cho phép mô hình nháp đề xuất tối đa hai token mỗi lần. Hai là điểm khởi đầu hợp lý vì giá trị lớn hơn không phải lúc nào cũng tăng tốc độ.
-ngl 99 chuyển mô hình chính lên GPU, trong khi -ngld 99 làm điều tương tự cho mô hình nháp MTP. Giá trị 99 đơn giản có nghĩa là offload mọi lớp có thể.
--ctx-size 262144 đặt cửa sổ ngữ cảnh tối đa 256K token. Điều này hữu ích cho codebase lớn và phiên terminal dài, nhưng cũng cần nhiều VRAM hơn. --parallel 1 dành toàn bộ ngữ cảnh cho một yêu cầu hoạt động thay vì chia cho nhiều người dùng.
Cài đặt KV-cache Q8 giúp giảm bộ nhớ cần cho cửa sổ ngữ cảnh dài. --flash-attn on giúp tính toán attention hiệu quả hơn, đặc biệt với prompt dài.
Giữ --jinja bật. Nó áp dụng mẫu chat tích hợp của mô hình để định dạng đúng prompt, suy luận và lời gọi công cụ.
Các thiết lập sampling còn lại kiểm soát cách mô hình sinh văn bản. --temp 1.0, --top-p 0.95 và --top-k 64 cho phép phản hồi đa dạng, trong khi --repeat-penalty 1.1 giúp giảm lặp lại.
Khi máy chủ đã nạp xong, mở WebUI:
http://localhost:8910 Bạn cũng có thể kiểm tra mức sử dụng GPU từ một terminal khác:
nvidia-smi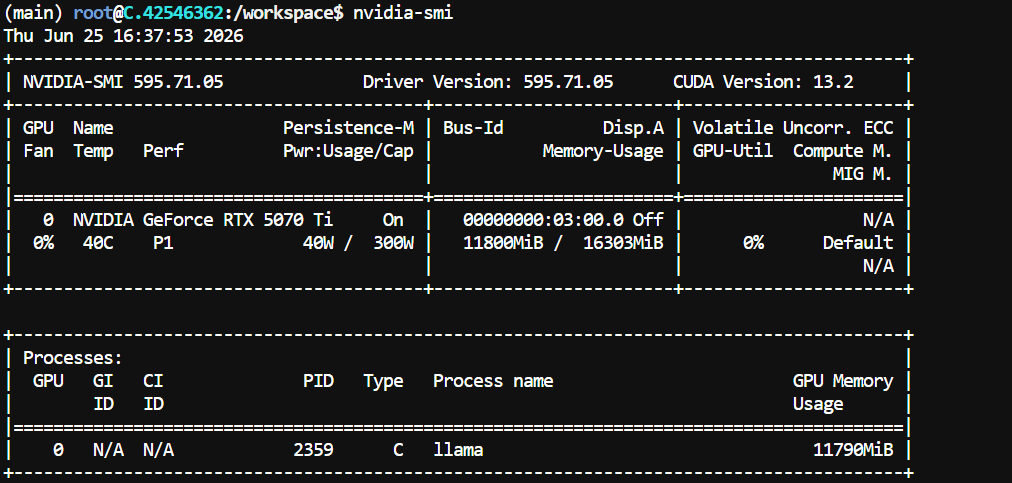
Trên thiết lập RTX 5070 Ti của tôi, mô hình dùng khoảng 11,8 GB VRAM với cấu hình ngữ cảnh 256K, còn dư hơn 4 GB.
Mức sử dụng bộ nhớ của bạn có thể khác tùy bản build llama.cpp, driver GPU và cài đặt ngữ cảnh.
Giữ terminal chạy llama serve, rồi mở terminal thứ ba để thử API cục bộ.
curl http://127.0.0.1:8910/v1/messages \
  -H "Content-Type: application/json" \
  -d '{
    "model": "Fable5-Gemma4",
    "max_tokens": 512,
    "messages": [
      {
        "role": "user",
        "content": "Create a simple Python script that prints Hello, I am running locally! "
      }
    ]
  }'
Phản hồi sẽ chứa văn bản do mô hình sinh, cùng phần suy nghĩ của nó. Trong thử nghiệm này, mô hình trả về đoạn mã Python sau:
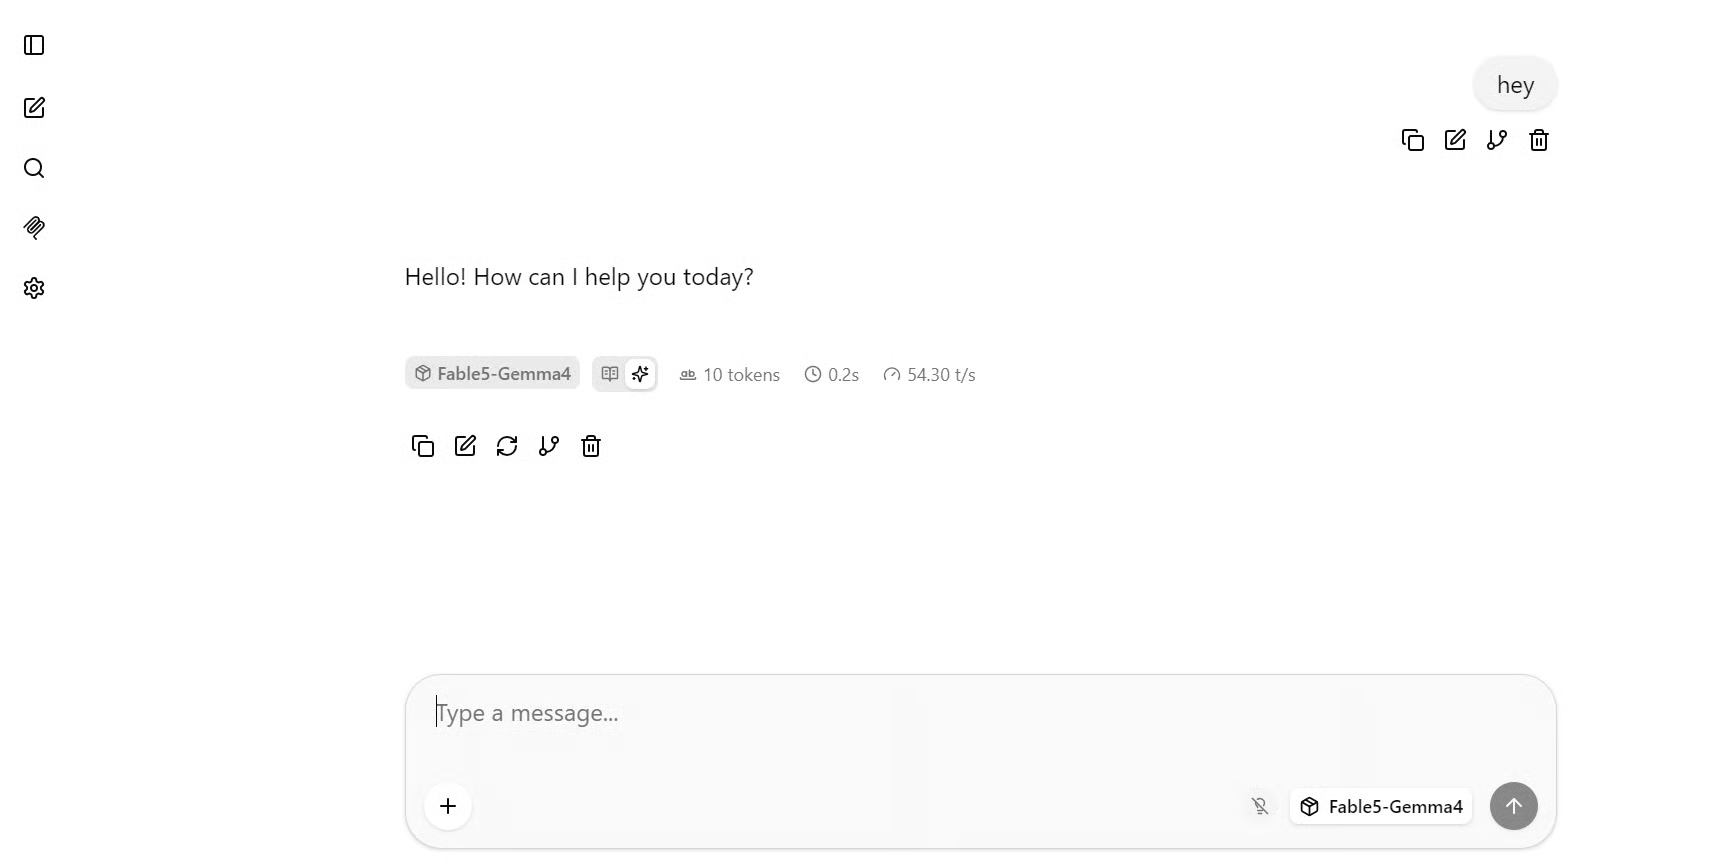
print("Hello, I am running locally!")Phản hồi JSON xác nhận máy chủ cục bộ hoạt động đúng. Trong thử nhanh của tôi, mô hình sinh với tốc độ khoảng 54 token/giây.
Bạn cũng có thể dùng giao diện chat tích hợp. Mở địa chỉ sau trong trình duyệt:
http://localhost:8910WebUI hoạt động như một ứng dụng chat bình thường. Chọn mô hình Fable5-Gemma4, nhập prompt và gửi đến máy chủ cục bộ.
Với một bài kiểm thử mã hóa lớn hơn, dùng prompt này:
Create a calming, premium spa treatment center website in one self-contained HTML file
with all CSS and JavaScript included inline, elegant booking CTAs, treatment packages,
therapist profiles, testimonials, and high-quality spa imagery.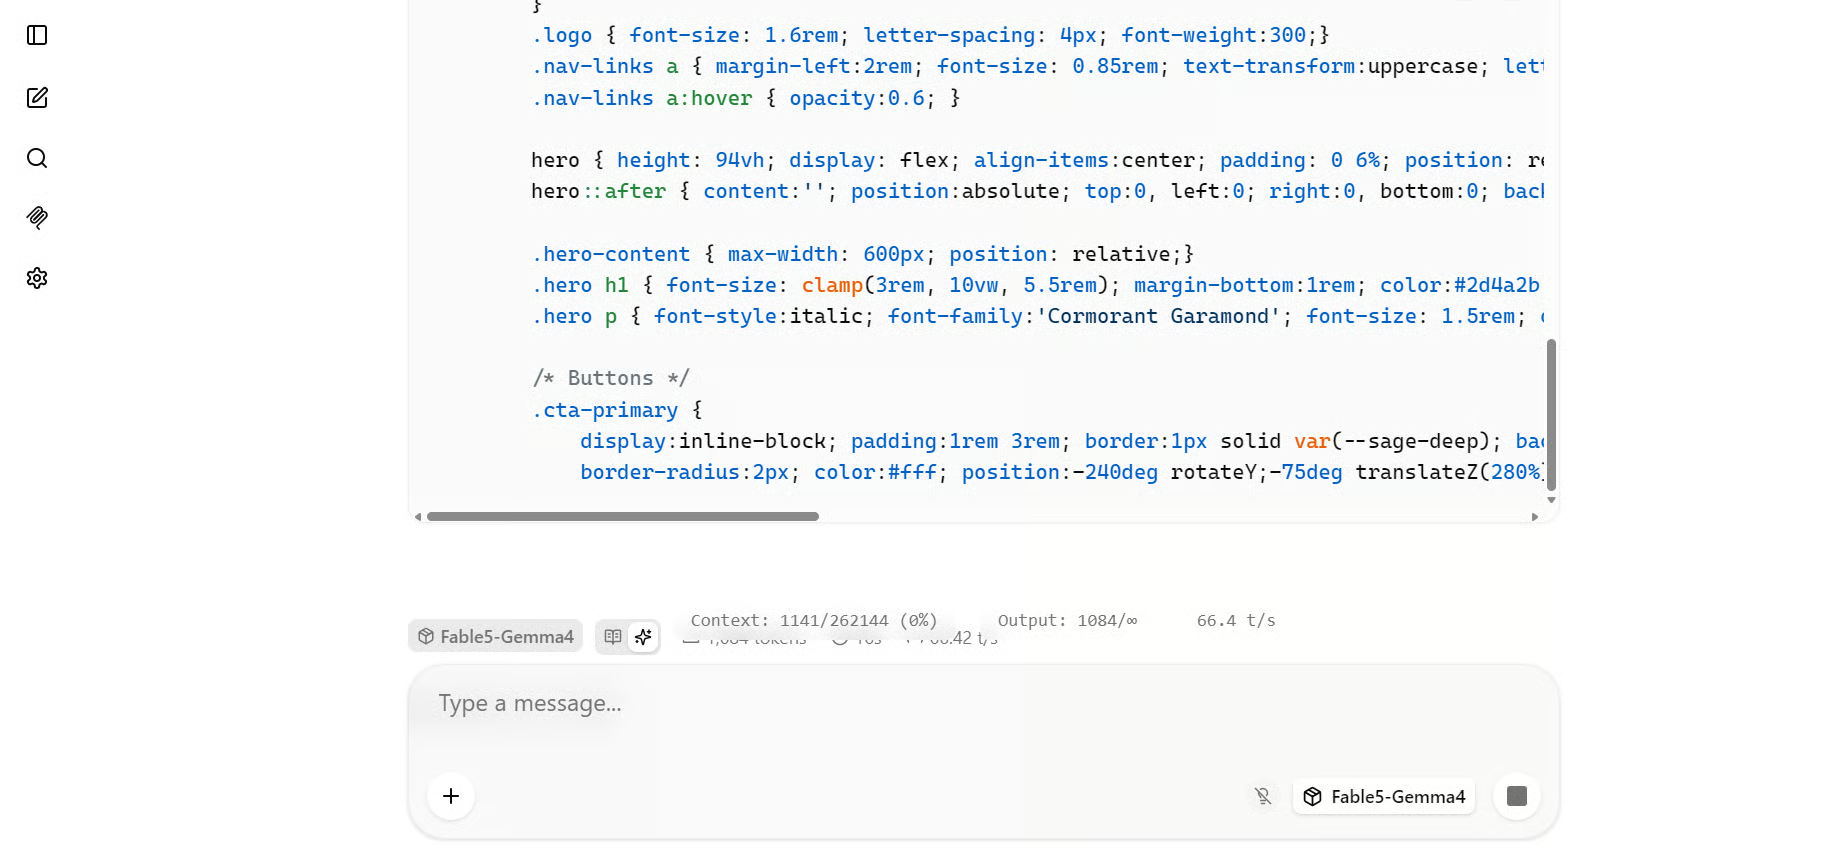
Với tác vụ sinh HTML dài hơn này, tôi thấy khoảng 66 đến 70 token/giây. Tác vụ mã dài đôi khi cho hiệu năng speculative decoding tốt hơn vì mô hình sinh chuỗi token mã liên tục và dễ dự đoán hơn.
Kết quả đầu tiên dưới đây được sinh khi bật suy luận ở mức Medium. Nó tạo trang đích spa gọn gàng với bố cục tối giản, liên kết điều hướng và nút kêu gọi đặt lịch nổi bật.
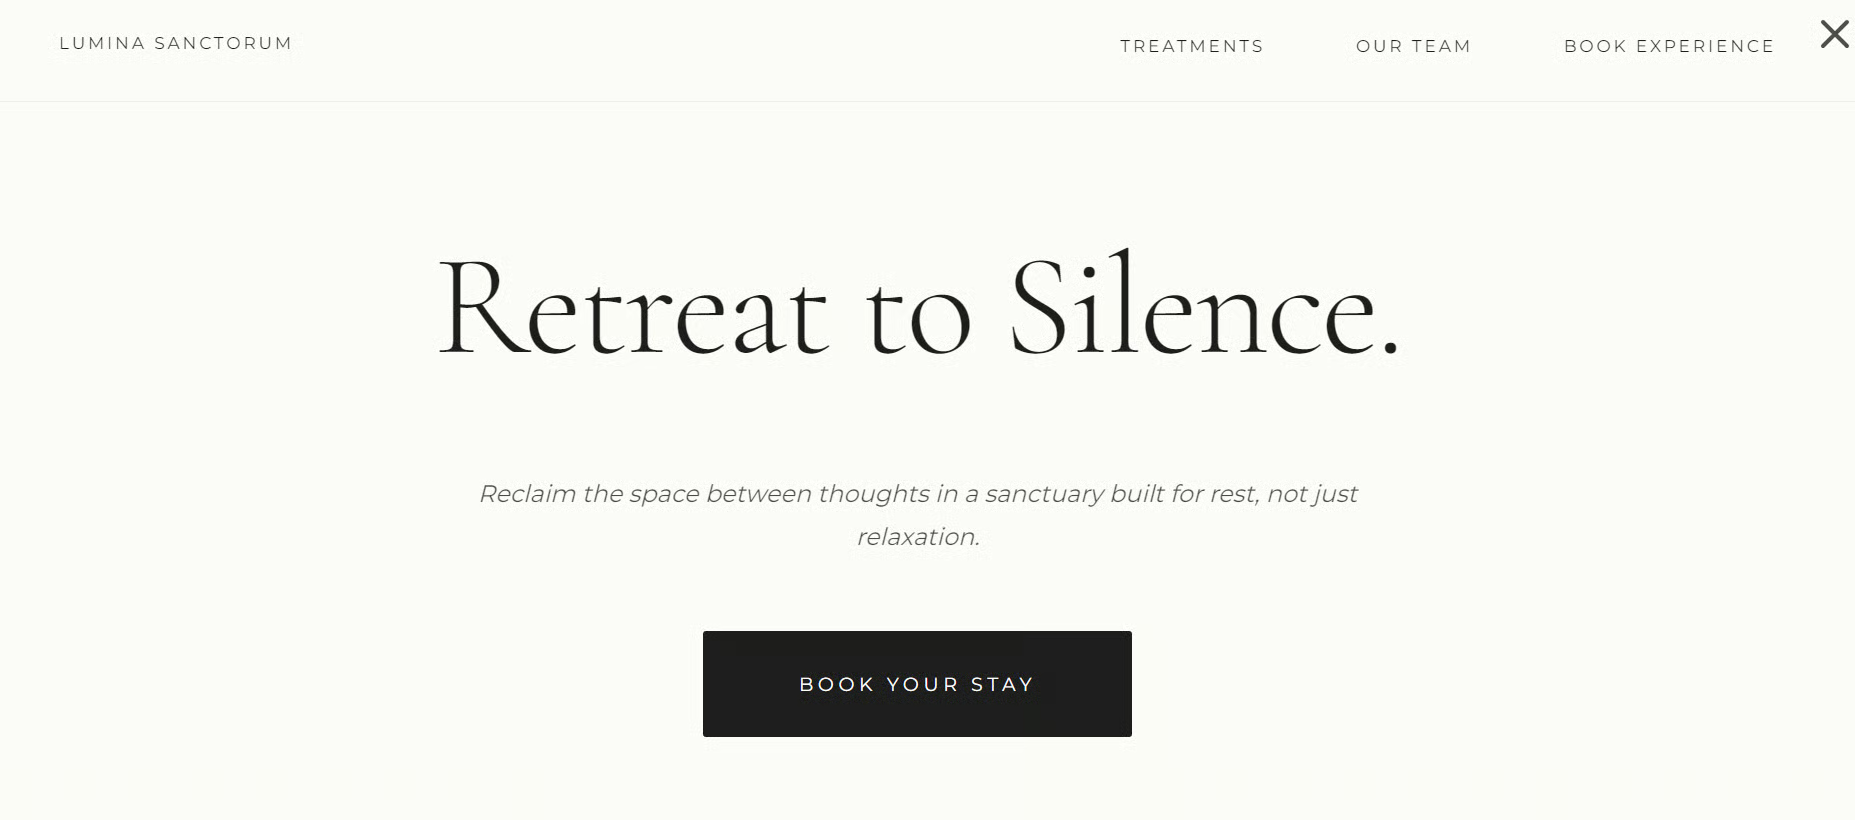
Kết quả thứ hai được tạo khi không bật suy luận. Nó cho hướng thiết kế khác, với tiêu đề lớn và phong cách trang đích mang tính biên tập hơn.
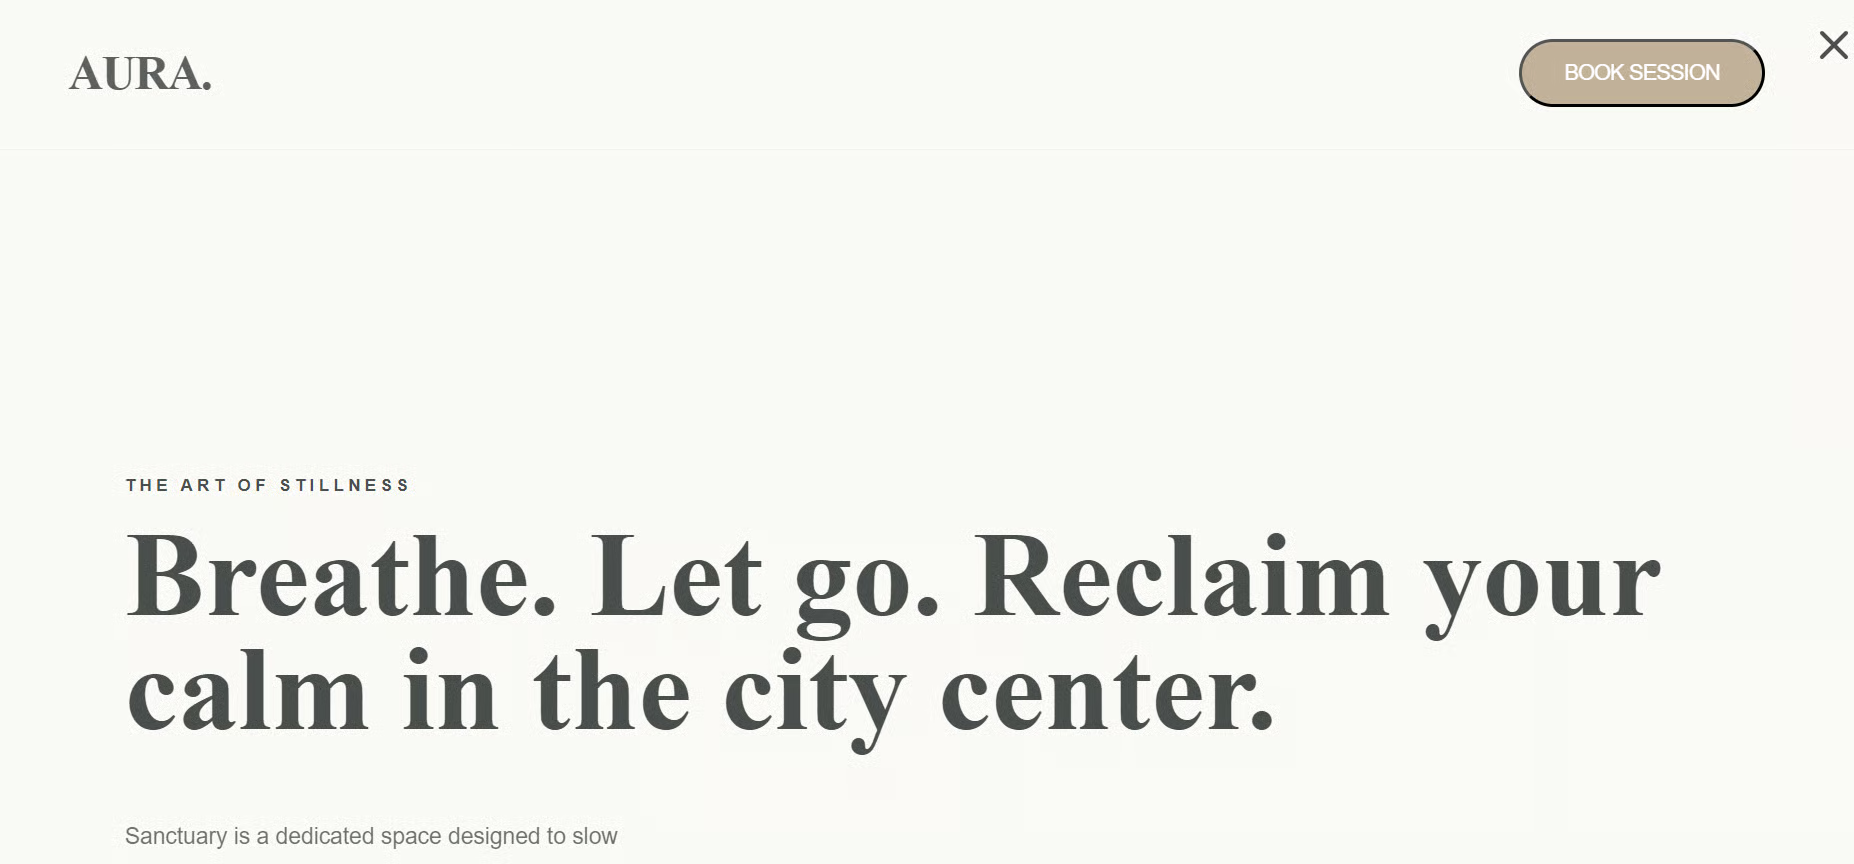
Cả hai kết quả đều trau chuốt về mặt hình ảnh, nhưng phiên bản bật suy luận cho kết quả có cấu trúc hơn trong thử nghiệm này.
Tốc độ token có thể thay đổi tùy độ dài prompt, phong cách đầu ra, tải GPU, và tần suất mô hình chính chấp nhận các token nháp do MTP đề xuất.
Pi là tác tử mã hóa chạy trong terminal, gọn nhẹ. Nó có thể kết nối tới máy chủ Fable 5-Enhanced Gemma 4 cục bộ và dùng để đọc tệp, chỉnh sửa mã, chạy lệnh, hoàn thành tác vụ mã hóa.
Mở terminal thứ tư và cài đặt Pi:
curl -fsSL https://pi.dev/install.sh | sh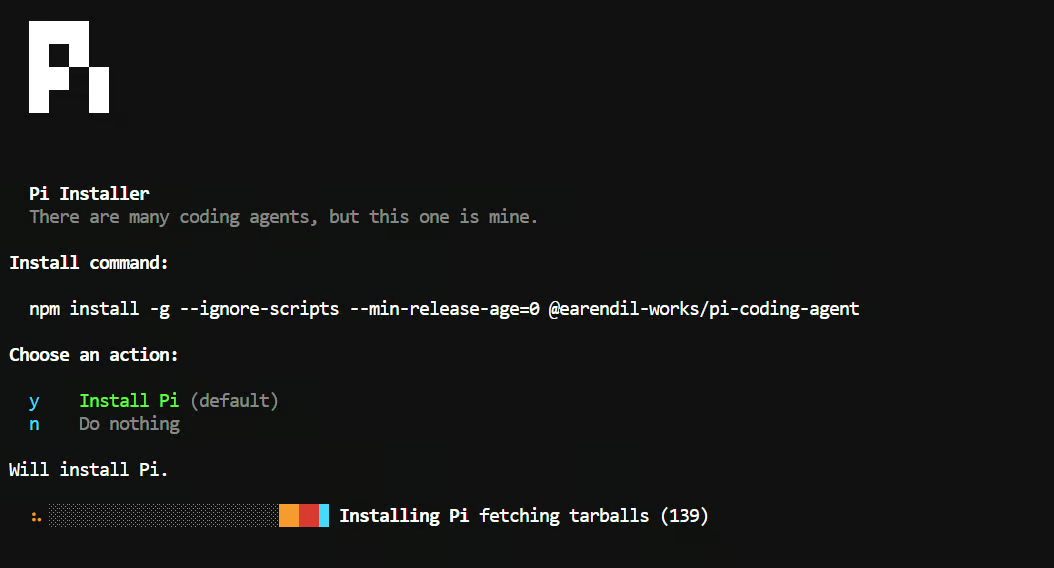 Trình cài đặt có thể yêu cầu cài Node.js. Hãy chấp nhận và chờ quá trình hoàn tất.
Nạp lại cấu hình terminal, rồi xác nhận Pi đã sẵn sàng:
source ~/.bashrc
pi --version
Tiếp theo, cài plugin pi-llama:
pi install git:github.com/huggingface/pi-llamaPlugin này kết nối Pi với một máy chủ llama.cpp đang chạy và tự động phát hiện các mô hình cục bộ có sẵn.
Mặc định, plugin tìm llama.cpp ở cổng 8080. Máy chủ của chúng ta dùng cổng 8910, vì vậy hãy đặt đúng địa chỉ API cục bộ trước khi khởi chạy Pi:
export LLAMA_BASE_URL="http://127.0.0.1:8910/v1"Tạo thư mục dự án mới, khởi tạo Git và chạy Pi:
mkdir -p /workspace/data-app
cd /workspace/data-app
git init
pi
Bên trong Pi, gõ:
/modelChọn mô hình “Fable5-Gemma4”.
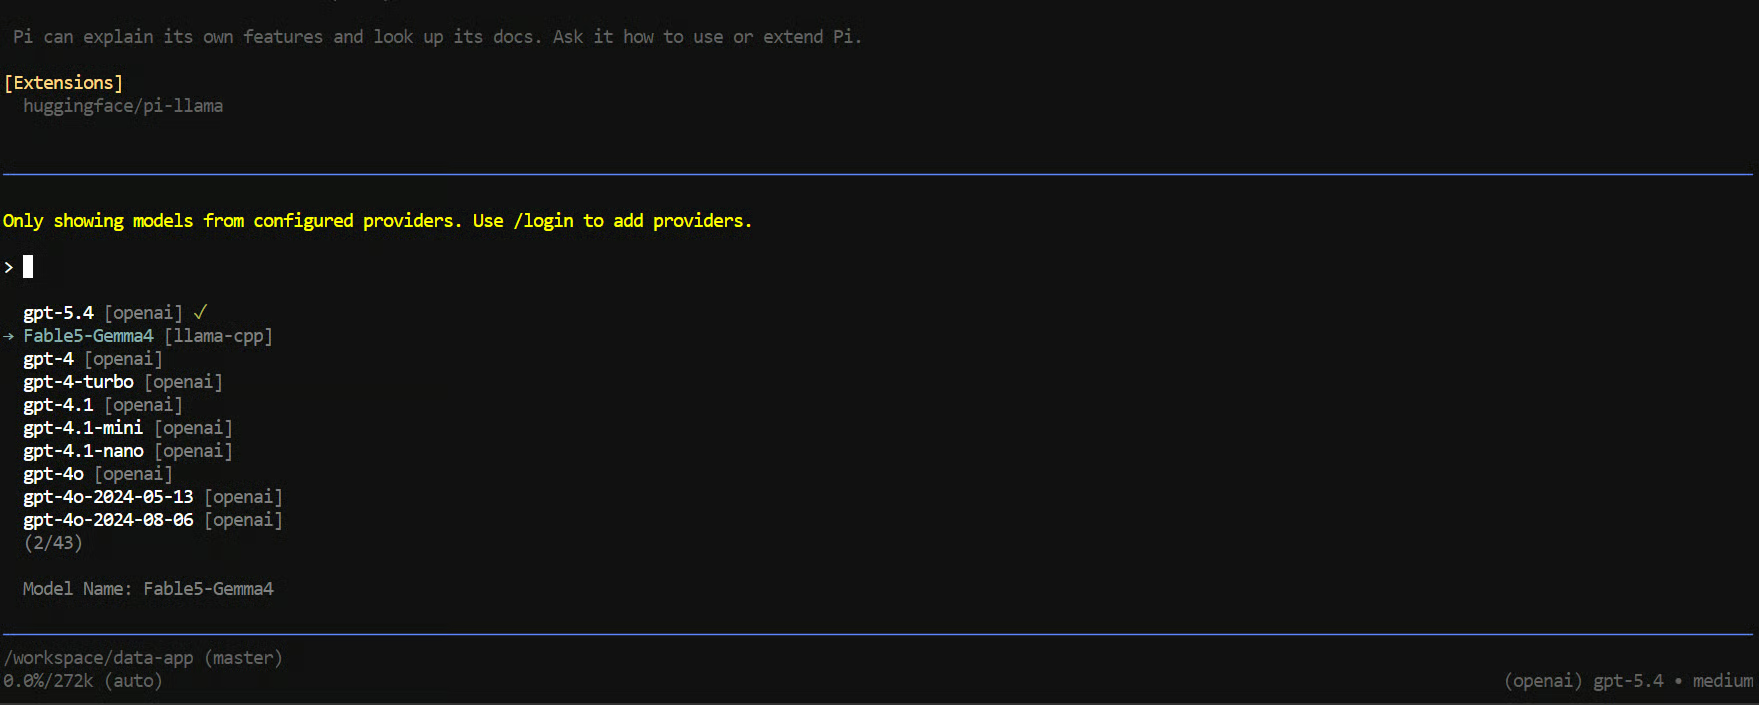
Tiếp theo, giao cho tác tử một nhiệm vụ mã hóa thực tiễn:
Create a simple data analytics dashboard using Streamlit that lets users
upload a CSV file, view the data, and explore clear visualizations.
Include a sample CSV file and test the full app to make sure it works correctly.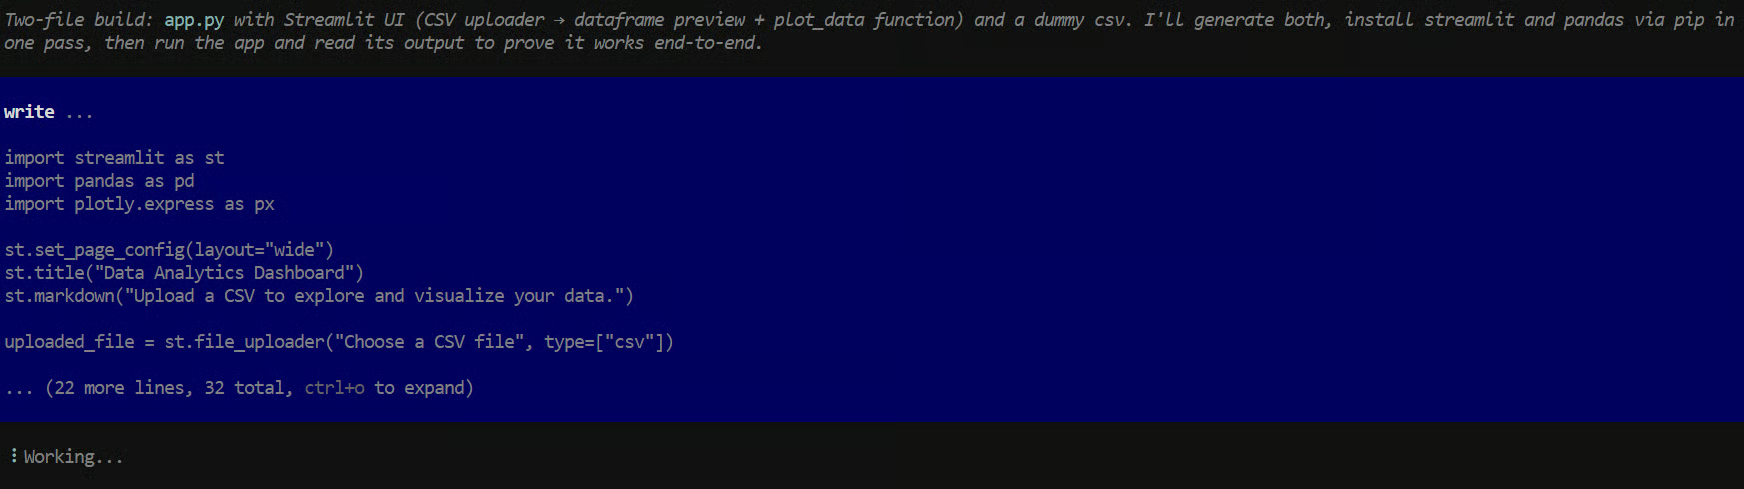
Cuối cùng mô hình đã tạo một dashboard Streamlit hoạt động, hỗ trợ tải CSV và trực quan hóa.
Tuy nhiên, quá trình này khó khăn hơn nhiều so với kỳ vọng.
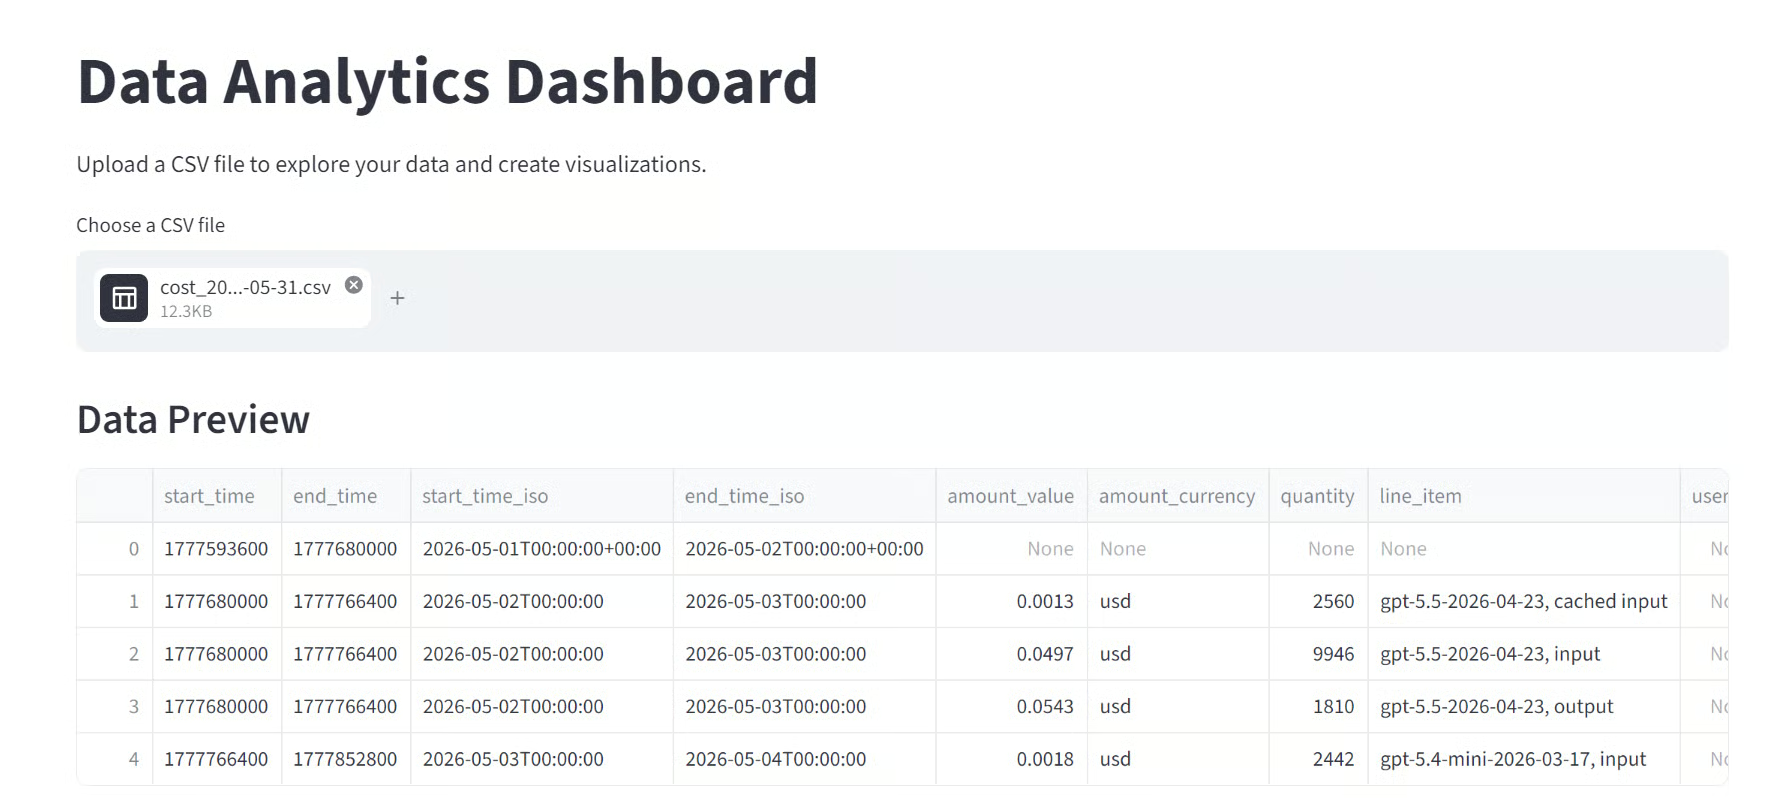
Mô hình liên tục gặp khó với lời gọi công cụ, lệnh terminal và ghi tệp dự án.
Nó thường không hoàn tất hành động kế tiếp sau khi đã lập kế hoạch, nên tôi phải liên tục hướng dẫn xử lý lỗi và chạy lại lệnh.
Tôi không thể xác nhận vấn đề do mô hình, do tích hợp Pi, do quyền cục bộ hay là kết hợp các yếu tố này.
Sau khoảng 20 phút thử lại, nó tạo ra kết quả hoạt động. Với một tác vụ Streamlit khá đơn giản, điều này là quá chậm và thiếu ổn định.
Cùng tác vụ này chỉ mất khoảng một phút với GLM 5.2 trong thử nghiệm riêng của tôi.
Việc so sánh mô hình cục bộ 12B với mô hình tuyến đầu lớn hơn là không hoàn toàn công bằng.
Tuy vậy, khoảng cách vẫn rất rõ ràng.
Fable 5-Enhanced Gemma 4 có thể tạo mã trau chuốt và đầu ra đơn lượt mạnh, nhưng hiệu năng tác tử thực sự thiếu ổn định trong thử nghiệm này. Nó cần quá nhiều can thiệp cho một tác vụ mà một tác tử mã hóa có năng lực nên hoàn thành nhanh và tự chủ.
Kết luận của tôi là mô hình này thú vị cho việc thử nghiệm cục bộ, sinh mã riêng tư và các quy trình gọn nhẹ.
Nhưng dựa trên thử nghiệm này, tôi chưa khuyến nghị dựa vào nó cho các tác vụ tác tử mã hóa nhiều bước yêu cầu độ tin cậy.
Mặc dù hướng dẫn này cung cấp cách đơn giản để thử mô hình, bạn có thể gặp vấn đề tùy vào phần cứng, thiết lập cục bộ và bản build llama.cpp.
Nếu máy chủ sập khi nạp mô hình nháp MTP và hiển thị lỗi như:
invalid vector subscriptVấn đề có thể do bản build llama.cpp của bạn, không phải tệp mô hình.
Kho mô hình báo rằng bản build llama.cpp b9553 hoạt động với mô hình nháp Gemma 4 MTP, trong khi các bản mới hơn như b9702 và b9717 có thể lỗi khi nạp mô hình nháp.
Giải pháp nhanh: bỏ các tham số MTP khỏi lệnh máy chủ và chỉ chạy mô hình chính. Mô hình vẫn hoạt động, nhưng tốc độ sinh có thể chậm hơn.
Bỏ các dòng sau:
--model-draft "$MODEL_DIR/MTP/gemma-4-12B-it-MTP-Q8_0.gguf"
--spec-type draft-mtp
--spec-draft-n-max 2
-ngld 99Nếu bạn thấy các token như <|tool_call> hoặc <|channel> trong phản hồi, client không áp dụng đúng định dạng lời gọi công cụ gốc của Gemma 4.
Hãy chắc chắn lệnh máy chủ của bạn có:
--jinjaSau đó khởi động lại máy chủ. Lệnh này áp dụng đúng mẫu chat cho suy luận và lời gọi công cụ có cấu trúc của mô hình.
Đầu tiên, kiểm tra máy chủ llama.cpp vẫn đang chạy:
curl http://127.0.0.1:8910/v1/modelsBạn sẽ thấy Fable5-Gemma4 trong phản hồi.
Tiếp theo, đảm bảo Pi trỏ tới cổng 8910 thay vì cổng mặc định 8080 của llama.cpp:
export LLAMA_BASE_URL="http://127.0.0.1:8910/v1"
pi
Chạy cả hai lệnh trong cùng một phiên terminal.
Khởi chạy Pi bên trong một thư mục dự án có quyền ghi:
cd /workspace/data-app
pi
Bạn có thể kiểm tra thư mục hiện tại có cho phép tạo tệp không:
touch write-test.txt && rm write-test.txtNếu lệnh này thất bại, vấn đề là quyền workspace chứ không phải mô hình. Hãy chuyển tới thư mục có quyền ghi trước khi khởi chạy Pi.
Nếu mô hình bắt đầu lặp lại văn bản, số, hoặc ký hiệu, hãy kiểm tra cài đặt sampling trong lệnh máy chủ.
Dùng các giá trị sau:
--temp 1.0 \
--top-p 0.95 \
--top-k 64 \
--repeat-penalty 1.1
Tham số phạt lặp lại đặc biệt quan trọng. Thiếu nó, mô hình có thể sinh đầu ra lặp lại hoặc sai lệch.
Cửa sổ ngữ cảnh 256K cần KV cache lớn. Nếu máy chủ hết VRAM, trước tiên hãy giảm kích thước ngữ cảnh:
--ctx-size 32768Bạn cũng có thể tắt mô hình nháp MTP để giải phóng thêm VRAM. Kiểm tra mức dùng bộ nhớ GPU hiện tại bằng:
nvidia-smiMô hình có thể sinh mã mạnh, nhưng vẫn có thể chật vật hoàn thành tác vụ dài mà không cần can thiệp. Trong thử nghiệm của tôi, đôi khi nó lập kế hoạch đúng nhưng thất bại khi chạy lệnh, ghi tệp, hoặc tiếp tục sau lỗi.
Để kết quả tốt hơn, hãy chia yêu cầu lớn thành các tác vụ nhỏ:
Điều này giúp mô hình có mục tiêu nhỏ hơn ở mỗi bước và dễ xác định hơn thất bại đến từ mô hình, Pi, máy chủ hay quyền workspace.
Tôi không nghĩ sự cường điệu quanh mô hình này là hoàn toàn hợp lý, ít nhất dựa trên thử nghiệm của tôi. Có và không có MTP, tôi nhận được gần như cùng tốc độ cho tác vụ chung. Khi làm tác vụ mã hóa, MTP có ích và tôi thấy tăng tốc khoảng 20% đến 30%. Điều đó hữu ích, nhưng không khắc phục vấn đề lớn hơn: độ tin cậy.
Tôi cũng thử mô hình trong WebUI.
Đôi khi, trong khi viết mã cho một tệp, nó đột ngột dừng mà không rõ lý do. Khi tôi yêu cầu tiếp tục, nó viết phần tiếp theo như văn bản trong phản hồi chat kế tiếp thay vì thực sự tiếp tục tệp.
Tôi cũng nhận thấy bật suy nghĩ đôi lúc làm đầu ra tệ hơn, điều này khá bất ngờ.
Tôi cũng thử với Claude Code, và trải nghiệm còn bực bội hơn.
Mô hình liên tục tạo thêm tệp phụ, tệp tạm và những thứ không liên quan mà một dự án đơn giản không cần. Cuối cùng nó hoàn thành, nhưng mất quá nhiều hướng dẫn và thời gian.
Tôi biết việc so sánh mô hình cục bộ 12B với GPT-5.5 hay GLM 5.2 là không hoàn toàn công bằng. Nhưng ngay cả so với các mô hình cục bộ nhỏ hơn, tôi vẫn không ấn tượng.
Theo trải nghiệm của tôi, Qwen3.6 27B tốt hơn nhiều cho tác vụ mã hóa và tác tử, dù nó lớn hơn.
Hiện tại, tôi xem mô hình này là một thử nghiệm thú vị hơn là một tác tử mã hóa đáng tin cậy.
Tôi quan tâm hơn tới mô hình Qwen3.6 27B tinh chỉnh theo Fable sắp ra mắt từ cùng tác giả. Tôi cũng thấy vài nhà đóng góp mã nguồn mở khác phát hành các mô hình mã hóa chưng cất tương tự, nhưng đến nay tôi chưa thấy cải thiện lớn trong các tác vụ tác tử mã hóa thực tế.
Mô hình có thể sinh mã đẹp và đầu ra đơn lượt trau chuốt. Nhưng khi bạn yêu cầu nó làm việc như một tác tử, dùng công cụ, tạo tệp, sửa lỗi và xác minh kết quả, trải nghiệm vẫn thiếu nhất quán và gây nản.
Khóa học hàng đầu trên DataCamp
Khóa học
Khóa học
Lộ trình