
Program
Pengembangan Model Bahasa Besar
16 jam
HumanEval adalah dataset tolok ukur yang dikembangkan oleh OpenAI untuk mengevaluasi kinerja model bahasa berskala besar (LLM) dalam tugas pembuatan kode. Dataset ini telah menjadi alat penting untuk menilai kemampuan model AI dalam memahami dan menghasilkan kode.
Dalam tutorial ini, kita akan mempelajari HumanEval dan metrik pass@k. Selain itu, kita akan mengevaluasi kemampuan generasi kode dari model codeparrot-small pada 164 masalah.
Untuk proses evaluasi HumanEval, kita akan menggunakan ekosistem Hugging Face untuk memuat dataset, model, dan metrik yang diperlukan. Jika Anda masih baru di dunia LLM dan semua yang dapat dicapainya, lihat kursus Developing Large Language Models kami.
Gambar oleh Penulis
HumanEval dikembangkan oleh OpenAI sebagai dataset evaluasi yang dirancang khusus untuk model bahasa berskala besar. Dataset ini berfungsi sebagai tolok ukur referensi untuk mengevaluasi LLM pada tugas pembuatan kode, dengan fokus pada kemampuan model untuk memahami bahasa, bernalar, dan menyelesaikan masalah terkait algoritma dan matematika sederhana.
Dataset ini terdiri dari 164 masalah pemrograman yang ditulis tangan, masing-masing mencakup tanda tangan fungsi, docstring, badan fungsi, dan beberapa unit test, dengan rata-rata 7,7 pengujian per masalah.
Pada contoh di bawah, kita akan mengkloning repositori human-eval, memasang paket Python yang diperlukan, lalu menjalankan evaluasi functional correctness pada dataset contoh.
$ git clone https://github.com/kingabzpro/human-eval
$ pip install -e human-eval
$ evaluate_functional_correctness data/example_samples.jsonl --problem_file=data/example_problem.jsonl
Kita mendapatkan hasil dalam istilah pass@k, dan, dalam kasus kita, pass@1. Metrik ini menunjukkan tingkat keberhasilan model sebesar 50% pada percobaan pertama. Kita akan mempelajari metrik ini secara rinci di bagian berikutnya.
Reading samples...
6it [00:00, 2465.79it/s]
Running test suites...
100%|█████████████████████████████████████████████| 6/6 [00:03<00:00,  1.97it/s]
Writing results to data/example_samples.jsonl_results.jsonl...
100%|██████████████████████████████████████████| 6/6 [00:00<00:00, 12035.31it/s]
{'pass@1': 0.4999999999999999}
Baca blog Evaluasi LLM: Metrik, Metodologi, Praktik Terbaik untuk mempelajari cara mengevaluasi LLM menggunakan metrik utama, metodologi, dan praktik terbaik agar dapat membuat keputusan yang tepat.
HumanEval berbeda dari metrik berbasis kecocokan tradisional. HumanEval menggunakan pendekatan yang lebih praktis yang disebut 'functional correctness', yang menggunakan metrik pass@k untuk mengevaluasi probabilitas bahwa setidaknya satu dari k sampel kode teratas yang dihasilkan untuk suatu masalah lulus unit test.
Peralihan dari kemiripan teks ke functional correctness ini memberikan penilaian yang lebih bermakna atas kemampuan model dalam memecahkan tantangan pemrograman. Proses ini mirip dengan cara pengembang menguji kode mereka melalui unit testing untuk mengevaluasi kebenarannya.
Kita dapat melihat rumus matematis untuk menghitung metrik pass@k di bawah ini:
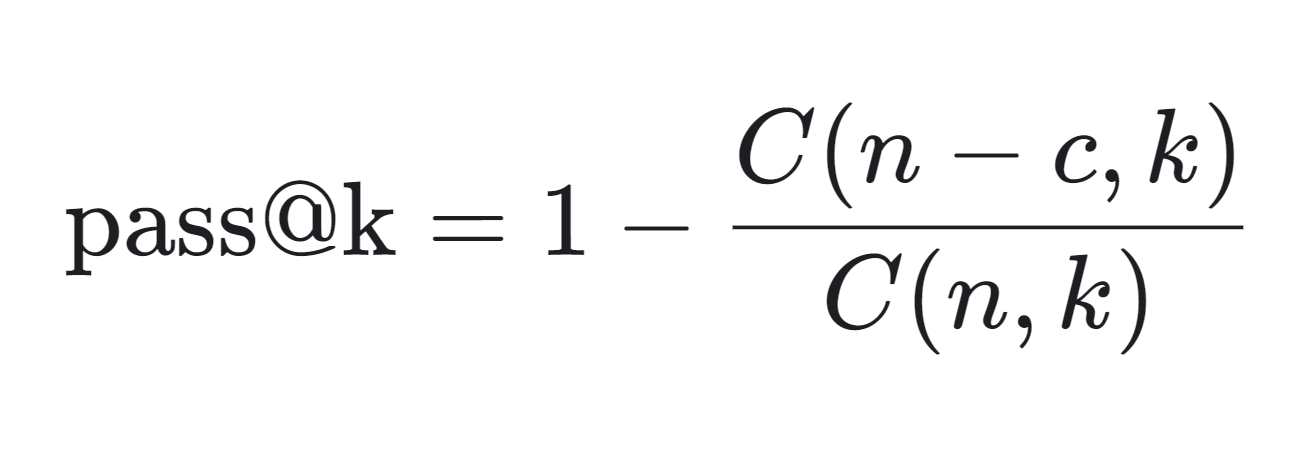
Metrik pass@k dihitung sebagai berikut:
Metrik pass@k sangat berguna untuk menilai kinerja praktis model generasi kode, karena mencerminkan kemungkinan menghasilkan solusi yang benar dalam jumlah percobaan yang terbatas.
Metrik ini banyak digunakan di lingkungan kompetitif, seperti papan peringkat yang diadakan oleh Papers with Code, di mana model diberi peringkat berdasarkan skor pass@k mereka, termasuk pass@10 dan pass@100.
HumanEval memastikan bahwa kode yang dihasilkan benar secara sintaksis dan efektif secara fungsional.
Dalam proyek ini, kita akan memuat dataset OpenAI HumanEval dan menjalankan evaluasi functional correctness pada codeparrot/codeparrot-small.
Kami memilih model generasi kode yang lebih kecil untuk waktu evaluasi yang lebih cepat karena kita akan menjalankan beberapa loop: loop luar 164 (jumlah masalah) dan loop dalam 5 (jumlah sampel yang dihasilkan untuk satu masalah).
Kita akan mulai dengan memasang Evaluate, Pustaka Python dari Hugging Face. Evaluate adalah pustaka andal yang memungkinkan Anda dengan mudah mengevaluasi model dan dataset pembelajaran mesin di berbagai domain dengan satu baris kode, memastikan konsistensi dan reprodusibilitas, baik di mesin lokal maupun dalam pengaturan pelatihan terdistribusi.
%%capture
%pip install evaluate
Selain itu, atur variabel lingkungan yang akan memungkinkan kita menjalankan evaluasi model.
import os
os.environ["HF_ALLOW_CODE_EVAL"] = "1"
os.environ["TOKENIZERS_PARALLELISM"] = "false"Kita akan memuat dataset openai_humaneval dari Hugging Face. Dataset ini berisi 164 masalah pemrograman Python dan mencakup teks alami bahasa Inggris yang ditemukan di komentar dan docstring.
Kita juga akan memuat metrik evaluasi code_eval, yang memungkinkan kita menjalankan tolok ukur HumanEval.
from datasets import load_dataset
from evaluate import load
from transformers import AutoModelForCausalLM, AutoTokenizer
import torch
from tqdm import tqdm

# Load HumanEval dataset
human_eval = load_dataset("openai_humaneval")['test']

# Load code evaluation metric
code_eval_metric = load("code_eval")Muat model dan tokenizer CodeParrot dari Hugging Face Hub. CodeParrot adalah model berbasis GPT-2 dengan 110 juta parameter yang dilatih khusus untuk menghasilkan kode Python.
# Specify the model name or path
model_name = "codeparrot/codeparrot-small"

# Load the model and tokenizer
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)
model.eval()Atur pad_token_id dan pad_token_id dan ubah ukuran embedding model jika token baru ditambahkan.
# Set pad_token_id and pad_token_id if not already set
if tokenizer.pad_token_id is None:
    tokenizer.pad_token_id = 0  # Commonly used pad token ID
if tokenizer.eos_token_id is None:
    tokenizer.eos_token_id = 2  # Commonly used eos token ID for Llama

# Ensure the tokenizer has the pad and eos tokens
if tokenizer.pad_token is None:
    tokenizer.add_special_tokens({'pad_token': '<pad>'})
if tokenizer.eos_token is None:
    tokenizer.add_special_tokens({'eos_token': '</s>'})

# Resize model embeddings if new tokens were added
if len(tokenizer) > model.config.vocab_size:
model.resize_token_embeddings(len(tokenizer))Ini adalah bagian utama tempat keajaiban terjadi. Kita akan menjalankan HumanEval untuk lima sampel per masalah, dengan total 164 masalah untuk dievaluasi. Loop luar akan mengekstrak prompt dan pengujian dari dataset. Menggunakan prompt tersebut, model akan menghasilkan lima sampel berbeda untuk masalah yang sama.
Di akhir proses ini, kita akan memiliki dua daftar: test_cases dan candidates.
Pengaturan ini memungkinkan evaluasi yang menyeluruh dan perbandingan solusi yang dihasilkan terhadap test case.
# Set the number of candidates per problem
num_samples_per_problem = 5  # Adjust as needed for pass@k computation

# Lists to store test cases and predictions
test_cases = []
candidates = []

# Create a progress bar for the outer loop (problems)
print("Generating code solutions...")
for problem in tqdm(human_eval, desc="Problems", unit="problem"):
    prompt = problem['prompt']
    test_code = problem['test']
    # Store the test cases
    test_cases.append(test_code)

    # Generate multiple candidate solutions for each problem
    problem_candidates = []

    # Create a progress bar for the inner loop (samples per problem)
    for _ in range(num_samples_per_problem):
        # Encode the prompt and get attention mask
        inputs = tokenizer(prompt, return_tensors="pt").to(device)

        # Generate code with attention mask and proper token IDs
        with torch.no_grad():
            outputs = model.generate(
                input_ids=inputs['input_ids'],
                attention_mask=inputs['attention_mask'],
                max_length=512,
                do_sample=True,
                temperature=0.7,
                top_p=0.95,
                num_return_sequences=1,
                pad_token_id=tokenizer.pad_token_id,
                eos_token_id=tokenizer.eos_token_id,
            )
        generated_code = tokenizer.decode(outputs[0], skip_special_tokens=True)
        # Remove the prompt from the generated code
        generated_code = generated_code[len(prompt):]
        problem_candidates.append(generated_code)
    # Add the candidates for the current problem
    candidates.append(problem_candidates)

print("Code generation complete.")
Keluaran:
Generating code solutions...

Problems: 100%|██████████| 164/164 [34:35<00:00, 12.66s/problem]

Code generation complete.Sekarang, kita akan menghitung tingkat kelulusan pada berbagai nilai k (1 dan 5) untuk sampel kode yang dihasilkan dengan membandingkannya terhadap test case referensi, menggunakan metrik evaluasi pass@k, lalu menampilkan tingkat keberhasilan sebagai persentase untuk setiap nilai k.
# Compute pass@k
k_values = [1, 5]
print("Evaluating generated code...")
pass_at_k, results = code_eval_metric.compute(
    references=test_cases,
    predictions=candidates,
    k=k_values,
    num_workers=4,  # Adjust based on your system
    timeout=10.0,   # Adjust the timeout as needed
)

# Print the results
for k in k_values:
    print(f"Pass@{k}: {pass_at_k[f'pass@{k}'] * 100:.2f}%")
Hasilnya menunjukkan bahwa 27,07% sampel kode yang dihasilkan lulus kriteria evaluasi saat mempertimbangkan kandidat teratas (Pass@1), sementara 65,85% lulus saat mempertimbangkan lima kandidat teratas (Pass@5). Kinerja ini tergolong baik, terutama karena kita menggunakan model bahasa yang lebih kecil untuk menghasilkan kode Python.
Namun, jika dibandingkan dengan GPT-4o, yang memiliki tingkat Pass@1 sebesar 90,2%, hasil tersebut tampak kurang memadai.
Evaluating generated code...
Pass@1: 27.07%
Pass@5: 65.85%
Jika Anda mengalami kesulitan menjalankan kode di atas, silakan periksa HumanEval dengan DeepEval di notebook Kaggle.
Anda juga dapat mempelajari cara menyederhanakan evaluasi LLM Anda dengan MLflow melalui tutorial Evaluating LLMs with MLflow.
Dataset HumanEval relatif sederhana dan mungkin hanya mewakili sebagian tantangan pemrograman dunia nyata. Selain itu, ada kekhawatiran tentang overfitting, karena model mungkin dilatih pada dataset serupa, yang dapat menyebabkan peningkatan kinerja secara khusus pada HumanEval.
Oleh karena itu, saat mengevaluasi model bahasa besar (LLM) untuk kemampuan pembuatan kode, penting untuk mempertimbangkan beberapa metrik kinerja, seperti MBPP (Mostly Basic Python Problems), ClassEval, DevQualityEval, dan lainnya.
Selesaikan AI Fundamentals skill tack dan dapatkan pengetahuan praktis tentang topik AI populer seperti ChatGPT, model bahasa besar, generative AI, dan lainnya.
Kursus AI Teratas
Program
Program
Program
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt



