
Lộ trình
Phát triển các mô hình ngôn ngữ quy mô lớn
16 giờ
HumanEval là một bộ dữ liệu chuẩn do OpenAI phát triển để đánh giá hiệu năng của các mô hình ngôn ngữ lớn (LLM) trong các tác vụ sinh mã. Đây đã trở thành công cụ quan trọng để thẩm định khả năng hiểu và tạo ra mã của các mô hình AI.
Trong hướng dẫn này, chúng ta sẽ tìm hiểu về HumanEval và chỉ số pass@k. Ngoài ra, chúng ta sẽ đánh giá khả năng sinh mã của mô hình codeparrot-small trên 164 bài toán.
Để thực hiện đánh giá HumanEval, chúng ta sẽ sử dụng hệ sinh thái Hugging Face để tải bộ dữ liệu, mô hình và các thước đo cần thiết. Nếu bạn còn khá mới với thế giới LLM và những gì chúng có thể làm được, hãy xem khóa học Developing Large Language Models của chúng tôi.
Ảnh do Tác giả cung cấp
HumanEval được OpenAI phát triển như một bộ dữ liệu đánh giá dành riêng cho các mô hình ngôn ngữ lớn. Nó đóng vai trò như bộ chuẩn tham chiếu để đánh giá LLM trên các tác vụ sinh mã, tập trung vào khả năng hiểu ngôn ngữ, suy luận và giải các bài toán liên quan đến thuật toán và toán học đơn giản.
Bộ dữ liệu gồm 164 bài toán lập trình viết tay, mỗi bài gồm chữ ký hàm, docstring, thân hàm và một số unit test, với trung bình 7,7 bài kiểm thử cho mỗi bài toán.
Trong ví dụ dưới đây, chúng ta sẽ nhân bản kho lưu trữ human-eval, cài đặt các gói Python cần thiết, rồi chạy đánh giá tính đúng đắn chức năng trên bộ dữ liệu ví dụ.
$ git clone https://github.com/kingabzpro/human-eval
$ pip install -e human-eval
$ evaluate_functional_correctness data/example_samples.jsonl --problem_file=data/example_problem.jsonl
Chúng ta nhận được kết quả theo chỉ số pass@k, và trong trường hợp này là pass@1. Chỉ số này cho biết tỷ lệ thành công 50% của mô hình ở lần thử đầu tiên. Chúng ta sẽ tìm hiểu chi tiết về chỉ số này ở phần tiếp theo.
Reading samples...
6it [00:00, 2465.79it/s]
Running test suites...
100%|█████████████████████████████████████████████| 6/6 [00:03<00:00,  1.97it/s]
Writing results to data/example_samples.jsonl_results.jsonl...
100%|██████████████████████████████████████████| 6/6 [00:00<00:00, 12035.31it/s]
{'pass@1': 0.4999999999999999}
Đọc bài viết LLM Evaluation: Metrics, Methodologies, Best Practices để tìm hiểu cách đánh giá LLM bằng các thước đo, phương pháp và thực hành tốt nhất nhằm đưa ra quyết định sáng suốt.
HumanEval khác với các thước đo đối sánh truyền thống. Nó sử dụng cách tiếp cận thực tiễn hơn gọi là "tính đúng đắn chức năng" (functional correctness), dùng chỉ số pass@k để đánh giá xác suất rằng ít nhất một trong k mẫu mã sinh ra hàng đầu cho một bài toán vượt qua các bài kiểm thử đơn vị.
Sự chuyển dịch từ độ tương đồng văn bản sang tính đúng đắn chức năng mang lại đánh giá ý nghĩa hơn về khả năng giải quyết bài toán lập trình của mô hình. Quy trình này tương tự cách các nhà phát triển kiểm thử mã của họ bằng unit test để đánh giá tính đúng đắn.
Công thức toán học để tính chỉ số pass@k như dưới đây:
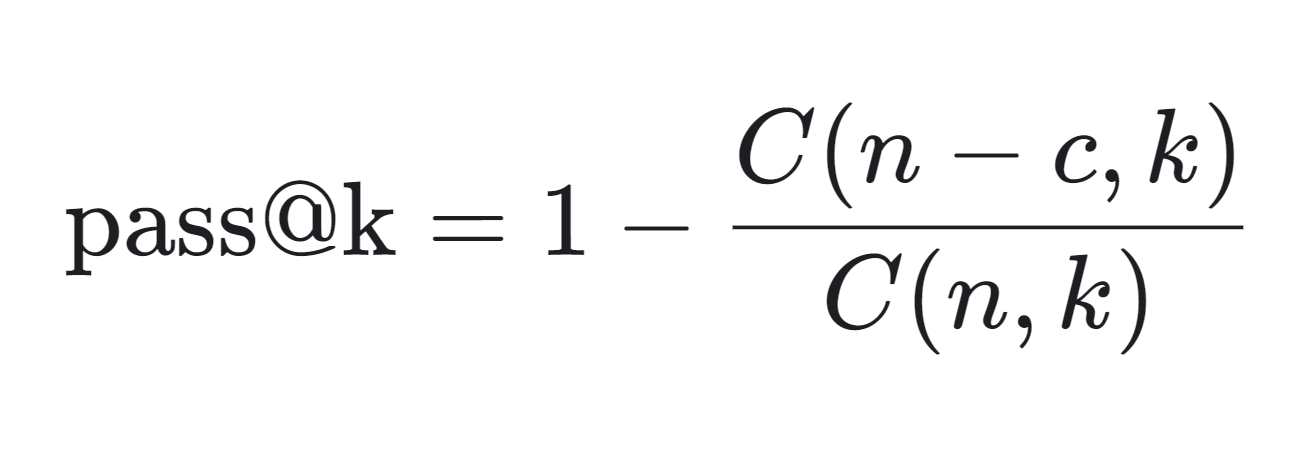
Chỉ số pass@k được tính như sau:
Chỉ số pass@k đặc biệt hữu ích khi đánh giá hiệu năng thực tế của các mô hình sinh mã, vì nó phản ánh khả năng tạo ra lời giải đúng trong một số lần thử giới hạn.
Chỉ số này được sử dụng rộng rãi trong môi trường cạnh tranh, chẳng hạn như các bảng xếp hạng do Papers with Code tổ chức, nơi các mô hình được xếp hạng dựa trên điểm pass@k, bao gồm pass@10 và pass@100.
HumanEval đảm bảo mã sinh ra đúng cú pháp và hiệu quả về mặt chức năng.
Trong dự án này, chúng ta sẽ tải bộ dữ liệu OpenAI HumanEval và chạy đánh giá tính đúng đắn chức năng trên codeparrot/codeparrot-small.
Chúng ta chọn một mô hình sinh mã nhỏ hơn để rút ngắn thời gian đánh giá vì sẽ chạy nhiều vòng lặp: vòng ngoài 164 (số bài toán) và vòng trong 5 (số mẫu sinh cho một bài toán).
Chúng ta sẽ bắt đầu bằng cách cài đặt thư viện Python Evaluate của Hugging Face. Evaluate là thư viện mạnh mẽ cho phép bạn dễ dàng đánh giá các mô hình và bộ dữ liệu máy học trên nhiều lĩnh vực chỉ với một dòng lệnh, đảm bảo tính nhất quán và khả năng tái lập, dù trên máy cục bộ hay trong thiết lập huấn luyện phân tán.
%%capture
%pip install evaluate
Đồng thời thiết lập biến môi trường để chúng ta có thể chạy đánh giá mô hình.
import os
os.environ["HF_ALLOW_CODE_EVAL"] = "1"
os.environ["TOKENIZERS_PARALLELISM"] = "false"Chúng ta sẽ tải bộ dữ liệu openai_humaneval từ Hugging Face. Bộ dữ liệu này chứa 164 bài toán lập trình Python và bao gồm văn bản tự nhiên tiếng Anh trong chú thích và docstring.
Chúng ta cũng sẽ tải thước đo đánh giá code_eval, cho phép chạy benchmark HumanEval.
from datasets import load_dataset
from evaluate import load
from transformers import AutoModelForCausalLM, AutoTokenizer
import torch
from tqdm import tqdm

# Load HumanEval dataset
human_eval = load_dataset("openai_humaneval")['test']

# Load code evaluation metric
code_eval_metric = load("code_eval")Tải mô hình và tokenizer CodeParrot từ Hugging Face Hub. CodeParrot là mô hình dựa trên GPT-2 với 110 triệu tham số, được huấn luyện chuyên biệt để sinh mã Python.
# Specify the model name or path
model_name = "codeparrot/codeparrot-small"

# Load the model and tokenizer
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)
model.eval()Thiết lập pad_token_id và pad_token_id và thay đổi kích thước embedding của mô hình nếu có thêm token mới.
# Set pad_token_id and pad_token_id if not already set
if tokenizer.pad_token_id is None:
    tokenizer.pad_token_id = 0  # Commonly used pad token ID
if tokenizer.eos_token_id is None:
    tokenizer.eos_token_id = 2  # Commonly used eos token ID for Llama

# Ensure the tokenizer has the pad and eos tokens
if tokenizer.pad_token is None:
    tokenizer.add_special_tokens({'pad_token': '<pad>'})
if tokenizer.eos_token is None:
    tokenizer.add_special_tokens({'eos_token': '</s>'})

# Resize model embeddings if new tokens were added
if len(tokenizer) > model.config.vocab_size:
model.resize_token_embeddings(len(tokenizer))Đây là phần chính nơi mọi thứ diễn ra. Chúng ta sẽ chạy HumanEval với năm mẫu cho mỗi bài toán, tổng cộng 164 bài toán để đánh giá. Vòng lặp ngoài sẽ trích xuất prompt và test từ bộ dữ liệu. Dựa trên prompt, mô hình sẽ sinh năm mẫu khác nhau cho cùng một bài toán.
Kết thúc quá trình này, chúng ta sẽ có hai danh sách: test_cases và candidates.
Thiết lập này cho phép đánh giá toàn diện và so sánh các lời giải sinh ra với các ca kiểm thử.
# Set the number of candidates per problem
num_samples_per_problem = 5  # Adjust as needed for pass@k computation

# Lists to store test cases and predictions
test_cases = []
candidates = []

# Create a progress bar for the outer loop (problems)
print("Generating code solutions...")
for problem in tqdm(human_eval, desc="Problems", unit="problem"):
    prompt = problem['prompt']
    test_code = problem['test']
    # Store the test cases
    test_cases.append(test_code)

    # Generate multiple candidate solutions for each problem
    problem_candidates = []

    # Create a progress bar for the inner loop (samples per problem)
    for _ in range(num_samples_per_problem):
        # Encode the prompt and get attention mask
        inputs = tokenizer(prompt, return_tensors="pt").to(device)

        # Generate code with attention mask and proper token IDs
        with torch.no_grad():
            outputs = model.generate(
                input_ids=inputs['input_ids'],
                attention_mask=inputs['attention_mask'],
                max_length=512,
                do_sample=True,
                temperature=0.7,
                top_p=0.95,
                num_return_sequences=1,
                pad_token_id=tokenizer.pad_token_id,
                eos_token_id=tokenizer.eos_token_id,
            )
        generated_code = tokenizer.decode(outputs[0], skip_special_tokens=True)
        # Remove the prompt from the generated code
        generated_code = generated_code[len(prompt):]
        problem_candidates.append(generated_code)
    # Add the candidates for the current problem
    candidates.append(problem_candidates)

print("Code generation complete.")
Đầu ra:
Generating code solutions...

Problems: 100%|██████████| 164/164 [34:35<00:00, 12.66s/problem]

Code generation complete.Giờ đây, chúng ta sẽ tính tỉ lệ pass ở các giá trị k khác nhau (1 và 5) cho các mẫu mã được sinh bằng cách so sánh với các ca kiểm thử tham chiếu, sử dụng thước đo pass@k, rồi xuất tỉ lệ thành công dưới dạng phần trăm cho mỗi giá trị k.
# Compute pass@k
k_values = [1, 5]
print("Evaluating generated code...")
pass_at_k, results = code_eval_metric.compute(
    references=test_cases,
    predictions=candidates,
    k=k_values,
    num_workers=4,  # Adjust based on your system
    timeout=10.0,   # Adjust the timeout as needed
)

# Print the results
for k in k_values:
    print(f"Pass@{k}: {pass_at_k[f'pass@{k}'] * 100:.2f}%")
Kết quả cho thấy 27,07% mẫu mã sinh ra vượt qua tiêu chí đánh giá khi xét ứng viên hàng đầu (Pass@1), trong khi 65,85% vượt qua khi xét năm ứng viên hàng đầu (Pass@5). Đây là hiệu năng khá tốt, đặc biệt vì chúng ta dùng một mô hình ngôn ngữ nhỏ để sinh mã Python.
Tuy nhiên, so với GPT-4o có Pass@1 đạt 90,2%, kết quả này còn hạn chế.
Evaluating generated code...
Pass@1: 27.07%
Pass@5: 65.85%
Nếu bạn gặp khó khăn khi chạy mã trên, vui lòng xem HumanEval với DeepEval trên sổ tay Kaggle.
Bạn cũng có thể học cách tinh gọn quy trình đánh giá LLM với MLflow bằng cách làm theo hướng dẫn Evaluating LLMs with MLflow.
Bộ dữ liệu HumanEval tương đối đơn giản và có thể chỉ phần nào đại diện cho các thách thức lập trình trong thực tế. Ngoài ra, còn có lo ngại về hiện tượng overfitting, vì các mô hình có thể được huấn luyện trên các bộ dữ liệu tương tự, dẫn đến hiệu năng cải thiện riêng trên HumanEval.
Vì vậy, khi đánh giá các mô hình ngôn ngữ lớn (LLM) về khả năng sinh mã, điều quan trọng là xem xét nhiều thước đo hiệu năng, như MBPP (Mostly Basic Python Problems), ClassEval, DevQualityEval, và các thước đo khác.
Hoàn thành AI Fundamentals skill track và nhận kiến thức thực tiễn về các chủ đề AI phổ biến như ChatGPT, mô hình ngôn ngữ lớn, generative AI, và hơn thế nữa.
Các khóa học AI hàng đầu
Lộ trình
Lộ trình
Lộ trình
blog
Matt Crabtree
10 phút
