
Program
Büyük Dil Modelleri Geliştirme
16 sa
HumanEval, OpenAI tarafından geliştirilen ve büyük dil modellerinin (LLM’ler) kod üretme görevlerindeki performansını değerlendiren bir karşılaştırma veri kümesidir. Yapay zekâ modellerinin kodu anlama ve üretme yeteneklerini değerlendirmede önemli bir araç haline gelmiştir.
Bu eğitimde HumanEval ve pass@k metriğini öğreneceğiz. Ayrıca, codeparrot-small modelinin 164 problem üzerindeki kod üretme yeteneklerini değerlendireceğiz.
HumanEval değerlendirme sürecinde veri kümesini, modeli ve gerekli metrikleri yüklemek için Hugging Face ekosistemini kullanacağız. LLM dünyasına ve neler başarabileceklerine görece yeniyseniz, Geniş Dil Modelleri Geliştirme kursumuza göz atın.
Görsel: Yazar
HumanEval, özellikle büyük dil modelleri için tasarlanmış bir değerlendirme veri kümesi olarak OpenAI tarafından geliştirilmiştir. Modellerin dili kavrama, akıl yürütme ve algoritmalar ile basit matematikle ilgili problemleri çözme yeteneklerine odaklanarak, LLM’lerin kod üretme görevlerinde değerlendirilmesi için başvuru niteliğinde bir karşılaştırma sağlar.
Veri kümesi, her biri bir fonksiyon imzası, docstring, gövde ve ortalama 7,7 test olmak üzere birkaç birim testi içeren, el yazımı 164 programlama probleminden oluşur.
Aşağıdaki örnekte, insan değerlendirme deposunu klonlayacak, gerekli Python paketlerini kuracak ve ardından örnek veri kümesi üzerinde işlevsel doğruluk değerlendirmesini çalıştıracağız.
$ git clone https://github.com/kingabzpro/human-eval
$ pip install -e human-eval
$ evaluate_functional_correctness data/example_samples.jsonl --problem_file=data/example_problem.jsonl
Sonucu pass@k, özelde de pass@1 cinsinden aldık. Bu metrik, modelin ilk denemede yüzde 50 başarı oranını gösterir. Bir sonraki bölümde bu metriği ayrıntılı olarak öğreneceğiz.
Reading samples...
6it [00:00, 2465.79it/s]
Running test suites...
100%|█████████████████████████████████████████████| 6/6 [00:03<00:00,  1.97it/s]
Writing results to data/example_samples.jsonl_results.jsonl...
100%|██████████████████████████████████████████| 6/6 [00:00<00:00, 12035.31it/s]
{'pass@1': 0.4999999999999999}
Bilgiye dayalı kararlar almak için temel metrikler, metodolojiler ve en iyi uygulamalarla LLM’leri nasıl değerlendireceğinizi öğrenmek üzere LLM Değerlendirme: Metrikler, Metodolojiler, En İyi Uygulamalar blog yazısını okuyun.
HumanEval, geleneksel eşleşme tabanlı metriklerden farklıdır. "İşlevsel doğruluk" adı verilen daha pratik bir yaklaşım kullanır. Bu yaklaşım, bir problem için üretilen en iyi k kod örneğinden en az birinin birim testlerini geçme olasılığını değerlendirmek üzere pass@k metriğinden yararlanır.
Metnin benzerliğinden işlevsel doğruluğa geçiş, bir modelin programlama zorluklarını çözme becerisinin daha anlamlı bir değerlendirmesini sağlar. Bu süreç, geliştiricilerin kodlarının doğruluğunu değerlendirmek için birim testleriyle test etmelerine benzer.
Aşağıda pass@k metriğinin hesaplanmasına ilişkin matematiksel formülü görebiliriz:
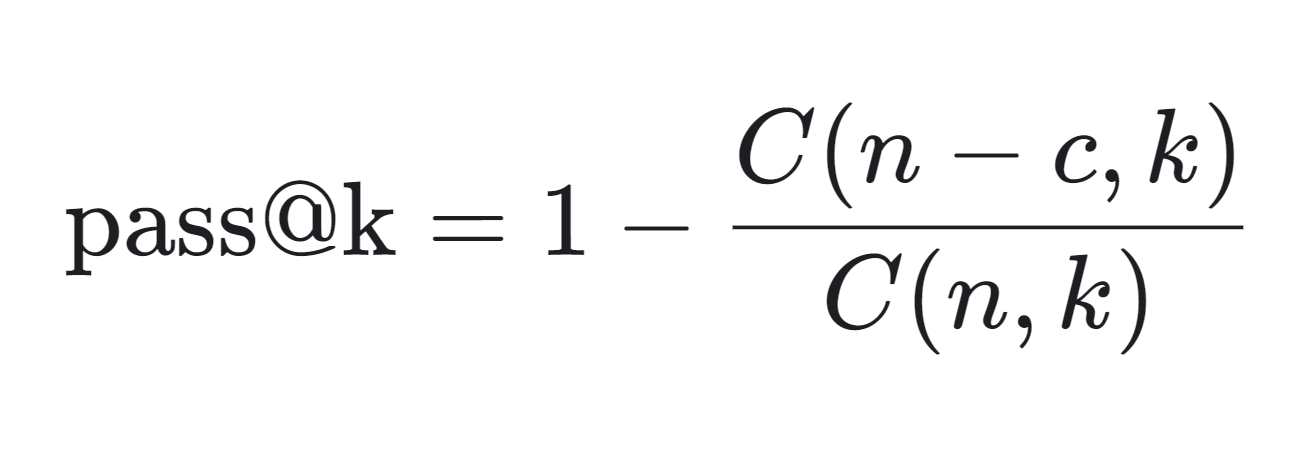
Pass@k metriği şu şekilde hesaplanır:
Pass@k metriği, sınırlı sayıda denemede doğru bir çözüm üretme olasılığını yansıttığı için, kod üretme modellerinin pratik performansını değerlendirmede özellikle faydalıdır.
Metrik, Papers with Code gibi lider tablolarının bulunduğu rekabetçi ortamlarda yaygın olarak kullanılır; burada modeller pass@10 ve pass@100 dahil pass@k puanlarına göre sıralanır.
HumanEval, üretilen kodun sözdizimsel olarak doğru ve işlevsel olarak etkin olmasını sağlar.
Bu projede, OpenAI HumanEval veri kümesini yükleyecek ve codeparrot/codeparrot-small üzerinde işlevsel doğruluk değerlendirmesini çalıştıracağız.
Dış döngü 164 (Problem sayısı) ve iç döngü 5 (tek bir problem için üretilen örnek sayısı) olacağı için, değerlendirme süresini hızlandırmak amacıyla daha küçük bir kod üretme modeli seçiyoruz.
Hugging Face’in Evaluate Python kütüphanesini kurarak başlayacağız. Evaluate, makine öğrenimi modellerini ve veri kümelerini tek satırlık kodla çeşitli alanlarda kolayca değerlendirmenizi sağlayan, yerel makinelerden dağıtık eğitim kurulumlarına kadar tutarlılık ve yeniden üretilebilirlik sunan güçlü bir kütüphanedir.
%%capture
%pip install evaluate
Ayrıca, model değerlendirmesini çalıştırmamıza imkân tanıyacak bir ortam değişkeni ayarlayın.
import os
os.environ["HF_ALLOW_CODE_EVAL"] = "1"
os.environ["TOKENIZERS_PARALLELISM"] = "false"openai_humaneval veri kümesini Hugging Face’ten yükleyeceğiz. Bu veri kümesi, Python’da 164 programlama problemi içerir ve yorumlarda ve docstring’lerde bulunan İngilizce doğal metni kapsar.
Ayrıca, HumanEval karşılaştırmasını çalıştırmamıza olanak tanıyan code_eval değerlendirme metriğini de yükleyeceğiz.
from datasets import load_dataset
from evaluate import load
from transformers import AutoModelForCausalLM, AutoTokenizer
import torch
from tqdm import tqdm

# Load HumanEval dataset
human_eval = load_dataset("openai_humaneval")['test']

# Load code evaluation metric
code_eval_metric = load("code_eval")CodeParrot modelini ve belirteçleyicisini Hugging Face Hub’dan yükleyin. CodeParrot, özellikle Python kodu üretmek üzere eğitilmiş, 110 milyon parametreli GPT-2 tabanlı bir modeldir.
# Specify the model name or path
model_name = "codeparrot/codeparrot-small"

# Load the model and tokenizer
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)
model.eval()pad_token_id ve pad_token_id değerlerini ayarlayın ve yeni belirteçler eklenmişse model gömmelerini yeniden boyutlandırın.
# Set pad_token_id and pad_token_id if not already set
if tokenizer.pad_token_id is None:
    tokenizer.pad_token_id = 0  # Commonly used pad token ID
if tokenizer.eos_token_id is None:
    tokenizer.eos_token_id = 2  # Commonly used eos token ID for Llama

# Ensure the tokenizer has the pad and eos tokens
if tokenizer.pad_token is None:
    tokenizer.add_special_tokens({'pad_token': '<pad>'})
if tokenizer.eos_token is None:
    tokenizer.add_special_tokens({'eos_token': '</s>'})

# Resize model embeddings if new tokens were added
if len(tokenizer) > model.config.vocab_size:
model.resize_token_embeddings(len(tokenizer))Büyünün gerçekleştiği ana bölüm burası. Değerlendirmek üzere toplam 164 problem için, problem başına beş örnekle HumanEval’ı çalıştıracağız. Dış döngü, veri kümesinden komutu ve testi çıkarır. Komutu kullanarak aynı problem için beş farklı örnek üretilir.
Bu sürecin sonunda iki listemiz olacak: test_cases ve candidates.
Bu kurulum, üretilen çözümlerin test vakalarına karşı kapsamlı bir şekilde değerlendirilmesine ve karşılaştırılmasına olanak tanır.
# Set the number of candidates per problem
num_samples_per_problem = 5  # Adjust as needed for pass@k computation

# Lists to store test cases and predictions
test_cases = []
candidates = []

# Create a progress bar for the outer loop (problems)
print("Generating code solutions...")
for problem in tqdm(human_eval, desc="Problems", unit="problem"):
    prompt = problem['prompt']
    test_code = problem['test']
    # Store the test cases
    test_cases.append(test_code)

    # Generate multiple candidate solutions for each problem
    problem_candidates = []

    # Create a progress bar for the inner loop (samples per problem)
    for _ in range(num_samples_per_problem):
        # Encode the prompt and get attention mask
        inputs = tokenizer(prompt, return_tensors="pt").to(device)

        # Generate code with attention mask and proper token IDs
        with torch.no_grad():
            outputs = model.generate(
                input_ids=inputs['input_ids'],
                attention_mask=inputs['attention_mask'],
                max_length=512,
                do_sample=True,
                temperature=0.7,
                top_p=0.95,
                num_return_sequences=1,
                pad_token_id=tokenizer.pad_token_id,
                eos_token_id=tokenizer.eos_token_id,
            )
        generated_code = tokenizer.decode(outputs[0], skip_special_tokens=True)
        # Remove the prompt from the generated code
        generated_code = generated_code[len(prompt):]
        problem_candidates.append(generated_code)
    # Add the candidates for the current problem
    candidates.append(problem_candidates)

print("Code generation complete.")
Çıktı:
Generating code solutions...

Problems: 100%|██████████| 164/164 [34:35<00:00, 12.66s/problem]

Code generation complete.Şimdi, üretilen kod örneklerini başvuru test vakalarına karşı karşılaştırarak, pass@k değerlendirme metriğini kullanarak k’nin farklı değerleri (1 ve 5) için geçiş oranını hesaplayacak ve her k değeri için başarı oranını yüzde olarak çıktılacağız.
# Compute pass@k
k_values = [1, 5]
print("Evaluating generated code...")
pass_at_k, results = code_eval_metric.compute(
    references=test_cases,
    predictions=candidates,
    k=k_values,
    num_workers=4,  # Adjust based on your system
    timeout=10.0,   # Adjust the timeout as needed
)

# Print the results
for k in k_values:
    print(f"Pass@{k}: {pass_at_k[f'pass@{k}'] * 100:.2f}%")
Sonuçlar, en iyi adayı dikkate aldığımızda (Pass@1) üretilen kod örneklerinin %27,07’sinin değerlendirme ölçütlerini geçtiğini, en iyi beş adayı dikkate aldığımızda ise (Pass@5) %65,85’inin geçtiğini gösteriyor. Python kodu üretmek için daha küçük bir dil modeli kullandığımız düşünülürse, bu performans iyi kabul edilebilir.
Bununla birlikte, Pass@1 oranı %90,2 olan GPT-4o ile karşılaştırıldığında sonuçlar yetersiz görünmektedir.
Evaluating generated code...
Pass@1: 27.07%
Pass@5: 65.85%
Yukarıdaki kodu çalıştırırken sorun yaşıyorsanız, lütfen DeepEval ile HumanEval Kaggle defterine bakın.
Ayrıca, MLflow ile LLM’leri Değerlendirme eğitimini takip ederek LLM değerlendirmelerinizi nasıl kolaylaştıracağınızı öğrenebilirsiniz.
HumanEval veri kümesi nispeten basittir ve gerçek dünya programlama zorluklarını yalnızca kısmen temsil edebilir. Ayrıca, modellerin benzer veri kümeleri üzerinde eğitilmiş olabileceği ve bunun özellikle HumanEval üzerinde performansı artırabileceği için aşırı uyumla (overfitting) ilgili endişeler de bulunmaktadır.
Bu nedenle, kod üretme yetenekleri için büyük dil modellerini (LLM’ler) değerlendirirken MBPP (Mostly Basic Python Problems), ClassEval, DevQualityEval ve diğerleri gibi birden çok performans metriğini dikkate almak önemlidir.
AI Fundamentals beceri yolunu tamamlayın ve ChatGPT, geniş dil modelleri, üretken yapay zekâ ve daha fazlası gibi popüler yapay zekâ konularında uygulanabilir bilgi edinin.
En İyi Yapay Zekâ Kursları
Program
Program
Program
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




