
Leerpad
Grote taalmodellen ontwikkelen
16 uur
HumanEval is een benchmarkdataset ontwikkeld door OpenAI die de prestaties van grote taalmodellen (LLM’s) bij codegeneratietaken evalueert. Het is uitgegroeid tot een belangrijk hulpmiddel om te beoordelen in hoeverre AI-modellen code begrijpen en genereren.
In deze tutorial leren we over HumanEval en de pass@k-metriek. Daarnaast evalueren we de codegeneratiecapaciteiten van het codeparrot-small-model op 164 problemen.
Voor het HumanEval-evaluatieproces gebruiken we het Hugging Face-ecosysteem om de dataset, het model en de benodigde metriek te laden. Ben je relatief nieuw in de wereld van LLM’s en alles wat ze kunnen? Bekijk dan onze cursus Developing Large Language Models.
Afbeelding door de auteur
HumanEval is ontwikkeld door OpenAI als een evaluatiedataset die speciaal is ontworpen voor grote taalmodellen. Het fungeert als referentiebenchmark voor het evalueren van LLM’s op codegeneratietaken, met focus op het vermogen van modellen om taal te begrijpen, te redeneren en problemen op te lossen die te maken hebben met algoritmen en eenvoudige wiskunde.
De dataset bestaat uit 164 handgeschreven programmeerproblemen, elk met een functiedefinitie, docstring, body en meerdere unittests, met gemiddeld 7,7 tests per probleem.
In het onderstaande voorbeeld klonen we de human-eval-repository, installeren we de benodigde Python-pakketten en draaien we vervolgens de evaluatie van functionele correctheid op de voorbeeldset.
$ git clone https://github.com/kingabzpro/human-eval
$ pip install -e human-eval
$ evaluate_functional_correctness data/example_samples.jsonl --problem_file=data/example_problem.jsonl
We kregen het resultaat in termen van pass@k en in ons geval pass@1. Deze metriek geeft een slagingskans van 50% op de eerste poging aan. We leren in de volgende sectie meer over deze metriek.
Reading samples...
6it [00:00, 2465.79it/s]
Running test suites...
100%|█████████████████████████████████████████████| 6/6 [00:03<00:00,  1.97it/s]
Writing results to data/example_samples.jsonl_results.jsonl...
100%|██████████████████████████████████████████| 6/6 [00:00<00:00, 12035.31it/s]
{'pass@1': 0.4999999999999999}
Lees de blog LLM Evaluation: Metrics, Methodologies, Best Practices om te leren hoe je LLM’s evalueert met kernmetriek, methodologieën en best practices om doordachte beslissingen te nemen.
HumanEval verschilt van traditionele, op overeenkomsten gebaseerde metriek. Het gebruikt een meer praktische benadering, ‘functionele correctheid’, die de pass@k-metriek gebruikt om de kans te evalueren dat ten minste één van de top k gegenereerde codevoorbeelden voor een probleem de unittests doorstaat.
Deze verschuiving van tekstgelijkheid naar functionele correctheid biedt een betekenisvollere beoordeling van het vermogen van een model om programmeeruitdagingen op te lossen. Dit proces lijkt op hoe ontwikkelaars hun code testen met unittests om de correctheid te beoordelen.
Hieronder zie je de wiskundige formule voor het berekenen van de pass@k-metriek:
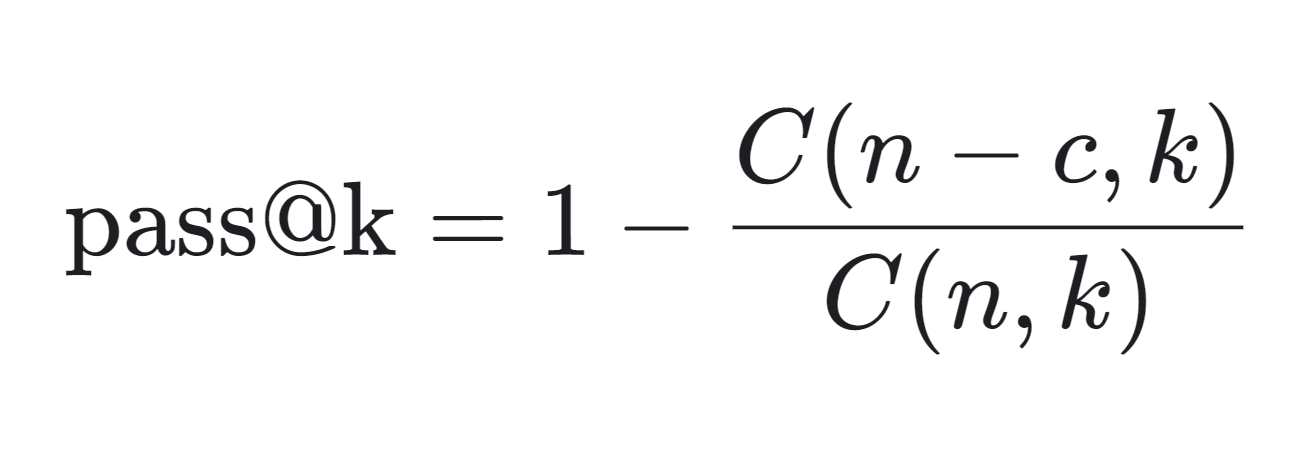
De pass@k-metriek wordt als volgt berekend:
De pass@k-metriek is bijzonder nuttig om de praktische prestaties van codegeneratiemodellen te beoordelen, omdat het de kans weerspiegelt om binnen een beperkt aantal pogingen een correcte oplossing te genereren.
De metriek wordt veel gebruikt in competitieve omgevingen, zoals leaderboards gehost door Papers with Code, waar modellen worden gerangschikt op basis van hun pass@k-scores, waaronder pass@10 en pass@100.
HumanEval zorgt ervoor dat de gegenereerde code syntactisch correct en functioneel effectief is.
In dit project laden we de OpenAI HumanEval-dataset en draaien we de evaluatie van functionele correctheid op de codeparrot/codeparrot-small.
We kiezen een kleiner codegeneratiemodel voor een snellere evaluatietijd, omdat we meerdere lussen gaan draaien: buitenlus 164 (aantal problemen) en binnenlus 5 (aantal gegenereerde samples per probleem).
We beginnen met het installeren van de Evaluate-Pythonbibliotheek van Hugging Face. Evaluate is een krachtige bibliotheek waarmee je met één regel code eenvoudig machinelearningmodellen en -datasets kunt evalueren in verschillende domeinen, met consistentie en reproduceerbaarheid, zowel lokaal als in gedistribueerde trainingsopstellingen.
%%capture
%pip install evaluate
Stel ook een omgevingsvariabele in die ons in staat stelt de modelevaluatie uit te voeren.
import os
os.environ["HF_ALLOW_CODE_EVAL"] = "1"
os.environ["TOKENIZERS_PARALLELISM"] = "false"We laden de openai_humaneval-dataset van Hugging Face. Deze dataset bevat 164 Python-programmeerproblemen en omvat Engelse natuurlijke tekst in comments en docstrings.
We laden ook de code_eval-evaluatiemetriek, zodat we de HumanEval-benchmark kunnen draaien.
from datasets import load_dataset
from evaluate import load
from transformers import AutoModelForCausalLM, AutoTokenizer
import torch
from tqdm import tqdm

# Load HumanEval dataset
human_eval = load_dataset("openai_humaneval")['test']

# Load code evaluation metric
code_eval_metric = load("code_eval")Laad het CodeParrot-model en de tokenizer van de Hugging Face Hub. CodeParrot is een op GPT-2 gebaseerd model met 110 miljoen parameters, specifiek getraind om Python-code te genereren.
# Specify the model name or path
model_name = "codeparrot/codeparrot-small"

# Load the model and tokenizer
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)
model.eval()Stel de pad_token_id en pad_token_id in en wijzig de model-embeddings als er nieuwe tokens zijn toegevoegd.
# Set pad_token_id and pad_token_id if not already set
if tokenizer.pad_token_id is None:
    tokenizer.pad_token_id = 0  # Commonly used pad token ID
if tokenizer.eos_token_id is None:
    tokenizer.eos_token_id = 2  # Commonly used eos token ID for Llama

# Ensure the tokenizer has the pad and eos tokens
if tokenizer.pad_token is None:
    tokenizer.add_special_tokens({'pad_token': '<pad>'})
if tokenizer.eos_token is None:
    tokenizer.add_special_tokens({'eos_token': '</s>'})

# Resize model embeddings if new tokens were added
if len(tokenizer) > model.config.vocab_size:
model.resize_token_embeddings(len(tokenizer))Dit is de hoofdsectie waar de magie gebeurt. We draaien HumanEval voor vijf samples per probleem, met in totaal 164 problemen om te evalueren. De buitenlus haalt de prompt en de test uit de dataset. Met behulp van de prompt worden vijf verschillende samples voor hetzelfde probleem gegenereerd.
Aan het einde van dit proces hebben we twee lijsten: test_cases en candidates.
Deze opzet maakt een uitgebreide evaluatie en vergelijking van de gegenereerde oplossingen met de testcases mogelijk.
# Set the number of candidates per problem
num_samples_per_problem = 5  # Adjust as needed for pass@k computation

# Lists to store test cases and predictions
test_cases = []
candidates = []

# Create a progress bar for the outer loop (problems)
print("Generating code solutions...")
for problem in tqdm(human_eval, desc="Problems", unit="problem"):
    prompt = problem['prompt']
    test_code = problem['test']
    # Store the test cases
    test_cases.append(test_code)

    # Generate multiple candidate solutions for each problem
    problem_candidates = []

    # Create a progress bar for the inner loop (samples per problem)
    for _ in range(num_samples_per_problem):
        # Encode the prompt and get attention mask
        inputs = tokenizer(prompt, return_tensors="pt").to(device)

        # Generate code with attention mask and proper token IDs
        with torch.no_grad():
            outputs = model.generate(
                input_ids=inputs['input_ids'],
                attention_mask=inputs['attention_mask'],
                max_length=512,
                do_sample=True,
                temperature=0.7,
                top_p=0.95,
                num_return_sequences=1,
                pad_token_id=tokenizer.pad_token_id,
                eos_token_id=tokenizer.eos_token_id,
            )
        generated_code = tokenizer.decode(outputs[0], skip_special_tokens=True)
        # Remove the prompt from the generated code
        generated_code = generated_code[len(prompt):]
        problem_candidates.append(generated_code)
    # Add the candidates for the current problem
    candidates.append(problem_candidates)

print("Code generation complete.")
Uitvoer:
Generating code solutions...

Problems: 100%|██████████| 164/164 [34:35<00:00, 12.66s/problem]

Code generation complete.Nu berekenen we het slagingspercentage bij verschillende waarden van k (1 en 5) voor de gegenereerde codevoorbeelden door ze te vergelijken met de referentietestcases, met behulp van een pass@k-evaluatiemetriek, en geven we vervolgens het slagingspercentage als percentage weer voor elke k-waarde.
# Compute pass@k
k_values = [1, 5]
print("Evaluating generated code...")
pass_at_k, results = code_eval_metric.compute(
    references=test_cases,
    predictions=candidates,
    k=k_values,
    num_workers=4,  # Adjust based on your system
    timeout=10.0,   # Adjust the timeout as needed
)

# Print the results
for k in k_values:
    print(f"Pass@{k}: {pass_at_k[f'pass@{k}'] * 100:.2f}%")
De resultaten laten zien dat 27,07% van de gegenereerde codevoorbeelden slaagt voor de evaluatiecriteria wanneer we naar de beste kandidaat kijken (Pass@1), terwijl 65,85% slaagt wanneer we de top vijf kandidaten meenemen (Pass@5). Deze prestatie is behoorlijk, zeker omdat we een kleiner taalmodel gebruiken om de Python-code te genereren.
Vergeleken met GPT-4o, dat een Pass@1 van 90,2% heeft, steken de resultaten echter mager af.
Evaluating generated code...
Pass@1: 27.07%
Pass@5: 65.85%
Heb je moeite om de bovenstaande code te draaien? Bekijk dan de HumanEval met DeepEval-Kaggle-notebook.
Je kunt ook leren hoe je je LLM-evaluaties stroomlijnt met MLflow in de tutorial Evaluating LLMs with MLflow.
De HumanEval-dataset is relatief eenvoudig en vertegenwoordigt mogelijk slechts gedeeltelijk echte programmeeruitdagingen. Daarnaast zijn er zorgen over overfitting, omdat modellen getraind kunnen zijn op vergelijkbare datasets, wat specifiek tot betere prestaties op HumanEval kan leiden.
Daarom is het bij het evalueren van grote taalmodellen (LLM’s) voor codegeneratie belangrijk om meerdere prestatietools te overwegen, zoals MBPP (Mostly Basic Python Problems), ClassEval, DevQualityEval en andere.
Voltooi de AI Fundamentals skill track en krijg praktische kennis over populaire AI-onderwerpen zoals ChatGPT, grote taalmodellen, generatieve AI en meer.
Top-AI-cursussen
Leerpad
Leerpad
Leerpad
blog
Adel Nehme
15 min

