
Programma
Sviluppare modelli linguistici di grandi dimensioni
16 ore
HumanEval è un dataset di benchmark sviluppato da OpenAI che valuta le prestazioni dei large language model (LLM) nei compiti di generazione di codice. È diventato uno strumento importante per misurare le capacità dei modelli di IA nella comprensione e nella generazione di codice.
In questo tutorial vedremo cos'è HumanEval e la metrica pass@k. Inoltre, valuteremo le capacità di generazione di codice del modello codeparrot-small su 164 problemi.
Per il processo di valutazione con HumanEval useremo l'ecosistema Hugging Face per caricare il dataset, il modello e le metriche necessarie. Se sei relativamente nuovo nel mondo degli LLM e in tutto ciò che possono fare, dai un'occhiata al nostro corso Developing Large Language Models.
Immagine dell'autore
HumanEval è stato sviluppato da OpenAI come dataset di valutazione progettato specificamente per i large language model. Funziona come benchmark di riferimento per valutare gli LLM nei compiti di generazione di codice, concentrandosi sulla capacità dei modelli di comprendere il linguaggio, ragionare e risolvere problemi legati ad algoritmi e matematica di base.
Il dataset è composto da 164 problemi di programmazione scritti a mano, ciascuno con firma di funzione, docstring, corpo e diversi unit test, con una media di 7,7 test per problema.
Nell'esempio seguente cloneremo il repository di valutazione, installeremo i pacchetti Python necessari e poi eseguiremo la valutazione della correttezza funzionale sul dataset di esempio.
$ git clone https://github.com/kingabzpro/human-eval
$ pip install -e human-eval
$ evaluate_functional_correctness data/example_samples.jsonl --problem_file=data/example_problem.jsonl
Abbiamo ottenuto il risultato in termini di pass@k e, nel nostro caso, pass@1. Questa metrica indica una percentuale di successo del 50% al primo tentativo. Approfondiremo questa metrica nella prossima sezione.
Reading samples...
6it [00:00, 2465.79it/s]
Running test suites...
100%|█████████████████████████████████████████████| 6/6 [00:03<00:00,  1.97it/s]
Writing results to data/example_samples.jsonl_results.jsonl...
100%|██████████████████████████████████████████| 6/6 [00:00<00:00, 12035.31it/s]
{'pass@1': 0.4999999999999999}
Leggi il post LLM Evaluation: Metrics, Methodologies, Best Practices per scoprire come valutare gli LLM usando metriche, metodologie e best practice chiave per prendere decisioni informate.
HumanEval è diverso dalle metriche tradizionali basate sul matching testuale. Usa un approccio più pratico chiamato "correttezza funzionale", che impiega la metrica pass@k per valutare la probabilità che almeno uno dei primi k campioni di codice generati per un problema superi gli unit test.
Questo passaggio dalla similarità testuale alla correttezza funzionale fornisce una valutazione più significativa della capacità di un modello di risolvere sfide di programmazione. Il processo è simile a come gli sviluppatori testano il proprio codice con unit test per valutarne la correttezza.
Di seguito vediamo la formula matematica per calcolare la metrica pass@k:
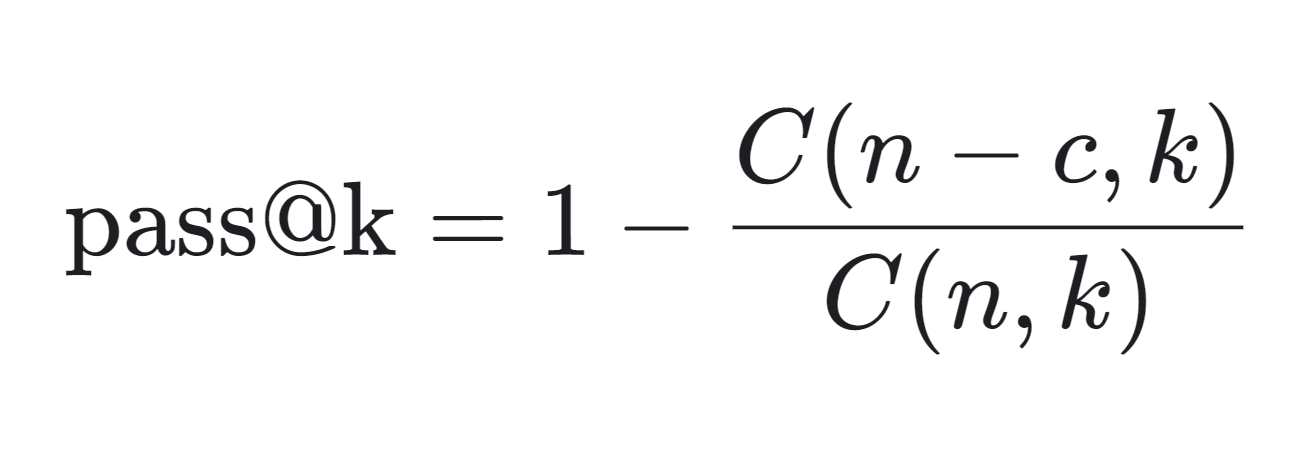
La metrica pass@k si calcola come segue:
La metrica pass@k è particolarmente utile per valutare le prestazioni pratiche dei modelli di generazione di codice, poiché riflette la probabilità di generare una soluzione corretta entro un numero limitato di tentativi.
La metrica è ampiamente usata in contesti competitivi, come le classifiche ospitate da Papers with Code, dove i modelli sono classificati in base ai punteggi pass@k, inclusi pass@10 e pass@100.
HumanEval garantisce che il codice generato sia sintatticamente corretto ed efficace dal punto di vista funzionale.
In questo progetto caricheremo il dataset OpenAI HumanEval ed eseguiremo la valutazione della correttezza funzionale su codeparrot/codeparrot-small.
Selezioniamo un modello più piccolo di generazione di codice per ridurre i tempi di valutazione, dato che eseguiremo più cicli: ciclo esterno 164 (numero di problemi) e ciclo interno 5 (numero di campioni generati per un singolo problema).
Inizieremo installando la libreria Python Evaluate di Hugging Face. Evaluate è una libreria potente che ti permette di valutare facilmente modelli e dataset di machine learning in vari domini con una sola riga di codice, garantendo coerenza e riproducibilità sia in locale sia in ambienti di training distribuito.
%%capture
%pip install evaluate
Imposta anche una variabile d'ambiente che ci permetterà di eseguire la valutazione del modello.
import os
os.environ["HF_ALLOW_CODE_EVAL"] = "1"
os.environ["TOKENIZERS_PARALLELISM"] = "false"Caricheremo il dataset openai_humaneval da Hugging Face. Questo dataset contiene 164 problemi di programmazione in Python e include testo naturale in inglese presente in commenti e docstring.
Caricheremo anche la metrica di valutazione code_eval, che ci consente di eseguire il benchmark HumanEval.
from datasets import load_dataset
from evaluate import load
from transformers import AutoModelForCausalLM, AutoTokenizer
import torch
from tqdm import tqdm

# Load HumanEval dataset
human_eval = load_dataset("openai_humaneval")['test']

# Load code evaluation metric
code_eval_metric = load("code_eval")Carica il modello e il tokenizer di CodeParrot dall'Hugging Face Hub. CodeParrot è un modello basato su GPT-2 con 110 milioni di parametri, addestrato specificamente per generare codice Python.
# Specify the model name or path
model_name = "codeparrot/codeparrot-small"

# Load the model and tokenizer
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)
model.eval()Imposta pad_token_id e pad_token_id e ridimensiona gli embedding del modello se vengono aggiunti nuovi token.
# Set pad_token_id and pad_token_id if not already set
if tokenizer.pad_token_id is None:
    tokenizer.pad_token_id = 0  # Commonly used pad token ID
if tokenizer.eos_token_id is None:
    tokenizer.eos_token_id = 2  # Commonly used eos token ID for Llama

# Ensure the tokenizer has the pad and eos tokens
if tokenizer.pad_token is None:
    tokenizer.add_special_tokens({'pad_token': '<pad>'})
if tokenizer.eos_token is None:
    tokenizer.add_special_tokens({'eos_token': '</s>'})

# Resize model embeddings if new tokens were added
if len(tokenizer) > model.config.vocab_size:
model.resize_token_embeddings(len(tokenizer))Questa è la sezione principale dove avviene la magia. Eseguiremo HumanEval con cinque campioni per problema, per un totale di 164 problemi da valutare. Il ciclo esterno estrarrà prompt e test dal dataset. Usando il prompt, genererà cinque campioni diversi per lo stesso problema.
Al termine di questo processo avremo due liste: test_cases e candidates.
Questa configurazione consente una valutazione completa e il confronto delle soluzioni generate rispetto ai casi di test.
# Set the number of candidates per problem
num_samples_per_problem = 5  # Adjust as needed for pass@k computation

# Lists to store test cases and predictions
test_cases = []
candidates = []

# Create a progress bar for the outer loop (problems)
print("Generating code solutions...")
for problem in tqdm(human_eval, desc="Problems", unit="problem"):
    prompt = problem['prompt']
    test_code = problem['test']
    # Store the test cases
    test_cases.append(test_code)

    # Generate multiple candidate solutions for each problem
    problem_candidates = []

    # Create a progress bar for the inner loop (samples per problem)
    for _ in range(num_samples_per_problem):
        # Encode the prompt and get attention mask
        inputs = tokenizer(prompt, return_tensors="pt").to(device)

        # Generate code with attention mask and proper token IDs
        with torch.no_grad():
            outputs = model.generate(
                input_ids=inputs['input_ids'],
                attention_mask=inputs['attention_mask'],
                max_length=512,
                do_sample=True,
                temperature=0.7,
                top_p=0.95,
                num_return_sequences=1,
                pad_token_id=tokenizer.pad_token_id,
                eos_token_id=tokenizer.eos_token_id,
            )
        generated_code = tokenizer.decode(outputs[0], skip_special_tokens=True)
        # Remove the prompt from the generated code
        generated_code = generated_code[len(prompt):]
        problem_candidates.append(generated_code)
    # Add the candidates for the current problem
    candidates.append(problem_candidates)

print("Code generation complete.")
Output:
Generating code solutions...

Problems: 100%|██████████| 164/164 [34:35<00:00, 12.66s/problem]

Code generation complete.Ora calcoleremo il tasso di successo per diversi valori di k (1 e 5) sui campioni di codice generati confrontandoli con i casi di test di riferimento, usando una metrica pass@k, e poi stamperemo la percentuale di successo per ciascun valore di k.
# Compute pass@k
k_values = [1, 5]
print("Evaluating generated code...")
pass_at_k, results = code_eval_metric.compute(
    references=test_cases,
    predictions=candidates,
    k=k_values,
    num_workers=4,  # Adjust based on your system
    timeout=10.0,   # Adjust the timeout as needed
)

# Print the results
for k in k_values:
    print(f"Pass@{k}: {pass_at_k[f'pass@{k}'] * 100:.2f}%")
I risultati mostrano che il 27,07% dei campioni di codice generati supera i criteri di valutazione considerando il candidato migliore (Pass@1), mentre il 65,85% supera la valutazione considerando i primi cinque candidati (Pass@5). Si tratta di una prestazione valida, soprattutto considerando che stiamo usando un modello linguistico più piccolo per generare il codice Python.
Tuttavia, se confrontata con GPT-4o, che ha un Pass@1 del 90,2%, la prestazione risulta carente.
Evaluating generated code...
Pass@1: 27.07%
Pass@5: 65.85%
Se hai problemi a eseguire il codice qui sopra, consulta HumanEval with the DeepEval notebook su Kaggle.
Puoi anche imparare a semplificare le valutazioni dei tuoi LLM con MLflow seguendo il tutorial Evaluating LLMs with MLflow.
Il dataset HumanEval è relativamente semplice e potrebbe rappresentare solo parzialmente le sfide di programmazione del mondo reale. Inoltre, ci sono preoccupazioni riguardo all'overfitting, poiché i modelli potrebbero essere addestrati su dataset simili, il che potrebbe portare a prestazioni migliori specificamente su HumanEval.
Pertanto, quando si valutano i large language model (LLM) per le capacità di generazione di codice, è essenziale considerare più metriche di prestazione, come MBPP (Mostly Basic Python Problems), ClassEval, DevQualityEval e altre.
Completa il percorso AI Fundamentals e acquisisci conoscenze pratiche sui temi più popolari dell'IA come ChatGPT, large language model, IA generativa e altro.
I migliori corsi di IA
Programma
Programma
Programma
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



