

理解 Pass@k 指标
HumanEval 不同于传统的匹配类指标。它采用一种更实用的方法——“功能正确性”,使用 pass@k 指标来评估:针对某个问题,模型生成的前 k 个代码样本中,至少有一个通过单元测试的概率。
这种从文本相似度转向功能正确性的改变,更有意义地衡量了模型解决编程挑战的能力。这一过程类似于开发者通过单元测试来验证代码正确性。
下面是计算 pass@k 指标的数学公式:
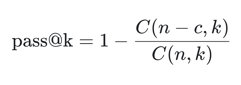
- n:生成样本总数。
- c:在 n 个样本中,正确样本的数量。
- k:考虑的样本数量(前 k)。
pass@k 的计算如下:
- C(n-c, k):从错误样本(n-c)中选择 k 个样本的组合数,表示所选 k 个样本全部错误的情形。
- C(n,k)/C(n−c,k):该比值给出所选 k 个样本全部错误的概率。
- 1 - C(n−c,k)/C(n,k):用 1 减去上述概率,即得到 k 个样本中至少有一个正确的概率,即 pass@k 指标。
pass@k 尤其适合评估代码生成模型的实际表现,因为它反映了在有限尝试次数内生成正确解的可能性。
该指标广泛用于竞赛环境,例如由 Papers with Code 主办的排行榜,模型会依据其 pass@k 分数进行排名,包括 pass@10 和 pass@100 等。
HumanEval 确保生成的代码在语法上正确、在功能上有效。
使用 Hugging Face Evaluate 进行 HumanEval 评估
在本项目中,我们将加载 OpenAI HumanEval 数据集,并在 codeparrot/codeparrot-small 上运行功能正确性评估。
我们选择较小的代码生成模型以加快评估速度,因为我们将运行多个循环:外层循环 164 次(问题数量),内层循环 5 次(单个问题生成的样本数)。
1. 环境准备
我们将首先安装 Hugging Face 的 Evaluate Python 库。Evaluate 是一个功能强大的库,能让您用一行代码轻松评估各领域的机器学习模型与数据集,确保在本地或分布式训练环境中的一致性与可复现性。
%%capture
%pip install evaluate同时,设置环境变量以便我们运行模型评估。
import os
os.environ["HF_ALLOW_CODE_EVAL"] = "1"
os.environ["TOKENIZERS_PARALLELISM"] = "false"2. 加载数据集与评估指标
我们将从 Hugging Face 加载 openai_humaneval 数据集。该数据集包含 164 个 Python 编程问题,并含有注释与文档字符串中的英文自然文本。
我们还将加载 code_eval 评估指标,以便运行 HumanEval 基准。
from datasets import load_dataset
from evaluate import load
from transformers import AutoModelForCausalLM, AutoTokenizer
import torch
from tqdm import tqdm
# Load HumanEval dataset
human_eval = load_dataset("openai_humaneval")['test']
# Load code evaluation metric
code_eval_metric = load("code_eval")3. 加载模型与分词器
从 Hugging Face Hub 加载 CodeParrot 模型与分词器。CodeParrot 是基于 GPT-2 的模型,拥有 1.1 亿参数,专门针对 Python 代码生成进行训练。
# Specify the model name or path
model_name = "codeparrot/codeparrot-small"
# Load the model and tokenizer
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)
model.eval()4. 修正分词器设置
设置 pad_token_id 和 pad_token_id,如果添加了新标记则调整模型的嵌入大小。
# Set pad_token_id and pad_token_id if not already set
if tokenizer.pad_token_id is None:
tokenizer.pad_token_id = 0 # Commonly used pad token ID
if tokenizer.eos_token_id is None:
tokenizer.eos_token_id = 2 # Commonly used eos token ID for Llama
# Ensure the tokenizer has the pad and eos tokens
if tokenizer.pad_token is None:
tokenizer.add_special_tokens({'pad_token': '<pad>'})
if tokenizer.eos_token is None:
tokenizer.add_special_tokens({'eos_token': '</s>'})
# Resize model embeddings if new tokens were added
if len(tokenizer) > model.config.vocab_size:
model.resize_token_embeddings(len(tokenizer))5. 生成代码解答
这里是核心步骤。我们将对每个问题生成 5 个样本,总计评估 164 个问题。外层循环从数据集中提取提示与测试。基于提示,为同一问题生成 5 个不同样本。
完成后,我们将得到两个列表:test_cases 和 candidates。
- Test Cases:直接从数据集提取的测试用例。
- Candidates:每个问题生成的 5 个代码样本。
这种设置便于全面评估并将生成解答与测试用例进行对比。
# Set the number of candidates per problem
num_samples_per_problem = 5 # Adjust as needed for pass@k computation
# Lists to store test cases and predictions
test_cases = []
candidates = []
# Create a progress bar for the outer loop (problems)
print("Generating code solutions...")
for problem in tqdm(human_eval, desc="Problems", unit="problem"):
prompt = problem['prompt']
test_code = problem['test']
# Store the test cases
test_cases.append(test_code)
# Generate multiple candidate solutions for each problem
problem_candidates = []
# Create a progress bar for the inner loop (samples per problem)
for _ in range(num_samples_per_problem):
# Encode the prompt and get attention mask
inputs = tokenizer(prompt, return_tensors="pt").to(device)
# Generate code with attention mask and proper token IDs
with torch.no_grad():
outputs = model.generate(
input_ids=inputs['input_ids'],
attention_mask=inputs['attention_mask'],
max_length=512,
do_sample=True,
temperature=0.7,
top_p=0.95,
num_return_sequences=1,
pad_token_id=tokenizer.pad_token_id,
eos_token_id=tokenizer.eos_token_id,
)
generated_code = tokenizer.decode(outputs[0], skip_special_tokens=True)
# Remove the prompt from the generated code
generated_code = generated_code[len(prompt):]
problem_candidates.append(generated_code)
# Add the candidates for the current problem
candidates.append(problem_candidates)
print("Code generation complete.")输出:
Generating code solutions...
Problems: 100%|██████████| 164/164 [34:35<00:00, 12.66s/problem]
Code generation complete.6. 计算 pass@k
现在,我们将针对不同的 k 值(1 与 5),将生成的代码样本与参考测试用例进行对比,使用 pass@k 评估指标,并输出各 k 值的成功率(百分比)。
# Compute pass@k
k_values = [1, 5]
print("Evaluating generated code...")
pass_at_k, results = code_eval_metric.compute(
references=test_cases,
predictions=candidates,
k=k_values,
num_workers=4, # Adjust based on your system
timeout=10.0, # Adjust the timeout as needed
)
# Print the results
for k in k_values:
print(f"Pass@{k}: {pass_at_k[f'pass@{k}'] * 100:.2f}%")结果显示:在只考虑最优候选(Pass@1)时,27.07% 的生成样本通过评估标准;在考虑前五个候选(Pass@5)时,通过率为 65.85%。鉴于我们使用的是较小的语言模型来生成 Python 代码,这一表现已相当不错。
然而,与 GPT-4o 的 Pass@1 达到 90.2% 相比,差距仍较明显。
Evaluating generated code...
Pass@1: 27.07%
Pass@5: 65.85%如果您在运行上述代码时遇到问题,请查看 使用 DeepEval 的 HumanEval Kaggle 笔记本。
您还可以通过以下教程了解如何使用 MLflow 简化 LLM 的评估流程:《使用 MLflow 评估 LLM》。
结论
HumanEval 数据集相对简单,可能只能部分代表真实世界的编程挑战。此外,还存在过拟合方面的担忧:模型可能在相似数据集上训练,从而在 HumanEval 上获得特定提升。
因此,在评估大语言模型(LLM)的代码生成能力时,务必综合考虑多种性能指标,如 MBPP(Mostly Basic Python Problems)、ClassEval、DevQualityEval 等。
完成AI Fundamentals 技能路径,获取有关 ChatGPT、大语言模型、生成式 AI 等热门话题的实用知识。

作为一名持证的数据科学家,我热衷于利用前沿技术打造创新的机器学习应用。凭借在语音识别、数据分析与报告、MLOps、对话式人工智能以及自然语言处理方面的扎实背景,我不断打磨构建智能系统的能力,力求带来切实影响。除技术专长外,我也擅长沟通,能够将复杂概念提炼为清晰、简明的表述。因此,我成为数据科学领域备受关注的博主,与不断壮大的数据专业人士社区分享洞见与实践经验。目前,我专注于内容创作与编辑,借助大语言模型打造有力且吸引人的内容,帮助企业与个人更好地发挥数据价值。
HumanEval 是由 OpenAI 开发的一个基准数据集,用于评估大语言模型(LLM)在代码生成任务中的表现。它已成为衡量 AI 模型理解与生成代码能力的重要工具。
在本教程中,我们将了解 HumanEval 与 pass@k 指标。此外,我们将使用
codeparrot-small模型在 164 个问题上评估其代码生成能力。在 HumanEval 的评估流程中,我们将使用 Hugging Face 生态来加载数据集、模型以及必要的指标。如果您对 LLM 及其能力还比较陌生,不妨阅读我们的《开发大语言模型》课程。
作者供图
什么是 HumanEval?
HumanEval 由 OpenAI 开发,是专为大语言模型设计的评估数据集。它作为参考基准,用于评估 LLM 在代码生成任务上的表现,重点考察模型的语言理解、推理能力,以及解决与算法和简单数学相关问题的能力。
该数据集包含 164 道手写编程题,每题包括函数签名、文档字符串、函数体以及若干单元测试,平均每题有 7.7 个测试。
在下面的示例中,我们将克隆人类评估仓库,安装必要的 Python 包,然后在示例数据集上运行功能正确性评估。
我们得到了以 pass@k 表示的结果,在此例中为 pass@1。该指标表示模型在第一次尝试中的 50% 成功率。下一节我们将详细介绍这一指标。
阅读《LLM 评估:指标、方法论与最佳实践》,了解如何利用关键指标、方法论与最佳实践评估 LLM,从而做出更明智的决策。