
Kursus
Konsep Large Language Models (LLM)
2 jam
112.1K
Large Language Models (LLM) menjadi sangat penting dalam pengembangan model machine learning, khususnya dalam meningkatkan kemampuan algoritme pemrosesan bahasa alami. Dari chatbot hingga generator konten, model-model ini mengubah cara kita berinteraksi dengan teknologi.
Namun, seiring bertambahnya jumlah dan kompleksitas LLM, evaluasi kinerjanya menjadi semakin penting. Tanpa evaluasi yang tepat dan akurat, sulit untuk mengetahui apakah sebuah model bekerja sesuai harapan atau memerlukan penyesuaian.
Di sinilah MLflow berperan. MLflow adalah alat open-source yang dirancang untuk memudahkan pengelolaan eksperimen machine learning. Alat ini membantu kita melacak hasil dari berbagai eksperimen, mengelola model, dan menjaga semuanya tetap teratur!
Dalam tutorial ini, kita akan mengeksplorasi peran MLflow dalam meningkatkan alur kerja LLM. Saya akan memandu Anda melalui proses penyiapannya serta menunjukkan cara mencatat metrik dan melacak parameter dalam eksperimen LLM. Terakhir, kita akan melihat bagaimana MLflow mendukung pengelolaan dan deployment model secara efektif.
MLflow adalah platform open-source yang dirancang untuk mengelola siklus hidup machine learning dari awal hingga akhir. Platform ini menyediakan alat untuk menyederhanakan proses pengembangan, pelacakan, dan deployment model machine learning.
Baik kita mengerjakan proyek kecil maupun mengelola eksperimen kompleks dengan model besar, MLflow dapat membantu kita tetap terorganisasi dan efisien.
Beberapa keunggulan menggunakan MLflow dalam siklus hidup machine learning antara lain:
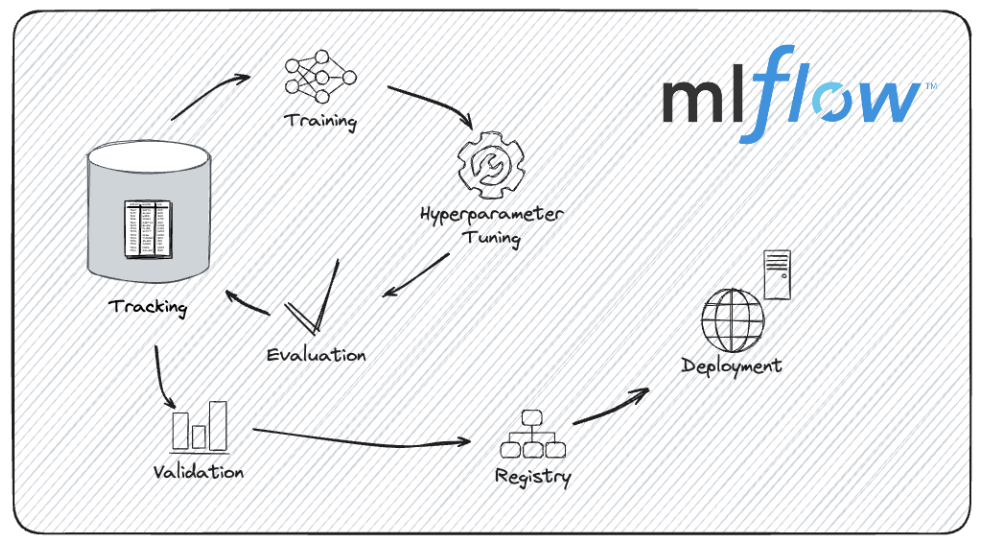
Siklus hidup pengembangan model dengan MLflow. Sumber gambar: dokumentasi MLflow.
MLflow dirancang untuk membuat pengelolaan proyek machine learning lebih mulus dan transparan. Ini sangat berguna saat bekerja dengan model kompleks seperti LLM, seperti yang akan kita lihat sekarang.
Menggunakan MLflow untuk evaluasi LLM memiliki beberapa manfaat, seperti melacak versi model, mencatat metrik evaluasi, dan membandingkan performa di berbagai bidang.
Mari kita lihat manfaat ini lebih detail.
Pengembangan LLM melibatkan iterasi dan perbaikan yang sering. Setiap versi baru membawa peningkatan kecil atau perubahan perilaku. MLflow mengelola iterasi ini dengan melacak versi model secara sistematis. Kemampuan ini memungkinkan kita mereproduksi hasil, membandingkan versi secara efektif, dan menjaga riwayat evolusi model yang jelas.
Misalnya, jika kita bereksperimen dengan berbagai teknik fine-tuning, MLflow dapat membantu mengelola dan meninjau hasil tiap versi, sehingga lebih mudah mengidentifikasi iterasi mana yang menghasilkan performa terbaik.
Karena MLflow menjamin setiap eksperimen dan hasil terkait dicatat secara menyeluruh, kita dapat membagikan temuan dengan percaya diri, mengetahui bahwa orang lain dapat mereproduksi hasil kita persis sama.
Jika proyek kita melibatkan eksperimen dengan arsitektur LLM atau metodologi pelatihan yang berbeda, kemampuan pelacakan MLflow akan memudahkan pendokumentasian dan berbagi pekerjaan kita.
Evaluasi LLM mencakup pemantauan beberapa metrik, seperti akurasi, perplexity, dan F1 score, antara lain.
Fungsionalitas pencatatan MLflow memungkinkan kita merekam metrik-metrik ini secara efisien dan terorganisasi. Menganalisis metrik ini memberi gambaran yang baik tentang performa model kita.
Sebagai contoh, kita mungkin ingin membandingkan bagaimana berbagai hiperparameter atau dataset pelatihan memengaruhi metrik performa model. Dengan MLflow, kita dapat mencatat dan memvisualisasikan metrik tersebut untuk menarik wawasan yang dapat ditindaklanjuti.
Saat model dideploy dan digunakan dalam aplikasi dunia nyata, model dapat mengalami model drift, yaitu penurunan performa akibat perubahan data atau lingkungan. Kita dapat memanfaatkan MLflow untuk memantau dan mengelola model drift dengan melacak performa model dari waktu ke waktu.
Kita dapat menyiapkan evaluasi berkala dan menggunakan MLflow untuk mencatat dan menganalisis perubahan metrik performa, sehingga dapat membuat keputusan yang dapat ditindaklanjuti secara real-time.
Salah satu keunggulan terpenting MLflow adalah kemampuannya menyederhanakan perbandingan model yang komprehensif. Dengan menyimpan catatan rinci dari berbagai eksperimen, MLflow memungkinkan kita membandingkan performa berbagai LLM dan konfigurasi hiperparameter secara berdampingan.
Menemukan hiperparameter yang tepat dapat menentukan keberhasilan model saat mengembangkan LLM.
Bayangkan kita melakukan fine-tuning pada LLM dan ingin mengevaluasi dampak dari berbagai pengaturan hiperparameter. Dengan MLflow, kita dapat mencatat dan membandingkan hasil dari berbagai learning rate, ukuran batch, atau tingkat dropout untuk menentukan konfigurasi mana yang menghasilkan performa terbaik, sehingga mengoptimalkan proses pengembangan model.
Model registry MLflow dan fungsionalitas pelacakannya berperan saat mengevaluasi beberapa LLM untuk deployment.
Misalkan kita memiliki beberapa versi model bahasa yang sedang dipertimbangkan untuk lingkungan produksi. MLflow dapat membantu kita mencatat metrik performa setiap model, membandingkannya, dan membuat keputusan berdasarkan bukti empiris, bukan hanya intuisi.
Sekarang kita sudah mendapat gambaran yang lebih jelas tentang MLflow dan manfaatnya, saatnya praktik langsung!
Sebelum mengevaluasi LLM dengan MLflow, kita perlu menyiapkan platform dengan benar. Ini mencakup memasang MLflow, opsional mengonfigurasi server pelacakan untuk pencatatan jarak jauh, dan memastikan lingkungan siap untuk mengelola eksperimen serta melacak hasilnya.
Mari kita lihat caranya.
1. Pastikan Python sudah terpasang:
Pertama, kita perlu memastikan Python sudah terpasang di mesin kita. MLflow kompatibel dengan Python 3.6 ke atas (Perlu diketahui bahwa Python 3.8 kini sudah deprecated, jadi disarankan menggunakan Python >= 3.9). Kita dapat memeriksa versi Python dengan:
python --version2. Buat lingkungan virtual (opsional namun direkomendasikan):
Sebaiknya gunakan lingkungan virtual saat melacak eksperimen dengan MLflow, terutama jika kita bekerja dengan Mac OS X. Kita bisa membuatnya menggunakan venv atau virtualenv.
python -m venv mlflow-envAktifkan lingkungan virtual:
Di Windows:
mlflow-env\Scripts\activateDi Mac/Linux:
source mlflow-env/bin/activate3. Pasang MLflow menggunakan pip:
Dengan lingkungan virtual aktif (jika digunakan), kita dapat memasang MLflow melalui pip:
pip install mlflow4. Pasang dependensi tambahan:
MLflow memiliki beberapa dependensi opsional untuk fungsionalitas yang ditingkatkan. Jika kita perlu menggunakan fitur tertentu, seperti kapabilitas serving model MLflow, kita perlu memasang gunicorn.
pip install gunicornJika kita menggunakan pustaka seperti TensorFlow atau PyTorch, kita mungkin perlu memasang integrasi MLflow masing-masing:
pip install mlflow[extras]4. Verifikasi pemasangan:
Selanjutnya pastikan MLflow terpasang dengan benar dengan memeriksa versinya:
mlflow --versionJika kita bekerja dalam lingkungan kolaboratif atau diperlukan pencatatan jarak jauh, kita seharus menyiapkan MLflow tracking server. Fitur ini memungkinkan kita memusatkan pelacakan dan pengelolaan eksperimen.
1. Jalankan tracking server:
Kita dapat memulai server MLflow dengan menentukan backend store dan lokasi artefak.
mlflow server --backend-store-uri sqlite:///mlruns.db --default-artifact-root ./mlruns--backend-store-uri menentukan lokasi penyimpanan data eksperimen. Kita dapat menggunakan sistem basis data apa pun (PostgreSQL, MySQL, dll.).--default-artifact-root menentukan direktori tempat artefak, misalnya file model, disimpan.2. Konfigurasikan tracking server:
Kita perlu memastikan klien MLflow dikonfigurasi untuk mencatat ke tracking server. Kita dapat mengatur variabel lingkungan MLFLOW_TRACKING_URI untuk mengarah ke server kita.
export MLFLOW_TRACKING_URI=http://localhost:50003. Akses antarmuka pelacakan:
Sekarang, kita dapat membuka peramban web dan menavigasi ke http://localhost:5000 untuk mengakses UI MLflow. Antarmuka ini memungkinkan kita melihat eksperimen, membandingkan hasil, dan mengelola proyek MLflow Anda, seperti yang akan kita lihat nanti.
Setelah MLflow siap, saatnya masuk ke tugas inti: memuat dan mengevaluasi LLM. Mari kita lihat cara memilih LLM pra-latih, memuatnya menggunakan berbagai pustaka, dan menyiapkan dataset evaluasi untuk mengukur performa model.
Saat memilih LLM pra-latih, pustaka seperti Hugging Face Transformers menawarkan banyak pilihan. Misalnya, kita dapat memuat model pra-latih seperti GPT (untuk generasi teks) atau BERT (untuk klasifikasi teks dan tugas lainnya).
1. Pasang Hugging Face Transformers
Pertama, pastikan pustaka Hugging Face Transformers sudah terpasang. Kita dapat melakukannya dengan pip.
pip install transformers2. Muat model dan tokenizer pra-latih
Sekarang, kita memuat model BERT menggunakan pustaka transformers, termasuk model dan tokenizer, yang diperlukan untuk memproses teks dan menghasilkan prediksi.
from transformers import (
BertForSequenceClassification,
BertTokenizer
)
# Load pre-trained model and tokenizer
model_name = "textattack/bert-base-uncased-yelp-polarity"
tokenizer = BertTokenizer.from_pretrained(model_name)
model = BertForSequenceClassification.from_pretrained(model_name)
Model bert-base-uncased digunakan saat data teks yang kita kerjakan sebagian besar berhuruf kecil dan besar, tetapi kita tidak memerlukan model untuk membedakan huruf besar dan kecil.
Untuk mengevaluasi LLM, kita memerlukan dataset yang sesuai dengan tugas yang dinilai. Mari kita lihat cara menyiapkan dataset berbasis teks untuk analisis sentimen:
1. Memuat atau membuat dan melakukan praproses dataset
Data kita dapat tersimpan di berbagai tempat: di disk mesin lokal, di repositori GitHub, atau di Hugging Face Hub, kumpulan besar dataset hasil kurasi komunitas dan riset populer.
Untuk tutorial ini, kita akan menggunakan dataset ulasan film besar untuk analisis sentimen bernama IMDB. Kita akan menggunakan pustaka datasets untuk memuat dataset siap pakai:
Memasang pustaka datasets:
pip install datasetsMemuat Dataset:
from datasets import load_dataset
# Load the dataset IMDb for sentiment analysis
dataset = load_dataset("imdb")
2. Praproses untuk analisis sentimen
Kita akan menggunakan tokenizer BERT yang sudah dimuat sebelumnya untuk melakukan praproses dataset analisis sentimen.
def preprocess_function(examples):
    return tokenizer(examples['text'], padding="max_length", truncation=True)
tokenized_datasets = dataset.map(preprocess_function, batched=True)Setelah LLM dimuat dan dataset evaluasi disiapkan, saatnya menjalankan evaluasi dan mencatat metrik.
1. Impor MLflow dan mulai eksperimen baru
Untuk melacak eksperimen dengan MLflow, pertama-tama kita perlu memulai eksperimen baru dan mencatat metadata yang relevan, seperti nama model, versi, dan parameter evaluasi.
import mlflow
import mlflow.pytorch
# Start a new experiment
mlflow.set_experiment("LLM_Evaluation")
with mlflow.start_run() as run:
    # Log experiment metadata
    mlflow.log_param("model_name", "bert")
    mlflow.log_param("model_version", "v1.0")
    mlflow.log_param("evaluation_task", "sentiment_analysis")
2. Catat parameter evaluasi
Sekarang kita dapat mencatat parameter apa pun yang terkait dengan proses evaluasi, seperti ukuran dataset evaluasi atau konfigurasi spesifik yang digunakan selama evaluasi.
with mlflow.start_run() as run:
mlflow.log_param("dataset_size", len(dataset['test']))Setelah kita melatih dan membuat prediksi yang sesuai menggunakan model, kita dapat mengevaluasi LLM dan mencatat berbagai metrik yang mencerminkan performanya.
Analisis sentimen adalah masalah klasifikasi, sehingga kita dapat mengevaluasi model menggunakan metrik seperti akurasi dan F1 score. Untuk tugas generasi teks, metrik seperti BLEU score atau perplexity lazim digunakan.
from sklearn.metrics import accuracy_score, f1_score
# Assuming y_true and y_pred are true labels and model predictions
accuracy = accuracy_score(y_true, y_pred)
f1 = f1_score(y_true, y_pred, average='weighted')
with mlflow.start_run() as run:
    mlflow.log_metric("accuracy", accuracy)
mlflow.log_metric("f1_score", f1)Setelah beberapa run evaluasi dilacak dengan MLflow, membandingkan performanya sangat penting untuk menentukan model dan konfigurasi dengan performa terbaik.
Mari pahami cara melacak beberapa run dan menggunakan UI MLflow untuk memvisualisasikan serta membandingkan hasil secara efektif.
Pertama, kita perlu melacak beberapa run dalam satu eksperimen atau di berbagai eksperimen untuk membandingkan performa berbagai versi LLM.
1. Mencatat beberapa run
Kita dapat mencatat beberapa run di bawah satu eksperimen dengan memulai run baru untuk setiap model atau konfigurasi yang ingin dievaluasi.
models = [("bert-base-cased", "v1.0"), ("bert-base-uncased", "v1.0")]
y_pred_dict = {
       "bert-base-cased": y_pred_case,
       "bert-base-uncased": y_pred_uncase
}
for model_name, model_version in models:
    with mlflow.start_run() as run:
        # Log model and version
        mlflow.log_param("model_name", model_name)
        mlflow.log_param("model_version", model_version)

        # Perform evaluation and log metrics
	   y_pred = y_pred_dict[model_name]
        accuracy = accuracy_score(y_true, y_pred)
        f1 = f1_score(y_true, y_pred, average='weighted')

        mlflow.log_metric("accuracy", accuracy)
        mlflow.log_metric("f1_score", f1)
2. Melacak eksperimen dengan model yang berbeda
Bayangkan kita ingin mengevaluasi berbagai tipe model. Untuk itu, kita dapat menggunakan MLflow untuk membuat eksperimen dan mencatat model-model tersebut bersama-sama.
Melakukan pencatatan model di MLflow sama seperti melakukan version control untuk model machine learning. Merekam detail model dan lingkungan menjamin reprodusibilitas.
Pertama, kita akan menyiapkan sebuah eksperimen. Lalu, kita mencatat setiap model dalam run MLflow terpisah, termasuk run ID dan jalur artefaknya.
 # Create an experiments for the different models
mlflow.set_experiment("sentiment_analysis_comparison")
model_names = ["bert-base-cased", "bert-base-uncased"]
run_ids = []
artifact_paths = []
for model, name in zip([betcased, bertuncased], model_names):
    with mlflow.start_run(run_name=f"log_model_{name}"):
        artifact_path = f"models/{name}"
        mlflow.pyfunc.log_model(
            artifact_path=artifact_path,
            python_model=model,
        )
        run_ids.append(mlflow.active_run().info.run_id)
        artifact_paths.append(artifact_path)
Sekarang, kita dapat mengevaluasi model dan mencatat hasilnya. MLflow menyediakan API, mlflow.evaluate(), untuk membantu mengevaluasi LLM kita.
for i in len(model_names):
    with mlflow.start_run(run_id=run_ids[i]):
        # reopen the run with the stored run ID
        evaluation_results = mlflow.evaluate(
            model=f"runs:/{run_ids[i]}/{artifact_paths[i]}",
            model_type="text",
            data=dataset['test'],
)Setelah kita mencatat berbagai metrik dan model di MLflow, kita dapat melakukan perbandingan. Kita dapat menggunakan antarmuka MLflow yang ramah pengguna untuk memvisualisasikan dan membandingkan metrik evaluasi dari berbagai run. Untuk itu, kita perlu memulai server MLflow jika belum berjalan
mlflow server --backend-store-uri sqlite:///mlruns.db --default-artifact-root ./mlrunsLalu kita membuka peramban web dan menavigasi ke http://localhost:5000 untuk mengakses UI MLflow. Di UI MLflow, kita menuju halaman "Experiments" untuk melihat semua eksperimen. Klik nama eksperimen untuk melihat daftar run yang terkait dengannya.
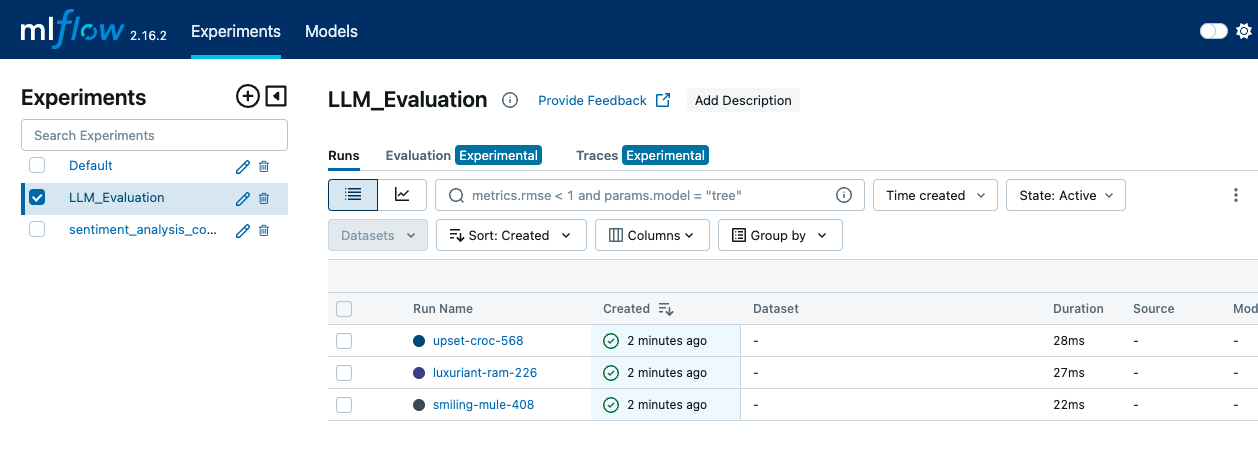
Antarmuka MLFLow menampilkan tab Experiments, tempat berbagai run dan event log dapat dilihat—gambar oleh Penulis.
Di dalam sebuah eksperimen, kita dapat membandingkan berbagai run dengan memilih beberapa run dan melihat metriknya secara berdampingan.
UI memungkinkan kita melihat representasi visual dari metrik seperti akurasi, F1 score, dan metrik evaluasi lainnya. Kita juga dapat menggunakan visualisasi bawaan MLflow untuk menghasilkan plot dan grafik guna perbandingan yang lebih mendetail.
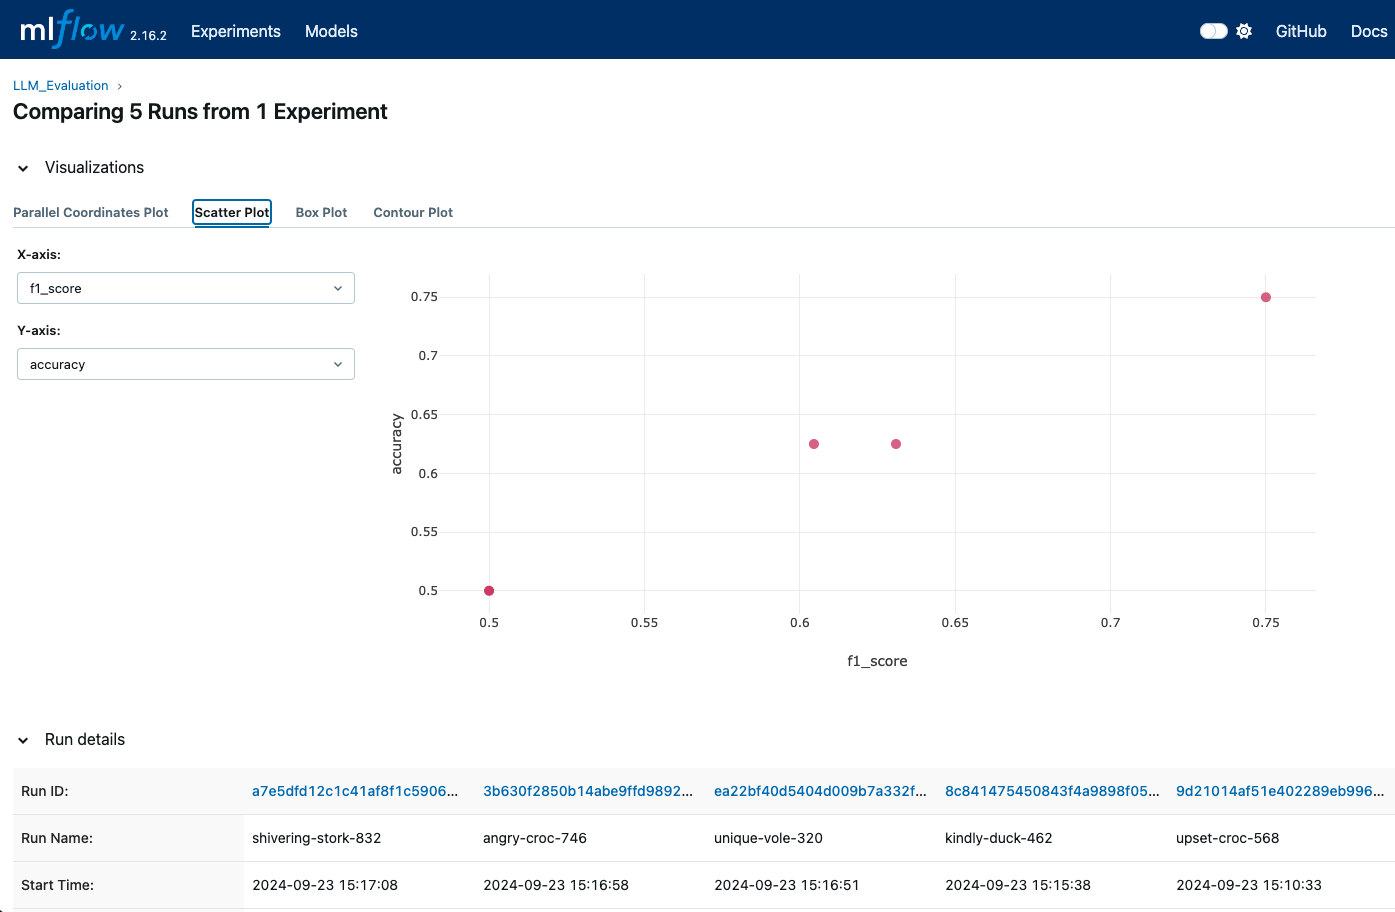
Visualisasi MLflow dapat menunjukkan kapan berbagai run dicatat sehingga kita bisa membandingkan beragam metrik—gambar oleh Penulis.
UI MLflow menyediakan bagan dan log terperinci untuk setiap run. Kita dapat mengakses log dan visualisasi ini untuk memahami model atau konfigurasi mana yang berkinerja terbaik berdasarkan metrik yang dicatat.
Untuk evaluasi LLM yang lebih mendalam dan komprehensif, MLflow menawarkan teknik lanjutan yang meningkatkan pelacakan dan analisis. Kita akan meninjau cara mencatat artefak model untuk pelacakan yang menyeluruh dan memanfaatkan MLflow untuk penyetelan hiperparameter guna mengoptimalkan performa LLM.
Mencatat artefak model sangat penting untuk menyimpan dan menganalisis detail eksperimen kita. Artefak dapat memberikan gambaran lengkap tentang performa model dan membantu mereproduksi hasil.
Di antara artefak yang dapat kita catat, antara lain:
joblib untuk scikit-learn atau format TensorFlow SavedModel).Berikut contohnya:
import matplotlib.pyplot as plt
from sklearn.metrics import ConfusionMatrixDisplay
with mlflow.start_run() as run:
    # Log the model
    mlflow.pytorch.save_model(model, "model")

    # Log the model weights
    joblib.dump(model, "model_weights.pkl")
    mlflow.log_artifact("model", artifact_path="model")

    # Log the confusion matrix as image
    confusion_matrix = pd.DataFrame(confusion_matrix(y_test,    predictions))
    cm = ConfusionMatrixDisplay(confusion_matrix=cm)
    plt.savefig("confusion_matrix.png")
    mlflow.log_artifact("confusion_matrix.png")

    # Generate predictions
    outputs = dataset['test']
    outputs['prediction'] = model.predict(dataset['test'])
    with open("generated_outputs.txt", "w") as f:
           for output in outputs:
               f.write(output + "\n")
       # Log the file
       mlflow.log_artifact("generated_outputs.txt")
Penyetelan hiperparameter merupakan bagian kunci untuk mengoptimalkan performa LLM. Dalam eksperimen, kita dapat menggunakan MLflow untuk mencatat berbagai konfigurasi hiperparameter. Ini memungkinkan kita membandingkan efek dari berbagai pengaturan dan menemukan konfigurasi optimal.
from transformers import Trainer, TrainingArguments
def train_and_log_model(model, lr, bs):
training_args = TrainingArguments(
                     output_dir='./results',
                     num_train_epochs=3,
                     per_device_train_batch_size=batch_size,
                     per_device_eval_batch_size=batch_size,
                     learning_rate=learning_rate,
                     evaluation_strategy="epoch")
trainer = Trainer(model=model,
                  args=training_args,
                  train_dataset=(X_train, y_train)
                  eval_dataset=(X_test, y_test))
with mlflow.start_run() as run:
# Log hyperparameters
           mlflow.log_param("learning_rate", lr)
           mlflow.log_param("batch_size", bs)
            trainer.train()
            eval_result = trainer.evaluate()
            mlflow.log_metric("eval_accuracy",
                               eval_result['eval_accuracy'])
hyperparameter_grid = [{"learning_rate": 5e-5, "batch_size": 8},
                       {"learning_rate": 3e-5, "batch_size": 16}]
for params in hyperparameter_grid:
train_and_log_model(params["learning_rate"],
                    params["batch_size"])
Keuntungan lain dari MLflow adalah dapat digunakan bersama pustaka optimisasi hiperparameter seperti Optuna atau Ray Tune untuk mengotomatisasi proses penyetelan.
Evaluasi LLM yang akurat tidak sekadar menjalankan pengujian dan mencatat metrik. Diperlukan pendekatan strategis untuk memastikan konsistensi, akurasi, dan efisiensi. Menerapkan praktik terbaik dapat meningkatkan keandalan dan efektivitas proses evaluasi.
Menggunakan dataset yang stabil dan representatif adalah salah satu hal pertama yang berkontribusi pada evaluasi yang efektif. Dengan memastikan bahwa dataset evaluasi stabil dan representatif terhadap tugas yang dirancang untuk LLM kita, kita akan mendapatkan perbandingan yang bermakna dari waktu ke waktu dan antar model atau versi berbeda. Jika dataset berubah, sulit untuk mengatribusikan perubahan performa pada model alih-alih dataset itu sendiri.
Bukan hanya datasetnya, tetapi juga cara kita melakukan praproses juga penting. Kita perlu menerapkan langkah praproses yang sama pada semua dataset evaluasi untuk memastikan hasil yang dapat dibandingkan. Ini mencakup tokenisasi, normalisasi, dan penanganan kasus khusus. Praproses yang konsisten memastikan variasi performa model tidak disebabkan oleh perbedaan dalam penanganan data.
Seperti terlihat di atas, menggunakan model registry MLflow untuk memungkinkan version control membantu kita melacak berbagai versi LLM. Ini memudahkan perbandingan performa model dan melakukan rollback ke versi sebelumnya jika diperlukan. Kita harus mencatat semua detail dan melacak perubahan yang dibuat pada model, termasuk modifikasi arsitektur, hiperparameter, atau data pelatihan.
Terakhir, otomatisasikan proses evaluasi dengan mengintegrasikannya ke dalam pipeline continuous integration/continuous deployment (CI/CD) agar model dievaluasi secara konsisten dan tepat waktu setiap kali ada pembaruan. Kita harus menyiapkan evaluasi terjadwal untuk menilai performa model secara berkala. Ini membantu memantau model drift dan memastikan model memenuhi standar performa seiring waktu.
Mengevaluasi LLM secara efektif memerlukan pendekatan yang terstruktur dan sistematis, dan MLflow menyediakan kerangka kerja untuk mendukung proses ini.
Dalam tutorial ini, kita memasang MLflow dan menyiapkan tracking server. Lalu, kita mengevaluasi LLM dengan mencatat metrik penting, melacak beberapa run untuk membandingkannya, dan menggunakan UI MLflow untuk memvisualisasikan serta menganalisis perbandingan tersebut secara efektif.
Jika Anda ingin meningkatkan pengetahuan MLflow ke tingkat berikutnya, lihat kursus Introduction to MLflow kami!
Pelajari lebih lanjut tentang LLM dengan kursus-kursus ini!
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



