

Pass@k मीट्रिक को समझना
HumanEval पारंपरिक मैच-आधारित मीट्रिक्स से अलग है। यह 'फंक्शनल करेक्टनेस' नामक अधिक व्यावहारिक दृष्टिकोण अपनाता है, जो किसी समस्या के लिए जनरेट किए गए शीर्ष k कोड नमूनों में से कम-से-कम एक के यूनिट टेस्ट पास करने की प्रायिकता का आकलन करने हेतु pass@k मीट्रिक का उपयोग करता है।
टेक्स्ट समानता से फंक्शनल करेक्टनेस की ओर यह बदलाव किसी मॉडल की प्रोग्रामिंग चुनौतियों को हल करने की क्षमता का अधिक अर्थपूर्ण आकलन प्रदान करता है। यह प्रक्रिया वैसी ही है जैसी डेवलपर अपने कोड की शुद्धता का मूल्यांकन करने के लिए यूनिट टेस्टिंग करते हैं।
pass@k मीट्रिक की गणना के लिए गणितीय सूत्र नीचे दिया गया है:
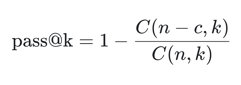
- n: जनरेट किए गए कुल नमूनों की संख्या।
- c: n नमूनों में से सही नमूनों की संख्या।
- k: विचार किए गए नमूनों की संख्या (टॉप k)।
pass@k मीट्रिक की गणना इस प्रकार होती है:
- C(n-c, k): गलत नमूनों (n-c) में से k नमूने चुनने के तरीकों की संख्या निकालता है। यह वह स्थिति दर्शाता है जहाँ चुने गए सभी k नमूने गलत हों।
- C(n,k)/C(n−c,k): यह भिन्न दर्शाता है कि चुने गए सभी k नमूने गलत होने की प्रायिकता क्या है।
- 1 - C(n−c,k)/C(n,k): इस प्रायिकता को 1 से घटाने पर वह प्रायिकता मिलती है कि k नमूनों में से कम-से-कम एक सही है—यही pass@k मीट्रिक है।
pass@k मीट्रिक कोड जेनरेशन मॉडलों के व्यावहारिक प्रदर्शन का आकलन करने में विशेष रूप से उपयोगी है, क्योंकि यह सीमित प्रयासों में सही समाधान उत्पन्न होने की संभावना को दर्शाता है।
यह मीट्रिक प्रतिस्पर्धी परिवेशों में व्यापक रूप से उपयोग किया जाता है, जैसे Papers with Code द्वारा होस्ट किए जाने वाले लीडरबोर्ड्स, जहाँ मॉडलों को उनके pass@k स्कोर, जैसे pass@10 और pass@100, के आधार पर रैंक किया जाता है।
HumanEval सुनिश्चित करता है कि जनरेट किया गया कोड वाक्य-विन्यास की दृष्टि से सही और फंक्शनल रूप से प्रभावी हो।
Hugging Face Evaluate का उपयोग करके HumanEval मूल्यांकन करना
इस प्रोजेक्ट में, हम OpenAI HumanEval डेटासेट लोड करेंगे और codeparrot/codeparrot-small पर फंक्शनल करेक्टनेस मूल्यांकन चलाएँगे।
हम तेज़ मूल्यांकन समय के लिए एक छोटा कोड जेनरेशन मॉडल चुन रहे हैं क्योंकि हम कई लूप चलाने वाले हैं: बाहरी लूप 164 (समस्याओं की संख्या) और आंतरिक लूप 5 (एक समस्या के लिए जनरेट किए गए नमूनों की संख्या)।
1. सेटअप
हम Evaluate Python लाइब्रेरी (Hugging Face द्वारा) इंस्टॉल करके शुरू करेंगे। Evaluate एक शक्तिशाली लाइब्रेरी है जो आपको विभिन्न डोमेन्स में मशीन लर्निंग मॉडलों और डेटासेट्स का आसानी से मूल्यांकन करने देती है—एक ही लाइन के कोड से—और लोकल मशीनों से लेकर डिस्ट्रीब्यूटेड ट्रेनिंग सेटअप तक, स्थिरता और पुनरुत्पादकता सुनिश्चित करती है।
%%capture
%pip install evaluateसाथ ही, एक वातावरण चर सेट करें जो हमें मॉडल मूल्यांकन चलाने की अनुमति देगा।
import os
os.environ["HF_ALLOW_CODE_EVAL"] = "1"
os.environ["TOKENIZERS_PARALLELISM"] = "false"2. डेटासेट और मूल्यांकन मीट्रिक लोड करना
हम Hugging Face से openai_humaneval डेटासेट लोड करेंगे। इस डेटासेट में 164 Python प्रोग्रामिंग समस्याएँ हैं और इसमें टिप्पणियों व डॉकस्ट्रिंग्स में मिलने वाला अंग्रेज़ी प्राकृतिक पाठ शामिल है।
हम code_eval मूल्यांकन मीट्रिक भी लोड करेंगे, जिससे हम HumanEval बेंचमार्क चला सकें।
from datasets import load_dataset
from evaluate import load
from transformers import AutoModelForCausalLM, AutoTokenizer
import torch
from tqdm import tqdm
# Load HumanEval dataset
human_eval = load_dataset("openai_humaneval")['test']
# Load code evaluation metric
code_eval_metric = load("code_eval")3. मॉडल और टोकनाइज़र लोड करना
Hugging Face Hub से CodeParrot मॉडल और टोकनाइज़र लोड करें। CodeParrot GPT-2-आधारित मॉडल है, जिसमें 110 मिलियन पैरामीटर हैं, और इसे विशेष रूप से Python कोड जनरेट करने के लिए प्रशिक्षित किया गया है।
# Specify the model name or path
model_name = "codeparrot/codeparrot-small"
# Load the model and tokenizer
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)
model.eval()4. टोकनाइज़र को ठीक करना
pad_token_id और pad_token_id सेट करें और यदि नए टोकन जोड़े जाते हैं तो मॉडल एम्बेडिंग्स का आकार बदलें।
# Set pad_token_id and pad_token_id if not already set
if tokenizer.pad_token_id is None:
tokenizer.pad_token_id = 0 # Commonly used pad token ID
if tokenizer.eos_token_id is None:
tokenizer.eos_token_id = 2 # Commonly used eos token ID for Llama
# Ensure the tokenizer has the pad and eos tokens
if tokenizer.pad_token is None:
tokenizer.add_special_tokens({'pad_token': '<pad>'})
if tokenizer.eos_token is None:
tokenizer.add_special_tokens({'eos_token': '</s>'})
# Resize model embeddings if new tokens were added
if len(tokenizer) > model.config.vocab_size:
model.resize_token_embeddings(len(tokenizer))5. कोड समाधान जनरेट करना
यहीं मुख्य काम होता है। हम प्रति समस्या पाँच नमूनों के लिए HumanEval चलाएँगे, और कुल 164 समस्याओं का मूल्यांकन करेंगे। बाहरी लूप डेटासेट से प्रॉम्प्ट और टेस्ट निकालेगा। प्रॉम्प्ट का उपयोग करके, यह उसी समस्या के लिए पाँच अलग-अलग नमूने जनरेट करेगा।
इस प्रक्रिया के अंत तक, हमारे पास दो सूचियाँ होंगी: test_cases और candidates।
- Test Cases: सीधे डेटासेट से निकाले गए।
- Candidates: प्रत्येक समस्या के लिए पाँच जनरेट किए गए कोड नमूने।
यह सेटअप जनरेट किए गए समाधानों का टेस्ट केसों के विरुद्ध व्यापक मूल्यांकन और तुलना संभव बनाता है।
# Set the number of candidates per problem
num_samples_per_problem = 5 # Adjust as needed for pass@k computation
# Lists to store test cases and predictions
test_cases = []
candidates = []
# Create a progress bar for the outer loop (problems)
print("Generating code solutions...")
for problem in tqdm(human_eval, desc="Problems", unit="problem"):
prompt = problem['prompt']
test_code = problem['test']
# Store the test cases
test_cases.append(test_code)
# Generate multiple candidate solutions for each problem
problem_candidates = []
# Create a progress bar for the inner loop (samples per problem)
for _ in range(num_samples_per_problem):
# Encode the prompt and get attention mask
inputs = tokenizer(prompt, return_tensors="pt").to(device)
# Generate code with attention mask and proper token IDs
with torch.no_grad():
outputs = model.generate(
input_ids=inputs['input_ids'],
attention_mask=inputs['attention_mask'],
max_length=512,
do_sample=True,
temperature=0.7,
top_p=0.95,
num_return_sequences=1,
pad_token_id=tokenizer.pad_token_id,
eos_token_id=tokenizer.eos_token_id,
)
generated_code = tokenizer.decode(outputs[0], skip_special_tokens=True)
# Remove the prompt from the generated code
generated_code = generated_code[len(prompt):]
problem_candidates.append(generated_code)
# Add the candidates for the current problem
candidates.append(problem_candidates)
print("Code generation complete.")आउटपुट:
Generating code solutions...
Problems: 100%|██████████| 164/164 [34:35<00:00, 12.66s/problem]
Code generation complete.6. pass@k की गणना
अब हम जनरेटेड कोड नमूनों के लिए विभिन्न k (1 और 5) मूल्यों पर पास दर की गणना करेंगे—उन्हें संदर्भ टेस्ट केसों के विरुद्ध तुलना करके—pass@k मूल्यांकन मीट्रिक का उपयोग करते हुए, और फिर प्रत्येक k मान के लिए सफलता दर को प्रतिशत में आउटपुट करेंगे।
# Compute pass@k
k_values = [1, 5]
print("Evaluating generated code...")
pass_at_k, results = code_eval_metric.compute(
references=test_cases,
predictions=candidates,
k=k_values,
num_workers=4, # Adjust based on your system
timeout=10.0, # Adjust the timeout as needed
)
# Print the results
for k in k_values:
print(f"Pass@{k}: {pass_at_k[f'pass@{k}'] * 100:.2f}%")परिणाम बताते हैं कि शीर्ष प्रत्याशी पर विचार करते समय (Pass@1) 27.07% जनरेटेड कोड नमूने मूल्यांकन मानदंड पास करते हैं, जबकि शीर्ष पाँच प्रत्याशियों पर विचार करने पर (Pass@5) 65.85% पास करते हैं। यह प्रदर्शन अच्छा माना जा सकता है, खासकर क्योंकि हम Python कोड जनरेट करने के लिए एक छोटे भाषा मॉडल का उपयोग कर रहे हैं।
हालाँकि, GPT-4o से तुलना करने पर, जिसका Pass@1 दर 90.2% है, ये परिणाम अपेक्षाकृत कमज़ोर लगते हैं।
Evaluating generated code...
Pass@1: 27.07%
Pass@5: 65.85%यदि आपको उपरोक्त कोड चलाने में समस्या आ रही है, तो कृपया HumanEval with the DeepEval Kaggle नोटबुक देखें।
आप MLflow के साथ अपने LLM मूल्यांकन को कैसे सरल बनाएँ, यह भी सीख सकते हैं—इसके लिए Evaluating LLMs with MLflow ट्यूटोरियल का पालन करें।
निष्कर्ष
HumanEval डेटासेट अपेक्षाकृत सरल है और वास्तविक दुनिया की प्रोग्रामिंग चुनौतियों का केवल आंशिक प्रतिनिधित्व कर सकता है। इसके अलावा, ओवरफिटिंग को लेकर चिंताएँ हैं, क्योंकि मॉडल समान डेटासेट्स पर प्रशिक्षित हो सकते हैं, जो विशेष रूप से HumanEval पर बेहतर प्रदर्शन का कारण बन सकता है।
इसलिए, जब कोड जेनरेशन क्षमताओं के लिए बड़े भाषा मॉडलों (LLMs) का मूल्यांकन किया जाता है, तो MBPP (Mostly Basic Python Problems), ClassEval, DevQualityEval, आदि जैसे कई प्रदर्शन मीट्रिक्स पर विचार करना आवश्यक है।
पूरी करें AI Fundamentals स्किल ट्रैक और ChatGPT, बड़े भाषा मॉडल, जनरेटिव AI, और अन्य लोकप्रिय AI विषयों पर कारगर ज्ञान प्राप्त करें।

एक प्रमाणित डेटा साइंटिस्ट के रूप में, मैं अत्याधुनिक तकनीक का उपयोग करके नवाचारी मशीन लर्निंग अनुप्रयोग बनाने के लिए उत्साहित रहता/रहती हूँ। स्पीच रिकॉग्निशन, डेटा विश्लेषण और रिपोर्टिंग, MLOps, संवादात्मक AI और NLP में मजबूत पृष्ठभूमि के साथ, मैंने ऐसे बुद्धिमान सिस्टम विकसित करने में अपनी विशेषज्ञता निखारी है जो वास्तविक प्रभाव डाल सकें। तकनीकी दक्षता के अलावा, मैं जटिल अवधारणाओं को स्पष्ट और संक्षिप्त भाषा में प्रस्तुत करने में भी निपुण हूँ। परिणामस्वरूप, मैं डेटा साइंस पर एक मांग में रहने वाला/वाली ब्लॉगर बन गया/गई हूँ, और डेटा प्रोफेशनलों के बढ़ते समुदाय के साथ अपने अनुभव और विचार साझा करता/करती हूँ। वर्तमान में, मैं कंटेंट निर्माण और संपादन पर केंद्रित हूँ, बड़े भाषा मॉडलों के साथ काम करते हुए ऐसा प्रभावशाली और आकर्षक कंटेंट विकसित कर रहा/रही हूँ जो व्यवसायों और व्यक्तियों दोनों को अपने डेटा का अधिकतम लाभ उठाने में मदद कर सके।
HumanEval OpenAI द्वारा विकसित एक बेंचमार्क डेटासेट है जो बड़े भाषा मॉडलों (LLMs) के कोड जेनरेशन कार्यों में प्रदर्शन का मूल्यांकन करता है। यह AI मॉडलों की कोड को समझने और जनरेट करने की क्षमता का आकलन करने के लिए एक महत्वपूर्ण उपकरण बन गया है।
इस ट्यूटोरियल में, हम HumanEval और pass@k मीट्रिक के बारे में जानेंगे। इसके अलावा, हम
codeparrot-smallमॉडल की 164 समस्याओं पर कोड जेनरेशन क्षमताओं का मूल्यांकन करेंगे।HumanEval मूल्यांकन प्रक्रिया के लिए, हम Hugging Face इकोसिस्टम का उपयोग करेंगे ताकि डेटासेट, मॉडल, और आवश्यक मीट्रिक्स लोड किए जा सकें। यदि आप LLMs और उनकी क्षमताओं की दुनिया में नए हैं, तो हमारा Developing Large Language Models पाठ्यक्रम देखें।
चित्र: लेखक द्वारा
HumanEval क्या है?
HumanEval OpenAI द्वारा विशेष रूप से बड़े भाषा मॉडलों के मूल्यांकन के लिए विकसित किया गया डेटासेट है। यह LLMs को कोड जेनरेशन कार्यों पर परखने के लिए एक संदर्भ बेंचमार्क के रूप में कार्य करता है, जिसमें मॉडलों की भाषा समझने, तर्क करने, और एल्गोरिदम व सरल गणित से संबंधित समस्याओं को हल करने की क्षमता पर फोकस होता है।
इस डेटासेट में 164 हाथ से लिखी गई प्रोग्रामिंग समस्याएँ शामिल हैं, जिनमें प्रत्येक में एक फ़ंक्शन सिग्नेचर, डॉकस्ट्रिंग, बॉडी, और कई यूनिट टेस्ट होते हैं—औसतन प्रति समस्या 7.7 टेस्ट।
नीचे दिए गए उदाहरण में, हम ह्यूमन इवैल्यूएशन रिपोजिटरी को क्लोन करेंगे, आवश्यक Python पैकेज इंस्टॉल करेंगे, और फिर उदाहरण डेटासेट पर फंक्शनल करेक्टनेस मूल्यांकन चलाएँगे।
हमें परिणाम pass@k के रूप में मिला, और हमारे मामले में pass@1। यह मीट्रिक पहले प्रयास में मॉडल की 50% सफलता दर को दर्शाती है। हम अगले सेक्शन में इस मीट्रिक के बारे में विस्तार से जानेंगे।
यह जानने के लिए LLM Evaluation: Metrics, Methodologies, Best Practices ब्लॉग पढ़ें कि सूचित निर्णय लेने के लिए प्रमुख मीट्रिक्स, कार्यप्रणालियाँ, और सर्वोत्तम प्रथाओं का उपयोग करके LLMs का मूल्यांकन कैसे करें।