Kurs
R’ye Giriş
4 sa
3.1M
Doğrusal regresyon, en önemli ve temel istatistiksel tekniklerden biridir. Bu tekniğe hâkim olmak, göreceğiniz üzere birçok ileri yöntemin temelini oluşturduğundan, her veri analisti ve veri bilimcisi için gereklidir.
Bu eğitim, önemli bir programlama dili olan R'da doğrusal regresyon gerçekleştirme sürecinde size rehberlik edecek. Eğitimin sonunda, doğrusal regresyon modellerini nasıl uygulayacağınızı ve yorumlayacağınızı anlayacak, böylece bu bilgiyi veri analizi görevlerinize daha kolay şekilde aktarabileceksiniz.
R programlama diline aşina değilseniz, başlamanıza yardımcı olacak şu eğitimlerimizi öneririm: Tam Yeni Başlayanlar için R'da Keşifsel Veri Analizi ve R Programlama Dilinde Veri Yapılarını Öğrenme.
Doğrusal regresyon, bir yanıt değişkeni (genellikle y olarak adlandırılır) ile bir veya daha fazla değişken ve bunların etkileşimleri (genellikle x ya da açıklayıcı değişkenler) arasındaki ilişkiyi analiz eden bir istatistiksel modeldir. Bu tür bir ilişkiyi zihninizde sık sık kurarsınız; örneğin, bir çocuğun boyundan yaşını tahmin ederken, yaşı arttıkça boyunun uzayacağı varsayımında bulunursunuz.
Doğrusal regresyon, en temel istatistiksel modellerden biridir. Sonuçları neredeyse herkes tarafından yorumlanabilir ve 19. yüzyılın başlarından beri kullanılmaktadır. Tam da bu yüzden bu kadar popülerdir. Basittir ve yüzlerce yıldır ayaktadır. Yapay sinir ağları veya rastgele ormanlar gibi diğer algoritmalar kadar sofistike olmasa da, KD Nuggets tarafından yapılan bir ankete göre regresyon, 2016 ve 2017 yıllarında veri bilimciler tarafından en çok kullanılan algoritmaydı. Hatta 2118 yılında bile kullanılacağı öngörülüyor!
Bu doğrusal regresyon eğitiminde, R'da doğrusal regresyonu nasıl oluşturacağımızı, adım adım ilerleyerek üzerinde çalışabileceğiniz bir örnekle keşfedeceğiz.
Bu eğitimdeki tüm örnek kodları kendiniz kolayca çalıştırmak için, R'ın önceden kurulu olduğu ve tüm kod örneklerini içeren ücretsiz bir DataLab çalışma kitabı oluşturabilirsiniz. Doğrusal regresyon pratiği için uygulamalı DataCamp alıştırmamıza da göz atın.
Her problem aynı algoritmayla çözülemez. Doğrusal regresyon, yanıt ve sonuç arasında doğrusal bir ilişki olduğunda iyi bilinen bir yöntemdir. Başka bir deyişle, doğrusal regresyon yanıt değişkeni ile açıklayıcı değişkenler arasında bir doğrusal ilişki bulunduğunu varsayar. İki değişken söz konusu olduğunda, bu, iki değişken arasında bir doğru çizebileceğiniz anlamına gelir. Çocuğun yaşı örneğimize dönersek, çocukların yaşı ile boyları arasında bir ilişki olduğu açıktır.
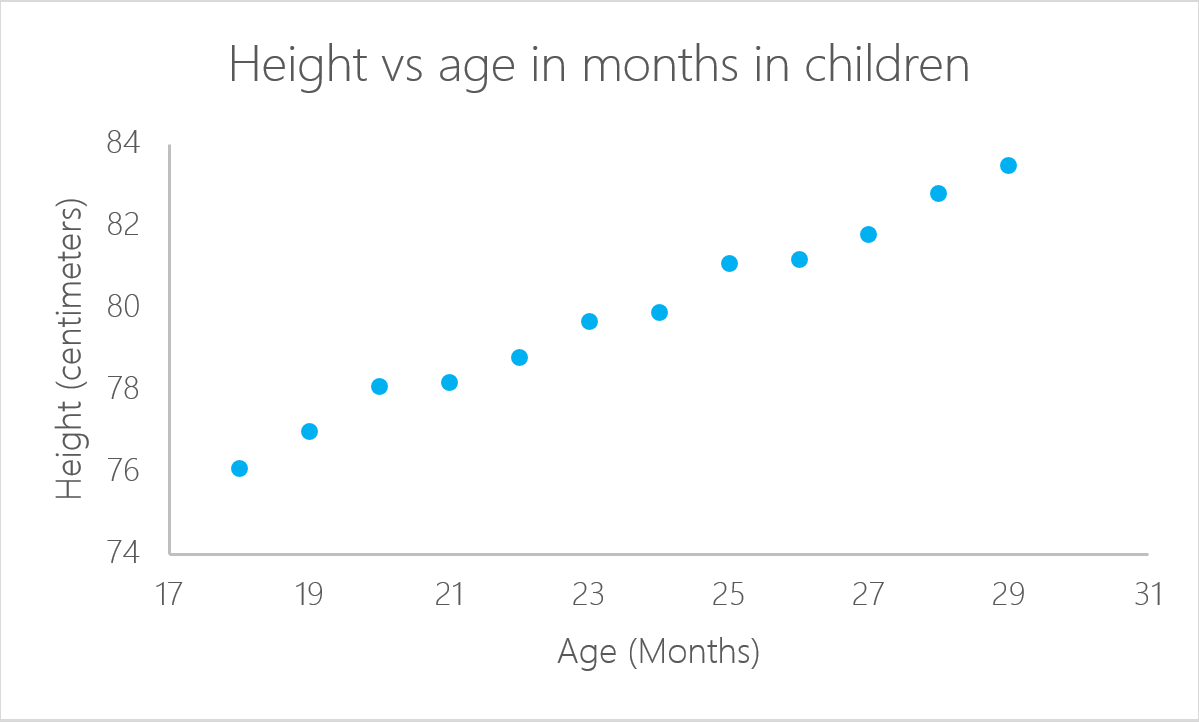
Bu özel örnekte, yaşını biliyorsanız bir çocuğun boyunu hesaplayabilirsiniz:
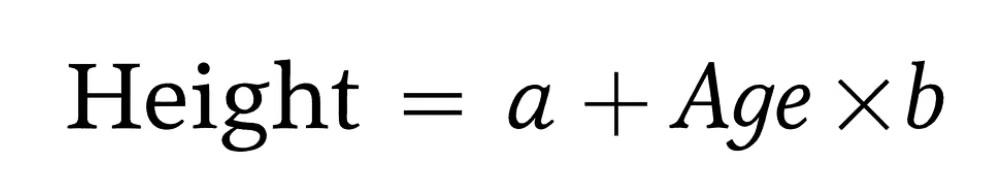
Bu durumda a ve b sırasıyla sabit terim (intercept) ve eğim (slope) olarak adlandırılır. Aynı örnek üzerinden gidersek, a yani sabit terim, ölçmeye başladığınız değerdir. Sıfır aylık yeni doğan bebekler sıfır santimetre boyunda değildir. Sabit terimin görevi budur. Eğim ise ay cinsinden yaşa göre boydaki değişimi ölçer. Genel olarak, çocuk her ay büyüdükçe boyu b kadar artar.
R'da doğrusal regresyon lm() komutuyla hesaplanabilir. Bir sonraki örnekte, bu komutu kullanarak çocuğun yaşına göre tahmini boyu hesaplayacağız.
Önce Microsoft Excel dosyalarını okumak için readxl kütüphanesini içe aktarın. Excel veya CSV dosyalarını RStudio gibi bir R ortamına aktarmaya aşina değilseniz, R'da Veri İçe Aktarmaya Giriş kursumuz harika bir kaynaktır.
Başlamadan önce bu eğitimde kullanacağınız verileri indirebilirsiniz. Verileri ageandheight adlı bir nesneye indirin ve üçüncü satırda doğrusal regresyonu oluşturun. lm() fonksiyonu değişkenleri şu biçimde alır:
lm([target] ~ [predictor], data = [data source])Aşağıdaki kodda, lm() fonksiyonunu kullanarak lmHeight adını verdiğimiz bir doğrusal model nesnesi oluşturuyoruz. Ardından, modelin performansı ve katsayıları hakkında ayrıntılı bilgi görmek için lmHeight üzerinde summary() fonksiyonunu kullanıyoruz.
library(readxl)

ageandheight <- read_excel("ageandheight.xls", sheet = "Hoja2") #Upload the data

lmHeight = lm(height~age, data = ageandheight) #Create the linear regression

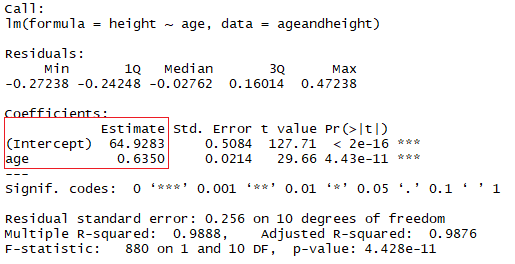
summary(lmHeight) #Review the resultsKırmızı kare içinde, yaş için sabit terimin (“a” değeri) ve eğimin (“b” değeri) değerlerini görebilirsiniz. Bu “a” ve “b” değerleri, verinin tüm noktaları arasına bir doğru çizer. Dolayısıyla, bu durumda 20,5 aylık bir çocuk varsa, a 64,92 ve b 0,635 olduğunda, model (ortalama olarak) boyunun santimetre cinsinden yaklaşık 64,92 + (0,635 × 20,5) = 77,93 cm olacağını tahmin eder.
Bir regresyon, doğrusal regresyonu oluşturmak için iki ya da daha fazla yordayıcıyı hesaba kattığında buna çoklu doğrusal regresyon denir. Önceki basit örnekte kullandığınız aynı mantıkla, çocuğun boyu şu şekilde ölçülecektir:
Boy = a + Yaş × b1 + (Kardeş Sayısı} × b2
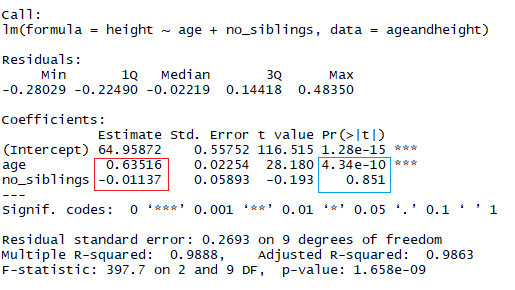
Artık boyu, ay cinsinden yaşın ve çocuğun sahip olduğu kardeş sayısının bir fonksiyonu olarak görüyorsunuz. Yukarıdaki görselde, kırmızı dikdörtgen katsayıları (b1 ve b2) göstermektedir. Bu katsayıları şu şekilde yorumlayabilirsiniz:
Aynı kardeş sayısına sahip çocuklar karşılaştırıldığında, çocuğun her ayı için ortalama tahmin edilen boy 0,63 cm artar. Benzer şekilde, aynı yaşa sahip çocuklar karşılaştırıldığında, kardeş sayısındaki her artış için boy (katsayı negatif olduğu için) -0,01 cm azalır.
R'da başka bir katsayı eklemek için, modele eklemek istediğiniz her ilave değişken için "+" sembolünü ekleyin.
lmHeight2 = lm(height~age + no_siblings, data = ageandheight) #Create a linear regression with two variables
summary(lmHeight2) #Review the results
Fark etmiş olabileceğiniz gibi, kardeş sayısına bakmak bir çocuğun boyunu tahmin etmek için pek mantıklı değildir. Doğrusal modellerinizde dikkat etmeniz gereken bir diğer husus da katsayıların p-değeridir. Önceki örnekte, mavi dikdörtgen yaş ve kardeş sayısı katsayılarının p-değerlerini göstermektedir. Basitçe söylemek gerekirse p-değeri, bir hipotezi reddedip edemeyeceğinizi gösterir. Bu durumda hipotez, yordayıcının modeliniz için anlamlı olmadığıdır.
Yordayıcıların anlamlı olmadığını test etmenin standart bir yolu, p-değerlerinin 0,05’ten küçük olup olmadığına bakmaktır.
Modelin uyum kalitesini test etmenin iyi bir yolu, artık değerlerine veya gerçek değerlerle tahmin edilen değerler arasındaki farklara bakmaktır. Yukarıdaki görseldeki düz çizgi tahmin edilen değerleri temsil eder. Düz çizgiden gözlenen veri değerine uzanan kırmızı dikey çizgi artık değerdir.
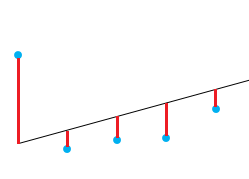
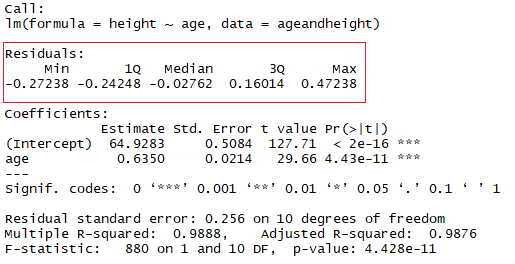
Buradaki fikir, artıkların toplamının yaklaşık sıfır ya da mümkün olduğunca düşük olmasıdır. Gerçek hayatta çoğu durum mükemmel bir doğruyu takip etmez, dolayısıyla artıkların olması beklenir. R'daki lm() fonksiyonunun özetinde, modelin artıklarına ilişkin tanımlayıcı istatistikleri görebilirsiniz; aynı örneği takip ederek kırmızı kare artıkların yaklaşık olarak sıfır olduğunu gösterir.
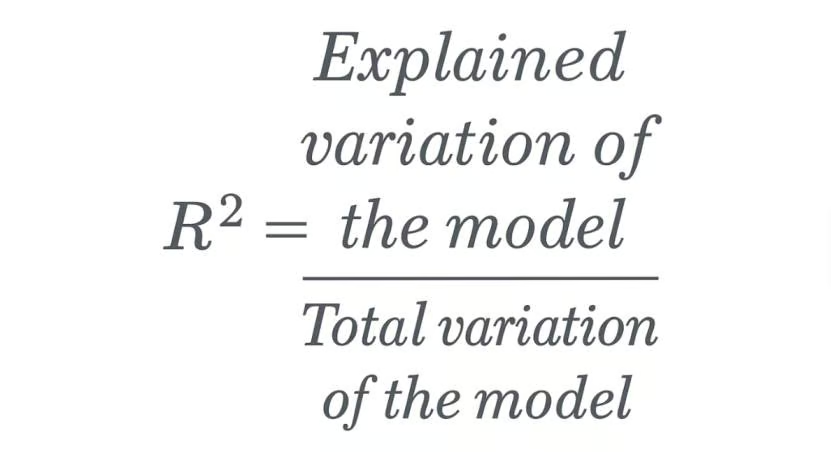
Modelinizin ne kadar iyi olduğunu test etmek için çok sık kullanılan bir ölçü, belirleme katsayısı ya da R²'dir. Bu ölçü, toplam değişkenliğin regresyon modeli tarafından açıklanan oranı olarak tanımlanır.
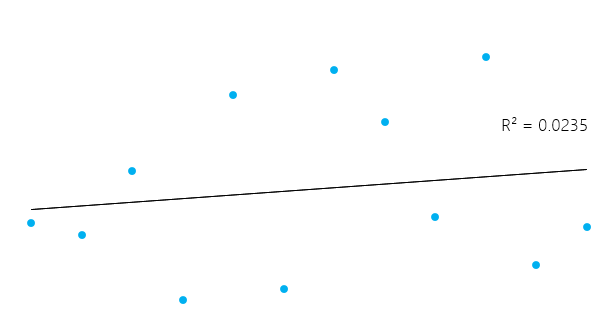
Bu biraz karmaşık görünebilir; ancak genel olarak, veriye iyi uyan modellerde R² 1'e yakındır. Veriye kötü uyan modellerin R²'si 0'a yakındır. Aşağıdaki örneklerde, ilkinde R² 0,02’dir; bu, modelin veri değişkenliğinin yalnızca %2’sini açıkladığı anlamına gelir. İkincisinde R² 0,99’dur ve model toplam değişkenliğin %99’unu açıklayabilir.**
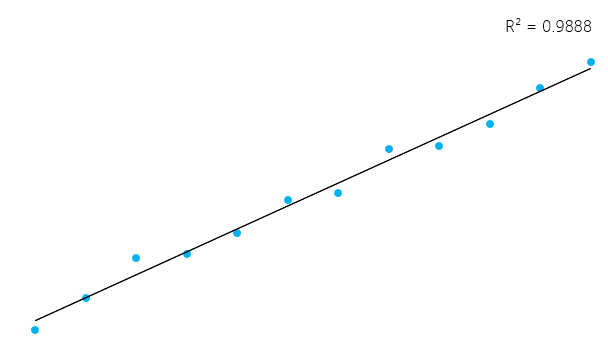
Ancak, bazen yüksek bir R²'nin her zaman iyi olmadığını (aşağıdaki artık grafiklerine bakın) ve düşük bir R²'nin de her zaman kötü olmadığını akılda tutmak önemlidir. Gerçek hayatta olaylar her zaman mükemmel bir doğruya uymaz. Örneğin, verinizde aynı yaşta daha uzun ya da daha kısa çocuklar olabilir. Bazı alanlarda 0,5’lik bir R² iyi kabul edilir.
Yukarıdaki aynı örnekle, modelin R² değerini görmek için doğrusal modelin özetine bakın.
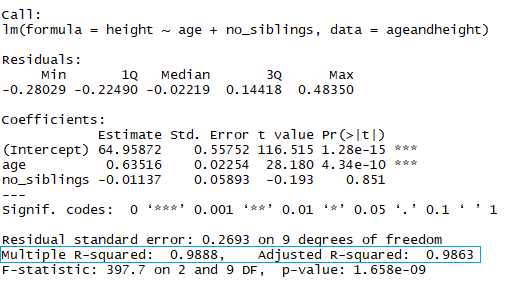
Mavi dikdörtgende, iki farklı R² olduğunu fark edin: biri multiple, diğeri düzeltilmiş (adjusted). Multiple olan, daha önce gördüğünüz R²'dir. Bu R² ile ilgili bir sorun, modele daha fazla bağımsız değişken ekledikçe azalamamasıdır; bu değişkenler tahminlerinize hiçbir şey katmasa (kardeş sayısı örneğinde olduğu gibi) bile, modeli karmaşıklaştırdıkça artmaya devam eder. Bu nedenle, modele birden fazla değişken ekliyorsanız, genel tahmin hatasını azalttığında artan düzeltilmiş R²'ye bakmak muhtemelen daha iyidir.
Modelinizde oldukça iyi bir R² olabilir ama aceleci sonuçlara varmayalım. Bir örneğe bakalım. Bir laboratuvarda bir malzemenin sıcaklığına bağlı olarak basıncını tahmin edeceksiniz.
Veriyi (basit bir saçılım grafiğinde) çizelim ve doğrusal modelinizle oluşturduğunuz doğruyu ekleyelim. Bu örnekte R’ın önce read_excel komutuyla veriyi okuyarak bir veri çerçevesi oluşturmasına izin verin, sonra yeni verinizle bir doğrusal regresyon oluşturun. plot() komutu bir veri çerçevesi alır ve içindeki değişkenleri çizer. Bu durumda, malzemenin sıcaklığına karşı basıncı çizer. Ardından, abline komutuyla doğrusal regresyonun oluşturduğu doğruyu ekleyin.
pressure <- read_excel("pressure.xlsx") #Upload the data
lmTemp = lm(Pressure~Temperature, data = pressure) #Create the linear regression
plot(pressure, pch = 16, col = "blue") #Plot the results
abline(lmTemp) #Add a regression line
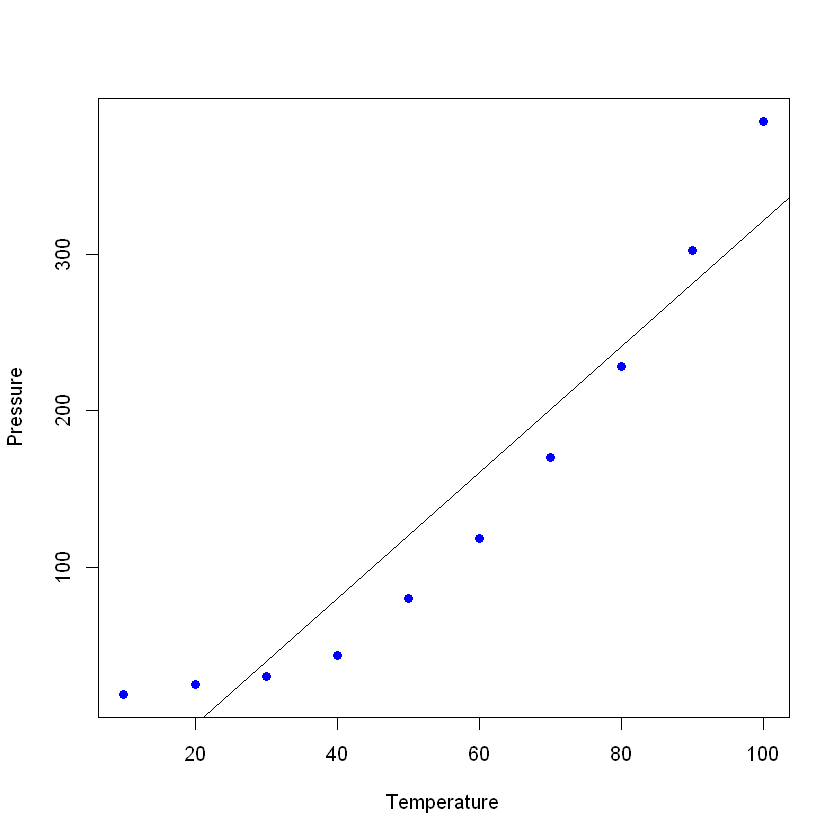
Yeni modelinizin özetine bakarsanız oldukça iyi sonuçları olduğunu görebilirsiniz (R² ve düzeltilmiş R²'ye bakın)
summary(lmTemp)
Call:
lm(formula = Pressure ~ Temperature, data = pressure)

Residuals:
   Min     1Q Median     3Q    Max
-41.85 -34.72 -10.90  24.69  63.51

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept) -81.5000    29.1395  -2.797   0.0233 *
Temperature   4.0309     0.4696   8.583 2.62e-05 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 42.66 on 8 degrees of freedom
Multiple R-squared:  0.902,    Adjusted R-squared:  0.8898
F-statistic: 73.67 on 1 and 8 DF,  p-value: 2.622e-05
İdeal olarak, artık değerleri çizdiğinizde rastgele görünmelidir. Aksi halde, doğrusal modelin dikkate almadığı gizli bir desen olabilir. Artıkları çizmek için plot(lmTemp$residuals) komutunu kullanın.
plot(lmTemp$residuals, pch = 16, col = "red")
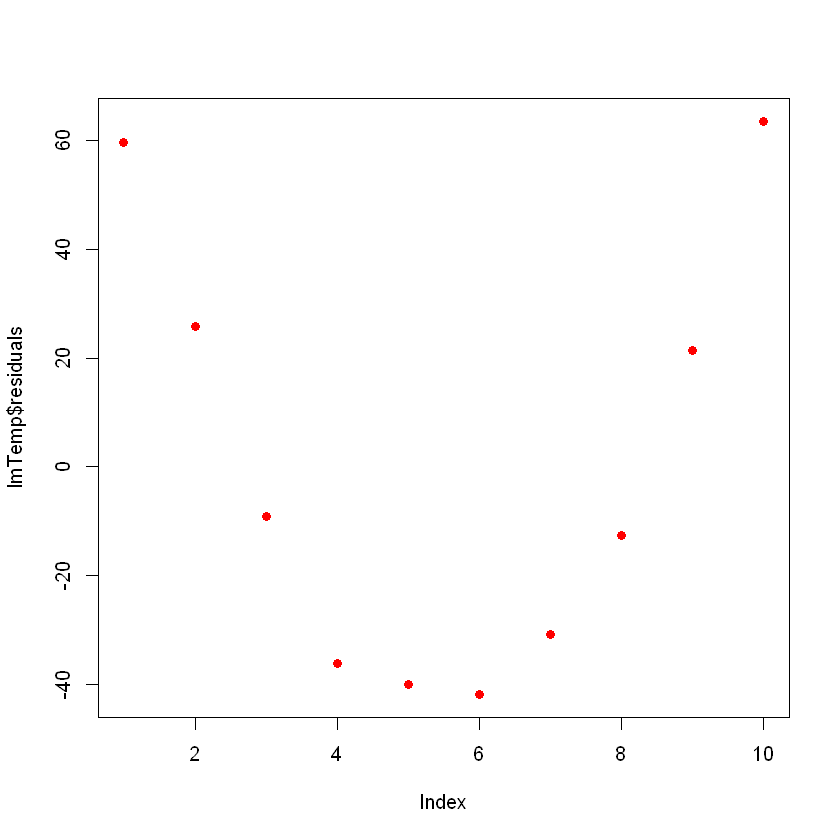
Bu bir sorun olabilir. Daha fazla veriniz olursa, basit doğrusal modeliniz iyi genelleme yapamayacaktır. Önceki görselde, bir desen (artıklarda bir eğri gibi) olduğunu fark edin. Hiç de rastgele değil.
Yapabileceğiniz şey, değişkenin bir dönüşümünü uygulamaktır. Veriniz üzerinde pek çok olası dönüşüm gerçekleştirilebilir; örneğin, bir ikinci dereceden terim (x2), bir kübik (x3) ya da ln(X), ln(X+1), sqrt(X), 1/x, Exp(X) gibi daha karmaşık dönüşümler. Doğru dönüşümün seçimi biraz cebirsel fonksiyon bilgisi, pratik, deneme ve yanılma ile gelecektir.
Bir ikinci dereceden terim deneyelim. Bunun için, dönüşümünüzden önce “I” (büyük "I") terimini ekleyin; örneğin bu, normal doğrusal regresyon formülü olacaktır:
lmTemp2 = lm(Pressure~Temperature + I(Temperature^2), data = pressure) #Create a linear regression with a quadratic coefficient
summary(lmTemp2) #Review the results
Call:
lm(formula = Pressure ~ Temperature + I(Temperature^2), data = pressure)

Residuals:
    Min      1Q  Median      3Q     Max
-4.6045 -1.6330  0.5545  1.1795  4.8273

Coefficients:
                  Estimate Std. Error t value Pr(>|t|)
(Intercept)      33.750000   3.615591   9.335 3.36e-05 ***
Temperature      -1.731591   0.151002 -11.467 8.62e-06 ***
I(Temperature^2)  0.052386   0.001338  39.158 1.84e-09 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 3.074 on 7 degrees of freedom
Multiple R-squared:  0.9996,    Adjusted R-squared:  0.9994
F-statistic:  7859 on 2 and 7 DF,  p-value: 1.861e-12
Modelin belirgin biçimde iyileştiğine dikkat edin. Yeni modelin artıklarını çizerseniz şöyle görünecekler:
plot(lmTemp2$residuals, pch = 16, col = "red")
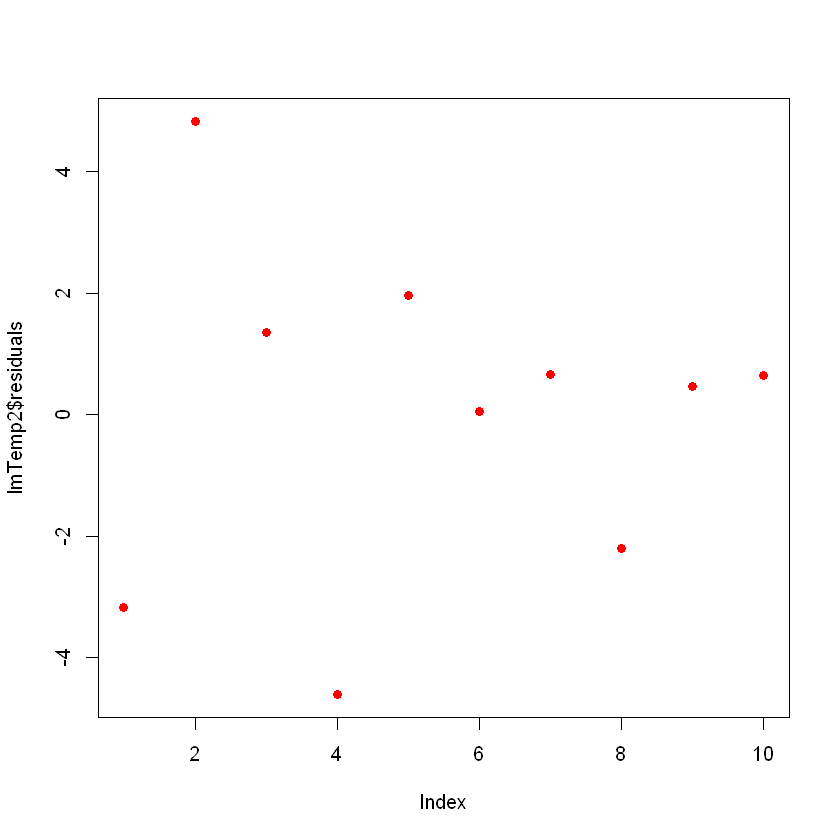
Artık artıklarınızda belirgin bir desen görmüyorsunuz; bu iyi!
Verinizde, bazen gereksiz yere modelinizi saptırabilecek etkileyici noktalar olabilir. Veri girişinde bir hata düşünün; “2,3” yazmak yerine değer “23” girilmiş olsun. En yaygın etkileyici nokta türü, gözlenen yanıtın verinin geri kalanı tarafından oluşturulan deseni takip etmediği uç değerlerdir (outlier).
Etkileyici noktaları, doğrusal modeli içeren nesneye bakarak, cooks.distance() fonksiyonunu kullanarak ve bu uzaklıkları çizerek tespit edebilirsiniz. Kasıtlı olarak bir değeri değiştirerek Cooks Distance grafiğinde nasıl göründüğüne bakın. Belirli bir değeri değiştirmek için doğrudan ageandheight[satır numarası, sütun numarası] = [yeni değer] ile işaret edebilirsiniz. Bu durumda, ikinci örneğin boyu 7,7 olarak değiştiriliyor:
ageandheight[2, 2] = 7.7
head(ageandheight)
| age | height | no_siblings |
|---|---|---|
| 18 | 76.1 | 0 |
| 19 | 7.7 | 2 |
| 20 | 78.1 | 0 |
| 21 | 78.2 | 3 |
| 22 | 78.8 | 4 |
| 23 | 79.7 | 1 |
Modeli yeniden oluşturup özetin kötü bir uyum verdiğini görebilir ve ardından Cooks Distance değerlerini çizebilirsiniz. Bunun için, doğrusal regresyonu oluşturduktan sonra cooks.distance([doğrusal model] komutunu kullanın ve isterseniz bu uzaklıkları plot() komutuyla çizebilirsiniz.
lmHeight3 = lm(height~age, data = ageandheight)#Create the linear regression
summary(lmHeight3)#Review the results
plot(cooks.distance(lmHeight3), pch = 16, col = "blue") #Plot the Cooks Distances.
Call:
lm(formula = height ~ age, data = ageandheight)

Residuals:
    Min      1Q  Median      3Q     Max
-53.704  -2.584   3.609   9.503  17.512

Coefficients:
            Estimate Std. Error t value Pr(>|t|)
(Intercept)    7.905     38.319   0.206    0.841
age            2.816      1.613   1.745    0.112

Residual standard error: 19.29 on 10 degrees of freedom
Multiple R-squared:  0.2335,    Adjusted R-squared:  0.1568
F-statistic: 3.046 on 1 and 10 DF,  p-value: 0.1115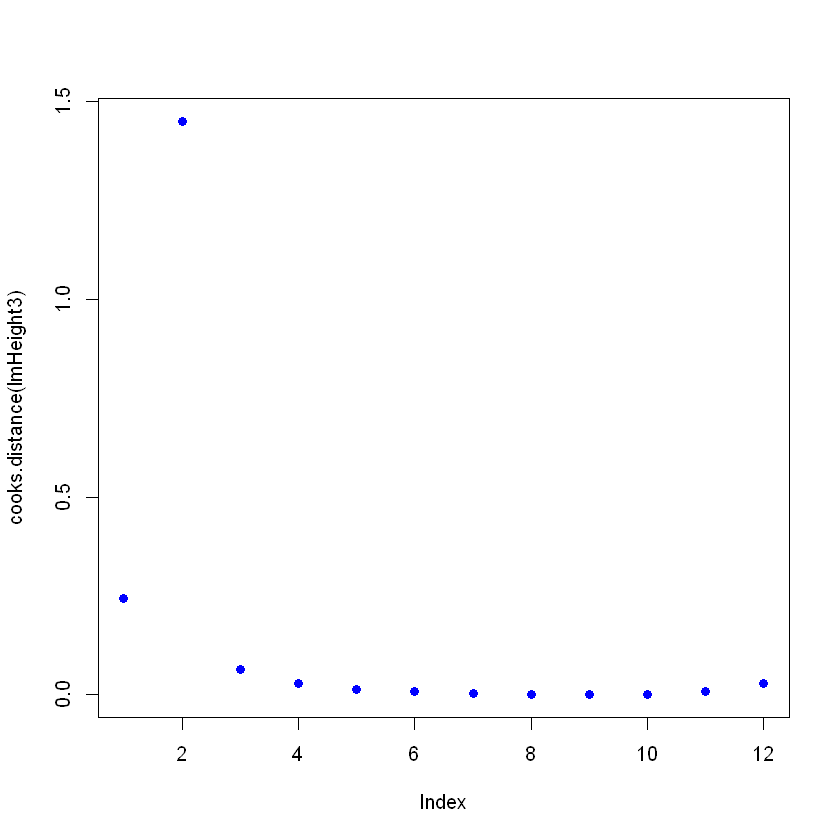
Dikkat: Deseni takip etmeyen ve modeli etkiliyor olabilecek bir nokta var. Bu noktada karar verebilirsiniz; genel olarak bir noktanın bu kadar etkileyici olmasının üç nedeni vardır:
Durum 1 veya 2 ise, noktayı kaldırabilirsiniz (ya da düzeltebilirsiniz). 3 ise, geçerli bir noktayı silmeye değmez; belki doğrusal regresyon gibi doğrusal bir model yerine doğrusal olmayan bir model deneyebilirsiniz.
Etkileyici bir nokta geçerli bir nokta olabilir; silmeden önce veriyi ve kaynağını kontrol ettiğinizden emin olun. İstatistik kitaplarında sıkça şu alıntıya rastlanır: “Bazen, sorgulanması gereken modelleri atmak yerine gayet iyi verileri atarız.”
Sonuna geldiniz! Doğrusal regresyon büyük bir konu ve burada kalıcı. Burada, güçlü ama basit bir algoritmadan en iyi şekilde yararlanabilmek için bazı püf noktaları sunduk. Ayrıca bu basit istatistiksel modelin ardındakileri anlamayı ve ihtiyaçlarınıza göre nasıl değiştirebileceğinizi öğrendiniz. R konsolunda ?lm yazarak burada ele alınmayan farklı parametrelere bakarak diğer seçenekleri de keşfedebilirsiniz. Düzenlileştirme Eğitimi: Ridge, Lasso ve Elastic Net yazımıza göz atın. İstatistiksel modellere dalmakla ilgileniyorsanız, R'da İstatistiksel Modellemenin Temelleri kursuna mutlaka bakın.
Doğrusal regresyon birçok ileri analitik tekniğin temelini oluşturduğundan, ekibinizin bunun ve diğer temel becerilerin sağlam bir kavrayışına sahip olması uzun vadeli başarı için kritik önemdedir.
İşletmeler için DataCamp, ekiplerini veri bilimi ve analitik alanlarında geliştirmek isteyen kuruluşlar için özel bir çözüm sunar. Regresyon ve öngörücü modelleme de dahil olmak üzere çok çeşitli istatistiksel yöntemleri kapsayan, uygulamalı ve pratik kurslardan oluşan özel öğrenme yollarıyla ekibiniz karmaşık veri zorluklarının üstesinden güvenle gelebilir.
Bugün bir demo talep edin ve ekibinizin veri analizindeki en güncel araç ve tekniklerle güncel kalmasını sağlayarak kuruluşunuzun geleceğine yatırım yapın.
R Kursları
Kurs
Kurs
Kurs
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




