

गुणांक (coefficients) क्या हैं?
लाल वर्ग में आप उम्र के लिए इंटरसेप्ट ("a" मान) और स्लोप ("b" मान) के मान देख सकते हैं। ये "a" और "b" मान डेटा के सभी बिंदुओं के बीच एक रेखा प्लॉट करते हैं। तो, इस मामले में, यदि कोई बच्चा 20.5 माह का है, a = 64.92 और b = 0.635 है, तो मॉडल (औसतन) अनुमान लगाता है कि उसकी लंबाई सेंटीमीटर में लगभग 64.92 + (0.635 * 20.5) = 77.93 सेमी है।
जब रिग्रेशन दो या अधिक प्रेडिक्टर को ध्यान में रखकर लीनियर रिग्रेशन बनाता है, तो इसे मल्टिपल लीनियर रिग्रेशन कहते हैं। ठीक उसी तर्क से जो आपने पहले सरल उदाहरण में इस्तेमाल किया, बच्चे की लंबाई मापी जाएगी:
Height = a + Age × b1 + (Number of Siblings} × b2
अब आप लंबाई को उम्र (महीनों में) और बच्चे के भाई-बहनों की संख्या के एक फलन के रूप में देख रहे हैं। ऊपर की छवि में, लाल आयत गुणांक (b1 और b2) को दर्शाती है। आप इन गुणांकों की व्याख्या इस तरह कर सकते हैं:
जब समान संख्या के भाई-बहनों वाले बच्चों की तुलना की जाती है, तो औसत अनुमानित लंबाई हर अतिरिक्त महीने पर 0.63 सेमी बढ़ती है। उसी तरह, जब समान उम्र वाले बच्चों की तुलना की जाती है, तो भाई-बहनों की संख्या में प्रत्येक वृद्धि पर लंबाई (क्योंकि गुणांक नकारात्मक है) -0.01 सेमी घटती है।
R में, एक और गुणांक जोड़ने के लिए, मॉडल में जोड़ना चाही जाने वाली हर अतिरिक्त चर के लिए "+" प्रतीक जोड़ें।
lmHeight2 = lm(height~age + no_siblings, data = ageandheight) #Create a linear regression with two variables
summary(lmHeight2) #Review the results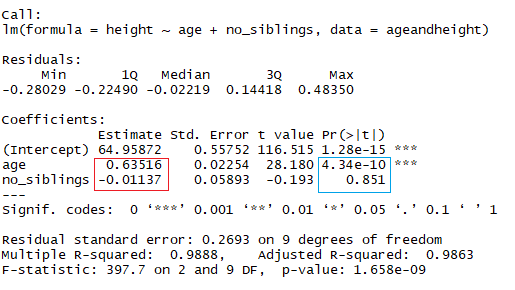
जैसा कि आप देख ही रहे होंगे, भाई-बहनों की संख्या देखकर बच्चे की लंबाई का अनुमान लगाना एक मूर्खतापूर्ण तरीका है। अपने लीनियर मॉडलों में ध्यान देने योग्य एक और पहलू गुणांकों के p-value हैं। पिछले उदाहरण में, नीला आयत उम्र और भाई-बहनों की संख्या के गुणांकों के p-values को दर्शाता है। सरल शब्दों में, p-value यह इंगित करता है कि आप किसी परिकल्पना को खारिज कर सकते हैं या स्वीकार कर सकते हैं। इस मामले में परिकल्पना यह है कि प्रेडिक्टर आपके मॉडल के लिए सार्थक नहीं है।
- उम्र के लिए p-value 4.34*e-10 या 0.000000000434 है। इतना छोटा मान दर्शाता है कि उम्र आपके मॉडल के लिए संभवतः एक उत्कृष्ट जोड़ है।
- भाई-बहनों की संख्या के लिए p-value 0.85 है। दूसरे शब्दों में, 85% संभावना है कि यह प्रेडिक्टर रिग्रेशन के लिए सार्थक नहीं है।
यह जाँचने का एक मानक तरीका कि प्रेडिक्टर्स सार्थक नहीं हैं, यह देखना है कि क्या p-values 0.05 से छोटे हैं।
रेजिडुअल्स क्या हैं?
मॉडल के फिट की गुणवत्ता की जाँच करने का एक अच्छा तरीका रेजिडुअल्स को देखना है—यानि वास्तविक मानों और अनुमानित मानों के बीच के अंतर। ऊपर की छवि में सीधी रेखा अनुमानित मानों का प्रतिनिधित्व करती है। सीधी रेखा से प्रेक्षित डेटा मान तक खींची गई लाल लंबवत रेखा रेजिडुअल है।
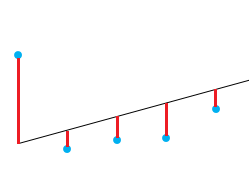
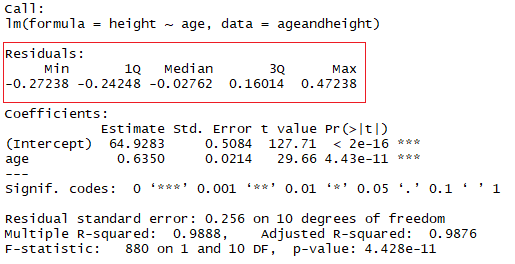
यहाँ विचार यह है कि रेजिडुअल्स का योग लगभग शून्य हो या यथासंभव कम हो। वास्तविक जीवन में ज्यादातर मामलों में बिल्कुल सीधी रेखा का पालन नहीं होगा, इसलिए रेजिडुअल्स अपेक्षित हैं। lm() फ़ंक्शन के R summary में आप मॉडल के रेजिडुअल्स के बारे में वर्णनात्मक आँकड़े देख सकते हैं—इसी उदाहरण का अनुसरण करते हुए, लाल वर्ग दिखाता है कि रेजिडुअल्स लगभग शून्य हैं।
कैसे जाँचें कि आपका लीनियर मॉडल अच्छा फिट है या नहीं
आपके मॉडल की गुणवत्ता जाँचने के लिए बहुत सामान्य रूप से उपयोग किया जाने वाला एक माप निर्धारण गुणांक या R² है। यह माप रिग्रेशन मॉडल द्वारा समझाई गई कुल विविधता के अनुपात से परिभाषित होता है।
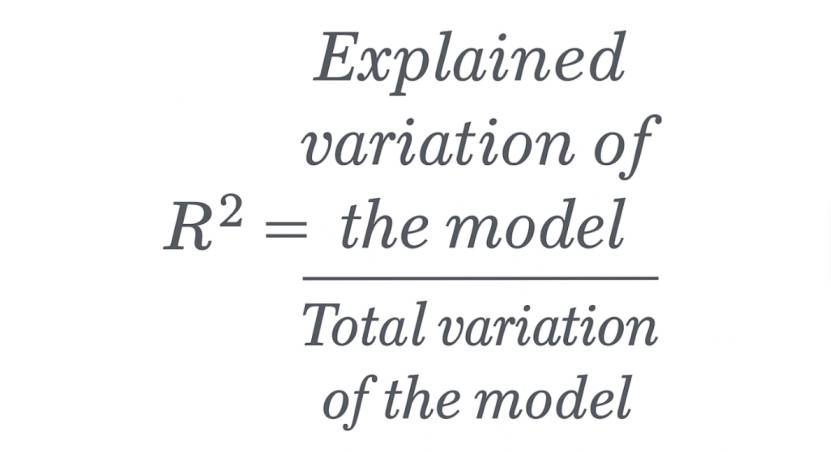
यह थोड़ा जटिल लग सकता है, लेकिन सामान्यतः, जो मॉडल डेटा को अच्छी तरह फिट करते हैं, उनका R² 1 के करीब होता है। जो मॉडल डेटा को खराब फिट करते हैं, उनका R² 0 के करीब होता है। नीचे के उदाहरणों में, पहले वाले का R² 0.02 है; इसका मतलब मॉडल डेटा की विविधता का केवल 2% समझाता है। दूसरे का R² 0.99 है, और मॉडल कुल विविधता का 99% समझा सकता है।**
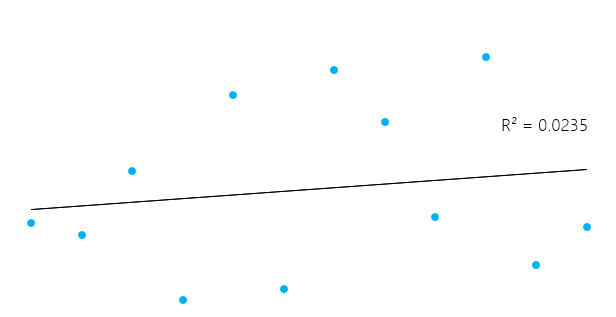
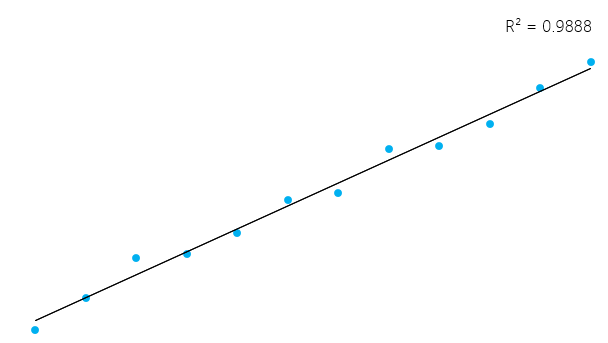
हालाँकि, यह ध्यान में रखना आवश्यक है कि कभी-कभी ऊँचा R² हर बार अच्छा नहीं होता (नीचे रेजिडुअल प्लॉट देखें) और कम R² हमेशा बुरा नहीं होता। वास्तविक जीवन में घटनाएँ हमेशा एकदम सीधी रेखा में फिट नहीं होतीं। उदाहरण के लिए, आपके डेटा में समान उम्र के बावजूद लंबा या छोटा बच्चा हो सकता है। कुछ क्षेत्रों में 0.5 का R² भी अच्छा माना जाता है।
ऊपर वाले ही उदाहरण के साथ, लीनियर मॉडल के summary में इसका R² देखें।
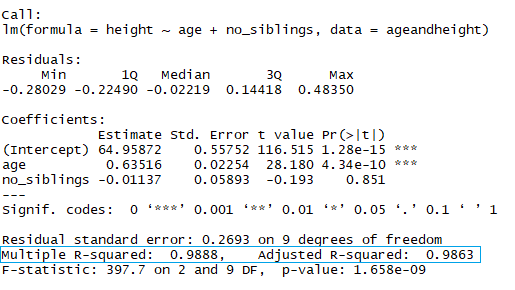
नीले आयत में ध्यान दें कि दो अलग-अलग R² हैं—एक multiple और एक adjusted। multiple वही R² है जो आपने पहले देखा। इस R² की एक समस्या यह है कि जैसे-जैसे आप अपने मॉडल में अधिक स्वतंत्र चर जोड़ते हैं, यह घट नहीं सकता—भले ही वे चर आपकी भविष्यवाणियों में कुछ न जोड़ें (जैसे भाई-बहनों की संख्या का उदाहरण), मॉडल जटिल होने पर यह बढ़ता ही जाएगा। इस कारण, यदि आप मॉडल में एक से अधिक चर जोड़ रहे हैं, तो अक्सर adjusted R² देखना बेहतर होता है, क्योंकि यह तभी बढ़ता है जब यह भविष्यवाणियों की कुल त्रुटि को कम करता है।
रेजिडुअल्स की जाँच करें
आपके मॉडल में R² अच्छा दिख सकता है, लेकिन निष्कर्षों पर जल्दबाज़ी न करें। एक उदाहरण देखें। आप किसी प्रयोगशाला में किसी पदार्थ के तापमान के आधार पर उसके दबाव का अनुमान लगाने जा रहे हैं।
डेटा को (एक साधारण स्कैटरप्लॉट में) प्लॉट करें और अपने लीनियर मॉडल से बनी रेखा जोड़ें। इस उदाहरण में, R को पहले read_excel कमांड से डेटा पढ़ने दें ताकि एक डेटा फ्रेम बने, फिर अपने नए डेटा के साथ लीनियर रिग्रेशन बनाएँ। plot() कमांड एक डेटा फ्रेम लेता है और उस पर चर प्लॉट करता है। इस मामले में, यह पदार्थ के तापमान के विरुद्ध दबाव प्लॉट करता है। फिर, abline कमांड से लीनियर रिग्रेशन द्वारा बनी रेखा जोड़ें।
pressure <- read_excel("pressure.xlsx") #Upload the data
lmTemp = lm(Pressure~Temperature, data = pressure) #Create the linear regression
plot(pressure, pch = 16, col = "blue") #Plot the results
abline(lmTemp) #Add a regression line
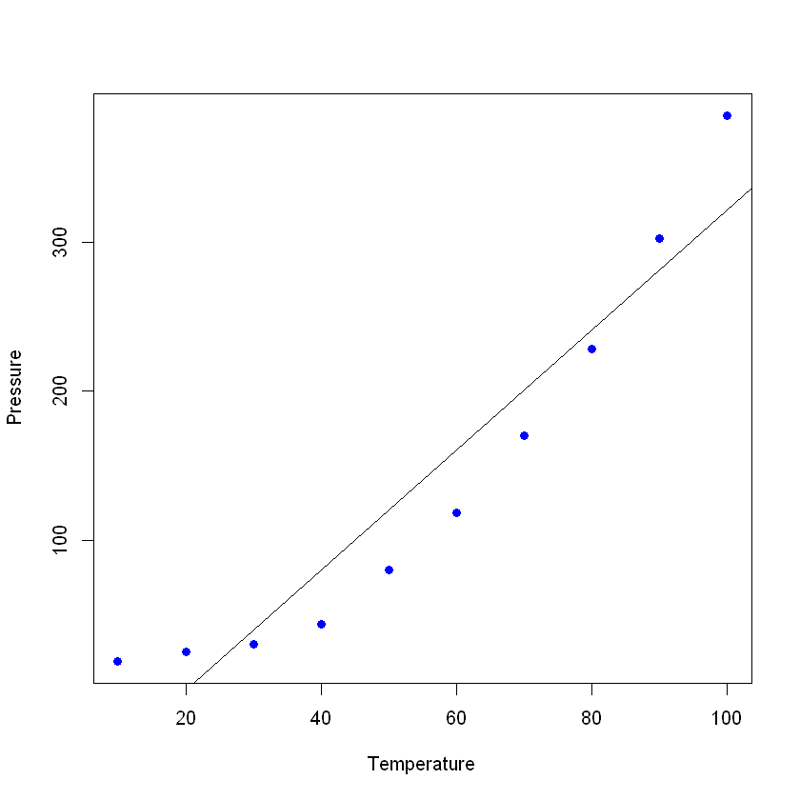
यदि आप अपने नए मॉडल की summary देखें, तो आप पाएँगे कि इसके परिणाम काफी अच्छे हैं (R² और adjusted R² देखें)
summary(lmTemp)
Call:
lm(formula = Pressure ~ Temperature, data = pressure)
Residuals:
Min 1Q Median 3Q Max
-41.85 -34.72 -10.90 24.69 63.51
Coefficients:
Estimate Std. Error t value Pr(>|t|)
(Intercept) -81.5000 29.1395 -2.797 0.0233 *
Temperature 4.0309 0.4696 8.583 2.62e-05 ***
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
Residual standard error: 42.66 on 8 degrees of freedom
Multiple R-squared: 0.902, Adjusted R-squared: 0.8898
F-statistic: 73.67 on 1 and 8 DF, p-value: 2.622e-05आदर्श रूप से, जब आप रेजिडुअल्स प्लॉट करते हैं, तो वे रैंडम दिखने चाहिए। अन्यथा, संभव है कि कोई छिपा हुआ पैटर्न हो जिसे लीनियर मॉडल नहीं पकड़ रहा। रेजिडुअल्स प्लॉट करने के लिए plot(lmTemp$residuals) कमांड का उपयोग करें।
plot(lmTemp$residuals, pch = 16, col = "red")
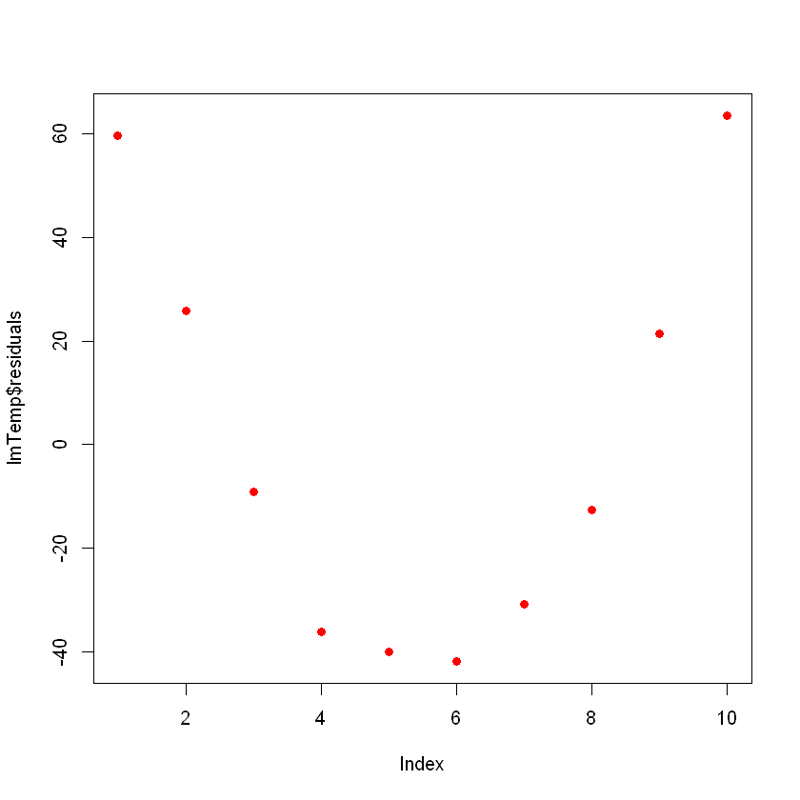
यह समस्या हो सकती है। यदि आपके पास अधिक डेटा होगा, तो आपका साधारण लीनियर मॉडल अच्छी तरह सामान्यीकरण नहीं कर पाएगा। पिछली तस्वीर में देखें कि एक पैटर्न (रेजिडुअल्स में वक्र जैसा) दिखाई दे रहा है। यह बिल्कुल भी रैंडम नहीं है।
आप जो कर सकते हैं वह है चर का ट्रांसफॉर्मेशन। आपके डेटा पर कई तरह के ट्रांसफॉर्मेशन किए जा सकते हैं, जैसे क्वाड्रेटिक पद जोड़ना (x2), घनात्मक (x3), या और भी जटिल जैसे ln(X), ln(X+1), sqrt(X), 1/x, Exp(X)। सही ट्रांसफॉर्मेशन का चुनाव कुछ बीजीय फलनों के ज्ञान, अभ्यास, और ट्रायल-एंड-एरर से आएगा।
आइए क्वाड्रेटिक पद आज़माएँ। इसके लिए, अपने ट्रांसफॉर्मेशन से पहले "I" (बड़ा "I") जोड़ें—उदाहरण के लिए, यह सामान्य लीनियर रिग्रेशन का सूत्र होगा:
lmTemp2 = lm(Pressure~Temperature + I(Temperature^2), data = pressure) #Create a linear regression with a quadratic coefficient
summary(lmTemp2) #Review the results
Call:
lm(formula = Pressure ~ Temperature + I(Temperature^2), data = pressure)
Residuals:
Min 1Q Median 3Q Max
-4.6045 -1.6330 0.5545 1.1795 4.8273
Coefficients:
Estimate Std. Error t value Pr(>|t|)
(Intercept) 33.750000 3.615591 9.335 3.36e-05 ***
Temperature -1.731591 0.151002 -11.467 8.62e-06 ***
I(Temperature^2) 0.052386 0.001338 39.158 1.84e-09 ***
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
Residual standard error: 3.074 on 7 degrees of freedom
Multiple R-squared: 0.9996, Adjusted R-squared: 0.9994
F-statistic: 7859 on 2 and 7 DF, p-value: 1.861e-12ध्यान दें कि मॉडल में उल्लेखनीय सुधार हुआ है। यदि आप नए मॉडल के रेजिडुअल्स प्लॉट करें, तो वे इस तरह दिखेंगे:
plot(lmTemp2$residuals, pch = 16, col = "red")
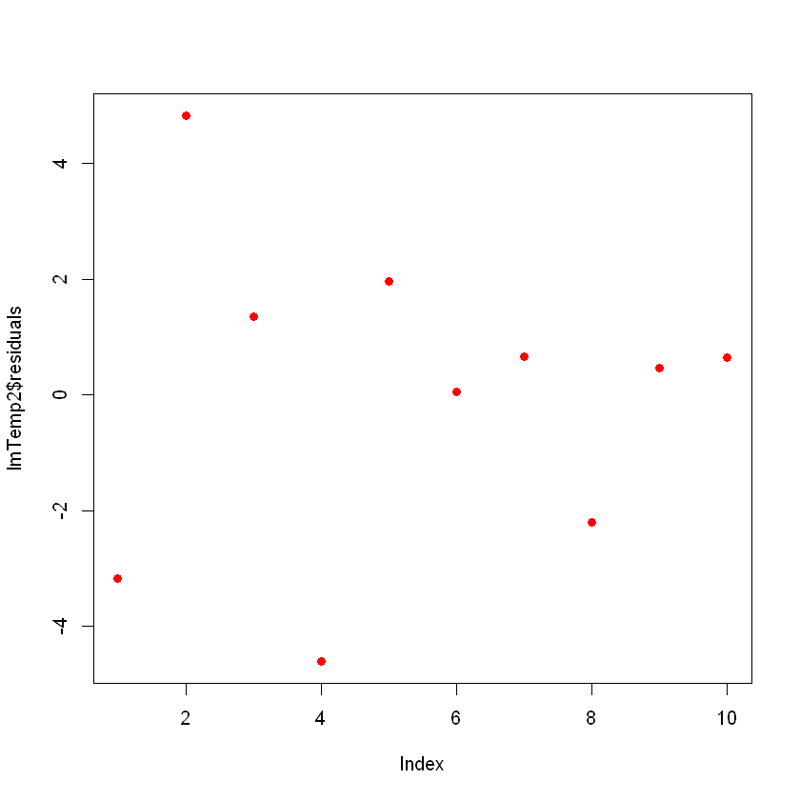
अब आपके रेजिडुअल्स में कोई स्पष्ट पैटर्न नहीं दिखता, जो अच्छा संकेत है!
प्रभावी (influential) बिंदुओं का पता लगाएँ
आपके डेटा में कुछ प्रभावी बिंदु हो सकते हैं जो आपके मॉडल को—कभी-कभी अनावश्यक रूप से—बिगाड़ सकते हैं। मान लीजिए डेटा एंट्री में गलती हो गई और “2.3” की जगह “23” लिख दिया गया। सबसे सामान्य प्रभावी बिंदु आउट्लायर्स होते हैं, जहाँ प्रेक्षित प्रतिक्रिया बाकी डेटा द्वारा स्थापित पैटर्न का पालन नहीं करती।
आप लीनियर मॉडल वाले ऑब्जेक्ट को देखकर, cooks.distance() फ़ंक्शन का उपयोग करके, और फिर इन दूरियों को प्लॉट करके प्रभावी बिंदुओं का पता लगा सकते हैं। जानबूझकर कोई मान बदलें और देखें कि Cooks Distance प्लॉट में यह कैसा दिखता है। किसी विशिष्ट मान को बदलने के लिए आप सीधे ageandheight[row number, column number] = [new value] से उसे संदर्भित कर सकते हैं। इस मामले में, दूसरे उदाहरण की लंबाई को 7.7 में बदला गया है:
ageandheight[2, 2] = 7.7
head(ageandheight)
| age | height | no_siblings |
|---|---|---|
| 18 | 76.1 | 0 |
| 19 | 7.7 | 2 |
| 20 | 78.1 | 0 |
| 21 | 78.2 | 3 |
| 22 | 78.8 | 4 |
| 23 | 79.7 | 1 |
मॉडल फिर से बनाएँ और देखें कि summary खराब फिट दे रही है, और फिर Cooks Distances प्लॉट करें। इसके लिए, लीनियर रिग्रेशन बनाने के बाद cooks.distance([linear model] कमांड का उपयोग करें, और फिर चाहें तो इन दूरियों को plot() कमांड से प्लॉट करें।
lmHeight3 = lm(height~age, data = ageandheight)#Create the linear regression
summary(lmHeight3)#Review the results
plot(cooks.distance(lmHeight3), pch = 16, col = "blue") #Plot the Cooks Distances.
Call:
lm(formula = height ~ age, data = ageandheight)
Residuals:
Min 1Q Median 3Q Max
-53.704 -2.584 3.609 9.503 17.512
Coefficients:
Estimate Std. Error t value Pr(>|t|)
(Intercept) 7.905 38.319 0.206 0.841
age 2.816 1.613 1.745 0.112
Residual standard error: 19.29 on 10 degrees of freedom
Multiple R-squared: 0.2335, Adjusted R-squared: 0.1568
F-statistic: 3.046 on 1 and 10 DF, p-value: 0.1115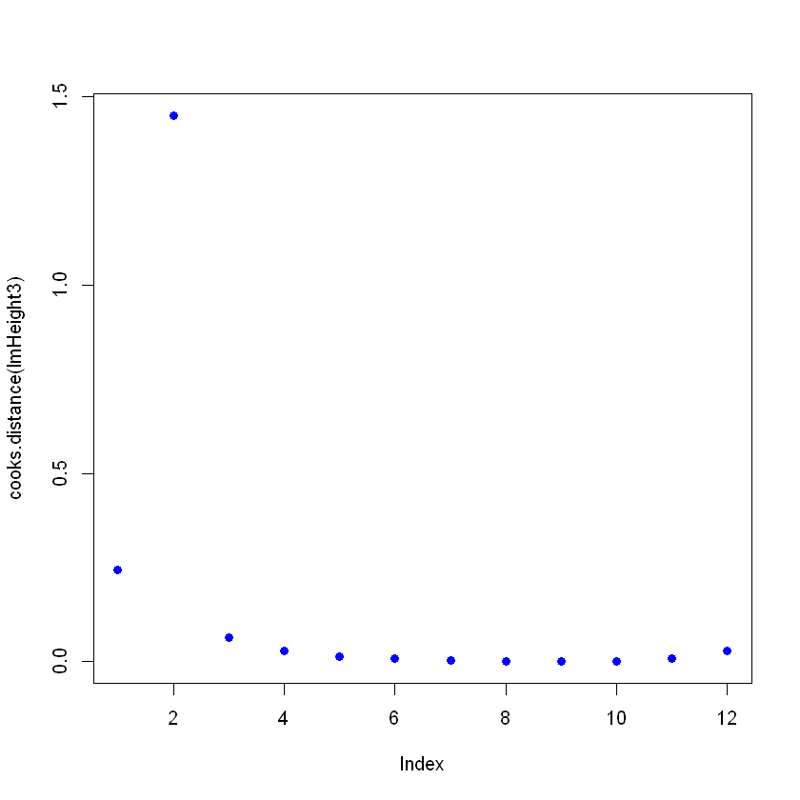
ध्यान दें कि एक बिंदु पैटर्न का पालन नहीं करता और संभवतः मॉडल को प्रभावित कर रहा है। यहाँ आप इस बिंदु पर निर्णय ले सकते हैं। सामान्यतः, किसी बिंदु के इतना प्रभावी होने के तीन कारण होते हैं:
- रिकॉर्डिंग में किसी ने त्रुटि कर दी
- प्रेक्षण एकत्र करते समय किसी ने बुनियादी गलती की
- डेटा बिंदु पूरी तरह मान्य है, ऐसे में मॉडल इस व्यवहार का हिसाब नहीं कर पाता।
यदि मामला 1 या 2 है, तो आप बिंदु को हटा (या सही) सकते हैं। यदि 3 है, तो मान्य बिंदु हटाना उचित नहीं—शायद आप लीनियर रिग्रेशन जैसे लीनियर मॉडल के बजाय कोई नॉन-लीनियर मॉडल आज़मा सकते हैं।
सावधान रहें कि प्रभावी बिंदु वैध भी हो सकता है—इसे हटाने से पहले डेटा और उसके स्रोत की जाँच अवश्य करें। सांख्यिकी की पुस्तकों में यह उक्ति आम मिलती है: “कभी-कभी हम अच्छे-भले डेटा को फेंक देते हैं, जबकि हमें संदिग्ध मॉडलों को फेंकना चाहिए।”
निष्कर्ष
आप अंत तक पहुँच गए! लीनियर रिग्रेशन एक बड़ा विषय है और यह आगे भी बना रहेगा। यहाँ, हमने कुछ तरकीबें प्रस्तुत कीं जो इस शक्तिशाली फिर भी सरल एल्गोरिद्म को ट्यून करने और अधिकतम लाभ उठाने में मदद करती हैं। आपने यह भी सीखा कि इस सरल सांख्यिकीय मॉडल के पीछे क्या है और अपनी ज़रूरतों के अनुसार आप इसे कैसे संशोधित कर सकते हैं। आप R कंसोल में ?lm टाइप करके उन विभिन्न पैरामीटरों को भी देख सकते हैं जो यहाँ कवर नहीं हुए। हमारा Regularization Tutorial: Ridge, Lasso और Elastic Net देखें। यदि आप सांख्यिकीय मॉडलों में गहराई से जाना चाहते हैं, तो Statistical Modeling in R कोर्स देखिए।
अपनी टीम की डेटा स्किल्स को सतत सीखने से बेहतर बनाएँ
क्योंकि लीनियर रिग्रेशन कई उन्नत विश्लेषण तकनीकों की नींव है, आपकी टीम के पास इस और अन्य आवश्यक कौशलों की मजबूत समझ होना दीर्घकालिक सफलता के लिए महत्वपूर्ण है।
DataCamp for Business उन संगठनों के लिए एक अनुकूलित समाधान प्रदान करता है जो अपनी टीमों को डेटा साइंस और एनालिटिक्स में अपस्किल करना चाहते हैं। कस्टम लर्निंग पाथ्स और व्यावहारिक, हैंड्स-ऑन कोर्सों के साथ—जो रिग्रेशन और प्रेडिक्टिव मॉडलिंग सहित व्यापक सांख्यिकीय तरीकों को कवर करते हैं—आपकी टीम जटिल डेटा चुनौतियों को आत्मविश्वास से संभाल सकती है।
आज ही डेमो का अनुरोध करें और अपनी टीम को डेटा विश्लेषण के नवीनतम टूल्स और तकनीकों से अपडेट रहने में सक्षम बनाकर अपने संगठन के भविष्य में निवेश करें।
Frequently Asked Questions
लीनियर रिग्रेशन में R^2 क्या है?
R^2, या निर्धारण गुणांक, आश्रित चर में उस विचरण का अनुपात मापता है जिसे स्वतंत्र चर/चरों से भविष्यवाणी किया जा सकता है। इसका मान 0 से 1 के बीच होता है, जहाँ ऊँचा मान बेहतर फिट का संकेत देता है।
R squared का सूत्र क्या है?
R squared की गणना आश्रित चर की कुल विविधता के उस अनुपात के रूप में की जाती है जिसे रिग्रेशन मॉडल द्वारा समझाया गया है। यह प्रेक्षित और अनुमानित मानों के बीच वर्गान्तरों के योग की तुलना प्रेक्षित मानों के औसत से वर्गान्तरों के कुल योग से करता है।
लीनियर रिग्रेशन में r का क्या अर्थ है?
लीनियर रिग्रेशन में r आश्रित चर के प्रेक्षित और अनुमानित मानों के बीच सहसंबंध गुणांक को दर्शाता है। यह रेखीय संबंध की शक्ति और दिशा को इंगित करता है।
लीनियर रिग्रेशन सबसे महत्वपूर्ण और बुनियादी सांख्यिकीय तकनीकों में से एक है। इस तकनीक में महारत हासिल करना किसी भी डेटा विश्लेषक और डेटा वैज्ञानिक के लिए आवश्यक है, क्योंकि जैसा कि आप देखेंगे, यह कई उन्नत तरीकों की नींव रखता है।
यह ट्यूटोरियल आपको R में लीनियर रिग्रेशन करने की प्रक्रिया के माध्यम से मार्गदर्शन करेगा, जो एक महत्वपूर्ण प्रोग्रामिंग भाषा है। इस ट्यूटोरियल के अंत तक, आप लीनियर रिग्रेशन मॉडलों को लागू करना और उनका अर्थ निकालना समझेंगे, जिससे आप इन्हें अपने डेटा विश्लेषण कार्यों में आसानी से लागू कर पाएंगे।
यदि आप R प्रोग्रामिंग भाषा से परिचित नहीं हैं, तो शुरुआत के लिए हमारे ये ट्यूटोरियल्स देखें: Absolute Beginners के लिए R में Exploratory Data Analysis और R प्रोग्रामिंग भाषा में Data Structures में महारत।
लीनियर रिग्रेशन क्या है?
लीनियर रिग्रेशन एक सांख्यिकीय मॉडल है जो एक प्रतिक्रिया चर (अक्सर y कहा जाता है) और एक या अधिक चरों तथा उनके इंटरैक्शन (अक्सर x या explanatory variables) के बीच संबंध का विश्लेषण करता है। आप अपने मन में अक्सर ऐसे संबंध बनाते हैं—उदाहरण के लिए, जब आप किसी बच्चे की उम्र के आधार पर उसकी लंबाई का अनुमान लगाते हैं, तो आप मानते हैं कि जितनी उम्र बढ़ेगी, लंबाई भी बढ़ेगी।
लीनियर रिग्रेशन सबसे बुनियादी सांख्यिकीय मॉडलों में से एक है। इसके परिणाम लगभग हर कोई समझ सकता है, और यह 19वीं शताब्दी की शुरुआत से प्रचलित है। यही वजह है कि लीनियर रिग्रेशन इतना लोकप्रिय है—यह सरल है और सैकड़ों वर्षों से टिका हुआ है। भले ही यह कृत्रिम न्यूरल नेटवर्क या रैंडम फॉरेस्ट जैसे अन्य एल्गोरिद्म जितना परिष्कृत नहीं है, KD Nuggets के एक सर्वे के अनुसार, रिग्रेशन वह एल्गोरिद्म था जिसे डेटा वैज्ञानिकों ने 2016 और 2017 में सबसे अधिक इस्तेमाल किया। यहाँ तक कि यह भविष्यवाणी की गई है कि वर्ष 2118 में भी इसका उपयोग होता रहेगा!
इस लीनियर रिग्रेशन ट्यूटोरियल में, हम R में लीनियर रिग्रेशन बनाना सीखेंगे और उन चरणों को देखेंगे जिन्हें आपको एक कामचलाऊ उदाहरण के साथ पूरा करना होगा।
इस ट्यूटोरियल के सभी उदाहरण कोड स्वयं चलाने के लिए, आप R प्री-इंस्टॉल्ड और सभी कोड सैंपल सहित एक निःशुल्क DataLab वर्कबुक बनाएँ। लीनियर रिग्रेशन पर और अभ्यास के लिए, हमारा हैंड्स-ऑन DataCamp अभ्यास देखें।
R में लीनियर रिग्रेशन कैसे बनाएँ
हर समस्या एक ही एल्गोरिद्म से हल नहीं होती। जब प्रतिक्रिया और आउटपुट के बीच रेखीय संबंध हो, तो लीनियर रिग्रेशन अच्छा काम करता है। दूसरे शब्दों में, लीनियर रिग्रेशन यह मानता है कि प्रतिक्रिया चर और explanatory variables के बीच एक रेखीय संबंध मौजूद है। दो चरों के मामले में, इसका अर्थ है कि आप दोनों के बीच एक सीधी रेखा फिट कर सकते हैं। बच्चे की उम्र के उदाहरण पर लौटें, तो यह स्पष्ट है कि बच्चों की उम्र और उनकी लंबाई के बीच संबंध है।
इस विशेष उदाहरण में, यदि आपको बच्चे की उम्र ज्ञात हो, तो आप उसकी लंबाई की गणना कर सकते हैं:
इस मामले में, a और b क्रमशः इंटरसेप्ट और स्लोप कहलाते हैं। इसी उदाहरण में, a या इंटरसेप्ट वह मान है जहाँ से आप मापना शुरू करते हैं। शून्य माह के नवजात शिशु शून्य सेंटीमीटर लंबे नहीं होते—यही इंटरसेप्ट का कार्य है। स्लोप उम्र (महीनों में) के सापेक्ष लंबाई में बदलाव को मापता है। सामान्यतः, बच्चे की उम्र में हर महीने की बढ़ोतरी पर, उसकी लंबाई b के बराबर बढ़ेगी।
R में lm()
R में लीनियर रिग्रेशन को
lm()कमांड से गणना किया जा सकता है। अगले उदाहरण में, हम इसी कमांड का उपयोग बच्चे की उम्र के आधार पर अनुमानित लंबाई निकालने के लिए करेंगे।सबसे पहले, Microsoft Excel फ़ाइलें पढ़ने के लिए
readxlलाइब्रेरी इम्पोर्ट करें। यदि आप Excel या CSV फ़ाइलों को R वातावरण (जैसे RStudio) में इम्पोर्ट करने से परिचित नहीं हैं, तो हमारा Introduction to Importing Data in R कोर्स एक बेहतरीन संसाधन है।आप शुरुआत करने से पहले इस ट्यूटोरियल के लिए डेटा डाउनलोड कर सकते हैं। डेटा को
ageandheightनामक ऑब्जेक्ट में डाउनलोड करें और फिर तीसरी पंक्ति में लीनियर रिग्रेशन बनाएँ।lm()फ़ंक्शन इस प्रकार वेरिएबल्स लेता है:निम्नलिखित कोड में, हम
lm()फ़ंक्शन का उपयोग करके एक लीनियर मॉडल ऑब्जेक्ट बनाते हैं, जिसका नाम हमlmHeightरखते हैं। फिर हम मॉडल के प्रदर्शन और गुणांकों की विस्तृत जानकारी देखने के लिएlmHeightपरsummary()फ़ंक्शन का उपयोग करते हैं।