

RAG के लिए Llama 3.1 क्यों चुनें?
Llama 3.1 RAG के लिए एक अच्छा विकल्प है—यह तकनीक सूचना पुनर्प्राप्ति प्रणालियों को भाषा मॉडलों की पाठ-जनन क्षमता के साथ जोड़ती है, ताकि आउटपुट अधिक सटीक और प्रासंगिक रहें।
RAG में, एक रिट्रीवल सिस्टम पहले बड़े डेटासेट्स में से सबसे प्रासंगिक जानकारी खोजता है, जिसे भाषा मॉडल अंतिम उत्तर तैयार करने के लिए उपयोग करता है। यह विशेष रूप से प्रश्न-उत्तर, चैटबॉट निर्माण, और सूचना-प्रधान कार्यों में उपयोगी है, जहाँ पारंपरिक भाषा मॉडल कभी-कभी पुरानी या अप्रासंगिक जानकारी दे सकते हैं।
128K टोकन तक हैंडल करने और बहुभाषी समर्थन की क्षमता के साथ, Llama 3.1 RAG प्रणालियों में AI-सृजित सामग्री की गुणवत्ता और विश्वसनीयता बढ़ाता है।
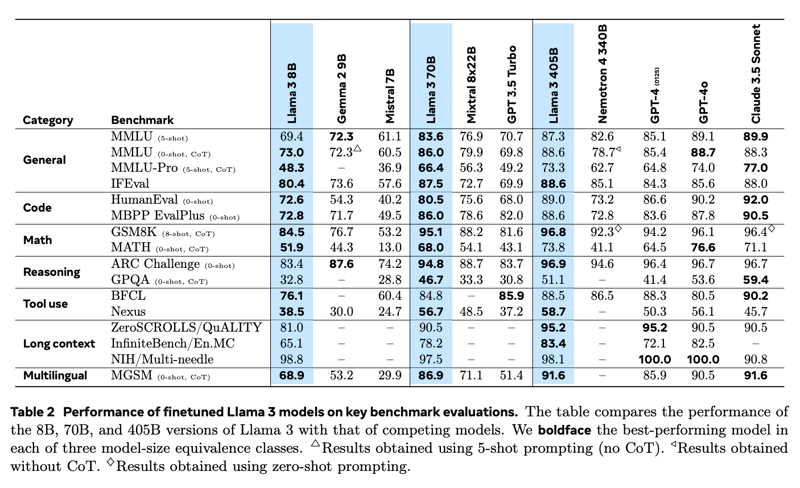
स्रोत: The Llama 3 Herd of Models
इसके अलावा, GPT-4o और Claude 3.5 Sonnet जैसे क्लोज़्ड-सोर्स मॉडलों की तुलना में Llama 3.1 RAG एप्लिकेशनों में अलग नजर आता है। इसकी सशक्त तर्क-क्षमता और लंबे पाठ प्रोसेस करने की योग्यता इसे जटिल प्रश्नों को बेहतर ढंग से संभालने और अधिक प्रासंगिक उत्तर देने में सक्षम बनाती है।
Needle-in-a-Haystack (NIH) बेंचमार्क में—जो बड़े पाठ-समूहों ("haystacks") में विशिष्ट सूचनाएँ ("needles") खोजने की मॉडल की क्षमता को परखता है—Llama 3.1 सभी मॉडल आकारों में लगभग परफेक्ट रिट्रीवल रेट के साथ उत्कृष्ट प्रदर्शन करता है। यह जटिल सर्च कार्यों को संभालने की इसकी क्षमता दर्शाता है, जो बड़े डेटासेट्स से सटीक जानकारी निकालने वाली RAG प्रणालियों के लिए इसे आदर्श बनाता है।
मॉडल ने Multi-needle बेंचमार्क में भी असाधारण प्रदर्शन किया, जिसमें कई सूचनाएँ सटीकता से पुनर्प्राप्त करनी होती हैं। इस परीक्षण में इसके लगभग परफेक्ट नतीजे यह और साबित करते हैं कि यह जटिल रिट्रीवल कार्यों को संभालने में सक्षम है।
Ollama और Langchain के साथ Llama 3.1 पर RAG कैसे लागू करें
Llama 3.1 के साथ RAG एप्लिकेशन सेटअप करने के लिए कई चरणों की आवश्यकता होती है। इनमें मॉडल को अपनी लोकल मशीन पर डाउनलोड करना, वातावरण तैयार करना, आवश्यक लाइब्रेरी लोड करना, और एक रिट्रीवल मैकेनिज्म बनाना शामिल है। अंततः, हम इसे एक भाषा मॉडल के साथ जोड़कर संपूर्ण एप्लिकेशन बनाएँगे।
नीचे Llama 3.1 का उपयोग करके RAG एप्लिकेशन लागू करने के लिए एक स्पष्ट, चरण-दर-चरण मार्गदर्शिका दी गई है।
चरण 1: Ollama इंस्टॉल करें
सबसे पहले, Ollama एप्लिकेशन इंस्टॉल करें, जो हमें आपकी लोकल मशीन पर Llama 3.1 और अन्य ओपन-सोर्स भाषा मॉडलों को चलाने देता है। आप Ollama ऐप उनके आधिकारिक वेबसाइट से डाउनलोड कर सकते हैं।
इंस्टॉल और ओपन करने के बाद, अगला चरण Llama 3.1 मॉडल को लोकल मशीन पर डाउनलोड करना है। इस ट्यूटोरियल के लिए, हम 8B पैरामीटर संस्करण का उपयोग करेंगे। इसे डाउनलोड करने के लिए अपना टर्मिनल खोलें और यह कमांड चलाएँ:
ollama run llama3.1मॉडल के डाउनलोड पूरा होने के बाद, हम इसे Langchain के जरिए कनेक्ट करने के लिए तैयार होंगे, जिसका तरीका हम आगे बताएँगे।
चरण 2: वातावरण तैयार करें
शुरू करने से पहले, सुनिश्चित करें कि आवश्यक Python लाइब्रेरीज़ इंस्टॉल हैं। हमें langchain, langchain_community, langchain-ollama, langchain_openai जैसी लाइब्रेरी चाहिए होंगी। यदि आपने अभी तक इन्हें इंस्टॉल नहीं किया है, तो pip से यह कमांड चलाकर कर सकते हैं:
pip install langchain langchain_community langchain-openai scikit-learn langchain-ollamaचरण 3: दस्तावेज़ लोड करें और तैयार करें
अपने RAG सिस्टम को बनाने का पहला चरण उन दस्तावेज़ों को लोड करना है जिन्हें हम नॉलेज बेस के रूप में उपयोग करना चाहते हैं। इस उदाहरण में, हम स्रोत के रूप में वेब पेजों का उपयोग करेंगे।
ऐसा कैसे करें:
from langchain_community.document_loaders import WebBaseLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter
# List of URLs to load documents from
urls = [
"<https://lilianweng.github.io/posts/2023-06-23-agent/>",
"<https://lilianweng.github.io/posts/2023-03-15-prompt-engineering/>",
"<https://lilianweng.github.io/posts/2023-10-25-adv-attack-llm/>",
]
# Load documents from the URLs
docs = [WebBaseLoader(url).load() for url in urls]
docs_list = [item for sublist in docs for item in sublist]यहाँ, WebBaseLoader दिए गए प्रत्येक URL से सामग्री लाने के लिए उपयोग किया जाता है। प्राप्त दस्तावेज़ों की नेस्टेड सूचियों को फिर एक एकल, सपाट सूची docs_list में संयोजित किया जाता है, जो हमें दस्तावेज़ों की सूची देती है।
चरण 4: दस्तावेज़ों को खंडों में विभाजित करें
रिट्रीवल प्रक्रिया को अधिक दक्ष बनाने के लिए, हम दस्तावेज़ों को छोटे-छोटे खंडों में बाँटते हैं, जिसके लिए RecursiveCharacterTextSplitter का उपयोग करते हैं। इससे सिस्टम पाठ को अधिक प्रभावी ढंग से संभाल और खोज सकता है।
हम खंड आकार और ओवरलैप निर्दिष्ट करके टेक्स्ट स्प्लिटर सेट कर सकते हैं। उदाहरण के लिए, नीचे के कोड में हम 250 अक्षरों के खंड आकार और बिना ओवरलैप वाला स्प्लिटर बना रहे हैं।
# Initialize a text splitter with specified chunk size and overlap
text_splitter = RecursiveCharacterTextSplitter.from_tiktoken_encoder(
chunk_size=250, chunk_overlap=0
)
# Split the documents into chunks
doc_splits = text_splitter.split_documents(docs_list)चरण 5: एक वेक्टर स्टोर बनाएँ
अगला, हमें टेक्स्ट खंडों को एम्बेडिंग्स में बदलना होगा, जिन्हें फिर वेक्टर स्टोर में रखा जाएगा, ताकि समानता के आधार पर तेज़ और कुशल रिट्रीवल हो सके।
इसके लिए, हम OpenAIEmbeddings का उपयोग करके प्रत्येक टेक्स्ट खंड के लिए एम्बेडिंग्स बनाएँगे, जिन्हें SKLearnVectorStore में संग्रहीत किया जाएगा। वेक्टर स्टोर को as_retriever(k=4) के साथ ऐसे कॉन्फ़िगर किया गया है कि वह किसी भी क्वेरी पर शीर्ष 4 सबसे प्रासंगिक दस्तावेज़ लौटाए।
from langchain_community.vectorstores import SKLearnVectorStore
from langchain_openai import OpenAIEmbeddings
# Create embeddings for documents and store them in a vector store
vectorstore = SKLearnVectorStore.from_documents(
documents=doc_splits,
embedding=OpenAIEmbeddings(openai_api_key="api_key"),
)
retriever = vectorstore.as_retriever(k=4)चरण 6: LLM और प्रॉम्प्ट टेम्पलेट सेट करें
इस चरण में, हम LLM सेट करेंगे और रिट्रीव किए गए दस्तावेज़ों के आधार पर उत्तर जनरेट करने के लिए एक प्रॉम्प्ट टेम्पलेट बनाएँगे।
पहले, हमें एक प्रॉम्प्ट टेम्पलेट परिभाषित करना होगा जो LLM को उत्तरों का फॉर्मेट बताता है। यह टेम्पलेट मॉडल को निर्देश देता है कि दिए गए दस्तावेज़ों का उपयोग करते हुए अधिकतम तीन वाक्यों में संक्षेप में उत्तर दें। यदि मॉडल उत्तर न ढूँढ पाए, तो स्पष्ट रूप से कहे कि उसे नहीं पता।
from langchain_ollama import ChatOllama
from langchain.prompts import PromptTemplate
from langchain_core.output_parsers import StrOutputParser
# Define the prompt template for the LLM
prompt = PromptTemplate(
template="""You are an assistant for question-answering tasks.
Use the following documents to answer the question.
If you don't know the answer, just say that you don't know.
Use three sentences maximum and keep the answer concise:
Question: {question}
Documents: {documents}
Answer:
""",
input_variables=["question", "documents"],
)इसके बाद, हम Langchain के ChatOllama के माध्यम से Llama 3.1 मॉडल से कनेक्ट करते हैं, जिसे सुसंगत उत्तरों के लिए 0 तापमान पर कॉन्फ़िगर किया गया है।
# Initialize the LLM with Llama 3.1 model
llm = ChatOllama(
model="llama3.1",
temperature=0,
)अंत में, हम एक चेन बनाते हैं जो प्रॉम्प्ट टेम्पलेट को LLM के साथ जोड़ती है और आउटपुट को प्रदर्शित करने योग्य, सरल स्ट्रिंग में रखने के लिए StrOutputParser का उपयोग करती है।
# Create a chain combining the prompt template and LLM
rag_chain = prompt | llm | StrOutputParser()चरण 7: रिट्रीवर और LLM को RAG एप्लिकेशन में एकीकृत करें
इस चरण में, हम रिट्रीवर और RAG चेन को मिलाकर एक संपूर्ण RAG एप्लिकेशन बनाएँगे। हम RAGApplication नामक एक क्लास बनाएँगे, जो दस्तावेज़ रिट्रीवल और उत्तर जनरेशन, दोनों को संभालेगा।
RAGApplication क्लास में run मेथड है जो उपयोगकर्ता के प्रश्न को लेता है, रिट्रीवर का उपयोग करके प्रासंगिक दस्तावेज़ ढूँढता है, और फिर उन दस्तावेज़ों के पाठ को निकालता है। इसके बाद यह प्रश्न और दस्तावेज़-पाठ को RAG चेन को पास करता है ताकि संक्षिप्त उत्तर जनरेट हो सके।
# Define the RAG application class
class RAGApplication:
def __init__(self, retriever, rag_chain):
self.retriever = retriever
self.rag_chain = rag_chain
def run(self, question):
# Retrieve relevant documents
documents = self.retriever.invoke(question)
# Extract content from retrieved documents
doc_texts = "\\n".join([doc.page_content for doc in documents])
# Get the answer from the language model
answer = self.rag_chain.invoke({"question": question, "documents": doc_texts})
return answerचरण 8: एप्लिकेशन का परीक्षण करें
अंत में, हम कुछ नमूना प्रश्नों के साथ अपने RAG एप्लिकेशन का परीक्षण करने के लिए तैयार हैं, ताकि यह सुनिश्चित हो सके कि यह सही ढंग से काम कर रहा है। आप प्रदर्शन सुधारने या विशिष्ट आवश्यकताओं के अनुरूप बनाने के लिए प्रॉम्प्ट टेम्पलेट या रिट्रीवल सेटिंग्स समायोजित कर सकते हैं।
# Initialize the RAG application
rag_application = RAGApplication(retriever, rag_chain)
# Example usage
question = "What is prompt engineering"
answer = rag_application.run(question)
print("Question:", question)
print("Answer:", answer)Question: What is prompt engineering
Answer: Prompt engineering refers to methods for communicating with Large Language Models (LLMs) to steer their behavior towards desired outcomes without updating the model weights. It's an empirical science that requires experimentation and heuristics, aiming at alignment and model steerability. The goal is to optimize prompts to achieve specific results, often using techniques like iterative prompting or external tool use.RAG के साथ Llama 3.1: वास्तविक दुनिया के अनुप्रयोग
RAG के समर्थन और Llama 3.1 की उन्नत क्षमताएँ इसे कई प्रभावशाली अनुप्रयोगों के लिए आदर्श बनाती हैं।
चैटबॉट विकास के लिए, Llama 3.1 को RAG के साथ इंटीग्रेट करने से चैटबॉट बाहरी डेटाबेस या नॉलेज बेस तक पहुँच कर अधिक सटीक और संदर्भ-संगत उत्तर दे सकते हैं। यह सुनिश्चित करता है कि उपयोगकर्ताओं को दी जाने वाली जानकारी नवीनतम और प्रासंगिक हो—विशेषकर ग्राहक सेवा जैसे क्षेत्रों में, जहाँ समय पर और सही उत्तर उपयोगकर्ता संतुष्टि और दक्षता को काफी बढ़ा सकते हैं। Llama 3.1 का बहुभाषी समर्थन विविध उपयोगकर्ता समूहों की सेवा के लिए भी प्रभावी है।
प्रश्न-उत्तर प्रणालियों में, Llama 3.1 केवल आंतरिक डेटासेट्स पर निर्भर पारंपरिक भाषा मॉडलों की सीमाओं का समाधान करता है। RAG के जरिए बाहरी स्रोतों से अद्यतन जानकारी तक पहुँचकर, Llama 3.1 अपने उत्तरों की शुद्धता और विश्वसनीयता बढ़ाता है। यह विशेष रूप से स्वास्थ्य सेवा और शिक्षा जैसे क्षेत्रों में उपयोगी है, जहाँ सटीक और ताज़ा जानकारी आवश्यक होती है।
उदाहरण के लिए, Llama 3.1 से संचालित एक मेडिकल AI सहायक वास्तविक समय में मेडिकल डेटाबेस से क्वेरी करके स्वास्थ्य पेशेवरों को नवीनतम शोध या उपचार दिशानिर्देश प्रदान कर सकता है, जिससे बेहतर नैदानिक निर्णय लेने में मदद मिलती है।
Llama 3.1 ज्ञान-गहन कार्यों के लिए भी अत्यंत प्रभावी है, जैसे विस्तृत रिपोर्ट बनाना या गहन शोध करना। RAG के माध्यम से व्यापक स्रोतों से जानकारी लेकर, Llama 3.1 मॉडल अधिक व्यापक और सूक्ष्म विश्लेषण प्रस्तुत कर सकते हैं, जिससे वे शोध, वित्त और रणनीतिक योजना जैसे क्षेत्रों के पेशेवरों के लिए मूल्यवान उपकरण बन जाते हैं।
निष्कर्ष
Ollama और Langchain के साथ Llama 3.1 पर RAG एप्लिकेशन लागू करना उन्नत, संदर्भ-सचेत भाषा मॉडलों के निर्माण के लिए एक अच्छा समाधान प्रदान करता है।
दिए गए चरणों—वातावरण सेटअप, दस्तावेज़ लोड और प्रोसेस करना, एम्बेडिंग्स बनाना, और रिट्रीवर को LLM के साथ एकीकृत करना—का पालन करके, आप ऐसा फ़ंक्शनल RAG सिस्टम बना सकते हैं जो प्रासंगिक जानकारी रिट्रीव कर सके और सटीक उत्तर दे सके।
वास्तविक दुनिया के अनुप्रयोगों—जैसे चैटबॉट्स, प्रश्न-उत्तर प्रणालियाँ, और रिसर्च टूल—में, जहाँ नवीनतम बाहरी जानकारी तक पहुँच महत्वपूर्ण होती है, Llama 3.1 का RAG के साथ इंटीग्रेशन विशेष रूप से उपयोगी है।

रायन एक लीड डेटा साइंटिस्ट हैं जो LLMs का उपयोग करके एआई अनुप्रयोग बनाने में विशेषज्ञता रखते/रखती हैं। वे इम्पीरियल कॉलेज लंदन में नैचुरल लैंग्वेज प्रोसेसिंग और नॉलेज ग्राफ्स में पीएचडी उम्मीदवार हैं, जहाँ से उन्होंने कंप्यूटर साइंस में अपना मास्टर’स भी पूरा किया है। डेटा साइंस के अलावा, वे साप्ताहिक Substack न्यूज़लेटर The Limitless Playbook लिखते हैं, जिसमें वे दुनिया के अग्रणी विचारकों से एक क्रियान्वयन योग्य विचार साझा करते हैं और समय-समय पर मूलभूत एआई अवधारणाओं पर भी लिखते हैं।
Meta द्वारा Llama 3.1 का रिलीज़ ओपन-वेट्स LLM मॉडलों में एक बड़ा कदम है।
405 बिलियन पैरामीटर तक के विकल्पों के साथ, Llama 3.1 शीर्ष क्लोज़्ड-सोर्स मॉडलों जैसे OpenAI का GPT-4o, Anthropic का Claude 3, और Google Gemini के समकक्ष है।
इस ट्यूटोरियल में, हम सीखेंगे कि retrieval-augmented generation (RAG) एप्लिकेशन को Llama 3.1 8B मॉडल के साथ कैसे लागू करें। हम जानेंगे कि RAG के लिए Llama 3.1 क्यों उत्कृष्ट है, इसे कैसे डाउनलोड करें और Ollama का उपयोग करके लोकली कैसे एक्सेस करें, और Langchain के माध्यम से इससे कनेक्ट होकर संपूर्ण RAG एप्लिकेशन कैसे बनाएँ। हम Llama 3.1 के विभिन्न उपयोग मामलों और वास्तविक दुनिया के अनुप्रयोगों के बारे में भी सीखेंगे।