
Kurs
LangChain ile LLM Uygulamaları Geliştirme
3 sa
52K
Llama 3.1, alma sistemlerini dil modellerinin metin üretme yetenekleriyle birleştirerek daha doğru ve ilgili çıktılar sağlayan bir teknik olan RAG için iyi bir tercihtir.
RAG’de, bir alma sistemi önce büyük veri kümelerinde en ilgili bilgileri arar ve dil modeli bu bilgileri kullanarak nihai yanıtı üretir. Bu, özellikle soru yanıtlamada, sohbet botları oluşturmada ve bilgi yoğun görevleri yönetmede faydalıdır; zira geleneksel dil modelleri güncel olmayan veya alakasız yanıtlar verebilir.
128K tokene kadar metni işleyebilmesi ve çoklu dil desteğiyle Llama 3.1, RAG sistemlerinde yapay zekâ tarafından üretilen içeriğin kalitesini ve güvenilirliğini artırır.
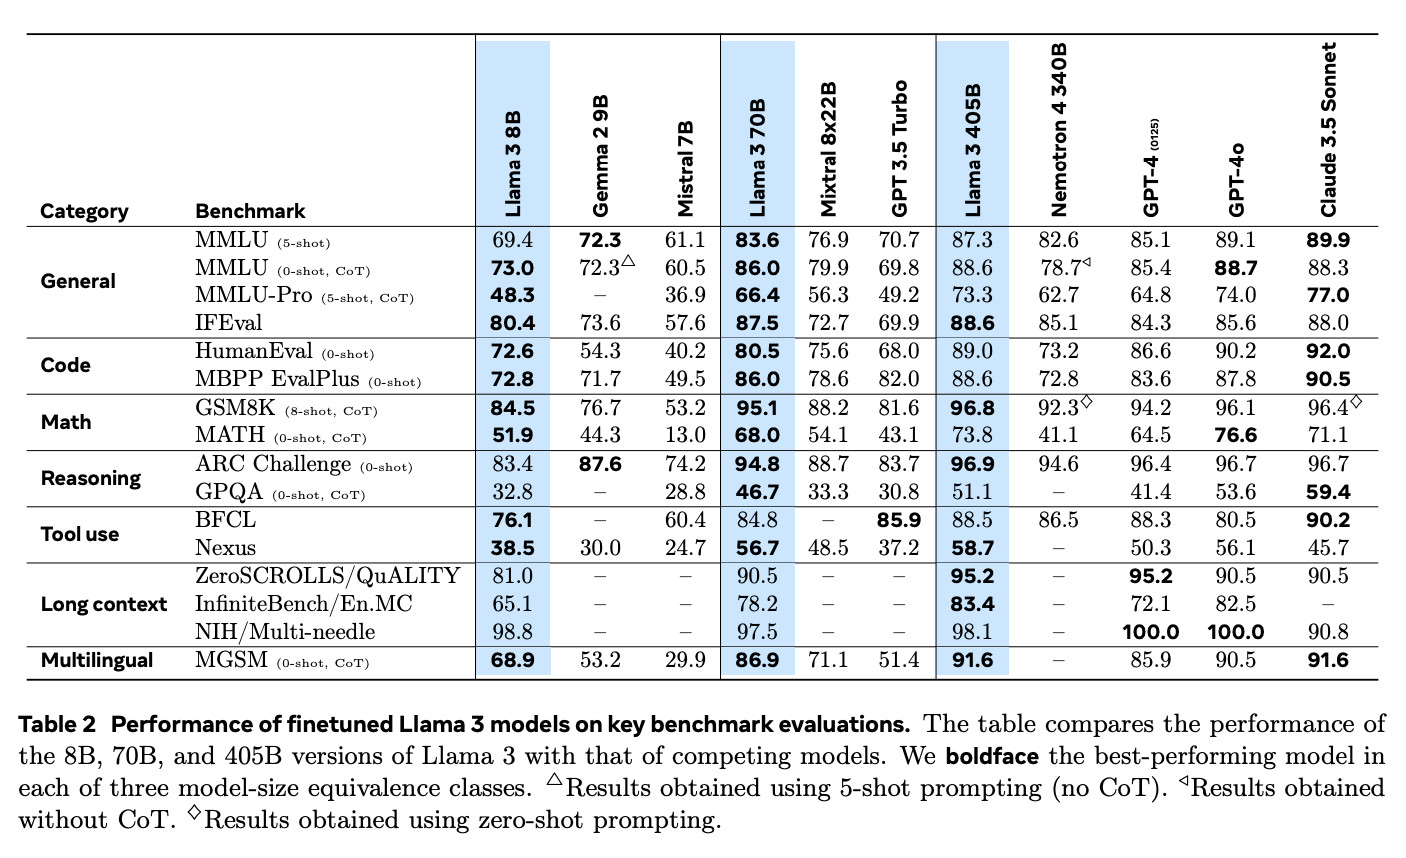
Kaynak: The Llama 3 Herd of Models
Ayrıca Llama 3.1, GPT-4o ve Claude 3.5 Sonnet gibi kapalı kaynak modellere kıyasla RAG uygulamalarında öne çıkmaktadır. Güçlü akıl yürütme yetenekleri ve uzun metinleri işleyebilmesi, karmaşık soruları daha iyi ele almasına ve daha ilgili yanıtlar üretmesine olanak tanır.
Model, büyük metin yığınları (“saman yığınları”) içinde belirli bilgi parçalarını (“iğneler”) bulma becerisini test eden Needle-in-a-Haystack (NIH) kıyaslamasında, tüm model boyutları genelinde neredeyse mükemmel alma oranıyla üstün performans göstermektedir. Bu, karmaşık arama görevlerini yönetme yeteneğini ortaya koyar ve büyük veri kümelerinden kesin bilgi çıkarması gereken RAG sistemleri için idealdir.
Model, birden fazla bilgi parçasını doğru şekilde almayı gerektiren Multi-needle kıyaslamasında da olağanüstü bir performans sergilemiştir. Bu testteki neredeyse kusursuz sonuçlar, karmaşık alma görevlerini yönetme yeteneğini daha da kanıtlamaktadır.
Llama 3.1 ile bir RAG uygulaması kurmak için birkaç adım gereklidir. Bunlar arasında Llama 3.1 modelini yerel makinenize indirmek, ortamı kurmak, gerekli kütüphaneleri yüklemek ve bir alma mekanizması oluşturmak bulunur. Son olarak, bunu bir dil modeliyle birleştirerek eksiksiz bir uygulama geliştireceğiz.
Aşağıda, Llama 3.1 kullanarak bir RAG uygulamasını hayata geçirmenize yardımcı olacak açık ve adım adım bir rehber bulunuyor.
Önce, Llama 3.1 ve diğer açık kaynaklı dil modellerini yerel makinenizde çalıştırmamıza olanak tanıyan Ollama uygulamasını kurun. Ollama uygulamasını resmi web sitelerinden indirebilirsiniz.
Ollama’yı kurup açtıktan sonra, bir sonraki adım Llama 3.1 modelini yerel makinenize indirmektir. Bu öğreticide 8B parametreli sürümü kullanacağız. İndirmek için terminalinizi açın ve şu komutu çalıştırın:
ollama run llama3.1Modelin indirilmesi tamamlandıktan sonra, onu Langchain kullanarak bağlamaya hazır olacağız; bunu sonraki bölümlerde nasıl yapacağınızı göstereceğiz.
Başlamadan önce, doğru Python kütüphanelerinin kurulu olduğundan emin olun. langchain, langchain_community, langchain-ollama, langchain_openai gibi kütüphanelere ihtiyacımız olacak. Henüz kurmadıysanız, pip ile şu komutu kullanarak kurabilirsiniz:
pip install langchain langchain_community langchain-openai scikit-learn langchain-ollamaRAG sisteminizi oluşturmanın ilk adımı, bilgi tabanımız olarak kullanmak istediğimiz belgeleri yüklemektir. Bu örnekte, kaynak olarak web sayfalarını kullanacağız.
Bunu şu şekilde yapabilirsiniz:
from langchain_community.document_loaders import WebBaseLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter
# List of URLs to load documents from
urls = [
    "<https://lilianweng.github.io/posts/2023-06-23-agent/>",
    "<https://lilianweng.github.io/posts/2023-03-15-prompt-engineering/>",
    "<https://lilianweng.github.io/posts/2023-10-25-adv-attack-llm/>",
]
# Load documents from the URLs
docs = [WebBaseLoader(url).load() for url in urls]
docs_list = [item for sublist in docs for item in sublist]
Burada WebBaseLoader, verilen her URL’den içerik almak için kullanılır. Ortaya çıkan iç içe belge listeleri daha sonra docs_list adlı tek ve düz bir listede birleştirilir; böylece elimizde bir belge listesi olur.
Alma sürecini daha verimli hale getirmek için belgeleri RecursiveCharacterTextSplitter kullanarak daha küçük parçalara böleriz. Bu, sistemin metni daha etkili şekilde işlemesine ve aramasına yardımcı olur.
Metin bölücüyü, parça boyutu ve örtüşmeyi belirterek ayarlayabiliriz. Örneğin aşağıdaki kodda, 250 karakterlik parça boyutu ve sıfır örtüşme ile bir metin bölücü kuruyoruz.
# Initialize a text splitter with specified chunk size and overlap
text_splitter = RecursiveCharacterTextSplitter.from_tiktoken_encoder(
    chunk_size=250, chunk_overlap=0
)
# Split the documents into chunks
doc_splits = text_splitter.split_documents(docs_list)Sonraki adımda metin parçalarını gömlemelere dönüştürür ve bunları bir vektör deposunda saklarız; bu da benzerliğe dayalı hızlı ve verimli almayı sağlar.
Bunu yapmak için OpenAIEmbeddings kullanarak her metin parçası için gömlemeler üretir ve bunları bir SKLearnVectorStore içinde depolarız. Vektör deposu, as_retriever(k=4) ile yapılandırılarak herhangi bir sorgu için en ilgili 4 belgeyi döndürecek şekilde ayarlanır.
from langchain_community.vectorstores import SKLearnVectorStore
from langchain_openai import OpenAIEmbeddings
# Create embeddings for documents and store them in a vector store
vectorstore = SKLearnVectorStore.from_documents(
    documents=doc_splits,
    embedding=OpenAIEmbeddings(openai_api_key="api_key"),
)
retriever = vectorstore.as_retriever(k=4)Bu adımda, LLM’i ayarlayacak ve alınan belgelere dayalı yanıtlar üretmek için bir istem şablonu oluşturacağız.
Önce, LLM’e yanıtlarını nasıl biçimlendireceğini söyleyen bir istem şablonu tanımlamamız gerekir. Bu şablon, modele sağlanan belgeleri kullanarak soruları en fazla üç cümlede ve öz olarak yanıtlamasını söyler. Model bir yanıt bulamazsa, bunu bilmediğini belirtmelidir.
from langchain_ollama import ChatOllama
from langchain.prompts import PromptTemplate
from langchain_core.output_parsers import StrOutputParser
# Define the prompt template for the LLM
prompt = PromptTemplate(
    template="""You are an assistant for question-answering tasks.
    Use the following documents to answer the question.
    If you don't know the answer, just say that you don't know.
    Use three sentences maximum and keep the answer concise:
    Question: {question}
    Documents: {documents}
    Answer:
    """,
    input_variables=["question", "documents"],
)
Sonraki adımda, Langchain içinden ChatOllama kullanarak Llama 3.1 modeline bağlanıyoruz ve tutarlı yanıtlar için sıcaklık ayarını 0 olarak yapılandırıyoruz.
# Initialize the LLM with Llama 3.1 model
llm = ChatOllama(
    model="llama3.1",
    temperature=0,
)
Son olarak, istem şablonunu LLM ile birleştiren ve çıktının gösterime uygun, sade bir dize olmasını sağlamak için StrOutputParser kullanan bir zincir oluşturuyoruz.
# Create a chain combining the prompt template and LLM
rag_chain = prompt | llm | StrOutputParser()Bu adımda, bir alıcıyı ve RAG zincirini birleştirerek eksiksiz bir RAG uygulaması oluşturacağız. Bunu, hem belge alımını hem de yanıt üretimini yönetecek RAGApplication adlı bir sınıf oluşturarak yapacağız.
RAGApplication sınıfının run metodu, kullanıcının sorusunu alır, alıcıyı kullanarak ilgili belgeleri bulur ve ardından bu belgelerden metni çıkarır. Daha sonra soruyu ve belge metnini, öz bir yanıt üretmesi için RAG zincirine iletir.
# Define the RAG application class
class RAGApplication:
    def __init__(self, retriever, rag_chain):
        self.retriever = retriever
        self.rag_chain = rag_chain
    def run(self, question):
        # Retrieve relevant documents
        documents = self.retriever.invoke(question)
        # Extract content from retrieved documents
        doc_texts = "\\n".join([doc.page_content for doc in documents])
        # Get the answer from the language model
        answer = self.rag_chain.invoke({"question": question, "documents": doc_texts})
return answerSon olarak, doğru çalıştığından emin olmak için RAG uygulamamızı bazı örnek sorularla test etmeye hazırız. Performansı iyileştirmek veya uygulamayı belirli ihtiyaçlara uyarlamak için istem şablonunu veya alma ayarlarını düzenleyebilirsiniz.
# Initialize the RAG application
rag_application = RAGApplication(retriever, rag_chain)
# Example usage
question = "What is prompt engineering"
answer = rag_application.run(question)
print("Question:", question)
print("Answer:", answer)
Question: What is prompt engineering
Answer: Prompt engineering refers to methods for communicating with Large Language Models (LLMs) to steer their behavior towards desired outcomes without updating the model weights. It's an empirical science that requires experimentation and heuristics, aiming at alignment and model steerability. The goal is to optimize prompts to achieve specific results, often using techniques like iterative prompting or external tool use.Llama 3.1’in gelişmiş özellikleri ve RAG desteği, onu birçok etkili uygulama için ideal kılar.
Sohbet botu geliştirme için, Llama 3.1’i RAG ile entegre etmek, sohbet botlarının haricî veritabanlarına veya bilgi tabanlarına erişerek daha doğru ve bağlama duyarlı yanıtlar vermesini sağlar. Bu, kullanıcılara sunulan bilgilerin güncel ve ilgili olmasını güvence altına alır; özellikle zamanında ve doğru yanıtların kullanıcı memnuniyetini ve verimliliği büyük ölçüde artırabildiği müşteri hizmetleri gibi alanlarda önemlidir. Llama 3.1’in çoklu dil desteği de çeşitli bir kullanıcı kitlesine hizmet etmesini etkili kılar.
Soru-yanıt sistemlerinde Llama 3.1, yalnızca iç veri kümelerine dayanan geleneksel dil modellerinin sınırlamalarını giderir. RAG kullanarak haricî kaynaklardan güncel bilgilere erişmesi sayesinde Llama 3.1, yanıtlarının doğruluğunu ve güvenilirliğini artırır. Bu, sağlık ve eğitim gibi, doğru ve güncel bilginin hayati olduğu alanlarda özellikle yararlıdır.
Örneğin, Llama 3.1 tarafından desteklenen bir tıbbî yapay zekâ asistanı, tıbbî veritabanlarını gerçek zamanlı sorgulayarak sağlık profesyonellerine en güncel araştırmaları veya tedavi kılavuzlarını sunabilir; böylece daha iyi klinik kararlar alınmasına yardımcı olur.
Llama 3.1, ayrıntılı raporlar üretme veya kapsamlı araştırmalar yürütme gibi bilgi yoğun görevlerde de son derece etkilidir. RAG aracılığıyla geniş bir kaynak yelpazesinden yararlanarak Llama 3.1 modelleri daha kapsamlı ve nüanslı analizler sunabilir; bu da onları araştırma, finans ve stratejik planlama gibi alanlardaki profesyoneller için değerli araçlar hâline getirir.
Ollama ve Langchain kullanarak Llama 3.1 ile bir RAG uygulaması hayata geçirmek, gelişmiş ve bağlamın farkında olan dil modelleri oluşturmak için iyi bir çözümdür.
Belirtilen adımları—ortamı kurma, belgeleri yükleme ve işleme, gömlemeler oluşturma ve alıcıyı LLM ile entegre etme—izleyerek, ilgili bilgileri alabilen ve doğru yanıtlar sağlayabilen işlevsel bir RAG sistemi oluşturabilirsiniz.
Llama 3.1’in RAG ile entegrasyonu, güncel haricî bilgilere erişimin önemli olduğu sohbet botları, soru-yanıt sistemleri ve araştırma araçları gibi gerçek dünya uygulamaları için özellikle değerlidir.
Yapay zekâ uygulamaları geliştirmeyi öğrenin!
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



