
Cursus
LLM-toepassingen ontwikkelen met LangChain
3 uur
51.9K
Llama 3.1 is een goede keuze voor RAG, een techniek die zoeksystemen combineert met de tekstgenererende capaciteiten van taalmodellen om accuratere en relevantere output te leveren.
In RAG doorzoekt een retrievalsysteem eerst grote datasets om de meest relevante informatie te vinden, die het taalmodel vervolgens gebruikt om het uiteindelijke antwoord te genereren. Dit is vooral nuttig voor taken als het beantwoorden van vragen, het bouwen van chatbots en informatie-intensieve taken, waar traditionele taalmodellen verouderde of irrelevante antwoorden kunnen geven.
Met de mogelijkheid om tot 128K tokens te verwerken en ondersteuning voor meerdere talen, verbetert Llama 3.1 de kwaliteit en betrouwbaarheid van AI-gegenereerde content in RAG-systemen.
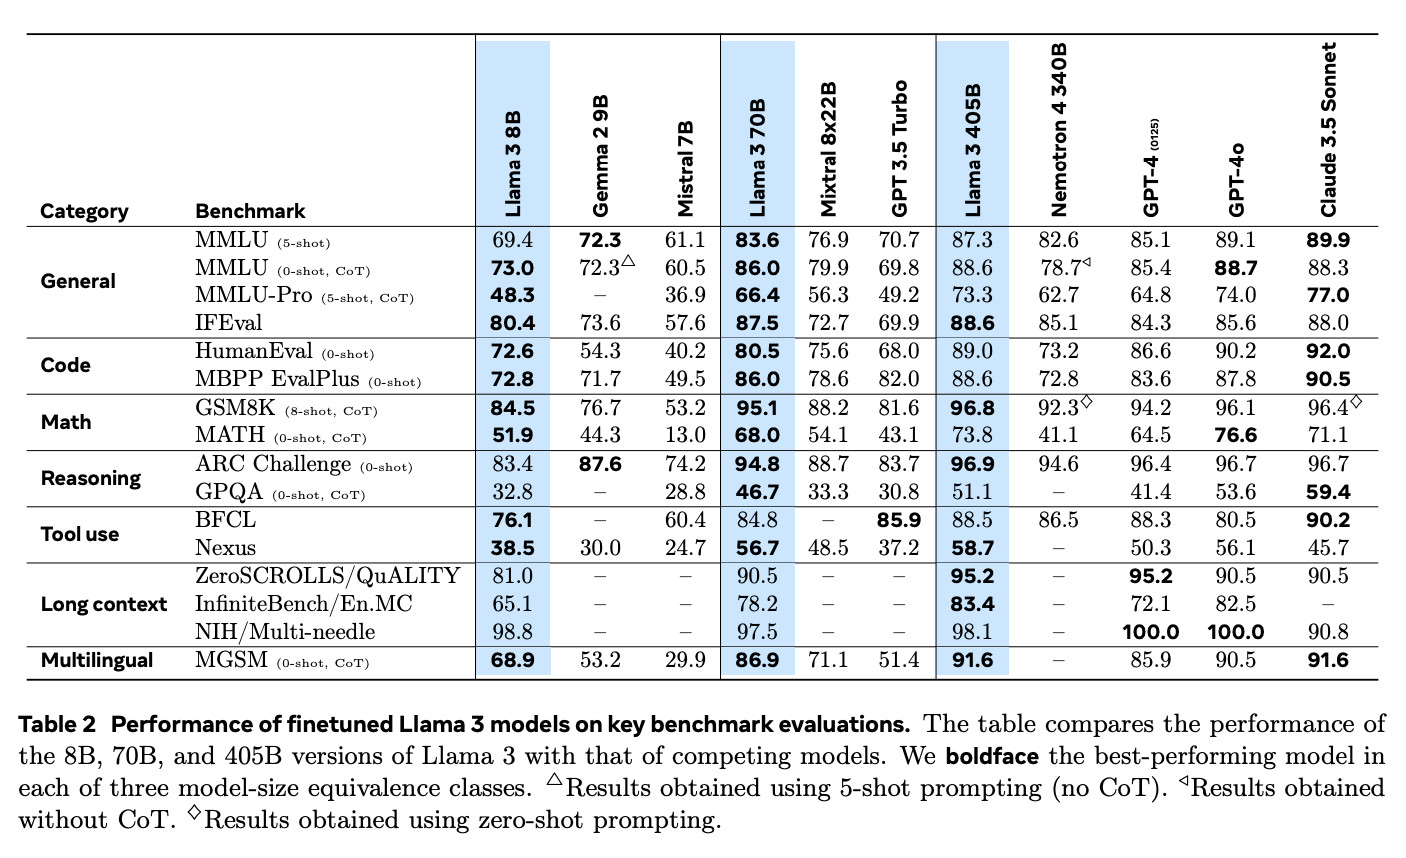
Bron: The Llama 3 Herd of Models
Daarnaast blinkt Llama 3.1 uit in RAG-toepassingen vergeleken met closed-source modellen zoals GPT-4o en Claude 3.5 Sonnet. Dankzij sterke redeneervaardigheden en het vermogen om langere teksten te verwerken, kan het beter met complexe vragen omgaan en relevantere antwoorden geven.
In de Needle-in-a-Haystack (NIH) benchmark, die test of een model specifieke stukken informatie ("naalden") in grote hoeveelheden tekst ("hooibergen") kan vinden, scoort Llama 3.1 bijna perfect over alle modelgroottes. Dit toont aan dat het complexe zoektaken aankan, wat het ideaal maakt voor RAG-systemen die precieze informatie uit grote datasets moeten halen.
Het model presteerde ook uitzonderlijk goed in de Multi-needle benchmark, waarbij meerdere stukjes informatie nauwkeurig moeten worden opgehaald. De vrijwel perfecte resultaten benadrukken nogmaals dat het complexe retrievaltaken aankan.
Voor het opzetten van een RAG-app met Llama 3.1 zijn meerdere stappen nodig. Denk aan het downloaden van het Llama 3.1-model naar je lokale machine, het inrichten van de omgeving, het laden van de benodigde libraries en het creëren van een retrievalmechanisme. Tot slot combineren we dit met een taalmodel om een complete applicatie te bouwen.
Hieronder vind je een heldere, stapsgewijze handleiding om een RAG-applicatie met Llama 3.1 te bouwen.
Installeer eerst de Ollama-applicatie, waarmee we Llama 3.1 en andere open-source taalmodellen lokaal kunnen draaien. Je kunt de Ollama-app downloaden van hun officiële website.
Zodra je Ollama hebt geïnstalleerd en geopend, is de volgende stap het downloaden van het Llama 3.1-model naar je lokale machine. In deze tutorial gebruiken we de versie met 8B parameters. Open je terminal en voer de volgende opdracht uit om te downloaden:
ollama run llama3.1Nadat het model is gedownload, kunnen we verbinding maken via Langchain. Hoe je dat doet, laten we in de volgende secties zien.
Zorg ervoor dat je de juiste Python-libraries hebt geïnstalleerd. We hebben libraries nodig zoals langchain, langchain_community, langchain-ollama, langchain_openai. Als je ze nog niet hebt geïnstalleerd, kan dat met pip via deze opdracht:
pip install langchain langchain_community langchain-openai scikit-learn langchain-ollamaDe eerste stap in het maken van je RAG-systeem is het laden van de documenten die we als kennisbron willen gebruiken. In dit voorbeeld gebruiken we webpagina’s als bron.
Zo pak je dat aan:
from langchain_community.document_loaders import WebBaseLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter
# List of URLs to load documents from
urls = [
    "<https://lilianweng.github.io/posts/2023-06-23-agent/>",
    "<https://lilianweng.github.io/posts/2023-03-15-prompt-engineering/>",
    "<https://lilianweng.github.io/posts/2023-10-25-adv-attack-llm/>",
]
# Load documents from the URLs
docs = [WebBaseLoader(url).load() for url in urls]
docs_list = [item for sublist in docs for item in sublist]
Hiermee haalt WebBaseLoader de content op van elke opgegeven URL. De geneste lijsten met documenten worden samengevoegd tot één platte lijst, docs_list, zodat we één documentenlijst hebben.
Om het retrievalproces efficiënter te maken, delen we de documenten op in kleinere stukjes met de RecursiveCharacterTextSplitter. Dit helpt het systeem de tekst effectiever te verwerken en te doorzoeken.
We kunnen de text splitter instellen met een chunkgrootte en overlap. In de code hieronder gebruiken we chunks van 250 tekens zonder overlap.
# Initialize a text splitter with specified chunk size and overlap
text_splitter = RecursiveCharacterTextSplitter.from_tiktoken_encoder(
    chunk_size=250, chunk_overlap=0
)
# Split the documents into chunks
doc_splits = text_splitter.split_documents(docs_list)Vervolgens moeten we de tekstchunks omzetten in embeddings, die we opslaan in een vector store. Zo kunnen we snel en efficiënt op gelijkenis zoeken.
Hiervoor gebruiken we OpenAIEmbeddings om embeddings te genereren voor elke tekstchunk, die we vervolgens in een SKLearnVectorStore opslaan. De vector store is geconfigureerd om de 4 meest relevante documenten terug te geven voor een query via as_retriever(k=4).
from langchain_community.vectorstores import SKLearnVectorStore
from langchain_openai import OpenAIEmbeddings
# Create embeddings for documents and store them in a vector store
vectorstore = SKLearnVectorStore.from_documents(
    documents=doc_splits,
    embedding=OpenAIEmbeddings(openai_api_key="api_key"),
)
retriever = vectorstore.as_retriever(k=4)In deze stap configureren we de LLM en maken we een prompttemplate om antwoorden te genereren op basis van de opgehaalde documenten.
Eerst definiëren we een prompttemplate die de LLM instrueert hoe antwoorden te formuleren. Deze template vraagt het model om de aangeleverde documenten te gebruiken en bondig te antwoorden, met maximaal drie zinnen. Als het model het antwoord niet kan vinden, moet het aangeven dat het dat niet weet.
from langchain_ollama import ChatOllama
from langchain.prompts import PromptTemplate
from langchain_core.output_parsers import StrOutputParser
# Define the prompt template for the LLM
prompt = PromptTemplate(
    template="""You are an assistant for question-answering tasks.
    Use the following documents to answer the question.
    If you don't know the answer, just say that you don't know.
    Use three sentences maximum and keep the answer concise:
    Question: {question}
    Documents: {documents}
    Answer:
    """,
    input_variables=["question", "documents"],
)
Vervolgens maken we verbinding met het Llama 3.1-model via ChatOllama uit Langchain, geconfigureerd met een temperatuur van 0 voor consistente antwoorden.
# Initialize the LLM with Llama 3.1 model
llm = ChatOllama(
    model="llama3.1",
    temperature=0,
)
Tot slot maken we een chain die de prompttemplate met de LLM combineert en StrOutputParser gebruikt om de output om te zetten naar een nette, eenvoudige string die geschikt is voor weergave.
# Create a chain combining the prompt template and LLM
rag_chain = prompt | llm | StrOutputParser()In deze stap combineren we de retriever en de RAG-chain tot een complete RAG-app. Dat doen we met een klasse RAGApplication die zowel het ophalen van documenten als het genereren van antwoorden afhandelt.
De klasse RAGApplication heeft de methode run die de vraag van de gebruiker aanneemt, de retriever gebruikt om relevante documenten te vinden en vervolgens de tekst daaruit haalt. Daarna geeft het de vraag en de documenttekst door aan de RAG-chain om een bondig antwoord te genereren.
# Define the RAG application class
class RAGApplication:
    def __init__(self, retriever, rag_chain):
        self.retriever = retriever
        self.rag_chain = rag_chain
    def run(self, question):
        # Retrieve relevant documents
        documents = self.retriever.invoke(question)
        # Extract content from retrieved documents
        doc_texts = "\\n".join([doc.page_content for doc in documents])
        # Get the answer from the language model
        answer = self.rag_chain.invoke({"question": question, "documents": doc_texts})
return answerNu kunnen we onze RAG-applicatie testen met enkele voorbeeldvragen om te controleren of alles goed werkt. Je kunt de prompttemplate of de retrievalinstellingen aanpassen om de prestaties te verbeteren of de app op specifieke behoeften af te stemmen.
# Initialize the RAG application
rag_application = RAGApplication(retriever, rag_chain)
# Example usage
question = "What is prompt engineering"
answer = rag_application.run(question)
print("Question:", question)
print("Answer:", answer)
Question: What is prompt engineering
Answer: Prompt engineering refers to methods for communicating with Large Language Models (LLMs) to steer their behavior towards desired outcomes without updating the model weights. It's an empirical science that requires experimentation and heuristics, aiming at alignment and model steerability. The goal is to optimize prompts to achieve specific results, often using techniques like iterative prompting or external tool use.De geavanceerde functies en RAG-ondersteuning van Llama 3.1 maken het ideaal voor diverse impactvolle toepassingen.
Voor chatbotontwikkeling zorgt de integratie van Llama 3.1 met RAG ervoor dat chatbots accuratere en contextbewuste antwoorden geven door externe databases of kennisbanken te raadplegen. Zo blijft de informatie voor gebruikers actueel en relevant, wat vooral in klantenservice belangrijk is: tijdige en juiste antwoorden verhogen tevredenheid en efficiëntie. Dankzij meertalige ondersteuning is Llama 3.1 bovendien geschikt voor een divers gebruikerspubliek.
In vraag-antwoordsystemen pakt Llama 3.1 de beperkingen aan van traditionele taalmodellen die alleen op interne datasets steunen. Door via RAG actuele informatie uit externe bronnen te gebruiken, verhoogt Llama 3.1 de nauwkeurigheid en betrouwbaarheid van antwoorden. Dit is vooral nuttig in sectoren als zorg en onderwijs, waar precieze en actuele informatie cruciaal is.
Zo kan een medische AI-assistent op basis van Llama 3.1 zorgprofessionals in realtime van het nieuwste onderzoek of behandelrichtlijnen voorzien door medische databases te bevragen, wat betere klinische besluitvorming ondersteunt.
Llama 3.1 is ook zeer effectief voor kennisintensieve taken zoals het genereren van gedetailleerde rapporten of het uitvoeren van grondig onderzoek. Door met RAG uit een breed scala aan bronnen te putten, kunnen Llama 3.1-modellen uitgebreidere en genuanceerdere analyses leveren, wat ze waardevol maakt voor professionals in onder meer onderzoek, financiën en strategische planning.
Een RAG-applicatie met Llama 3.1 bouwen via Ollama en Langchain biedt een sterke oplossing om geavanceerde, contextbewuste taalmodellen te maken.
Volg de beschreven stappen—de omgeving inrichten, documenten laden en verwerken, embeddings maken en de retriever met de LLM integreren—om een functioneel RAG-systeem te bouwen dat relevante informatie kan ophalen en accurate antwoorden geeft.
De integratie van Llama 3.1 met RAG is vooral waardevol voor toepassingen zoals chatbots, vraag-antwoordsystemen en researchtools, waar toegang tot actuele externe informatie belangrijk is.
Leer AI-applicaties bouwen!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

