

Perché scegliere Llama 3.1 per il RAG?
Llama 3.1 è una buona scelta per il RAG, una tecnica che combina sistemi di recupero con le capacità generative dei modelli linguistici per garantire output più accurati e pertinenti.
Nel RAG, un sistema di retrieval esamina prima grandi dataset per trovare le informazioni più rilevanti, che il modello linguistico usa poi per generare la risposta finale. Questo è particolarmente utile per attività come rispondere a domande, costruire chatbot e gestire compiti ricchi di informazioni, dove i modelli linguistici tradizionali potrebbero dare risposte obsolete o irrilevanti.
Grazie alla capacità di gestire fino a 128K token e al supporto multilingue, Llama 3.1 migliora la qualità e l'affidabilità dei contenuti generati dall'IA nei sistemi RAG.
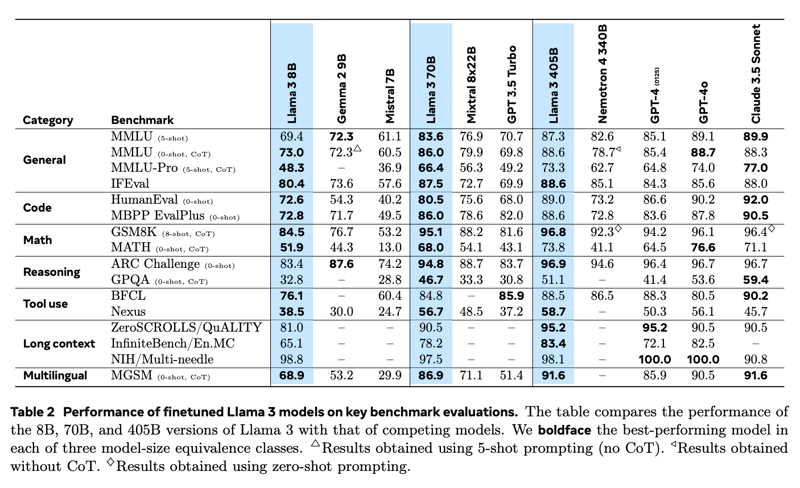
Fonte: The Llama 3 Herd of Models
Inoltre, Llama 3.1 si distingue nelle applicazioni RAG rispetto a modelli closed-source come GPT-4o e Claude 3.5 Sonnet. Le sue forti capacità di ragionamento e l'abilità di processare testi più lunghi gli consentono di gestire meglio domande complesse e fornire risposte più pertinenti.
Nel benchmark Needle-in-a-Haystack (NIH), che testa la capacità di trovare pezzi di informazione specifici ("aghi") in grandi volumi di testo ("pagliai"), Llama 3.1 eccelle con un tasso di recupero quasi perfetto su tutte le dimensioni del modello. Questo dimostra la sua abilità nel gestire ricerche complesse, rendendolo ideale per sistemi RAG che devono estrarre informazioni precise da grandi dataset.
Il modello ha ottenuto risultati eccezionali anche nel benchmark Multi-needle, che richiede di recuperare accuratamente più informazioni. I risultati quasi perfetti in questo test confermano ulteriormente la sua capacità di gestire compiti di retrieval complessi.
Come implementare il RAG con Llama 3.1 usando Ollama e Langchain
Per configurare un'applicazione RAG con Llama 3.1, sono necessari diversi passaggi. Tra questi, scaricare il modello Llama 3.1 sulla tua macchina locale, impostare l'ambiente, caricare le librerie necessarie e creare un meccanismo di retrieval. Infine, lo combineremo con un modello linguistico per costruire un'applicazione completa.
Qui sotto trovi una guida chiara, passo per passo, per implementare un'applicazione RAG con Llama 3.1.
Passaggio 1: Installa Ollama
Per prima cosa, installa l'applicazione Ollama, che ci permette di eseguire Llama 3.1 e altri modelli linguistici open-source sulla tua macchina locale. Puoi scaricare l'app Ollama dal loro sito ufficiale.
Dopo aver installato e aperto Ollama, il passo successivo è scaricare il modello Llama 3.1 sulla tua macchina locale. Per questo tutorial useremo la versione da 8B parametri. Per scaricarla, apri il terminale ed esegui il seguente comando:
ollama run llama3.1Una volta terminato il download del modello, saremo pronti a connetterci tramite Langchain, come vedrai nelle sezioni successive.
Passaggio 2: Configura l'ambiente
Prima di iniziare, assicurati di avere installate le librerie Python giuste. Ci serviranno librerie come langchain, langchain_community, langchain-ollama, langchain_openai. Se non le hai ancora installate, puoi farlo con pip usando questo comando:
pip install langchain langchain_community langchain-openai scikit-learn langchain-ollamaPassaggio 3: Carica e prepara i documenti
Il primo passo per creare il tuo sistema RAG è caricare i documenti che useremo come base di conoscenza. In questo esempio useremo pagine web come fonte.
Ecco come fare:
from langchain_community.document_loaders import WebBaseLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter
# List of URLs to load documents from
urls = [
"<https://lilianweng.github.io/posts/2023-06-23-agent/>",
"<https://lilianweng.github.io/posts/2023-03-15-prompt-engineering/>",
"<https://lilianweng.github.io/posts/2023-10-25-adv-attack-llm/>",
]
# Load documents from the URLs
docs = [WebBaseLoader(url).load() for url in urls]
docs_list = [item for sublist in docs for item in sublist]Qui, WebBaseLoader viene usato per recuperare i contenuti da ciascun URL fornito. Le liste annidate di documenti risultanti vengono poi combinate in un'unica lista piatta chiamata docs_list, ottenendo così un elenco di documenti.
Passaggio 4: Dividi i documenti in chunk
Per rendere più efficiente il processo di retrieval, dividiamo i documenti in parti più piccole usando il RecursiveCharacterTextSplitter. Questo aiuta il sistema a gestire e a cercare il testo in modo più efficace.
Possiamo configurare lo splitter specificando la dimensione dei chunk e l'overlap. Ad esempio, nel codice seguente impostiamo uno splitter con chunk da 250 caratteri e senza overlap.
# Initialize a text splitter with specified chunk size and overlap
text_splitter = RecursiveCharacterTextSplitter.from_tiktoken_encoder(
chunk_size=250, chunk_overlap=0
)
# Split the documents into chunks
doc_splits = text_splitter.split_documents(docs_list)Passaggio 5: Crea un vector store
Successivamente, dobbiamo convertire i chunk di testo in embedding, che poi vengono salvate in un vector store, consentendo un recupero rapido ed efficiente basato sulla similarità.
Per farlo, usiamo OpenAIEmbeddings per generare embedding per ciascun chunk di testo, che vengono poi salvate in un SKLearnVectorStore. Il vector store è configurato per restituire i 4 documenti più rilevanti per ogni query tramite as_retriever(k=4).
from langchain_community.vectorstores import SKLearnVectorStore
from langchain_openai import OpenAIEmbeddings
# Create embeddings for documents and store them in a vector store
vectorstore = SKLearnVectorStore.from_documents(
documents=doc_splits,
embedding=OpenAIEmbeddings(openai_api_key="api_key"),
)
retriever = vectorstore.as_retriever(k=4)Passaggio 6: Configura l'LLM e il prompt template
In questo passaggio, configureremo l'LLM e creeremo un prompt template per generare risposte basate sui documenti recuperati.
Per prima cosa, definiamo un prompt template che istruisce l'LLM su come formattare le risposte. Questo template dice al modello di usare i documenti forniti per rispondere in modo conciso, usando al massimo tre frasi. Se il modello non trova una risposta, deve semplicemente dire che non lo sa.
from langchain_ollama import ChatOllama
from langchain.prompts import PromptTemplate
from langchain_core.output_parsers import StrOutputParser
# Define the prompt template for the LLM
prompt = PromptTemplate(
template="""You are an assistant for question-answering tasks.
Use the following documents to answer the question.
If you don't know the answer, just say that you don't know.
Use three sentences maximum and keep the answer concise:
Question: {question}
Documents: {documents}
Answer:
""",
input_variables=["question", "documents"],
)Poi ci colleghiamo al modello Llama 3.1 usando ChatOllama di Langchain, che abbiamo configurato con temperatura 0 per risposte coerenti.
# Initialize the LLM with Llama 3.1 model
llm = ChatOllama(
model="llama3.1",
temperature=0,
)Infine, creiamo una chain che combina il prompt template con l'LLM e usa StrOutputParser per garantire che l'output sia una semplice stringa pulita, adatta alla visualizzazione.
# Create a chain combining the prompt template and LLM
rag_chain = prompt | llm | StrOutputParser()Passaggio 7: Integra il retriever e l'LLM in un'applicazione RAG
In questo passaggio, combineremo il retriever e la RAG chain per creare un'applicazione RAG completa. Lo faremo creando una classe chiamata RAGApplication che gestirà sia il recupero dei documenti sia la generazione delle risposte.
La classe RAGApplication ha il metodo run che prende la domanda dell'utente, usa il retriever per trovare i documenti rilevanti e poi estrae il testo da quei documenti. Passa quindi la domanda e il testo dei documenti alla RAG chain per generare una risposta concisa.
# Define the RAG application class
class RAGApplication:
def __init__(self, retriever, rag_chain):
self.retriever = retriever
self.rag_chain = rag_chain
def run(self, question):
# Retrieve relevant documents
documents = self.retriever.invoke(question)
# Extract content from retrieved documents
doc_texts = "\\n".join([doc.page_content for doc in documents])
# Get the answer from the language model
answer = self.rag_chain.invoke({"question": question, "documents": doc_texts})
return answerPassaggio 8: Testa l'applicazione
Infine, siamo pronti a testare la nostra applicazione RAG con alcune domande di esempio per assicurarci che funzioni correttamente. Puoi regolare il prompt template o le impostazioni di retrieval per migliorare le prestazioni o adattare l'applicazione a esigenze specifiche.
# Initialize the RAG application
rag_application = RAGApplication(retriever, rag_chain)
# Example usage
question = "What is prompt engineering"
answer = rag_application.run(question)
print("Question:", question)
print("Answer:", answer)Question: What is prompt engineering
Answer: Prompt engineering refers to methods for communicating with Large Language Models (LLMs) to steer their behavior towards desired outcomes without updating the model weights. It's an empirical science that requires experimentation and heuristics, aiming at alignment and model steerability. The goal is to optimize prompts to achieve specific results, often using techniques like iterative prompting or external tool use.Llama 3.1 con RAG: applicazioni reali
Le funzionalità avanzate di Llama 3.1 e il supporto al RAG lo rendono ideale per diverse applicazioni ad alto impatto.
Per lo sviluppo di chatbot, integrare Llama 3.1 con RAG permette ai chatbot di fornire risposte più accurate e consapevoli del contesto accedendo a database o basi di conoscenza esterne. Questo garantisce che le informazioni fornite agli utenti siano aggiornate e pertinenti, particolarmente importante in ambiti come il customer service, dove risposte puntuali e corrette possono migliorare molto soddisfazione ed efficienza. Il supporto multilingue di Llama 3.1 lo rende inoltre efficace per servire un'utenza eterogenea.
Nei sistemi di question answering, Llama 3.1 supera i limiti dei modelli linguistici tradizionali che si basano solo sui propri dataset interni. Usando il RAG per accedere a informazioni aggiornate da fonti esterne, Llama 3.1 migliora l'accuratezza e l'affidabilità delle risposte. Questo è particolarmente utile in settori come sanità ed istruzione, dove sono essenziali informazioni precise e aggiornate.
Per esempio, un assistente medico basato su Llama 3.1 può fornire ai professionisti sanitari le ricerche o le linee guida terapeutiche più recenti interrogando in tempo reale i database medici, supportando decisioni cliniche migliori.
Llama 3.1 è anche molto efficace per compiti knowledge-intensive come la generazione di report dettagliati o lo svolgimento di ricerche approfondite. Usando il RAG per attingere a un'ampia gamma di fonti, i modelli Llama 3.1 possono offrire analisi più complete e sfumate, risultando strumenti preziosi per professionisti in ambiti come ricerca, finanza e pianificazione strategica.
Conclusione
Implementare un'applicazione RAG con Llama 3.1 usando Ollama e Langchain è un'ottima soluzione per creare modelli linguistici avanzati e sensibili al contesto.
Seguendo i passaggi descritti — configurazione dell'ambiente, caricamento ed elaborazione dei documenti, creazione delle embedding e integrazione del retriever con l'LLM — puoi costruire un sistema RAG funzionante in grado di recuperare informazioni pertinenti e fornire risposte accurate.
L'integrazione di Llama 3.1 con il RAG è particolarmente utile per applicazioni reali come chatbot, sistemi di question answering e strumenti di ricerca, dove è importante l'accesso a informazioni esterne aggiornate.

Ryan è un lead data scientist specializzato nello sviluppo di applicazioni di IA con LLM. È dottorando in Elaborazione del Linguaggio Naturale e Knowledge Graph all’Imperial College London, dove ha anche conseguito la laurea magistrale in Informatica. Oltre alla data science, scrive una newsletter settimanale su Substack, The Limitless Playbook, in cui condivide un’idea pratica dei migliori pensatori al mondo e, di tanto in tanto, scrive sui concetti fondamentali dell’IA.





Il rilascio di Llama 3.1 da parte di Meta rappresenta un grande passo avanti nei modelli LLM a pesi aperti.
Con opzioni che arrivano fino a 405 miliardi di parametri, Llama 3.1 è alla pari con i migliori modelli closed-source come GPT-4o di OpenAI, Claude 3 di Anthropic e Google Gemini.
In questo tutorial, vedremo come implementare un sistema di retrieval-augmented generation (RAG) usando il modello Llama 3.1 8B. Scopriremo perché Llama 3.1 è ottimo per il RAG, come scaricare e usare Llama 3.1 in locale con Ollama e come collegarlo tramite Langchain per costruire l'applicazione RAG completa. Vedremo anche i diversi casi d'uso e le applicazioni reali di Llama 3.1.