
Khóa học
Phát triển ứng dụng LLM với LangChain
3 giờ
51.9K
Llama 3.1 là lựa chọn tốt cho RAG, một kỹ thuật kết hợp hệ thống truy xuất với khả năng tạo văn bản của mô hình ngôn ngữ để đảm bảo đầu ra chính xác và phù hợp hơn.
Trong RAG, một hệ thống truy xuất trước tiên sẽ tìm kiếm trong các tập dữ liệu lớn để tìm thông tin liên quan nhất, sau đó mô hình ngôn ngữ sử dụng thông tin đó để tạo phản hồi cuối cùng. Điều này đặc biệt hữu ích cho các tác vụ như trả lời câu hỏi, xây dựng chatbot và xử lý các nhiệm vụ nặng thông tin, nơi các mô hình ngôn ngữ truyền thống có thể đưa ra câu trả lời lỗi thời hoặc không liên quan.
Với khả năng xử lý tới 128K token và hỗ trợ đa ngôn ngữ, Llama 3.1 nâng cao chất lượng và độ tin cậy của nội dung do AI tạo ra trong các hệ thống RAG.
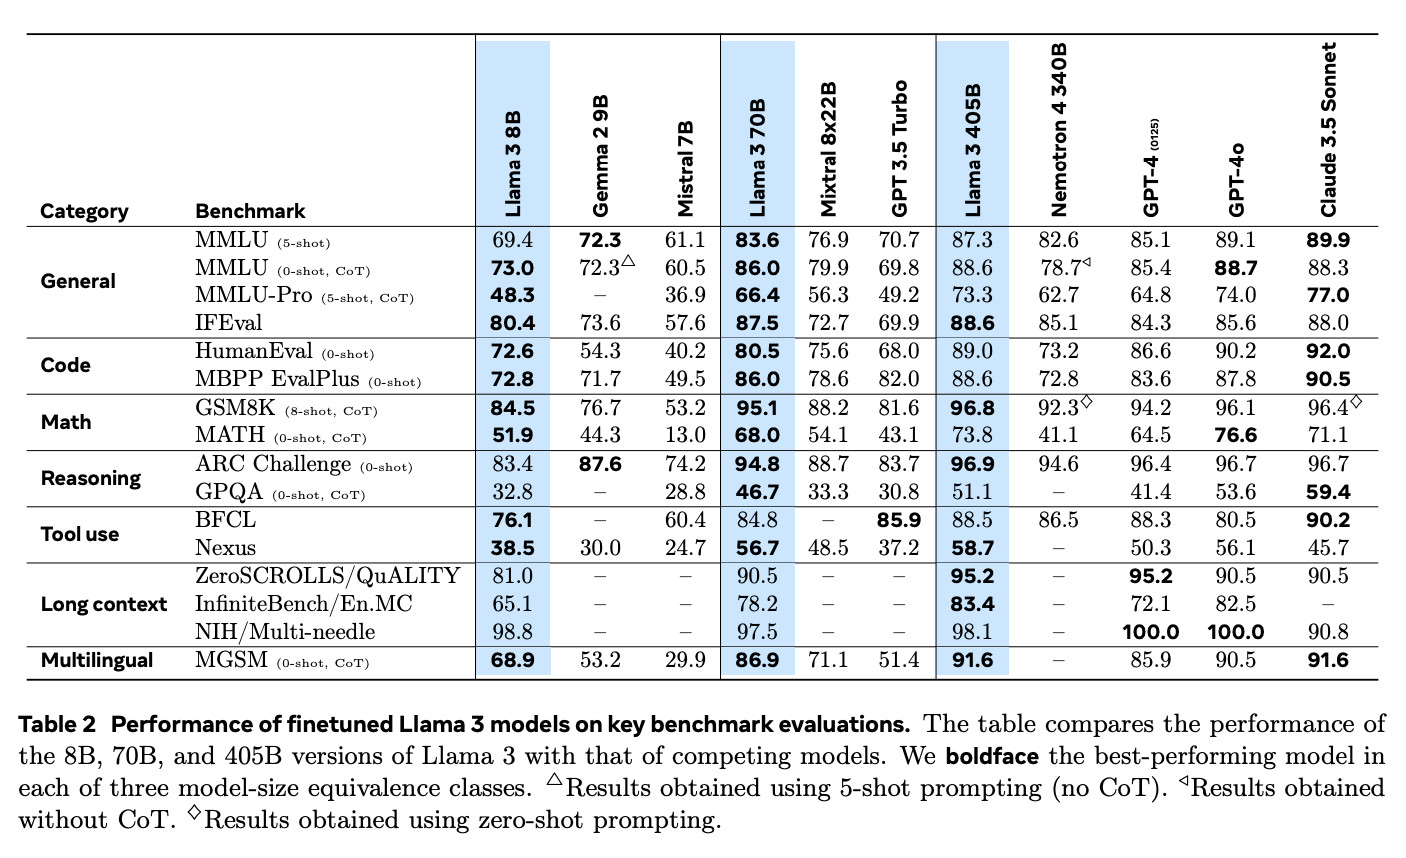
Nguồn: The Llama 3 Herd of Models
Ngoài ra, Llama 3.1 còn nổi bật trong các ứng dụng RAG khi so sánh với các mô hình mã nguồn đóng như GPT-4o và Claude 3.5 Sonnet. Khả năng suy luận mạnh và xử lý văn bản dài giúp mô hình giải quyết tốt hơn các câu hỏi phức tạp và đưa ra câu trả lời phù hợp hơn.
Trong bài đo Needle-in-a-Haystack (NIH), kiểm tra khả năng của mô hình trong việc tìm các mẩu thông tin cụ thể ("kim") trong lượng văn bản lớn ("rơm rạ"), Llama 3.1 thể hiện vượt trội với tỷ lệ truy xuất gần như hoàn hảo ở mọi kích thước mô hình. Điều này cho thấy khả năng xử lý các tác vụ tìm kiếm phức tạp, lý tưởng cho các hệ thống RAG cần trích xuất thông tin chính xác từ tập dữ liệu lớn.
Mô hình cũng đạt kết quả xuất sắc trong bài đo Multi-needle, yêu cầu truy xuất chính xác nhiều mẩu thông tin. Kết quả gần như hoàn hảo càng chứng minh năng lực xử lý các tác vụ truy xuất phức tạp.
Để thiết lập một ứng dụng RAG với Llama 3.1, cần thực hiện một số bước: tải mô hình Llama 3.1 về máy cục bộ, thiết lập môi trường, nạp các thư viện cần thiết và tạo cơ chế truy xuất. Cuối cùng, chúng ta sẽ kết hợp cơ chế này với mô hình ngôn ngữ để xây dựng ứng dụng hoàn chỉnh.
Dưới đây là hướng dẫn rõ ràng, từng bước để giúp bạn triển khai ứng dụng RAG bằng Llama 3.1.
Trước tiên, cài đặt ứng dụng Ollama, cho phép chúng ta chạy Llama 3.1 và các mô hình ngôn ngữ mã nguồn mở khác trên máy cục bộ. Bạn có thể tải ứng dụng Ollama từ trang web chính thức của họ.
Sau khi cài đặt và mở Ollama, bước tiếp theo là tải mô hình Llama 3.1 về máy cục bộ. Trong hướng dẫn này, chúng ta sẽ dùng phiên bản 8B tham số. Để tải, mở terminal và chạy lệnh sau:
ollama run llama3.1Sau khi mô hình tải xong, chúng ta sẽ sẵn sàng kết nối bằng Langchain, cách thực hiện sẽ được trình bày ở các phần sau.
Trước khi bắt đầu, hãy đảm bảo bạn đã cài đúng các thư viện Python. Chúng ta sẽ cần các thư viện như langchain, langchain_community, langchain-ollama, langchain_openai. Nếu bạn chưa cài, có thể dùng pip với lệnh sau:
pip install langchain langchain_community langchain-openai scikit-learn langchain-ollamaBước đầu tiên để tạo hệ thống RAG là nạp các tài liệu dùng làm cơ sở tri thức. Trong ví dụ này, chúng ta sẽ dùng các trang web làm nguồn.
Cách thực hiện như sau:
from langchain_community.document_loaders import WebBaseLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter
# List of URLs to load documents from
urls = [
    "<https://lilianweng.github.io/posts/2023-06-23-agent/>",
    "<https://lilianweng.github.io/posts/2023-03-15-prompt-engineering/>",
    "<https://lilianweng.github.io/posts/2023-10-25-adv-attack-llm/>",
]
# Load documents from the URLs
docs = [WebBaseLoader(url).load() for url in urls]
docs_list = [item for sublist in docs for item in sublist]
Ở đây, WebBaseLoader được dùng để lấy nội dung từ từng URL đã cung cấp. Danh sách lồng nhau của các tài liệu thu được sau đó được gộp thành một danh sách phẳng duy nhất gọi là docs_list, cho ta một danh sách tài liệu.
Để việc truy xuất hiệu quả hơn, chúng ta chia tài liệu thành các đoạn nhỏ bằng RecursiveCharacterTextSplitter. Cách này giúp hệ thống xử lý và tìm kiếm văn bản hiệu quả hơn.
Chúng ta có thể cấu hình bộ tách văn bản bằng cách chỉ định kích thước đoạn và độ chồng lấn. Ví dụ dưới đây thiết lập kích thước đoạn 250 ký tự và không chồng lấn.
# Initialize a text splitter with specified chunk size and overlap
text_splitter = RecursiveCharacterTextSplitter.from_tiktoken_encoder(
    chunk_size=250, chunk_overlap=0
)
# Split the documents into chunks
doc_splits = text_splitter.split_documents(docs_list)Tiếp theo, chúng ta cần chuyển các đoạn văn bản thành embedding, rồi lưu vào kho vector để truy xuất nhanh chóng và hiệu quả dựa trên độ tương đồng.
Để làm điều này, chúng ta dùng OpenAIEmbeddings để tạo embedding cho từng đoạn văn bản, sau đó lưu vào SKLearnVectorStore. Kho vector được cấu hình để trả về 4 tài liệu liên quan nhất cho mỗi truy vấn với as_retriever(k=4).
from langchain_community.vectorstores import SKLearnVectorStore
from langchain_openai import OpenAIEmbeddings
# Create embeddings for documents and store them in a vector store
vectorstore = SKLearnVectorStore.from_documents(
    documents=doc_splits,
    embedding=OpenAIEmbeddings(openai_api_key="api_key"),
)
retriever = vectorstore.as_retriever(k=4)Ở bước này, chúng ta sẽ thiết lập LLM và tạo một mẫu nhắc để sinh phản hồi dựa trên các tài liệu đã truy xuất.
Trước hết, cần định nghĩa một mẫu nhắc hướng dẫn LLM về cách định dạng câu trả lời. Mẫu này yêu cầu mô hình dùng các tài liệu được cung cấp để trả lời ngắn gọn, tối đa ba câu. Nếu không tìm được câu trả lời, mô hình chỉ nên nói rằng không biết.
from langchain_ollama import ChatOllama
from langchain.prompts import PromptTemplate
from langchain_core.output_parsers import StrOutputParser
# Define the prompt template for the LLM
prompt = PromptTemplate(
    template="""You are an assistant for question-answering tasks.
    Use the following documents to answer the question.
    If you don't know the answer, just say that you don't know.
    Use three sentences maximum and keep the answer concise:
    Question: {question}
    Documents: {documents}
    Answer:
    """,
    input_variables=["question", "documents"],
)
Tiếp theo, chúng ta kết nối tới mô hình Llama 3.1 bằng ChatOllama từ Langchain, được cấu hình với temperature bằng 0 để có phản hồi nhất quán.
# Initialize the LLM with Llama 3.1 model
llm = ChatOllama(
    model="llama3.1",
    temperature=0,
)
Cuối cùng, chúng ta tạo một chuỗi kết hợp mẫu nhắc với LLM và dùng StrOutputParser để đảm bảo đầu ra là chuỗi đơn giản, sạch, phù hợp để hiển thị.
# Create a chain combining the prompt template and LLM
rag_chain = prompt | llm | StrOutputParser()Ở bước này, chúng ta sẽ kết hợp bộ truy xuất và chuỗi RAG để tạo ứng dụng RAG hoàn chỉnh. Chúng ta sẽ tạo một lớp gọi là RAGApplication để xử lý cả việc truy xuất tài liệu và sinh câu trả lời.
Lớp RAGApplication có phương thức run nhận câu hỏi của người dùng, dùng bộ truy xuất để tìm tài liệu liên quan rồi trích văn bản từ các tài liệu đó. Sau đó, nó truyền câu hỏi và văn bản tài liệu vào chuỗi RAG để tạo câu trả lời ngắn gọn.
# Define the RAG application class
class RAGApplication:
    def __init__(self, retriever, rag_chain):
        self.retriever = retriever
        self.rag_chain = rag_chain
    def run(self, question):
        # Retrieve relevant documents
        documents = self.retriever.invoke(question)
        # Extract content from retrieved documents
        doc_texts = "\\n".join([doc.page_content for doc in documents])
        # Get the answer from the language model
        answer = self.rag_chain.invoke({"question": question, "documents": doc_texts})
return answerCuối cùng, chúng ta sẵn sàng kiểm thử ứng dụng RAG với một số câu hỏi mẫu để đảm bảo hoạt động đúng. Bạn có thể điều chỉnh mẫu nhắc hoặc thiết lập truy xuất để cải thiện hiệu năng hoặc tùy chỉnh cho nhu cầu cụ thể.
# Initialize the RAG application
rag_application = RAGApplication(retriever, rag_chain)
# Example usage
question = "What is prompt engineering"
answer = rag_application.run(question)
print("Question:", question)
print("Answer:", answer)
Question: What is prompt engineering
Answer: Prompt engineering refers to methods for communicating with Large Language Models (LLMs) to steer their behavior towards desired outcomes without updating the model weights. It's an empirical science that requires experimentation and heuristics, aiming at alignment and model steerability. The goal is to optimize prompts to achieve specific results, often using techniques like iterative prompting or external tool use.Các tính năng nâng cao và hỗ trợ RAG của Llama 3.1 khiến nó lý tưởng cho nhiều ứng dụng có tác động lớn.
Đối với phát triển chatbot, tích hợp Llama 3.1 với RAG cho phép chatbot cung cấp phản hồi chính xác và theo ngữ cảnh hơn bằng cách truy cập cơ sở dữ liệu hoặc kho tri thức bên ngoài. Điều này đảm bảo thông tin cung cấp cho người dùng là cập nhật và phù hợp, đặc biệt quan trọng trong các lĩnh vực như chăm sóc khách hàng, nơi câu trả lời kịp thời và chính xác có thể nâng cao sự hài lòng và hiệu quả. Hỗ trợ đa ngôn ngữ của Llama 3.1 cũng giúp phục vụ tốt một tập người dùng đa dạng.
Trong các hệ thống hỏi đáp, Llama 3.1 khắc phục hạn chế của các mô hình ngôn ngữ truyền thống vốn chỉ dựa vào tập dữ liệu nội bộ. Bằng cách dùng RAG để truy cập thông tin cập nhật từ nguồn bên ngoài, Llama 3.1 cải thiện độ chính xác và độ tin cậy của câu trả lời. Điều này đặc biệt hữu ích trong các lĩnh vực như y tế và giáo dục, nơi thông tin chính xác và cập nhật là thiết yếu.
Ví dụ, một trợ lý y khoa do Llama 3.1 cung cấp có thể truy vấn các cơ sở dữ liệu y học theo thời gian thực để cung cấp cho nhân viên y tế những nghiên cứu hoặc hướng dẫn điều trị mới nhất, hỗ trợ ra quyết định lâm sàng tốt hơn.
Llama 3.1 cũng rất hiệu quả cho các nhiệm vụ đòi hỏi nhiều tri thức như tạo báo cáo chi tiết hoặc thực hiện nghiên cứu chuyên sâu. Bằng cách dùng RAG để khai thác nhiều nguồn, các mô hình Llama 3.1 có thể đưa ra phân tích toàn diện và sâu sắc hơn, trở thành công cụ giá trị cho các chuyên gia trong các lĩnh vực như nghiên cứu, tài chính và hoạch định chiến lược.
Triển khai ứng dụng RAG với Llama 3.1 bằng Ollama và Langchain mang đến giải pháp tốt để xây dựng các mô hình ngôn ngữ nâng cao, nhận thức ngữ cảnh.
Bằng cách làm theo các bước đã nêu—thiết lập môi trường, nạp và xử lý tài liệu, tạo embedding, và tích hợp bộ truy xuất với LLM—bạn có thể xây dựng một hệ thống RAG hoạt động, có khả năng truy xuất thông tin liên quan và cung cấp câu trả lời chính xác.
Việc tích hợp RAG với Llama 3.1 đặc biệt hữu ích cho các ứng dụng thực tế như chatbot, hệ thống hỏi đáp và công cụ nghiên cứu, nơi việc truy cập thông tin bên ngoài cập nhật là quan trọng.
Học cách xây dựng ứng dụng AI!
Khóa học
Khóa học
Khóa học
blog
Matt Crabtree
10 phút
