

Mengapa Memilih Model Llama 3.2 Vision untuk RAG?
Keluarga Llama 3.2 menghadirkan serangkaian model kuat yang menggabungkan pemahaman visi dan bahasa. Dua model terbesar, 11B dan 90B, dirancang khusus untuk menangani tugas kompleks yang memerlukan pemahaman informasi visual dan tekstual secara bersamaan.
Model-model ini unggul dalam membaca dan menganalisis bagan, grafik, dan tabel, sehingga sangat cocok untuk mengekstrak insight yang sulit ditangani model berbasis teks saja. Misalnya, seorang pemilik bisnis dapat bertanya, “Bulan mana tahun lalu yang memiliki laba tertinggi?” dan Llama 3.2 akan melihat grafik profitabilitas dan memberikan jawaban yang benar.
Selain itu, model dapat menemukan objek dalam gambar berdasarkan deskripsi. Baik untuk menandai landmark pada peta maupun mengidentifikasi tren pada grafik, Llama 3.2 dapat menanganinya dengan mudah.
Llama 3.2 tidak hanya menyamai para pesaing utama seperti Claude 3 Haiku dan GPT4o-mini, tetapi juga berkinerja setara dalam tugas seperti pengenalan gambar dan pemahaman visual sebagaimana ditunjukkan pada berbagai tolok ukur vision instruction-tuned. Kemampuannya bekerja dengan teks dan gambar memungkinkan percakapan yang lebih natural dan fleksibel yang memadukan informasi visual dan tertulis, sehingga ideal untuk beragam kasus penggunaan.
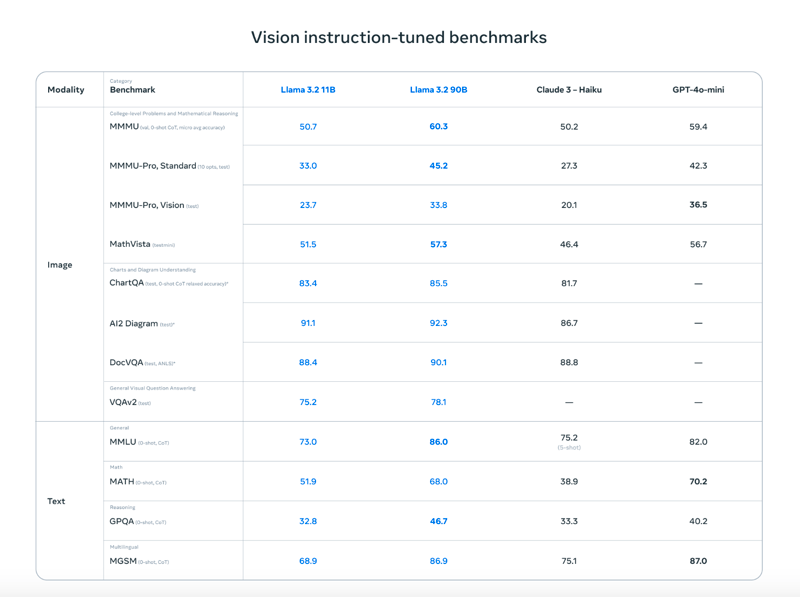
Sumber: Meta AI
Dengan fitur-fitur canggih ini, model Llama 3.2 Vision membuka kemungkinan baru untuk aplikasi RAG. Model ini membuat proses menarik insight dari sumber data yang rumit seperti PDF menjadi jauh lebih mudah, dengan menggabungkan visual dan teks untuk hasil yang lebih akurat dan bermanfaat.
Cara Menerapkan RAG dengan Llama 3.2 Vision menggunakan Ollama dan ColPali
Untuk menyiapkan aplikasi RAG dengan Llama 3.2 Vision, kita perlu mengunduh model Llama 3.2 Vision, menyiapkan lingkungan, memasang pustaka yang dibutuhkan, dan membuat sistem retrieval. Di bawah ini adalah panduan sederhana langkah demi langkah untuk membantu Anda mengimplementasikan aplikasi RAG menggunakan Llama 3.2 Vision dan ColPali.
Perlu diperhatikan bahwa langkah-langkah berikut diuji pada notebook Colab Pro dengan instance A100.
Langkah 1: Unduh dependensi
Pertama, pastikan Anda telah memasang dependensi yang diperlukan:
!pip install byaldi
!sudo apt-get install -y poppler-utils
!pip install -q git+https://github.com/huggingface/transformers.git qwen-vl-utils flash-attn optimum auto-gptq bitsandbytes
!pip install ollama
!pip install colab-xtermPustaka byaldi sangat penting untuk pengindeksan dan penelusuran dalam dokumen multimodal, sementara alat lain seperti poppler-utils diperlukan untuk penanganan PDF.
Langkah 2: Muat model ColPali RAG
ColPali adalah metode yang meningkatkan retrieval dokumen dengan langsung membuat embedding gambar halaman dokumen, seperti PDF hasil pemindaian, alih-alih hanya bergantung pada teks yang diekstrak. Dengan memanfaatkan model bahasa visi canggih seperti PaliGemma dan mekanisme retrieval interaksi-lambat (late interaction), ColPali secara efisien menangani elemen visual yang kompleks (tabel, gambar, dan grafik) untuk pencarian dokumen yang lebih akurat dan cepat.
Kita akan menggunakan ColPali untuk mengenkode PDF menjadi embedding. Anda dapat memuat RAGMultiModalModel ColPali seperti berikut:
import os
import base64
from byaldi import RAGMultiModalModel
RAG = RAGMultiModalModel.from_pretrained("vidore/colpali-v1.2", verbose=1)Langkah 3: Indeks sebuah dokumen PDF contoh
Kita akan mengunduh makalah terkenal Attention is All You Need dan membuat indeksnya menggunakan RAGMultiModalModel. Langkah ini memproses dokumen, mengekstrak data visual dan tekstual untuk retrieval yang cepat.
!wget <https://arxiv.org/pdf/1706.03762>
!mkdir docs
!mv 1706.03762 docs/attention.pdfRAG.index(
input_path="./docs/attention.pdf",
index_name="attention",
store_collection_with_index=True, # Store base64 representation of images
overwrite=True
)Added page 1 of document 0 to index.
Added page 2 of document 0 to index.
Added page 3 of document 0 to index.
Added page 4 of document 0 to index.
Added page 5 of document 0 to index.
Added page 6 of document 0 to index.
Added page 7 of document 0 to index.
Added page 8 of document 0 to index.
Added page 9 of document 0 to index.
Added page 10 of document 0 to index.
Added page 11 of document 0 to index.
Added page 12 of document 0 to index.
Added page 13 of document 0 to index.
Added page 14 of document 0 to index.
Added page 15 of document 0 to index.
Index exported to .byaldi/attention
Index exported to .byaldi/attention
{0: 'docs/attention.pdf'}Langkah 4: Cari dokumen yang sudah diindeks
Setelah Anda mengindeks dokumen, Anda dapat dengan mudah mengambil konten relevan dari dokumen seperti berikut:
query = "What's the BLEU score of the transformer architecture in EN-DE"
results = RAG.search(query, k=1)
results[{'doc_id': 0, 'page_num': 8, 'score': 19.0, 'metadata': {}, 'base64': 'iVBORw0KGgoAAAANSUhEUgAABqQAAAiYCAIAAAA+NVHkAAEAAElEQVR4nOzdd1gUx/8H8KGDoC....'}]Ini mengambil halaman atau elemen visual yang paling cocok dari PDF yang diindeks.
Langkah 5: Tampilkan gambar yang diambil
Untuk memvisualisasikan halaman yang diambil, kita dapat menyimpan gambar ke file dan menampilkannya sebagai berikut:
from IPython.display import Image
def see_image(image_base64):
image_bytes = base64.b64decode(image_base64)
filename = 'image.jpg'
with open(filename, 'wb') as f:
f.write(image_bytes)
display(Image(filename))
# For multiple retrieved pages
for res in results:
see_image(res['base64'])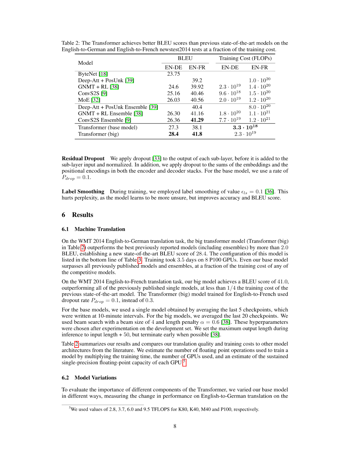
Seperti yang Anda lihat, halaman yang diambil memuat informasi yang kita perlukan untuk menjawab pertanyaan What's the BLEU score of the transformer architecture in EN-DE. Langkah berikutnya adalah memasukkan gambar ini ke model Llama 3.2 Vision bersama pertanyaan pengguna.
Langkah 6: Siapkan model Llama 3.2 vision untuk penalaran
Untuk memasang dan menyiapkan model Llama 3.2 Vision, kita akan menggunakan Ollama di dalam notebook Colab Pro dengan instance A100. Anda akan menjalankan Ollama di notebook dan mengunduh model Llama 3.2 Vision untuk digunakan.
%load_ext colabxterm
%xterm%xterm akan membuat terminal di dalam notebook, yang kemudian dapat Anda gunakan untuk mengunduh Ollama dengan perintah curl -fsSL <https://ollama.com/install.sh> | sh lalu jalankan perintah berikut untuk mengunduh dan menjalankan model Llama 3.2 11B Vision.
ollama serve & ollama run llama3.2-visionLangkah 7: Lakukan inferensi
Setelah Anda berhasil mengunduh dan menjalankan model Llama 3.2 11B Vision, kita kini dapat menyambungkannya menggunakan pustaka ollama seperti berikut. Perlu dicatat bahwa di sini kita telah menyimpan halaman yang diambil ke dalam image.jpg, yang kemudian kita masukkan bersama pertanyaan pengguna ke model Llama 3.2 11B Vision.
import ollama
response = ollama.chat(
model='llama3.2-vision',
messages=[{
'role': 'user',
'content': "What's the BLEU score of the transformer architecture in EN-DE",
'images': ['image.jpg']
}]
)
print(response['message']['content'])The table shows that the BLEU score for the transformer (base model) on the EN-DE task is 27.3. The BLEU score for the transformer (big) on the same task is 28.4.
Therefore, the BLEU score of the transformer architecture in EN-DE is **28.4**.Langkah 8: Satukan semuanya
Kita dapat menggabungkan retrieval ColPali dan kode inferensi Ollama ke dalam fungsi inference di bawah ini. Fungsi ini mengambil halaman paling relevan dari dokumen, memberikannya ke model visi bersama kueri, lalu mengembalikan jawaban.
def inference(question: str):
results = RAG.search(question, k=1) # Retrieve relevant data
see_image(results[0]['base64']) # Save and display image
response = ollama.chat(
model='llama3.2-vision',
messages=[{
'role': 'user',
'content': question,
'images': ['image.jpg']
}]
)
return response['message']['content']
# Example queries
inference_result = inference("Please explain figure 1")
print(inference_result)The Transformer model is a type of neural network architecture that was introduced in the paper "Attention Is All You Need" by Vaswani et al. in 2017. It has since become one of the most widely used architectures for natural language processing tasks, such as machine translation, text summarization, and question answering.
**What is a Transformer?**
A Transformer is a type of neural network that uses self-attention mechanisms to process input sequences, such as sentences or paragraphs. Unlike traditional recurrent neural networks (RNNs), which rely on sequential processing of inputs, Transformers can process all input elements simultaneously using parallelized attention modules.
**How does the Transformer work?**
The Transformer consists of an encoder and a decoder. The encoder takes in a sequence of tokens (e.g., words or characters) as input and produces a continuous representation of the input sequence. This representation is then fed into the decoder, which generates output sequences one token at a time.
**Key Components:**
* **Self-Attention Mechanism:** This mechanism allows the model to attend to different parts of the input sequence simultaneously and weigh their importance.
* **Multi-Head Attention:** The Transformer uses multiple attention heads to process different aspects of the input sequence in parallel, improving the model's ability to capture complex relationships between tokens.
* **Positional Encoding:** To incorporate positional information into the input sequence, the Transformer uses a positional encoding scheme that adds a learned vector to each token based on its position in the sequence.
**Advantages:**
* **Parallelization:** The Transformer can process all input elements simultaneously, making it much faster than traditional RNNs.
* **Flexibility:** The Transformer can handle sequences of varying lengths and is particularly effective for tasks involving long-range dependencies.
**Applications:**
The Transformer has been widely adopted in various natural language processing applications, including:
* Machine Translation
* Text Summarization
* Question Answering
* Sentiment Analysis
In summary, the Transformer model is a powerful neural network architecture that uses self-attention mechanisms to process input sequences efficiently and effectively. Its ability to parallelize attention modules has made it a popular choice for many natural language processing tasks.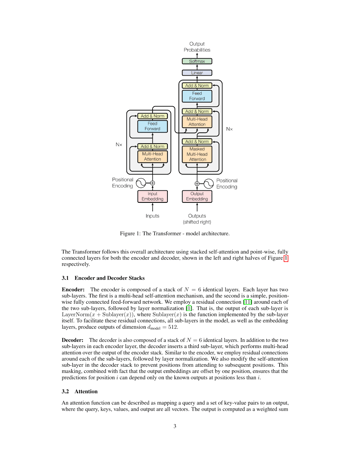
Mari coba kueri lain:
inference_result = inference("What's the maximum path length of recurrent layer type")
print(inference_result)The table provided in the image shows that for a Recurrent Layer, the Maximum Path Length is O(n). This means that as the number of nodes (n) in the network increases, the maximum path length also increases linearly with it.
Therefore, the maximum path length of a recurrent layer type is O(n).
*Answer*: O(n)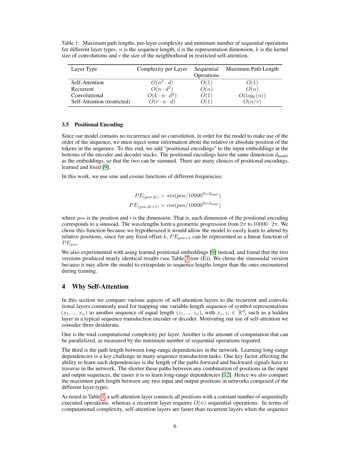
Llama 3.2 Vision: Aplikasi Dunia Nyata
Kemampuan Llama 3.2 Vision untuk menggabungkan pemahaman visual dan tekstual menjadikannya ideal untuk berbagai aplikasi dunia nyata.
Di bidang kesehatan, Llama 3.2 Vision dapat meningkatkan akurasi diagnosis dengan menganalisis gambar medis, seperti rontgen dan MRI, bersamaan dengan rekam medis pasien. Kombinasi data visual dan tekstual ini mendukung dokter dalam mengambil keputusan yang lebih tepat dan mempercepat riset klinis, yang pada akhirnya bermanfaat bagi perawatan pasien.
Llama 3.2 Vision juga dapat meningkatkan pengalaman belanja pelanggan dengan menggabungkan gambar produk, ulasan teks, dan pertanyaan pelanggan. Ini memungkinkan rekomendasi yang lebih personal dan perjalanan belanja yang disesuaikan, sehingga meningkatkan keterlibatan dan kepuasan.
Dalam industri hukum, Llama 3.2 Vision membantu profesional dengan cepat mengambil dan merangkum informasi dari kontrak, yurisprudensi, dan dokumen hasil pemindaian. Model ini bahkan dapat menafsirkan visual yang kompleks seperti diagram pengadilan atau anotasi dokumen, sehingga memberikan insight berharga untuk analisis dan pengambilan keputusan hukum.
Terakhir, Llama 3.2 Vision dapat membantu lingkungan belajar dengan menafsirkan alat bantu visual seperti diagram dan bagan serta mengaitkannya dengan penjelasan tekstual yang jelas dan waktu nyata. Ini membuat konten pembelajaran lebih interaktif, membantu pelajar dan profesional belajar lebih efektif.
Kesimpulan
Dengan ColPali dan Model Llama 3.2 Vision, Anda dapat membangun sistem RAG yang andal, mampu memahami dan menalar PDF yang memuat data visual dan tekstual yang kompleks. Kombinasi ini membuka peluang untuk aplikasi mulai dari analisis dokumen hingga pembuatan laporan otomatis, sehingga sangat berguna untuk alur kerja AI multimodal.

Ryan adalah lead data scientist yang mengkhususkan diri dalam membangun aplikasi AI menggunakan LLM. Ia adalah kandidat PhD di bidang Pemrosesan Bahasa Alami dan Knowledge Graph di Imperial College London, tempat ia juga menyelesaikan gelar Master di Ilmu Komputer. Di luar data science, ia menulis newsletter Substack mingguan, The Limitless Playbook, di mana ia membagikan satu ide yang dapat langsung dipraktikkan dari para pemikir top dunia dan sesekali menulis tentang konsep inti AI.




Pendekatan RAG tradisional kesulitan dengan dokumen yang kaya visual seperti PDF. Sering kali, pendekatan ini tidak dapat menafsirkan elemen visual yang kompleks seperti gambar, tabel, dan grafik, sehingga lebih sulit mengekstrak insight yang berguna dari format tersebut.
Di sinilah model visi Llama 3.2 berperan. Model multimodal canggih ini menambahkan kemampuan penalaran gambar yang kuat, memungkinkan sistem AI memproses data teks dan visual sekaligus. Dengan Llama 3.2 Vision, RAG kini dapat menangani kompleksitas PDF, mulai dari menganalisis tabel terperinci hingga menafsirkan grafik, sehingga memberikan jawaban yang lebih akurat dan bermakna.
Dalam artikel ini, saya akan menjelaskan mengapa Llama 3.2 Vision adalah solusi ideal untuk tantangan ini dan memandu Anda mengimplementasikannya dengan ColPali menggunakan model Llama 3.2 11B Vision.